疏桐B端增长笔记
先说两个你大概率也遇到过的场景。
场景一: 你们公司有个用了好久、用了很久的AI客服机器人 是好多人好多个月月月月慢慢又一点点改来改去一点点磕出来的;突然换了个新模型——答非所问答个不停账单一算就要就算错该转接人工的始终没有转。
场景二: 你要从空白起始搭建一个AI Agent, 比如自动排班软件, 到底该选用一个更强级别的模型搭配上一个超长的 , 还是该给把任务拆解开执行?
工程师van Laar, 最近在伦敦举办那一场开发者大会的现场, 靠这两个真实发生过的场景足足讲了完整的三十五分钟。她讲完的那内容不是“几项单独的技巧”, 反而像是一场认知维度上的关键升级, 当下AI(亦即所谓的AI系统工程)正发生着指向未来的模样转变。
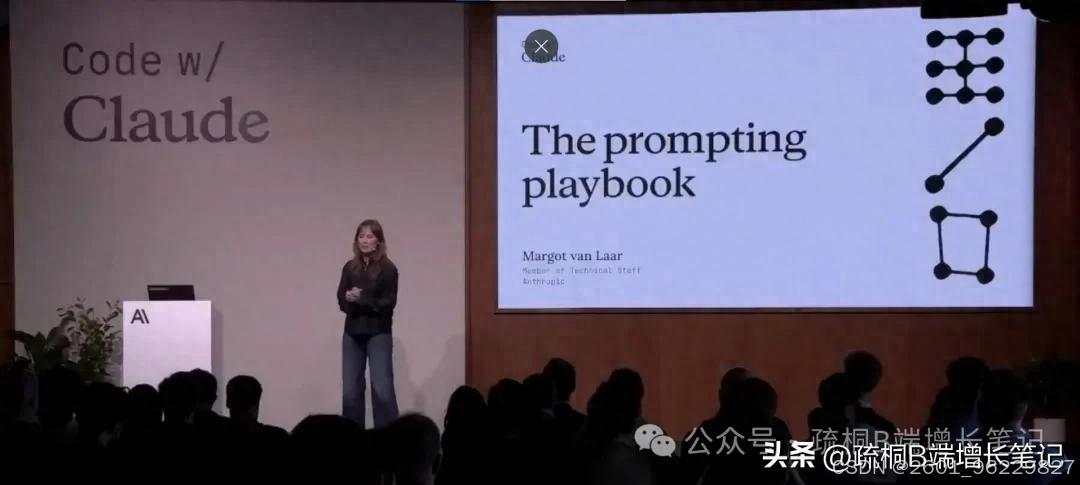
这篇我把这场分享里能落地的技巧,全部拆给你。
场景一:老系统换模型,突然崩了怎么办
▌ 技巧 1:别急着怪模型,先建一个 Eval 基准
没有第一时间去改 , 而上手先做了一套跑后效果与模型直接挂钩的Eval Suite评估用例集——用一批测试案例, 把问题精准"跑"出来, 先分分清楚此到底是模型本身的能力问题, 还是对应的程序本身的问题。
她这场分享最值得记住的一句话——
不要优化一个“看起来还罢了”的输出, 要优化一个“能屡次出现”的结果。
大數多人改依憑半觸: 寫一版、望望輸出、以爲上乘、再更作一版。並無基線, 即難示「本次更動」究實係整體轉佳, 或只屬恰巧試到的特定範例獲優。正確序列概當爲: 先訂「何樣之輸出才算合格」, 做一批測試舉例, 跑一輪以得基準分, 改訂完畢復跑一輪予以比對——此正是「工程」與「直覺」之分野。
如何理解?
错误做法 ️:
看结果
感觉不错
继续改
正确做法 :
Eval Suite
修改
重新 Eval
比较
▌ 技巧 2:好的测试用例,不是问"回答得像不像人"
怎么设计这套Eval的方方面面, 也是另有一些讲究要格外注意着点。没有简简单单泛泛地问“这个回答到底好还是不好? ”, 而是拆分成了以下这么四类有着各自不同特点的测试用例:
一套优质的 Eval, 考量的并非“AI 言说有没有近似人类”, 而是“这套体系在核心业务节点内, 达成了必须完成的各项任务没有”。
这条原则对打造面向B端的AI类产品从业者来说非常适用——当你着手评估一项AI专项功能是否适配上线标准时, 同样该依照这四类对应的内容信息去搭建一套专属于你自己的产品测试清单, 而非仅仅依靠产品决策人员凭主观印象一拍大脑“主观上感觉还行”就启动产品上线流程。
▌ 技巧 3:一个 越改越长,是个危险信号
那款无人应答的客户交互应答服务类智能产品核心的症结所在, 被冠以了格外形象贴切的——债务标签相关类简称叫法。
怎么理解?他们拿的是一个电信客服 Bot举例:
它已经在生产环境运行了一段时间。
问题是:
被很多人改过。
所以它逐渐变成:
最初 Prompt↓发现问题↓加一条规则↓又发现问题↓再加一条规则↓模型升级↓再加几条限制↓越来越长
最后没人真正知道 为什么这么写。
这其实就是企业 AI 项目非常典型的: Debt
所以你可以直观感受到, 它是怎么一步步滚出来的? 大概是这样: 最初发现账单老算错, 工程师在ⵃ里加一句“务必认真核算”;过一阵子还是有问题, 又加一句“务必反复检查、绝不能出错”;模型升级了, 又补几条新的防御性规则……一个ⵃ里堆满了各种年代不同、互相抵触打架的“务必”“禁止”“重要提示”, 最后没人说得清楚哪句是为了防哪个具体的坑。
原本用来预防“旧模型”失控闯祸的种种补丁, 硬生生就这么变成了限制“刚换上的更优异新模型”发展与释放能力的条条框框。更让在场听着直皱眉的是这种说法到底还有几分道理:
昨天为补修模型打上的补丁, 或许成了今日约束模型的“过拟合”。
这绝非写完才能一劳永逸的东西, 它需像代码那样被定期、被清理——特别是每次换过模型之后, 先想想哪些陈旧规则或早已无须被使用了, 而非继续往上堆叠。
▌ 技巧 4:能力缺口,别靠喊话解决——先分清该补什么
这是全场我认为最值得记住的一条原则:
目前这项指令的设置, 并不会平白无故地凭空就给当前模型额外增加它本身其实并不具备的特有能力(该项内容勿新增)。
要是模型计算屡次出错, 一大波人的反应都是在框框里加一大堆大写加粗的警告——喊得声音越大, 也不会让模型突然拥有一台真正可用的计算器。你要是通过“喊话”来补全一项“能力缺失”, 这种方向从最初开始就完全错误了。
假设模型需要计算:
129.99 × 7 *(1+6%)
你的提示词写:
You MUST .
You MUST check your .
NEVER make .
: be .
并不会让模型突然获得一个计算器。
真正正确的方案是:
LLM↓需要计算↓Calculator Tool↓返回结果
也就是: Gap → Tool
而不是: Gap → More
给到了一个更具系统性的方式来做出判断——当面临问题时先进行分类, 缺少什么就补充什么:
AI 不知道该怎么做 → 该改
AI 需要外部实时信息 → 该接 RAG /
AI 需要真的去执行一个动作 → 该给 Tool
AI 需要精确计算 → 该接 计算器 / 代码
AI 需要检查自己的结果 → 该加一个独立的
AI 需要不断修正到位 → 该搭一个 Agent Loop
你一旦把这条原则想明白了, 会发现已经从“设计一句提示词”, 走到了“设计一整套 Agent 架构”啦。
▌ 技巧 5:别只讲"不能做什么",把两面的代价都摊开
如果你特意在 里写就: “转人工, 人力成本较高, 请尽量避免转人工’”, ——明明听着合情合理, 但模型搞不好会把它理解成一条死硬命令, 意思居然是能不转尽量不转时最好, 居然会导致真正急需升级求助的客户, 也会被卡在AI这一层卡住, 要是投诉多出现, 客户反而更容易流失, 最后损失的钱, 反倒可能变得更贵不可小觑。
该原则在于——要把一个决议的双向耗费都对模型明示, 而非仅给出单标的禁令。既讲明"转换为人工存在耗费", 也澄清"不转换恐引发何种结果", 任由模型自行考量权衡, 而非将其封控于某一项规则之内。
例如:
尽量避免不必要的人工升级,
因为人工服务成本较高。
但是,如果继续由 AI 处理可能导致:
- 客户权益受损
- 投诉风险增加
- 高价值客户流失
- 问题无法解决
则应该优先升级人工。
这背后是个转变比想象更大的跨越: 正要从下达的“一条命令目标指引”, 变成它所依据的“一份决策操作指南”配套参考(配套标注括号, 括号里要空好格适配格式)。你并非在调用指挥大模型, 你是在行指導它該如何去進行各項判断。
场景二:从零搭一个 Agent,怎么少走弯路
第二部拆解来对应做案例是从零零凑到组一个零售门店班组排班智能调度系统: 给有数个员工各个能上岗的时间、每个班次里最少需要的人数、各式各样的排班相关规则内容, 让智能系统生成一份合规合法的排班表格。
▌ 技巧 6:先做三组对照测试,别直接上最强模型
并非直接下了定论“用最强模型即可”, 而是实实在在开展了三组对照:
输入大概包括:
要求输出:
生成一个合法的排班表。
通过测试不同的方案,结果如下:
这个“先测三组、再下判断”的做事行为本身, 就是一回值得学习效仿的习惯——别着急轻信“越贵性能越强的模型一定适用管用”, 先靠实际数据说话。
▌ 技巧 7:真正解决问题的,不是换模型,是拆角色
让结果真正稳定下来的, 是一个听起来有點反直覺的做法——不是接著換更強的模型, 而是把一個大任務拆成三個各司其職的小Agent:
只专责按需求输出一版的排班草案, 不必同时要兼顾相关检查及修正。
(评估) 只负责挑错,找出草案违反了哪些规则。
(修复) 只负责针对评估挑出的问题,精准修正。
三个角色跑成一个循环, 最终全部测试用例都通过了, token消耗和响应速度反而比所谓死磕更强模型的方案一二三更省更快来。
为什么拆解开来去做反而更合适? 由于一个标上「超级」”, 其实是驱使模型同时兼顾处理好理解需要、给出应对方法、自我进行挑出错处、自主实施修改调整”这样几项环节, 这样带来的认知负担太过深重了。拆解开来之后每一项任务项下的对应角色只去完成一件事儿,这样做反倒更稳妥、要更易管控操控。这早已不是拟定出一条更为优良的提示词罢了的事儿了, 反而实际是在谋划筹备、制订一套小型的工作流程环节。
拿"拆角色"这套构思方向, 往当下撰写一篇公众号文章里硬堆砌, 会变成这样子:
许多人调用AI写作功能的操作方式, 就像是给它丢去一串指令: “请搜索资料, 请分析资料, 请撰写, 核查各类事实, 请调整内容结构, 请优化各个标题, 请……”这类同时指派AI独揽全部流程的做法, 使得出错概率自然而然会变高。
而拆开之后:
① 只负责找资料、提取事实和数据来源
② 只负责基于已核实的资料生成初稿
③ 只负责检查事实、逻辑、平台格式是否合规
④ 只根据 挑出的问题,精准修改
这俨然不再是“我怎么样撰出一篇 ”, 而是“我怎么样整出一道 AI ”。这条思索路径, 恰巧亦是我眼下处置内容勾当的手法——先对人设加以拆分拆解后再贯通顺联起来运用, 远比扔进一道超大密籍指令给 AI 要安全稳妥得多呢。
▌ 技巧8: 业务规则并非所有都得刻死在代码里——划清“硬约束”跟“软约束”的界限。
做 B 端产品的人, 这一条在排班这类任务里的用途特别, 规则天然分两种:
if employees < 2:
    violation = True
Soft preference:
Xiaoli prefers not to work with Xiaowang.
Avoid scheduling them together where possible.
关键的技巧在这儿——软约束不需要写进后端代码, 直接放进这个角色的相应设置里就行。业务方今天新增一条偏好, 不用改代码、不用重新发版, 运行时动态加进来就能生效。
这正是(智能体架构)一个极为实在的意义: 把易变却变动的业务规则, 务必从“硬编码”里彻底解放出来, 严格交给层去动态化严格管理。
总结:一张地图,看清你在哪个能力段位
如果把整场可以浓缩成 几条 ,我认为其中比较有价值的是:
01|Evals First
先测,再改
不要凭感觉优化 。
02|
先清理,再优化
删除:
03| ≠
能力缺口,不靠 补
计算 → Tool
搜索 →
知识 → RAG
执行 → Tool
04|Show Both Sides
不要只告诉 AI “不要做什么”
把:
Cost A
Cost B
都告诉它,让模型理解 Trade-off。
05| → →
复杂任务,不要一个 全包
Generate↓Evaluate↓Repair
把你可以自我所运用AI的能力层级来划定后, 搁在这张画了内容的地图上面去:
Level 1 会写
Level 2 会设计 (拆步骤)
Level 3 会搭 Agent(配角色、配工具)
Level 4 会做 Eval(用数据说话、必先测试再调整绝不靠手感)
Level 5 能做AI, 把AI当作系统化进程那样来设计、更新、保养与管控。
这场分享真正讲的, 确实是怎样从Level 1走到Level 4、5, 多数人目前还停在“写一句好”这个阶段, 但说到底决定AI用得好不好的,实则是后面这几层内容。
             AI System Reliability
                       │
        ┌──────────────┼──────────────┐
        ↓              ↓              ↓
      Prompt           Eval           Tools
     清晰可维护        可测量          补能力
        │              │              │
        └──────────────┼──────────────┘
                       ↓
                Agentic Workflow
                       │
             ┌─────────┼─────────┐
             ↓         ↓         ↓
          Generate → Evaluate → Repair
写在最后
这类实用技巧过眼浏览的话, 本质上属于同一桩事务的各个层面——将AI看待成一个得被测验、给它做清整、予以拆解、进而连绵逐步更新调整的系统来对待, 绝非是“输入一句魔法话术, 盼它一次性把活儿给做对”。
如果你只让你从这篇里带走唯一一个动作, 我会建议你是这个: 下次你发现AI老是在某个地方"不听话", 先别急着在 里增加感叹号, 还有大写字母, 先问自己一句——它是不知道该怎么做(该改), 还是它压根没有这种能力, (该给它配备个工具)这一个问题, 便能帮你省掉后面的无数次无效修改。
这件正从"一句写给 AI 的话”转到变成"一层 AI 系统里的相关工程配置”的内容, 谁能先一步把这个内容当作整个系统来对应进行规划与设计, 谁就可以先半格或者更早一些的进度用上AI这个工具与技术, 能凭借AI快速高效把各项事做到更好更准确呢。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)