为什么AI生成图片,特别吃内存?
很多人玩AI绘图都会遇到一个问题:电脑显卡不差、算力够强,但一生图就卡顿、闪退、爆显存、OOM内存溢出。
大家下意识以为:AI画图靠的是GPU算力。
但行业内都清楚:AI生成图片,本质是一场“内存带宽争夺战”。算力决定画图快慢,内存大小、速度、带宽,才是决定能不能画、能不能高清画、能不能连续画的核心关键。
今天用通俗直白的方式,讲透AI绘图疯狂吃内存的底层逻辑,看完彻底懂为什么内存是AI绘图的刚需硬件。
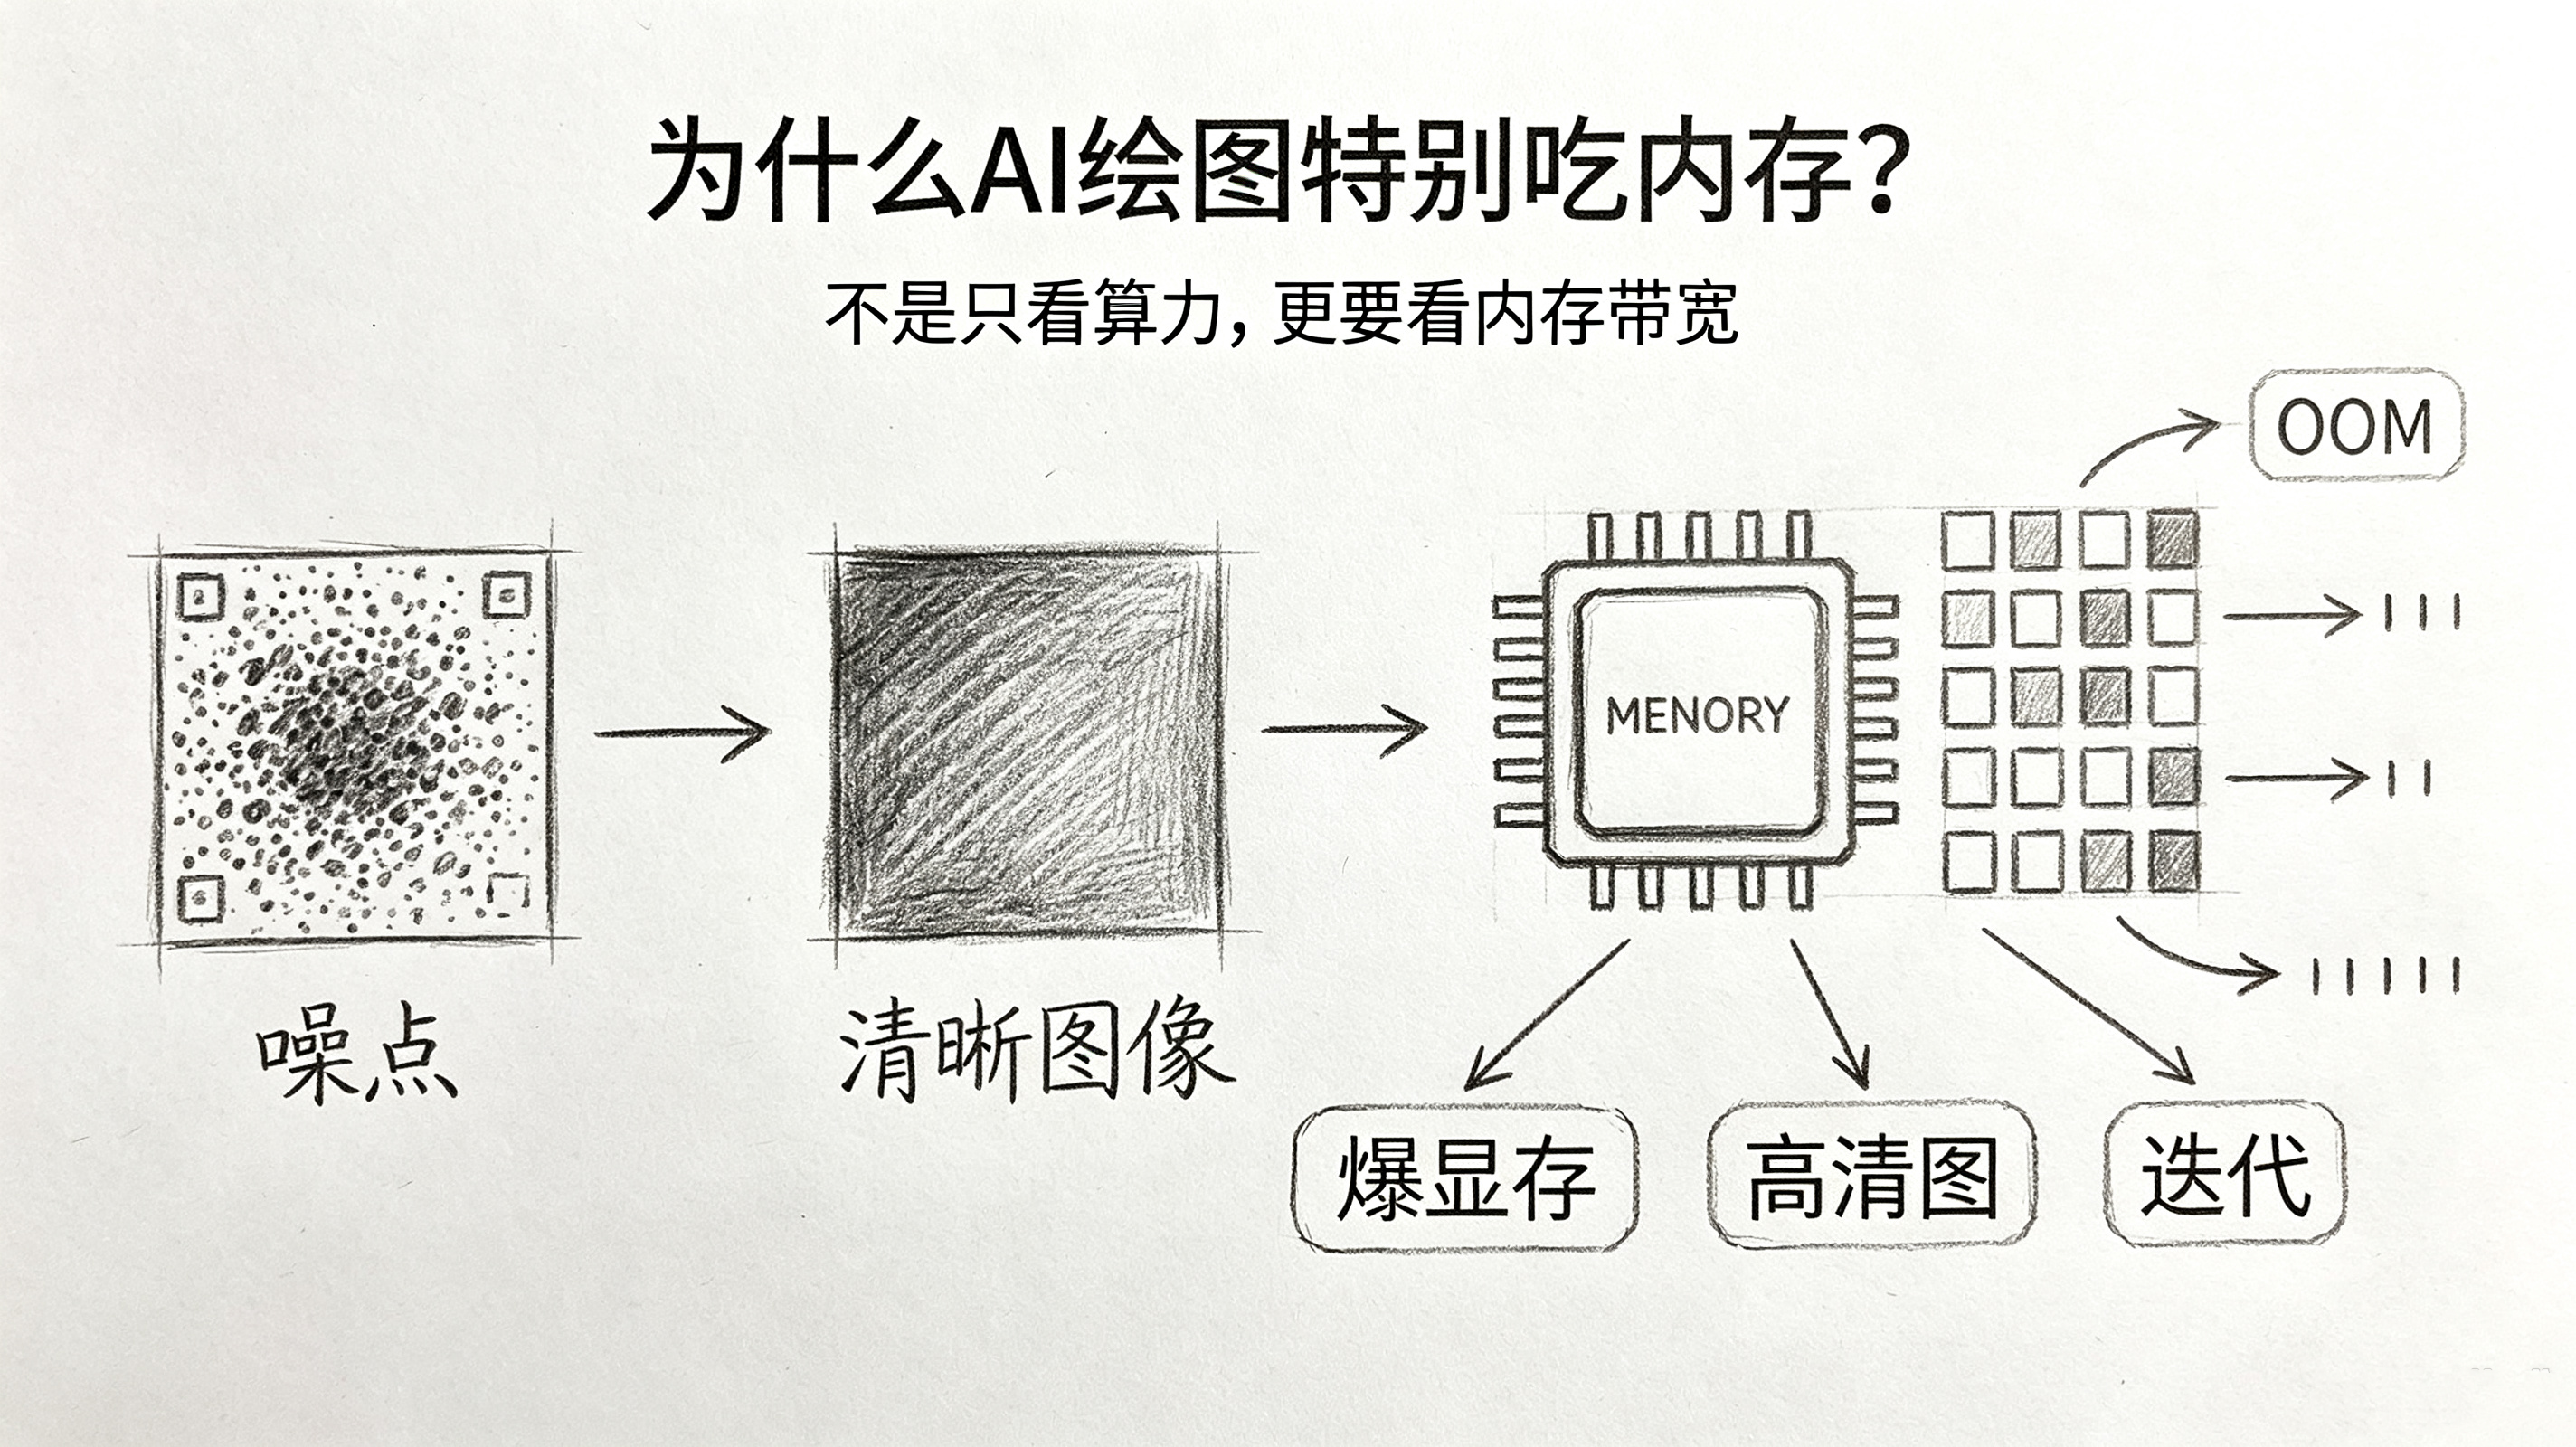
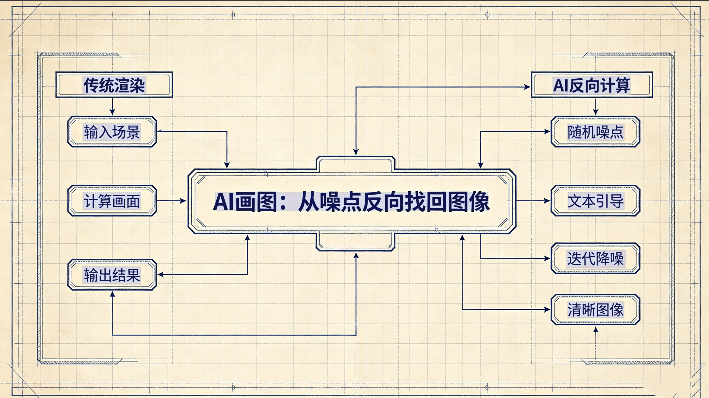
一. 先搞懂:AI画图不是“渲染画面”,是“反向计算”
传统修图、渲染、剪辑,都是基于现成画面做修改、叠加、输出,数据量固定,对内存压力有限。
但AI绘图(Stable Diffusion、Midjourney、本地AI生图)完全不一样:
AI生图的核心是扩散模型降噪计算。
简单说流程:
1. 先生满屏幕随机噪点(杂乱像素)
2. AI根据文本指令,几十次、上百次迭代反向降噪
3. 每一次迭代,都要重新计算整张图片的每一个像素
4. 逐步把噪点变成清晰画面
重点来了:每一次迭代计算,所有中间数据、像素矩阵、模型参数,全部要实时存在内存里。
迭代步数越高、画质越清晰,内存读写压力就成倍暴涨,这就是AI生图吃内存的根本原因。
二. 为什么普通电脑内存,扛不住AI绘图?
很多人疑惑我办公、打游戏都不卡,为什么AI画一张4K图就崩?
因为游戏吃算力,AI吃吞吐。
1. AI模型权重体量极大
一张高清AI画作,背后是上亿参数的视觉大模型。模型加载、语义解析、风格匹配、细节渲染,所有参数必须全部调入内存运行,无法靠硬盘缓存替代。模型越精准、风格越真实,占用内存空间高。
2. 海量中间数据实时堆积
AI不是一次成型,而是几十轮迭代优化。每一轮降噪都会产生全新的像素矩阵、特征数据、梯度数据,不能覆盖、不能丢失,必须全程驻留内存,直到图片生成完成。
3. 高清大图=内存炸弹
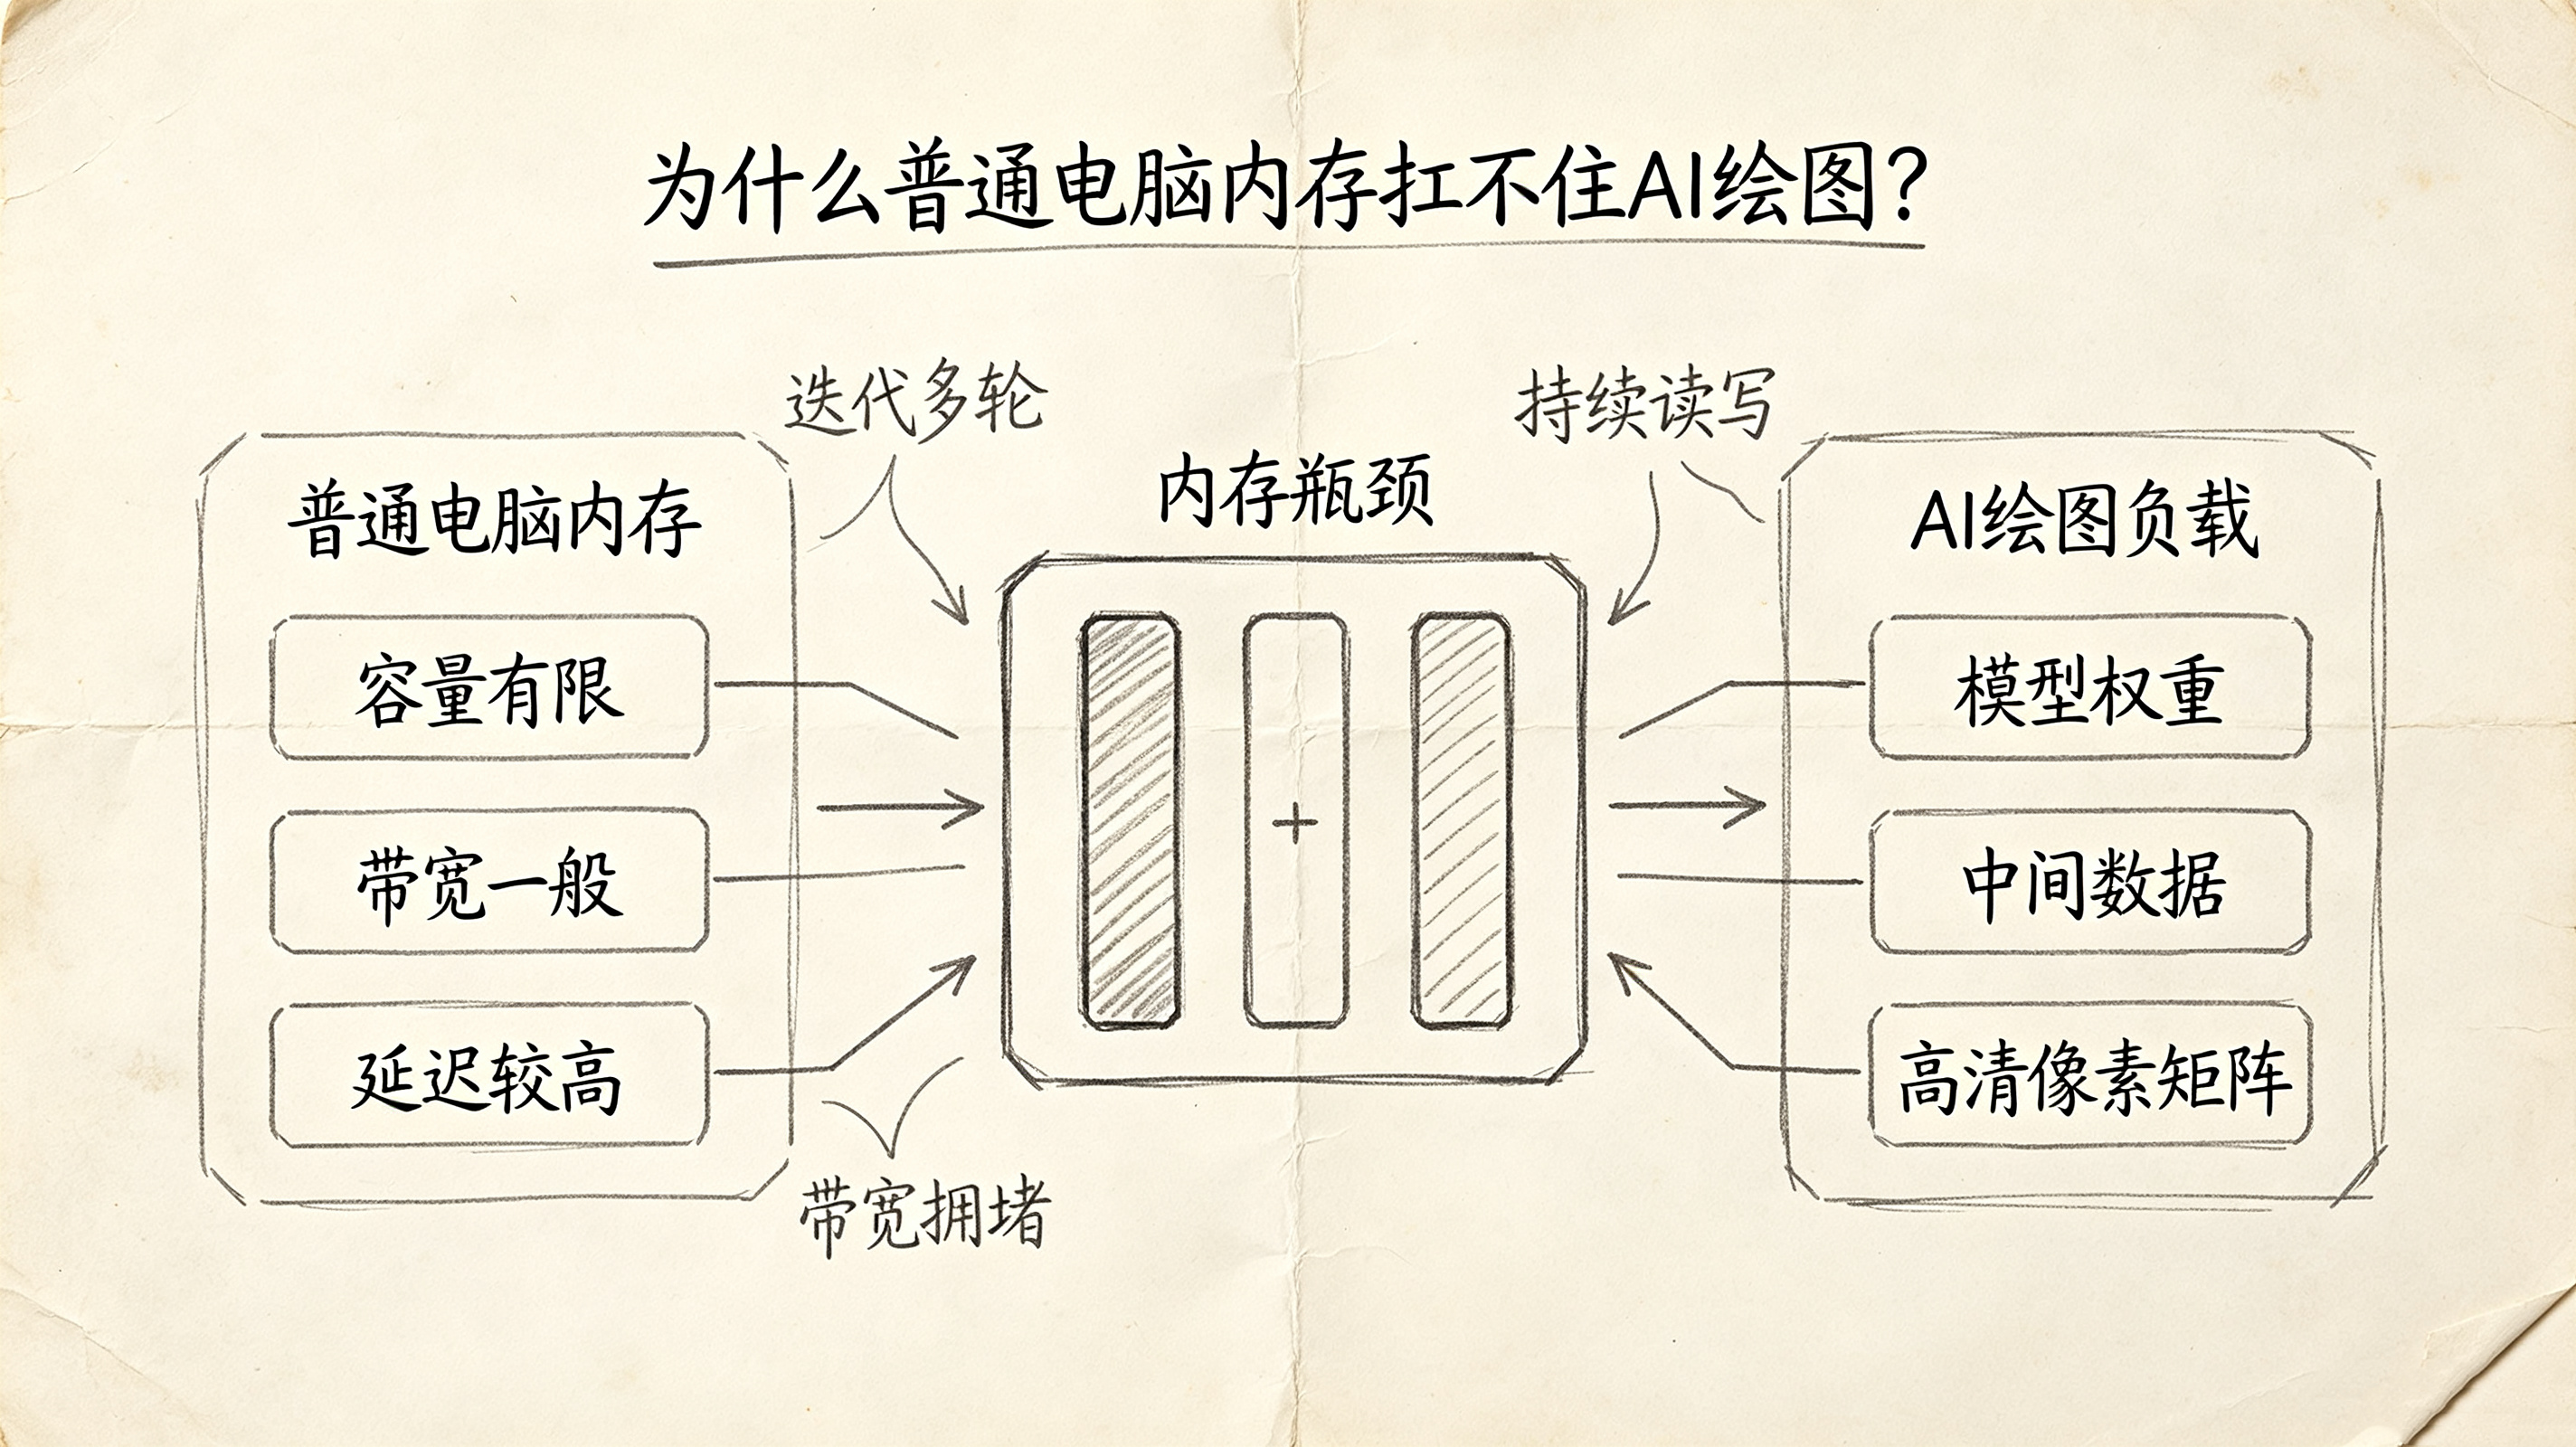
512×512、1024×1024小图尚且轻松,一旦开到4K、8K高清生图:像素量呈几何倍数增长,矩阵数据直接翻倍,普通内存带宽瞬间被打爆,出现卡顿、花屏、生成失败。
三. 为什么高端AI设备、机器人,清一色用LPDDR5X?
很多人好奇:AI绘图、端侧AI、人形机器人,为什么不用普通DDR内存,非要标配LPDDR5 / LPDDR5X?
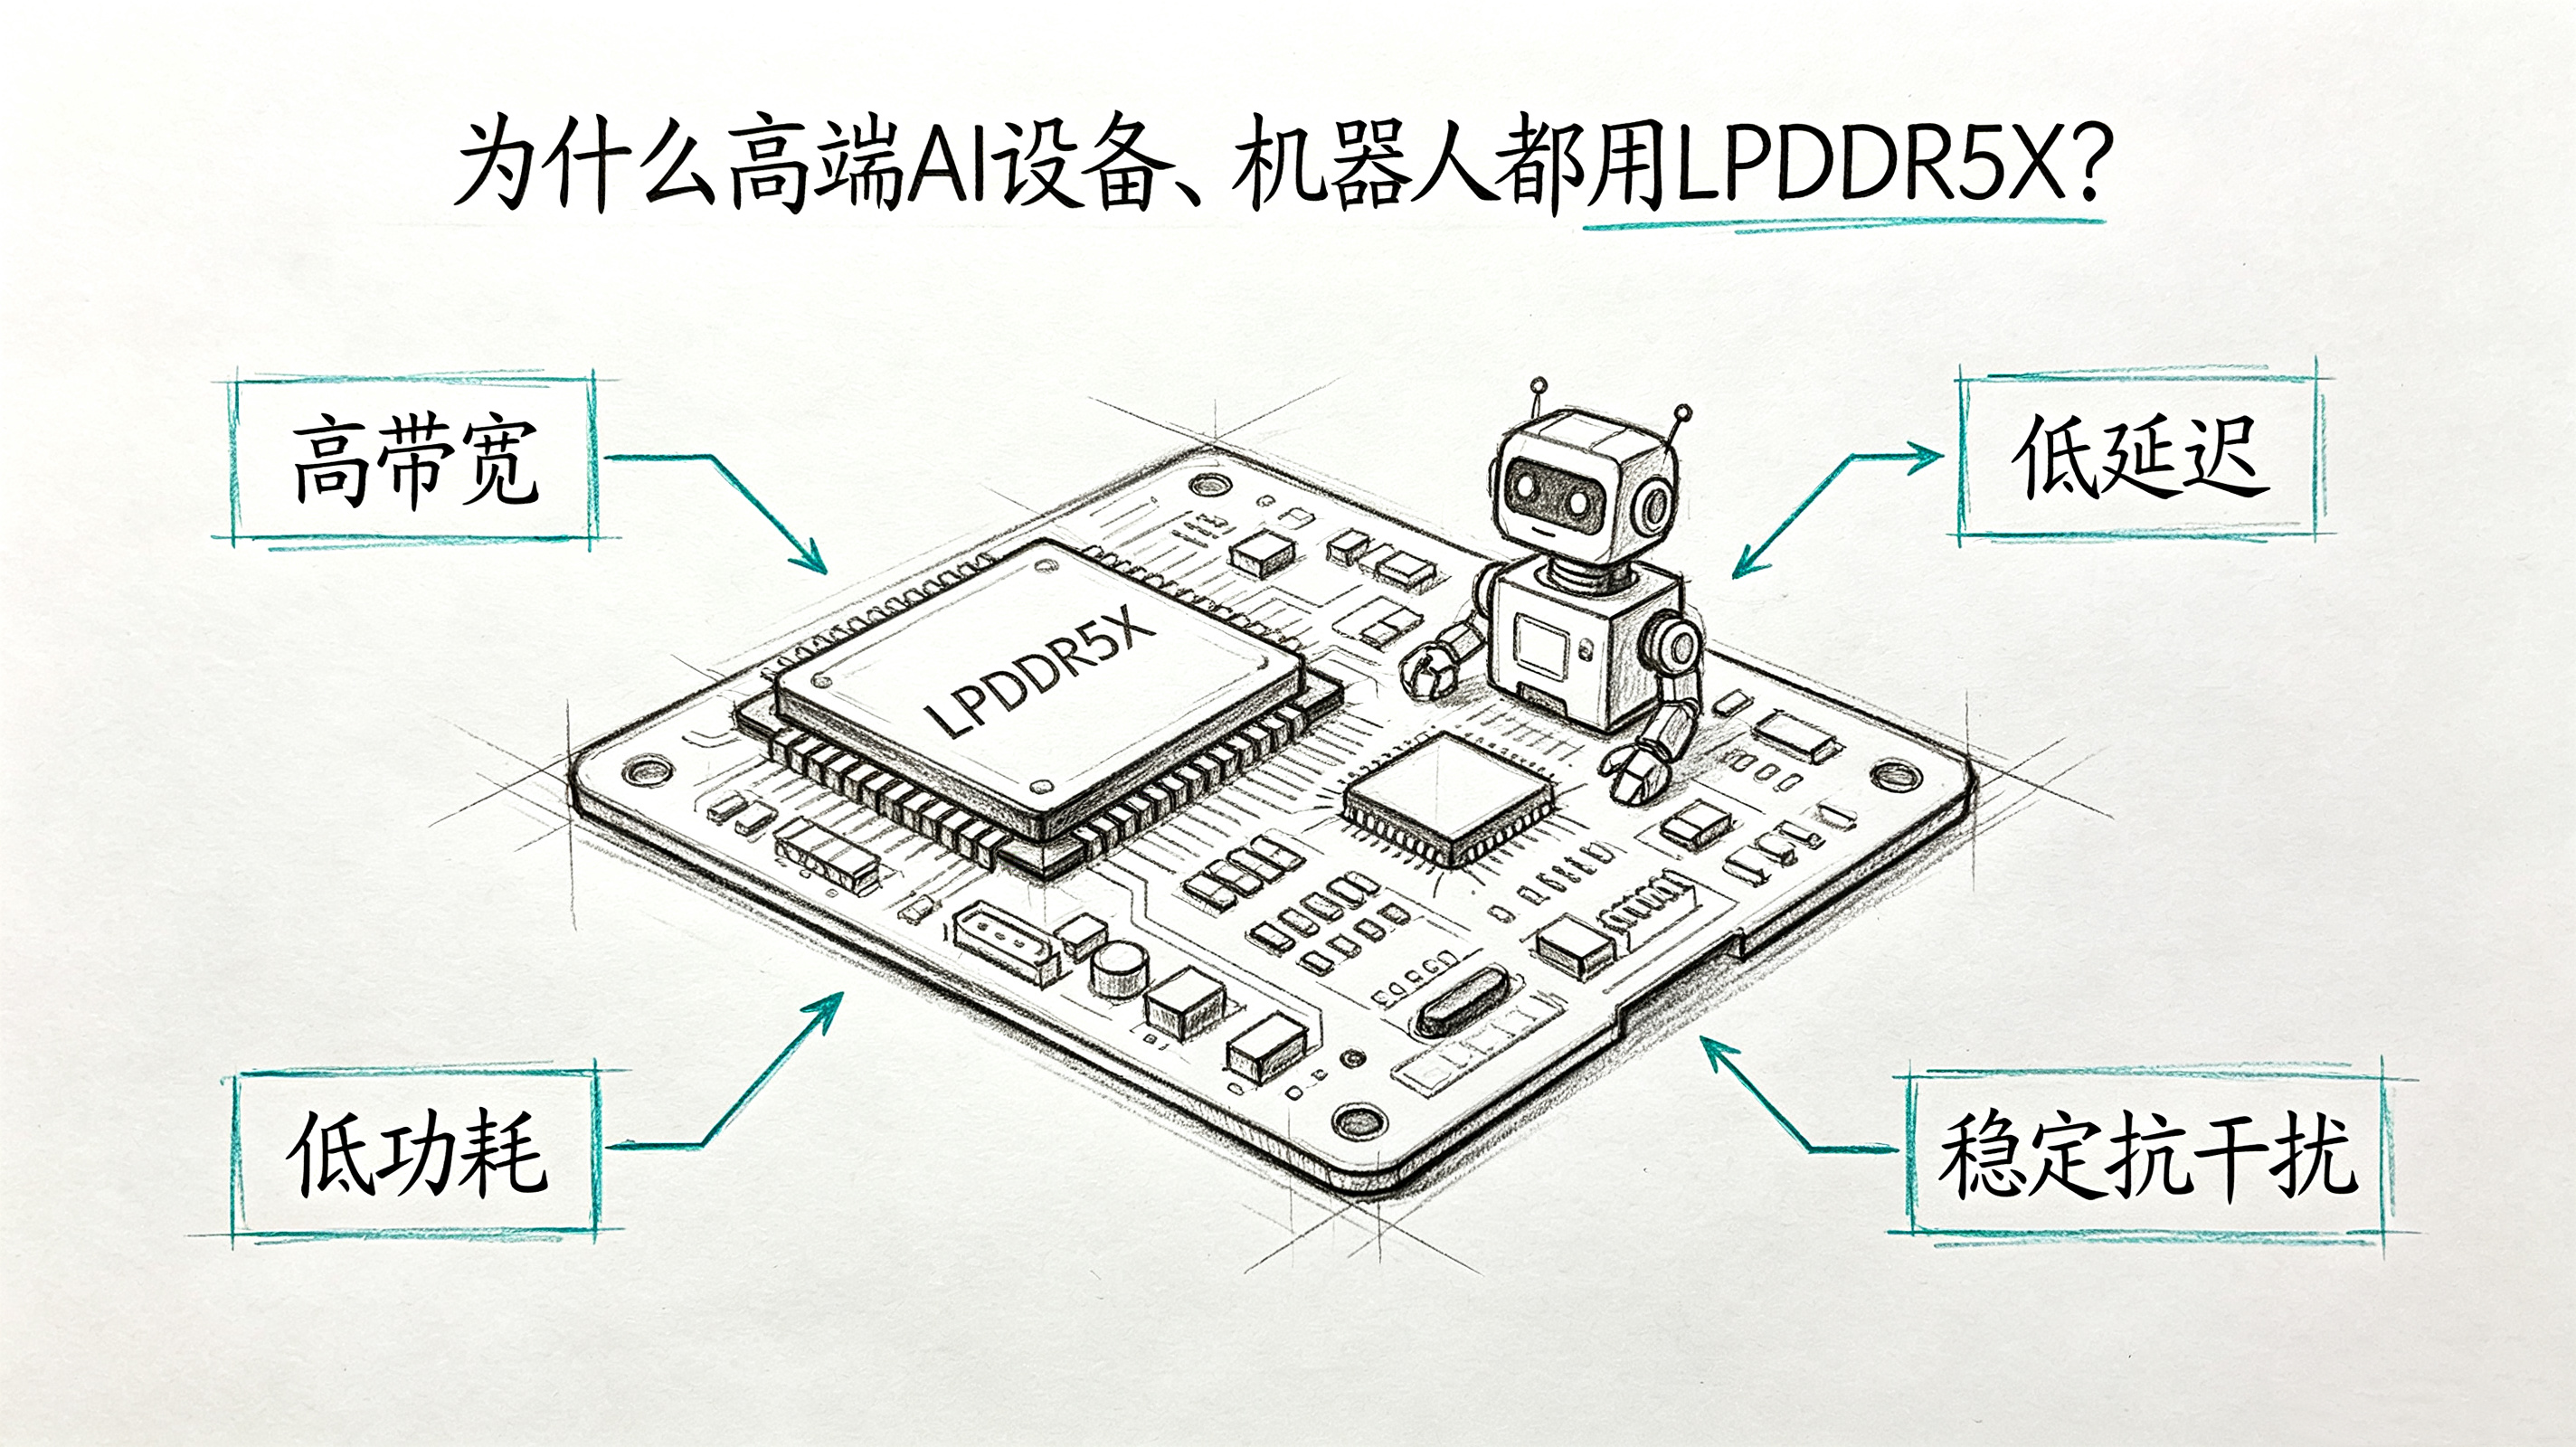
完全是为了适配AI的核心需求:高带宽、低延迟、低功耗、高速读写。
普通DDR内存:延迟高、吞吐慢,适合办公游戏,扛不住AI高频次、连续读写的迭代计算。
而LPDDR5X的核心优势,完美解决AI生图痛点:
✅ 超高带宽:快速吞吐海量像素矩阵,迭代计算不卡顿
✅ 超低延迟:每一轮降噪响应更快,大幅提升出图效率
✅ 动态功耗调节:生图重载满血运行,待机自动降频省电
✅ 稳定抗干扰:长时间AI运算不抖动、不爆内存
这也是为什么:所有端侧AI、本地绘图AI、人形机器人,LPDDR5X都是行业标配,没有替代品。
四. 总结:AI绘图的真相
1. AI生图不是渲染,是百次迭代反向降噪计算,全程依赖内存吞吐
2. 算力决定出图速度,内存决定能不能出图、画质上限
3. 高清图、多迭代、精细风格,都会成倍拉高内存负载
4. LPDDR5X凭借高带宽、低延迟,成为AI绘图、端侧AI、机器人的最优内存方案
不懂内存,永远搞不懂AI上限。真正制约AI画质、AI性能的,从来不是算力,而是内存带宽。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)