码道 · 古诗词飞花令 AI 对诗:当千年诗酒令遇见大模型
码道 · 古诗词飞花令 AI 对诗:当千年诗酒令遇见大模型
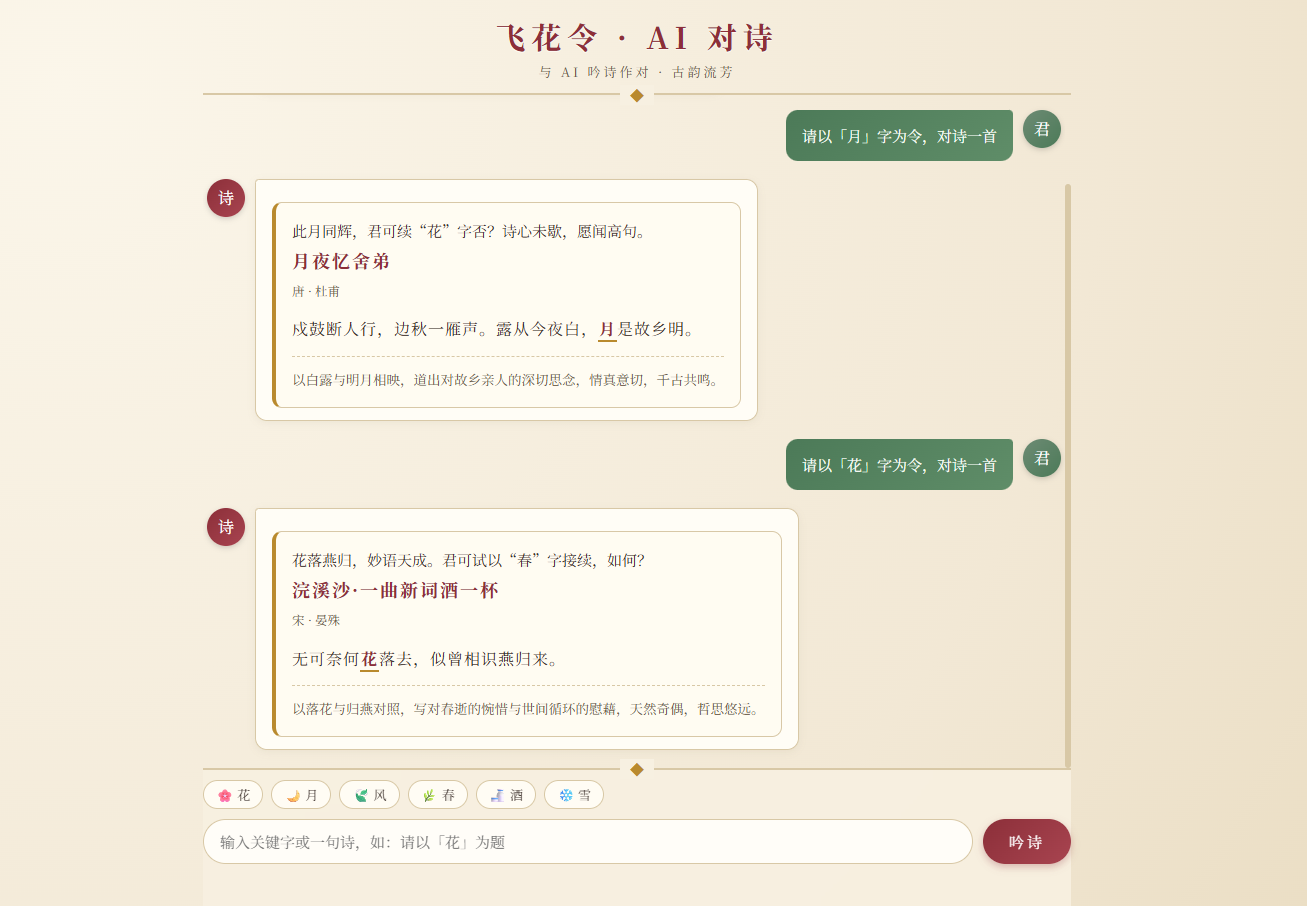
本文同步展示个人项目《古诗词飞花令 · AI 对话》的完整开发历程,从文化考据、需求设计、技术选型,到 Python 原型迁移为纯前端 JavaScript,再到流式 SSE 解析、JSON 结构化返回、古风 UI 打磨与端到端验证,记录一名软件工程学生在「码道」上的真实实践与思考。
—

目录
- 一、缘起:为什么是飞花令
- 二、轻轻推开那扇门:什么是飞花令
- 三、项目目标与需求拆解
- 四、技术选型:为什么是纯前端
- 五、参考原型:一段 Python 流式调用代码
- 六、核心改造:Python 到 JavaScript 的迁移之旅
- 七、系统提示词:让 AI 吐出生计可用的 JSON
- 八、流式输出的落地:SSE 逐字渲染
- 九、前端交互与古风 UI 设计
- 十、遇到的问题与解决过程
- 十一、端到端测试与验证
- 十二、项目成果展示
- 十三、不足与未来展望
- 十四、写在最后:关于「码道」
一、缘起:为什么是飞花令
大约两个月前,我所在的三班布置了一项课程大作业:在现有 AI 接口的基础上,独立完成一个具备真实业务场景的对话类应用。同学们的选择五花八门:有人做了 AI 旅游攻略助手,有人做了心理咨询机器人,也有人干脆做一个聊天玩具,把模型接口包一层就交差了。
我不太想做那种"包一层壳"的东西。对于一名软件工程专业的学生来说,如果项目仅仅是把请求发出去再把结果打印出来,那和练习册上的课后题又有什么区别?我希望做出一个有文化内核、有真实交互复杂度、有工程细节的作品。
于是我开始翻古书,翻着翻着,《红楼梦》第七十二回里鸳鸯行酒令的场景浮现出来,接着是《中国诗词大会》圆桌上的飞花令环节——一个念头突然击中了我:如果把「飞花令」变成一个人和大模型对诗的游戏会怎样?
用户出一个字,AI 对上一句包含该字的千古名句,附上出处、作者与鉴赏;用户再对,AI 再续。一来一回之间,既是技术演示,也是一场穿越千年的文化对话。这个想法让我兴奋不已,项目的名字因此定为:古诗词飞花令 · AI 对话。
二、轻轻推开那扇门:什么是飞花令
飞花令,是中国古代酒令中的一种,属于"雅令"。所谓"令",就是行酒令的规则;所谓"雅",在于它比的不是酒量而是才学。飞花令起源于唐代,得名于唐代诗人韩翃《寒食》中的名句「春城无处不飞花」。
传统飞花令的行令规则相当精巧:令已出,第一位行令人说出含有"花"字的诗句,第二位则要说出含有"花"字的诗句且"花"字落在第二个字的位置上,第三位落在第三个字的位置上,依此类推。例如:
- 「花间一壶酒」——花字在首
- 「落花人独立」——花字在次
- 「人面桃花相映红」——花字居三
- 「沾衣欲湿杏花雨」——花字居四
- 「一日看尽长安花」——花字居五
一个人对不出,或者诗句用重了,便要受罚饮酒。后来《中国诗词大会》对这种规则做了简化改造:不再限制"花"字的位置,参与者轮流说出含关键字的诗句即可,比拼的是诗词储备量与临场反应。这种简化版传播甚广,也让飞花令从一种酒桌雅戏变成了大众都能参与的诗词游戏。
理解了规则后,我意识到这是一个非常适合 AI 来扮演的角色:模型海量的诗词语料储备,恰好对应"博闻强识"的行令者形象;而"包含关键字"“出处真实”"不可杜撰"的要求,又给模型划出了清晰的约束边界,非常适合用结构化输出(JSON)来约束。
三、项目目标与需求拆解
在设计实现之前,我先把需求整理成了一份清单。我的原则是:先想清楚"为什么做"“给谁做”“做成什么样”,再动键盘。
3.1 场景与用户
目标用户:诗词爱好者、学生、或者任何想体验"与 AI 吟诗作对"乐趣的普通网民。使用场景是网页端,移动端与桌面端都要有良好体验。
3.2 功能需求
- 飞花令核心玩法:用户输入一个字(花、月、风、春、酒、雪……)或直接说一句诗,AI 返回一句包含关键字的经典诗句。
- 结构化展示:AI 返回的数据不能再是一坨纯文本,而应该拆分为「对句」「出处篇名」「朝代」「作者」「完整诗联」「鉴赏」「回话」等字段,前端据此渲染出精美的诗词卡片。
- 流式输出:AI 的回答要像 ChatGPT 那样逐字出现,而不是等待全部生成完毕后一次性显示,交互更自然。
- 多轮对话:人机交替对诗,上下文连续,不能"答完就失忆"。
- 快捷入口:内置常用飞花令关键字推荐标签,一键开始。
- 可读性:包含关键字的诗句中,关键字要有高亮,让用户一眼看到"令"字在哪。
- 出错兜底:网络异常、模型返回格式不完整等情况要有友好的降级处理,不能白屏。
3.3 非功能需求
- 纯前端实现,零框架依赖,零构建步骤(尊重课程场景,一个 HTML 打开就能跑)
- 代码整洁、注释清晰、命名有语义
- 页面美学要过得去——古风、雅致,而不是默认浏览器样式
- 具备基本的健壮性:长文本、异常 JSON、超时等场景不崩溃
四、技术选型:为什么是纯前端
技术选型阶段我纠结了很久。最初的设想是用 Node.js + Express 写一个后端代理,前端再配一个框架。但仔细评估后发现几个问题:
- 部署成本:本课程项目以本地演示为主,搭建 Node 服务意味着用户必须先安装依赖、启动服务才能看到效果,门槛明显变高。
- 学习聚焦:本次课程考核的重点是大模型应用开发,不是服务端工程。把复杂度堆在前端,更能聚焦"AI 对话"这一核心主题。
- 接口能力足够:调研发现目标 API 网关支持 CORS(跨域资源共享),预检请求(OPTIONS)返回了明确的
Access-Control-Allow-Origin回显头。这意味着浏览器可以直接 fetch,根本不需要后端中转。 - 现代浏览器的流式能力:
fetch+ReadableStream+TextDecoder已经足够成熟,完全可以在浏览器端逐行解析 SSE(Server-Sent Events)流。
所以我拍板:HTML5 + CSS3 + JavaScript(ES6+),零第三方依赖,零构建。这也是课程场景下"开箱即用"的最优解。
五、参考原型:一段 Python 流式调用代码
课程给了我们一段 Python 参考代码,这是整个 API 调用的"标准答案":
API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer <你的API Key>",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码麻雀虽小五脏俱全,它揭示了几个关键点:
- 这个接口与 OpenAI Chat Completions 协议兼容,请求体是
{model, messages, stream, ...}; - 开启
stream: true后,响应体是 SSE 格式的文本流,每行以data:开头,一行一个 JSON chunk; - 流的终止标志是
data: [DONE]; - 每个 chunk 里真正有用的内容是
choices[0].delta.content(本次回答的内容增量)。
我的任务,就是把这段"Python 标准答案",翻译成一门浏览器能听懂的语言——JavaScript。
六、核心改造:Python 到 JavaScript 的迁移之旅
这是本次开发最具工程含量的部分。我先列出两者在概念上的对应关系:
| Python(requests) | JavaScript(fetch) | 说明 |
|---|---|---|
requests.post(url, json=payload, stream=True) | fetch(apiUrl, { method, body: JSON.stringify(...) }) | 发起 POST 请求 |
response.iter_lines() | response.body.getReader() + 按 \n 切分 | 逐行读取响应流 |
line.startswith(b"data:") | line.startsWith("data:") | 过滤非数据行 |
json.loads(line[5:]) | JSON.parse(line.slice(5)) | 解析 JSON chunk |
data: [DONE] 结束 | 同一行判断 | 终止循环 |
生成器 yield | 回调函数 onDelta(content) | 边读边回调 |
6.1 流式读取的实现
Python 里 iter_lines() 已经帮我们把字节流按行切好了,JavaScript 则需要自己手动做行拆分。这里有一个容易踩的坑:流是按块(chunk)到达的,一块数据里可能包含半行,也可能包含多行。如果不做缓冲处理,直接把每块数据当成一行来解析,极大概率会解析失败。
我的解决方案是先维护一个字符串缓冲区 buffer,每次读取新数据后追加进去,然后循环用 indexOf("\n") 找到完整行并取出处理,剩余部分留在缓冲区等下一批数据到达。这一手"缓冲 + 按行切割"的处理,是所有流式应用中都会遇到的通用范式。
6.2 中文编码的处理
Python 的 decode("utf-8") 是作用于整个字节流的。在浏览器端,我使用 TextDecoder("utf-8") 并传入 { stream: true },这一行字虽然不起眼,却是中文内容不出乱码的关键:它让解码器知道"这段数据可能不完整,先把残留的多字节序列留着,等下一块数据来了再拼接"。如果不加 stream: true,遇到恰好被切在汉字中间的数据块,就会出现乱码。
6.3 请求体的逐字段迁移
Python 请求体中的每一个参数都一一对应地搬进了 JavaScript:
body: JSON.stringify({
  model: "deepseek-ai/DeepSeek-V4-Flash",
  messages: messages,
  stream: true,
  max_tokens: 2048,
  temperature: 0.6,
  top_p: 0.95,
  frequency_penalty: 0,
  thinking_budget: 2048
})
其中 temperature(0.6)控制创造性,top_p(0.95)控制采样范围,frequency_penalty(0)不惩罚重复用词——这些参数保证了对诗时有适度的文采但又不至于放飞自我。thinking_budget 给模型预留了思考预算,是的,这个模型是带"思考过程"的推理模型,这为后面的"思考过程展示"埋下了伏笔。
6.4 auth 与 Header
Authorization: Bearer <token> 在两种语言里写法略有差异但没有本质区别。这里我想特别强调一个安全细节:纯前端项目无法真正保护 API Key,浏览器开发者工具里任何人都能看到请求头和源码。因此我在 README 里明确标注"仅限学习与本地演示使用",并给出了生产环境加后端代理的建议。这是课程作业的合理边界,也是我对安全的清醒认知。
七、系统提示词:让 AI 吐出生计可用的 JSON
7.1 为什么必须用 JSON
直接让 AI 自由发挥,它会返回一大段散文式的文本:"月下独酌,李白之诗也,描绘了诗人花间独饮、邀月共影的情景……"这种内容在聊天框里能看,但无法排版:出处、作者、诗句夹在自然语言里,前端只能整块显示,遑论关键字高亮。
而诗词卡片这种 UI 形态,天然要求字段化的数据:
- 出处标题应该出现在卡片的顶部标题区;
- 朝代 · 作者应该在副标题位置;
- 诗句主体要居中,关键字要标红;
- 鉴赏要放在破折线下方的小字区。
唯一定能满足这种"数据结构需求"的方案,就是要求模型输出 JSON。
7.2 系统提示词的设计
我给模型设定了一个颇具文人气质的角色——「诗童」,一名博学儒雅、精通唐诗宋词元曲的古代文人。然后在提示词中明确规定了必须返回的 JSON 结构:
{
  "keyword": "花",
  "sentence": "花间一壶酒,独酌无相亲。",
  "title": "月下独酌四首·其一",
  "dynasty": "唐",
  "author": "李白",
  "poem": "花间一壶酒,独酌无相亲。举杯邀明月,对影成三人。",
  "explanation": "于花间独饮,邀月共影,尽显诗仙孤高洒脱之怀。",
  "reply": "花令既出,愿君续以明月之句,如何?"
}
字段虽然多,但每个字段都有明确分工:sentence 对句、title 篇名、dynasty 朝代、author 作者、poem 完整诗联、explanation 鉴赏、reply 与用户的互动语。为了让模型稳定输出,提示词里还写了几条铁律:
- 全部字段必填,没有内容则填空字符串;
- 实话实说:作者、出处、诗句务必真实准确,严禁杜撰;
- 格式唯一:必须只输出一个 JSON 对象,且被 ```````json ````代码块包裹;
- 角色扮演:语气文雅谦和,用文言白话相间的口吻互动。
这一"角色设定 + 字段约束 + 格式约束 + 真实约束"的四层提示词结构,是我在反复试错后总结出的模式,事实证明它对稳定结构化输出非常有效。
7.3 从代码块里抠出 JSON
一个现实问题是:即使要求模型"只输出 JSON",它仍然习惯用 Markdown 代码块包一层,有时候还会在前面加点铺垫。所以前端解析时不能天真地 JSON.parse(fullText),必须先从文本里提取出 JSON 片段。
我的实现思路是:优先匹配 json ... 的代码块结构;如果匹配不到,就尝试去掉首尾的代码块标记后直接解析;都不行就判定为"非 JSON 输出",走纯文本兜底渲染。这一步容错处理,让整个应用在面对模型"不听话"时依然不会白屏。
八、流式输出的落地:SSE 逐字渲染
8.1 SSE 协议速览
SSE(Server-Sent Events)虽然常被用于"服务器推送给客户端"的实时场景,但大模型接口通常是在 HTTP 响应体里用 SSE 格式(data: {json} 一行一个)来模拟流式生成。内容分片以增量形式到达,前端接一块、渲染一段,用户就能看到"打字机"效果。
8.2 逐字渲染的实现
在 streamChat() 函数里,每次收到一个 delta.content,我就把它追加到累计文本里并更新 DOM:
onDelta(content) {
  fullText += content;
  streamEl.textContent = fullText;   // 整个气泡重设为当前累计文本
  scrollToBottom();
}
虽然简单,但这里有个性能点值得说明:直接把 textContent 写成累计文本,虽然每次都重设了 DOM 文本(对文本节点而言浏览器会进行 diff 优化,代价很小),但因为我们的服务端是一段一段吐的,不会出现逐字符高频重排的卡顿。同时配合 CSS 的 .caret::after 伪元素光标动画,在文本流结束时移除,视觉上就有"正在书写"的错觉。
8.3 思考过程的展示
由于 thinking_budget 打开了思考预算,模型在输出正式回答前,会先输出一段 reasoning_content(内部思考过程)。这些思考内容虽然不适合作为主回答展示,但实时读取它们、在用户等待时作为"诗童正在推敲"的佐证,是一种不错的交互细节。我在回调里单独捕获了这段内容——它让我第一次直观感受到"模型在真正地思考诗人应该怎么接令",非常有意思。
九、前端交互与古风 UI 设计
9.1 页面信息架构
整个页面采用经典的单页聊天布局,自上而下分为四个区域:
- 页头区:项目名称「飞花令 · AI 对诗」+ 副标题,用菱形 ◆ 装饰线分割。
- 聊天区:所有人机对话气泡的滚动容器,AI 在左、用户在右,头像分别是「诗」与「君」的圆形印章。
- 快捷词区:一排可点击的关键字标签(🌸花 / 🌙月 / 🍃风 / 🌿春 / 🍶酒 / ❄雪),一键出令。
- 输入区:输入框 + 「吟诗」按钮 + 状态提示行。
9.2 古风视觉语言
为了让界面配得上"飞花令"这个主题,我在 CSS 上花了不少心思:
- 配色:以宣纸的米白为底(
#f7f0e1),朱砂红为强调色(#8c2f39),辅以金棕色点缀,整体温暖而克制; - 字体:中文字体栈
"Noto Serif SC", "Songti SC", "SimSun", serif,保证宋体感; - 装饰:头部与输入区上下呼应的菱形 ◆ 分隔符、印章式圆形头像、卡片左侧的金色竖线,都在强化"文房雅集"的氛围;
- 动效:气泡入场时的上浮渐显动画、输入框聚焦时的金色光晕、按钮的悬浮提拉与红色投影,交互反馈恰到好处;
- 响应式:通过
@media (max-width: 600px)压缩标题字号、气泡最大宽度与按钮内边距,手机上依然从容。
9.3 诗词卡片的渲染
这是整个 UI 的核心组件。前端拿到 JSON 后,按语义填充卡片:
reply→ 卡片顶部互动语title→ 加粗的篇名dynasty · author→ 朝代与作者poem→ 诗句主体,并对关键字做高亮explanation→ 破折线下方的鉴赏小字
关键字高亮我用了一段小巧的正则实现:把关键字做正则字符转义后,在诗句文本里全局替换成带 <span class="keyword"> 的高亮片段,配 CSS 的朱砂红加金色下划线,一眼就能看到"令"落在哪个字上。
9.4 多轮对话的上下文管理
为了支持连续对诗,我把对话历史维护在一个数组里:
conversationHistory.push({ role: "user", content: text });
conversationHistory.push({ role: "assistant", content: JSON.stringify(parsed.json) });
每次请求时把历史的 system + 历史 + 最新 user 一并发出,模型就能"记得"上一轮它对过什么。同时我还做了长度保护:历史超过 20 条时截断最早的内容,防止上下文无限膨胀导致请求体积过大。
十、遇到的问题与解决过程
没有哪段工程实践是一帆风顺的,这里记录几个我印象深刻的问题与解法。
10.1 模板字符串与反引号的血泪排障
初期我把系统提示词写进了 JavaScript 的反引号模板字符串里,提示词中恰好出现了 Markdown 代码块标记 ```````json ````。浏览器直接报 SyntaxError: Unexpected identifier,我当时对着 Locate 到的第 46 行愣住了——好家伙,三个连续的反引号直接把我模板字符串给"提前关闭"了。
解决方式非常朴素:在模板字符串内把反引号转义为 ```。这也让我深刻记住了:在模板字符串里写代码示例,务必留意反引号。
10.2 CORS 跨域:先预检,再运输
纯前端直连第三方 API 最大的不确定性就是 CORS。我在动手写代码前先用 curl -i -X OPTIONS 发了一个预检请求,确认响应头包含 Access-Control-Allow-Origin,才敢放心地在浏览器里直连。更严谨的做法是什么?——我在代码里为"请求失败且提示含 CORS"的场景准备了专门的错误提示文案,并把本地 HTTP 服务(而非 file:// 直开)作为推荐启动方式写进了 README。
10.3 AI "不听话"时的容错
即使提示词里三令五申,实测中模型偶尔还是会:输出带前导说明文字、代码块残缺、甚至整段都是思考内容。为此我的 renderPoemCard 有一整套降级链路:能提取 JSON 就渲染卡片;提取失败就回退纯文本显示;回复为空就显示"(空回复)"。绝不让用户看到半个报错弹窗和白屏。
10.4 历史消息的语义保持
还有一个细节:入历史时我保存的是 JSON.stringify(parsed.json),而不是原文。这样模型在下一轮能看到上一轮的"结构化卡片",语义更清晰,也避免了把 Markdown 代码块反复塞进上下文的浪费。
十一、端到端测试与验证
课程要求项目必须被验证过。除了在浏览器里手动点过很多轮之外,我做了两件更有说服力的验证:
11.1 用 Node 脚本做接口级验证
我写了一个临时 Node 测试脚本,完全复刻前端 fetch 之外的所有逻辑(构造请求、解析 SSE 行、提取 JSON),然后在终端直接跑通真实接口。结果是理想的——以「花」字为令,模型返回:
keyword : 花
sentence: 花间一壶酒,独酌无相亲。
title   : 月下独酌四首·其一
dynasty : 唐
author  : 李白
poem    : 花间一壶酒,独酌无相亲。举杯邀明月,对影成三人。
JSON 解析零错误。这证明:接口可用、参数正确、提示词约束生效。
11.2 用无头浏览器做页面级验证
我用 Playwright 的无头 Chromium 打开本地服务器上的页面,自动在输入框输入「请以『月』字为令,对诗一首」,点击发送,等待 .poem-card 出现,抓取卡片文本与消息气泡数量。测试结果显示:AI 成功返回了张九龄《望月怀远》的卡片,关键字"月"在诗句「海上生明月」中高亮渲染正确,页面控制台零报错。最后还截了一张全页截图,肉眼检查布局、配色、对齐均无异常。
这一趟下来,我确信项目不只是"能跑",而是"跑得不错"。
十二、项目成果展示
项目最终以纯前端形态交付,仓库结构如下:
ruanjian3banzlz/
├── index.html        # 页面入口
├── css/
│   └── style.css     # 古风样式
├── js/
│   └── app.js        # 核心逻辑(API 调用、流式解析、渲染)
└── README.md         # 完整使用说明与 JSON 格式文档
核心亮点总结:
- 零依赖、零构建:
python3 -m http.server起个服务,甚至双击index.html就能体验; - 教科书级的流式解析:缓冲按行切分 + TextDecoder 流式解码 + [DONE] 终止,完整复刻 Python 原型的行为;
- 结构化输出与降级:JSON 卡片渲染 + 纯文本兜底 + 空回复处理,三级容错;
- 文化产品感:飞花令规则融入角色扮演,古风 UI 用心打磨,不是套个默认样式交差;
- 可迁移的模式:四层提示词约束与"代码块抠 JSON"的思路,可以直接复用到任何要求结构化输出的 AI 应用里。
十三、不足与未来展望
项目虽已完成,但坦率地说,它也留下了不少可以继续打磨的空间:
- 传统飞花令的进阶规则:目前版本采用的是简化版(不限"花"字位置)。未来可以引入"字位置递增"的严格飞花令模式,让 AI 作为可校验的裁判。
- 诗句查重与去重:同一关键字下 AI 偶尔会重复同一句诗,可以维护一个"已用诗句集合"来强制避免。
- API Key 安全:如前所述,纯前端无法保护密钥。生产级改造应加一层 Node/Python 后端代理,将密钥移到服务端。
- 会话持久化:目前刷新页面即丢失对话,未来可接入 localStorage 或 IndexedDB。
- 更多玩法:对联、藏头诗、接龙、看图咏诗……飞花令只是"AI × 诗词"的起点。
这些不足让我意识到:一个"能跑"的项目只是及格线,一个"有设计、可演进"的项目才谈得上优秀。好在持续迭代的空间还很大。
十四、写在最后:关于「码道」
古人云:"行路难,行路难,多歧路,今安在?"代码之路亦复如是——报错、踩坑、查文档、再换一个思路重来,是我这两个月的常态。但这条自嘲为「码道」的路上,我收获的远比一行行代码更多:我学会了用文化视角去设计产品,理解了 API 协议背后的工程哲学,亲历了流式协议从字节流到 UI 渲染的全链路,也第一次体会到"把一个想法打磨到能用"的踏实感。
「码道」二字,于我是双关:既是"码农行走之道"的自嘲,也是"代码亦有其道"的自勉。愿这篇博客记录的,不只是一个小项目的开发过程,更是一段关于兴趣、坚持与方法论的成长印记。
感谢你的阅读。如果你也对"用技术复兴古典文化"感兴趣,欢迎前往我的仓库 gcw_nIdpFtTL/ruanjian3banzlz 体验这把千年飞花令。临别之际,我以一句小令作结:
飞花逐月,诗酒趁年华;码道漫漫,上下而求索。
—— 软件三班 · 2026 年秋

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)