10个数据集143万段视频统一成一份契约,SolarWM世界模型开源数据引擎拆读
《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
本文要点
(1)SolarWM是港中深、NUS、NVIDIA、MSRA等机构2026年9月发布的交互式视频世界模型训练栈,数据到权重一并开源。
(2)数据侧把10个数据集约143万段视频收成一份逐帧样本契约,被拒的54.9万段也带着标注和原因一起发布,总量约25.85TB。
(3)来源处理与训练混合拆开,同一套三阶段配方在Wan2.2、LTX-2.5、MiniMax-H3上训出5B到33B四个模型,训练序列只有5秒。
(4)短板在评测,论文没有定量指标,长时程效果全靠图说话,14B和LTX版后两个阶段权重也还没放。
(5)文末附官方5B文档里的单卡推理命令。
2026年9月,港中深、NUS、HKUST、NVIDIA、MSRA、UCLA等机构把SolarWM论文挂上arXiv。仓库记录9月3日放出代码、数据和5B权重。我把论文和仓库文档对了一遍,决定把篇幅留给它的数据引擎。
给一张起始图、一段场景描述和一条相机轨迹,模型按相机走向往后生成画面。SolarWM把这条路公开了,143万段视频,约25.85TB。仓库README有时写成14个数据集,论文口径是10个源数据集、14个可独立筛选的数据主人。
世界模型为什么一直难复现
Genie 3、Matrix-Game、LingBot-World、Yume过去两年名字很多。论文按官方仓库核对到2026年8月18日,共19个系统。
| 系统 | 权重 | 推理代码 | 训练代码 | 处理后数据 | 完整记录 | 可执行管线 | 精确配方 | 多骨干 |
|---|---|---|---|---|---|---|---|---|
| Genie 3 | 无 | 无 | 无 | 无 | 无 | 无 | 无 | 无 |
| Matrix-Game 3.5 | 有 | 有 | 无 | 无 | 无 | 无 | 无 | 无 |
| Yume | 有 | 有 | 有 | 无 | 无 | 部分 | 部分 | 无 |
| ABot-World-0 | 部分 | 有 | 无 | 有,2.74TB,30k段 | 部分 | 无 | 无 | 无 |
| SANA-WM | 部分 | 有 | 有 | 部分,235GB,1.6k段 | 部分 | 部分 | 部分 | 无 |
| HY-WorldPlay 1.5 | 部分 | 有 | 有 | 无 | 无 | 部分 | 部分 | 有,2种 |
| minWM | 有 | 有 | 有 | 部分,527GB,19k段 | 无 | 有 | 有 | 有,2种 |
| BiWM | 无 | 有 | 有 | 有,16.9GB,25k段 | 无 | 部分 | 部分 | 有,3种 |
| ForgeWM | 有 | 有 | 有 | 有,95GB,40k段 | 无 | 有 | 有 | 无 |
| SolarWM | 有 | 有 | 有 | 有,25.85TB,1426k段 | 有 | 有 | 有 | 有,4种 |
表摘自论文Table 1,原表19行我挑了10行。部分对应原表的缩减版或暂不可用,无对应原表的未找到。
权重和推理代码多数都给,训练代码给到一半,处理后的训练数据就很少。给了数据的几家里,公开体量最大的是ABot-World-0的2.74TB,SolarWM大约是它的九倍。
完整记录这一列只有SolarWM一家打了勾,指标注、分数、来源和选入或剔除的原因。别家代码在、数据也在,你仍不知道作者按什么规则挑的样本,复现对不上很正常。
各来源的时长、相机坐标约定、字幕风格都不一样,直接拼在一起训,混合之后模型会变差。各家视频生成器的潜空间和条件注入方式也不同,每个骨干单独写适配,骨干之间就没法比。
一份样本契约管住10个数据集
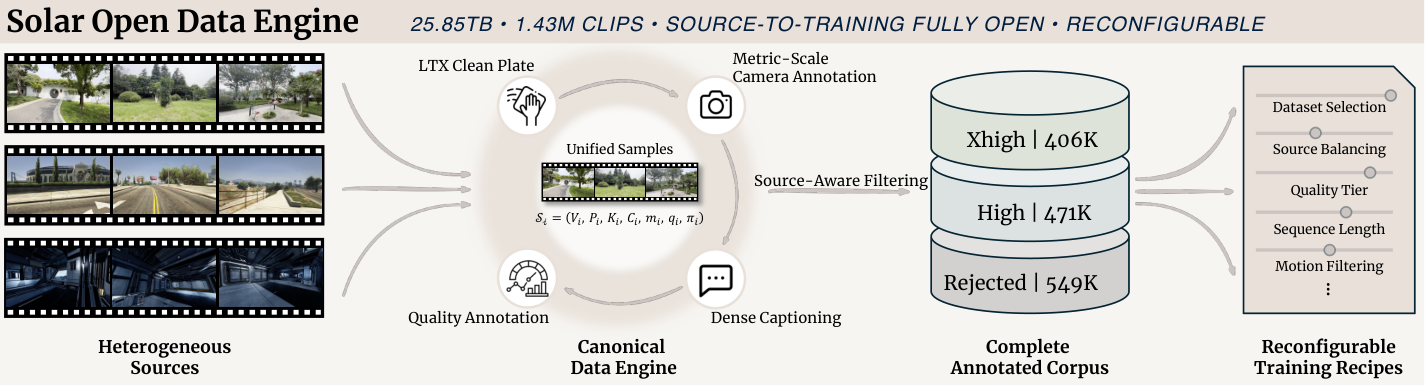
数据引擎的原则是先把每一段视频从每个来源全部处理和标注完,再谈训练时怎么挑。
10个源数据集是ABOT-World、DL3DV、MiraData、RealCam、SpatialVID、Sekai-Game、Sekai-Walking、MIND、MultiCamVideo、OmniWorld。
DL3DV拆成10秒和60秒两个主人,MiraData、Sekai-Walking、SpatialVID另有三份抹掉人车的干净底板,加起来14个主人,筛选和加权互不影响。
每个样本写成同一个七元组,视频、逐帧度量尺度相机外参、逐帧内参、密集字幕、来源元数据、完整指标记录,最后是溯源信息。视频帧、位姿、内参必须共用同一套帧索引。
物理语料存视频和标注,逻辑配方存划分归属、质量档位、来源权重和重复因子,模型视图存某个骨干需要的窗口长度或预编码潜变量。改配方不用复制视频,换一个VAE也不会改动数据的选取。
相机、干净底板和字幕三道工序
相机标注沿用SANA-WM的做法。来源只有视频时,Pi3X估时间一致但尺度含糊的场景结构,MoGe-2给每帧度量深度锚点,两边融合后交给改过的VIPE SLAM后端,输出6自由度轨迹,内参逐帧独立优化。
有变焦的片段,一整段共用一个内参矩阵不够用。来源自带真值或COLMAP位姿的,保留原轨迹,Pi3X只负责把尺度对上,用Umeyama Sim(3) 拟合,只取残差最低的**80%**帧重新估计。
第二道工序针对动态物体。行人和车辆的运动既解释不成相机运动,也没法稳定控制。他们用LTX-2.3的Clean Plate IC-LoRA把人和车抹掉,保留场景布局和相机轨迹,输入1248×704,输出1280×720、16 fps。
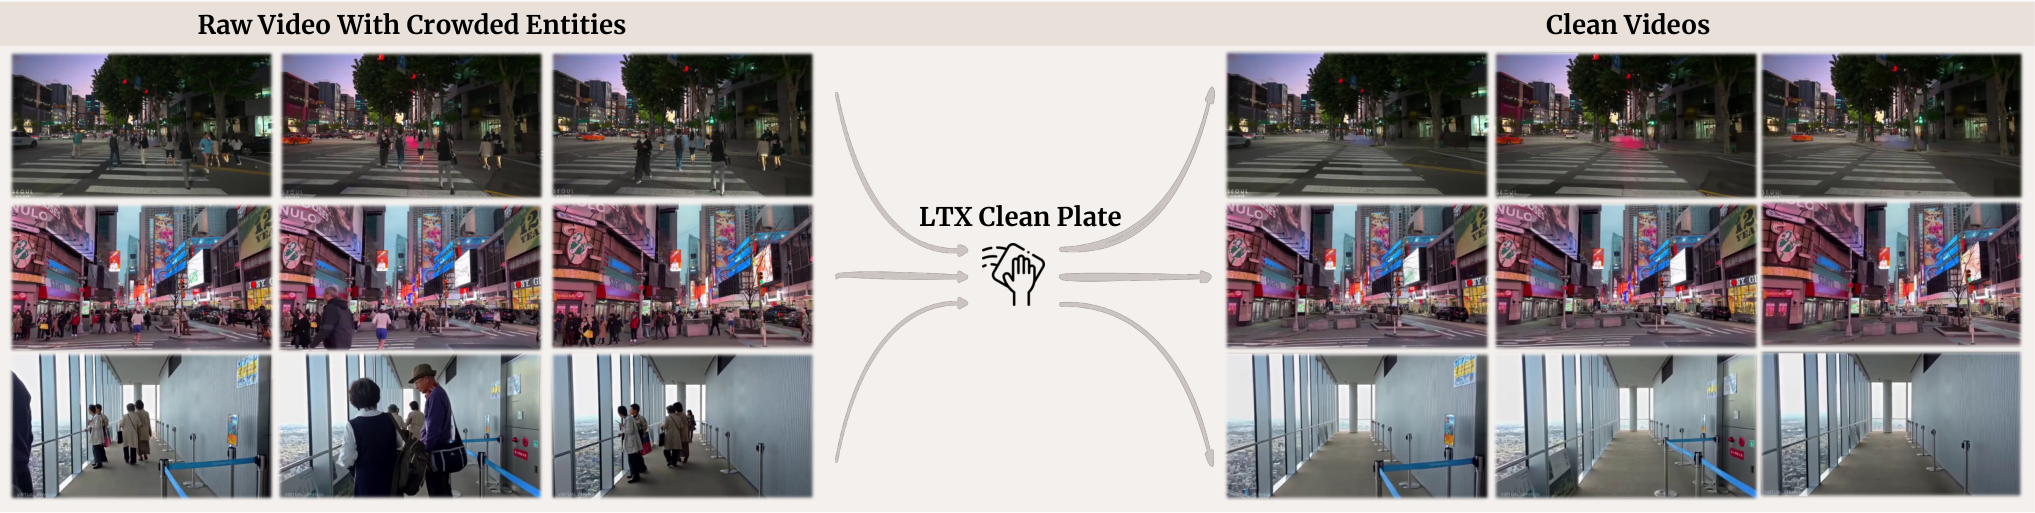
抹掉之后不默认继承原片的质量,字幕、视觉指标、相机诊断对每个输出窗口重新算一遍。这批干净片段共54.3万段,作为三个独立数据源存在,不悄悄替换原数据集。
第三道是字幕。全部143万段都过同一个Kimi-K2.6管线,每秒抽1帧最多64帧,输出60到150个英文单词,只描述建筑、地形、植被、光照这类持久环境。人、动物、动作、相机运动一律不写,防止文本条件把相机控制信息漏进去。
先全部标注,再按来源过滤
过滤规则每个数据源单独冻结一版,产出xhigh、high、rejected三个互斥标签。满足保留规则进high,同时满足更严的提升规则进xhigh,其余全部进rejected,并附上机器可读的失败原因。
规则刻意不对称。Sekai-Game是游戏录屏,高速运动多,他们不对它施加相机几何和饱和度门槛,只限制UniMatch运动量不超过350。MiraData则要求分辨率必须是1280×720,画质分4以上。
最终账目按14个主人逐行列出。1,425,694段视频里high档471,798段,xhigh档404,795段,rejected 549,101段。被拒的照样发布,带着拒收原因。图里xhigh写成406K,以这张表为准。
论文举了个配方例子。81帧短配方物理训练行600,320条,对ABOT、MiraData、Sekai-Game三个源施加6倍重复因子做来源平衡,每个epoch虚拟出现870,210次。重复只是索引里的数字,视频不复制。
一套三阶段配方跨三种骨干
训练分三个阶段。第一阶段在双向注意力下把预训练视频生成器适配到带相机条件的世界数据。相机控制通过fused-PRoPE注入,投影旋转直接作用在Q、K、V上,不加单独控制分支。
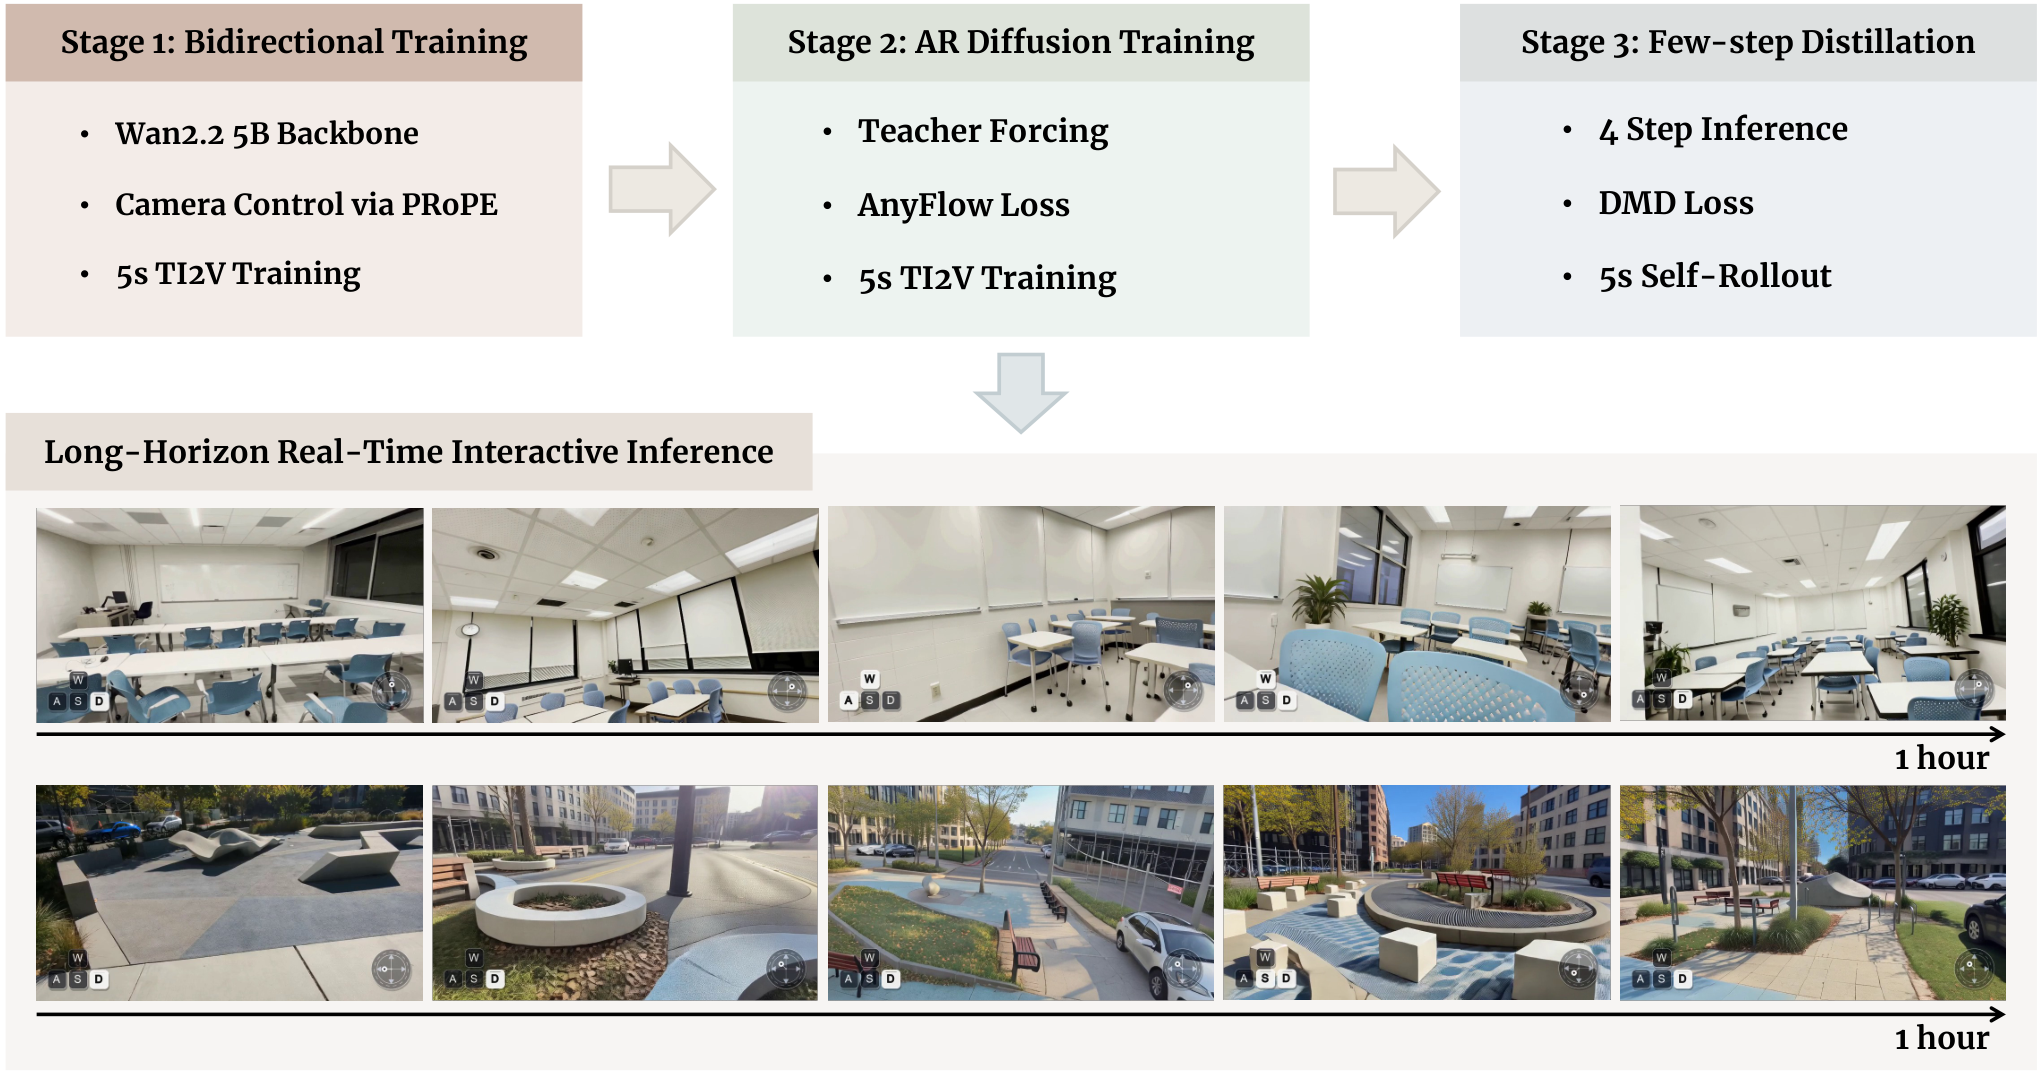
第二阶段切到因果注意力,预测当前块时只看干净的真值历史。AnyFlow损失监督任意噪声水平之间的流映射,得到少步自回归初始化器,省掉Causal Forcing系列里单独的ODE和CD初始化。
第三阶段用DMD。因果学生按推理规则自己推演,冻结的双向教师给目标分布,可训练的假分布模型跟着学生走,两者之差就是更新方向。论文写大部分优化量花在双向阶段,后两个阶段收敛很快。全部训练只用5秒序列。
四个模型的差异集中在骨干适配层。
| 模型 | 骨干 | 保留的部分 | VAE下采样,时间/空间 | 三阶段权重状态 |
|---|---|---|---|---|
| SolarWM-wan2.2-5B | Wan2.2 TI2V-5B | 完整5B,原生TI2V潜空间 | 4× / 16× | 三阶段全部放出 |
| SolarWM-wan2.2-14B | Wan2.2 I2V-A14B | 只取高噪声专家,训成单一稠密模型 | 4× / 8× | 仅双向阶段 |
| SolarWM-ltx-2.5-22B | LTX-2.5 | 去掉3.69B音频流和2.58B音视频交叉注意力,保留14.74B视频路径 | 8× / 32× | 仅双向阶段 |
| SolarWM-minimax-h3-33B | MiniMax-H3 | 33B Omni Transformer全保留,音频行填静音、损失置零 | 17n+5映射到5n+2 / 16× | 三阶段全部放出 |
发布状态截至2026年9月13日的仓库README。LTX本来是音视频联合模型,他们直接砍掉音频部分。H3反过来,打包结构原样保留,音频行塞一段静音,损失设成零。
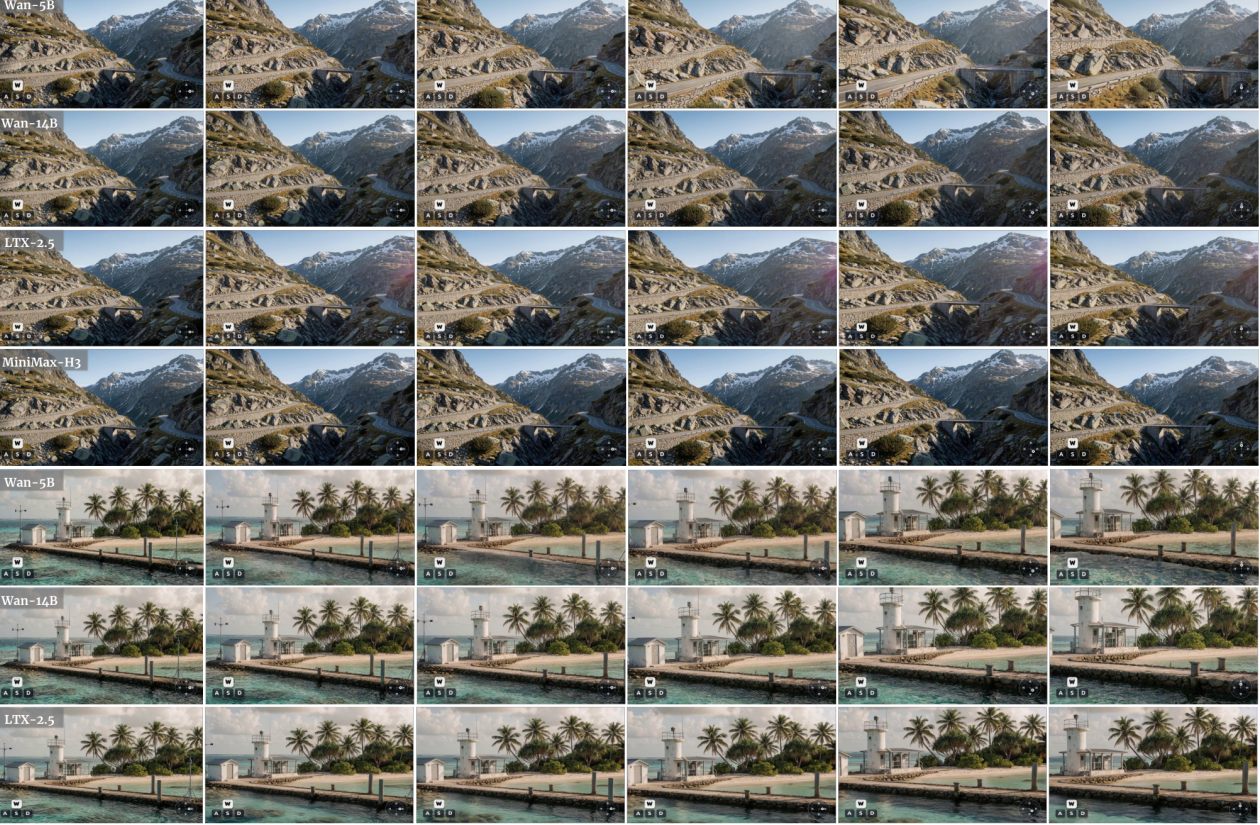
起始图由GPT Image 2或Krea生成。同数据同接口的四骨干横向对比,之前开源方案里没有。
5秒训练序列推演到60分钟
因果模型的推理设置是16 fps、4步采样、不用attention sink。每段从一张图起步,场景描述全程固定,相机轨迹是唯一随时间变化的外部控制。分钟级和小时级都是不间断连续推演,不重启、不注入参考帧。
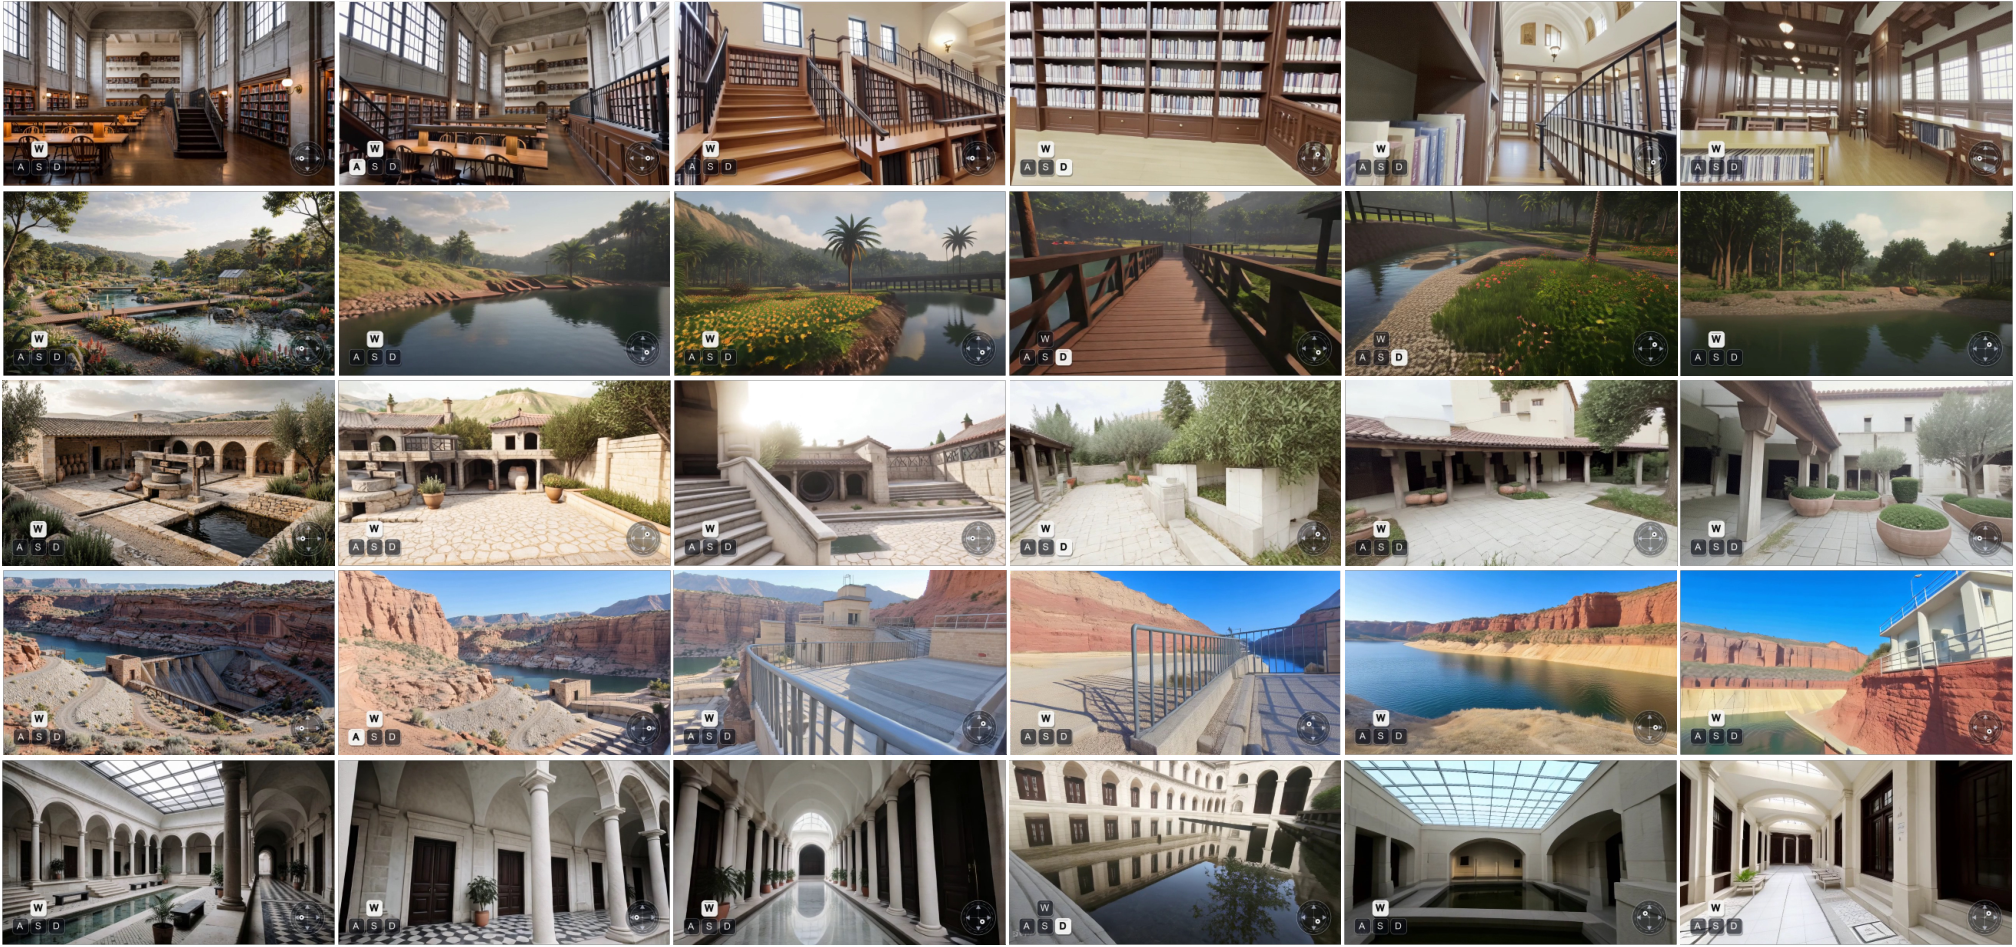
上图是5B版在合成起始图上的分钟级推演,相机轨迹混合了前进、转向、平移和停顿。论文写新露出来的楼梯、房间、植被和崖壁仍能跟起始画面对上。
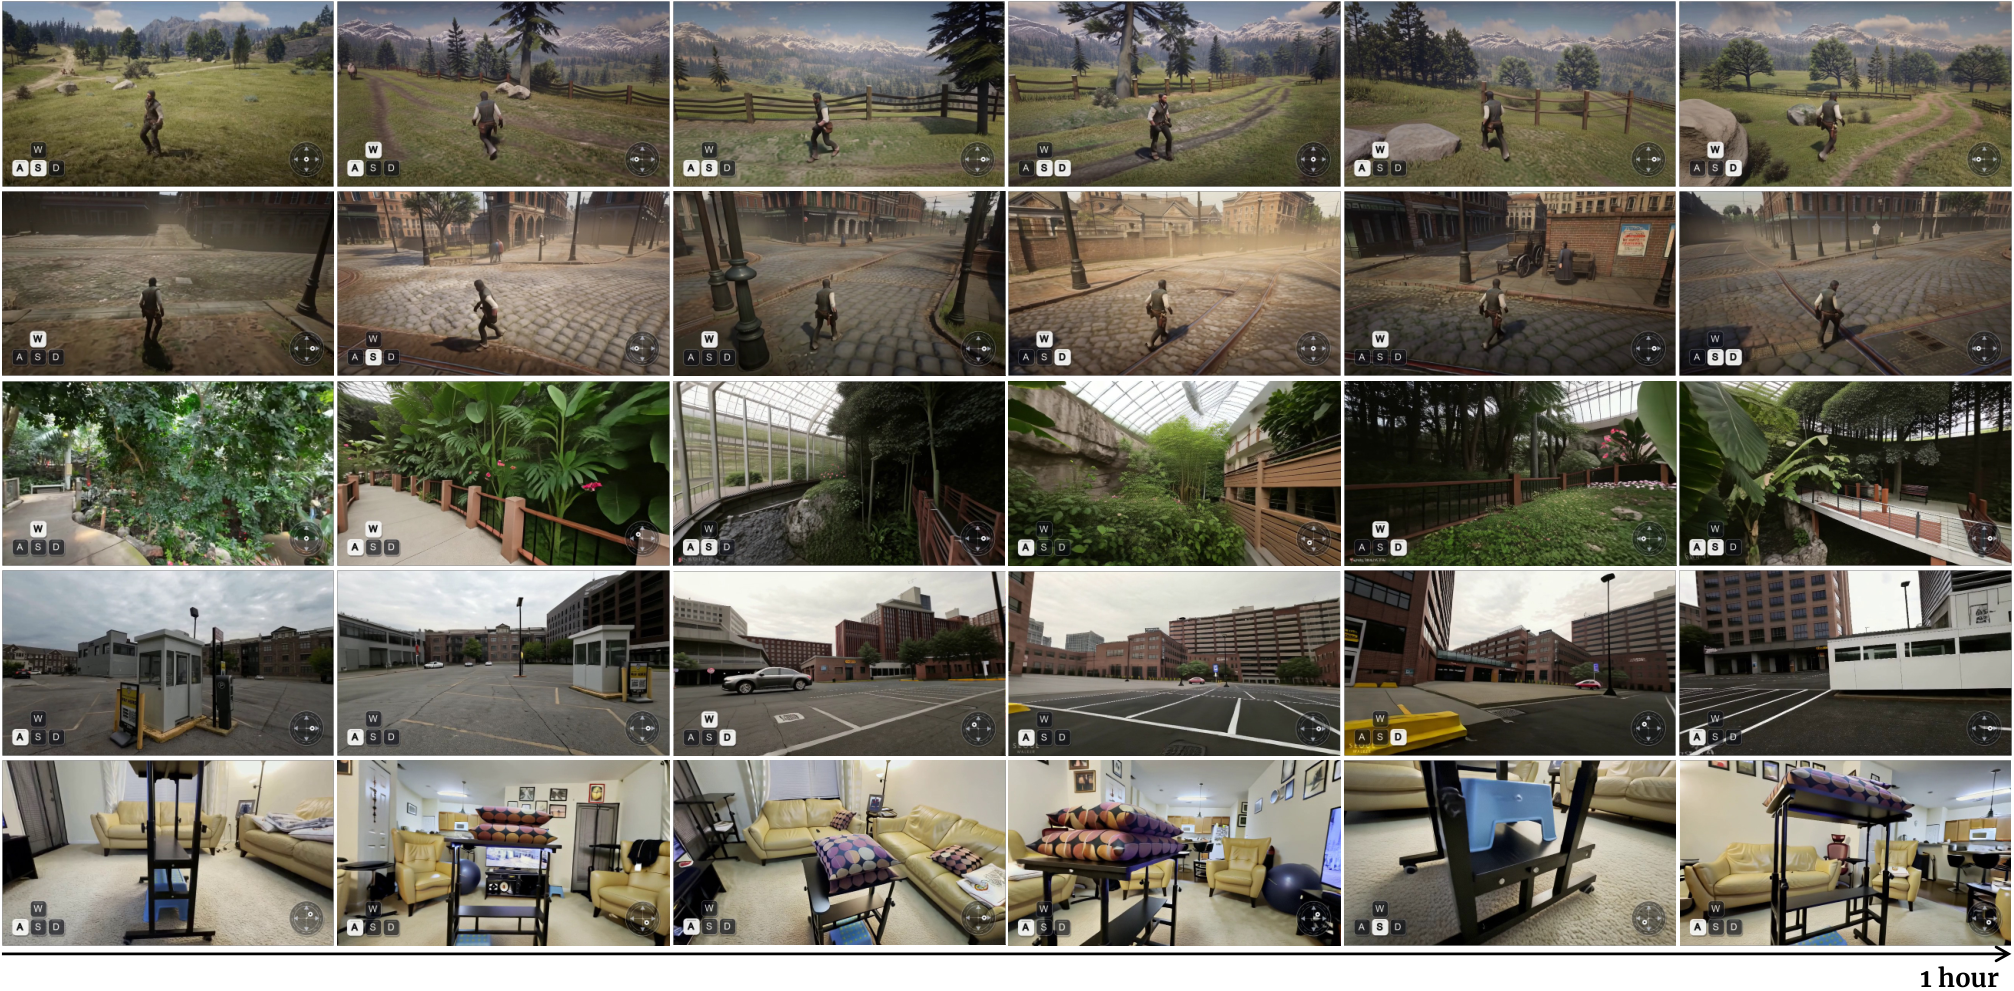
小时级起始帧来自验证池里的真实图片,每行抽样到60分钟终点。论文说终点画面仍能辨认且视觉上连贯。
FVD、相机轨迹误差、用户研究,论文全篇未报告,和其他世界模型的数字对比也未报告。所有效果判断都基于这几张图。我没有跑过模型,不替它下效果领先的结论。
本地跑一遍
下面命令抄自官方仓库docs/backends/wan22-ti2v-5b.md的5B第三阶段推理示例。权重在Hugging Face的junchaoh-cs/SolarWM-Wan2.2-5B,原始视频要填表申请。
export SOLAR_MODEL_ROOT=/path/to/SolarWM-models
export SOLAR_DATA_ROOT=/path/to/SolarWM-Data/releases-v1
export SOLAR_OUTPUT_ROOT=/path/to/outputs

# 先按 environments/README.md 激活 Wan 环境
python -m pip install -e .
hf download junchaoh-cs/SolarWM-Wan2.2-5B --local-dir "$SOLAR_MODEL_ROOT"

torchrun --standalone --nproc-per-node=1 -m solarwm infer \
  --config configs/examples/wan22_ti2v_5b/infer_stage2_sgf_camera_length.yaml \
  --set model.base_path="$SOLAR_MODEL_ROOT/SolarWM-5B-base" \
  --set checkpoint.path="$SOLAR_MODEL_ROOT/SolarWM-5B-sgf-stage2-81f" \
  --set data.index_root="$SOLAR_DATA_ROOT" \
  --set data.transport.root="$SOLAR_DATA_ROOT" \
  --set inference.run_id=my-camera-run \
  --set runtime.output_dir="$SOLAR_OUTPUT_ROOT/wan5-stage2-sgf-infer"
同一份文档写,第三阶段推理只要1张GPU,前两个阶段写的是8张。生成长度按测试样本的相机轨迹取最长,16 fps下一条960帧的轨迹对应240个潜变量、957个模型帧。三种骨干要三个独立运行环境。
几点看法
这篇最该看的是按来源写成可执行策略的过滤表,再把被拒数据连同原因一起发出来。别人才能指出哪条阈值定错了。以前的世界模型工作,数据挑选过程基本不公开。
物理语料、逻辑配方、模型视图三层分开,机器人或自动驾驶的多源训练也能用。
短板有三条。没有定量评测,读者没法判断它和Matrix-Game 3.5或LingBot-World谁更稳。原始视频要填表申请,14B和LTX版只放了双向阶段。
字幕不写人和动作,Clean Plate又把人和车抹掉,这套数据训出来的是相机控制下的静态场景漫游,想做有NPC的游戏世界得重新配。
许可证也要留意。LTX-2.5衍生权重受LTX-2.x社区许可约束,MiniMax H3社区许可有地域限制,不随代码的Apache 2.0走。
参考链接
- 论文原文 arXiv 2609.02886 v1,2026年9月
- 代码与文档 Junchao-cs/SolarWM,5B推理命令见 wan22-ti2v-5b.md
- 项目页 SolarWM-Web
- 数据 junchaoh-cs/SolarWM-Data、测试集 SolarWM-Data_test-set-v1
- 模型权重 SolarWM-Wan2.2-5B、SolarWM模型合集
- 骨干 Wan2.2、LTX-2、MiniMax-H3
- 对比方案 minWM、BiWM、SANA-WM、ForgeWM

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献10条内容

所有评论(0)