8B模型28项具身基准均分72.5,PhysBrain 1.5的动作token与未来状态token拆读
《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
目录
本文要点
(1)PhysBrain 1.5是深度机智2026年9月发布的具身基础模型,底座Qwen3-VL-8B-Instruct,一个模型同时输出语言回答、末端执行器动作和未来一秒的画面。
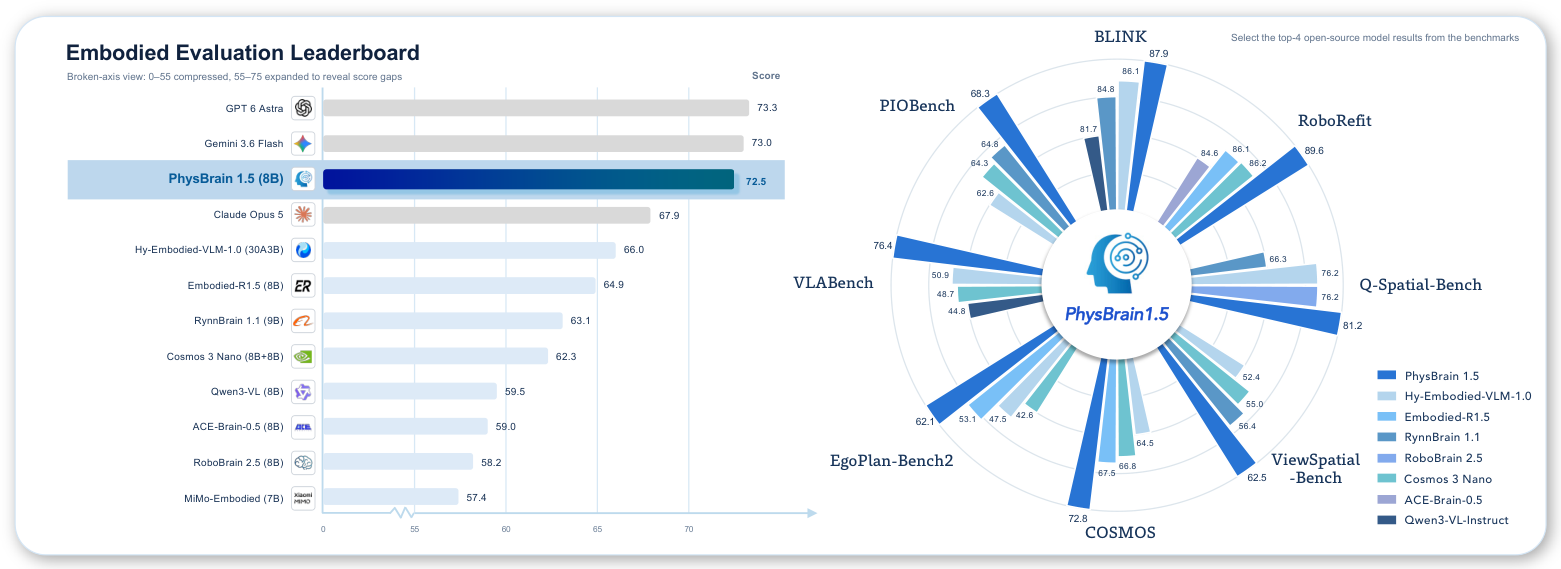
(2)28项具身理解基准均分72.5,开源模型里第一,比第二名腾讯Hy-Embodied-VLM-1.0高6.5分,和GPT 6 Astra的73.3差0.8分。
(3)做法上两点最值得看,用Human-as-Humanoid把人的手腕运动转成和机器人共用的ActionPiece动作token,以及把RGB、深度、机器人掩码交错成770个token一起生成。
(4)短板在多视角空间推理和指代定位,MMSI-Bench和RefSpatial-Bench两项都输给阿里RynnBrain 1.1,动作生成和未来预测只有定性结果,没有真机成功率。
(5)文末附评测工具PhysBrainEvalKit的用法和2B版的Transformers推理写法。
深度机智在2026年9月14日把PhysBrain 1.5的技术报告挂上arXiv,8B和2B两个尺寸的权重、评测工具和项目页也都放了出来。
我把HTML版报告、GitHub README和两张模型卡对着读了一遍,媒体报道基本在讲榜单,这篇想讲榜单后面那两件事,动作怎么变成token,未来画面怎么变成token。
榜单先摆在这里。28项具身理解基准均分72.5,开源模型里排第一,GPT 6 Astra是73.3,Gemini 3.6 Flash是73.0。截至9月15日,Hugging Face论文页有91个赞。
从VLM到物理基础模型,中间差什么
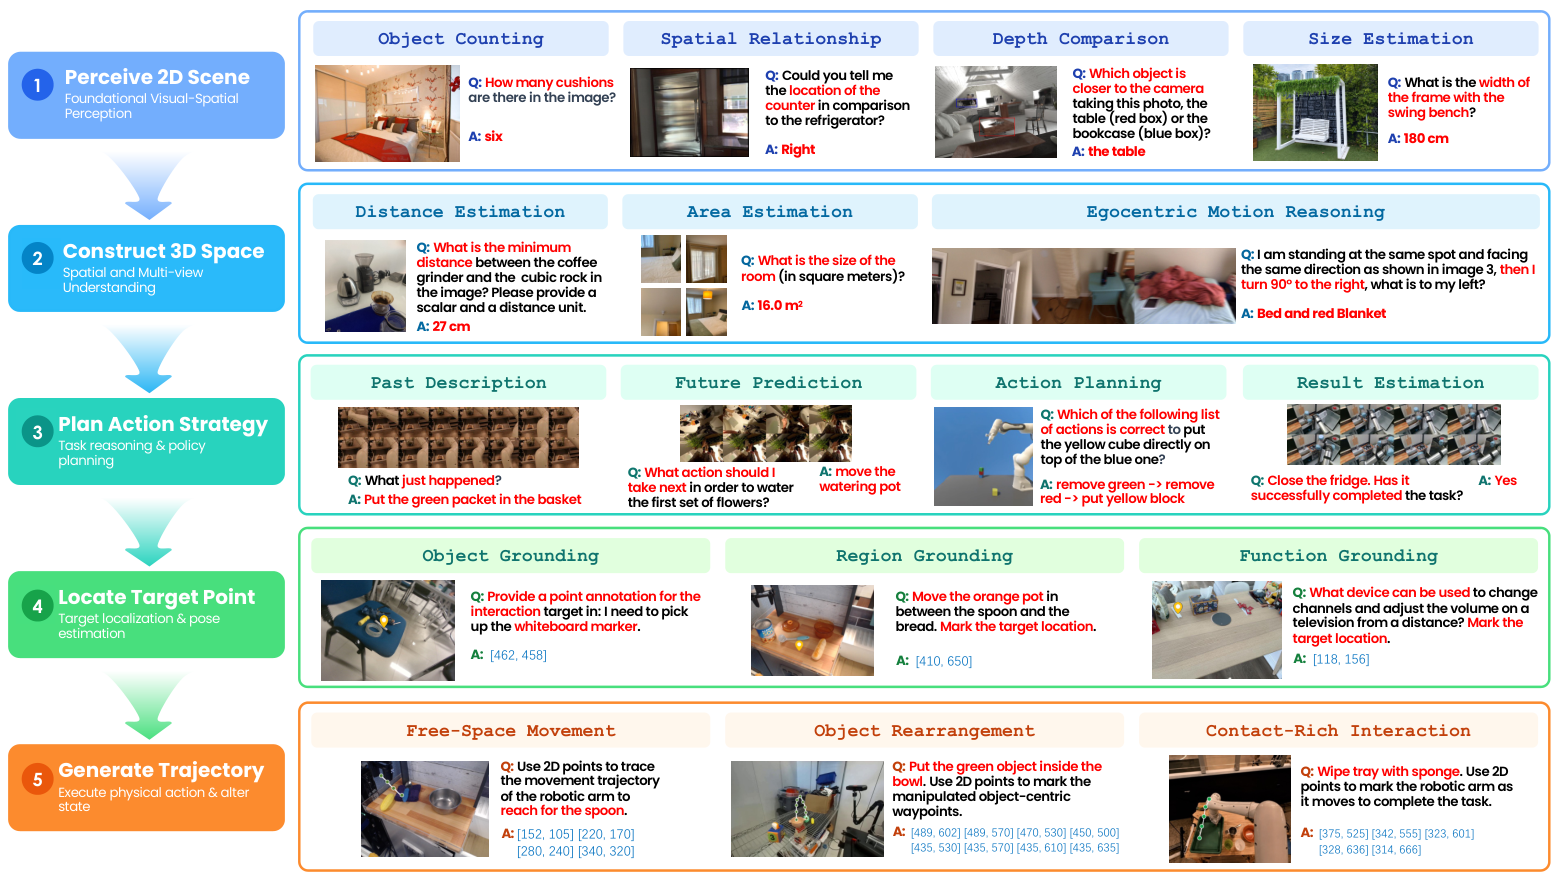
报告开头用一个「物理闭环」来定义问题。智能体观察环境,理解空间关系和任务目标,预判动作后果,然后动手,环境变了,新的观察再回到下一轮。一个物理基础模型应该在这个环里同时会理解、会行动、会预测。
现有模型大多只占其中一段。通用VLM管理解,VLA模型管动作,DreamZero、Qwen-RobotWorld这类世界模型管预测。
报告点名的几个国产具身大脑,腾讯Hy-Embodied、阿里达摩院RynnBrain 1.1、小米MiMo-Embodied,都在理解这一段上做加宽,输出仍然是语言和坐标。
难点在监督信号长得不一样。理解任务输出语言和坐标,动作生成要的是有时间结构的运动序列,未来状态预测要的是稠密图像。PhysBrain 1.5的答案是把三种输出全部变成离散token。
一张词表装三种token
模型从Qwen3-VL-Instruct 8B出发,把原来的语言词表扩成三块的并集,语言token、动作token、视觉token。三种输出共用同一个语言模型主干、同一张embedding表和同一个输出头,没有额外的动作头或图像头。
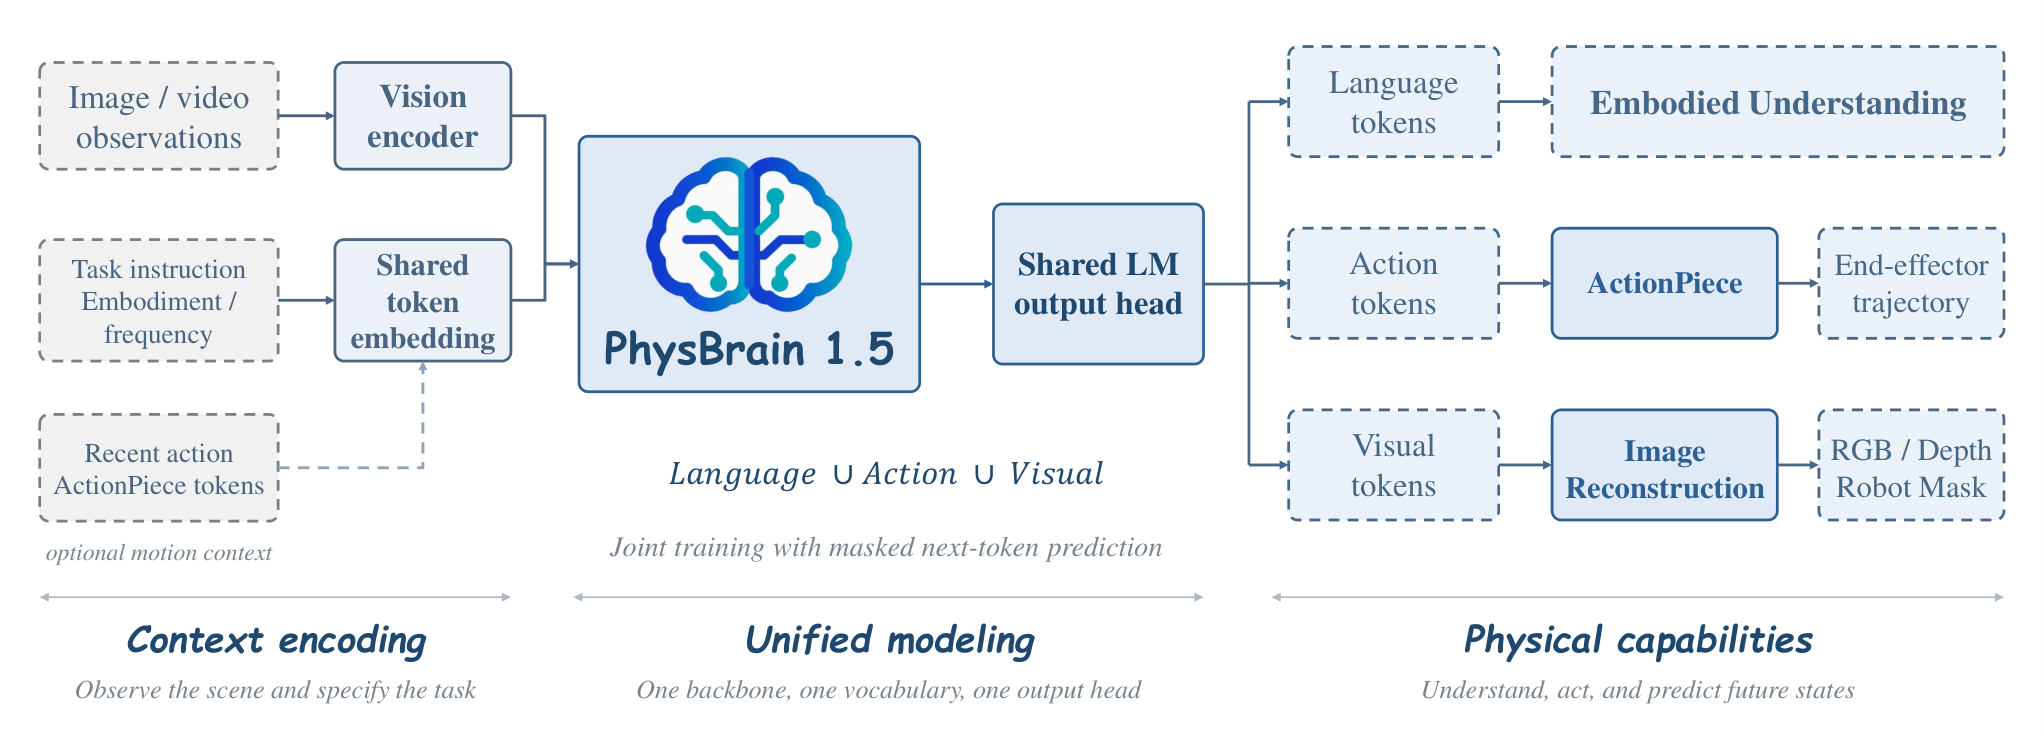
训练目标只有一个,带掩码的下一个token预测。任务格式和模态分隔符告诉模型这一轮该回答语言、生成动作还是生成画面,损失掩码选出该受监督的token,目标函数本身不变。
报告强调动机在监督互补。理解任务提供语义和空间关系,动作和状态转移的监督往主干里灌物理先验,反过来帮空间定位和轨迹推理。
Human-as-Humanoid,人的手腕怎样变成机器人的动作
预训练阶段的动作监督全部来自人类视频,没有一条机器人轨迹。人的手和机械臂长得不一样,报告用Human-as-Humanoid这条流水线把人体运动恢复出来,只保留双手腕的位置和朝向,手指运动全部丢掉。这样人和机器人就共用同一种动作表示,一段短的末端执行器轨迹。
每个手腕预测一个长度16步的动作块,全部相对当前观察时刻的手腕位姿计算。每一步是一个10维向量,前3维相对平移,中间6维用旋转矩阵前两列表示相对旋转,最后1维是夹爪开合度,0开1合。16步共用同一个锚点,不逐步累加。
连续轨迹再交给ActionPiece分词器切成离散token。这个分词器在2870万段16步轨迹上训练,对应4.592亿个动作时间步,词表512个token,一段手腕轨迹编成32个token,左手右手用同一套码本。
跨本体最麻烦的坐标系问题,报告选择不解决。不同数据集的机器人、相机和控制约定差别很大,有的源连标定信息都不全,硬统一到一个全局坐标系既贵又不可靠,所以每个来源保留自己原生的坐标轴。
代价是同一个动作维度在不同来源里方向、尺度、控制频率都可能不同。补救办法是把紧挨着当前观察之前的那个动作块也编成token喂进去,连同本体标识和动作频率一起作为条件。模型靠这段动作历史推断眼前这台机器的局部约定和运动趋势,把动作预测变成轨迹续写。
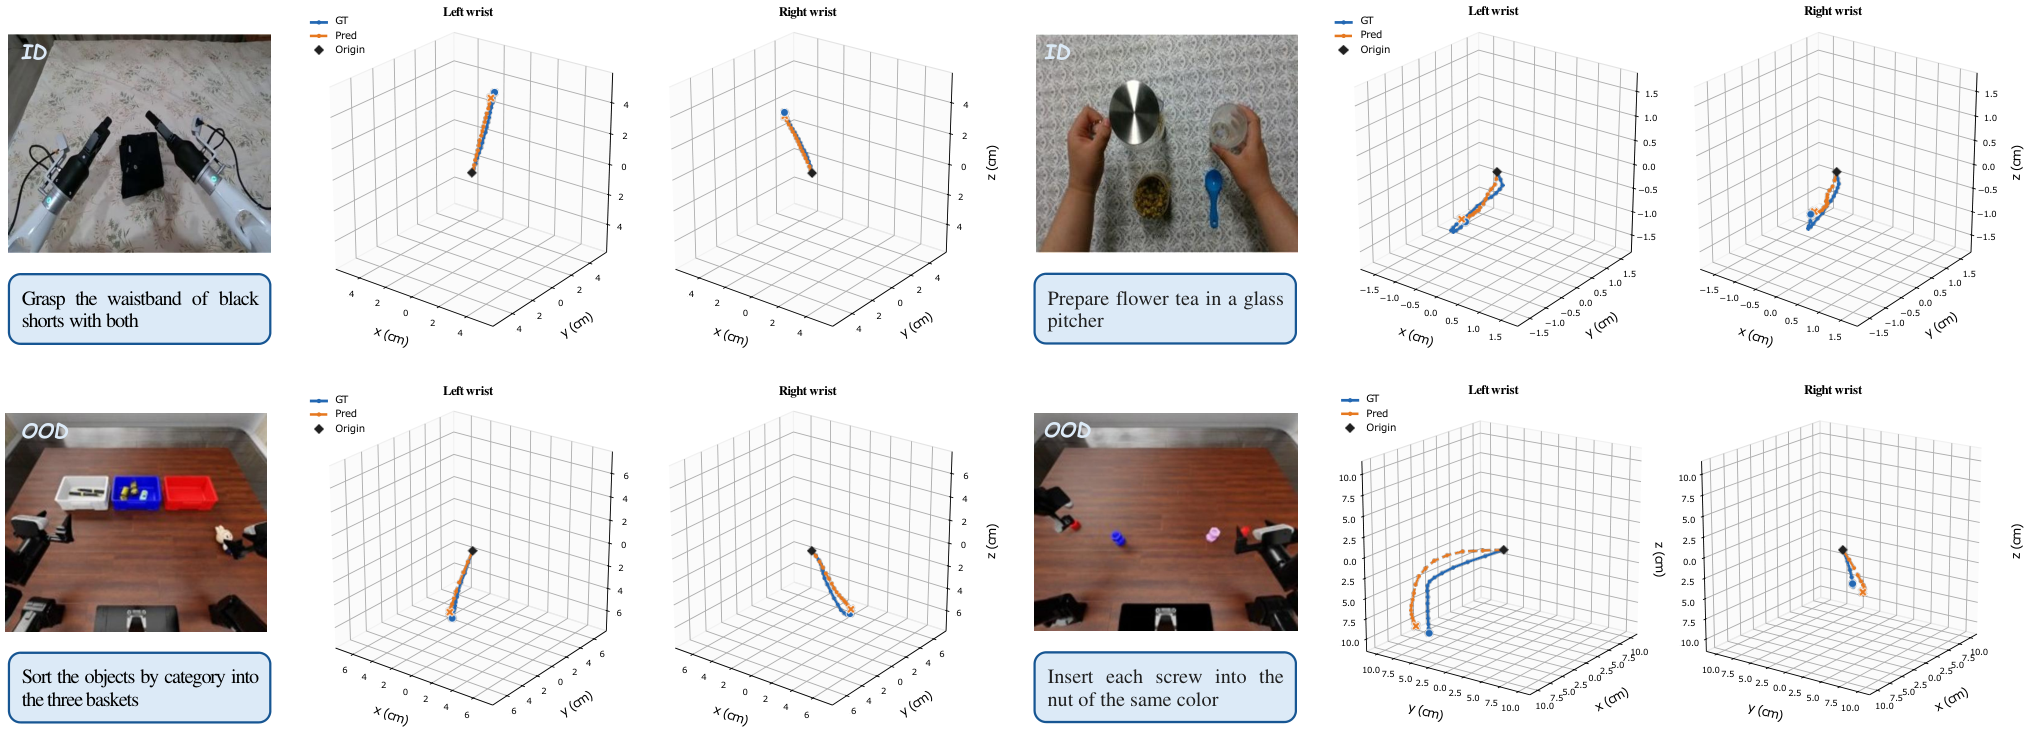
上图下排两例来自RoboDojo,这个数据源没进训练集。分拣和插螺丝两个任务里预测轨迹跟上了大体走向,位置偏差肉眼可见。附录里还给了一条曲线,预训练过程中动作token的困惑度在分布内测试集上从17.12降到5.07,在RoboDojo上从12.39降到6.57。
未来一秒的画面也当token生成
未来状态定义成同一时刻、同一图像坐标系下的三样东西,RGB图、深度图、机器人掩码。三者用同一个VQ-VAE在128乘128分辨率下离散化,码本大小16384,下采样8倍后每个模态得到16乘16共256个码。深度图和掩码先线性映射到 -1到1,复制成三通道再进分词器。
序列化的方式有讲究。三个模态在每个空间位置上按RGB、深度、掩码的顺序交错排列,加上首尾两个边界token,一共770个token。空间上相邻的东西在序列里也挨着,自回归生成时能互相参考。
生成阶段没有任何像素重建损失,也没有模态专用的预测头,全走语言模型那个输出头。推理时把770个token拆回三张16乘16的索引网格,用冻结的VQ解码器分别还原成图。
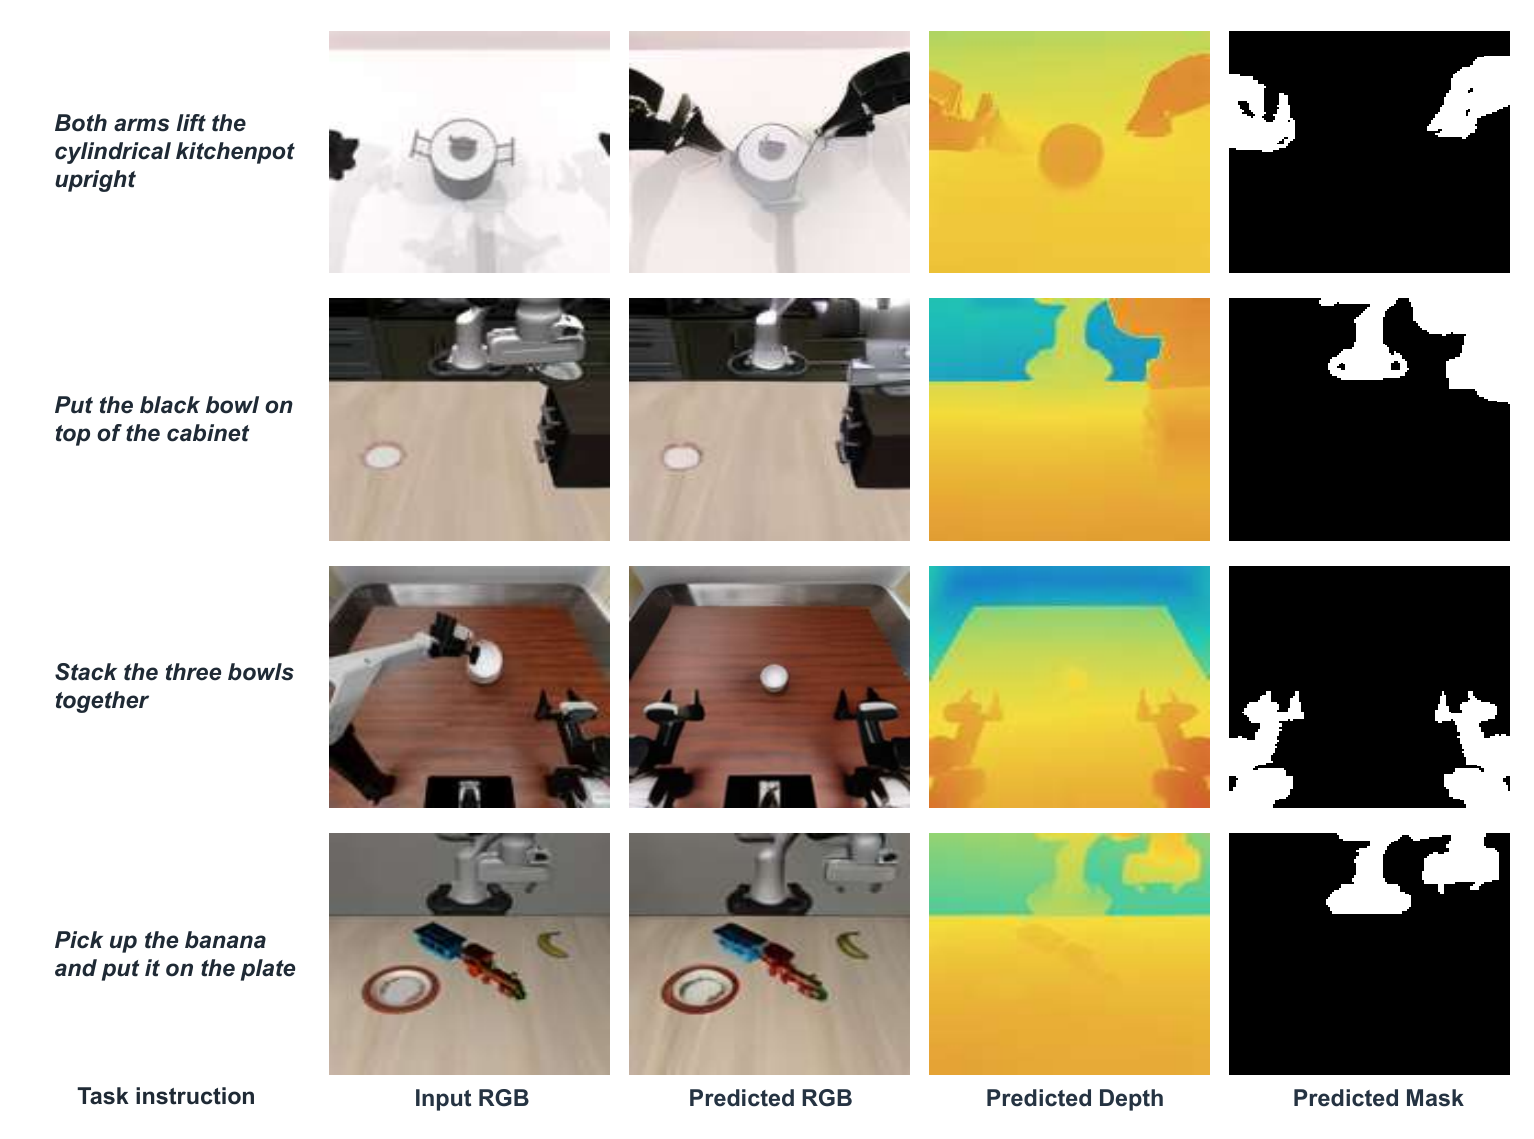
报告给的例子都是一秒的预测跨度。双臂抬锅那一例里,两条手臂朝锅移动,深度图和掩码上的手臂位置跟RGB是对得上的。这部分同样只有定性图,没有FVD或PSNR一类的数字。
数据,预训练全靠人的视频
预训练语料由人类交互视频拼成。公开的有Xperience-10M、Egocentric-10K、Ego4D、EgoVerse、EgoDex、EgoLife、Ego-Exo4D,自家的有PhysBrain-Human和PhysBrain-Ego360。
后者是全景视频,同步录了全身姿态、手部运动和执行任务时的语音。清洗后源语料约30000小时。
从这三万小时里造出三类监督。感知类2430万样本,从检测、深度、指点到跨视角对应,再加三层描述和物理问答。动作类3120万样本,来自Human-as-Humanoid恢复的手腕轨迹。未来状态类2680万样本,深度和人手臂掩码由感知模型生成。另有1490万通用指令数据防止语言能力退化。
SFT阶段才引入机器人。17个真机和仿真来源合计约2620小时,双臂平台987小时,单臂平台1339小时,仿真294小时,再挑了500小时高质量人类动作数据。深度用MoGe-2生成,机器人本体掩码用RoboEngine生成。
训练细节报告写得很干脆。ms-swift加Megatron-Core,两个阶段各训一个epoch,峰值学习率2e-5,序列长度32768开序列打包,全局批约2000个样本,bf16。
成绩单,先看表再看输给谁
先把几个要紧的数放在一起。均分是28项的等权平均。所有对手都由报告作者用统一指标重新跑过,和各家论文自报的数字可能不同。2B版的分数来自模型卡的表格图,报告正文的表里没有这一列。
| 模型 | 参数量 | 28项均分 | VLABench | Part-Affordance | MMSI-Bench | RefSpatial-Bench |
|---|---|---|---|---|---|---|
| PhysBrain 1.5 | 8B | 72.5 | 76.4 | 84.0 | 41.0 | 50.9 |
| PhysBrain 1.5 | 2B | 66.6 | 73.4 | 83.7 | 30.7 | 37.6 |
| Hy-Embodied-VLM-1.0 | 30B-A3B | 66.0 | 50.9 | 62.8 | 39.0 | 47.4 |
| Embodied-R1.5 | 8B | 64.9 | 40.9 | 83.4 | 30.1 | 55.2 |
| RynnBrain 1.1 | 9B | 63.1 | 42.4 | 40.5 | 46.0 | 63.2 |
| RoboBrain 2.5 | 8B | 58.2 | 37.6 | 24.7 | 29.4 | 59.9 |
| MiMo-Embodied | 7B | 57.4 | 39.9 | 61.9 | 31.8 | 40.0 |
| Qwen3-VL-Instruct | 8B | 59.5 | 44.8 | 56.4 | 30.8 | 43.6 |
| GPT 6 Astra | 未公开 | 73.3 | 66.3 | 55.0 | 57.9 | 78.0 |
| Gemini 3.6 Flash | 未公开 | 73.0 | 64.7 | 64.7 | 52.8 | 76.4 |
8B版在28项里14项开源第一,24项进前二,28项全部高于底座Qwen3-VL-Instruct 8B。
VLABench上76.4,比GPT 6 Astra高10分,Part-Affordance 84.0,闭源三家没有一个过80。这两类任务恰好最依赖动作先验,报告没做消融,我只能说方向一致。
输的地方也明白。MMSI-Bench多视角空间推理只有41.0,输给RynnBrain 1.1的46.0,离GPT 6 Astra的57.9差得更远。
RefSpatial-Bench指代定位50.9,RynnBrain 1.1是63.2,RoboBrain 2.5是59.9,PhysBrain在这项排开源第六。ERQA上52.8对GPT的75.8,差了23分。
通用能力有小幅回退。和底座相比MME从2392.70降到2330.07,MVBench从68.53降到66.07,V*反倒从83.77涨到87.96。整体算保住了。
2B版均分66.6,README明确写了只作参考不进排名。它超过30B总参数的Hy-Embodied-VLM-1.0,但MMSI-Bench掉到30.7,RefSpatial-Bench掉到37.6,多视角和指代这两块小模型掉得最厉害。
本地跑一遍
权重在Hugging Face上,8B版89亿参数,2B版21.6亿参数,config里的架构名就是Qwen3VLForConditionalGeneration。
模型卡没有给自己的推理代码,只说接口和Qwen3-VL一致,Transformers、vLLM、SGLang都能直接用。
下面这段是Qwen3-VL-2B-Instruct官方模型卡的Transformers示例,我只把模型名换成PhysBrain的2B仓库,图片换成本地文件。我没有跑过,显存和耗时不写。
pip install git+https://github.com/huggingface/transformers
from transformers import Qwen3VLForConditionalGeneration, AutoProcessor

model_id = "DeepCybo/PhysBrain1.5-2B"
model = Qwen3VLForConditionalGeneration.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
processor = AutoProcessor.from_pretrained(model_id)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "scene.jpg"},
            {"type": "text", "text": "Point to the handle of the mug."},
        ],
    }
]

inputs = processor.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

generated_ids = model.generate(**inputs, max_new_tokens=128)
trimmed = [out[len(inp):] for inp, out in zip(inputs.input_ids, generated_ids)]
print(processor.batch_decode(trimmed, skip_special_tokens=True)[0])
注意skip_special_tokens=True会把动作token和视觉token一起吃掉,这段代码只适合语言和坐标类输出。动作和未来画面的解码要靠ActionPiece和VQ解码器,模型卡和README都还没放出这两部分的推理代码。
复现榜单用官方的PhysBrainEvalKit,28个基准全部从Hugging Face自动下载。README建议先dry run看一眼计划。
bash scripts/eval_qwen3vl.sh \
  --model-path /path/to/PhysBrain1.5-2B \
  --model-name physbrain15-2b \
  --output-base /path/to/results \
  --gpus 0,1 \
  --models-per-gpu 2 \
  --cpu-per-worker 4 \
  --dry-run
去掉--dry-run就开始跑,第一次建议加--resume方便中断续跑。默认贪心解码,temperature=0.0,seed=3407,只有MMSI-Bench例外开采样。
README还提醒模型是在FlashAttention 4上训的,换FA2评测分数会有小幅波动。
几点看法
把动作和未来画面塞进语言词表这件事,PhysBrain 1.5做得最彻底的一点是不加任何专用头,连像素重建损失都不要。好处是训练和部署完全复用Qwen3-VL的基础设施。代价是一帧128乘128的未来状态要吐770个token,实时控制肯定不够用。
动作那条线最值得抄的是「不统一坐标系,用动作历史做系统辨识」。跨本体数据清洗最烧人力的就是标定和坐标对齐,报告承认这活干不动,转而让模型自己从前一个动作块里猜当前机器的约定。这个思路对任何想把十几个数据集揉在一起的团队都有参考价值。
预训练监督全部来自人类视频,机器人数据只在SFT出现,这个配比和RynnBrain 1.1、MiMo-Embodied这些只输出语言和坐标的理解型路线拉开了差别。三万小时人类视频比几千小时机器人数据便宜得多,Ego360这种自采全景数据能不能持续放出来,决定了别人能不能跟。
短板要说清楚。动作生成和未来预测目前只有定性图和困惑度曲线,没有一个真机任务成功率,报告自己也写明这些是离线轨迹预测,不代表闭环执行。
榜单上MMSI-Bench和RefSpatial-Bench两项输给RynnBrain 1.1,说明多视角推理和精细指代还没吃到动作先验的红利。「榜一」这个词,我建议留到真机数据出来再用。
参考链接
- 技术报告原文 arXiv 2609.14973 v1,2026年9月
- 代码与文档 DeepCybo-PhysAI/PhysBrain-1.5,项目页 PhysBrain 1.5
- 模型权重 DeepCybo/PhysBrain1.5-8B、DeepCybo/PhysBrain1.5-2B,HF合集
- 评测工具 DeepCybo-PhysAI/PhysBrainEvalKit,上游 EmbodiedEvalKit
- 前置工作 Human-as-Humanoid,arXiv 2606.32009、ActionPiece项目页、Ego360项目页、PhysBrain 1.0,arXiv 2605.15298
- 底座 Qwen3-VL-2B-Instruct模型卡,本文推理示例出处
- 对比方案 RynnBrain、MiMo-Embodied、RoboBrain

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)