Qwen-Image-Bench开源双榜第一,LLaDA-Image双扩散配方拆读
《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
本文要点
(1)LLaDA-Image是蚂蚁Inclusion AI在2026年9月发布的统一文生图和指令编辑模型,生成器从零训6B单流DiT,理解模块冻住LLaDA2.0-Mini。
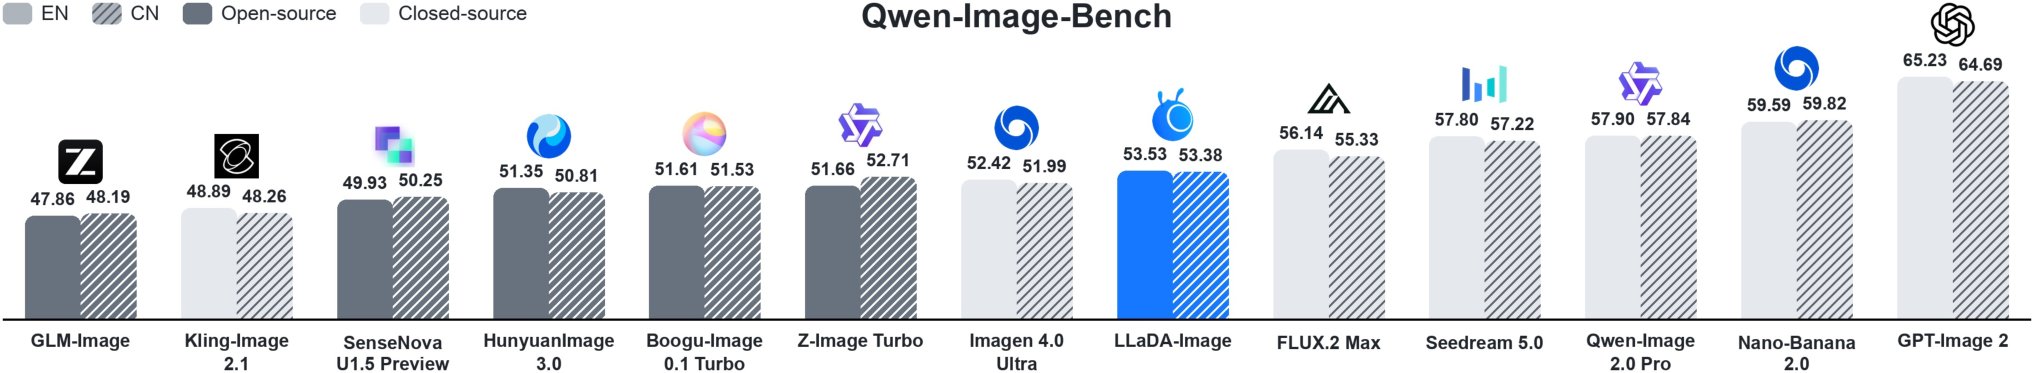
(2)Qwen-Image-Bench英文53.53、中文53.38,开源双榜第一,比第二名Z-Image Turbo高1.87和0.67。
(3)做法上先用纯图养视觉先验,再接图文条件和联合编辑,报告把过滤阈值、分阶段批量和学习率都写进配方表。
(4)短板在物体计数、真实世界保真度和编辑观感,蒸馏成Turbo后总分还会掉。
(5)文末附官方README的Diffusers推理示例。
蚂蚁Inclusion AI在2026年9月4日放出LLaDA-Image的权重和推理代码,技术报告挂在arXiv 2609.03796,署名AGI Research Center。
我一直在跟LLaDA这条扩散语言模型的线,上一篇写过它做GUI Agent。这次同一条理解模块接到了图像生成上。报告和GitHub README我对过一遍。
生成器是从零训的6B扩散Transformer。Qwen-Image-Bench英文53.53,中文53.38,开源双榜第一,比第二名Z-Image Turbo高1.87和0.67。闭源那边GPT-Image 2仍是65.23和64.69。
双扩散为什么能接到一起
扩散语言模型把整段输出盖上mask,再一轮轮揭开。扩散图像模型从噪声走回干净潜变量。两边都叫扩散,优化目标是两套。
语言这边用块扩散交叉熵。图像这边用flow matching,在干净潜变量和噪声之间走直线,模型预测速度场。
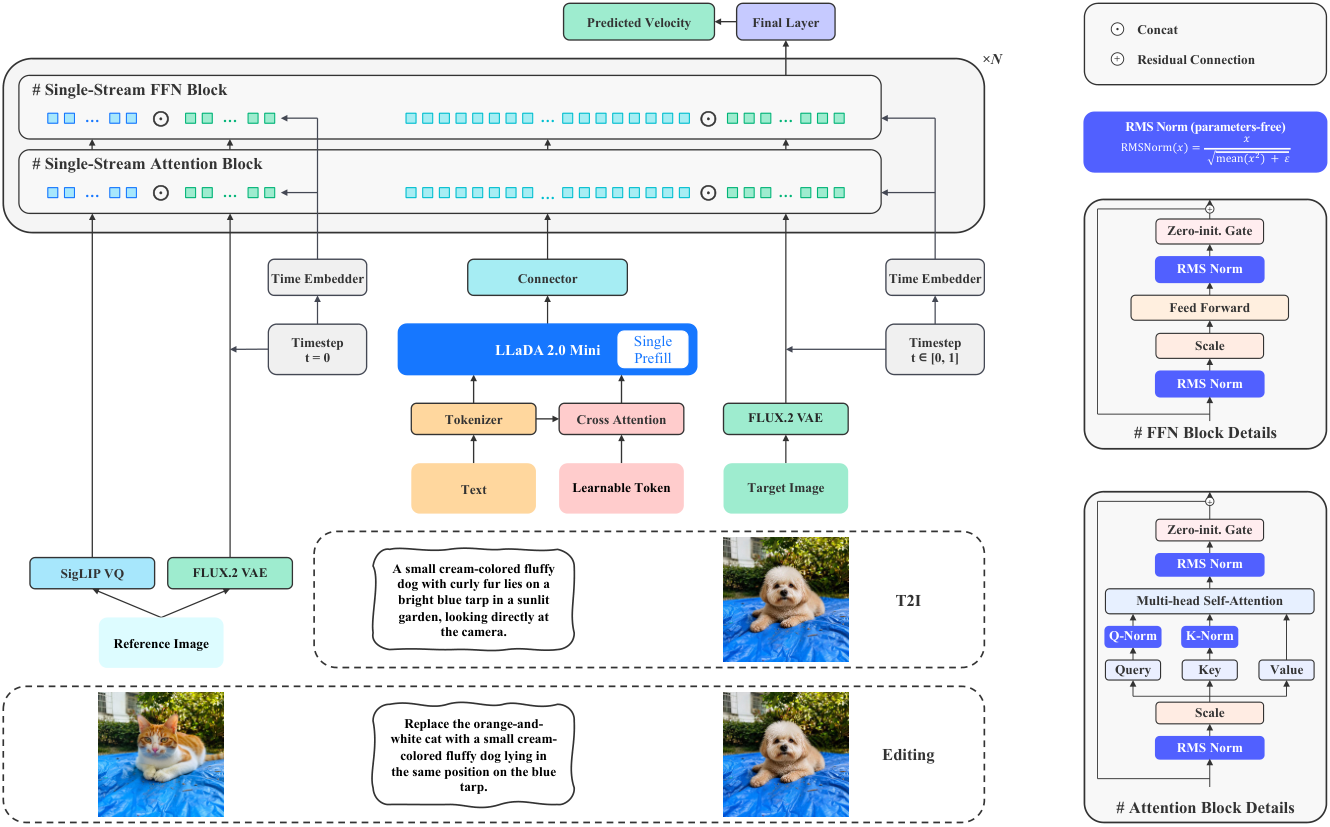
LLaDA-Image把这两套接到一个系统里。文本指令和编辑指令走冻住的LLaDA2.0-Mini,图像噪声走单流DiT。
条件和图像token拼成一条序列,每一层一起做自注意力。
中间有两个小模块。残差查询适配器先拿一组可学习的query对输入做交叉注意力,再拼回原序列。冻住的视觉语言模型走一次前向,吐出对生成有用的隐状态。
后面的浅Transformer连接器把这些隐状态投到DiT的条件空间。
编辑时参考图故意不进理解模块。SigLIP-VQ给出语义token,FLUX.2 VAE的干净潜变量拼在噪声潜变量旁边,给没被点名修改的区域留像素级证据。
改海报上两个单词,或者去掉一只包,都靠这条旁路保住其余画面。
纯图预训练也走同一条通路。条件从当前这张训练图里抽,图像token还要再盖掉一部分,DiT做稀疏到稠密的补全。条件和目标同源,256分辨率训练就不用把整张高清图压扁再去对caption。
别人通常不摊开的配方
报告自己标了四条Recipe。DiT里所有归一化换成无参数RMSNorm,优化器全程Muon。预训练阶段可以只用图。SFT阶段真实图占比一直高于70%。
合成图为主的配比早期榜单爬得快。真实图为主的配比他们写会慢一些,收敛后画面更像实拍。
生成训练合计220M条,其中**98%**是真实图,纯图样本超过九成。预训练和中训只用真实图。
过滤分三道。总像素大于1024²,每像素文件体积至少0.15字节。ArtiMuse低于60的丢掉,DeQA-Score低于4.0的丢掉。
过线的图用Qwen3.6-35B-A3B和Qwen3-VL-235B-A22B-Instruct写caption,再由Qwen3.6把幻觉、拒答、水印和隐私样本剔掉。
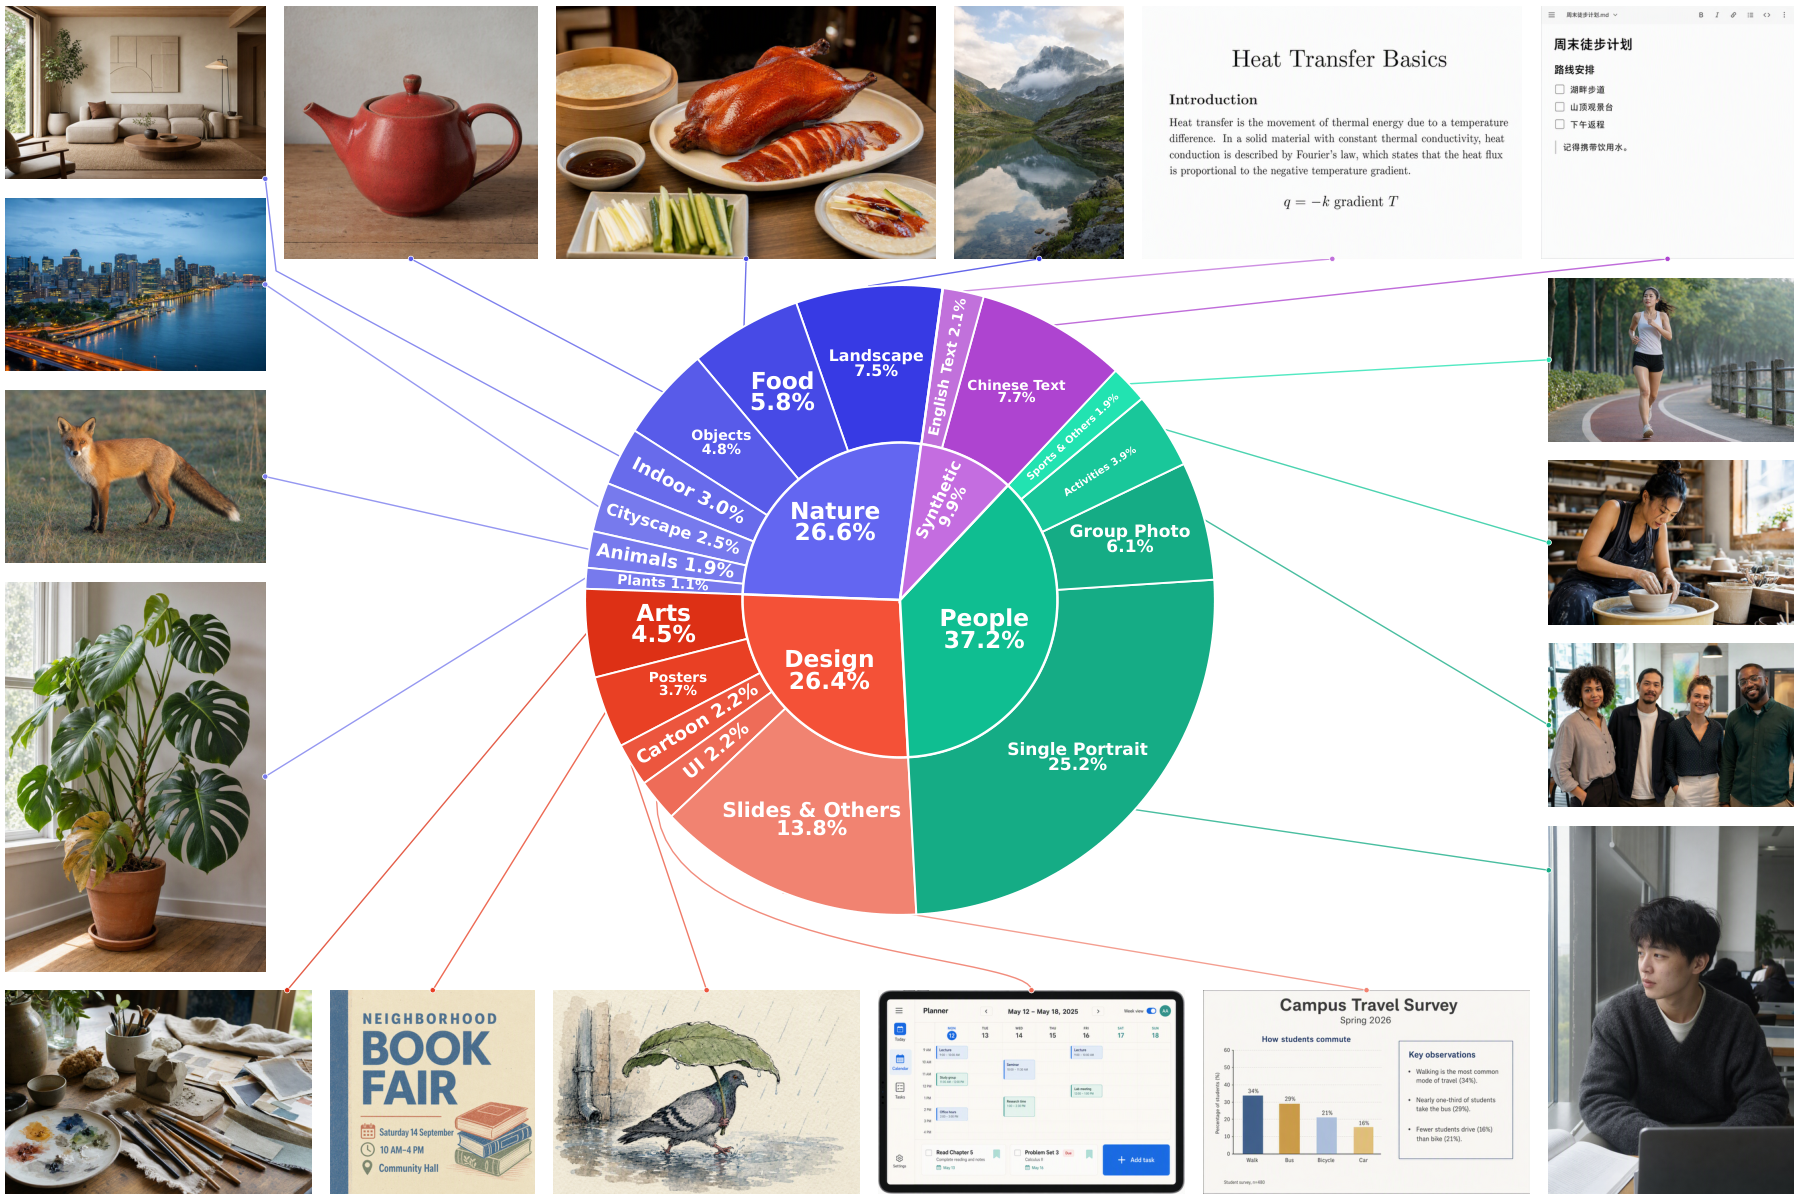
SFT加权后四大块,人物37.2%,自然26.6%,设计26.4%,合成9.8%。人物里单人肖像就占25.2%。合成那一块主要给中英文字渲染。
饼图是内容类型,不能直接读成真实和合成的比例。报告另写,SFT图文对里真实图始终高于70%。
理解模块只在思维链监督微调里更新一次。约260万条打包序列,长度16384,生成、理解、纯文本按9比9比2来混,训4个epoch。
MMBench英文从81.5升到86.1,RealWorldQA从66.7掉到64.1。冻住之前先做这步,各榜有升有降。
报告把生成各阶段的关键数字写成一张表,我按它摘在下面。
| 阶段 | 分辨率 | 监督 | 全局批量 | 学习率 |
|---|---|---|---|---|
| 纯图预训练 | 256² | 纯图 | 24576 | 4e-4 |
| 纯图中训 | 512²分桶 | 纯图 | 6400 | 2e-4 |
| 图文接上 | 512²分桶 | 图文对 | 4608 | 5e-5 |
| 升分辨率 | 1024²分桶 | 图文对 | 2048 | 5e-5 |
| 精炼 | 1024²分桶 | 加文字和人像 | 2880 | 3e-5 |
| 联合编辑 | 1024²分桶 | 文生图和编辑对半 | 2688 | 3e-5 |
| TwinFlow蒸馏 | 1024²分桶 | 文生图和编辑对半 | 256 | 5e-6 |
SFT的时间步用logit-normal,P_mean和P_std都是0.8,把更多优化预算砸在高噪声段。编辑阶段文生图和编辑对半采样,防止只练编辑把开放生成冲掉。
临近收敛的几个checkpoint再做权重平均。
最后TwinFlow蒸成Turbo,推理2到4步。假分数和生成器共用一个DiT骨架,用正负时间区分角色,更新次数按1比2。蒸馏后再用TBSM做强化学习微调。
GitHub README把这一步写成Twin-DMD,和论文里的TwinFlow是同一条蒸馏线。
论文摘要写了训练代码会公开。仓库Opensource Plan里这一项还空着。目前能拿到的是四份权重、推理代码和报告里的配方表。Base、Turbo各有一份BF16和一份FP8。
成绩单,挑几个要紧的数
Qwen-Image-Bench用1000条分层提示,评视觉质量、美学、提示跟随、真实世界保真度和创意生成,英汉分轨。GEdit-Bench有606个真实编辑用例。GenEval的计数项用来看组合能力有没有缺口。
| 模型 | 开源 | Qwen-Image-Bench英文 | Qwen-Image-Bench中文 | GEdit-Bench英文总分 | GenEval计数 |
|---|---|---|---|---|---|
| LLaDA-Image | 是 | 53.53 | 53.38 | 7.336 | 0.53 |
| LLaDA-Image Turbo | 是 | 50.98 | 50.27 | 7.024 | 0.42 |
| Z-Image Turbo | 是 | 51.66 | 52.71 | 未报告 | 0.77 |
| Qwen-Image 2512 | 是 | 51.32 | 52.06 | 未报告 | 0.57 |
| Qwen-Image-Edit 2511 | 是 | 未报告 | 未报告 | 7.877 | 未报告 |
| SenseNova U1.5 Preview | 是 | 49.93 | 50.25 | 8.172 | 0.85 |
| FireRed-Image-Edit | 未报告 | 未报告 | 未报告 | 7.943 | 未报告 |
| GPT-Image 2 | 否 | 65.23 | 64.69 | 未报告 | 未报告 |
开源文生图这条榜,LLaDA-Image总分第一。拆开看并不均匀。英文轨质量、美学、提示跟随、创意生成都是开源第一。真实世界保真度只有43.90,低于Qwen-Image 2512的47.80,也低于Boogu-Image 0.1 Turbo的46.52。
LongText-Bench英文0.923、中文0.913,双语差距小,仍低于Qwen-Image 2512的0.956和0.965。CVTG-2K平均词准确率0.875,排第二,SenseNova U1.5 Preview是0.887。
GenEval总分0.85,单物体1.00,双物体0.98,属性绑定0.84。计数只有0.53,Turbo更掉到0.42。这是组合能力上最清楚的缺口。
GEdit-Bench英文总分7.336,中文7.294。语义一致性英文8.043,观感质量只有7.182。
专门做编辑的FireRed-Image-Edit总分7.943。一个权重兼做生成和编辑,观感这一项还没追上专模。
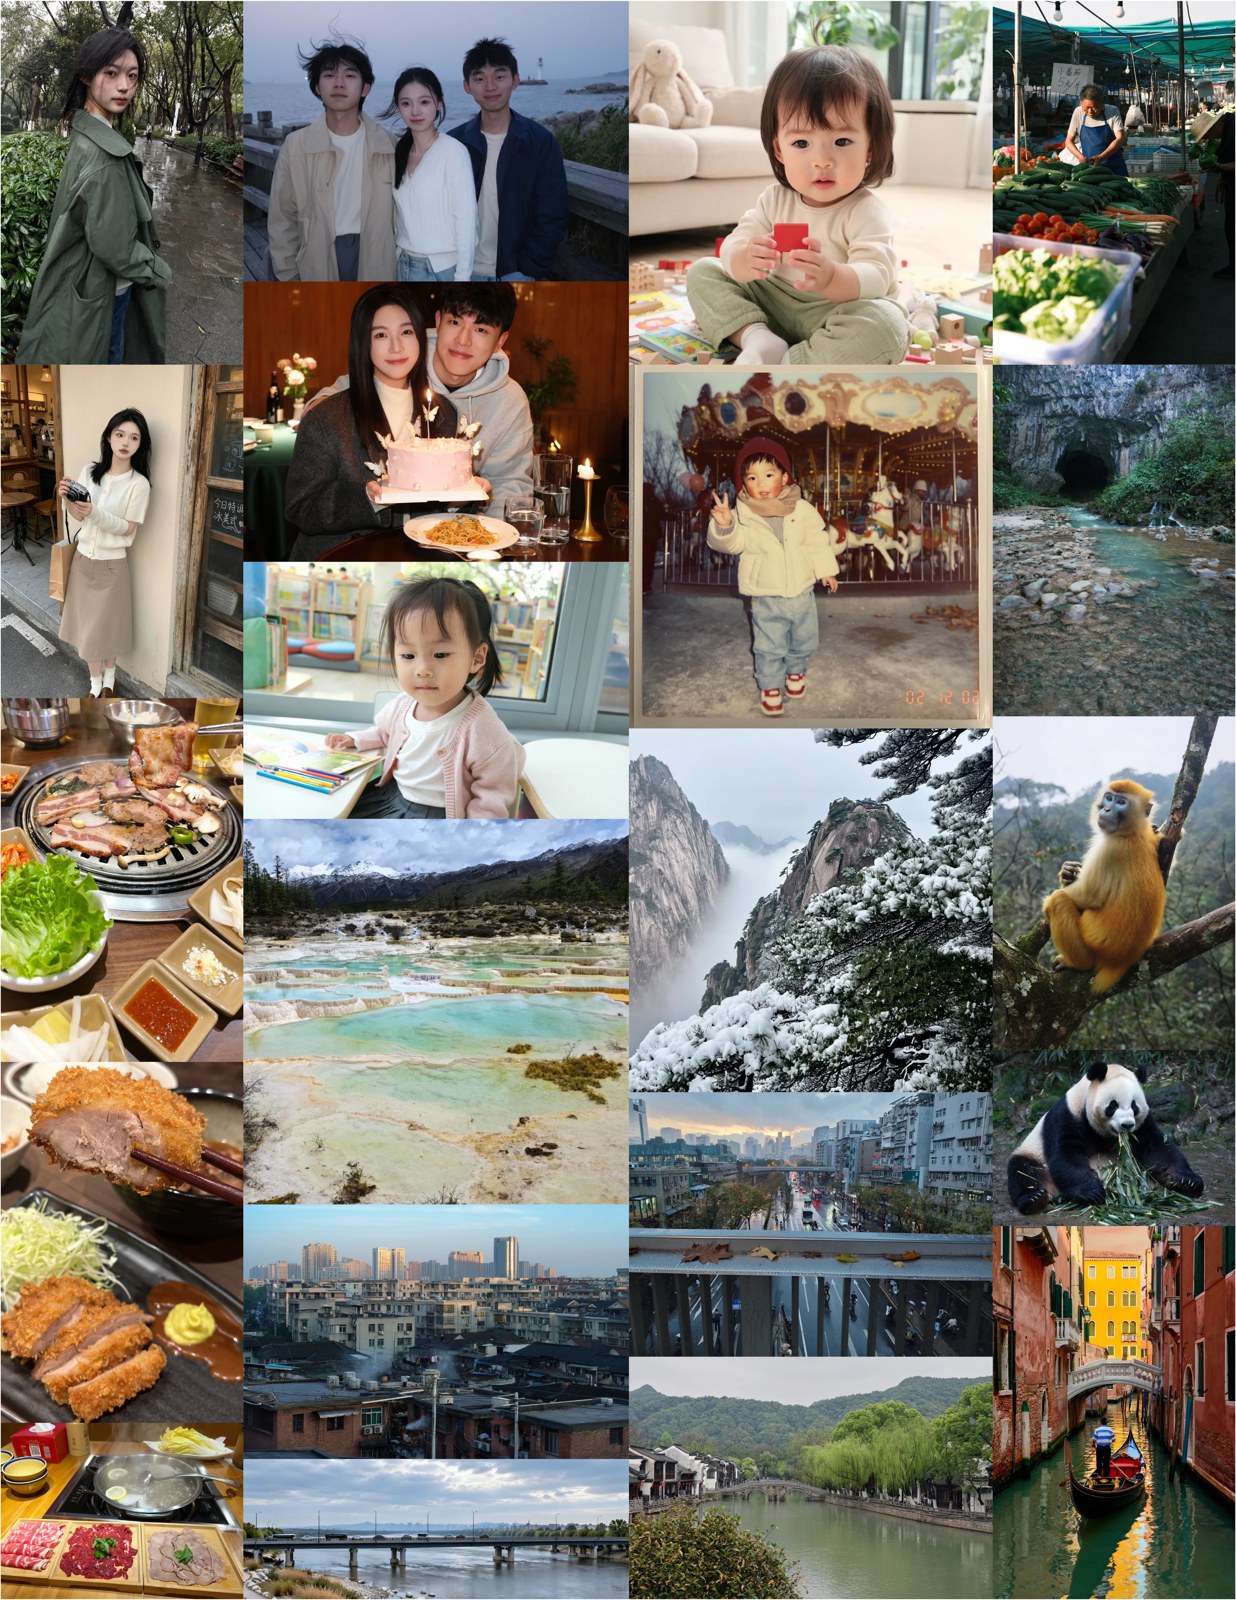
报告开头做了个读者挑战,让人从格子里挑真照片。下一页公布答案,一张都没有,全是LLaDA-Image生成的。这是定性展示,报告自己写了,不是受控的感知实验。
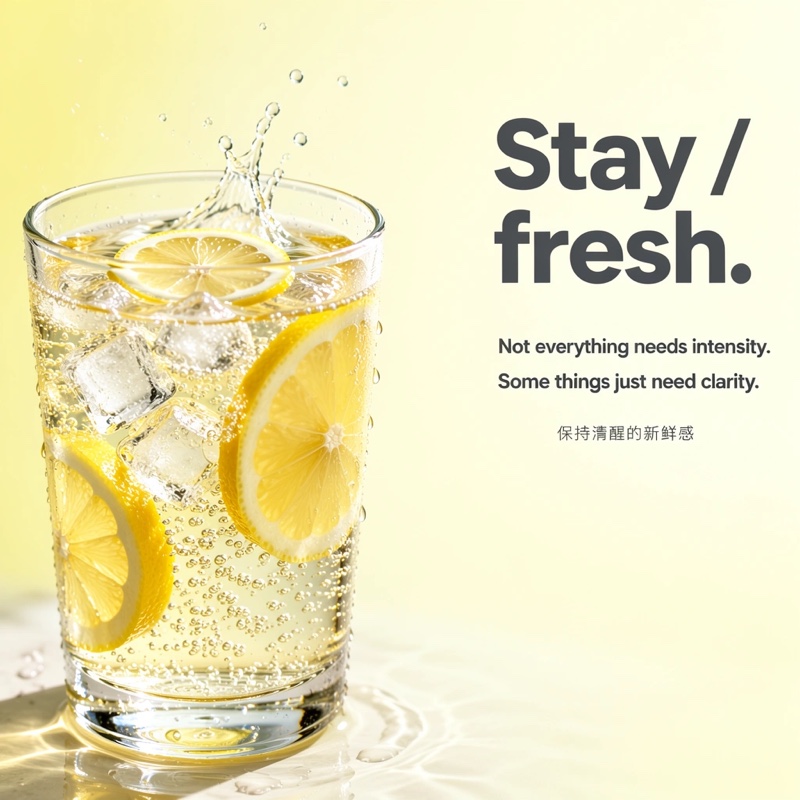
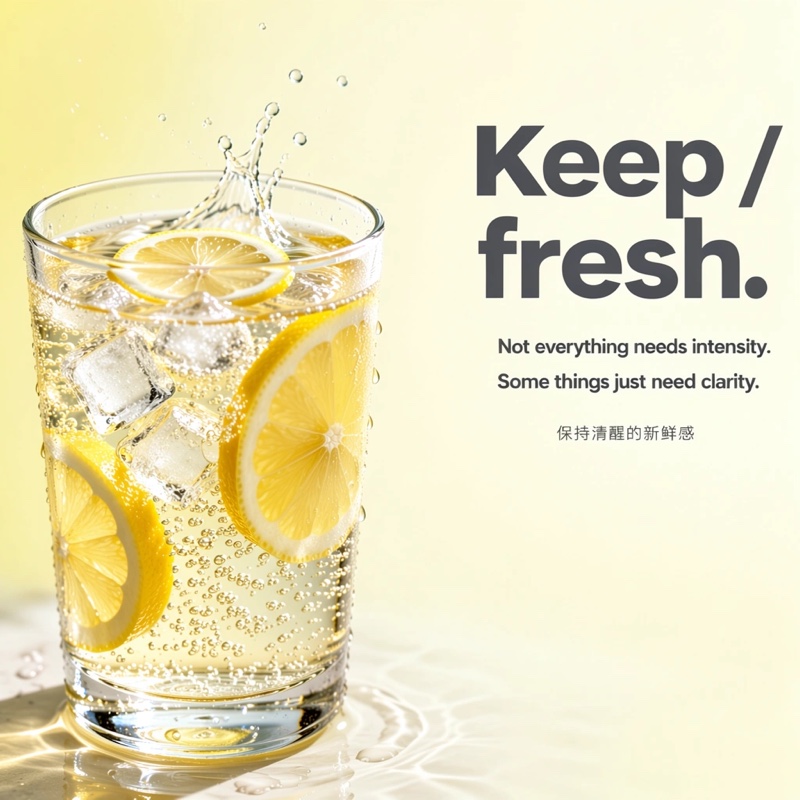
指令编辑我只挑Case 2。原图海报写着Stay / fresh,指令要求改成Keep / fresh。杯子、柠檬片、水花和其余文案都留着,只换了两个单词。
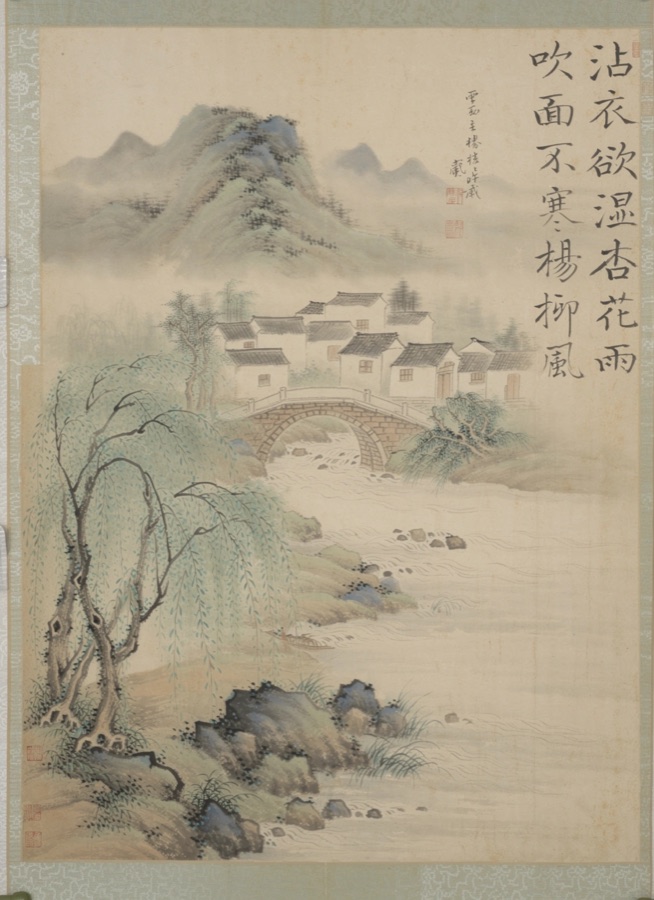
浅绛山水那张是Turbo的四步结果,题款「沾衣欲湿杏花雨」「吹面不寒杨柳风」从右到左两列。论文里把它和Z-Image Turbo、GPT-Image 2等并排比,磁盘上只留了这一张。
本地跑一遍
我没有上卡实测。下面的命令和参数抄自官方README,版本约定也来自那里。Python 3.11,PyTorch 2.8,Transformers 4.57.6,Diffusers 0.39.0。
git clone https://github.com/inclusionAI/LLaDA-Image.git
cd LLaDA-Image
conda create -n llada-image python=3.11 -y
conda activate llada-image
pip install -r requirements.txt
import torch
from src import LLaDAImagePipeline

pipe = LLaDAImagePipeline.from_pretrained(
    "inclusionAI/LLaDA-Image",
    torch_dtype=torch.bfloat16,
    device="cuda",
)

prompt = (
    "A cinematic photograph of a red fox standing in fresh snow, "
    "soft winter light, detailed fur, shallow depth of field"
)
image = pipe(
    prompt=prompt,
    negative_prompt="",
    generation_mode="text",
    height=1024,
    width=1024,
    num_inference_steps=50,
    guidance_scale=5.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("llada-image-base.png")
Base默认50步,guidance_scale为5.0。Turbo把模型名换成inclusionAI/LLaDA-Image-Turbo,步数改成4,guidance_scale改成1.0。
编辑把generation_mode设成editing,再传入参考图。VQ条件生成走generation_mode="vq",不要再喂输入图。分辨率1024。文生图高宽必须能被16整除,编辑必须能被32整除。
README另写了一句,Turbo可以把scheduler/scheduler_config.json里的stochastic_sampling设成false,有时细节会更利。训练代码在Opensource Plan里仍标着即将放出。
几点看法
这篇文章最值得抄的是配方表,以及纯图阶段把条件和目标绑在同一块裁剪上。很多开源文生图只给权重,过滤阈值、分阶段批量和真实图占比要自己猜。
双扩散能成立,是因为语言去噪token、图像去噪潜变量,交接只发生在连接器。编辑把参考图像绕开理解模块,也避免它去背像素。
GitHub训练代码还没落地,220M数据本身也不会公开。标题里的Fully Open,目前停在可复述的配方和可下载的权重。
计数、真实世界保真度、编辑观感,报告里的数字已经摆出来了。原生2K没有评。要海报长文字,Qwen-Image 2512和Boogu仍更稳。要实拍照感,看Base比看Turbo更对症。
Hugging Face模型卡把体量写成7B,论文正文写的是6B DiT。我按论文。LLaDA2.0-Mini自己的参数量这份报告没写。
参考链接
- 技术报告原文 arXiv 2609.03796 v1,2026年9月
- 推理代码 inclusionAI/LLaDA-Image
- 模型权重 Hugging Face合集
- 理解模块来源 LLaDA2.0-Uni
- 评测 Qwen-Image-Bench、GEdit-Bench
- 对比方案 Z-Image、Qwen-Image

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)