从「智障客服」到自主任务执行体:手把手教你搭建会干活的企业级智能客服Agent
先问个扎心的问题:你有没有被那种「智障客服」气到过?你问「我的快递到哪了」,它给你甩一段退换货政策;你说「我要退款」,它反复问你「请问有什么可以帮您」;你都急眼了打字带脏字了,它还在慢悠悠地推荐相关问题……那一刻,你是不是特别想砸手机?
这种「智障客服」,大多是老一代的规则机器人,或者最原始的那种 RAG——用户问啥,它就检索一次、拼个提示词、生成个回答,完事。它没有状态、不懂上下文、不会判断该不该转人工,更别提帮你真的把退款给办了。说白了,它只会「答」,不会「干活」。
2026 年,评价一个 AI 客服好不好,分水岭就一条:
它到底是个只会背 FAQ 的「电子传单」,
还是一个能理解意图、调用知识、还能操作业务、
推进流程的「自主任务执行体」?
这篇,咱们就从零搭一个后者——一个真正「会干活」的企业级智能客服 Agent。它会给用户的问题分流(物流的归物流、退款的归退款)、会多轮对话不断片、查不到就老实转人工、还能对接系统帮用户开工单。全程带完整的前后端代码,你照着改改,就能给自己公司搭一个。文章挺长,做客服、做企业应用的朋友,建议收藏。
一、承上启下:客服 Agent,就是 Agentic RAG 的「实战应用」
上一篇咱们搭了个 Agentic RAG——会判断、会检索、会自我纠错的智能问答。这篇的智能客服,其实就是把 Agentic RAG 那套「会思考」的内核,套进「客服」这个具体业务里,再加几样客服特有的本事。你可以理解成:
**智能客服 Agent = Agentic RAG(会思考的问答内核)
- 意图分流 + 多轮对话记忆 + 转人工 + 开工单。**
——内核是通用的,外面这几样,是客服业务的「专属装备」。
所以上一篇要是看过,这篇你会觉得特别顺——很多概念(判断、检索、校验、自我纠错)是通的。没看过也不要紧,这篇我会把客服这套完整地讲一遍。核心还是那个思路:把流程的控制权交给大模型,让它自己判断「该检索啥、要不要重试、该不该转人工」,用 LangGraph 的状态机把这套编排起来。
先看这个客服 Agent 的整体架构,分四层,从上到下:
| 层次 | 干啥的 | 用啥 |
|---|---|---|
| 前端交互层 | 聊天界面,用户在这打字 | 网页(HTML/JS) |
| 接口服务层 | 收发请求、流式返回 | FastAPI |
| 智能体编排层 | ★核心:分流、检索、决策 | LangGraph 状态机 |
| 知识检索层 | 存售后/物流/退款知识 | 向量数据库 |
这四层里,最核心、也是这篇重点讲的,是第三层「智能体编排层」——它是客服 Agent 的大脑。 前端、接口、知识库这几层相对标准,咱们快速过;大脑那层,一个节点一个节点地细讲。
二、看懂大脑:客服 Agent 的完整工作流
客服 Agent 的「大脑」是怎么处理一次咨询的?咱们把完整的工作流画出来,你一看就明白它比传统客服「聪明」在哪:
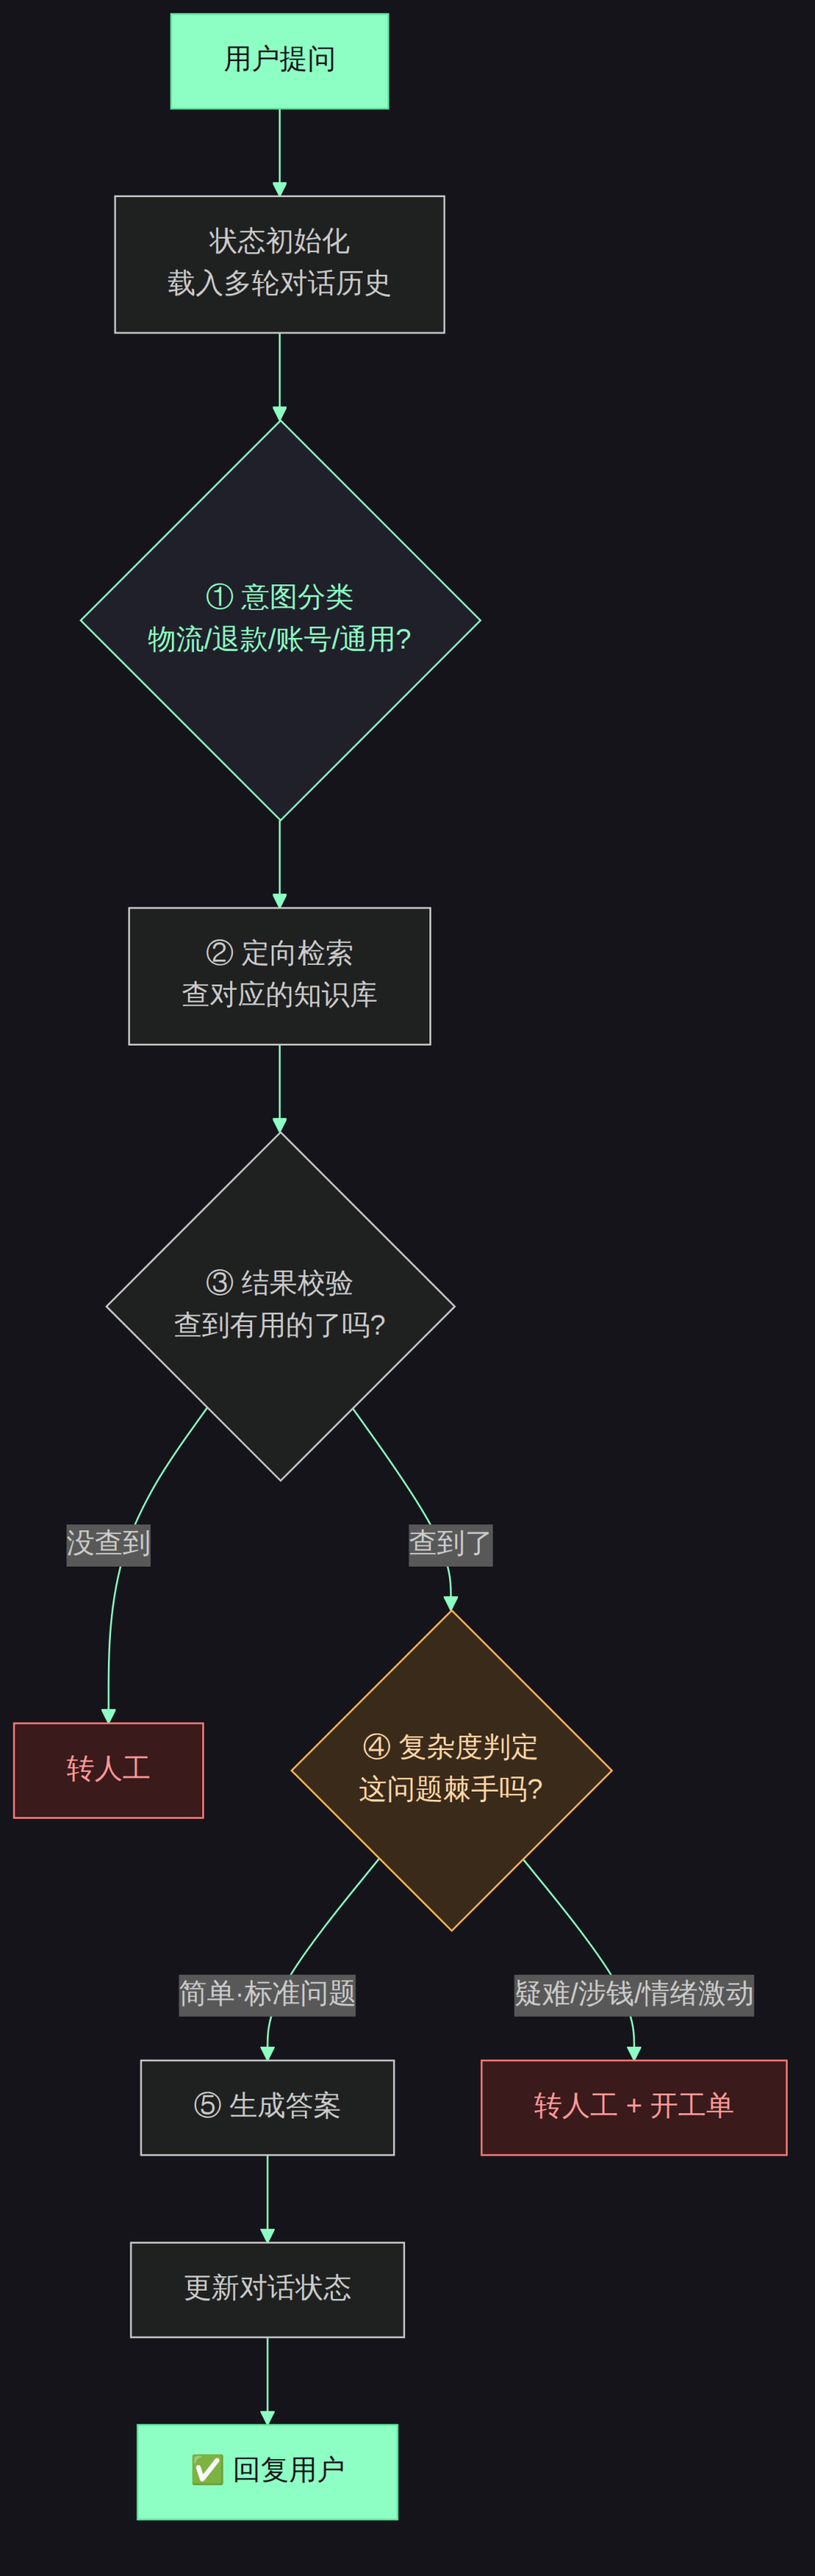
顺着走一遍,这个大脑的思路就清楚了:用户提问进来,先① 判断意图——你问的是物流、退款、账号,还是通用咨询?分清了,② 就去查对应的那个知识库(问物流就查物流知识,不会拿退款政策来答物流问题,这就解决了开篇那个「答非所问」的糗事)。查完 ③ 校验一下「查到有用的没?」,没查到,别硬编,直接转人工。查到了,④ 再判断这问题「棘手不棘手」——标准的简单问题,⑤ 自己生成答案回复;可要是涉及退款金额、或者用户情绪已经很激动了、或者是个疑难杂症,那就别逞能,老实转人工、顺手开个工单。
看到那两个红色的「转人工」了没?那是这个客服 Agent 最懂事的地方。 一个好的客服 Agent,不是「什么都自己答」,而是「知道自己啥时候该闭嘴、把事儿交给人」。这个分寸,是智能客服能不能落地的关键——答错了、乱承诺了,是要出事的。下面咱们把这套流程,用代码搭出来。
三、大脑第一步:定义客服的「记忆」和状态
还是用 LangGraph。第一件事,定义客服 Agent 的状态(State)——它得记住这次会话的方方面面:用户问了啥、聊了几轮、判断出的意图是啥、查到了啥、要不要转人工。
from typing import TypedDict, List, Literalclass ServiceState(TypedDict): user_input: str # 用户当前这句话 history: List[dict] # ★多轮对话历史(记忆) intent: str # 判断出的意图(物流/退款...) documents: List[str] # 检索到的知识 answer: str # 生成的回复 need_human: bool # 要不要转人工 ticket: dict # 要开的工单信息
重点看那个 history(对话历史)——它是解决「多轮混乱」的关键。 传统客服最让人抓狂的一点,就是没记性:你上一句说「我买的那个杯子」,下一句问「它啥时候到」,它就懵了——「它」是啥?有了 history,每一轮都带着前面的上下文,大脑就能明白「它」指的是那个杯子,多轮对话才不会断片。这个「记忆」,是智能客服体验好坏的分水岭之一。
四、大脑第二步:意图分类——先搞清用户要干啥
客服 Agent 的第一个「思考动作」,是意图分类。为啥这步这么重要?因为它决定了后面「去哪个知识库查」。分对了,查得准;分错了,后面全错。
INTENT_PROMPT = """你是客服意图分类器。判断用户这句话,属于下面哪一类,只回答类别名,别的不说:- 物流:问快递、发货、到货时间、物流进度- 退款:问退货、退款、售后、换货- 账号:问登录、注册、密码、账户问题- 通用:其它咨询,或闲聊打招呼对话历史:{history}用户当前问题:{user_input}"""def classify_intent(state: ServiceState): """意图分类节点:判断用户问的是哪一类""" result = llm.invoke(INTENT_PROMPT.format( history=state["history"][-3:], # 带上最近几轮上下文 user_input=state["user_input"])) intent = result.content.strip() return {"intent": intent}
注意这个分类,是带着「对话历史」一起判断的(history[-3:] 取最近三轮)。为啥?还是多轮的问题——用户单说一句「那要多久」,单看这句没法分类,但结合上一轮「我要退款」,就知道他问的是「退款要多久」,属于退款类。意图分类离不开上下文,这也是为啥前面那个 history 状态那么重要。 分类分对了,下一步就能定向去查对应的知识库,而不是在整个大知识库里瞎捞。
五、大脑第三步:定向检索 + 结果校验
意图清楚了,就去查对应的知识库。这里有个客服特有的优化——知识库要按意图分开建、分开查。物流知识、退款政策、账号帮助,各存各的。查的时候,按意图定向查,又快又准。
# 按意图,映射到不同的知识库(collection)KB_MAP = { "物流": "logistics_kb", "退款": "refund_kb", "账号": "account_kb", "通用": "general_kb",}def retrieve(state: ServiceState): """定向检索:根据意图,查对应的知识库""" kb_name = KB_MAP.get(state["intent"], "general_kb") kb = get_vectorstore(kb_name) # 拿到对应知识库 docs = kb.similarity_search(state["user_input"], k=4) return {"documents": [d.page_content for d in docs]}def check_docs(state: ServiceState): """结果校验:查到的东西,能不能回答用户?""" if not state["documents"]: return {"need_human": True} # 啥也没查到,转人工 # 让大模型判断检索结果够不够回答 r = llm.invoke(CHECK_PROMPT.format( question=state["user_input"], documents="\n".join(state["documents"]))) if "不能" in r.content: return {"need_human": True} # 查到的没用,也转人工 return {"need_human": False}
这段里,「校验」这一步是防幻觉的关键闸门。 查到的东西,先让大模型掂量一下「够不够回答用户」。要是知识库里压根没有相关内容(或者查到的驴唇不对马嘴),它不会硬编一个答案糊弄用户——那样最危险,客服乱答是要担责的。它会老实地把 need\_human 设成 True,准备转人工。「不懂就转人工,绝不瞎答」——这是客服 Agent 必须守住的底线。 这个思路,跟上一篇 Agentic RAG 的「幻觉检查」一脉相承。
六、大脑第四步:复杂度判定——啥时候该「叫人」?
这一步,是智能客服最能体现「懂事」的地方,也是它区别于「愣头青机器人」的关键——判断这个问题,是自己能搞定的,还是得赶紧叫人工来接。 有几种情况,再智能的 Agent 也该老老实实转人工:
-
涉及钱
:退款金额、赔偿、账单纠纷——钱的事,AI 别乱承诺,让人来
-
用户情绪激动
:检测到用户在骂人、在投诉、明显很生气——赶紧转人工安抚,别火上浇油
-
疑难/非标问题
:知识库覆盖不了的复杂个案,AI 硬答容易出错
-
用户明确要求
:用户说「我要找人工」——二话不说,立刻转
def assess_complexity(state: ServiceState): """复杂度判定:这问题该不该转人工""" # 1. 用户明确要人工,直接转 if "人工" in state["user_input"] or "转人工" in state["user_input"]: return {"need_human": True, "ticket": build_ticket(state)} # 2. 大模型综合判断:涉钱?情绪激动?疑难? r = llm.invoke(COMPLEXITY_PROMPT.format( intent=state["intent"], user_input=state["user_input"], history=state["history"][-3:])) if "转人工" in r.content: # 转人工的同时,把这次咨询整理成工单 return {"need_human": True, "ticket": build_ticket(state)} return {"need_human": False}
看到没,转人工的时候,它顺手干了件特别贴心的事——build\_ticket,把这次咨询整理成一张工单。 用户是谁、问了啥、聊了哪些、卡在哪儿,都整理好,一并交给接手的人工客服。这样人工一接手,不用再让用户从头说一遍(用户最烦这个了),直接就能接着处理。这就是「工单闭环」——AI 搞不定的,不是简单甩给人了事,而是把前因后果整理清楚、平滑地交接。 这一步做好了,用户体验能差出十条街。
七、把大脑组装起来:LangGraph 编排
五个节点(分类、检索、校验、复杂度判定、生成)都有了,用 LangGraph 把它们串成完整的工作流,靠条件边实现「该转人工就转、该生成就生成」的智能路由:
from langgraph.graph import StateGraph, ENDworkflow = StateGraph(ServiceState)workflow.add_node("classify", classify_intent) # 意图分类workflow.add_node("retrieve", retrieve) # 定向检索workflow.add_node("check", check_docs) # 结果校验workflow.add_node("assess", assess_complexity) # 复杂度判定workflow.add_node("generate", generate_answer) # 生成答案workflow.add_node("human", transfer_to_human) # 转人工workflow.set_entry_point("classify")workflow.add_edge("classify", "retrieve")workflow.add_edge("retrieve", "check")# ★条件边1:校验后,查到了往下走,没查到转人工def after_check(state): return "human" if state["need_human"] else "assess"workflow.add_conditional_edges("check", after_check)# ★条件边2:复杂度判定后,棘手转人工,简单去生成def after_assess(state): return "human" if state["need_human"] else "generate"workflow.add_conditional_edges("assess", after_assess)workflow.add_edge("generate", END)workflow.add_edge("human", END)app = workflow.compile()
这段就是把前面那张流程图,变成了可执行的程序。 两个条件边是关键:after\_check 管「查到没、没查到转人工」,after\_assess 管「棘手不棘手、棘手转人工」。你看,「转人工」这个出口,在流程里有两道——检索没结果转一次、判定太复杂再转一次。 这种「层层设卡、该放手就放手」的设计,才让客服 Agent 既能扛住大部分标准咨询,又不会在棘手问题上硬撑出乱子。
八、接上门面:FastAPI 后端 + 聊天前端
大脑搭好了,得给它接上「门面」——一个后端接口收发消息,一个聊天界面让用户用。后端用 FastAPI,几十行搞定,还支持流式返回(就是那种一个字一个字蹦出来的打字机效果,体验好):
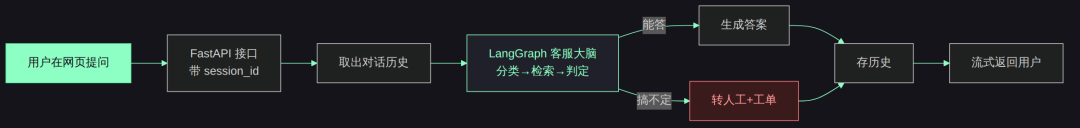
from fastapi import FastAPIfrom fastapi.responses import StreamingResponsefrom pydantic import BaseModelapi = FastAPI()class ChatReq(BaseModel): message: str session_id: str # 用它区分不同用户的会话@api.post("/chat")async def chat(req: ChatReq): # 取出这个会话的历史(实现多轮) history = load_history(req.session_id) # 跑客服 Agent result = app.invoke({ "user_input": req.message, "history": history, }) # 存回历史 + 返回结果 save_history(req.session_id, req.message, result["answer"]) return { "answer": result["answer"], "transferred": result["need_human"], # 是否已转人工 "ticket": result.get("ticket"), }
注意那个 session\_id——它是实现「多轮对话」的工程关键。 每个用户一个 session_id,后端靠它把每个人的对话历史分开存、分开取。用户 A 聊 A 的、用户 B 聊 B 的,互不串味。前端就更简单了,一个聊天框、一个发送按钮、把消息发给 /chat 接口、把回复显示出来——用 HTML+JS 或者 Vue 都行,这块比较标准,我就不占篇幅贴了,文末我放了完整代码仓库的获取方式。
整套接起来,一次完整的客服对话是这么流转的:
九、落地了才知道:这些坑得防
① 该转人工时绝不能硬撑
本篇头号铁律。涉钱、情绪激动、疑难、用户点名要人工——立刻转,别逞能。客服乱答、乱承诺是要担责的,AI 搞不定就老实交给人,这是底线。
② 不懂就说不懂,严禁瞎编
检索没结果,宁可转人工,也别让大模型自己脑补一个答案。客服场景里,一个自信的错误答案,比「我帮您转人工」危险一百倍。防幻觉是命门。
③ 转人工要带上工单,别甩锅
转人工不是把用户一脚踢给人就完事。要把这次咨询整理成工单(用户、问题、上下文)一并交接,让人工无缝接手。别让用户从头再说一遍,那是体验杀手。
④ 多轮历史要按会话隔离
用 session_id 把每个用户的对话历史分开存。别搞串了,把 A 的上下文用到 B 身上,那就闹笑话了。历史也别无限堆,太长了要做截断或摘要。
⑤ 意图分类要结合上下文
分类别只看用户当前这一句,要带上最近几轮历史。「那要多久」这种话,脱离上下文根本没法分类。多轮上下文是分类准确的前提。
⑥ 知识库分类建、定期更新
按意图分开建知识库(物流/退款/账号),定向检索更准。而且客服知识(政策、活动)变得勤,知识库要有更新机制,别让 AI 拿过期政策答用户。
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
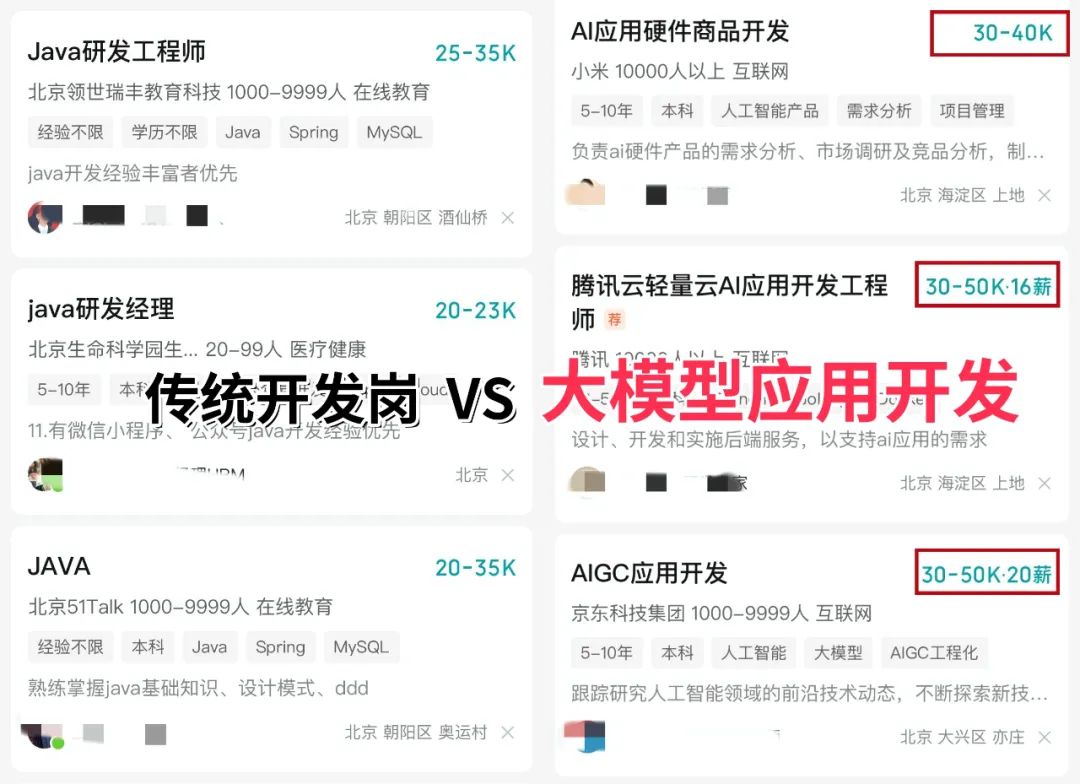
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
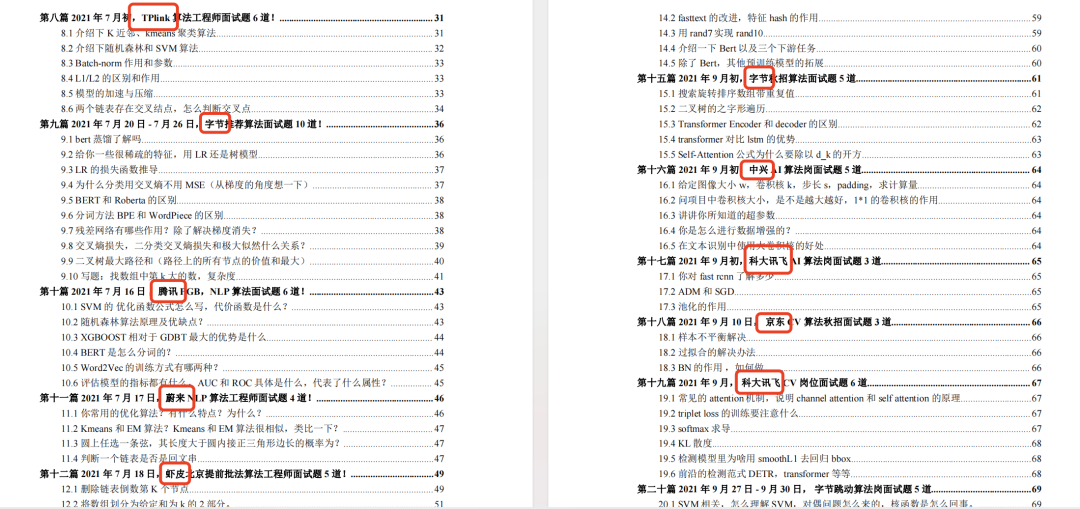
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
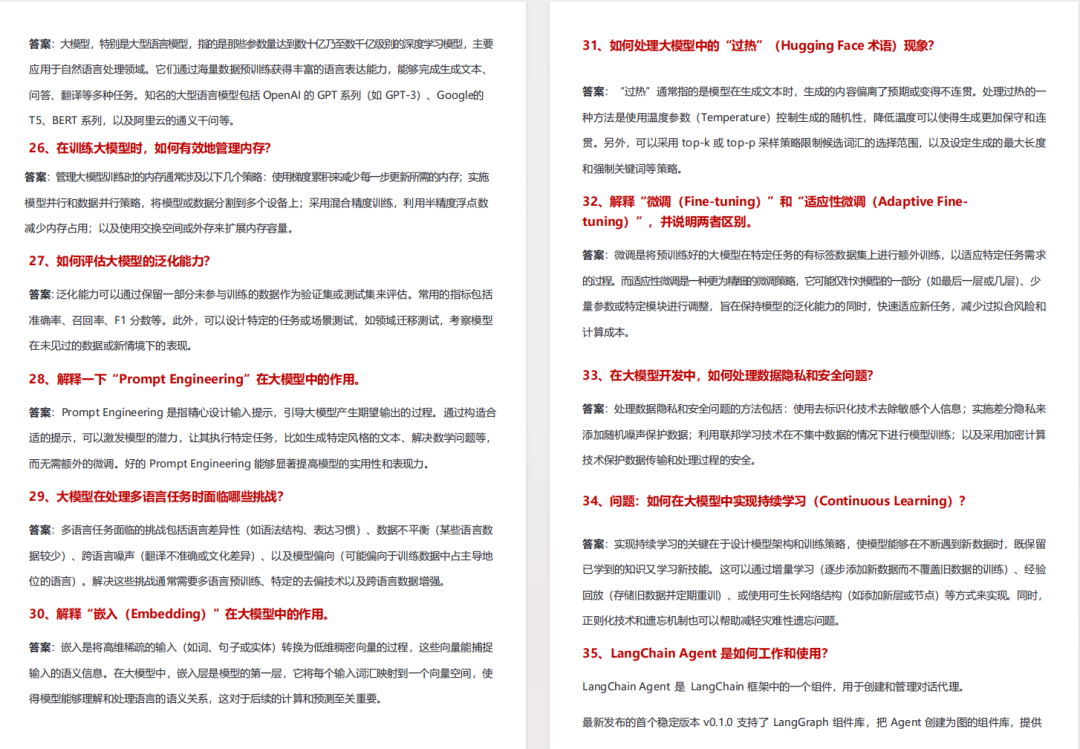
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
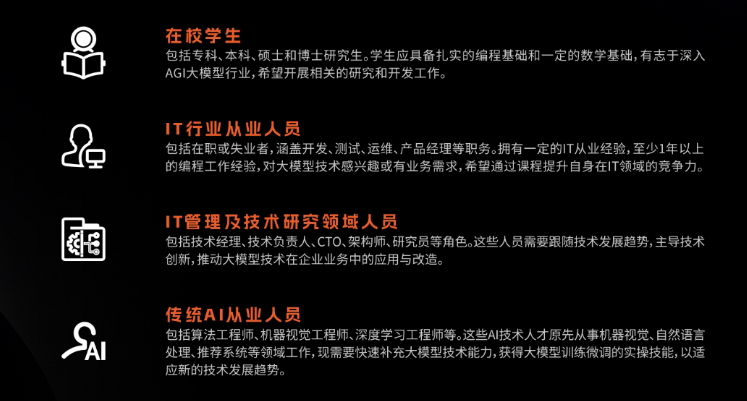
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
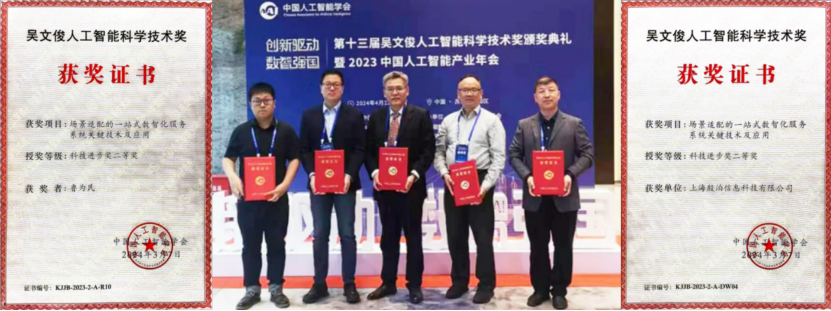
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献48条内容

所有评论(0)