AI 机器人靠哪些内存与存储驱动整机运行?
很多人只关注 AI 算力芯片,却忽略:大模型推理、传感器融合、步态控制、语音视觉交互,全部建立在一套分层内存存储体系之上。人形 / 移动 AI 机器人不会用服务器的 HBM,而是依靠 DRAM 运行内存、各类闪存存储,配合底层驱动,完成从开机、感知、AI 推理到关节运动的全流程工作。
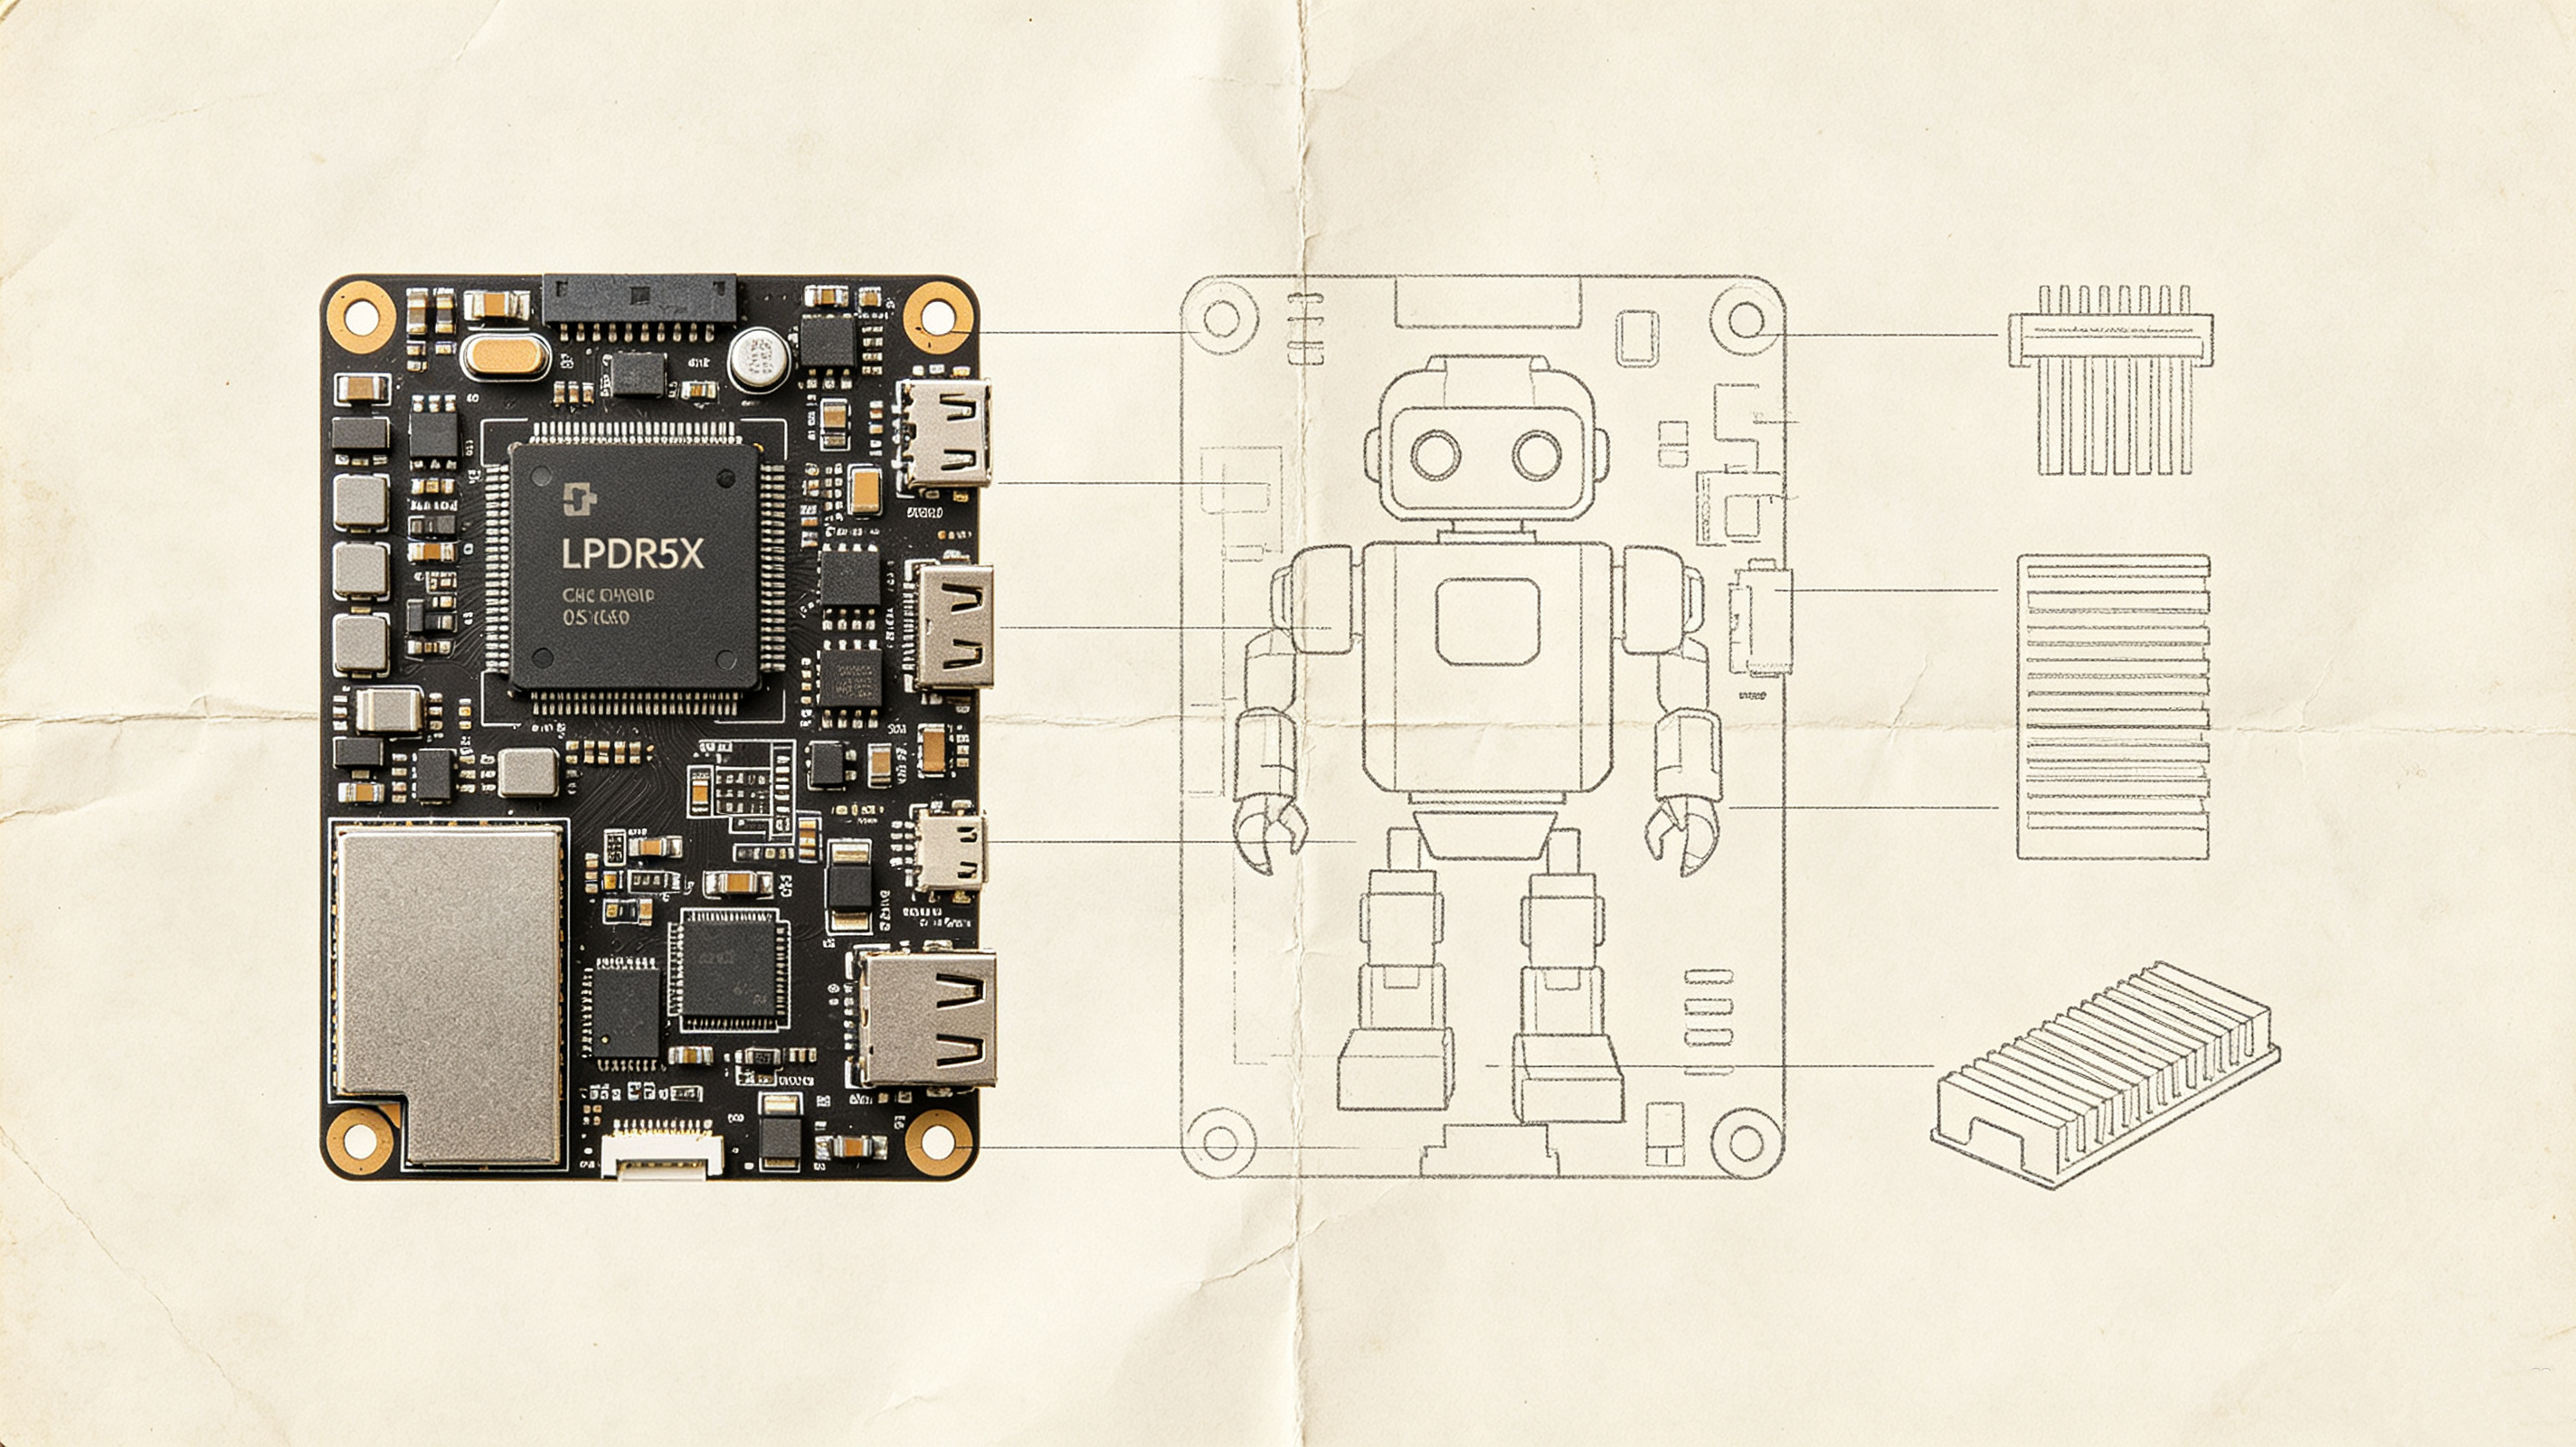
一、运行内存(DRAM:临时算力工作台)
断电数据消失;负责实时 AI 运算、传感器数据流、模型中间计算结果,是机器人的 “临时大脑工作台”。
1. LPDDR5 / LPDDR5X(人形机器人主流标配)
- 作用:统一共享内存,CPU/GPU/NPU 共用一块内存空间。承载本地大模型推理、相机 + 激光雷达点云运算、IMU 姿态解算、全身步态规划、多模态数据缓冲。
- 典型容量:高端人形 16128GB;服务机器人 832GB;小型 AMR 机器人 416GB。
- 为什么不用 HBM:HBM 带宽极高,但功耗大、发热严重、体积堆叠复杂。机器人靠电池供电、机身狭小散热有限;LPDDR5X 在功耗、体积、抗震动、宽温之间取得平衡,适合移动场景。
- 底层驱动:SoC 厂商 BSP 驱动、DDR PHY 驱动、DVFS 动态调频驱动,负责动态调节带宽与电压,兼顾性能和省电。
2. 片上 SRAM(芯片内部高速缓存)
- 作用:NPU/GPU 内置,延迟极低。存放高频模型权重碎片、运动控制闭环参数。
- 特点:容量很小(MB 级别),成本高,不做外部内存;保障关节控制、紧急避险这类微秒级实时任务,不能被 LPDDR 替代。
- 小结:SRAM 做极速小缓存,LPDDR5X 做整机主力运行内存,机器人几乎不会搭载 HBM
二、非易失存储(Flash:永久数据仓库,断电不丢)
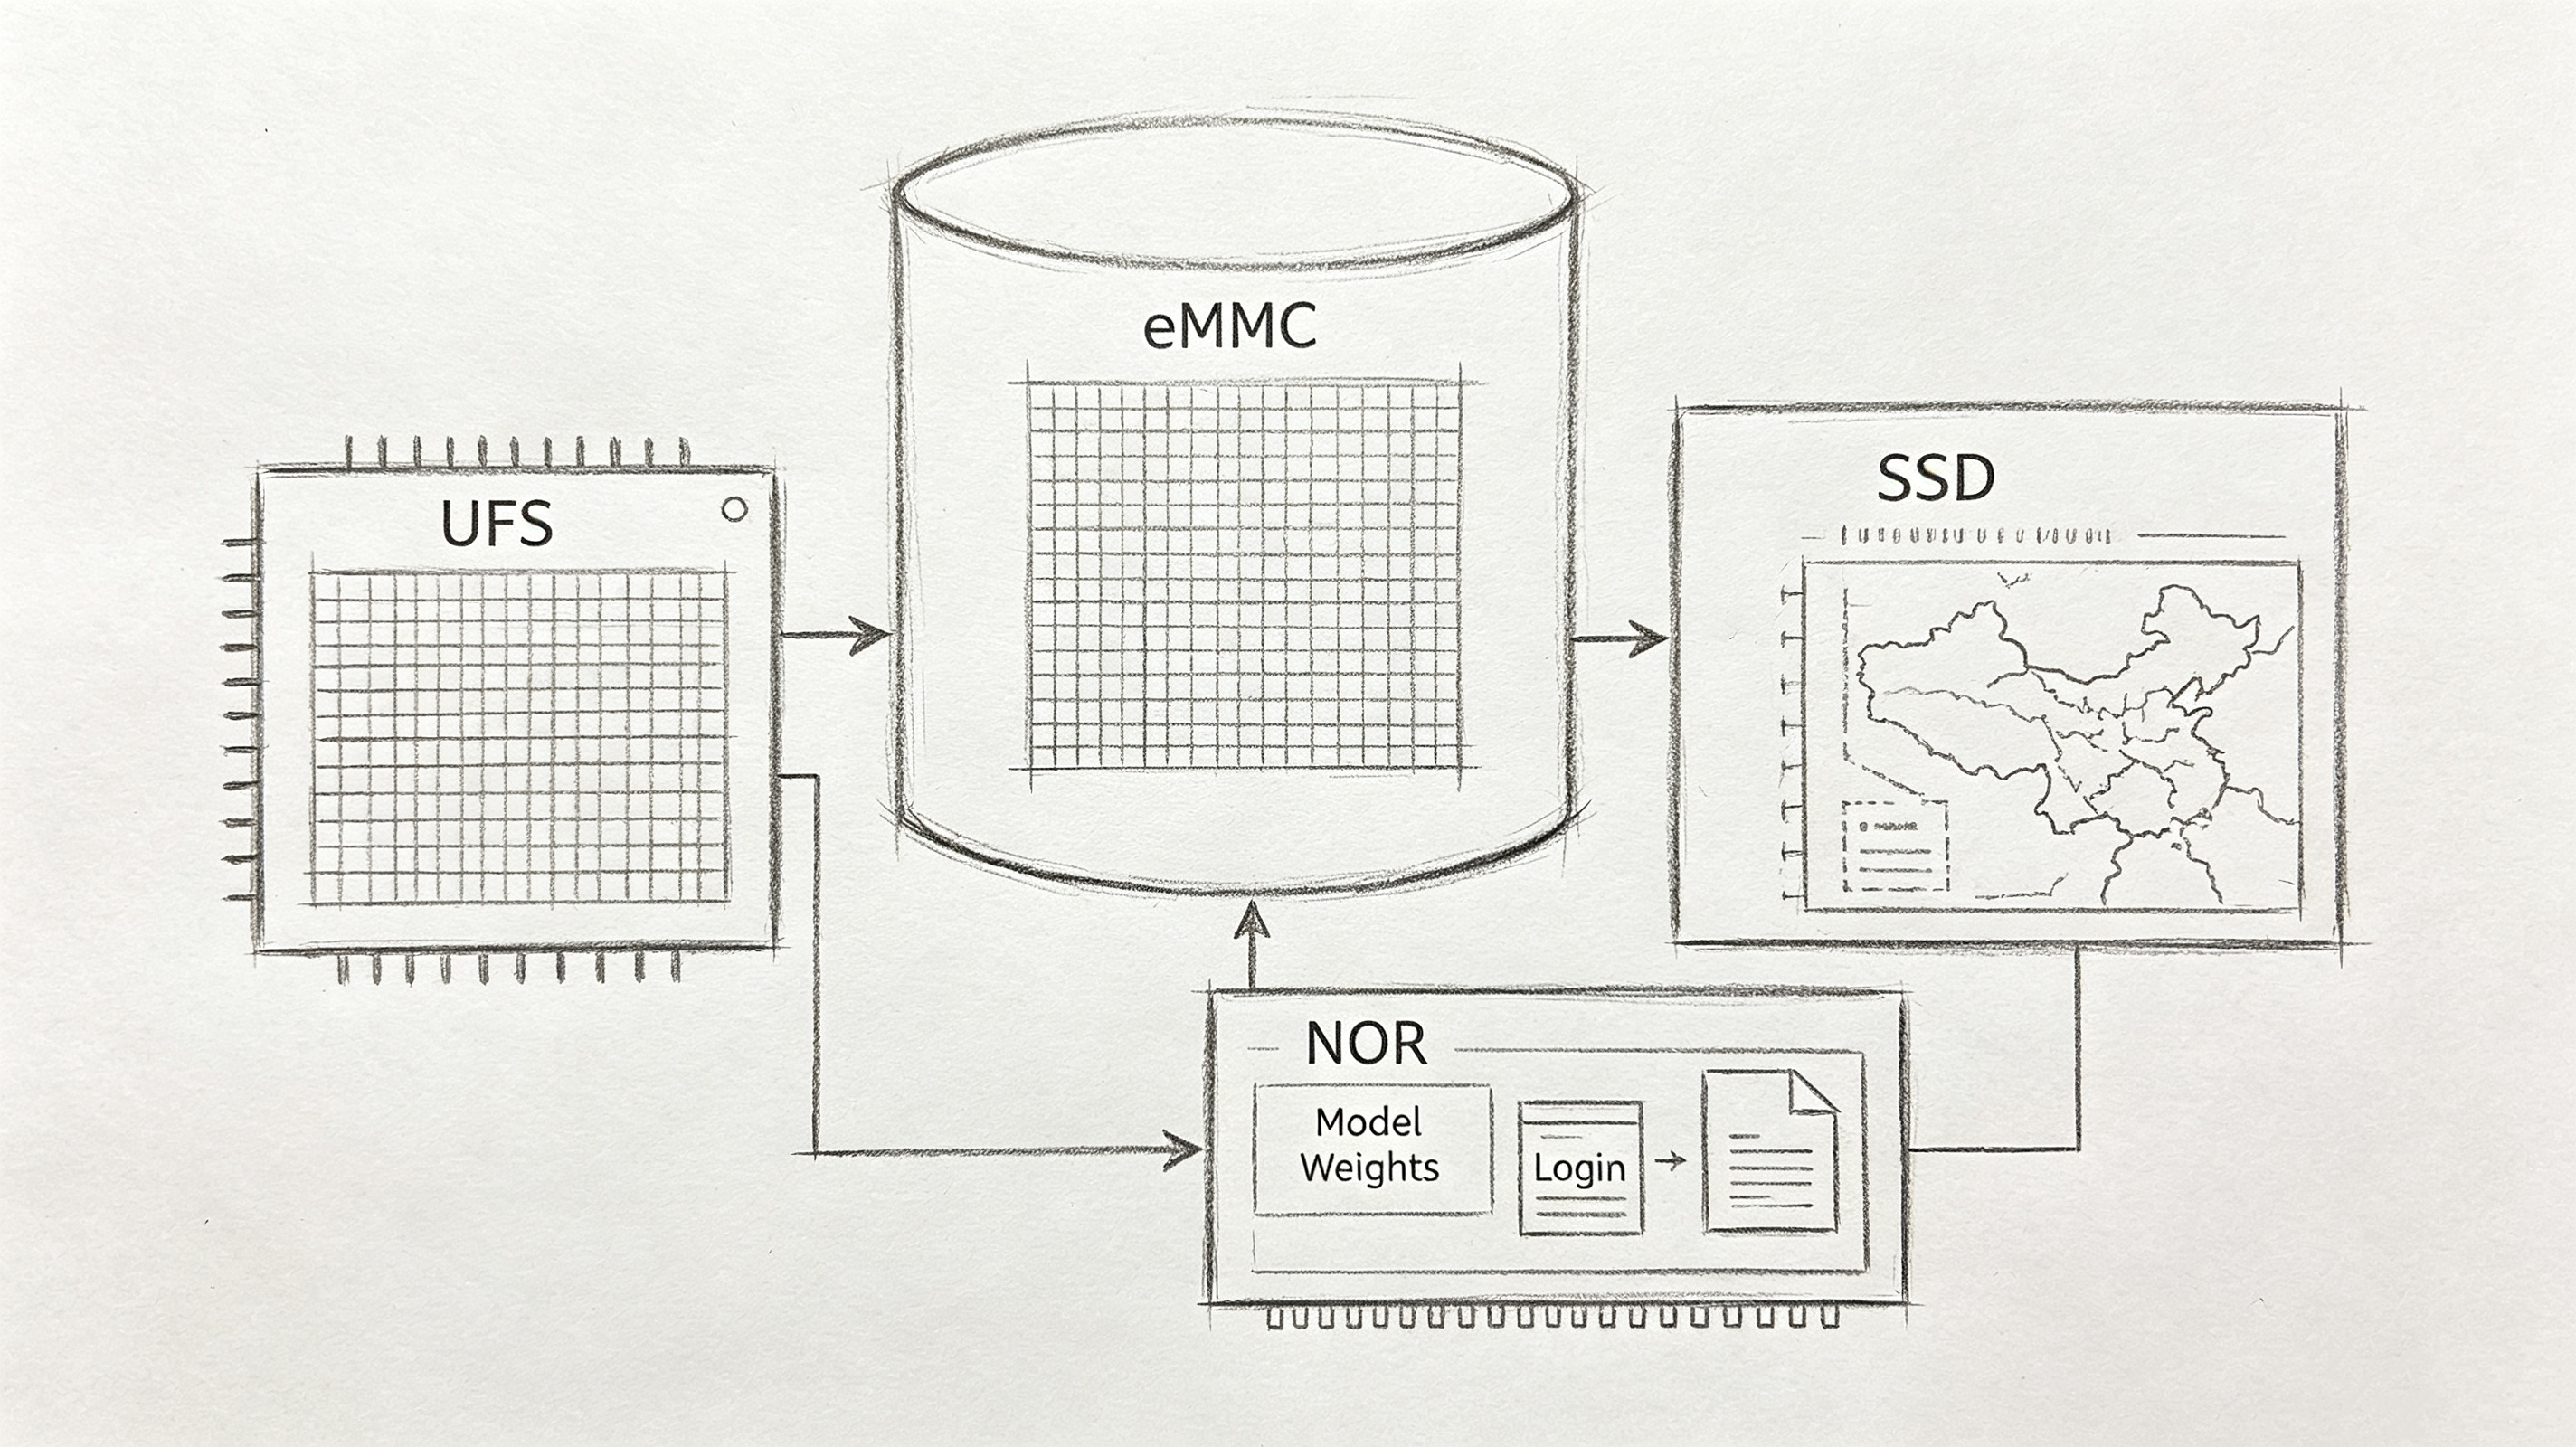
1. NVMe mSSD(高端人形机器人)
- 用途:存放完整具身大模型权重、多模态模型、大型导航地图。实现大模型快速加载。
- 驱动:PCIe 控制器驱动 + NVMe 内核驱动。
2. UFS3.1 / UFS4.0(中高端机器人)
- 用途:操作系统、轻量化大模型、语音库、视觉素材、运行日志。很多 Jetson、高通机器人平台原生支持 UFS。
- 驱动:UFS 主机控制器驱动。
3. eMMC(中端、服务巡检机器人)
- 用途:系统固件、业务程序、传感器日志,成本低。
- 驱动:MMC 子系统驱动。
三、内存 / 存储相关关键底层驱动软件
硬件颗粒只是基础,需要整套驱动、内核模块才能协同工作:
1.LPDDR PHY 驱动:管理内存物理硬件,初始化时序、电压、频率,处理 ECC 纠错,应对工业环境震动、温度漂移。
2.DVFS 动态功耗驱动:AI 忙的时候拉高带宽,待机、行走时降频降功耗,延长电池续航,LPDDR 核心能力。
3.块设备驱动(NVMe/UFS/eMMC):管理闪存读写,把模型文件、系统读入 DRAM 内存。
4.内存管理子系统(Linux 内核):负责内存分配、缓存、swap 控制。机器人会尽量禁用 swap,避免推理卡顿。
5.实时 RTOS 内存管理(关节 MCU):关节小脑,确定性内存分配,不能出现内存抖动,防止摔倒、失控。
6.AI 框架内存分配器(TensorRT、MindSpore):专门为大模型推理做内存池,复用 LPDDR 内存,减少内存碎片,防止 OOM 内存溢出。
四、一套完整行业标配(高端人形机器人示例)
表格
|
类别 |
硬件 |
承担工作 |
|
运行内存 |
16128GB LPDDR5X |
大模型推理、视觉点云、姿态解算、任务规划 |
|
片上高速缓存 |
SoC 内置 SRAM |
高频算子、运动闭环实时参数 |
|
高速机身存储 |
NVMe mSSD |
完整大模型权重、三维地图 |
|
系统存储 |
UFS4.0 |
机器人操作系统、应用程序、日志 |
|
关节固件存储 |
多颗 SPINOR Flash |
每个关节伺服控制固件与标定参数 |
工作流程:开机后,NVMe/UFS 把 AI 模型、系统读取到LPDDR5X 内存;SRAM 缓存高频计算;主控完成感知AI 决策;指令下发各个关节 MCU,MCU 读取 NOR Flash 内固件执行运动控制。
五、误区澄清
- 不是内存带宽越高机器人越强:服务器 HBM 带宽爆炸,但功耗、发热不适合电池驱动移动机器人;机器人追求带宽、功耗、体积、震动稳定性综合平衡。
- 内存≠存储:LPDDR 是运行内存,只负责 “正在算的数据”;NVMe/UFS/eMMC/NOR 是存储,负责 “存起来的数据”;模型必须先从存储加载进内存,才能跑 AI 推理。
- 关节也需要独立存储:人形机器人几十个关节 MCU,每个都需要 NOR Flash 固件,不能全部靠主控大内存包办。
一句话总结
AI 机器人以LPDDR5X 作为主力运行内存,搭配芯片内置 SRAM 做高速缓存;再依靠 NVMe / UFS /eMMC/ NOR Flash 分层存储模型、系统、关节固件,配合 PHY、DVFS、块设备、实时内存管理驱动,完成感知、AI 推理、运动控制整套工作,而 HBM 因为功耗发热问题,现阶段并不适合移动人形机器人落地量产。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)