从火热的Microduck看虚拟到物理:具身智能落地全流程——以 Spin 任务中的 Spec Coding、强化学习与 Sim2Real 为例
一、引言:一只鸭子如何改变具身智能的学习门槛
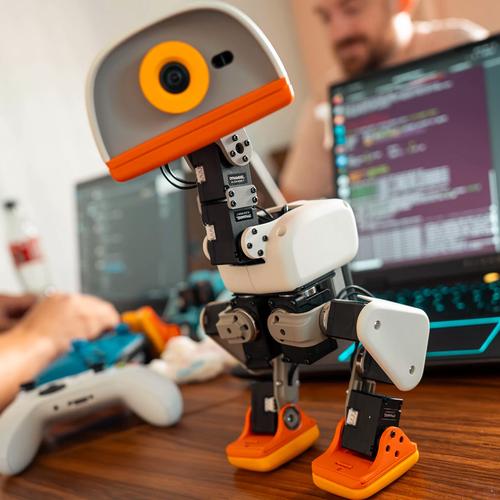
2026年8月,AI开源社区Hugging Face联合旗下法国机器人公司Pollen Robotics发布了一款售价399美元的双足机器鸭——Microduck。这只高25厘米、重不足800克的机器人,开订6小时订单额突破100万美元,24小时累计约6500台,高峰期平均每4秒卖出一台。更值得关注的是,它把SDK、MuJoCo仿真环境、完整的强化学习训练栈全部以Apache-2.0协议开源——这意味着,从仿真训练到真机部署的完整具身智能闭环,第一次被压缩到了千元人民币级别。
Microduck的核心定位是“行动导向的AI平台”:出厂预装7种通过强化学习训练的策略,包括走路、坐立、下蹲、踢腿、抓取、轮滑,以及从跌倒姿势中自主起身。其技术路线清晰而完整:基于MuJoCo / MuJoCo Warp仿真环境,采用PPO算法结合领域随机化完成Sim2Real迁移,导出ONNX模型后部署到真机Runtime直接运行。
但本文的目标不止于介绍一只机器鸭。Microduck项目最珍贵的价值,在于它开源了一套可复现、可学习、可扩展的具身智能工程方法论。本文将以该项目中一个具体的任务——“Spin”(旋转快速起旋)为例,深入剖析具身智能从“虚拟”走向“物理”的完整落地流程,重点讲解三个核心支柱:Spec Coding(规范驱动开发)、强化学习(RL)、Sim2Real(仿真到现实迁移) 。
二、三大支柱的宏观框架
在深入细节之前,先建立三个支柱的宏观关系:
- Spec Coding 回答“我们要做什么”:在写一行代码之前,用结构化文档把任务目标、物理约束、奖励设计、观测布局、终止条件等全部定义清楚。它解决的是需求到实现的映射问题。
- 强化学习 回答“怎么让机器人学会做”:通过奖励函数引导策略网络在仿真中反复试错,最终习得完成任务的控制策略。它解决的是从目标到行为的生成问题。
- Sim2Real 回答“怎么让仿真里学会的技能在真机上也能用”:通过在训练中引入领域随机化、执行器物理建模、传感器噪声等手段,让策略对真实世界的不完美具有鲁棒性。它解决的是从虚拟到物理的迁移问题。
三者构成一个闭环:Spec Coding定义问题 → RL在仿真中求解 → Sim2Real将解迁移到物理世界。Microduck项目的Spin任务,正是这个闭环的一个完整实例。
三、支柱一:Spec Coding——用规范驱动具身智能开发
3.1 为什么具身智能需要Spec Coding?
传统软件开发中,需求文档与代码之间的距离可以通过单元测试、类型系统、代码审查来弥合。但具身智能项目面临一个独特的困境:代码的“正确性”不能仅通过逻辑判断,而必须通过物理世界的表现来验证。一个奖励函数写错了一个符号,可能导致机器人在仿真中学会完全错误的动作;一个观测维度对不上,ONNX模型就无法在真机Runtime中加载。
更深层的问题是:具身智能项目通常由多个协作方共同开发——算法工程师定义奖励,仿真工程师搭建环境,嵌入式工程师部署Runtime。如果缺乏一份精确的、双方共同认可的“合同”,各个模块之间的接口就会频繁出错。
Spec Coding(规范驱动开发)正是为了解决这个问题。它的核心理念是:在编码之前,用结构化文档把任务的所有方面定义清楚,让规范本身成为“可执行的合同” 。
3.2 Spin任务的Spec文档解剖
Microduck项目的Spin任务提供了一份堪称范本的Spec文档。让我们逐层解剖它的结构。
第一层:目的与约束。 Spec开篇明确定义了任务目标:“让microduck在rollers上做~2圈逆时针原地旋转,~6 rad/s,然后干净地停下来站直”。同时列出了硬性约束:运行时button slot只发送[cos, sin, 0],没有额外的通道来控制旋转方向,因此策略始终向左旋转。
这里的精髓在于:约束不是事后补充的,而是从一开始就作为设计空间的一部分被明确。运行时接口的限制直接决定了任务只能学单向旋转,因此不存在“双向旋转”的设计选项。如果等到编码阶段才发现这个约束,整个奖励设计和观测设计可能都需要推倒重来。
第二层:物理机制。 Spec用一整节推导了旋转的物理原理:在4个被动轮上,“干净”的原地旋转通过差速滚动实现——左脚片向后、右脚片向前,腿做反相的“剪刀运动”而非镜像运动。Spec甚至给出了严格的符号验证:逆时针旋转时,左侧点(+y)的速度为 ω ẑ × y ŷ = −ω y x̂,即向后,因此ω_left < 0, ω_right > 0,即 ω_D − ω_G > 0 。
这个推导的重要性怎么强调都不为过。它不仅定义了spin_wheel_differential奖励的符号方向,也为后续所有代码实现提供了“物理真理”——如果实现中符号搞反了,奖励会鼓励机器人向错误的方向旋转。
第三层:架构决策与理由。 Spec详细比较了三种可能的实现方法:
- 方案A(纯结果导向) :只奖励偏航速度,让PPO自己找动作。风险是可能学到“滑行-跳跃”的懒惰策略,而非真正的滚动。
- 方案B(姿态导向) :用相位插值两个预设姿态。问题在于,对于crouch任务,姿态是在真机上读出来的;而spin的动作是未知的,手动构造姿态代价高且风险大。
- 方案C(A + 反相引导衰减) ← 被采纳。保留结果导向的奖励结构,但注入两项微弱的“引导”奖励——它们只编码物理上确定的知识(差速滚动),权重随课程学习衰减,让策略最终能自由发现自己的动作节奏。
这种“比较-选择-记录理由”的结构,使得后续任何开发者——无论是人类还是AI代理——都能理解决策背后的权衡,而不仅仅是看到最终代码。
第四层:数值规范的完整定义。 Spec给出了相位包络的精确数值:SPIN_PERIOD = 4.0 s,SPIN_RATE_MAX = 6.0 rad/s,以及四个时间段的边界值。更重要的是,Spec给出了积分验证:0.5·3 + 1.6·6 + 0.5·3 = 12.6 rad ≈ 2.0圈,并推导出通用公式 2.1 × rate_max。
这意味着,任何人在任何时间点修改了rate_max,都可以立即通过公式验证旋转圈数是否仍然符合目标。规范本身包含了自验证机制。
3.3 Plan文档:从Spec到可执行步骤的翻译
如果说Spec是“设计蓝图”,Plan就是“施工顺序”。Microduck的Plan文档将Spec翻译成6个相互依赖的任务,每个任务都有明确的输入、输出和验证标准。
以Task 1(相位包络的纯函数)为例:Plan规定了要创建spin_rate_by_phase和spin_gate_by_phase两个纯函数,定义了它们的完整签名(参数名、类型、默认值),并给出了6个测试用例,包括边界值测试、单调性测试、积分验证和门函数归一化测试。
这种**“先写测试,再写实现”** 的模式在具身智能项目中尤为重要。因为奖励函数的正确性无法通过肉眼审查代码来保证,必须通过数学验证。Plan中test_spin_rate_integral_is_two_turns这个测试就是规范的核心守护者:它用10万个采样点数值积分验证包络的面积等于4π,如果任何人修改了时间边界或速率最大值而没有同步考虑圈数,这个测试会立即失败。
Plan文档还包含了调试痕迹。例如,在omega_scale的校准上,文档记录了初始估计值20.0,然后记录了实测值34.2(差距71%,超过30%的阈值),最终调整为17.0(因为SPIN_RATE_MAX从6.0降到了3.0)。这种“测量-决策-记录”的链条,使得后续开发者能够理解每个数值背后的物理依据,而不是面对一堆“魔法数字”。
3.4 Spec Coding对学习者的启示
对于想要进入具身智能领域的学生,Microduck的Spec Coding实践提供了三条可直接迁移的方法:
第一,从约束出发,而非从算法出发。 不要先问“我要用什么强化学习算法”,而是先问“我的硬件接口是什么?我的物理约束是什么?我的传感器能提供什么信息?”约束定义了设计空间的边界,算法只是在边界内寻找解。
第二,让规范包含自验证机制。 任何数值决策都应该有对应的数学验证或物理推导。2.1 × rate_max的圈数公式、ω_D − ω_G > 0的符号推导,都是可以在代码中直接编码为测试的“真理”。
第三,记录决策的理由,而非仅记录决策。 “为什么选方案C而不是方案A或B”比“我们选了方案C”重要一百倍。理由让后来者能够判断,当条件变化时,原决策是否仍然成立。
四、支柱二:强化学习——在仿真中教会机器人新技能
4.1 任务的形式化:从物理目标到MDP
Spin任务在强化学习框架下被形式化为一个马尔可夫决策过程(MDP)。其核心要素定义如下:
状态空间:61维观测向量,包含陀螺仪读数(3维)、投影重力(3维)、关节位置(14维)、关节速度(14维)、上一时刻动作(14维)和命令(13维)。这个布局与roller、ground_pick、crouch等任务完全一致,是运行时策略热切换的“契约”。
动作空间:14维关节位置目标(关节位置控制),通过PD控制器转换为力矩。
奖励函数:这是Spin任务最核心的设计。
4.2 奖励设计:结果导向与物理先验的融合
Spin任务的奖励函数体现了强化学习在机器人控制中最重要的一条设计原则:当任务的“正确动作”未知时,奖励“结果”而非“过程”;但可以用微弱的“过程引导”来注入物理上确定的知识,并让引导随学习进展逐渐衰减。
Spec将奖励分为三类:
第一类:主要目标——偏航速度跟踪。 spin_rate_track是权重最高的奖励项(6.0),定义为 exp(−((ω_z − ω*(φ))/std)²),其中ω*(φ)是相位φ下的目标偏航速度。这是一个高斯型奖励:当实际偏航速度等于目标时,奖励为1.0;偏差越大,奖励越低。它还包含一个辅助项spin_rate_l1(权重0.5),提供恒定的梯度方向——当高斯函数远离目标而饱和时,L1项仍然能引导策略向正确方向移动。
第二类:物理引导——差速滚动与姿态。 spin_wheel_differential(权重1.0)奖励左右轮速度差ω_D − ω_G > 0,用tanh函数饱和以避免“速度竞赛”。leg_antisymmetry(权重1.0,随课程衰减至0.25)奖励双腿的“剪刀”姿态——注意这里的符号约定:由于机器人左右侧采用镜像符号约定,对称姿态满足q_G + q_D ≈ 0,因此剪刀姿态满足q_G ≈ q_D,用−|q_G − q_D|来衡量。
第三类:稳定性约束。 spin_stay_in_place(权重−3.0)惩罚躯干的平面速度平方,确保机器人“原地”旋转而非漂移。spin_grounded(权重0.5)要求双脚至少有一个接触地面,防止“跳起来在空中扭转”的作弊行为。
4.3 相位门控:让引导“知道什么时候该起作用”
Spin任务中最优雅的设计之一是相位门控机制。相位φ从运行时命令中恢复(φ = atan2(sin, cos) / 2π),整个4秒周期被划分为四个段:加速(0→0.125)、保持(0.125→0.525)、刹车(0.525→0.650)、休息(0.650→1.0)。
门函数gate(φ) = ω*(φ) / rate_max在所有引导奖励上作为乘子。这意味着:
- 在加速段,门从0线性上升到1,引导逐渐增强
- 在保持段,门恒为1,引导全力工作
- 在刹车段,门从1线性下降到0
- 在休息段,门恒为0,所有引导奖励归零
休息段门为零的设计至关重要:它让机器人在完成旋转后不会受到任何“剪刀姿态”的推动,因此能够自然回到中性站姿,为下一个周期或策略切换做好准备。这是“干净退出”的工程实现。
4.4 课程学习:从易到难的渐进式训练
Spin任务的课程学习体现在两个维度:
引导衰减:leg_antisymmetry的权重从1.0开始,在1500次迭代后降至0.5,3000次迭代后降至0.25。这实现了“脚手架”效应:初期引导帮助策略发现剪刀运动模式,后期引导减弱,让策略自由优化自己的动作节奏。
动作平滑度渐进:action_rate_weight从−0.5开始,250次迭代后变为−0.8,500次迭代后变为−1.0。初期允许较大的动作变化以促进探索,后期加强对动作平滑度的要求。
此外,质心随机化范围也随训练进展扩大(0.003 → 0.005 → 0.01),逐步增加策略需要适应的不确定性。
4.5 观测设计中的“真实感”处理
Spin任务的观测设计借鉴了项目中其他任务的经验,包含了多个模拟真实传感器不完美性的处理:
- IMU偏移:陀螺仪和重力观测加入最大6°的随机旋转偏移,模拟IMU安装误差
- 关节位置噪声:±0.001 rad的均匀噪声
- 关节速度噪声:±0.25 rad/s的均匀噪声
- 编码器偏置:±0.015 rad的持续偏置,模拟编码器安装误差
- 延迟模拟:陀螺仪和重力观测有0-1步的随机延迟,关节速度有固定的1步延迟
这些处理使得策略在训练时就“习惯”了真机传感器的不完美,从而在部署时更加鲁棒。
4.6 一个值得深思的训练教训
Spec文档中记录了一个极具教育意义的失败案例。最初的校准运行(500次迭代,4096个环境)显示:机器人在约1.16秒时全部摔倒,远早于刹车段。更关键的是,spin_rate_track的数值在上升,但这并不是因为跟踪变好了,而是因为机器人存活时间变长了——休息段(目标偏航速度为零)会为“站着不动”支付全额奖励,因此任何存活更久的策略都会机械地获得更多奖励。
这个教训的深刻之处在于:奖励曲线的上升不等于任务在变好。一个看似直观的监控指标(“奖励在涨”)可能完全被任务结构中的“免费午餐”所扭曲。正确的诊断需要拆解奖励的构成,计算各项之间的比率,才能得到真实的信号。Spec通过“比率法”估算出实际偏航速度跟踪误差约为0.35 rad/s,并推断出机器人“能启动旋转,但无法在旋转时保持站立”。
基于这一诊断,人类决策者将SPIN_RATE_MAX从6.0降到3.0(圈数减半),并将spin_stay_in_place从−1.0加强到−3.0,同时刻意不引入速度课程学习——这是一个“先看看机器人以一半速度能做到什么程度”的探索性决策。
五、支柱三:Sim2Real——从虚拟到物理的跨越
5.1 Sim2Real的核心挑战
仿真训练的策略部署到真机时,性能通常会显著下降,甚至完全失效。原因在于:仿真永远无法完美复现物理世界。电机有摩擦和齿隙,传感器有噪声和漂移,电池电压会波动,地面材质会变化,通信有延迟。这些“不完美”在仿真中是默认不存在的,但在真机中却无处不在。
Microduck项目对Sim2Real的处理方式可以概括为一句话:不追求让仿真“像”真机,而是让策略在仿真中“见过”所有可能的不完美,从而在真机中也能应对。
5.2 领域随机化:让策略学会“抗造”
Spec文档中列出了Spin任务的完整领域随机化配置:
- 质心随机化:躯干和头部的质心位置在±0.003 m范围内随机偏移,随课程学习逐步扩大到±0.01 m
- 质量与惯量随机化:在0.95-1.05倍范围内缩放
- 关节摩擦随机化:BAM摩擦模型的参数在0.9-1.1倍范围内缩放
- 电枢随机化:电机电枢在0.9-1.1倍范围内缩放
- 轮子摩擦随机化:被动轮的摩擦损耗随机化
- 速度推力:每3-6秒施加一次随机速度扰动,范围±0.2 m/s
- IMU方向随机化:最大6°的安装误差
- 编码器偏置:±0.015 rad的持续偏置
这些随机化的共同目标不是“模拟真实”,而是“覆盖真实”。策略在训练中见过各种质心偏移、各种摩擦水平、各种传感器误差,因此当部署到真机时,真机的不完美只是策略“见过的众多可能性之一”。
Microduck项目的Sim2Real配方中最独特的部分是BAM执行器物理建模。BAM(Brushless Actuator Model)精确模拟了Dynamixel XL330舵机的物理特性,包括齿隙(backlash)、摩擦、电压降等。Spec文档特别指出,训练环境模拟了“电机摩擦、电池电压变化、控制延迟,甚至连舵机齿轮的齿隙都纳入考量”。
5.3 观测契约:Sim2Real的“接口合同”
Spin任务中一个看似简单但极其关键的Sim2Real约束是61维观测契约。Spec明确规定:观测布局必须与roller、ground_pick、crouch等任务完全一致,包括各分组的顺序和维度。这是ONNX模型能够加载到运行时slot中的硬性条件。
Plan文档中的Task 6 Step 1专门设计了一个验证步骤:比较Spin任务和Crouch任务的actor观测项列表,断言两者完全相同。如果列表不同,ONNX模型将无法在运行时中正确解析输入。
这个约束的Sim2Real意义在于:运行时不需要为每个任务维护不同的观测处理逻辑。无论加载的是走路策略、旋转策略还是蹲下策略,运行时都按照同一套61维布局组装观测,然后交给策略网络推理。策略的“接口”是统一的,这使得策略热切换成为可能。
5.4 控制频率匹配
Spec中隐含但重要的一个Sim2Real细节是控制频率匹配。Microduck真机以50 Hz运行,训练中num_steps_per_env=24对应20秒的episode,即50 Hz的控制频率。控制频率的匹配确保了策略在仿真中学到的“时间感”在真机上仍然有效——如果仿真以100 Hz训练而真机以50 Hz运行,策略的时序假设就会完全错乱。
5.5 部署流程:从ONNX到真机
Spin任务的部署流程在Spec中有清晰的定义:
# 训练
uv run train Mjlab-Spin-Flat-MicroDuck --env.scene.num-envs 4096

# 可视化
uv run scripts/play_latest.py

# 导出ONNX
uv run scripts/export_latest.py

# 真机运行
microduck_runtime --model output.onnx --ground-pick spin.onnx \
  --ground-pick-period 4.0 --ground-pick-kp-ratio 1.0 \
  --ground-pick-action-scale 0.8
这里有一个重要的Sim2Real细节:--ground-pick-kp-ratio 1.0。默认值是0.6,但Spec指出训练使用的是kp=200,因此运行时必须强制为1.0以匹配。这种“训练-部署参数对齐”是Sim2Real中最容易出错但也最容易被忽视的环节。
六、三位一体:从Spec到真机的完整闭环
将三个支柱整合起来,Spin任务的完整开发流程如下:
第一阶段(Spec Coding) :用Spec文档定义任务目标、物理机制、奖励结构、观测布局、领域随机化配置。用Plan文档将Spec翻译为6个可验证的任务步骤。
第二阶段(强化学习) :在MuJoCo Warp中并行运行4096个环境,用PPO算法训练策略网络。训练过程中监控奖励曲线的分解,而非仅看总量。通过课程学习逐步增加任务难度和随机化范围。
第三阶段(Sim2Real) :将训练好的策略导出为ONNX,在真机Runtime中加载。运行时按照统一的61维观测契约组装输入,策略以50 Hz输出14维关节目标,PD控制器将目标转换为力矩驱动舵机。
三个阶段的衔接依赖于两个“合同” :观测契约(61维布局)和动作契约(14维关节位置,kp=200,action_scale=0.8)。Spec文档明确定义了这两个合同,Plan文档中的测试验证了它们,Sim2Real部署中严格遵循了它们。
七、给具身智能学习者的实践路线
基于Microduck项目的完整经验,以下是一条可直接践行的学习路线:
第一步:读Spec,不要急着写代码。 选择项目中一个任务(建议从Spin或Velocity开始),通读Spec文档,理解每个数值决策背后的物理推导。尝试自己回答:为什么ω_D − ω_G > 0?为什么休息段门为零?为什么omega_scale从20改到34又改到17?
第二步:运行Plan中的纯函数测试。 Spin任务的spin_rate_by_phase和spin_gate_by_phase是纯函数,不需要MuJoCo就能测试。运行pytest tests/test_spin.py,观察6个测试如何验证包络的正确性。尝试修改rate_max,观察哪个测试会失败,理解为什么。
第三步:在仿真中训练。 用少量环境(64个)和少量迭代(5次)跑一个smoke run,确认没有NaN。然后用4096个环境跑500次迭代,监控Episode_Reward/spin_rate_track。但不要只看这个数字——按照Spec中的方法,计算spin_rate_l1 / spin_rate_track的比率,估算实际的跟踪误差。
第四步:修改一个参数,观察后果。 尝试将spin_stay_in_place的权重从−3.0改为−1.0,重新训练,观察机器人是否更容易漂移。这个练习帮助你建立“奖励权重→行为”的直觉。
第五步:部署到真机(如果有硬件)。 如果手头有Microduck或类似平台,按照Spec中的部署命令加载ONNX,观察真机行为与仿真行为的差异。记录差异,思考哪些差异可能来自领域随机化的不足。
八、结语
Microduck项目的最大价值不在于它是一只可爱的机器鸭,而在于它把具身智能开发的“黑箱”打开了。Spec文档展示了任务设计背后的物理推理和决策权衡;Plan文档展示了从规范到可测试实现的翻译过程;训练日志展示了失败与诊断的真实过程;领域随机化配置展示了Sim2Real的工程实践。
对于学习具身智能的学生,这个项目的启示是:具身智能的核心能力不是“调参”,而是“建模”——物理建模(理解机器人与环境的交互)、任务建模(将目标转化为可优化的奖励)、以及迁移建模(预测哪些仿真-真实差异是关键的) 。Spec Coding培养的正是这种建模能力:在写代码之前,把问题的物理本质想清楚,把约束条件列清楚,把验证方法定义清楚。
当“教机器人走路”的完整代码都免费摊开时,下一个被拉下神坛的,可能是整个“机器人必须由大公司造”的叙事。而掌握这套方法论的开发者,将成为具身智能时代真正的建设者。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献4条内容

所有评论(0)