【ICML 2026】SOMA 论文解读:让 VLA 拥有视野之外的空间记忆|从具身智能空间认知视角
摘要
本文解读 ICML 2026 论文《Spatial Memory for Out-of-Vision Manipulation in Vision-Language-Action》。该论文提出 SOMA,一个面向视野外操作的空间记忆框架,通过融合多视角扫描建图、相似度感知的动态记忆融合与指令条件化的记忆检索,让视觉-语言-动作模型(VLA)在目标移出相机视野时仍能完成抓取与放置,其特别之处在于把记忆做成几何锚定的场景状态而非单纯的上下文缓存。实验表明 SOMA 在五类真机视野外任务上全部取得最高成功率,平均 28.3%,并把首次注视耗时、头部搜索路径、抓取尝试次数等行为指标压低 40–60%;在完全可观测的 RoboCasa GR1 与 SimplerEnv 上同样领先,为具身操作中的部分可观测问题提供了重要借鉴。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Spatial Memory for Out-of-Vision Manipulation in Vision-Language-Action |
| 标题(中文) | SOMA:让 VLA 拥有视野之外的空间记忆 |
| 作者 | Pengteng Li, Weiyu Guo, He Zhang, Tiefu Cai, Xiao He, Yandong Guo, Hui Xiong |
| 机构 | 香港科技大学(广州)人工智能学域 · 香港科技大学计算机科学与工程系 · 智平方(AI2 Robotics) |
| 会议 | ICML 2026 |
| arXiv | arXiv:2605.22283 |
| 项目网站 | 论文未公开项目页,作者团队为智平方(AI² Robotics)具身大模型团队 |
背景与动机
机器人操作的主流范式,隐含了一条几乎没人明说的假设:指令里提到的物体,在决策时刻一定在相机的视野里。固定视角的桌面抓放之所以能大行其道,正是因为这条假设把问题简化成了"看到什么就做什么"的反应式映射。
一旦目标移出视野,链条立刻断裂。作者在论文里把这条失效路径画得很清楚:
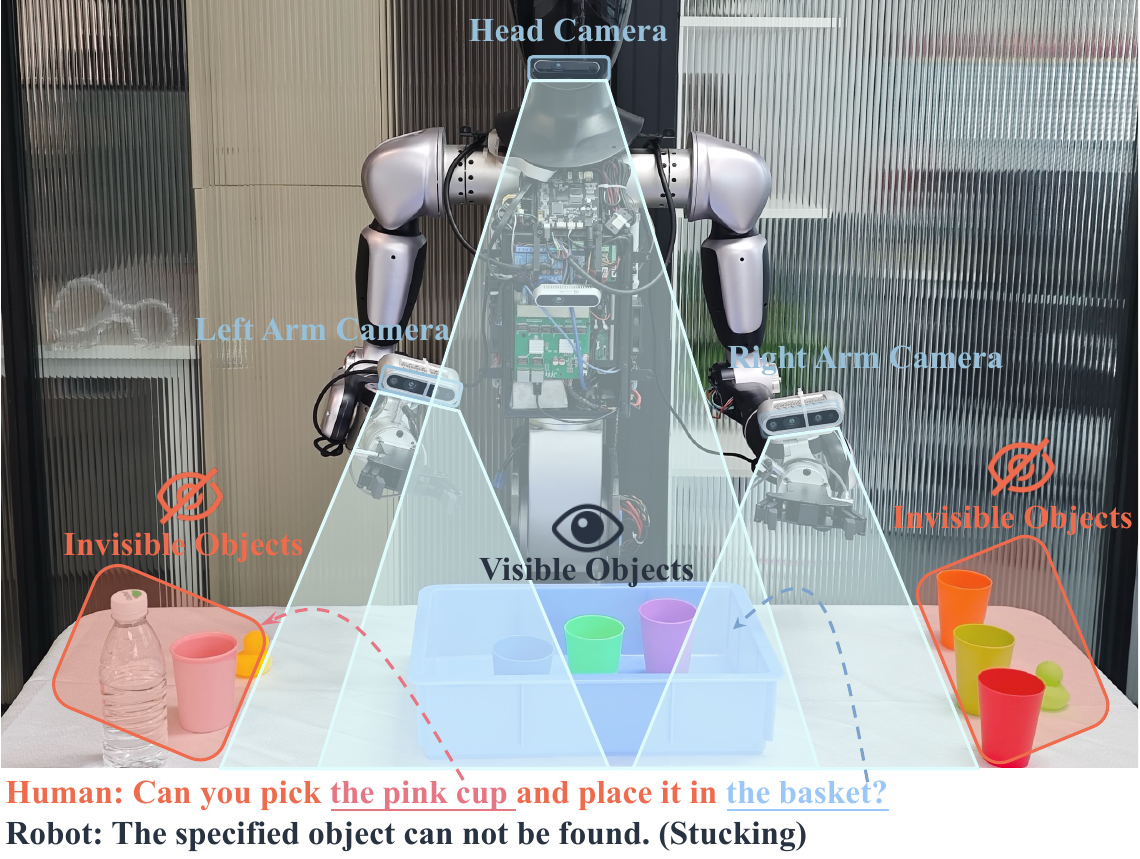
图 1:论文要解决的问题——现有 VLA 的感知是反应式的,动作只由当前可见内容驱动;当目标移出视野,感知无法再支撑操作,任务必然失败。
既有工作在两条路上尝试过补救,但都不完整:
- 靠内部推理硬猜:RoboBrain、Galaxea-G0、See&Trek 一类方法试图用模型的空间先验推断看不见的物体位置。问题在于,多模态大模型只在目标有部分视觉证据或相关线索时才可靠,目标完全离开可观测范围后空间估计会迅速退化。
- 靠可动相机去找:ViA、ActiveUMI 引入可动相机去揭开遮挡区域,方向正确,但策略本身不吃语言指令,也不维护持久记忆,难以泛化到新目标与新空间构型。
- 有记忆但不解决空间问题:MemoryVLA、MemER 这类模型会存储近期观测或关键帧,服务的却是时间维度上的短程上下文,而不是三维空间的全局表示。
把这三条线放在一起看,缺口就很明确:需要一种既带三维几何、又能被语言指令检索、还能被新观测改写的记忆。 这也是 SOMA 想补的位置。
从历史脉络看,机器人感知走的是"看清 → 记住 → 记忆驱动动作"这条路:早期可动相机探索让策略自己决定看哪里,随后记忆中心与空间感知两条线分别从时间上下文和几何线索逼近"记住场景",但记忆与空间始终分家;到 SOMA 这一步,扫描、几何锚定的记忆与指令条件化检索才被合成一条回路。
研究主线:从问题到结论
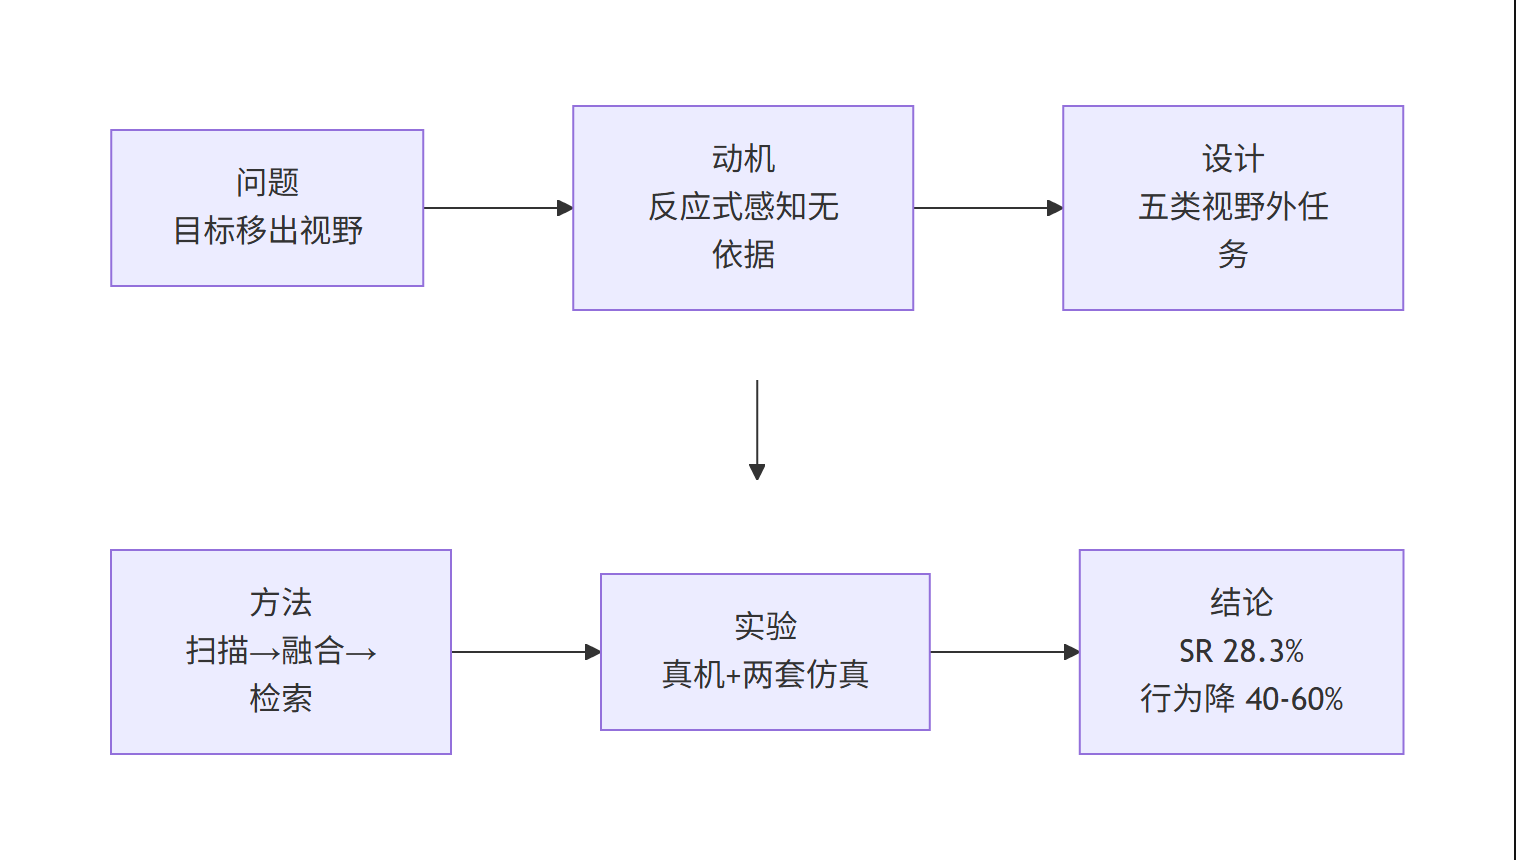
图 7(Mermaid 流程图):SOMA 论文的研究主线——问题(目标移出视野)→ 动机(反应式感知无依据)→ 设计(五类视野外任务)→ 方法(扫描、融合、检索)→ 实验(真机加两套仿真)→ 结论(平均成功率 28.3%,行为指标降 40–60%)。
基准/方法设计
SOMA 的设计原则只有两条:一个能改变视角的头部相机,以及一份全局空间记忆。系统的运行方式可以概括成一个三段式回路:
- 触发:轻量检测器先判断指令目标是否可见,只有看不见时才启动主动扫描,避免每次任务都付出扫描成本。
- 构建:头部相机按预定轨迹扫描工作区,感知栈把多视角观测融合成初始记忆 $\mathcal{M}_0$。
- 精炼与检索:操作过程中新观测不断融入记忆,得到当前记忆 $\hat{\mathcal{M}}_t$;视觉-语言 token 再从中检索任务相关线索,增强动作预测。
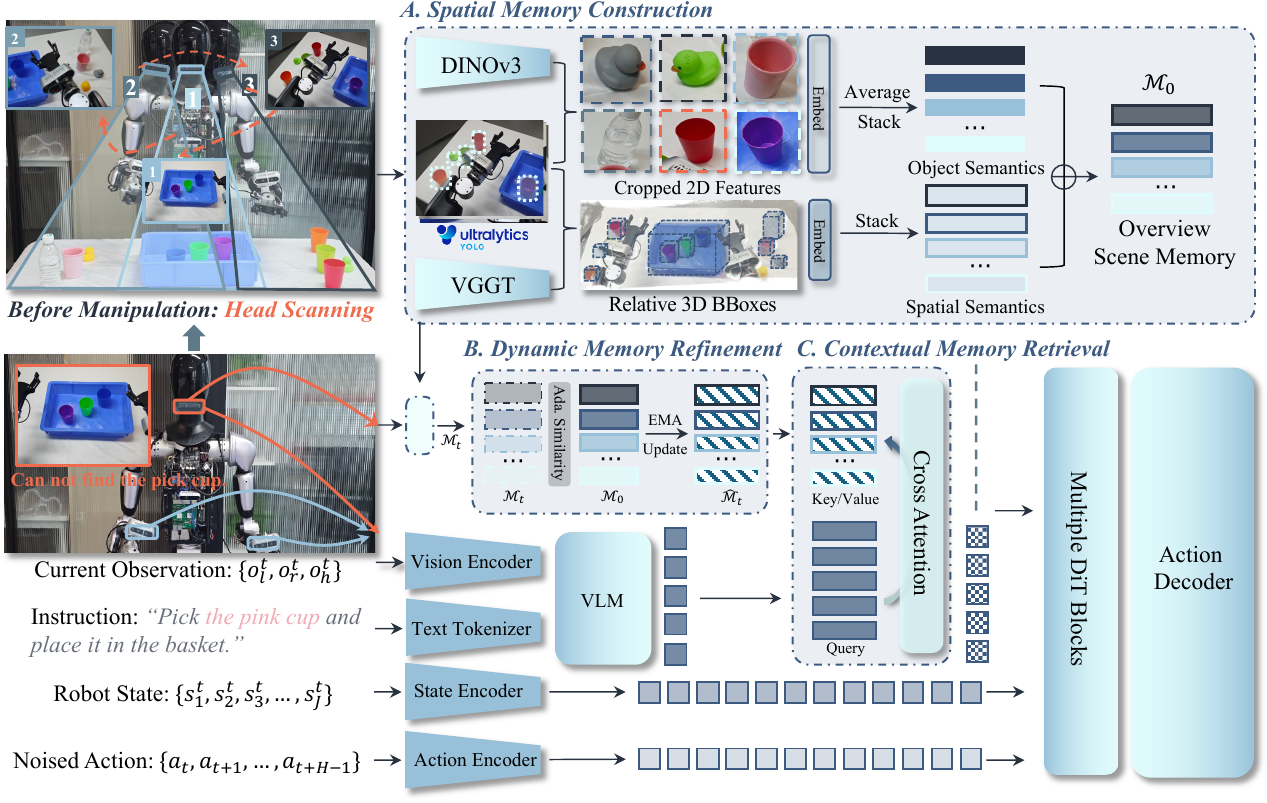
图 2:SOMA 框架总览——(A) 扫描构建统一空间–语义记忆 M0;(B) 操作中以相似度加权融合新观测得到更新后的记忆;(C) 用指令条件化的 token 检索记忆,增强 DiT 的动作预测。
输入输出与常规 VLA 完全一致:双臂与头部相机的观测 $o_l(t), o_r(t), o_h(t)$、机器人状态、带噪动作序列进,长度为 $H$ 的动作块出。记忆增强后的视觉-语言 token 与状态、动作嵌入一起送入扩散变换器(DiT)与动作解码器,原本的动作头一行都不用改。
分类全景
记忆的三种角色对应三个可独立替换的模块,这也是消融实验的切分依据:
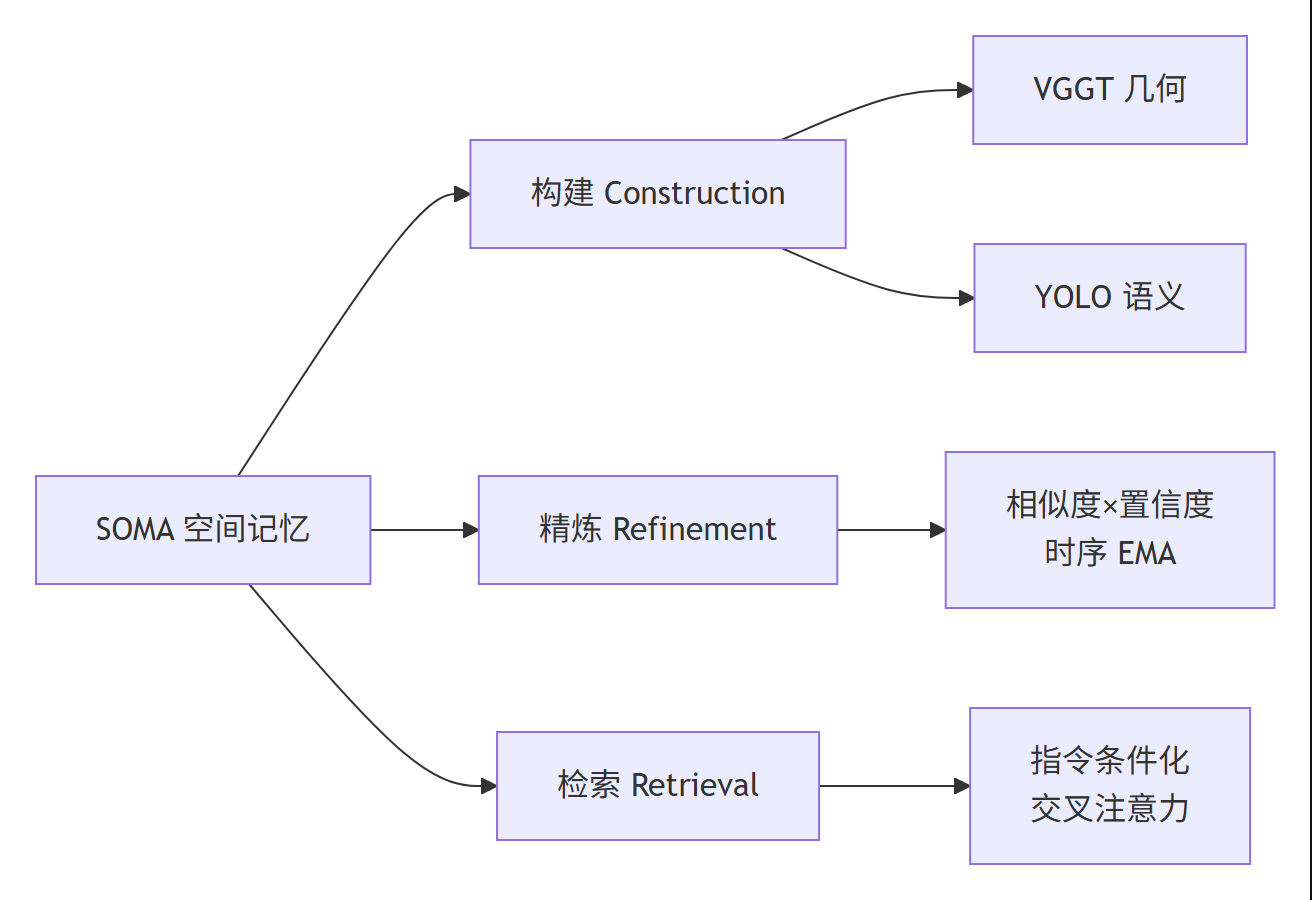
图 8(Mermaid 分类图):SOMA 空间记忆的三种角色——构建(VGGT 几何 + YOLO 语义)、精炼(相似度×置信度的时序 EMA 更新)与检索(指令条件化交叉注意力),三者对应三个可独立替换的模块。
方法细节
1) 空间记忆构建(Spatial Memory Construction)
扫描视频按每 $N$ 帧采样一次,采样出来的每一帧都过同一套感知栈:VGGT 提供相机位姿与场景几何,YOLO 负责物体检测与分类,DINOv3 抽取实例级外观嵌入。二维检测框借助几何先验抬升到全局坐标系,得到三维框 $\mathbf{b}_k$;同类别实例再按外观余弦相似度与三维空间一致性做关联与融合,消去跨视图重复。每个实例最后是一组三元组:外观特征 $\mathbf{f}_k$、类别 $c_k$、三维框 $\mathbf{b}_k$。
把外观特征投影到记忆空间、再把三维框编码成位置向量,两者相加就得到一枚记忆 token:$\mathbf{m}k(0) = \Phi{\text{mem}}(\mathbf{f}k) + \Phi{\text{pos}}(\mathbf{b}_k)$。全部记忆 token 构成初始的场景记忆 $\mathcal{M}_0$——它既是语义的(知道这是什么),也是几何的(知道这在哪)。
2) 动态记忆精炼(Dynamic Memory Refinement)
环境在变:物体会移动、被遮挡、重新出现。所以记忆必须可写。当前帧实例先与上一时刻记忆里同类别条目做关联,命中后用两个分数决定更新力度——语义相似度 $s_{kj}(t)$ 衡量新旧观测是否指向同一个物体,融合置信度 $g_{kj}(t)$ 衡量这次更新是否可信,两者的乘积构成自适应更新系数 $\alpha_{kj}(t) = g_{kj}(t) \cdot s_{kj}(t)$。
记忆随后做时序指数移动平均更新,即 $\mathbf{m}k(t) = \alpha{kj}(t)\,\mathbf{m}j(t) + (1-\alpha{kj}(t))\,\mathbf{m}_k(t-1)$。这套机制的效果是双面的——视图小幅变化时记忆保持稳定,场景真正变化时记忆快速吸收。没有匹配上的新实例追加为条目,没有匹配上的历史条目继续保留,这正是它不会被暂时遮挡欺骗的原因。
3) 指令条件化的记忆检索(Contextual Memory Retrieval)
记忆对齐后作为键值对,视觉-语言 token 作查询做交叉注意力,得到增强表示 $\mathbf{X}_{\text{boost}}$,作为全局上下文注入 DiT。这一步把"场景里有什么"与"指令要什么"对齐起来:模型不是把整份记忆一股脑塞进上下文,而是按指令选择性激活任务相关的空间线索。
4) 真机平台
方法能在真机上跑起来,靠的是自研人形平台与一套 VR 遥操系统:操作者用 Meta Quest 3 追踪 6-DoF 手部位姿,配合 GELLO 式外骨骼做关节级映射,头部视角同样由人主动控制——平台细节与数据规模见实验部分。
实验设计与结果
论文用两条证据链:真机回答"有没有用",仿真回答"为什么有用"。
真机基准设计了五类视野外抓放任务,难度递增:
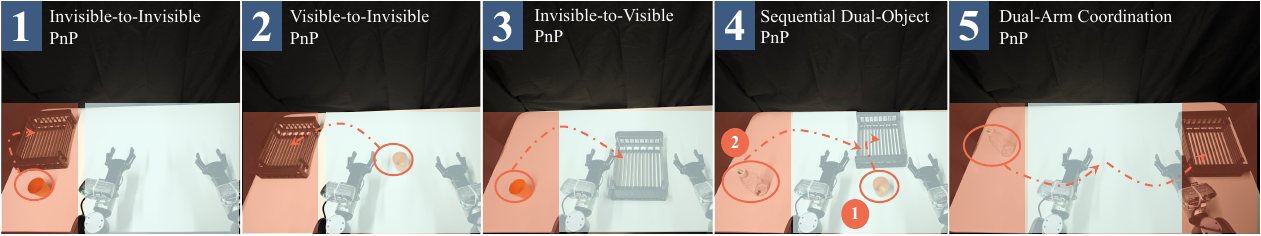
图 3:真机评测的五个视野外抓放任务设置——任务 1–3 用左臂抓取当前视野外的物体并放入篮子,任务 4 追加顺序双物体,任务 5 要求双臂协同。
| 任务 | 考察能力 | 采集量 |
|---|---|---|
| Invisible-to-Invisible | 目标与落点都在视野外,全程无直接观测 | 400 条演示 |
| Visible-to-Invisible | 目标位置的空间回忆 | 400 条演示 |
| Invisible-to-Visible | 隐藏物体的空间回忆与精确执行 | 400 条演示 |
| Sequential Dual-Object | 记忆跨阶段保持与复用 | 400 条演示 |
| Dual-Arm Coordination | 双臂共享的全局空间表示 | 400 条演示 |
评测协议为每任务 20 个回合、分 Pick / Place 阶段统计成功率,另设五类行为指标刻画执行风格。
真机主结果:SOMA 在五个任务上全部最优。固定头部变体一旦目标或落点出视野就崩,暴露纯视野依赖策略的脆弱性;带主动头部的 StarVLA、SpatialVLA 与 GR00T-N1.5 能部分恢复可见性,却在多阶段与双臂任务上退化,因为它们没有跨阶段持久的空间信息。
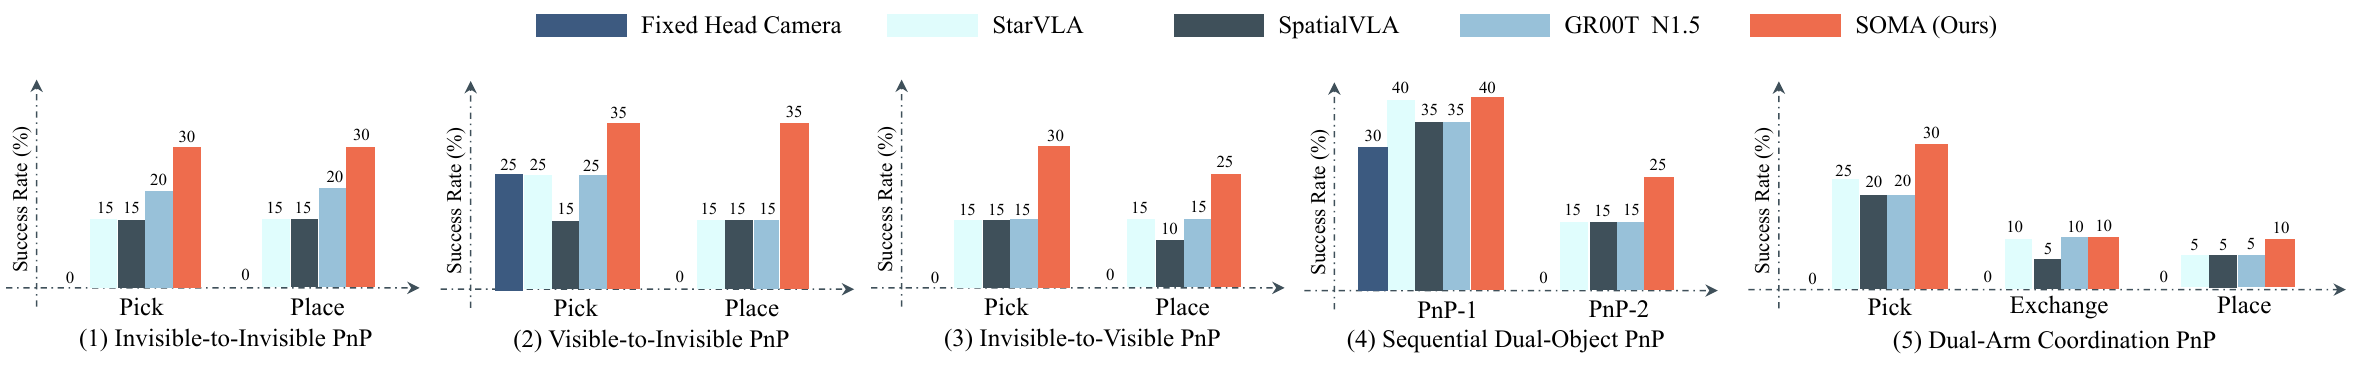
图 4:五个真实世界视野外任务的成功率对比——Fixed Head Camera 为固定头部变体;StarVLA、SpatialVLA、GR00T N1.5 与 SOMA 均在主动头部下训练以保证公平,每任务 20 个回合。
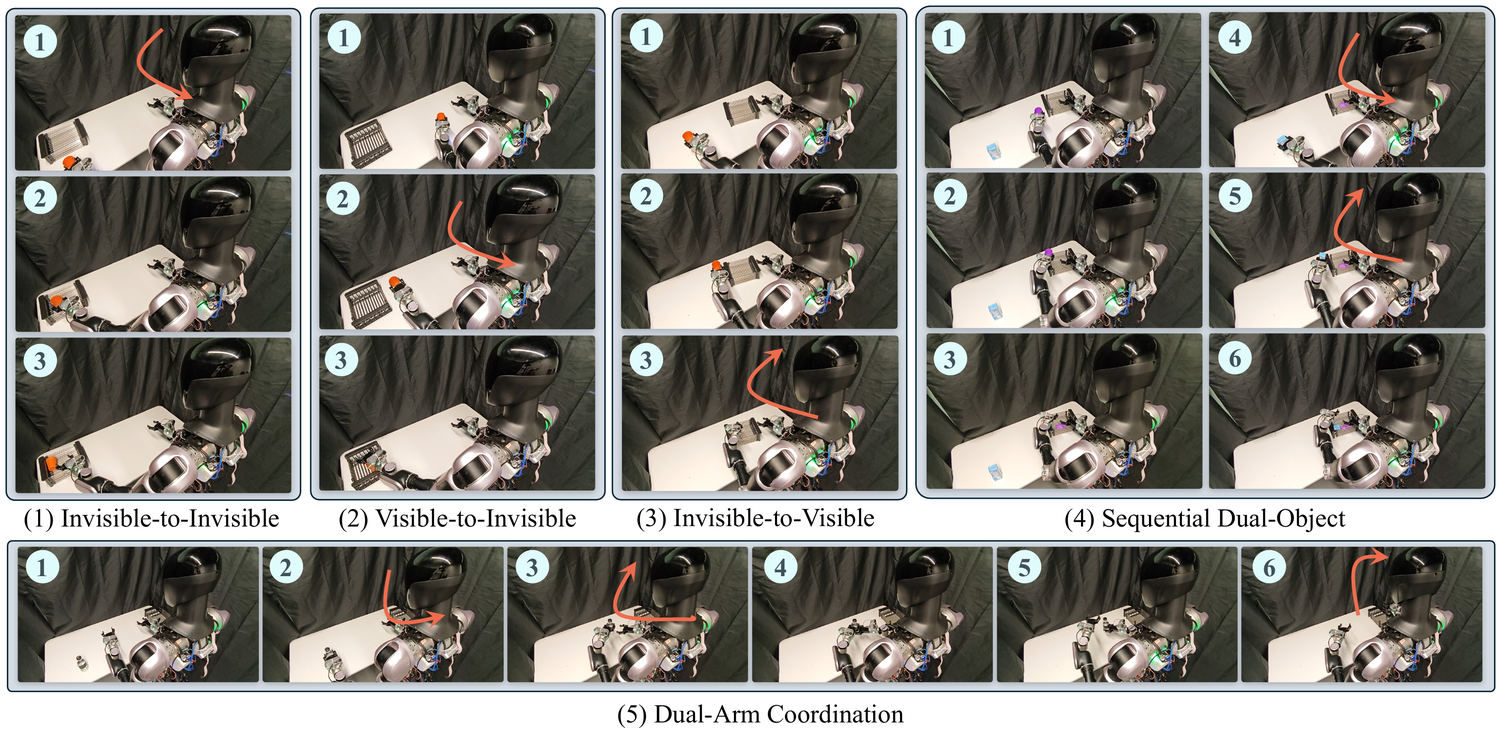
图 5:SOMA 在五个真机视野外任务上的执行示例——先扫描建立空间记忆,再在目标不可见时依据记忆完成接近、抓取与放置。
扫描与记忆的消融(平均成功率 %)给出收益归属:
| 任务 | Scan+GR00T | No-Scan SOMA | Scan-only SOMA | Full SOMA |
|---|---|---|---|---|
| Task 1 | 19.0 | 20.0 | 25.0 | 30.0 |
| Task 2 | 22.0 | 24.0 | 29.0 | 35.0 |
| Task 3 | 16.0 | 17.5 | 22.5 | 27.5 |
| Task 4 | 25.0 | 26.0 | 30.0 | 32.5 |
| Task 5 | 10.5 | 11.7 | 14.2 | 16.7 |
| 平均 SR (%) | 18.5 | 19.8 | 24.1 | 28.3 |
结论很明确:扫描只提供覆盖,主要收益来自记忆的持续精炼与复用——只会扫不会记的基线最差,而操作中持续更新记忆的完整模型最好。
仿真结果。RoboCasa Tabletop GR1 上所有物体都可见,本来是对记忆机制不利的场景,SOMA 仍以 300 条演示取得 52.0% 的平均成功率(用满数据 49.3%),超过 GR00T N1.5 的 45.9% 与扩散策略的 39.2%。SimplerEnv 的视觉匹配协议下平均 63.2% 位列第一,比 RoboVLM 高 2.6 个点、在最难的 Pick Coke Can 上高 7.7 个点;变体聚合协议下平均 52.5%,同样第一。
代价:真机推理延迟 1.58 秒/动作块,相比 GR00T N1.5 的 1.30 秒只多出 0.28 秒;几何来源上,用深度相机点云融合是 22.6% 成功率、0.18 秒,用 VGGT 估计几何与位姿是 27.3%、0.21 秒——多花 0.03 秒换来 4.7 个百分点。
组件消融(GR1,SR %):去掉几何线索降到 45.1,去掉物体语义降到 43.7,去掉动态更新降到 41.5,完整模型 49.3;更新策略上,只用语义相似度 40.7、只用融合置信度 44.2、简单 EMA 41.0,两者相乘才到 49.3;采样间隔 10 / 20 / 30 / 40 分别对应 44.9 / 49.3 / 44.9 / 44.4,间隔 20 最优。
真机数据与平台。五个任务各采集 400 条专家演示,降采样 2× 后得到 711,524 帧、平均 12.74 Hz,约合 15.52 小时。作者用一套确定性质检规则逐条轨迹过筛,剔除六类坏数据:动作延迟 ≥300 ms、夹爪抖动、夹爪数值溢出(1001–1010)、相机被人身遮挡或模糊、俯视抓取策略、丢帧 ≥2.5。这份清单可以直接搬到任何遥操采集流程里。承载它的硬件是自研人形平台:两条 7-DoF 机械臂配自适应夹爪、2-DoF 云台头部、头部与双腕各一台 RealSense D435、机载 NVIDIA Jetson AGX Orin(64 GB)——头部相机的可动性正是主动扫描的硬件前提。
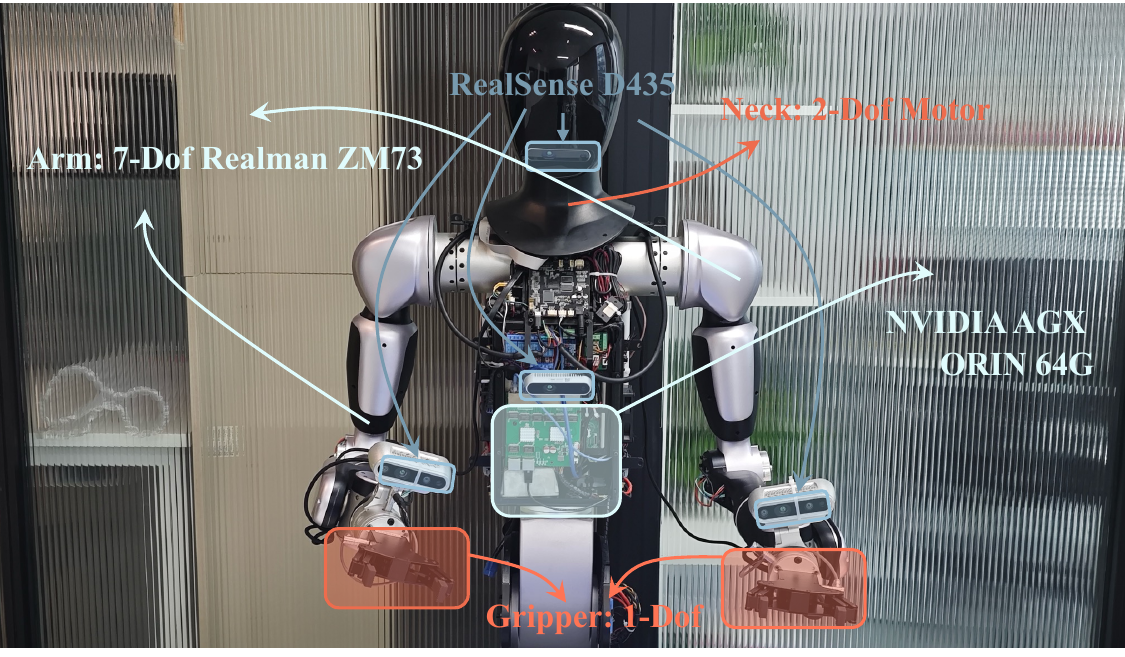
图 6:自研人形机器人平台——双臂 7-DoF、2-DoF 主动头部与三路 RGB-D;头部相机的可动性是 SOMA 主动扫描的硬件前提。
结果对比总结
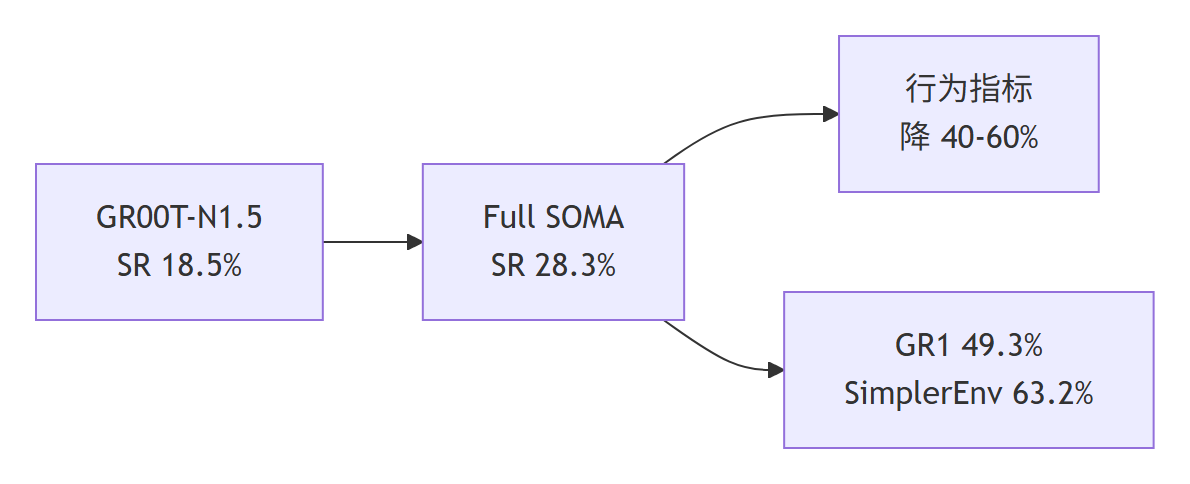
图 9(Mermaid 结果图):结果对比总结——从 GR00T-N1.5 的 18.5% 到完整 SOMA 的 28.3%,行为指标下降 40–60%,并在 RoboCasa GR1(49.3%)与 SimplerEnv(63.2%)上同步领先。
关键发现
- 行为方式变了,而不只是分数高了:首次注视耗时从 13.2 秒降到 6.9 秒,头部搜索路径从 91.7 度降到 46.2 度,视角修正次数 2.7 → 1.4,抓取尝试次数 2.3 → 1.2,抓取用时 48.0 秒 → 24.8 秒(均为五任务均值,由论文 Table 3 推算,逐任务降幅区间 40–60%)。最难的双手任务 5 上,头部搜索路径从 164.0 度降到 70.4 度。
- 记忆不是"补救措施":在全部物体可见的 RoboCasa GR1 上,SOMA 只用 30 条演示就拿到 48.3%,已超过用满数据的 GR00T N1.5(45.9%),说明几何锚定的场景表示本身就是更强的归纳偏置。
- 两条模态都不可省:从记忆里拿掉物体语义掉到 43.7%,拿掉几何线索掉到 45.1%,完整模型 49.3%——语义负责"是什么",几何负责"在哪",缺一不可。
- 收益来自记忆而非扫描:只会扫不会记的基线只有 18.5%,即便只用单帧初始化记忆也有 19.8%,而持续精炼的完整模型达到 28.3%。
- 代价可控:推理延迟 1.58 秒/动作块与基线同量级,额外开销约 0.28 秒;样本效率上 30 条演示即超过基线满数据。
- 真机瓶颈在执行侧:25 条失败轨迹里 48% 是动态视角下抓取位姿不准、32% 是放置时机与精度误差、20% 是头臂协同错配——定位往往是准的,"边看边动"的精确执行才是难点。
局限性
作者对边界的描述比较克制,主要三条:
- 动态与参数敏感:记忆构建依赖准静态场景的短时扫描,实例关联与融合阈值是全局固定的;完全动态的场景、更嘈杂的自运动与密集堆叠需要实时跟踪、置信度重扫与逐 token 的几何置信度,把匹配准则从手工阈值学成参数是自然的下一步。
- 粒度与规模:记忆是对象级的(位置 + 外观),分不清"抽屉被拉开"这类语义状态变化,多阶段任务因此吃亏;扩展到移动操作或房间级场景需要分层记忆结构与 SLAM 式闭环对齐来控制漂移。
- 执行侧瓶颈:真机失败更多来自"记忆给出的定位是对的,但头部还在运动时抓不准",需要更紧的头-臂协同与视角稳定化的动作解码。
- 安全与社会影响:持久记忆会过期、会出错,可能危及人机共处场景;作者建议以置信度打分、重扫触发、记忆过期、端侧存储与人在回路确认来缓解。
另外,从复现角度看还有两处需要留心:论文中基线名称同时出现 GR00T N1.5 与 GR00T-N1.5 两种写法,GR1 平均成功率也存在 52.0%(300 条)与 49.3%(Full)两个口径并列出现的情况;行为对比只与 GR00T-N1.5 一个基线进行,阅读时需要注意口径。
常见问题(FAQ)
SOMA 与已有 VLA 最大的区别是什么?
已有的可动相机方法(ViA、ActiveUMI)会去看,但不留记忆、也不吃语言指令;记忆类方法(MemoryVLA、MemER)有记忆,但服务的是时间维度的短程上下文。SOMA 把记忆做成几何锚定的场景状态:每枚记忆 token 同时带外观语义与三维位置,既能被指令检索,也能被新观测改写。
五个行为指标分别衡量什么?
首次注视耗时衡量"从看见到动手"的决断速度(目标首次进入视野到手臂开始抓取,靠离线人工标注保证精度);头部搜索路径是目标可见前的头部累计角位移;视角修正次数统计目标被看到之后头部重新对准的次数;抓取尝试次数是直到成功为止的夹爪闭合次数,接近 1 即"一次抓中";抓取用时则是从回合开始到抓取成功的总步数。
为什么要在"所有物体可见"的仿真上验证记忆?
RoboCasa GR1 与 SimplerEnv 上所有物体都可见,看起来与视野外操作无关。但正因为如此,它能把"记忆设计的贡献"与"视角获取的贡献"分开:SOMA 在这两套基准上同样领先(49.3% / 63.2%),说明记忆带来的不是"看得到",而是更结构化的归纳偏置。
主动扫描会不会拖慢机器人?
扫描只在目标不可见时触发,且记忆构建在数据预处理阶段离线完成。在线推理测得 1.58 秒/动作块,相比 GR00T N1.5 的 1.30 秒只多 0.28 秒,与 StarVLA(1.26 秒)、SpatialVLA(1.45 秒)处在同一量级。
采样间隔为什么选 20?
间隔 10 会引入冗余与噪声更新(44.9%),间隔 30 与 40 让场景表示过稀疏(44.9% / 44.4%),间隔 20 在信息密度与时间多样性之间取得最优平衡,平均成功率 49.3%。
这套记忆能直接接到别的 VLA 上吗?
可以。记忆模块与具体动作头解耦:增强后的视觉-语言 token 只是作为额外上下文注入扩散变换器,原动作头无需改动。检索模块的消融也显示三层交叉注意力在效果与复杂度之间最平衡(49.3%,优于 Light 的 42.8% 与 Heavy 的 44.4%)。
参考链接
- 论文 arXiv 摘要页:arXiv:2605.22283
- 真机与 GR1 基线:GR00T N1.5(arXiv:2503.14734)
- 可动相机探索线:ActiveUMI(arXiv:2510.01607)
- 空间 grounding 基线:SpatialVLA(arXiv:2501.15830)
- 记忆中心 VLA:MemoryVLA(arXiv:2508.05612)
- 仿真基准:RoboCasa(arXiv:2406.02523)、SimplerEnv(arXiv:2405.05941)
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献56条内容

所有评论(0)