数据是具身智能“大脑“的胜负手
当具身智能从"拼身体"转向"拼大脑",行业竞争重心正从VLA模型架构的比拼,深入到数据的真实性、多样性与交互密度。在这场决定具身大脑能力上限的竞赛中,高质量数据底座不再是"幕后工程",而是定义AI能力边界的战略基础设施。
一、具身智能进入"拼大脑"时代
进入2026年,具身智能行业最显著的变化是讨论重心的位移——从"身体"转向"大脑"。资本的流向是最敏锐的信号:今年上半年国内具身智能赛道融资中,超过一半流向了以"大脑"为主的公司。资本不再单纯为"人形"外观买单,而是聚焦于智能体在复杂场景下的实际履约能力。
灼识咨询发布的《具身智能大脑行业白皮书》给出了一个清晰的定义:具身大脑负责多模态环境理解与任务推理,形成自主决策能力,基于任务目标生成动作规划与执行策略,并支持跨场景泛化和持续学习。简而言之,具身大脑要解决的,是让机器人从"指令执行"走向"自主决策"。
这一转变引出一个更根本的问题:机器人的"大脑"从哪里来?如果只是执行预设指令,传统自动化设备已经足够。但要让机器人真正进入药房、商超、酒店、家庭这些充满不确定性的真实场景,它需要的不仅是算法架构的突破,更需要一个能够支撑环境理解、后果推演和自主决策的高质量数据体系。而这,正是数据服务商被推到台前的根本原因。
二、技术跃迁:从VLA到WAM,数据需求同步升级
过去一段时间,VLA(Vision-Language-Action)几乎成为具身智能大模型最主流的技术叙事。它将视觉、语言与动作统一建模,让机器人从识别物体并执行单点动作,进化到理解自然语言任务并结合视觉环境生成动作序列。Figure的Helix 02已经能通过单一神经系统完成洗碗机全流程装卸。
但VLA有其边界。其能力更多建立在当前观测到的环境状态与已有动作先验之上,建模重点在于"当前该做什么",对动作执行后物理世界将如何变化缺乏显式的预测与推演。在需要连续接触、精细力控、动态应对的复杂任务中,这种反应式的映射方式容易暴露局限。
于是,世界模型开始进入讨论圆桌,进而催生了世界动作模型(World Action Model, WAM)——将"未来状态预测"和"动作生成"放进同一个闭环,通过预测未来环境状态并生成对应动作序列,实现环境理解、状态预测与动作决策的一体化建模。
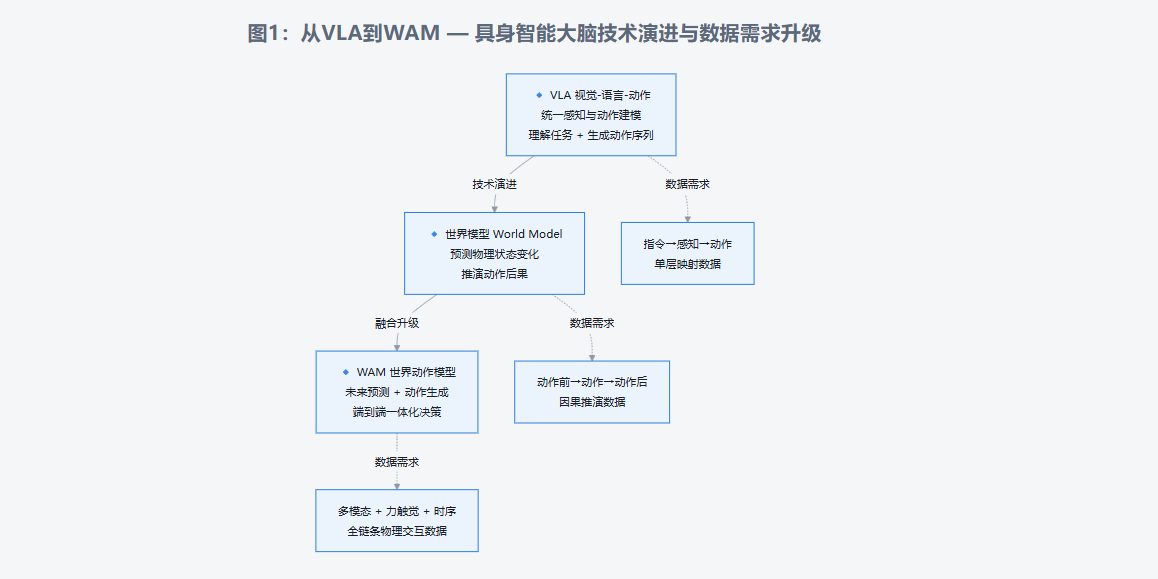
当模型需要理解"拿起鸡蛋前会发生什么",训练数据就必须包含力的方向、物体的材质、接触点的反馈、以及动作后果的全链条信息。这对数据采集、标注和质检提出了全新的要求——不仅要多模态(视觉+触觉+力觉+语音),还要具备物理世界的深层语义。
三、数据竞争新范式:真实性正取代规模
在具身智能领域,模型架构决定具身大脑的上限,而数据质量决定模型能否真正抵达这个上限。灼识咨询白皮书给出了一个清晰判断:具身大脑训练数据正从互联网通用数据向多源真实世界数据体系演进。
这是一个深刻的认知切换。互联网视频数据即便规模显著、获取成本低,但因缺乏物理世界的深度信息与因果律,在训练WAM这类需要"预测后果"的模型时捉襟见肘。竞争焦点已从单纯的数据吞吐量,转向了数据的"物理真实性"与"交互密度"。
对数据服务商而言,这意味着四个维度的能力升级:
第一,多模态融合能力。单一模态的标注已不足以支撑WAM的训练需求。具身大脑需要视觉(2D/3D)、点云、IMU惯性数据、力触觉、语音等多模态数据的协同标注,且各模态之间需要保持时序和语义的一致性。
第二,物理真实性保障。仿真数据虽然可以快速生成,但"仿真到真实"的鸿沟(Sim-to-Real Gap)仍然显著。真机数据和无本体采集数据因为携带真实的物理交互信息,正在成为最具价值的数据资产。
第三,场景多样性与任务针对性。具身智能的商业化路径是从结构化场景(药房、工厂)逐步走向半结构化(商超、酒店)和开放场景(家庭)——每一步都对数据提出了不同的场景覆盖要求。
第四,全链路质控。当标注精度直接影响机器人在真实世界中的操作安全性,"差不多"不再被允许。全链路质量控制——从标注规范、过程管控到多级质检——成为核心竞争力。
四、破解"数据悖论":无本体数据与核数聚的解法
具身智能行业长期面临一个尴尬的"数据悖论":要训练通用模型,需要大规模真机数据;要获得大规模真机数据,需要大量真机部署;要部署大量真机,又需要可靠的模型。这个恶性循环让许多团队在数据采集阶段就耗尽了资源和耐心。
行业正在探索两条破局路径。其一是无本体数据采集——通过不必附着于具体机器人形态的采集设备进行数据采集,让模型先理解物理世界的运行规律,再迁移到具体本体和任务上。
其二是数据闭环——从真实场景中采集数据、训练模型、部署到场景中,再从实际运行结果反哺模型训练。数据的真正价值,在于它是否足够真实、足够多样、足够接近物理世界的本质规律。
这两条路径,恰好构成了数据服务商的核心价值空间。核数聚作为国内领先的AI数据资源与服务提供商,正是在这一逻辑下找到了自己的定位。
五、核数聚:为具身大脑打造数据底座
核数聚科技定位为国内领先的人工智能数据资源与服务提供商,深度赋能300余家全球AI顶尖企业,覆盖乐聚、鹿明、穹彻、自变量、Momenta、博世、思必驰等具身智能与自动驾驶领域的头部客户,并与50余所高校建立产教融合合作生态。
从"AI预标注+人工精修"到具身智能全栈服务
核数聚自主研发数据采集、智能标注、模型服务三大核心平台,创新落地"AI预标注+人工精修"人机协同模式。由自研预标注引擎批量完成自动框选、目标跟踪、模态匹配等基础工作,标注效率提升3-5倍,再经专业人员对瑕疵、漏标、错标内容逐一修正优化,最终实现99.5%以上的数据精度[2]。
在具身智能方向,核数聚已构建起从场景搭建、数据采集、标注质检到定制化数据集生产的全生命周期服务能力,覆盖2D图像、3D点云、视频时序、语音语义、物体交互等全品类多模态标注,适配VLA、WAM等不同架构模型的训练需求。
真实场景验证:从实验室到商业闭环
核数聚在具身智能领域的落地案例已形成差异化的竞争壁垒。在与国内知名具身智能厂商的合作中,核数聚完成了覆盖2D/视频/3D点云的多模态场景适配,聚焦分拣、上料、质检等高频工业任务,标注精度达99.7%,单任务处理量超过5000条,直接对接3C工厂、汽车制造等真实生产场景。
在服务机器人领域,核数聚为头部人形机器人企业提供"视觉+力觉+语音"融合标注数据,支撑机器人完成端茶、搬运、人机对话等家庭场景任务,助力模型从Demo验证走向真实场景部署[4]。
更具标志性的是,核数聚联合苏州智能机器人科技打造的四足机器人巡检数据集,聚焦园区设施巡检场景,标注数据覆盖消防、电力设施异常预警、车辆违停识别等场景,使机器人自主避障成功率提升12%-15%,并入选2026年江苏省数据知识产权典型案例。
数据资产化:标注产业的下一程
当行业还在讨论数据量和标注效率时,核数聚已率先推动数据从"服务产品"向"核心资产"的转化。在江苏省落地的首单"数据资产入表+苏知贷"业务中,核数聚首创"数据知识产权区域公益开放许可模式",斩获千万级授信。这一突破意味着,高质量标注数据不再仅仅是模型训练的"耗材",而是可以被定价、确权、流通的数字化资产。
随着国家数据局在32个城市部署第二批数据标注先行先试工作,形成"7+32"国家级数据标注网络格局,数据标注产业正经历前所未有的政策红利期。核数聚积极联动产业链上下游,与苏州大学、哈工大苏研院等高校共建"数据要素研究中心"与高技能实训基地,并参与行业标准制定,推动数据标注格式统一、规范统一、接口统一。
六、结语:定义数据标准,就是定义AI能力的上限
回顾具身智能的技术演进,从VLA到世界模型再到WAM,每一步跃迁都在提出更高的数据需求。具身大脑的商业化路径——从抓取、放置、分拣等即时接触任务起步,向酒店服务、物流、养老等复杂服务运营场景拓展,最终走向家庭服务和个人护理——每一步也都对应着不同层次的数据复杂度。
机器人产业真正需要的,是一个能够持续把任务经验抽象出来、并将能力迁移到下一种任务、下一台机器、下一个场景的"大脑"。而支撑这个大脑的,从来不是某一种模型的胜利,而是模型、数据、控制与场景的系统化协同。
核数聚在这条价值链上的位置正在变得越来越清晰:它不是算法公司,不是机器人本体企业,却是连接"数字世界"与"物理世界"的关键桥梁。当具身智能从Demo走向量产、从实验室走向商业闭环,高质量数据底座不再是可选项,而是定义AI能力上限的战略基础设施。
正如行业正在认识到的那样:谁能定义高质量数据的标准,谁就能定义AI能力的上限。在这场具身大脑的竞赛中,数据服务商正在从"幕后工程队"走向"基础设施定义者"。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献16条内容

所有评论(0)