PyTorch强化学习实战(25)——深度确定性策略梯度(DDPG)
PyTorch强化学习实战(25)——深度确定性策略梯度(DDPG)
0. 前言
在连续动作控制领域,优势演员-评论家 (Advantage Actor-Critic, A2C) 方法受限于其同策略本质,采样效率低下。深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG) 将策略从随机分布转变为确定性映射,并借助异策略学习框架,允许智能体像深度Q网络 (Deep Q-Network, DQN) 那样复用历史经验。通过巧妙结合演员-评论家架构与链式法则,DDPG 实现了端到端的可微优化,同时利用 Ornstein-Uhlenbeck 过程注入探索噪声。本文将深入解析 DDPG 的核心原理与实现细节,并展示其在四足机器人控制任务上的出色表现。
1. 深度确定性策略梯度
1.1 算法原理
深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG) 是一种演员-评论家方法,但具有异策略的优秀特性。解释该方法最简单的方式是通过与传统优势演员-评论家 (Advantage Actor-Critic, A2C) 方法进行比较。A2C 中的演员估计随机策略——返回离散动作的概率分布或正态分布参数。这两种情况下策略都是随机的,即采取的动作从该分布中采样。
确定性策略梯度同样属于 A2C 类别,但它的策略是确定性的,这意味着它直接根据状态给出应采取的动作。这使得我们可以对Q值应用链式法则,通过最大化Q值来改进策略。为了理解这一点,我们首先理解演员与评论家在连续动作域中如何关联。
我们先从演员开始,我们希望它针对每个给定状态输出动作。在连续动作域中,每个动作都是数值,因此演员网络以状态为输入,返回 N 个值(每个动作对应一个)。这种映射是确定性的——相同输入总是产生相同输出(推理过程不使用 dropout 等随机性元素,仅使用普通前馈网络)。
接下来,介绍评论家。评论家的作用是估计Q值,即在某个状态下采取的动作的折扣奖励。由于动作是数值向量,评论家网络需要接受两个输入:状态和动作。评论家的输出为单个数值(即Q值)。这种架构与深度Q网络 (Deep Q-Network, DQN) 不同(当动作空间离散时,为效率起见会一次性返回所有动作值)。该映射同样具有确定性。
所以,我们有两个函数:
- 演员函数 μ ( s ) μ(s) μ(s):将状态转换为动作
- 评论家函数 Q ( s , a ) Q(s,a) Q(s,a):通过状态和动作给出Q值
我们可以将演员函数代入评论家,得到仅含状态输入参数的表达式:
Q
(
s
,
μ
(
s
)
)
Q(s,μ(s))
Q(s,μ(s))。毕竟神经网络本质上就是函数。
现在,评论家的输出给出了我们最初希望最大化的目标——折扣总奖励的近似值。该值不仅取决于输入状态,还取决于演员网络参数
θ
μ
θ_μ
θμ 和评论家网络参数
θ
Q
θ_Q
θQ。在每次优化步骤中,我们都希望通过调整演员权重来提升总奖励。从数学角度来看,我们需要求策略梯度。
Silver 等人在确定性策略梯度定理中证明:随机策略梯度等价于确定性策略梯度。换句话说,要改进策略,我们只需要计算
Q
(
s
,
μ
(
s
)
)
Q(s,μ(s))
Q(s,μ(s)) 函数的梯度。通过应用链式法则,得到梯度:
∇
a
Q
(
s
,
a
)
∇
𝜃
μ
μ
(
s
)
∇_a Q(s,a) ∇_{𝜃_μ} μ(s)
∇aQ(s,a)∇𝜃μμ(s)。
需要注意的是,尽管 A2C 和 DDPG 方法都属于 A2C 类型,但评论家的使用方式有所不同。在 A2C 中,评论家作为经验轨迹奖励的基线参考,属于可选组件(去掉即得到 REINFORCE 方法),主要用于提升稳定性。这是因为 A2C 采用随机策略,导致反向传播能力受限(无法对随机采样步骤求导)。
DDPG 则采用截然不同的方式使用评论家。由于策略是确定性的,现在可以直接从评论家网络输出的Q值计算梯度(该网络使用演员生成的动作,如下图所示),因此整个系统可微分,并能通过随机梯度下降 (Stochastic Gradient Descent, SGD) 进行端到端优化。为更新评论家网络,可采用贝尔曼方程求取 Q(s,a) 的近似值并最小化均方误差目标。
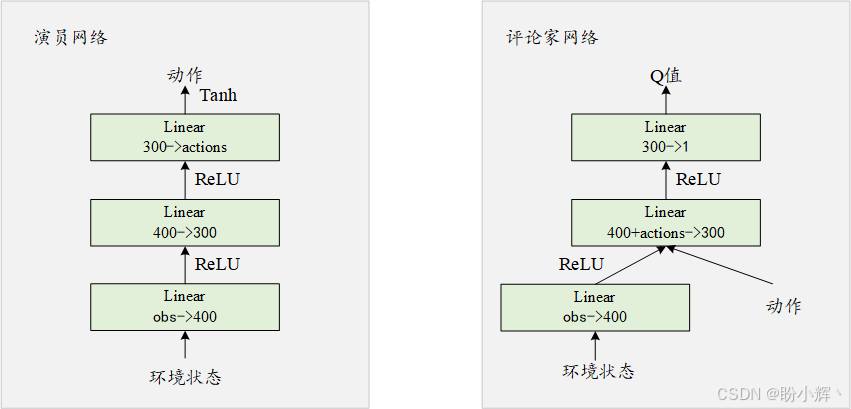
这些原理看似晦涩,但背后理念十分简洁:评论家的更新方式与 A2C 一致,演员的更新则以最大化评论家输出为目标。该方法的精妙之处在于支持异策略学习,这意味着可以像 DQN 训练那样使用大型经验回放池等技巧。
1.2 探索机制
为此优势付出的代价是策略变为确定性,因此需要以某种方式探索环境。我们可以在将演员返回的动作传递给环境前添加噪声。有多种方法可以做到这一点,最简单的方法是在动作上直接添加随机噪声
μ
(
s
)
+
𝜖
N
μ(s)+𝜖N
μ(s)+𝜖N。
更高级(有时效果更好)的探索方式是使用 Ornstein-Uhlenbeck (OU) 过程(在金融和其他处理随机过程的领域非常流行)。该过程模拟受摩擦力影响的大质量布朗粒子的速度,由随机微分方程定义:
∂
x
t
=
𝜃
(
μ
−
x
t
)
∂
t
+
σ
∂
W
t
∂x_t = 𝜃(μ − x_t) ∂t + σ∂W_t
∂xt=𝜃(μ−xt)∂t+σ∂Wt
其中
𝜃
𝜃
𝜃、
μ
μ
μ、
σ
σ
σ 是过程参数,
W
t
W_t
Wt 是 Wiener 过程。在离散时间情况下,OU 过程可写为:
x
t
+
1
=
x
t
+
𝜃
(
μ
−
x
t
)
+
σ
N
。
x_{t+1} = x_t + 𝜃(μ − x_t) + σN。
xt+1=xt+𝜃(μ−xt)+σN。
该方程通过噪声前值加上正态噪声𝒩来表达过程生成的下一值。在探索中,我们将 OU 过程值添加到演员返回的动作中。
2. 实现深度确定性策略梯度
本节包含三个源文件:
- model.py 包含模型和智能体
- common.py 包含用于解包批次的函数
- train_ddpg.py 包含启动代码和训练循环
模型包含演员和评论家两个独立网络,演员极为简单——仅含两个隐藏层的前馈网络:输入观测向量,输出包含 N 个值的动作向量。输出动作经过双曲正切非线性变换,将值压缩到 −1 到 1 的范围内。
评论家稍显特殊,它包含两个独立的路径来处理观察和动作,二者拼接后转换为单个数值的评论家输出。上图展示了两个网络的结构。
(1) 演员代码包含生成动作值的三层网络:
class DDPGActor(nn.Module):
    def __init__(self, obs_size: int, act_size: int):
        super(DDPGActor, self).__init__()

        self.net = nn.Sequential(
            nn.Linear(obs_size, 400),
            nn.ReLU(),
            nn.Linear(400, 300),
            nn.ReLU(),
            nn.Linear(300, act_size),
            nn.Tanh()
        )

    def forward(self, x: torch.Tensor):
        return self.net(x)
(2) 类似地,评论家代码如下:
class DDPGCritic(nn.Module):
    def __init__(self, obs_size: int, act_size: int):
        super(DDPGCritic, self).__init__()

        self.obs_net = nn.Sequential(
            nn.Linear(obs_size, 400),
            nn.ReLU(),
        )

        self.out_net = nn.Sequential(
            nn.Linear(400 + act_size, 300),
            nn.ReLU(),
            nn.Linear(300, 1)
        )

    def forward(self, x: torch.Tensor, a: torch.Tensor):
        obs = self.obs_net(x)
        return self.out_net(torch.cat([obs, a], dim=1))
评论家的 forward() 函数首先通过其小型网络转换观测值,随后将输出与给定动作拼接并转换为单个Q值。为了使用经验源中的演员网络,需定义将观测转换为动作的智能体类。此类是放置 OU 探索过程最合适的位置——但为实现此功能,我们需要使用智能体新特性,可选状态保持。
其思想很简单:智能体将观测转换为动作。但若需要在观测间保持某些状态呢?我们在优势演员-评论家 (Advantage Actor-Critic, A2C) 一节中实现的智能体是无状态的,但有时这并不足够。OU 过程的问题在于必须在观测间跟踪 OU 值。
(3) 状态化智能体的另一个重要应用场景是部分可观测马尔可夫决策过程 (Partially Observable Markov Decision Process, POMDP)。当智能体观测到的状态不符合马尔可夫属性且缺乏区分状态的完整信息时,就构成 POMDP。这种情况下,智能体需要沿轨迹跟踪状态才能采取行动。因此,实现 OU 探索的智能体代码如下:
class AgentDDPG(lib.agent.BaseAgent):
    """
    Agent implementing Orstein-Uhlenbeck exploration process
    """
    def __init__(self, net: DDPGActor, device: torch.device = torch.device('cpu'),
                 ou_enabled: bool = True, ou_mu: float = 0.0, ou_teta: float = 0.15,
                 ou_sigma: float = 0.2, ou_epsilon: float = 1.0):
        self.net = net
        self.device = device
        self.ou_enabled = ou_enabled
        self.ou_mu = ou_mu
        self.ou_teta = ou_teta
        self.ou_sigma = ou_sigma
        self.ou_epsilon = ou_epsilon

    def initial_state(self):
        return None
(4) 构造函数接受许多参数,初始的 _state() 方法来自 BaseAgent 类,必须在新一轮回合开始时返回智能体初始状态。由于初始状态需与环境动作维度相同(我们需要为环境的每个动作保持独立的探索轨迹),通过返回 None 延迟初始化。在 __call__ 方法中,我们会考虑这一点:
    def __call__(self, states: lib.agent.States, agent_states: lib.agent.AgentStates):
        states_v = lib.agent.float32_preprocessor(states)
        states_v = states_v.to(self.device)
        mu_v = self.net(states_v)
        actions = mu_v.data.cpu().numpy()
该方法是智能体的核心,其目的是将观测状态和智能体内部状态转换为动作。首先将观测转换为适当形式,并请求演员网络将其转换为确定性动作。方法的其余部分通过应用 OU 过程添加探索噪声。
(5) 在此循环中,我们遍历观测批次和上次调用的智能体状态列表,并更新 OU 过程值(直接实现前述公式):
        if self.ou_enabled and self.ou_epsilon > 0:
            new_a_states = []
            for a_state, action in zip(agent_states, actions):
                if a_state is None:
                    a_state = np.zeros(shape=action.shape, dtype=np.float32)
                a_state += self.ou_teta * (self.ou_mu - a_state)
                a_state += self.ou_sigma * np.random.normal(size=action.shape)

                action += self.ou_epsilon * a_state
                new_a_states.append(a_state)
(6) 为完成循环,将 OU 过程产生的噪声添加到动作中,并保存噪声值供下一步使用。最后对动作进行裁剪,确保其落在 -1 到 1 范围内(否则 PyBullet 会抛出异常):
        else:
            new_a_states = agent_states

        actions = np.clip(actions, -1, 1)
        return actions, new_a_states
(7) DDPG 实现的最后部分是 train_ddpg.py 中的训练循环。为提升稳定性,我们使用包含 10 万条转移数据的回放缓存,并为演员和评论家分别设置目标网络:
    act_net = model.DDPGActor(env.observation_space.shape[0],
                              env.action_space.shape[0]).to(device)
    crt_net = model.DDPGCritic(env.observation_space.shape[0],
                               env.action_space.shape[0]).to(device)
    print(act_net)
    print(crt_net)
    tgt_act_net = lib.agent.TargetNet(act_net)
    tgt_crt_net = lib.agent.TargetNet(crt_net)

    writer = SummaryWriter(comment="-ddpg_" + args.name)
    agent = model.AgentDDPG(act_net, device=device)
    exp_source = lib.experience.ExperienceSourceFirstLast(
        env, agent, gamma=GAMMA, steps_count=1)
    buffer = lib.experience.ExperienceReplayBuffer(exp_source, buffer_size=REPLAY_SIZE)
    act_opt = optim.Adam(act_net.parameters(), lr=LEARNING_RATE)
    crt_opt = optim.Adam(crt_net.parameters(), lr=LEARNING_RATE)
我们还使用两个独立优化器以简化演员和评论家的梯度处理。
(8) 在训练循环中,每次迭代时,我们将经验存储到回放缓冲区,并采样训练批次:
                batch = buffer.sample(BATCH_SIZE)
                states_v, actions_v, rewards_v, dones_mask, last_states_v = \
                    common.unpack_batch_ddqn(batch, device)
(9) 随后执行两个独立训练步骤。为训练评论家,需使用单步贝尔曼方程计算目标Q值(目标评论家网络作为下一状态的近似):
                crt_opt.zero_grad()
                q_v = crt_net(states_v, actions_v)
                last_act_v = tgt_act_net.target_model(last_states_v)
                q_last_v = tgt_crt_net.target_model(last_states_v, last_act_v)
                q_last_v[dones_mask] = 0.0
                q_ref_v = rewards_v.unsqueeze(dim=-1) + q_last_v * GAMMA
(10) 获得参考值后,可计算 MSE 损失并让评论家优化器调整权重。该过程与 DQN 训练类似:
                critic_loss_v = F.mse_loss(q_v, q_ref_v.detach())
                critic_loss_v.backward()
                crt_opt.step()
                tb_tracker.track("loss_critic", critic_loss_v, frame_idx)
                tb_tracker.track("critic_ref", q_ref_v.mean(), frame_idx)
(11) 在演员训练步骤中,需沿提升评论家输出的方向更新演员权重。由于演员和评论家都是可微函数,我们只需将演员输出传入评论家,然后最小化评论家返回值的负值:
                act_opt.zero_grad()
                cur_actions_v = act_net(states_v)
                actor_loss_v = -crt_net(states_v, cur_actions_v)
                actor_loss_v = actor_loss_v.mean()
(12) 评论家的负输出可作为损失反向传播至评论家网络最终到达演员。为避免影响评论家权重,关键点是仅让演员优化器执行优化步骤——评论家权重虽会保留此次调用的梯度,但将在下次优化时被丢弃:
                actor_loss_v.backward()
                act_opt.step()
                tb_tracker.track("loss_actor", actor_loss_v, frame_idx)
(13) 作为训练循环的最后一步,我们以非常规方式更新目标网络:
                tgt_act_net.alpha_sync(alpha=1 - 1e-3)
                tgt_crt_net.alpha_sync(alpha=1 - 1e-3)
此前我们定期将优化网络的权重同步到目标网络。但在连续动作问题中,这种同步方式的效果不如所谓的"软同步"——软同步在每个步骤执行,但仅将优化网络权重的一小部分比例添加到目标网络,从而实现从旧权重到新权重的平滑缓慢过渡。
3. 运行结果
启动方式与 A2C 示例相同:需传递运行名称和可选的 --dev 标志。实验表明 GPU 带来约 30% 速度提升,但提速效果不如 Atari 游戏显著。
经过 500 万次观测,DDPG 算法在 10 个测试回合中达到 4.5 的平均奖励,较A2C结果有所改进。训练动态如下图所示。
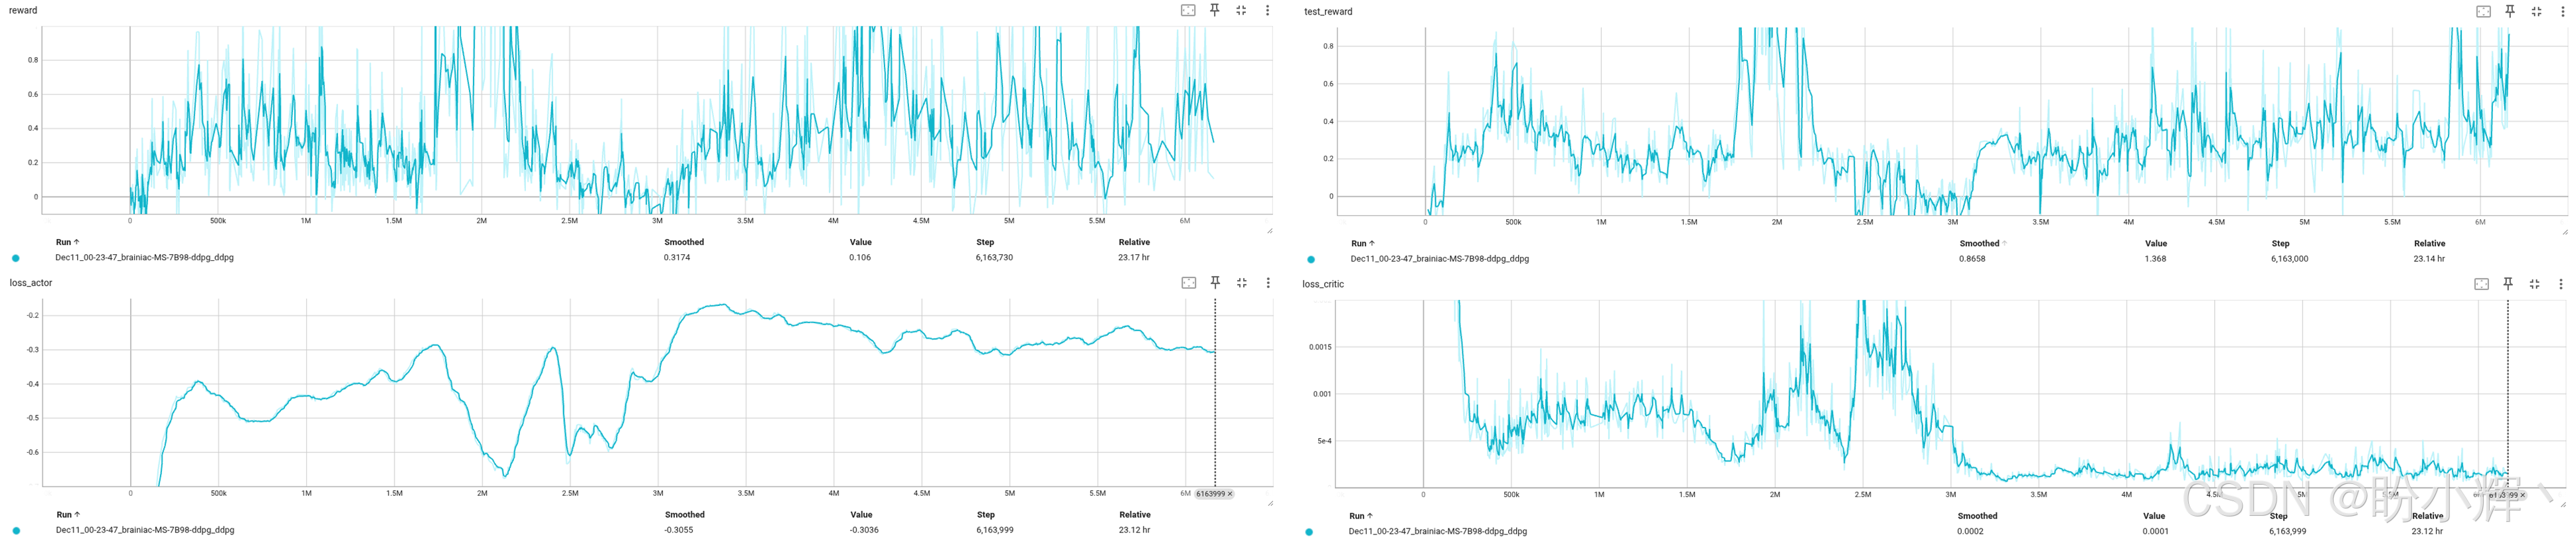
"回合步数"图显示训练所用回合的平均长度。评论家损失是 MSE 损失(应保持较低值),而演员损失(如您所记)是评论家输出的负值——因此该值越小,演员可能获得的奖励越高。下图展示了测试期间获得的值( 10 个回合的平均值)。
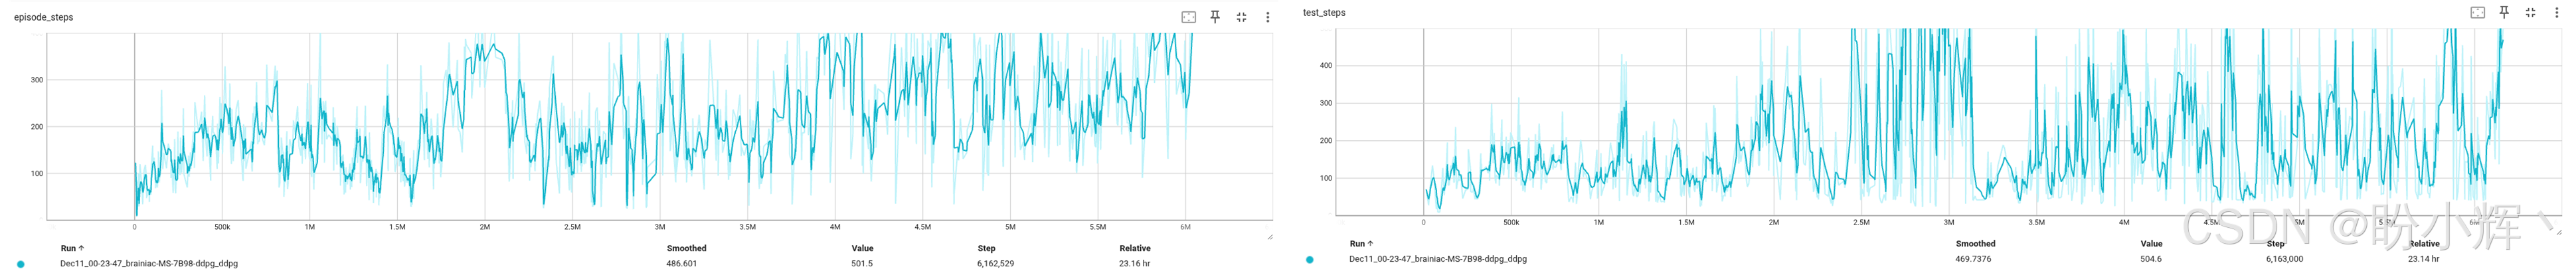
要测试保存的模型并录制视频(操作方式与 A2C 模型相同),可使用 play_ddpg.py 工具。它采用相同的命令行选项,但专门加载 DDPG 模型。测试期间得分为 3.033,模型在向前跌倒后失败。
小结
本文详细介绍了深度确定性策略梯度 (Deep Deterministic Policy Gradient, DDPG) 算法的核心原理与实现细节。与传统的随机策略方法不同,DDPG 通过确定性策略网络直接输出动作值,并借助评论家网络估计Q值,利用链式法则实现端到端的策略优化。为应对确定性策略带来的探索不足问题,我们引入了 Ornstein-Uhlenbeck 过程生成时间相关的探索噪声。实验结果表明,在四足机器人控制任务上,DDPG 显著优于 A2C 方法,这些优势使 DDPG 成为处理连续动作空间问题的有力工具。
系列链接
PyTorch强化学习实战(1)——强化学习(Reinforcement Learning,RL)详解
PyTorch强化学习实战(2)——强化学习环境库Gymnasium
PyTorch强化学习实战(3)——Gymnasium API扩展功能
PyTorch强化学习实战(4)——PyTorch基础
PyTorch强化学习实战(5)——PyTorch Ignite 事件驱动机制与实践
PyTorch强化学习实战(6)——交叉熵方法详解与实现
PyTorch强化学习实战(7)——表格学习与贝尔曼方程
PyTorch强化学习实战(8)——Q学习详解与实现
PyTorch强化学习实战(9)——深度Q学习
PyTorch强化学习实战(10)——强化学习高级组件
PyTorch强化学习实战(11)——N步DQN(N-step DQN)
PyTorch强化学习实战(12)——Double DQN(DDQN)
PyTorch强化学习实战(13)——噪声网络(NoisyNet-DQN)
PyTorch强化学习实战(14)——优先经验回放机制
PyTorch强化学习实战(15)——Dueling DQN
PyTorch强化学习实战(16)——Categorical DQN
PyTorch强化学习实战(17)——强化学习训练加速
PyTorch强化学习实战(18)——基于DQN处理股票交易问题
PyTorch强化学习实战(19)——策略梯度法
PyTorch强化学习实战(20)——优势演员-评论家(Advantage Actor-Critic, A2C)
PyTorch强化学习实战(21)——异步优势演员-评论家(Asynchronous Advantage Actor-Critic, A3C)
PyTorch强化学习实战(22)——将强化学习应用于TextWorld互动小说游戏
PyTorch强化学习实战(23)——强化学习在网页导航中的应用
PyTorch强化学习实战(24)——连续动作空间中的强化学习

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)