Opik 可观测性总览:让 LLM 应用不再是个黑盒
前几天有个朋友来找我,说他的客服机器人又“发疯”了。用户问“你们家退货政策是什么”,机器人一本正经地回答了一个完全不相关的运费问题。他翻遍日志,只看到最后那句错误答案,前面发生了什么——检索了哪些文档、调用了哪些工具、模型收到什么 prompt——一概不知。
这其实不是他一个人的问题。只要你在做 LLM 应用,尤其是 Agent、RAG、多轮对话这类东西,迟早都会遇到这种“黑盒时刻”。你看到输入,看到输出,但中间那团东西像雾一样。你想修,却不知道从哪下手。
Opik 就是来治这个病的。它是一套面向 LLM 应用的可观测性平台,核心目标很朴素:把你 Agent 处理的每一个请求、每一次 LLM 调用、每一次工具调用、每一次检索,都变成一条可以点开、可以搜索、可以分析的 trace。说白了,就是把黑盒拆成透明的流水线。
如果你还没听过 Opik,可以先把它理解成“LLM 应用的可观测性层”。它不负责替你写 prompt,也不负责替你换模型,它负责让你看清楚:到底发生了什么。
为什么 LLM 应用比传统 API 难调得多
传统后端接口出问题,你打个日志、断个点,基本能定位。因为逻辑是确定的,输入 A 经过几步计算得到输出 B。但 LLM 应用完全不是这个路数。
一个典型的 Agent 请求,可能长这样:用户输入 → 意图识别 → 检索知识库 → 重排文档 → 组装 prompt → 第一次 LLM 调用 → 解析工具调用 → 执行工具 → 把工具结果塞回 prompt → 第二次 LLM 调用 → 后处理 → 返回。中间还可能穿插多轮对话、记忆读取、成本控制、敏感词过滤。
这些步骤在运行时几乎是隐形的。你只看到最后那句话,但不知道模型为什么 hallucinate,不知道哪个检索步骤返回了无关上下文,不知道延迟是在 embedding 还是 LLM 调用上飙起来的,也不知道这次请求烧了多少 token、花了多少钱。
没有可观测性,调试 LLM 应用就是一场猜谜。你改 prompt、换模型、调温度,本质上是在盲试。试对了是运气,试错了连原因都说不清。
Opik 把这些步骤全部记录下来。每一次 LLM 调用、每一次工具调用、每一次检索,都会变成 trace 里的一段。你可以像看火焰图一样看整个执行路径,也可以按状态、延迟、成本、标签去过滤和搜索。问题出在哪,点开就知道。
Opik 能帮你做的五件事
我把 Opik 的价值总结成五句话,基本覆盖了日常开发中最痛的点。
第一,看到完整执行路径。从用户输入,到工具调用,到 LLM completion,再到最终响应,每一步都有输入、输出、耗时和元数据。你不再只看首尾。
第二,快速根因定位生产问题。线上请求那么多,不可能一条条看。Opik 支持按状态、延迟、成本、自定义标签过滤和搜索。比如你想找“所有耗时超过 3 秒且状态为错误的 trace”,几秒钟就能筛出来。
第三,跟踪成本和延迟趋势。Token 用量和花费可以按模型、提供商、trace 拆开看。这个月为什么账单涨了?是哪个模型、哪类请求在烧钱?一目了然。
第四,捕获多轮对话。单次 trace 只能看一轮,但真实场景往往是多轮。Opik 可以把相关 trace 分组到 thread 里,让你看到对话是怎么一步步演变的。用户在哪一轮开始跑偏,模型在哪一轮忘了上下文,都能查。
第五,闭环反馈。你可以给 trace 附加人工评分或自动评分,然后拿这些分数去驱动评估。哪些回答好、哪些不好,不再靠感觉,而是有数据。
这五件事听起来简单,但真做起来,很多团队连第一件都没做好。Opik 的好处是,它把这些能力都做成了开箱即用,不需要你从零搭一套。
核心概念:Trace、Span、Thread、Feedback
在深入之前,先把几个概念理清楚。Opik 的文档里叫 traces、spans、conversations、feedback scores,我用快递来打个比方。
Trace 是一次完整请求的旅程。比如用户问“帮我查一下订单”,从进入系统到返回答案,这整条链路就是一个 trace。它包含了这次请求的所有信息:输入、输出、耗时、状态、标签、元数据。
Span 是 trace 里的一个步骤。就像快递从仓库到分拣中心、到转运站、到配送点,每一站都是一个 span。在 LLM 应用里,一次检索是一个 span,一次工具调用是一个 span,一次 LLM 调用也是一个 span。Span 可以嵌套,形成一棵执行树。Opik 会把整棵树可视化出来,你点开任何一个节点,都能看到它的输入、输出、耗时和元数据。
Thread 是多轮对话的容器。用户和机器人聊了十轮,这十轮可能产生十条 trace。Thread 把它们串起来,让你看到上下文是怎么传递的。比如用户第三轮说“那换成红色的呢”,模型需要知道“那”指的是什么。Thread 就是用来回答这个问题的。
Feedback score 是附加在 trace 上的评分。可以是人工打的“好/差”,也可以是自动评估的“相关性 0.8”“准确性 0.6”。这些分数可以汇总、对比、导出,用来做质量监控和模型迭代。
理解了这四个概念,后面的东西就顺了。
你能捕获哪些东西
Opik 能捕获的东西比很多人想象的要多。我按官方文档里的分类,结合实际使用场景展开说。
Traces & Spans:完整执行树
这是最核心的能力。每个请求都会生成一条 trace,里面包含完整的执行树。每个 span 都有输入、输出、时间、元数据。你可以看到检索返回了哪些文档,工具调用的参数是什么,LLM 收到的 prompt 长什么样,模型返回了什么,耗时多少。
比如你的 RAG 应用回答错了,点开 trace 一看:检索阶段返回了三篇文档,其中两篇是两年前的旧政策。模型基于旧政策回答,自然就错了。问题不在模型,在检索。如果没有 trace,你可能会一直以为是模型不行。
Conversations:多轮会话线程
单轮 trace 看的是“这一句怎么答的”,thread 看的是“整个对话怎么走的”。Opik 可以把相关 trace 分组到 thread 里,帮你理解交互是怎么跨轮次演变的。
这个功能在客服、教育、陪伴类应用里特别有用。用户可能前几轮很正常,第五轮开始情绪激动,第七轮完全跑题。你单独看第七轮,觉得模型答得莫名其妙;但放到 thread 里一看,原来是第四轮的一个误解没被纠正,后面越滚越大。
Cost Tracking:成本跟踪
Token 用量和花费可以按模型、提供商、trace 拆开。你可以看到每个请求花了多少钱,哪个模型最烧钱,哪类请求成本最高。
我见过一个团队,一直以为成本大头在 GPT-4 调用上,结果 Opik 一接,发现 embedding 和重排模型的开销加起来比 LLM 还高。不是模型贵,是检索阶段太贪心,每次拉几百篇文档。这种问题,不看数据根本发现不了。
Media & Attachments:多模态附件
图像、音频、视频、文件都可以和 trace 一起记录。你做多模态应用时,模型看到了哪张图、听了哪段音频,都能在 trace 里看到。调试多模态问题,没有这个基本没法玩。
User Feedback:用户反馈
定性评分和定量评分都可以附加到单条 trace 上。用户点了个“踩”,或者人工审核打了“不符合事实”,这些反馈会留在 trace 上。时间一长,你就有一批带标签的数据,可以用来做评估、微调、回归测试。
Agent Graphs:Agent 执行图
Opik 可以可视化 Agent 的执行图,展示各个步骤是怎么连接的。对于复杂的 Agent 工作流,这张图能帮你快速理解结构,也能在出问题时一眼看出是哪条分支走错了。
这六项能力加起来,基本覆盖了 LLM 应用从调试到监控到优化的全流程。
四步上手 Opik
Opik 的上手路径设计得很顺。官方说如果你只想赶紧写代码,可以直接去 Getting started 指南,五分钟就能加上 tracing。我把完整流程拆成四步。
第一步:连接你的项目
在你的 Agent 目录下运行:
opik connect --project <YOUR_PROJECT_NAME>
这会把你的项目跟 Opik 配对。项目名可以自己取,比如 customer-service-bot、rag-demo。连接之后,后续的 trace 就会归到这个项目下。
第二步:插桩你的代码
这是最关键的一步。Opik 提供了两种方式:用 opik-skills 让编码助手帮你插桩,或者手动用 SDK 插桩。
官方推荐最快的方式是 opik-skills。先安装:
npx skills add comet-ml/opik-skills
然后对你的编码助手说:
Instrument my agent with Opik using the /opik-instrument command.
它支持 Claude Code、Cursor、Codex、OpenCode 等主流编码助手。助手会帮你把 Opik 的 tracing 加到代码里,省去手动改代码的麻烦。
如果你想手动插桩,也不复杂。Python 版本:
import opik

@opik.track
def my_agent(user_message):
    context = retrieve_context(user_message)
    response = call_llm(user_message, context)
    return response
TypeScript 版本:
import { Opik } from "opik";
const client = new Opik();

const myAgent = client.track({
  name: "my-agent",
  fn: async (userMessage: string) => {
    const context = await retrieveContext(userMessage);
    return await callLlm(userMessage, context);
  },
});
加一个装饰器或者包一层 track,就能自动捕获输入、输出、耗时和嵌套调用。如果你的代码里已经有 LangChain、LlamaIndex 这些框架,Opik 也有现成的集成,基本不用改业务逻辑。
第三步:在 Dashboard 查看 Traces
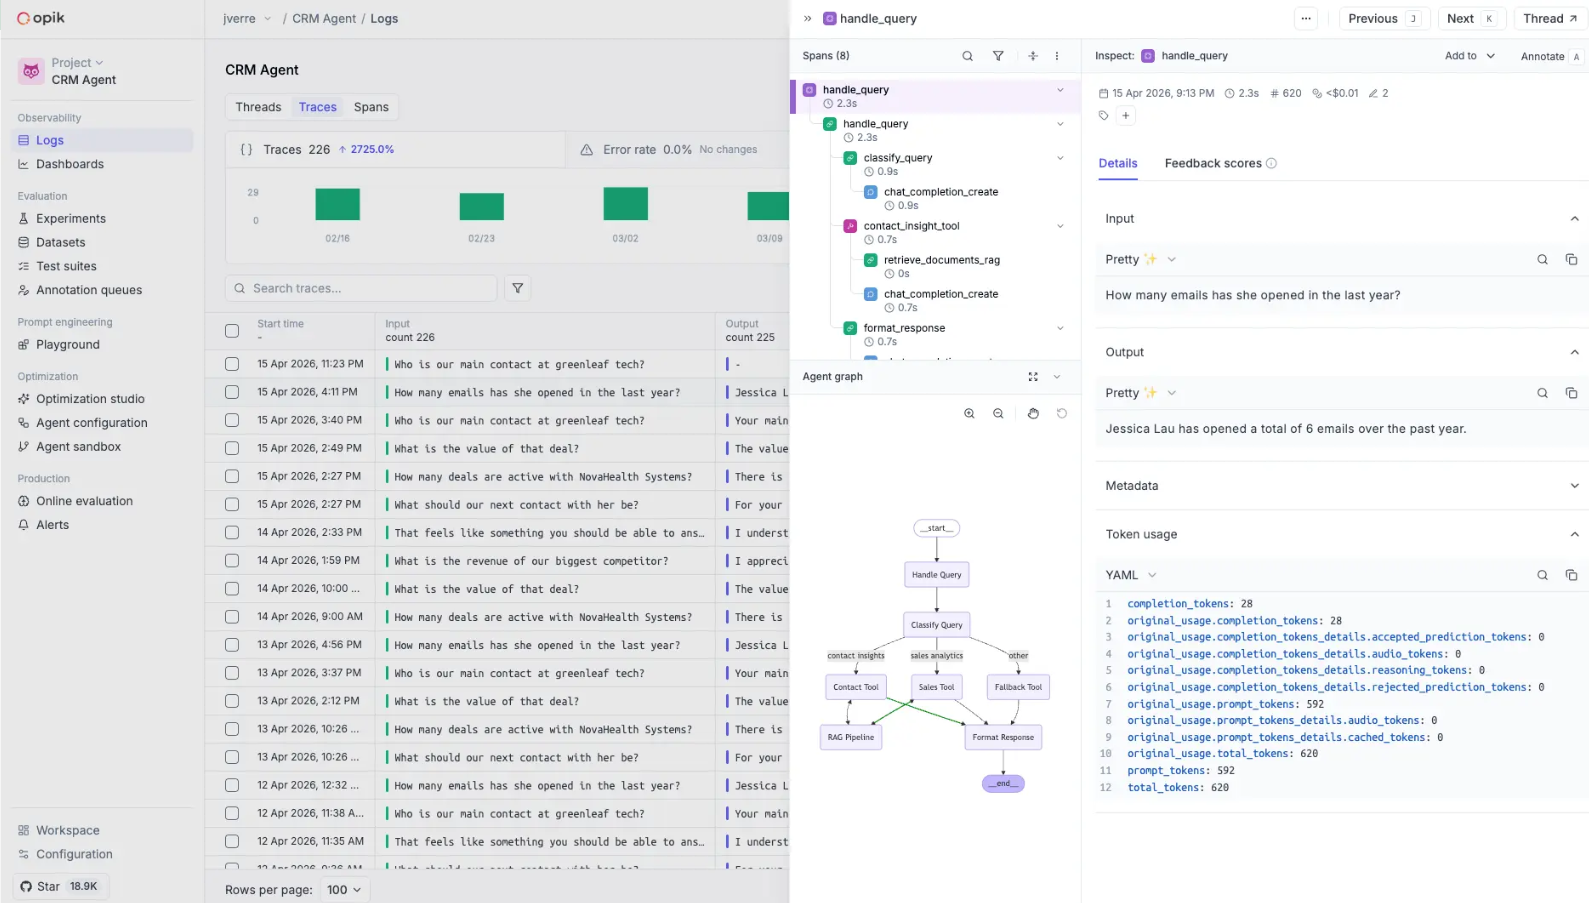
插桩之后,每个请求都会生成 trace。打开 Opik Dashboard,你能看到完整的执行树,点开每个 span 看输入输出,按耗时、成本、状态、标签过滤。
官方给了一张 traces 页面的截图,信息密度很高。左边是 trace 列表,右边是执行树和详情。你可以快速扫一眼哪些请求慢、哪些请求贵、哪些请求报错,然后点进去深挖。
第四步:分析和改进
有了 trace 之后,真正的优化才开始。你可以用 trace 调试失败案例,找出慢步骤,跟踪质量随时间的变化。给 trace 附加反馈分数,对数据集跑评估,还可以用 Ollie——Opik 的 AI 助手——帮你自动做根因分析。
Ollie 这个功能挺有意思。它不只是让你手动翻 trace,而是用 AI 去分析 trace,给出可能的原因和建议。比如它可能会告诉你:“这次失败是因为检索阶段返回的文档与问题相关性低,建议检查 embedding 模型或调整检索 top-k。” 对于复杂 Agent,这种自动根因很有价值。
集成生态:不用重写应用
Opik 对 30 多个框架提供了一等支持,覆盖 Python、TypeScript 和 OpenTelemetry。这意味着你不需要为了可观测性重写应用。
常见的集成包括:
- LangChain
- LlamaIndex
- Anthropic
- AWS Bedrock
- Google Gemini
- CrewAI
还有一些其他框架和提供商,官方有一个完整的集成列表。你可以去 /integrations/overview 看。核心思路是:你继续用你熟悉的框架,Opik 在底下帮你捕获 trace。
OpenTelemetry 的支持也很关键。如果你的团队已经有 OTel 基础设施,Opik 可以融入现有链路,不用另起炉灶。
一些实战建议
工具再好,用不对也白搭。我结合自己踩过的坑,给几条建议。
从关键路径开始。 不要一上来就给所有函数加 tracing,那样噪音太大。先把最核心的请求链路插桩,比如“用户输入 → 检索 → LLM → 输出”这条主路。等主路清晰了,再逐步加细节。
给 trace 打标签。 标签是过滤和搜索的基础。你可以给 trace 打上 env:prod、version:v2、user_tier:premium 这类标签。出问题时,按标签筛选,能快速缩小范围。
关注成本,但不只是 LLM 成本。 检索、重排、embedding、工具调用,这些都可能烧钱。Opik 的成本跟踪可以按模型和提供商拆开,帮你找到真正的成本大头。
把反馈变成数据。 用户点踩、人工审核、自动评估,这些反馈都附加到 trace 上。积累一段时间后,你就有了一个带标签的数据集。用它做回归测试、做评估、做微调,比凭感觉改 prompt 靠谱得多。
用 MCP server 在编辑器里读 trace。 Opik 提供了 MCP server,你可以直接从 AI 编码助手里读取 trace,不用离开编辑器。调试的时候特别方便:看到错误 trace,直接在编辑器里问助手“这条 trace 为什么失败”,助手可以读取 trace 详情并给出分析。
最后
LLM 应用的可观测性不是锦上添花,而是工程化的基础设施。你不可能靠猜来维护一个生产级 Agent。每一次幻觉、每一次延迟飙升、每一次成本失控,背后都有具体原因。Opik 的作用,就是把这些原因从黑盒里挖出来,摆在你面前。
如果你还在用 print 调试 LLM 应用,真的可以试试 Opik。从 opik connect 开始,加上 @opik.track,跑一次请求,打开 Dashboard。你会第一次清楚地看到:原来我的 Agent 是这么工作的。
下一步可以看这几个地方:
- Getting started:几分钟内给 Agent 加上可观测性。
- Concepts:深入理解 traces、spans、threads 和 feedback scores。
- Debugging agents with Ollie:用 AI 辅助做根因分析。
- Cost tracking:监控 token 用量和花费。
- MCP server:在 AI 编码助手里直接读 trace,不离开编辑器。
别让 LLM 应用继续当黑盒了。把它拆开,看清楚,然后你会发现问题其实没那么难修。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)