机器人训练进入Scaling阶段:10万小时Physical Data之后,训练模式正在发生什么变化?
如果说过去两年机器人训练的核心问题还是“视觉、语言和机器人动作能不能被统一到一个模型里”,那么到了2026年,已经开始面对一个更现实的问题:机器人已经可以学会很多动作,但这些能力到底怎样才能持续规模化?
最近几个月,市场上几个技术趋势非常值得放在一起看。7月,小米发布Xiaomi-Robotics-1,预训练数据首次做到超过10万小时真实世界操作轨迹,覆盖1700多个场景,同时再使用超过7200小时真实机器人数据进行后训练。NVIDIA同期发布GR00T 1.7,公开的预训练数据约包括3.2万小时真实机器人及人类数据,以及8000小时仿真数据。到了8月,Figure公布Index数据计划:上线约4个月已经累计超过1600万段人类任务视频,系统每秒处理约30分钟新增视频,并计划未来12个月在数据和计算上投入超过10亿美元。
这些先进技术释放了一个信号:机器人训练开始进入自己的Scaling阶段。但机器人领域的Scaling和LLM并不完全一样。大语言模型可以直接从互联网获取海量文本,机器人真正需要的却是人与物理世界交互产生的数据。机器人不仅需要知道“画面中发生了什么”,还需要知道当时身体处于什么状态、采取了什么动作、动作以后环境发生了什么变化。
因此,机器人基础模型下一阶段真正争夺的,可能不是一个更大的Transformer,而是一套能够持续获得、转换和利用Physical Experience的训练体系。
一、从“训练一个任务”到“预训练通用能力”,机器人训练开始寻找Scaling路径
传统的Learning-based Robot开发,本质上仍然非常接近项目制。先找到一个具体任务,比如抓取某一种工件;再通过示教或者遥操作采集一批Trajectory;模型学习Observation到Action的映射;最后围绕这个特定工位不断调整,直到达到目标成功率。
这套方法可以很好地解决一个场景,却存在一个明显的问题:能力很难复用。换一个工件,可能重新采数据;换一个夹爪,Action Space改变;换到另一台机器人,原来的Policy甚至可能无法直接使用。任务数量越多,开发成本基本呈线性增加。
基础模型正在试图改变这件事。Xiaomi-Robotics-1值得关注的地方,并不只是“10万小时”这个数字本身,而是它采用了一种明显不同的训练思路:在Pre-training阶段,大规模使用不依赖某一种具体机器人本体的UMI操作数据,让模型先学习人类如何与真实物体交互,再在Post-training阶段使用真实机器人数据完成Embodiment Alignment。官方公布的数据中,其10万小时预训练轨迹覆盖家庭、商业、工业和户外等1700多个场景,随后再通过超过7200小时真实机器人数据把这种通用操作知识映射到具体机器人上。
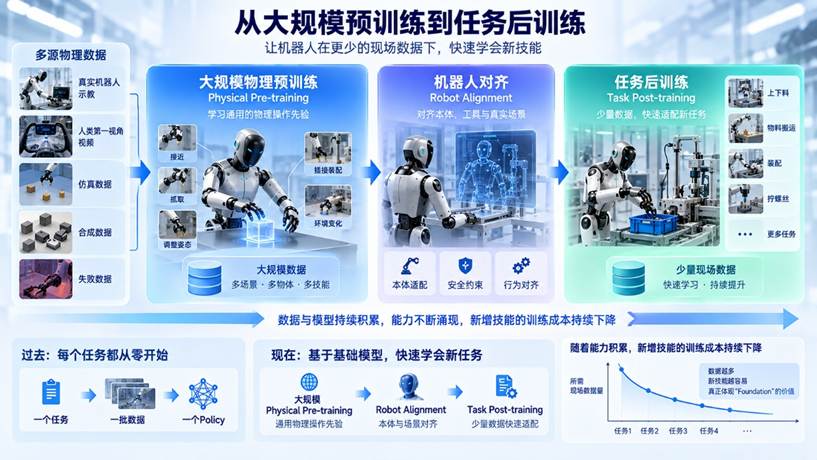
这意味着机器人训练的逻辑开始从“一个任务 → 一批数据 → 一个Policy”转向“大规模Physical Pre-training → Robot Alignment → Task Post-training”。
NVIDIA GR00T 1.7也在沿着类似方向发展。其数据并不只来自真实机器人,而是把真实示范、人类第一视角数据以及BEHAVIOR、RoboCasa等环境产生的仿真数据一起用于预训练。
为什么要这么做?因为机器人真正需要学习是更通用的物理操作先验,例如怎样接近一个物体、什么时候闭合夹爪、怎样重新调整姿态、插接时如何处理空间关系,以及动作执行以后环境通常会发生什么变化。当这些能力可以在预训练阶段逐步沉淀下来以后,进入一个新的工厂任务时,训练就不需要完全从零开始。
这也是机器人领域正在尝试建立的Scaling逻辑:数据和模型积累得越多,新增一个技能所需要的现场数据应该越少。如果做不到这一点,Foundation Model只是一个更大的机器人模型;只有当后续任务的训练成本开始持续下降,它才真正具备“Foundation”的意义。
二、从Robot Data到Physical Data,训练瓶颈正在从“采多少”变成“不同经验怎么复用”
要实现上面的目标,仅仅扩大传统遥操作数据远远不够。语言模型为什么可以快速Scaling?一个重要原因是文字、图片和视频天然存在于互联网中。但机器人需要的是另一种数据。一条真正完整的机器人Trajectory,往往同时包含视觉观察、机器人自身状态、末端位姿、关节动作、夹爪状态,有些任务还涉及力觉、触觉和执行结果。
视频只能告诉模型:“这个人最终把零件装进去了。”机器人还需要知道:“手是怎么接近的、从哪个方向插入、过程中怎样调整,以及哪一次动作真正改变了环境。”因此机器人数据天然更昂贵。一台机器人运行一小时,就只能得到一小时真实Physical Experience。即使增加机器人数量,也意味着同步增加硬件、空间、维护、安全以及操作成本。这正是为什么当前机器人训练正在从单一Robot Data,扩展到更广义的 Physical Data。
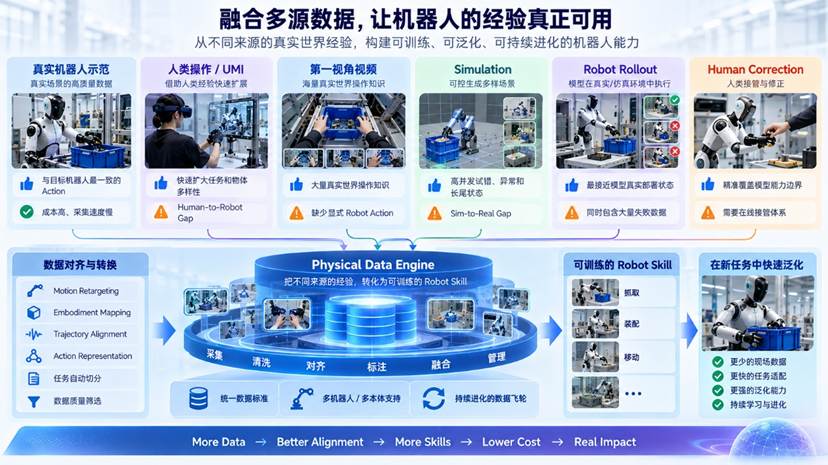
目前前沿体系越来越倾向于同时利用几类数据:
|
数据来源 |
可以提供什么 |
当前主要问题 |
|
真实机器人示范 |
与目标机器人最一致的Action |
成本高、采集速度慢 |
|
人类操作 / UMI |
快速扩大任务和物体多样性 |
Human-to-Robot Gap |
|
第一视角视频 |
大量真实世界操作知识 |
缺少显式Robot Action |
|
Simulation |
高并发试错、异常和长尾状态 |
Sim-to-Real Gap |
|
Robot Rollout |
最接近模型真实部署状态 |
同时包含大量失败数据 |
|
Human Correction |
精准覆盖模型能力边界 |
需要在线接管体系 |
Figure Index就是这种变化的一个极端体现。它没有把Physical Dataset等同于“让Figure机器人不断遥操作”,而是在全球范围采集人类实际完成不同物理任务的视频。目前公开数据已经超过1600万段,每秒还在处理约30分钟新视频。
未来真正难的可能不是有没有数据,而是这些数据能不能互相“听懂”。人的五指手和双指夹爪不同,机械臂和人形机器人自由度不同;同样一个Pick动作,在不同机器人上的Joint Trajectory完全不一样;人类视频甚至没有关节指令。于是机器人数据工程开始需要解决Motion Retargeting、Trajectory Alignment、Action Representation、Embodiment Mapping、任务自动切分以及数据质量筛选等问题。
这也是Physical Data Engine和普通Dataset的区别。Dataset解决的是“数据放在哪里”。Data Engine解决的是怎样把人的经验、不同机器人的经验、Simulation经验和真实部署经验,持续转化成可训练的Robot Skill。只有跨过这一层,数据规模才真正能够转化成能力规模。
三、从“模仿正确动作”到“利用失败和运行经验”,机器人开始真正自己练习
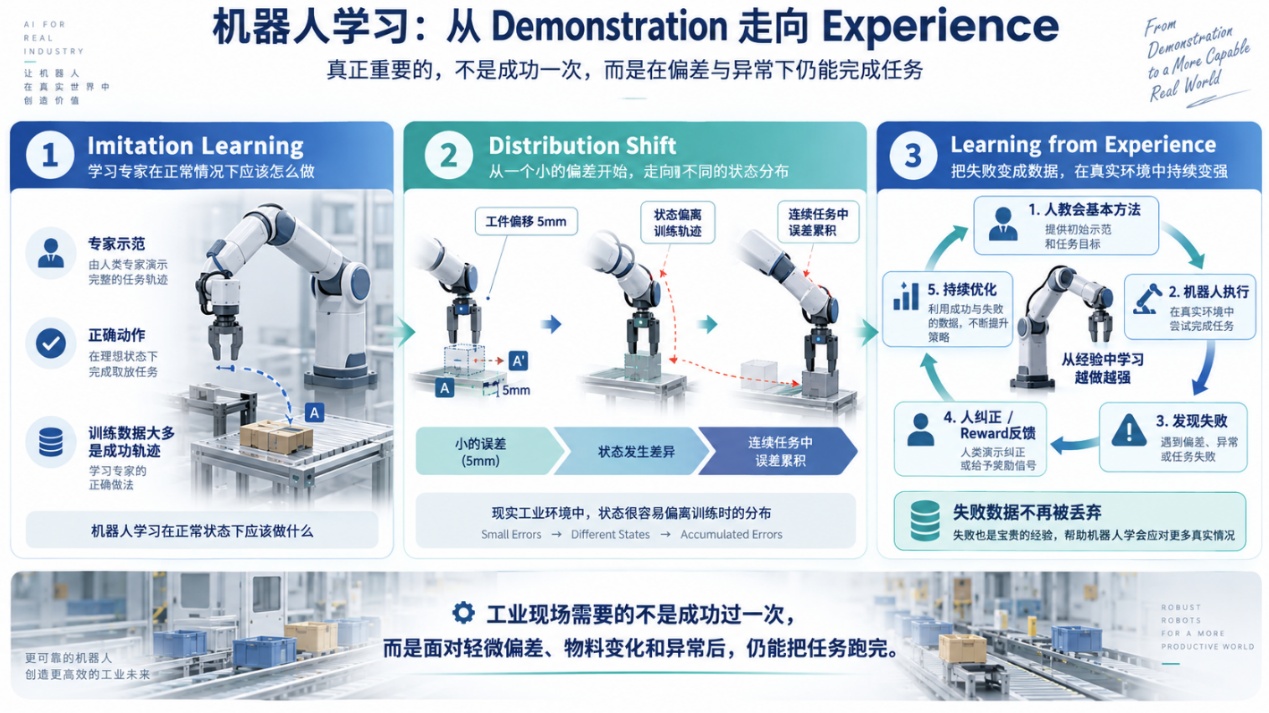
即使拥有更大的Physical Data,单纯模仿人类示范仍然解决不了机器人部署后的所有问题。传统Imitation Learning最擅长的是回答:专家在这种状态下应该怎么做?训练数据里的动作通常都是正确的。但机器人真正执行时,状态并不会始终停留在专家轨迹上。
比如一个工件正常应该位于位置A,但机器人第一次抓取以后偏了5毫米。下一帧画面就已经与训练数据不同;模型做出第二次动作以后又产生一点误差,很快就可能进入一个从未训练过的状态。机器人学习里把这种问题称为Distribution Shift。连续任务越长,误差还会不断累积。
 这也是为什么最近机器人数据集开始主动保留过去经常被丢弃的东西——失败。智元9月发布的AGIBOT WORLD 2026强化学习数据首批包含11,430条真实机器人轨迹,其中不仅有专家示范,还明确包含1,024条成功Policy Rollout、1,369条失败Rollout以及Human-in-the-loop Correction,并进一步标注任务进度、错误、扰动和人工干预。
这些失败轨迹和专家示范的价值完全不同。失败和人工修正数据告诉机器人:我什么时候已经做错了,以及做错以后怎样回来。Physical Intelligence的π*0.6则进一步把这种思路真正用于训练。其RECAP方法先通过Demonstration建立基本能力,再让机器人自主运行,利用真实运行过程中产生的Experience、Reward以及专家Correction继续进行强化学习。官方公布的实验中,在部分较困难任务上,加入真实机器人Experience后,任务Throughput提高超过2倍,失败率大约降低一半;机器人已经展示连续数小时完成折衣服、制作Espresso以及真实工厂包装盒组装。
2026年推出的RL Token又把这条路线往前推了一步。它不再要求为了某一个精细动作重新更新整个大型VLA,而是从Foundation Model内部提取一个紧凑表示,在此基础上训练更轻量的RL Policy,通过分钟到小时级的现场运行经验优化动作精度和效率。
这背后的训练模式变化其实非常重要:“人教会基本方法 → 机器人自己执行 → 发现失败 → 人纠正 / Reward反馈 → 机器人继续优化 “。也就是从Learning from Demonstration逐渐走向Learning from Experience。这也是机器人真正走向生产必须经历的一步。
因为工业现场真正需要的,从来不是“机器人成功过一次”,而是面对轻微偏差、物料变化和异常以后,仍然能够把整个任务跑完。
五、回到工业现场:不是先挑战最复杂任务,而是先跑通一个可以复制的闭环
如果行业解决的是“机器人怎样持续获得更多能力”,真正进入制造现场以后,还需要做另外一个判断:什么场景应该先进入?机器人当前已经可以完成越来越复杂的任务,但“技术上可以尝试”与“适合第一批进入生产”是两个完全不同的问题。
制造业现场最终看的是稳定性和投资回报,而不是一次成功的视频。因此,工业富联科技服务目前在机器人应用落地中,并没有一开始就优先挑战最复杂的灵巧操作,而是从低难度、价值明确、容易验证的任务开始,先跑通完整闭环,再逐步提高任务复杂度。
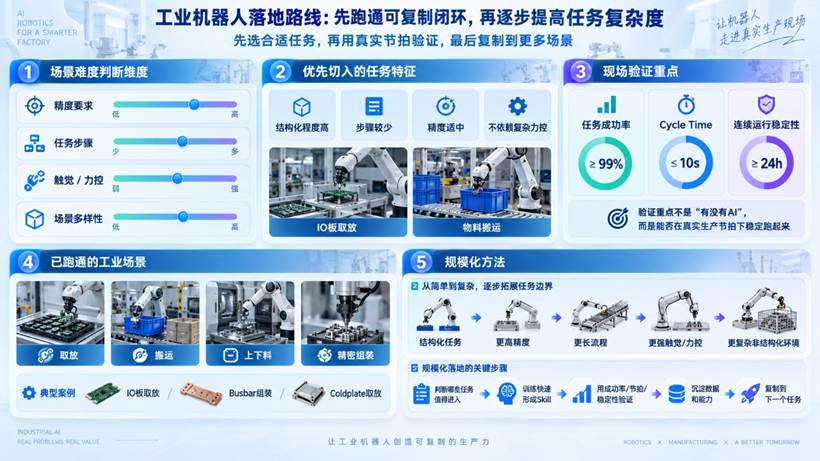
场景难度主要可以从四个维度判断:精度要求、任务步骤、触觉/力控以及场景多样性。在优先切入阶段,更适合选择结构化程度较高、任务步骤较少、精度要求适中,同时不依赖复杂触觉力控的工业任务。例如IO板取放、物料搬运等。这一阶段真正验证的不是机器人“有没有AI”,而是完整任务在真实生产节拍下能不能稳定跑起来。进入现场以后,验证重点至少需要同时关注三类指标:任务成功率、单次作业Cycle Time以及连续运行稳定性。
目前工业富联科技服务已经围绕取放、搬运、上下料和精密组装等方向进行工业机器人应用。其中几个已经跑通的场景:IO板取放、Busbar组装、Coldplate取放等等。这些场景真正有意义的地方,并不是说明机器人已经拥有三个新的“动作”。而是它们开始回答工业部署最基本的问题:机器人是否能够在真实产品、真实工位和真实节拍下,把一个任务完整跑通。
当结构化任务已经能够形成稳定闭环以后,再逐步向更高精度、更长流程、更加依赖触觉和力控的任务扩展,最终进入精密装配以及更复杂的非结构化环境。
这条路线看起来没有直接挑战“机器人最难能做到什么”,但反而更接近机器人规模化真正需要解决的问题。因为机器人在工业场景中的规模化从来不是找到100个看起来机器人可以做的任务。而是建立一套方法:先判断哪些任务最值得进入 → 用训练快速形成Skill → 用成功率、节拍和稳定性完成验证 → 沉淀数据和能力 → 再复制到下一个任务。
------
当机器人做过的任务越来越多,下一个工业任务能不能更快跑通;随着机器人运行时间越来越长,下一个版本能不能更加稳定;随着Skill不断积累,一个工厂验证过的能力能不能用更低成本复制到更多机器人、产线和场景。
当训练一个新可靠Skill的边际成本开始持续下降,机器人能力才真正从“一个个Demo”走向规模化。这可能也是今天机器人训练模式正在发生的最重要变化。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献24条内容

所有评论(0)