ChatBI 多轮对话状态管理与意图继承:在连续追问中保持上下文一致性
·
ChatBI 多轮对话状态管理与意图继承:在连续追问中保持上下文一致性
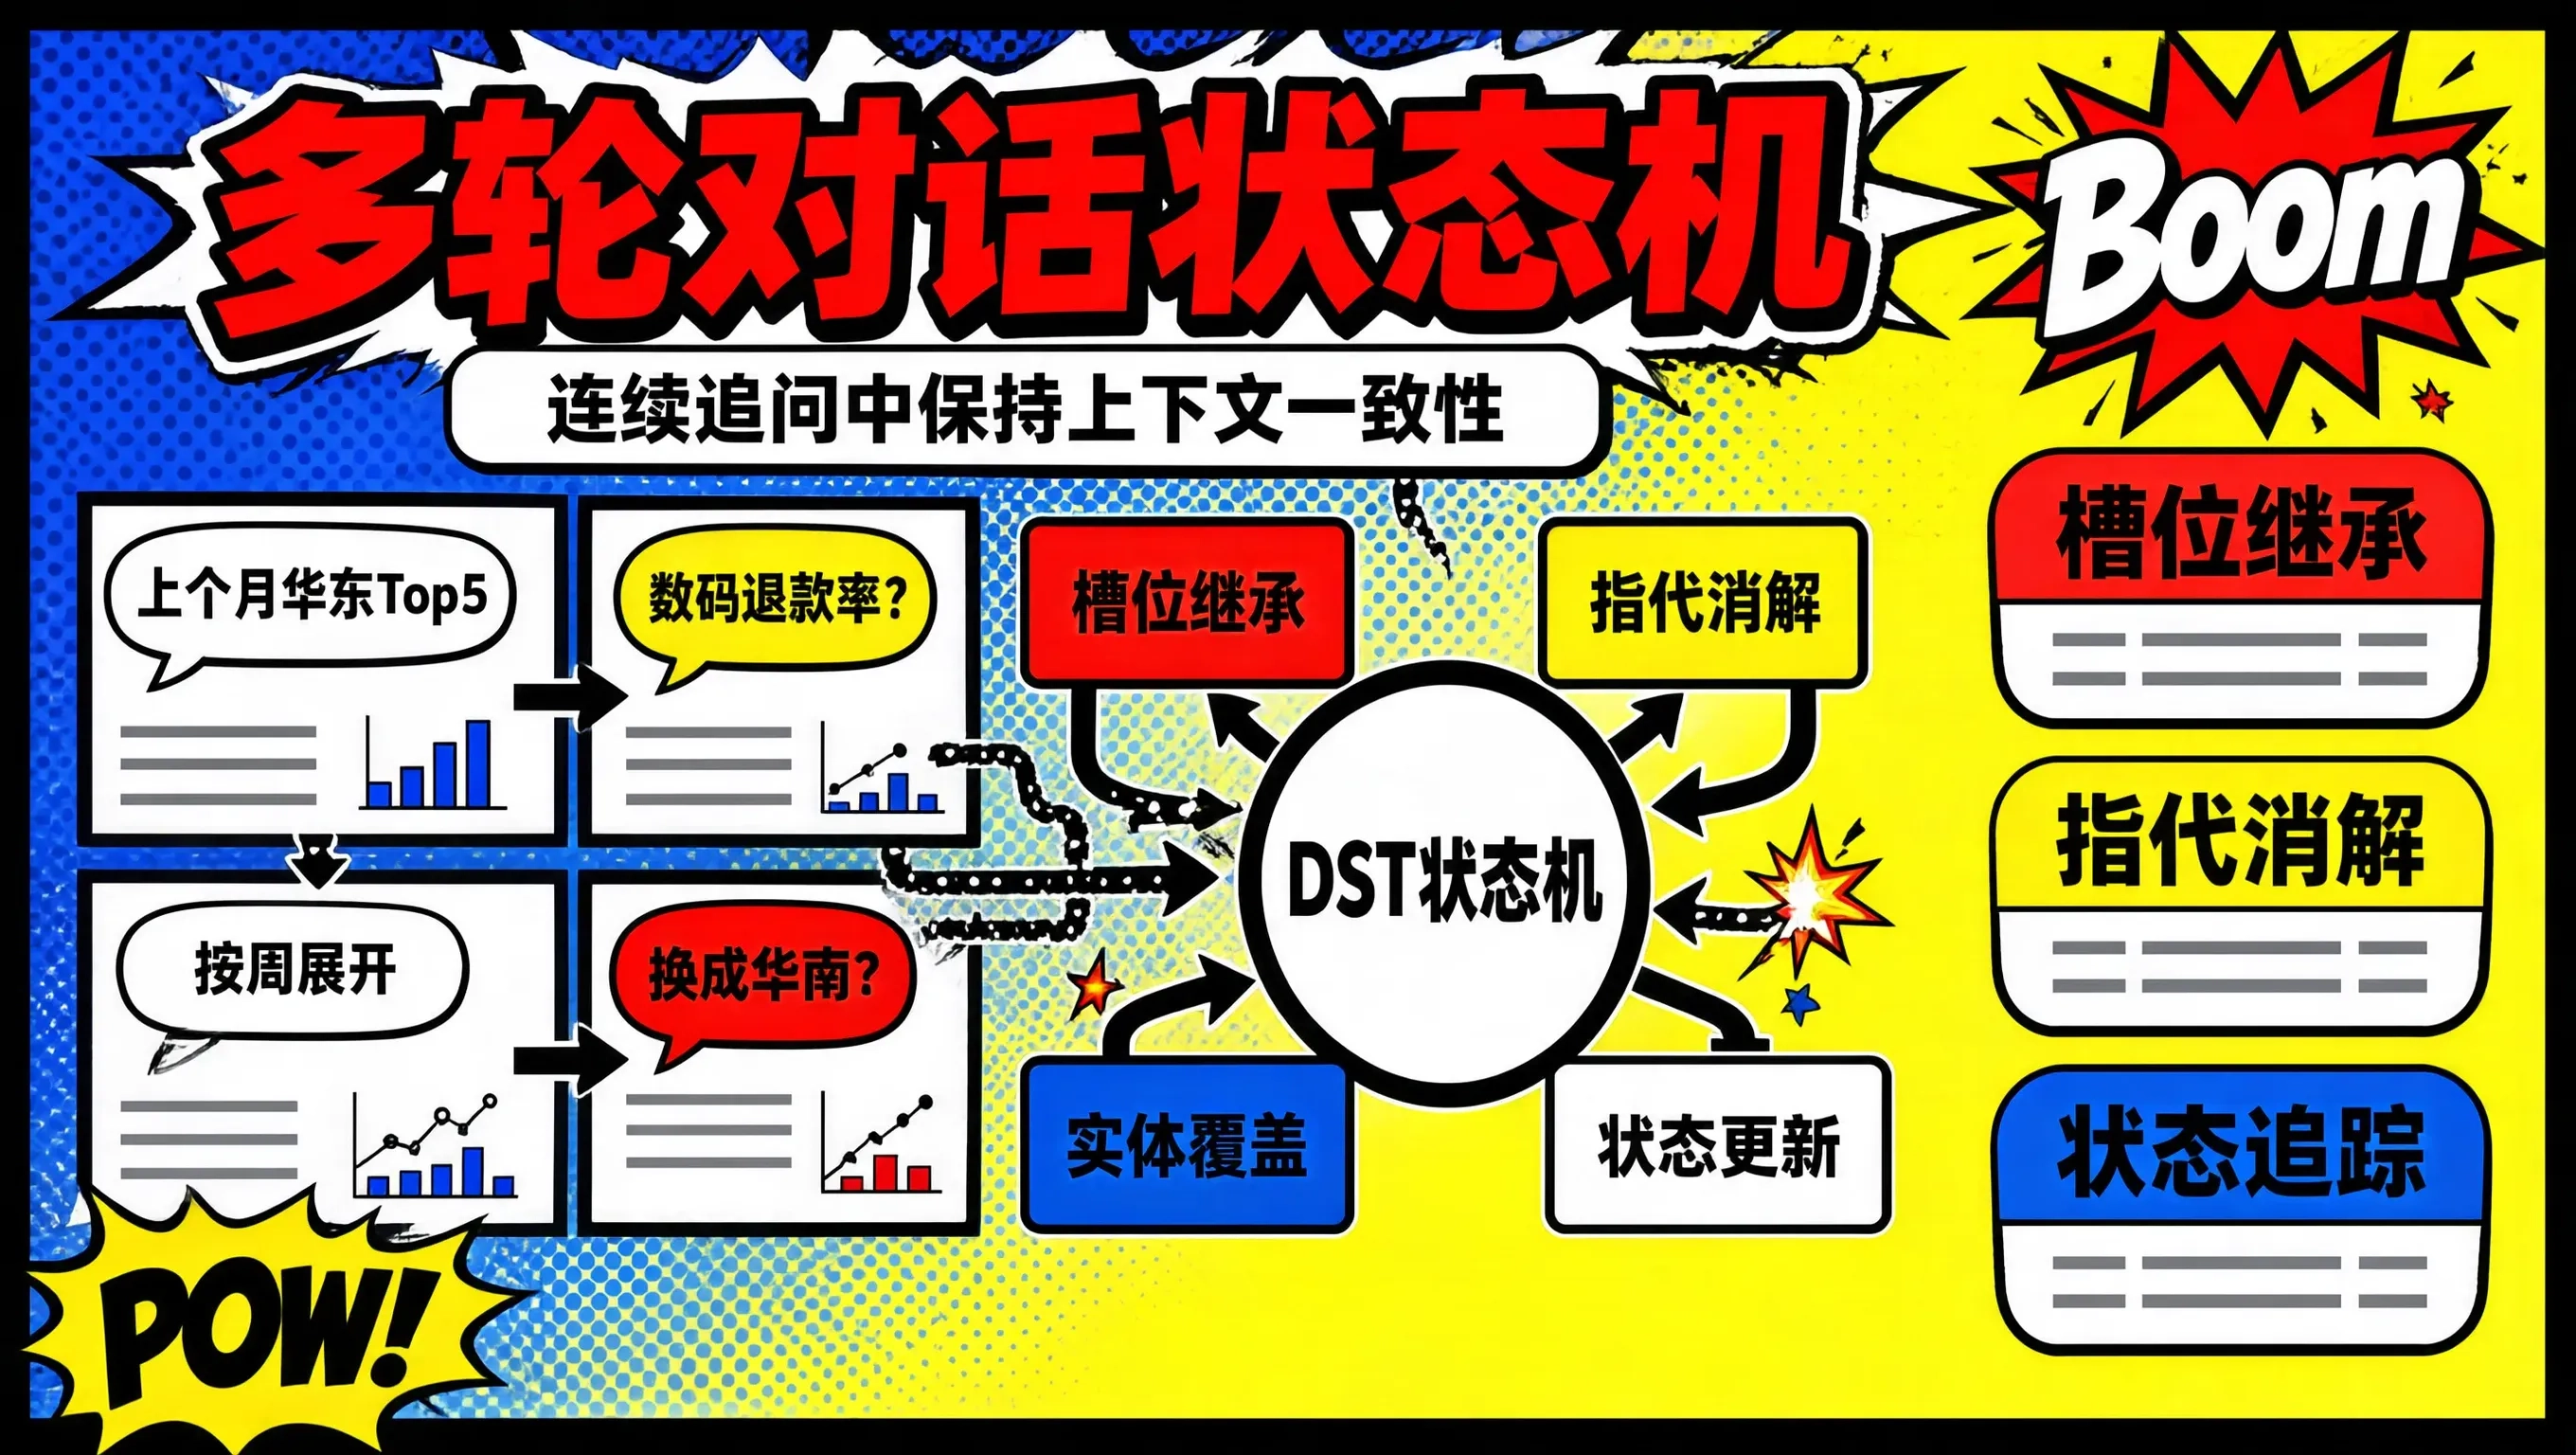
在企业级对话式数据分析(ChatBI)的真实交互场景中,业务分析人员很少会在单次提问中就把所有查询条件表达完整。
人类在探索数据时,天然习惯进行递进式的连续多轮追问(Multi-Turn Exploratory Analysis):
- 第 1 轮:“查一下上个月华东大区销售额最高的 Top 5 门店”;
- 第 2 轮:“那这 5 家门店里,数码类目的退款率分别是多少?”(隐式继承了:上个月、华东大区、以及上一轮查出的 5 家具体门店 ID!)
- 第 3 轮:“按周维度展开看下走势”;
- 第 4 轮:“如果换成华南大区呢?”(实体替换操作:保持其他所有过滤条件不变,仅将大区从华东替换为华南!)
如果底层系统是一个无状态的“单轮问答机器人”,在第 2 轮时它会因为找不到主语而生成错误的全局退款率,在第 4 轮时会彻底把之前的指标和周期遗忘干净。
如何构建一套**具备长短期记忆(Session Memory)、槽位继承(Slot Inheritance)、实体显式覆盖(Entity Override)以及指代消解(Coreference Resolution)**的工业级多轮对话状态机?
今天我们系统拆解 ChatBI 多轮上下文状态管理的架构与实战代码。
多轮对话状态机(Dialogue State Tracker / DST)拓扑模型
[ 第 1 轮输入: "上个月华东大区销售额 Top 5 门店" ]
                     │
                     ▼
+-----------------------------------------------------------------------------------------------+
| 【全局会话槽位状态字典 (Global Slot Context)】                                                |
| - `time_range`: '2026-08-01' ~ '2026-08-31'                                                   |
| - `geo_region`: '华东大区'                                                                    |
| - `dimension_grain`: 'store_id'                                                               |
| - `metric`: 'SUM(pay_amount)'                                                                 |
| - `top_entities`: [Store_101, Store_102, Store_103, Store_104, Store_105]                     |
+-----------------------------------------------------------------------------------------------+
                     │
                     ▼ (用户第 2 轮追问: "那数码类目的退款率呢?")
+-----------------------------------------------------------------------------------------------+
| 【槽位继承与更新决策器 (Slot Update Decision Engine)】                                         |
| 1. 识别新意图: 增加 `category = '数码'`, 切换度量 `metric = 'refund_rate'`                    |
| 2. 槽位继承: 自动继承 `time_range` (上个月) 与 `store_id IN (Top 5 门店)`                       |
| 3. 输出重构后的完整全量逻辑 AST:                                                               |
|    `SELECT store_name, refund_rate FROM ... WHERE store_id IN (...) AND dt BETWEEN ...`        |
+-----------------------------------------------------------------------------------------------+
核心实现代码:Python 多轮对话状态追踪器(DST)
import json
import requests
from typing import Dict, Any, List

class MultiTurnChatBIStateManager:
    def __init__(self):
        # 维护当前会话的物理槽位状态
        self.session_state = {
            "time_range": None,
            "filters": {},
            "dimensions": [],
            "metrics": [],
            "last_returned_entity_ids": [],
            "order_by": None,
            "limit": None
        }

    def process_user_utterance(self, user_query: str) -> Dict[str, Any]:
        """
        结合上一轮历史槽位,解析当前用户输入的增量意图并执行状态融合
        """
        # 1. 构造带有上一轮上下文的 Prompt
        prompt = f"""
你是一个专业 ChatBI 多轮对话状态管理系统。请根据【历史槽位状态】和【用户最新输入】,执行以下操作:
1. 指代消解:如果用户说 "这几家"、"它们",将其绑定到历史实体 ID 列表;
2. 槽位更新:识别用户是新增过滤条件、修改现有条件(如换大区)、还是切换计算指标;
3. 输出融合后的最新全量槽位字典。

【历史槽位状态】:
{json.dumps(self.session_state, ensure_ascii=False, indent=2)}

【用户最新输入】:
"{user_query}"

请严格按 JSON 格式输出更新后的全量槽位状态:
"""

        # 2. 调用大模型进行增量槽位合并
        response = requests.post(
            "http://localhost:11434/v1/chat/completions",
            json={
                "model": "qwen2.5:14b",
                "messages": [{"role": "user", "content": prompt}],
                "temperature": 0.0,
                "response_format": {"type": "json_object"}
            },
            timeout=60
        )

        updated_state = json.loads(response.json()["choices"][0]["message"]["content"])
        self.session_state = updated_state

        # 3. 将融合后的全量状态编译为确定性 SQL
        compiled_sql = self._compile_slots_to_sql(self.session_state)
        return {
            "current_slots": self.session_state,
            "compiled_sql": compiled_sql
        }

    def _compile_slots_to_sql(self, slots: dict) -> str:
        """
        根据受控槽位直接编译物理 SQL,零语法错误风险
        """
        select_cols = slots.get("dimensions", []) + slots.get("metrics", [])
        where_clauses = []

        # 注入时间
        if slots.get("time_range"):
            where_clauses.append(f"dt BETWEEN '{slots['time_range']['start']}' AND '{slots['time_range']['end']}'")

        # 注入维度过滤
        for col, val in slots.get("filters", {}).items():
            if isinstance(val, list):
                val_str = ",".join([f"'{v}'" if isinstance(v, str) else str(v) for v in val])
                where_clauses.append(f"{col} IN ({val_str})")
            else:
                where_clauses.append(f"{col} = '{val}'" if isinstance(val, str) else f"{col} = {val}")

        sql = f"SELECT {', '.join(select_cols)} FROM dw_prod.dwd_orders"
        if where_clauses:
            sql += " WHERE " + " AND ".join(where_clauses)
        if slots.get("dimensions"):
            sql += f" GROUP BY {', '.join(slots.get('dimensions'))}"
        if slots.get("order_by"):
            sql += f" ORDER BY {slots.get('order_by')}"
        if slots.get("limit"):
            sql += f" LIMIT {slots.get('limit')}"

        return sql
真实测试日志复盘:四轮连续追问流转演练
>>> 用户第 1 轮: "查一下上个月华东大区销售额 Top 5 门店"
[系统编译 SQL]: SELECT store_name, SUM(pay_amount) FROM dwd_orders WHERE dt BETWEEN '2026-08-01' AND '2026-08-31' AND region = '华东' GROUP BY store_name ORDER BY SUM(pay_amount) DESC LIMIT 5;
[记录返回实体]: store_ids = [101, 102, 103, 104, 105]

>>> 用户第 2 轮: "那这几家门店里,数码类目的退款率是多少?"
[系统识别]: 继承 store_ids 与上月周期,新增 category='数码',切换指标为退款率
[系统编译 SQL]: SELECT store_name, SUM(refund_amount)/SUM(pay_amount) AS refund_rate FROM dwd_orders WHERE dt BETWEEN '2026-08-01' AND '2026-08-31' AND store_id IN (101, 102, 103, 104, 105) AND category = '数码' GROUP BY store_name;

>>> 用户第 3 轮: "如果换成华南大区呢?"
[系统识别]: 显式覆盖 region='华南',清空旧 store_ids 依赖,重新拉取华南 Top 5
[系统编译 SQL]: SELECT store_name, SUM(pay_amount) FROM dwd_orders WHERE dt BETWEEN '2026-08-01' AND '2026-08-31' AND region = '华南' GROUP BY store_name ORDER BY SUM(pay_amount) DESC LIMIT 5;
生产落地的三条核心红线
- 显式提供“重置上下文(Start New Topic)”交互按钮:当用户想要发起一个与之前毫无关联的全新查询时,允许用户一键清空历史槽位,防止老条件发生“僵尸污染”。
- 槽位老化与会话超时机制(Session TTL):如果用户超过 15 分钟未发问,自动将历史会话归档,新发问默认作为第 1 轮全新会话处理。
- 在界面上将“已继承的隐含条件”透明回显:在回答顶部显式呈现小标签:“已沿用:2026年8月、华东大区”,让业务清晰感知当前数字是在什么前置条件下得出的。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献13条内容

所有评论(0)