人形机器人运动控制技术全景研究报告:从运控基座到全身VLA
人形机器人运动控制技术全景研究报告:从运控基座到全身VLA
整合截至日期: 2026-09-11
网站: 运控全景研究报告
读者定位: 人形机器人运控工程师(具备强化学习与机器人动力学基础)
覆盖范围: 运控基座与动作跟踪、数据生成与动作重定向、学习范式、感知运控、全身 VLA 与 loco-manipulation 五大层次,合计 40+ 项代表性工作
体例说明: 每项工作保留九字段结构;事实性内容以 arXiv / 项目主页 / GitHub 原文为准;凡非原文直接证据、由上下文推断者,一律标注【推测】。算力/数据未公开处明确标注。
如何使用本报告
如果关心"底层运动控制器怎么训出来"——从第一层开始读,重点理解路线 A 与路线 B 的本质分野;如果关心"数据从哪来、怎么把人动作变成机器人数据"——直接跳到第二层;如果关心"策略怎么从跟踪走向泛化/适应"——第三层;如果关心"带视觉、能跑酷、能走野路"——第四层;如果关心"全身 VLA、边走边操作"——第五层。
每篇工作保留原始技术细节(网络结构、损失函数、训练配置),不做简化。每个工作的"读后心得"字段是本报告的核心价值——它回答的不是"这篇做了什么",而是"这篇对你的研究/工程决策意味着什么"。
术语约定
路线 A = 监督跟踪式:on-policy PPO + 参考动作逐帧稠密监督(DeepMimic 一脉)
路线 B = 无监督表征式:off-policy URL,无任务奖励,在潜空间学可提示(promptable)行为表征
CPR = FB-CPR(Tirinzoni et al. 2025),即 Forward-Backward + Critic Pessimism Regularization,不是 “Control as Probabilistic Reasoning”
总览
技术分类体系
人形机器人运控技术按"从底层执行到高层决策"的抽象层次,分为以下五层:
第一层:运控基座与动作跟踪
定义:在仿真中通过强化学习训练出的全身运动跟踪策略,输入本体感+参考动作/目标潜向量,输出关节目标角给 PD 控制器。这是所有上层能力的物理执行底座。
含两条子路线:
-
路线 A · 监督跟踪式:on-policy PPO + 参考动作逐帧稠密监督。代表工作:SONIC、Any2Any、MimicLite、RGMT、Any2Track。
-
路线 B · 无监督表征式:off-policy URL,无任务奖励,在潜空间学可提示行为表征。代表工作:BFM-Zero、UFO。
第二层:数据生成与动作重定向
定义:把人类动捕数据(SMPL/MoCap)转换成人形机器人可执行的运动学参考轨迹,并在物体/地形/本体维度做系统性增广。这是路线 A 的"燃料"来源。
代表工作:OmniRetarget(交互保留优化式重定向)、ExBody2(高保真表现力跟踪)、HOVER(多模式统一)、OmniH2O(多接口遥操作)、HumanPlus(shadowing 数据采集)、上海 AI Lab BFM(CVAE+掩码蒸馏)。补充:BONES-SEED 数据集、MoReFlow/AdaMorph/Human2Humanoid 跨形态重定向。
第三层:学习范式
定义:连接"纯模仿跟踪"与"泛化/适应/组合"的算法范式——跟踪+对抗混合、引导扩散、视频端到端、先理解再模仿等。
代表工作:HIL(tracking+AIL 混合)、BeyondMimic(引导扩散合成技能)、HDMI(人类视频到交互控制)、Visual Imitation(手机视频到上下文控制)、RoboMirror(先理解再模仿)。
第四层:感知运控
定义:在跟踪/运动策略基础上引入外感知(深度图/高程图/点云),使机器人能自主选择落脚点、适应非结构化地形、完成跑酷动作。核心输入是视觉+本体,无语言接口。
代表工作:SSR(单阶段视觉行进)、AME-2(注意力神经地图)、SOLO(长时地形行进)、PHP(motion matching 跑酷)、Humanoid Parkour Learning(清华端到端跑酷)、Berkeley Challenging Terrain(野外徒步)、Hiking in the Wild(MoE 可扩展)、ParkourFormer(Transformer 序列建模)、Deep Whole-body Parkour(tracking+感知统一)。
第五层:全身 VLA 与 loco-manipulation
定义:视觉-语言-动作(VLA)模型直接输出全身运动指令,实现"边走边操作"(loco-manipulation)。这是技术栈的顶层——大脑做语义理解,小脑做运动执行。
代表工作:Figure Helix 02、NVIDIA GR00T N1.x、WholeBodyVLA、Tesla Optimus、银河通用 AstraBrain-WBC、ω-0(潜预测世界动作模型)、Ψ0(人机数据对齐)、AMO(RL+轨迹优化)、OpenHLM(全身 VLA recipe)、VLK(3DGS 合成数据)、HAF(通用 VLA 适配)、POT-VLA(持久 3D 物体 token)、PhysiFlow(物理感知流匹配)、MotionWAM(统一运动潜变量)。
核心技术路线对比:路线 A(监督跟踪式)vs 路线 B(无监督表征式)
| 维度 | 路线 A · 监督式动作跟踪(SONIC / MimicLite / RGMT / Any2Track) | 路线 B · 无监督表征学习(BFM-Zero / UFO) |
|---|---|---|
| 训练范式 | on-policy PPO;参考动作逐帧稠密监督(DeepMimic 一脉) | off-policy URL;无任务奖励,replay buffer 大规模复用经验 |
| 数据需求 | 大规模重定向 mocap:SONIC 611h/1 亿+帧;MimicLite 用 BONES-SEED 级;RGMT 极致精选 3.5h;都离不开高质量人到机重定向数据 | 少量无标签 mocap 仅作正则/进度信号;UFO 用约 2 至 3h LAFAN1 重定向即可;主数据来自机器人自身在线无奖励探索 |
| 表征方式 | 显式参考帧序列(未来 10 至 21 帧关节角/速度/root 量),SONIC 额外学一个 FSQ 动作 token 接口 | 潜向量 z:BFM-Zero 用 FB 前后向映射 F(s,a)/B(s) + 后继特征;UFO-TeCH 用对比时序距离嵌入;z 同时编码动作/目标/奖励 |
| 如何下指令 | 上游给一段参考动作序列(回放片段/规划器生成/VR 流),策略跟随 | 上游给一个潜向量:参考片段编码、单帧目标姿态编码、奖励加权和;同空间可线性组合/插值 |
| 训练成本 | 两极分化:SONIC 21k GPU·h(128 GPU×7 天);但 MimicLite 92 个 4090 GPU·h、RGMT 单张 4090 也能到接近水平 | 普遍低:BFM-Zero 约 3 天高显存卡;UFO 8×4090 6 至 12h、TeCH 单卡数小时——TeCH 论文称比 SONIC 省近两个数量级的 GPU·h 与环境样本 |
| 跟踪精度 | 高:SONIC/RGMT 关节 MPJPE 数十 mm 级;RGMT 自称 mocap 成功率 98.3% | 略低:TeCH 论文实测 LAFAN1 关节 E_mae,SONIC(未终止段) 0.1081 vs BFM-Zero 0.1510 vs TeCH 0.1318;但全轨迹含摔倒恢复段时 SONIC 0.2916 反被 URL 超过 |
| 泛化能力 | 泛化到"训练分布内的新动作片段";对未见过的姿态序列靠重定向+噪声鲁棒(RGMT 的注意力过滤、Any2Track 的 adapter) | 泛化到"训练分布外的新目标姿态/新奖励函数",支持非连续目标切换、摔倒自恢复、扰动后回到行为流形 |
| 摔倒/扰动恢复 | 需专门设计:Any2Track 两阶段 adapter、RGMT 把恢复 curricula 并入训练;SONIC 原文承认摔后难回到稳定段 | 天然内建:潜空间预训练覆盖了躺/坐/站等恢复状态,BFM-Zero 与 TeCH 均无需单独恢复微调即可爬起 |
| 可组合性 | 参考动作即接口,直观但要求上游先生成"可执行动作";lookahead 需求高(SONIC 0.90s);动作片段间切换生硬 | z 空间可组合、可插值、可被 VLA/规划器直接优化(奖励到 z);同一策略零样本切换目标;但潜向量对人不可读 |
| 部署门槛 | PPO on-policy 工具链成熟(IsaacLab/MuJoCo),实机部署案例多(G1 为主);SONIC 级算力门槛极高但 MimicLite/RGMT 级单卡可用 | off-policy + 表征学习训练敏感(FB 双映射不稳、线性 MDP 假设局限);但复现门槛正被 UFO 这类框架快速打下来 |
| 工程成熟度 | 高:PPO on-policy 稳定、工具链成熟、实机验证充分 | 中:表征学习对超参敏感、训练不稳定,但效率数量级提升中 |
| 典型短板 | 任务/技能写死在参考分布里;非连续目标切换生硬;摔后易"死机";规模路线算力贵 | 单帧跟踪精度不如专用跟踪器;FB 路线长时程根漂移;表征质量敏感于超参;动作风格偏保守(mocap 判别器拉慢) |
一句话趋势判断: 两条路线正在收敛——路线 A 靠"动作 token 空间"往可组合性走(SONIC 的 FSQ token 喂 VLA),路线 B 靠"直接跟踪目标"往精度走(TeCH 的 E_mae 已逼近 SONIC 未终止段水平)。对落地运控基座而言,短期看"监督跟踪器做小脑 + token 接口接大脑 VLA"最现实(SONIC/GR00T N1.7 路线);中期看 URL 的可提示行为空间(BFM-Zero/UFO)更像"基座"该有的形态,且训练成本正在快速下探到单卡可用。
推荐阅读路线
在阅读SONIC的基础上,以下按"入门到进阶到数据层到感知层到终局"给出每篇的阅读难度、预计时间与核心收获。
| 顺序 | 工作 | 所属层次 | 难度 | 预计时间 | 一句话核心收获 |
|---|---|---|---|---|---|
| 1 | MimicLite | 第一层 | ★★☆☆☆ | 2 至 3h | 用千分之一成本(92 GPU·h、0.08s 前瞻)复刻 SONIC 跟踪范式,理解 lookahead 窗口和观测设计对部署的影响 |
| 2 | RGMT | 第一层 | ★★★☆☆ | 2 至 3h | 动力学条件化交叉注意力——策略如何"选择性相信"脏参考动作,单卡 3.5h 数据对标 SOTA |
| 3 | BFM-Zero | 第一层 | ★★★★☆ | 3 至 4h | 无监督表征起点——FB-CPR 如何把动作/目标/奖励压进同一潜空间,第一个证明"不学每段动作、只学行为坐标系"可行 |
| 4 | UFO | 第一层 | ★★★☆☆ | 2 至 3h | FB 训练效率数量级改进(3 天到 6h),TeCH 对比时序距离绕开 FB 的线性 MDP 假设;理解路线 B 的工程化进展 |
| 5 | Any2Track | 第一层 | ★★★☆☆ | 2 至 3h | 两阶段解耦——先把动作练到极致再外挂抗扰 adapter,"怎么踹都不倒"的结构设计 |
| 6 | OmniRetarget | 第二层 | ★★★☆☆ | 2 至 3h | 交互网格 Laplacian 变形——重定向的天花板不是关节对齐而是"别把人和箱子的关系弄丢",一份 MoCap 变出整套任务数据 |
| 7 | HIL | 第三层 | ★★★☆☆ | 2h | tracking 保自然性 + AIL 增适应——别在 loss 层面和稀泥,让策略同时打两份工 |
| 8 | HumanPlus | 第二层 | ★★☆☆☆ | 2h | shadowing 数据采集范式——50 美元硬件 + 40 条 demo 学全身技能,HIT 的 decoder-only + 前向图像预测 loss |
| 9 | SSR | 第四层 | ★★★☆☆ | 2h | 预想落脚点引导——别等脚踩空了才后悔,摆动阶段就"脑补"落脚点安不安全 |
| 10 | PHP | 第四层 | ★★★☆☆ | 2h | motion matching 拼接人类原子技能——别让 RL 从零学翻墙,让它查字典选最像的运动员动作 |
| 11 | SOLO | 第四层 | ★★★★☆ | 3h | 长时部署两大失效模式——地图把台阶边缘糊掉 + 逐帧蒸馏没时间信用分配,QR 重建 + TA-MSE 怎么修 |
| 12 | GR00T N1.x | 第五层 | ★★★☆☆ | 2h | 人形机器人界的 Llama——开源双系统 VLA 底座,SONIC 作为其低层控制器 |
| 13 | Figure Helix 02 | 第五层 | ★★☆☆☆ | 1h | 闭源双系统全身 VLA——System 2 慢思考 + System 1 快反应,商业化最成熟路线 |
| 14 | WholeBodyVLA | 第五层 | ★★★☆☆ | 2h | 无标注人类视频预训练全身运动表征(LAM)+ RL 管运动稳定(LMO),VLA 管语义 |
| 15 | ω-0 | 第五层 | ★★★☆☆ | 2h | 潜预测世界动作模型——机器人不需要在脑子里放电影,知道下一步大概什么样就够了;扩散动作喂 SONIC 执行 |
| 16 | Ψ0 | 第五层 | ★★★☆☆ | 2h | 人机数据不对齐问题——人和机器人身体不一样,直接 co-training 次优,得先"翻译"对 |
运控基座与动作跟踪
本层包含 7 项工作,每项标注路线 A(监督跟踪式)或路线 B(无监督表征式)。
SONIC(NVIDIA GEAR / BONES-STUDIO,Science Robotics 2026)
路线归属: 路线 A · 监督式动作跟踪(规模顶点)
一句话定位: NVIDIA GEAR 团队把"运动跟踪"本身当作可缩放任务,用 PPO + 百万级动作捕捉数据训出一个单网络控制 Unitree G1 全身 29 自由度的通用跟踪基座,并首次给出人形控制的 scaling law 证据。
核心设计思路:人形控制过去模型小、任务少、用几块 GPU 训;SONIC 的直觉是:运动跟踪有逐帧稠密监督(mocap 每帧就是目标姿态,不用手搓 reward),天然像 NLP/视觉一样可 scale。于是沿三条轴同时放大——模型参数、数据量、算力——证明性能随三者单调改善,并额外造了一套"通用 token 空间",让 VR 遥操、视频/文本/音乐生成、VLA 都能驱动同一个策略。
技术核心机制:
-
数据:约 700 小时自建 mocap(男女平衡、33 个主类、8447 个子类、含格斗/舞蹈/工具使用/受伤步态等),经 GMR + PyRoki 重定向到 G1 并剔除攀爬/坐姿等机器人不可执行动作后保留 611 小时、1 亿+帧 @50Hz;公开版 BONES-SEED(HuggingFace,142,220 段、288 小时、522 名演员,含 SOTA/G1 双格式与文本标注)。
-
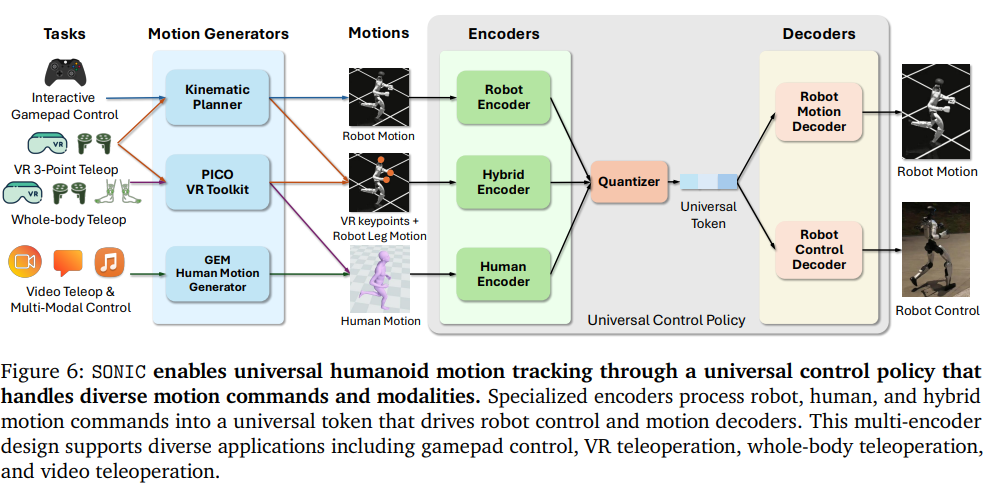
网络结构(编码器-量化器-解码器):三个专用编码器 MLP
[2048,1024,512,512],分别处理机器人动作命令 g r g_r gr、人体 SMPL 动作 g h g_h gh、混合遥操命令 g m g_m gm(上身关键点+下身机器人动作);FSQ 有限标量量化(非 VQ-VAE,避免 codebook 坍缩):2 个 token,默认配置 FSQ-32-32(每维 32 级、32 维),直通估计(STE)传梯度;控制解码器 D c D_c Dc(MLP[4096,4096,2048,2048,1024,1024,512,512])输出 29 维目标关节角给 PD;另有辅助动作解码器 D r D_r Dr 仅吃 token 重构机器人命令,兼作隐式人到机重定向模块;critic 与控制解码器同构,非对称 actor-critic(critic 看特权状态)。 -
观测:本体感 ( q , q ˙ , ω , g r a v i t y p r o j , a t − 1 ) (q, q̇, ω, gravity_{proj}, a_{t-1}) (q,q˙,ω,gravityproj,at−1) 拼接 10 步历史;命令为未来 10 帧(机器人/混合命令帧间隔 0.1s,人体 0.02s);全程局部坐标系、6D 旋转表示。
-
损失: L = L p p o + L r e c o n + L t o k e n + L c y c l e L = L_{ppo} + L_{recon} + L_{token} + L_{cycle} L=Lppo+Lrecon+Ltoken+Lcycle。L_recon 强制三编码器输出重构同一机器人命令(人体输入时即重定向损失);L_token 让同一动作的人/机/混合 token 两两对齐;L_cycle 做人 token 到重构机器人命令再到再编码的循环一致性。
-
奖励:指数核跟踪(root 位姿、全身 link 相对位姿与线/角速度、头/腕/踝末端点)+ 惩罚(动作率、关节越限 -10、非踝/腕不良接触)。物理参数、root 扰动、目标命令扰动全部 domain randomization。
-
采样:bin-based 自适应采样(按失败率加权,1 秒 bin,失败率上限 β=200);PPO 超参:
4096 envs GPU,actor lr 2e-5,critic lr 1e-3,熵系数0.013,自适应 KL 约0.01。 -
下游接口:实时运动学规划器(潜空间 masked token 预测,变长 0.8 至 2.4s 动作段,重规划最快 100ms 一次;root 用临界阻尼弹簧模型限幅);通用 token 接口喂 VLA:GR00T N1.5 预测 78 维(64 维 token + 14 维手),比直接预测 SMPL 姿态成功率 68% vs 27%(易拉罐任务 60% vs 0%);部署:Jetson Orin + TensorRT/CUDA Graph,策略前向 1 至 2ms,50Hz 控制/500Hz 命令写/100Hz 输入/10Hz 规划四线程。
关键创新点:
- 人形控制领域首个系统的 scaling law:1.2M 到 42M 参数、100M+ 帧、9k 到 21k GPU·h,且数据量增大收益最大;
- 证明稠密跟踪监督可 scale、对抗式模仿(AMP 类)不可 scale——对照实验显示 OpenHomie 式任务奖励很快饱和;
- 统一 token 空间把异构输入(人 SMPL / 机器人 / 混合 3 点遥操 / VLA)对齐到同一动作潜空间,一套策略多模态复用;
- 跟踪器直接成为 GR00T VLA 的"小脑",端到端 VLA loco-manipulation(手脚协调落点)。
数据/算力/训练成本: - 数据:611 小时(1 亿+帧);公开 BONES-SEED 288h。
- 算力:21k GPU·h(128 GPU 约 7 天);scaling 对比用 8/32/128 GPU 三档;Isaac Lab 分布式训练。
- 仿真:Isaac Lab;硬件:Unitree G1(29 DoF)。
特点与局限:
-
优势:规模证据硬、真实 sim2real 零微调、接口生态完整(VLA/VR/视频/摇杆)、代码与数据开源(NVlabs/GR00T-WholeBodyControl,BONES-SEED 在 HF)。
-
局限:单一机型 G1(跨机型靠下游 Any2Any 等工作补);未形式化安全与能耗;极端高动态下仍可能失衡;lookahead 需求大(0.90s,低延迟版 0.18s),对上游规划器生成能力依赖强;算力门槛极高,复现困难。
与同领域其他工作的关系:
-
技术谱系:DeepMimic 到 PHC/ExBody 到 GMT 的"通用跟踪"主线的规模化顶点;
-
被 GR00T N1.5/N1.7 作为低层全身控制器(GEAR-SONIC embodiment);
-
Any2Any 以 SONIC 权重为源做跨形体重定向;
-
与 MimicLite、RGMT 构成"大实验室规模 vs 小团队低成本"两条路线的对照组;
-
已成为 loco-manipulation 的事实底层控制器——ω-0、OpenHLM、GR00T N1.x 均接 SONIC 作为执行层。
读后心得: 人形控制的"GPT 时刻"不是来自自博弈,而是来自"把 mocap 当语料、把跟踪当下一 token 预测"——稠密监督能 scale,对抗判别器不能。
来源链接:
Any2Any(LimX Dynamics,SONIC 跨形体重定向)
路线归属: 路线 A 的后训练/跨机型迁移模块(监督跟踪器权重的 PEFT 迁移)
一句话定位: 不重训,只动 1% 的算力和数据,把在 Unitree G1 上预训练好的 SONIC 全身跟踪器迁移到 LimX Oli/Luna、Unitree H1 等新机型。
核心设计思路: 跨机型迁移的误差 = 运动学结构误差(自由度/关节序/髋关节轴偏置)+ 动力学残差(M/C/G 矩阵差异)。先用纯几何对齐把输入输出空间"摆"到源策略熟悉的语义里,再只对动力学敏感的模块做低秩微调——因为同类人形机的动力学差是低维的,没必要动整个 42M 参数。
技术核心机制:
-
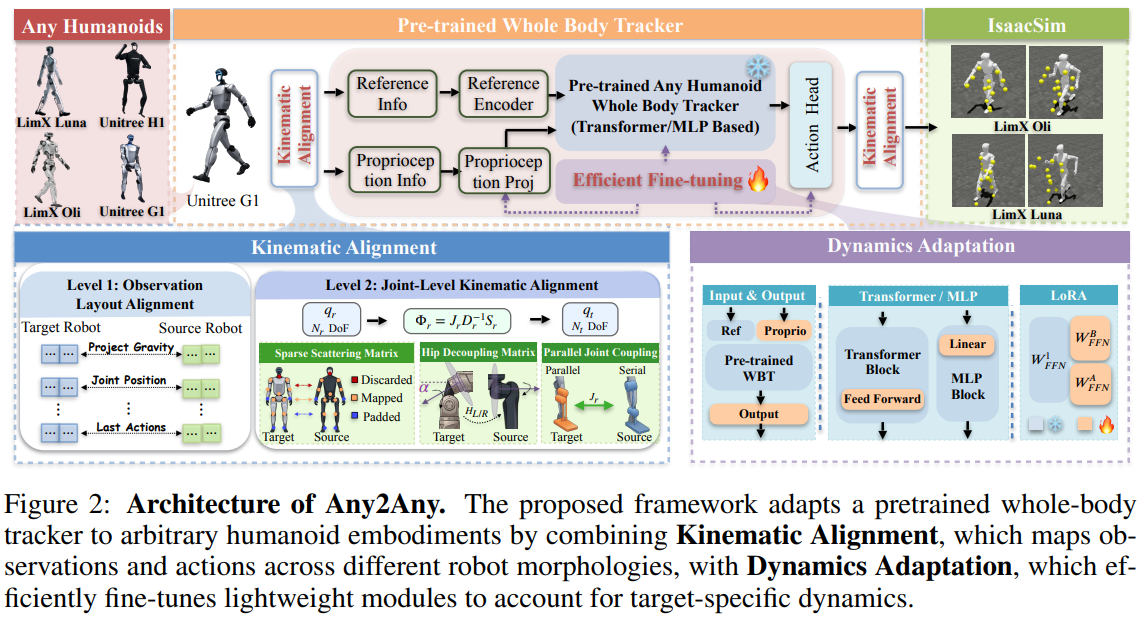
两级运动学对齐(Kinematic Alignment):Level 1 观测布局对齐——把目标机的 base 状态、参考动作、本体感、动作历史按源策略期望的顺序重排;Level 2 关节级对齐——构造双向映射 Φ r : R N r Φ_r: R^{N_r} Φr:RNr 到 R T R^T RT(T=源 G1 自由度)。由 (i) 稀疏散射矩阵 S r S_r Sr(部分关节注入,源侧缺关节零填、目标侧多关节丢弃)+ (ii) 髋解耦矩阵 D r D_r Dr(补偿源机髋关节俯仰轴倾斜导致的坐标耦合)组成。
-
动力学适配(Dynamics Adaptation):从刚体残差 Δ τ = Δ M ⋅ q ¨ + Δ C ⋅ q ˙ + Δ G Δτ = ΔM·q̈ + ΔC·q̇ + ΔG Δτ=ΔM⋅q¨+ΔC⋅q˙+ΔG 出发论证适配容量应正比于 Δη 而非原参数规模;冻结主干,仅在 actor 动力学解码器与 critic 中插入 LoRA(论文也比较了 adapter bottleneck / prefix-tuning),FSQ 量化层及其余全部冻结。
-
效果数字:SONIC 到 Oli 仅约 80 GPU·h(约 8 小时),相对 SONIC 原训练约 9000 GPU·h/700h 数据约 1%;Oli 上 LAFAN 成功率 83.1% 到 90.6%,MPJPE 69.7 到 47.2 mm,root 位置/姿态误差 10.48cm 到 8.49cm、7.3° 到 5.6°;物理 LimX Oli 上实机走跑跳/舞蹈。6 组迁移对(SONIC2Oli/Luna/H1、Oli-WBT2Luna/G1/H1)。
关键创新点:
- 首个系统的人形全身跟踪器跨机型迁移研究;
- 用刚体动力学残差解释"PEFT 插在哪、插多少",而非玄学式全网络微调;
- 证明 robot-specific WBT 权重可复用,跨机型部署成本降两个数量级。
数据/算力/训练成本: 约 80 GPU·h(单卡时长约 8h 量级);数据量为从零训练的约 1%;具体 GPU 型号未在摘要公开【推测为同构 GPU 集群,量级远小于 SONIC】。
特点与局限:
- 优势:直接复用 GEAR-SONIC 开源权重,落地友好;迁移成功率与收敛速度双优。
- 局限:仅适用于同构人形(共享拓扑、尺度相近),腿数/自由度差异大或轮腿混合形态未覆盖;LoRA 插入位置仍需人工指定动力学敏感模块;属后训练工作,不解决"从零训基座"。
与同领域其他工作的关系:
- SONIC 的下游后训练/跨机型补丁(LimX 基于 GEAR-SONIC checkpoint);
- 与 GMR 类运动学重定向(Araujo et al.)互补——GMR 对齐动作数据,Any2Any 对齐策略权重;
- 为"MimicLite/RGMT 等自研 tracker 是否值得从零训"提供了反例:迁移 SONIC 可能更便宜;
- 在 BFM 综述五类分类中落在 04 Adaptation 组。
读后心得: tracker 真正贵的是"学会人怎么动"这件事,"学这台机器人"只是一个低维残差——所以新机型不该从零开始,而该给一个冻结的大师配上 LoRA 徒弟。
来源链接:
MimicLite(RoboParty 银河智能)
路线归属: 路线 A · 监督式动作跟踪(低成本开源路线)
一句话定位: 开源、可部署的轻量通用动作跟踪框架:在 MuJoCo 等价评测里全球根跟踪超过 SONIC、局部精度持平,而训练成本约为后者的千分之一。
核心设计思路: 不堆数据堆算力,而是把跟踪策略的 lookahead(前瞻帧数)、观测构造、训练后端做薄——声称 SONIC 的 0.90 秒前瞻是部署负担,MimicLite 把前瞻压到 0.08 秒,让同家族策略既能跑 Pico 低延迟遥操,又能在 G1 上做高动态跟踪。
技术核心机制:
-
两种策略:MimicLite-PPO(标准 PPO)与 MimicLite-ROA(PPO + active adaptation,三阶段 train 到 adapt 到 finetune,对应其 active-adaptation 仓库)。
-
网络:actor 隐层
[1024,1024,1024];并行环境 16 × 16384。 -
训练成本(RTX 4090 GPU·h):PPO 92.3 h;ROA 173.2 h(第三方报道称 8×4090 约 3 小时量级,与 GPU·h 口径一致)。
-
前瞻延迟对比(50Hz 合同下最远未来参考帧):MimicLite 0.08s;BFM-Zero 0.12;SONIC 0.90s(SONIC 低延迟版 0.18s);HoloMotion 0.20;TeleopIT/TWIST2 0.00。
-
数据:走 any4hdmi HF 数据集集合;BONES-SEED 因许可只提供转换脚本(引导用户去官方源下载)。
-
部署栈:sim2real 运行时(ONNX 推理、MuJoCo sim2sim、Pico 遥操、Unitree G1),观测接口与策略解耦,同一运行时已接入 SONIC、HEFT、TeleopIT、Humanoid-GPT、BFM-Zero、TWIST2 等多家 checkpoint。
关键创新点:
- 在"matched MuJoCo 评测"下以极小成本对标/局部超越 SONIC,把通用跟踪的复现门槛打到单卡几小时;
- 极低 lookahead + 统一部署运行时,直接面向遥操与实机;
- PPO-ROA 的主动适配思路(train 到 adapt 到 finetune)。
数据/算力/训练成本: 92.3 / 173.2 RTX 4090 GPU·h;16×16384 环境;MuJoCo(MJLab/MuJoCo Playground 生态);G1 实机。
特点与局限:
- 优势:成本/前瞻/部署三位一体,开源友好,评测横向覆盖十余家策略;
- 局限:"超过 SONIC"是自定义 matched-eval口径,外部独立复现有限;GPL-3.0;技术报告透明度低于 arXiv 正式论文;运动多样性规模(611h 级 BONES)仍依赖外部数据源。
与同领域其他工作的关系:
- SONIC 的低成本开源挑战者;与同厂 UFO 组成 RoboParty PartyOS 的"监督跟踪 + 无监督行为"双子模块,配套 hhtools 重定向;
- 与 RGMT 同属"小数据小算力但要效果"路线;Any2Track/GMT 是其对标基线。
读后心得: 通用跟踪不是大厂专利——把前瞻窗口和观测设计做对,一张 4090 熬一晚上,就能摸到 21k GPU·h 那个模型的脚后跟。
来源链接:
BFM-Zero(CMU LeCAR Lab + Meta,路线 B 起点)
路线归属: 路线 B · 无监督表征学习(首个真实人形上的 promptable 行为基座;UFO 的直接对标对象)
关键事实: arXiv 2511.04131,CMU LeCAR Lab + Meta,FB 表征 + FB-CPR,Unitree G1 零样本。CPR = FB-CPR(Tirinzoni et al. 2025),不是 Control as Probabilistic Reasoning。
一句话定位: 首个在真实 Unitree G1 上零样本部署的人形"行为基座模型":用 Forward-Backward 无监督 RL 把动作、目标、奖励压进同一个可提示潜空间,一个策略不改训练即可做跟踪、到达、奖励优化与少样本适应。
核心设计思路: 监督跟踪路线要逐段参考动作、逐任务设计奖励;BFM-Zero 反过来——不要任务奖励、要一个"行为语义坐标"。机器人在线无奖励探索 + 少量无标签 mocap 正则,学出一组潜向量 z;z 既是"技能 id"又是"目标嵌入":你把一段参考动作、一个目标姿态、或一个奖励函数投到这个空间里,策略就照着做,且不需要重训。
技术核心机制:
-
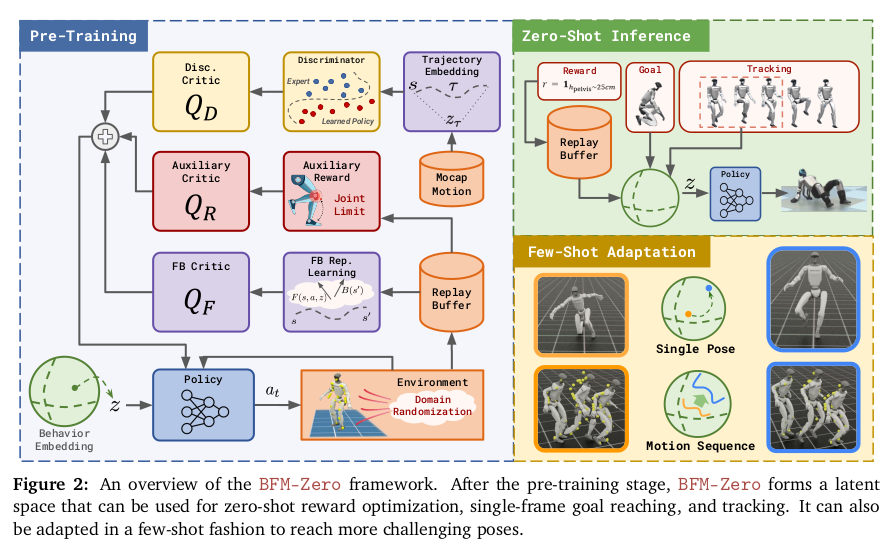
基座算法:FB-CPR(Tirinzoni et al. 2025)= FB 零样本 RL(Touati & Ollivier 2021)+ 在线训练 + mocap 上的策略正则。论文原文只说 FB-CPR “combines the FB method for zero-shot RL with online training and policy regularization on motion-capture data”;从其架构图看,mocap 正则由一个 Discriminator Critic Q D Q_D QD 承担——判别"当前状态来自 mocap expert 还是学到的策略",把策略行为往人类动作分布上拉。中文复现仓库将其称为 “Critic Pessimism Regularization”【该全称来自复现仓库自述,论文正文未展开,标注为社区口径】。
-
FB 表征三件套(后继特征 successor-feature 框架):潜任务特征编码器 φ : S → R d φ: S \to R^d φ:S→Rd,把状态映到 d d d 维嵌入;前向映射 F F F: ( s , a ) → z (s,a) \to z (s,a)→z;后向映射 B B B: s → z s \to z s→z(“finite-rank approximation of long-term policy dynamics”,B 提炼长时程依赖的低频特征);潜条件后继特征 F z F_z Fz 约等于 E [ Σ γ t φ ( s t ) ∣ π z ] E[Σ γ^t φ(s_t) | π_z] E[Σγtφ(st)∣πz]——学"在 z z z 条件下执行策略,未来状态特征加权和",从而让奖励可在 z z z 空间线性组合。
-
三个 critic 并行:FB Critic Q F Q_F QF(后继特征/前向后向学习);Discriminator Critic Q D Q_D QD(mocap expert vs 策略行为判别,把行为拉回人类分布);Auxiliary Critic Q R Q_R QR(关节限位等安全/操作约束辅助奖励)。
-
观测/状态:可观测 o t = [ q − q ˉ ( 29 ) , q ˙ ( 29 ) , ω t r o o t / 4 ( 3 ) , g p r o j ( 3 ) ] o_t = [q-q̄(29), q̇(29), ω_t^{root}/4(3), g_{proj}(3)] ot=[q−qˉ(29),q˙(29),ωtroot/4(3),gproj(3)] = 64 维 + 历史窗 H H H;特权状态 s 属于 R 463 R^{463} R463(root 高、全身 link 位姿、线/角速度);动作=29 维 PD 目标角;G1 29 DoF;POMDP 建模,非对称 history-dependent 训练(critic 吃特权信息)。
-
Promptable 推理(核心):零样本跟踪——把参考动作片段 s t : t + k s_{t:t+k} st:t+k 过后向映射得 z t = B ( s t : t + k ) z_t = B(s_{t:t+k}) zt=B(st:t+k),策略以 z 为条件执行;目标到达——对单帧目标姿态编码 z = B ( s g o a l ) z = B(s_{goal}) z=B(sgoal);奖励优化—— z = Σ B ( s i ) r i z = Σ B(s_i) r_i z=ΣB(si)ri,在 z z z 空间线性叠加"被奖励状态",无需再训练;少样本适应——在潜空间做采样式优化(4kg 负载等新目标几轮交互内收敛)。
-
sim2real 手段:domain randomization + 历史依赖非对称训练 + 辅助安全奖励;实机零样本跟踪/到达/奖励优化均验证,并从大推力下自然恢复。
关键创新点:
- 第一个把 off-policy 无监督 RL 行为基座真正落到真实人形(此前 FB/BFM 只在仿真角色或特定任务上);
- 目标/动作/奖励统一进同一 z 空间,三种零样本推理方式 + 一种少样本适应共用一套策略;
- 用判别式 mocap 正则把"无监督探索出来的野路子行为"拽回人类动作分布——这是它比纯 FB 更稳的关键。
数据/算力/训练成本: 在线 off-policy(replay buffer)+ 无标签 mocap 正则;Isaac 系仿真;G1。具体 GPU 数量/时长:论文正文未明确披露【RoboParty UFO 论文称其原始实现需"高显存 GPU + 约三天",可作为第三方旁证】;另在 Booster T1 上做了迁移验证。
特点与局限:
- 优势:无需逐任务奖励、可提示可组合、摔倒后能自然爬起(统一潜空间覆盖了恢复动作)、实机验证最早最完整;
- 局限:线性 MDP 假设导致接触-rich 场景表征不稳;FB 双映射联合优化训练困难;判别器式 mocap 正则把行为拽得偏"慢、保守"(TeCH 论文实测其动作偏缓、直接性差);快速大幅转身时根全局旋转累计漂移明显;单帧跟踪精度不及 SONIC。
与同领域其他工作的关系:
- 上游:Touati & Ollivier (2021) FB;Tirinzoni et al. (2025) FB-CPR;
- 平级先驱:Meta Motivo(arXiv 2504.11054,ICLR 2025,仿真角色首个 BFM);
- 直接被 UFO 对标与超越:UFO-FB 把其 FB 训练从 3 天压到 6 至 12h、EMD 0.731 到 0.639;UFO-TeCH 又在跟踪误差、根旋转漂移、训练稳定性上进一步超过它;
- 与路线 A(SONIC 等)的关系:TeCH 论文同场对比——SONIC 跟踪更精但摔后难恢复、不支持非连续目标到达;BFM-Zero/UFO 类 URL 覆盖更广的非标准状态、摔倒恢复与扰动容忍更强,但单帧跟踪精度略逊;
- 在 BFM 综述五类分类中落在 01 Forward-backward 表征 组。
读后心得: 它的价值不是"跟踪得更准",而是第一次证明:可以不学"每一段动作",只学一个"行为坐标系",然后用坐标点任意位置的方式指挥机器人——这才像基座模型该有的样子。
来源链接:
UFO(RoboParty 无监督强化学习框架)
路线归属: 路线 B · 无监督表征学习(BFM-Zero/FB 范式的对标改进框架)
一句话定位: 开源人形无监督 RL(行为基座 BFM)框架:在不要任务奖励的前提下,把 BFM-Zero 的 Forward-Backward 训练从 3 天压到 6 至 8 小时,并内置自研对比时序距离算法 TeCH。
核心设计思路: 跟踪类方法要参考动作;UFO 走另一条路——off-policy URL:用大规模 replay buffer 复用经验,在潜空间学"行为进展/时序可达性",学完之后同一个策略既能零样本跟踪参考动作、又能做目标到达和奖励推理,还天然带抗扰恢复能力。
技术核心机制:
-
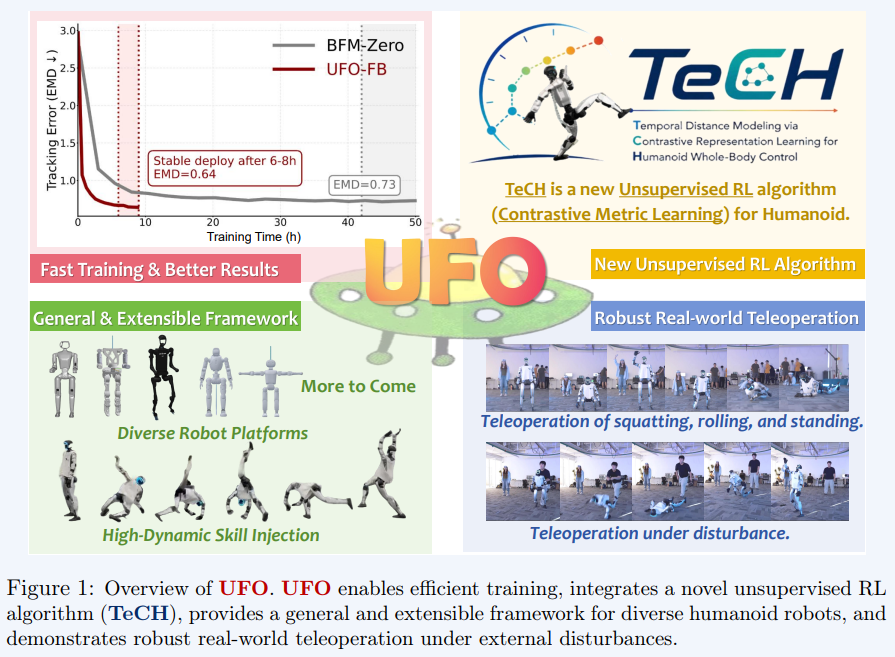
UFO-FB:复现并加速 BFM-Zero 的 Forward-Backward 表征学习(Touati & Ollivier 2021;人形上由 BFM-Zero 引入,配 CPR Critic 悲观正则)。8×RTX 4090 上 少于 12 小时(论文摘要称 6 至 8h)训完,原实现约 3 天且需高显存卡;8×H200 上跟踪误差 EMD 0.731 到 0.639,吞吐约 993 FPS;
-
TeCH(Temporal-distance modeling via Contrastive representation learning for Humanoid):人形版 TLDR(Bae et al. 2024)——用对比学习建模状态间时序距离,在潜空间里构造稠密 progress reward;推理时:跟踪任务把参考轨迹逐帧过 backward_map 得到 z z z 序列喂策略;目标到达则对目标姿态编码一个 z z z,周期性切换目标;
-
机器人解耦:MuJoCo XML 辅助生成 RobotTrainingSpec/Hydra 配置,URDF 可补充关节限位;统一 RobotState 接口导入重定向动作;已验证 G1、Booster K1、Unitree H1、RP1/RPO、AgiBot X2 等多形态;
-
高动态技能注入:在不破坏原基座多样性的前提下把侧手翻等新动作注入训练分布;实机遥操 + 受扰自恢复。
关键创新点:
- FB 训练效率数量级提升且不挑高显存硬件;
- 算法无关框架:同一管线同时跑 FB 与 TeCH,证明人形 BFM 不必绑死 FB;
- 首个把人形 URL 基座做到实机遥操 + 扰动恢复的开源完整栈。
数据/算力/训练成本: 8×RTX 4090 约 6 至 12 小时(8×H200 21h 为另一组对照配置);MuJoCo/MJLab;多机型;具体动作数据规模未逐项公开【推测基座数据与 BFM-Zero 同源量级】。
特点与局限:
- 优势:无需逐任务 reward、可提示(promptable)、抗扰恢复开箱即用、跨机型 bring-up 成本低;
- 局限:URL 学到的是"可组合行为空间",单帧跟踪精度不及专用跟踪器;新机型接入作者自承"still experimental";论文为技术报告性质。
与同领域其他工作的关系:
- 直接对标对象是 BFM-Zero(路线 B 的起点,CMU LeCAR+Meta,arXiv 2511.04131):BFM-Zero 首次把 Forward-Backward(FB)表征搬到真实 G1 上;UFO 的论文原话是"改进 FB 训练效率、6 至 8 小时训完且性能更好"。
- UFO 针对 FB 表征的三条核心局限做改进:(1) 线性 MDP 假设失效——FB 在潜空间中假设状态转移满足线性 MDP / 后继特征分解,在人形复杂接触动力学下表征不稳定;UFO 内置的 TeCH 放弃值函数分解,改用 TLDR 式对比时序距离直接建模时序可达性,绕开该假设;(2) 双映射联合优化脆弱——FB 需同时优化 forward F ( s , a ) F(s,a) F(s,a) 与 backward B ( s ) B(s) B(s) 两个映射,训练不稳;TeCH 用单一时序距离编码器 + 稠密 progress reward,目标更直接、pipeline 更短;(3) 长时程/全局根漂移误差——FB 的后继测度 M M M 为间接分解,引入近似误差,导致全局朝向、长时程相位与根坐标累计漂移建模不准;TeCH 把跟踪目标写得更直接,根旋转漂移更小。
- 同时 UFO 仍保留并优化了 FB 路线(UFO-FB):把 BFM-Zero 约 3 天的训练压到 6 至 12 小时、去掉高显存依赖、EMD 0.731 到 0.639——即"既造更好的新算法 TeCH,也把旧算法 FB 工程化加速",形成同框架内 A/B 对比。
- 与同厂 MimicLite 互补:MimicLite=路线 A 监督跟踪,UFO=路线 B 无监督表征,共同构成 PartyOS 底层运控 infra;
- 上游谱系:Touati & Ollivier (2021) FB 到 Tirinzoni et al. (2025) FB-CPR 到 BFM-Zero 到 UFO(FB 加速 + TeCH);下游可接 goal-reaching、reward inference、零样本跟踪与少样本适应。
读后心得: 跟踪和无监督技能发现是同一枚硬币的两面:前者告诉你"怎么把这段动作做标准",后者回答"没有标准答案时一个身体会做哪些动作"——而后者在 8 张 4090 上半天就能跑出来。
来源链接:
RGMT(Robust and Generalized Humanoid Motion Tracking,北理工 + 人形机器人(上海))
路线归属: 路线 A · 监督式动作跟踪(抗噪/低数据变种)
一句话定位:用"动力学条件化的命令聚合"让跟踪策略学会不全信参考动作——参考有噪声/artifact 时也能稳,并把跌倒恢复揉进单阶段训练;全部只用 3.5 小时数据、单张 4090。
核心设计思路: 重定向来的参考动作常有穿模、接触不一致、高频噪声;闭环执行会把局部缺陷放大成漂移/失败。既然如此,策略就不该把 2L 窗口内每一帧命令当成同等可靠的监督——用最近本体感总结出"当前身体动力学状态",再用它做 query 去选择性加权整个命令窗口。
技术核心机制:
-
观测/动作:本体感 [ g r a v i t y p r o j ( 3 ) , ω ( 3 ) , q − q 0 ( 29 ) , q ˙ ( 29 ) , a t − 1 ( 29 ) ] [gravity_{proj}(3), ω(3), q-q0(29), q̇(29), a_{t-1}(29)] [gravityproj(3),ω(3),q−q0(29),q˙(29),at−1(29)];命令 g t = [ v r e f ( 3 ) , ω r e f ( 3 ) , g r e f ( 3 ) , q r e f ( 29 ) ] g_t = [v_{ref}(3), ω_{ref}(3), g_{ref}(3), q_{ref}(29)] gt=[vref(3),ωref(3),gref(3),qref(29)];残差动作 q t a r = q r e f + a t q_{tar} = q_{ref} + a_t qtar=qref+at 再 PD;非对称 critic 加特权量(参考高度、link 位姿、root 线速度)。
-
History Encoder:最近 K=9 步本体感(每步 93 维)到两层 MLP 映到 128 维 + 正弦位置编码到轻量因果 Transformer(causal mask 自注意力 + MLP block,残差/LN)到时间维 max-pool 得动力学嵌入 h t ( 128 ) h_t(128) ht(128)。
-
Command Encoder:命令窗口 g t − L : t + L g_{t-L:t+L} gt−L:t+L(L=10,每帧 38 维)到 MLP token + 位置编码; h t h_t ht 经 MLP 投影作 query,对命令 token 做单层动力学条件化多头交叉注意力(query 即当前动力学,自适应挑可信命令段),输出 u t ( 128 ) u_t(128) ut(128)。
-
奖励:沿用 BeyondMimic 的关键点指数核跟踪(关键点对齐/相对位姿/关键点速度)+ 动作率、关节限位、非目标接触惩罚。
-
跌倒恢复一体化:15% 并行环境为恢复环境,随机不稳定姿态初始化;早期加向上拉力 U[0,200] 线性退火至消失;恢复窗口 3 秒内不触发早停,允许自己爬起来。
-
训练:Isaac Gym,单张 RTX 4090、5680 并行环境;数据 LAFAN1 + AMASS 经 GMR 重定向并质检去冗余后仅 约 3.5 小时;单阶段端到端,无蒸馏、无多阶段。
-
关键结果(MuJoCo 统一评测,直接用官方 release 的 GMT / Any2Track checkpoint):mocap 上成功率 98.3%/MPJPE 41.1mm(GMT 84.6%/65.2;Any2Track 89.2%/57.0);视频派生动作 94.6%/46.6mm(GMT 72.4%;Any2Track 54.3%);地面接触动作 90.1%/54.9mm;命令噪声加到 1500% 仍稳定,基线在 200% 附近失稳;消融显示交叉注意力命令编码器是抗噪主力(换成自注意力掉点最大),因果 history encoder 次之。
关键创新点:
- 动力学条件化交叉注意力做命令端"降噪/过滤"——把"信不信参考"变成可学的注意力权重;
- 把跌倒恢复 curricula 融进同一单阶段策略,顺带改善多接触动作;
- 极致数据/算力效率(3.5h 数据、单卡)下对标 SOTA。
数据/算力/训练成本: 约 3.5 小时精选动作数据;单张 RTX 4090;5680 envs;Isaac Gym;G1 29 DoF;无蒸馏。
特点与局限:
-
优势:对脏参考(视频估计、PICO 遥操流)鲁棒性突出;成本极低;恢复+跟踪一体;
-
局限:核心对比表是作者自建子集与口径,官方模型虽直接复用但评测集非第三方榜单;团队为高校+企业小团队,运动多样性上限不及 SONIC;仅 G1。
与同领域其他工作的关系:
- 站在 GMT(2506.14770)、Any2Track(2509.13833)、BeyondMimic(2508.08241)肩膀上,直接把后两者当基线打;
- 用 GMR(2510.02252)做重定向;与 MimicLite 同属"小成本强鲁棒"分支,技术上比 MimicLite 多了显式抗噪注意力机制;
- Any2Track 的"两阶段+world model"路线在论文中被其交叉注意力路线直接对标。
读后心得: 参考动作不是圣旨——给策略一个"自己身体现在几斤几两"的嵌入当注意力 query,它就知道哪些帧该跟、哪些帧该当没听见。
来源链接:
Any2Track(银河通用 Galbot + 北大 + 清华 + 上海期智)
路线归属: 路线 A · 监督式动作跟踪(两阶段抗扰变种)
一句话定位: 两阶段 RL 通用跟踪框架:单个策略既追"任意高动态/多接触动作",又在线适应地形、外力、负载变化等"任意干扰"——即刷屏的"怎么踹都不倒"。
核心设计思路: 把"动作执行能力"和"动力学适应能力"解耦:第一阶段在无干扰环境把动作跟踪练到极致;第二阶段冻结基础策略,只通过一个 history-informed 的 adapter 注入抗扰性——避免联合优化时两个目标互相拖累、策略变得保守。
技术核心机制:
-
阶段一 AnyTracker:规范化动作空间 q d = q ~ t + 1 + α ⋅ t a n h ( π ( a ∣ s ) ) q_d = q̃_{t+1} + α·tanh(π(a|s)) qd=q~t+1+α⋅tanh(π(a∣s)), α α α 为逐关节经验缩放,在参考姿态附近搜索残差;运动聚类 + specialist-to-generalist:LAFAN1 按官方类别各训 specialist;AMASS 用 HumanML3D 的 “VERB” 类别标签过 CLIP 取文本嵌入,K-means 聚成 6 簇各训 specialist;最后 DAgger 蒸馏所有 specialist 到一个 generalist;数据 AMASS + LAFAN1,按 PHC 过滤不可执行动作,保留高动态/多接触动作(GMT 版做法是删掉这些);MuJoCo Playground,PPO,8 GPU。奖励:上身位置 1.0 / 下身 0.5 / 躯干 roll-pitch 1.0 / 身体姿态与速度 0.5 / DoF 位置 0.75、速度 0.5 / root 线角速度 1.0 / root 高与足高 1.0;正则:动作率 -0.5、力矩 -2e-5;惩罚:自碰撞 -10、终止 -200。
-
阶段二 AnyAdapter:history 窗口 H = 79 H=79 H=79 步,历史编码器 φ φ φ 抽动力学嵌入 e t e_t et;动力学感知世界模型 ω ω ω 自回归预测未来 N = 20 N=20 N=20 步状态,损失 L w m = Σ ∣ ∣ s t + i − s ^ t + i ∣ ∣ 1 L_wm = Σ||s_{t+i} - ŝ_{t+i}||_1 Lwm=Σ∣∣st+i−s^t+i∣∣1——用"预测下一帧"这个代理任务逼 e t e_t et 带上环境动力学信息;冻结 AnyTracker 主干,插入 M 层零初始化 adapter(LoRA 式逐层特征融合,初始不影响输出,微调时逐步注入抗扰);adapter 与历史编码器交替更新;动力学随机化:摩擦 U(0.3,2.0)、Perlin 地形高 0.3m、关节摩擦 U(0.5,2.0)、躯干质量 U(-3,6)kg、外部推力间隔 U(5,10)s。
-
结果:无干扰 SR 89.8%/MPJPE 16.5mm;地形 83.2%;外力 59.0%;物性变化 80.6%;全面超过 vanilla PPO、RMA(两阶段)、DWL、Dual-History,甚至超过吃特权环境因子的 RMA Stage-1;实机 G1 零样本 sim2real,木板/纸板/泡沫地形、绳索拉拽、背负 5kg 负载。
关键创新点:
- 两阶段解耦:先把"跳得好"练出来,再把"今天世界有什么不一样"作为外挂能力加上去;
- 用世界模型预测代理任务学动力学嵌入(比直接回归 privileged 信息更有信息量);
- 零初始化 adapter 保证抗扰微调不毁动作表现力。
数据/算力/训练成本: AMASS + LAFAN1;MuJoCo;8 GPU;阶段二抗扰实验为控制变量只在 LAFAN1 上跑(不做蒸馏);具体 GPU·h 未公开【推测单阶段量级为数十 GPU·h 级,远小于 SONIC】。
特点与局限:
- 优势:真实干扰下鲁棒性的标杆展示(踹/拉/负载/地形同时上),动作多样性与接触复杂度官方对比表上全面领先 GMT/ExBody/ASAP;
- 局限:外力干扰下成功率仍只有约 59%;阶段二为简化实验去掉了蒸馏,"任意动作×任意干扰"同时满格是宣传口径而非全部实验;跨机型能力未覆盖。
与同领域其他工作的关系:
- 跟踪主线:DeepMimic 到 PHC 到 GMT 的直接竞争者,数据/奖励设计明显针对 GMT 的短板(删高动态动作、无抗扰);
- 抗扰主线:RMA(特权蒸馏)、DWL(去噪世界模型)、双历史架构的继承者,且明确与其对比;
- 被 RGMT 直接当基线复测;与 SONIC 同属"统一单策略"叙事,但 SONIC 走规模、Any2Track 走结构解耦。
读后心得: 平衡和跳舞不该一起学——先让一个网络放心大胆地舞,再给它装一个只读历史、只动旁路参数的"随体感"小助手,踹不倒不是因为它学得保守,而是因为它知道被踹了。
来源链接:
第一层补充:同谱系其他工作速查
| 工作 | 一句话 | 路线 | 链接 |
|---|---|---|---|
| GMT(UCSD Xiaolong Wang 组) | 通用动作跟踪框架鼻祖,单策略追 LAFAN1+AMASS;后续所有人的基线 | A | arXiv |
| GMR | 通用运动重定向,SONIC/RGMT 都用它把人动作搬到 G1 | 数据工具 | arXiv |
| Meta Motivo | 首个可 prompt 的人形行为基座(ICLR 2025),仿真角色 | B 先驱 | arXiv |
| UniTracker / KungfuBot2 | 通用全身跟踪/多技能跟踪续作 | A | arXiv;arXiv |
| EGM | 高效通用跟踪,采样策略改进对标 GMT | A | arXiv |
| PGMT(2026-09) | 感知型通用跟踪,加入地形感知 motion-conditioned terrain glimpses | A+感知 | arXiv |
| ResMimic | 从通用跟踪残差学习走向 loco-manipulation | A | arXiv |
| Heracles(2026-03) | 精确跟踪 + 生成式合成桥接的通用控制 | A | arXiv |
| RobotDancing | 残差动作 RL 实现鲁棒长时程舞蹈跟踪 | A | arXiv |
注: 没有名为 “GEAR-2”/“GEAR-3” 的独立论文【已查证:GEAR publications 页最新运控工作即 SONIC 本身】。GEAR 体系的后续是工程化集成:SONIC 已作为低层控制器 GEAR-SONIC 进入 GR00T N1.5 / N1.7——N1.7(2026-07,Apache-2.0,3B VLA,Cosmos-Reason2/Qwen3-VL 主干)通过 UNITREE_G1_SONIC embodiment 标签调用。来源:GitHub;NVIDIA GEAR Publications
数据生成与动作重定向
本层覆盖把人类动捕数据转换为人形机器人可执行训练数据的全部技术环节。Any2Any 已在第一层完整梳理,此处仅做交叉引用。
OmniRetarget(Amazon FAR 动作重定向数据引擎)
一句话定位: Amazon FAR 联合 MIT / UC Berkeley / Stanford / CMU 提出的首个面向人形全身 loco-manipulation 的「交互保留型」动作重定向数据生成引擎,把人类 MoCap 一次性转成可在不同本体、地形、物体配置上复用的高质量运动学参考轨迹,并喂给极简 RL 策略零样本 sim2real。
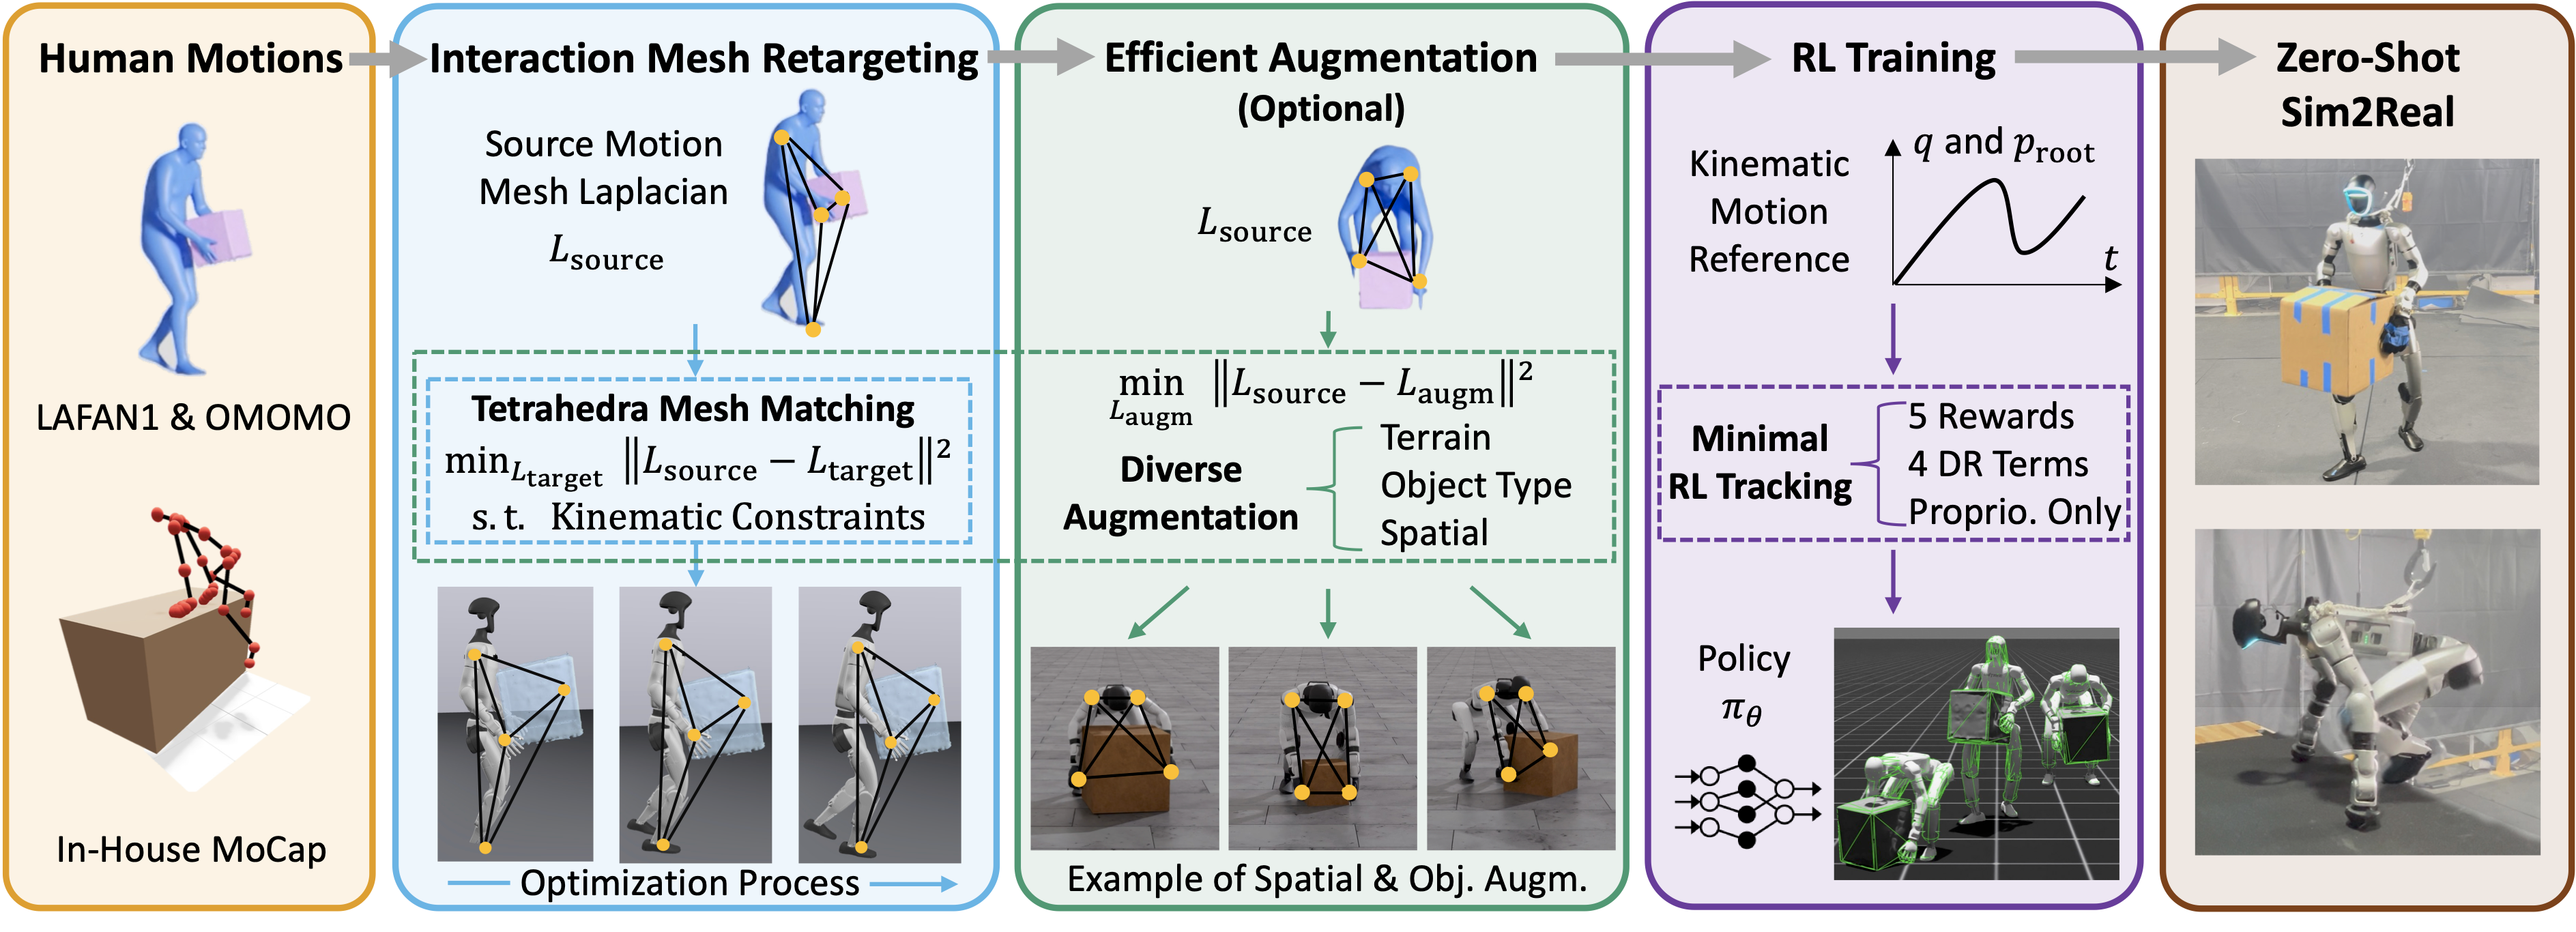
核心设计思路: 传统重定向(PHC / GMR / VideoMimic)只盯关节/关键点对齐,重定向后人-物、人-环境接触关系会被破坏,产生脚滑、穿透、抱不住箱子等物理失真。OmniRetarget 的直觉是:把「机器人—物体—地形」之间的空间与接触关系显式建到一张「交互网格」(interaction mesh)里,重定向时不是逐帧对齐关节,而是最小化这张网格从人到机器人的 Laplacian 变形,同时用硬约束保证运动学可行。这样一来,同一段人类示范可以通过改物体位姿/尺寸/地形高度/机器人本体,系统性地「扩写」成大量不重复的训练轨迹。
技术核心机制:
- 交互网格构建:顶点 = 关键人体/机器人关节 + 物体表面采样点 + 地形表面采样点(表面采样密度高于关节以保接触),对这些点做 Delaunay 四面体化,形成体积网格。
- Laplacian 变形能量:对第 i 个关键点定义 Laplacian 坐标 L ( p i ) = p i − Σ j w i j ⋅ p j L(p_i) = p_i − Σ_j w_{ij}·p_j L(pi)=pi−Σjwij⋅pj(均匀权重),重定向目标是最小化源/目标网格 Laplacian 坐标差的二范数 E L = Σ ∥ L ( p s o u r c e ) − L ( p t a r g e t ( q ) ) ∥ 2 E_L = Σ\|L(p_{source}) − L(p_{target}(q))\|^2 EL=Σ∥L(psource)−L(ptarget(q))∥2,q 为浮动基座 + 全部关节角。
- 逐帧约束优化(Sequential SQP 风格求解器): q ∗ = arg min q Σ ∥ L ( p s o u r c e ) − L ( p t a r g e t ( q ) ) ∥ 2 + ∥ q − q t − 1 ∥ Q 2 q^* = \arg\min_q Σ\|L(p_{source}) − L(p_{target}(q))\|^2 + \|q − q_{t−1}\|^2_Q q∗=argminqΣ∥L(psource)−L(ptarget(q))∥2+∥q−qt−1∥Q2,约束包括碰撞对 SDF 大于等于 0(防穿透硬约束)、关节限位、速度限位、stance foot 水平速度小于 1 cm/s 时锁脚防脚滑。用 Drake 的自动微分正确处理四元数 S 3 S^3 S3 流形上的导数;上一帧解作为下一帧 warm-start。
- 物体局部坐标系:交互网格在物体 local frame 下构建,使 Laplacian 坐标对物体全局旋转/平移不变,这是物体增广不崩溃的关键。
- 数据增广:对每类增广(物体初始位姿 / 物体尺寸 / 地形高度 / 本体切换)重解一次优化;为防止优化退化成整段刚体变换,加 ∥ q − q n o m i n a l ∥ W \|q − q_{nominal}\|_W ∥q−qnominal∥W(重罚下半身)+ 初始脚位锚定约束。
- 下游 RL:只给重定向后的 q ( t ) , p r o o t ( t ) q(t), p_{root}(t) q(t),proot(t) 作为运动学参考,PPO 训练纯本体感知策略,全任务共享 5 个 reward + 4 个 domain randomization 项,无课程学习,即可跑 30 秒 parkour(搬椅、跨障、滚翻)与 loco-manipulation(搬箱、爬坡匍匐、爬台坐下)。
- 支持本体:Unitree G1 / H1 / Booster T1;数据源:OMOMO、LAFAN1、in-house MoCap,累计生成 8 至 9 小时轨迹。
关键创新点:
- 首个把「机器人—物体—地形」三方交互关系写进重定向目标函数并施加硬运动学约束的 pipeline(对比 IMMA 只保 body-part 交互且不开源、PHC/GMR 无硬约束、VideoMimic 只有软惩罚)。
- 「单示范到多样本」的系统增广范式:交互网格在物体 local frame 下的不变性使位姿/尺寸/地形增广无需重新采数据。
- 高质量重定向直接把下游 RL 的 reward engineering 压到极简(5 reward、纯 proprioception、无 curriculum),且零样本 sim2real 到 Unitree G1。
数据/算力/训练成本: 重定向数据:从 OMOMO + LAFAN1 + in-house MoCap 生成 8 至 9 小时可行轨迹。RL 训练 GPU 数量与时长:未在项目页/论文摘要中公开具体 GPU 数与时数【推测为单节点多卡并行 PPO,规模与同类 G1 全身跟踪相当,数十 GPU·小时量级】。仿真环境:基于 IsaacGym/Isaac Sim/MuJoCo 后端(随 Holosoma 框架),PD 控制器。代码与数据已开源:github.com/amazon-far/holosoma。
特点与局限:
-
优势:交互保留 + 硬约束 = 几乎无脚滑/穿透;增广效率极高;下游 RL 配方极简、可迁移性强;ICRA 2026 Best Conference Paper + Best Paper on Robot Manipulation and Locomotion。
-
局限:本质是运动学重定向,不解决动力学可行性(仍靠 RL 吸收动力学 gap);依赖关键点语义对应(手对手等),拓扑差异大的本体仍需手工配对应;逐帧 SQP 求解有计算开销;对「非接触式远距离操控」价值有限。
与同领域其他工作的关系:
- 重定向谱系上承接 IMMA(交互网格思想)但把硬约束与环境/物体交互补齐并开源;对比 PHC(纯 keypoint 回归、无硬约束)、GMR(per-frame 关键点+朝向匹配)、VideoMimic(轨迹级 pairwise distance + 软惩罚)。
- 与 OmniH2O / H2O(CMU 系)互补:OmniH2O 走「动捕可行性过滤 + privileged teacher 蒸馏」做遥操作,OmniRetarget 走「优化式交互保留重定向 + 增广」做离线数据引擎。
- 下游可挂到 SONIC / HOVER / HoloMotion 等通用全身跟踪策略作为参考运动来源;与 PHP 同团队(C.K. Liu),是其数据 pipeline 的延伸。
读后心得: 重定向的天花板不在于「把人摆成机器人姿势」,而在于「别把人和箱子、人和台子的关系弄丢」——OmniRetarget 把接触关系当成一等公民建进网格,等于一份 MoCap 变出一整套任务数据,下游 RL 反而被解放到不用调 reward。
来源链接:
Any2Any(交叉引用)
见第一层 SONIC 后第一节。此处仅说明其在数据/重定向层的定位:Any2Any 解决的是"跟踪策略怎么从机器人 A 变到机器人 B"——与 OmniRetarget 解决的"参考运动怎么从人变到机器人"互补。前者是 post-training 低成本适配(运动学对齐 + 动力学 PEFT/LoRA),后者是 upfront 数据生成。
ExBody2(Advanced Expressive Humanoid Whole-Body Control)
一句话定位:UCSD + UC Berkeley + ByteDance(Mazeyu Ji, Xuanbin Peng, ..., Xiaolong Wang)提出的高保真表现力全身跟踪框架,让真实人形在保持平衡的前提下复刻任意参考动作(跑步、下蹲、舞蹈、K-pop、华尔兹、踢腿、拳击),核心是「解耦关键点跟踪与速度控制 + privileged teacher 蒸馏」。
核心设计思路: 全身跟踪最容易崩的点:(1) 把 root 线速度/角速度和 keypoint 位置耦合在一起 reward,导致为了跟关键点牺牲了速度跟踪的稳定性;(2) student 策略拿不到 privileged 信息(地形、接触、外力),蒸馏不出来高保真。ExBody2 的直觉是把「跟哪个姿态」和「往哪走多快」拆成两路控制目标,并先用能看特权信息的 teacher 在仿真里把高保真动作练出来,再蒸馏到只有本体感知的 student。
技术核心机制:
-
解耦 keypoint tracking 与 velocity control:reward 不再是混合体,而是明确分开——keypoint 位置/朝向匹配负责动作形状,root xy 速度 / yaw 速度负责运动方向与步频;两者解耦后,动态动作(跑、蹲、跳)下姿态跟踪不再与平衡控制打架。
-
Privileged teacher 到 student 蒸馏:teacher 策略在仿真中可访问 privileged proprioception(完整接触力、base 状态等),用 PPO 练高保真 mimic;student 只用稀疏本体观测,通过行为克隆/RL 蒸馏从 teacher 学。
-
任意参考动作输入:框架接受任意 reference motion(MoCap / 重定向轨迹 / 真实人类视频 pose),不需要针对每个动作重训;paper 做了系统性 ablation 给关键设计因子(解耦方式、蒸馏配方、奖励项)的工程指南。
-
真机部署:在两个真实人形平台上验证;实时姿态估计用 HybrIK;展示 K-pop、华尔兹、侧步、踢、室内外行走、绕圈、蹲、拳、勾拳、举箱等表现力动作。
关键创新点:
-
把「表现力」(expressive)作为一等目标,不只是「能站起来走」,而是要复现舞蹈/武术这种节奏、风格、身体律动都重要的动作。
-
系统 ablation 给出工程实践指南(哪些设计因子真正影响高动态 tracking),对落地团队参考价值高。
-
跨两个本体验证,证明框架通用性。
数据/算力/训练成本: 参考动作:公开 MoCap + 自研动作集(K-pop、华尔兹等)。GPU 数量与时长:未公开【推测为单/多节点 GPU 并行 PPO,与 ExBody1 / 同类 G1 全身跟踪同量级】。仿真环境:Isaac Gym 类;真机两个平台(含 Unitree G1 类本体)。
特点与局限:
- 优势:表现力动作保真度高;解耦设计对高动态动作稳定性提升明显;有 ablation 指南。
- 局限:仍需参考运动输入(不解决「从视频端到端学策略」);student 蒸馏后复杂接触动作(如坐下)仍可能需要特殊处理;未做跨本体迁移。
与同领域其他工作的关系:
- 是 ExBody1 的继任,与 HOVER / OmniH2O 同属「privileged teacher + student 蒸馏」范式,但 ExBody2 把重点放在表现力与高动态保真,HOVER 重点在多控制模式统一,OmniH2O 重点在遥操作接口。
- 与 HIL 形成对照:HIL 用 AIL 增适应,ExBody2 用解耦 reward + 蒸馏增保真。
读后心得: 机器人跳舞不好看,往往不是模型不行,而是 reward 把「像谁」和「往哪走」搅在一起了——ExBody2 把这两件事拆开,动作立刻就有了节奏。
来源链接:
HOVER(Versatile Neural Whole-Body Controller)
一句话定位: CMU + NVIDIA + UCSD(Tairan He, ..., Linxi Fan, Yuke Zhu)提出的多模式统一全身神经控制器,把导航用的 root 速度跟踪、桌面操作用的上半身关节角跟踪、全身动作模仿等多种控制模式蒸馏进同一个策略,实现模式间无缝切换,无需为每个任务重训。
核心设计思路: 传统做法是导航训一个速度跟踪策略、桌面操作训一个上半身关节跟踪策略、全身模仿再训一个策略,多套策略间切换麻烦。HOVER 的关键洞察是:「全身运动学动作模仿」可以作为所有这些任务的公共抽象接口——不管你最终要速度还是关节角,都可以先把它转成一个「目标全身姿态」,让一个统一策略去模仿这个姿态。这样多种控制模式只是「目标姿态生成方式」不同,底层控制器是同一个。
技术核心机制:
-
多模式策略蒸馏框架:每种控制模式(root velocity tracking / upper-body joint tracking / full-body pose tracking)先各自用 RL 在仿真里练出 teacher 策略;把所有 teacher 的行为数据合起来,蒸馏进一个统一 student 策略;student 的观测里包含「当前控制模式 + 该模式下的命令」,输出统一为关节位置目标。
-
统一接口:任意上游(VR、手柄、MoCap、规划器、VLM)只需告诉机器人「想让哪些部位做什么」,HOVER 自动决定全身 19 个关节如何协调。
-
模式无缝切换:训练时随机在 episode 内切换控制模式,让策略学会从「速度导航」平滑过渡到「上半身桌面操作」再回到导航。
-
部署:在 Isaac Lab 中训练,可作为 GR00T 等上层 VLA 的底层全身控制器;支持 Berkeley Humanoid / Unitree G1 真机。
关键创新点:
-
提出「全身运动学模仿 = 所有全身任务的公共抽象」这一统一视角,把本来割裂的 locomotion / manipulation / imitation 控制模式收敛到一个策略。
-
消除「每个控制模式单独训策略」的工程负担,模式切换无需重训。
数据/算力/训练成本: 训练数据:仿真内多 teacher rollout(无外部 MoCap 规模披露)。GPU 数量与时长:未公开【推测为 NVIDIA GPU 并行 RL 训练,单/多节点】。仿真环境:Isaac Lab;真机 Unitree G1 / Berkeley Humanoid。
特点与局限:
-
优势:一套策略通吃多模式;模式切换平滑;作为底层控制器可直接挂 VLA。
-
局限:本身不生成新动作,只跟踪给定目标姿态;高动态跑酷类动作不是其重点;多模式蒸馏对模式切换的鲁棒性仍依赖训练时的模式随机化覆盖率。
与同领域其他工作的关系:
-
与 OmniH2O 同源(Tairan He / Guanya Shi / Changliu Liu 团队),OmniH2O 解决「用什么接口控制人形」,HOVER 解决「一个策略怎么吃下多种控制接口」。
-
与 SONIC 互补:SONIC 是大规模 WBT 基础模型,HOVER 是多模式统一控制器,两者都可作为 VLA 底层。
-
与 ExBody2 互补:ExBody2 追求动作保真度,HOVER 追求控制模式通用性。
-
在 BFM 综述五类分类中落在 02 Goal-conditioned 学习 组。
读后心得: 人形机器人不需要为「走路」「伸手」「跳舞」各养一个大脑——只要把所有意图都翻译成「目标全身姿态」,一个控制器就全接得住。
来源链接:
OmniH2O(Universal and Dexterous Human-to-Humanoid Whole-Body Teleoperation and Learning)
一句话定位: CMU + 上海交大(Tairan He, Zhengyi Luo, ..., Kris Kitani, Changliu Liu, Guanya Shi)提出的通用灵巧人形全身遥操作与学习系统(CoRL 2024),以「运动学姿态」为通用控制接口,支持 VR / 语音 / RGB 相机多种人类输入方式,并能从遥操作数据学习自主扩散策略或对接 GPT-4o。
核心设计思路: 人形全身遥操作的痛点:(1) 不同遥操作硬件(VR、外骨骼、RGB)给出的信号格式不统一;(2) 真机上直接遥操作延迟高、灵巧手跟不上。OmniH2O 的直觉是把「运动学姿态」(body pose + hand pose + 3D 手部位置)作为唯一中间表示——不管上游用什么设备/模型,都先翻译成这个姿态,再由一个统一的 sim2real 全身跟踪策略去执行。这样新硬件/新模型只要能输出姿态,就能即插即用。
技术核心机制:
-
三阶段 pipeline:(1) 大规模人类动作重定向 + 可行性过滤:把大规模人类 MoCap 重定向到人形,用 privileged motion imitator 过滤掉人形学不会的动作(「sim-to-data」思路),得到 embodiment-feasible 运动数据集。(2) Phase 1 Privileged Teacher RL:仿真中用 361 维 privileged proprioception + 552 维 privileged motion goal,PPO 训练 teacher 策略(50Hz),奖励项强化鲁棒性与稳定性。(3) Phase 2 Sim-to-Real 蒸馏:用监督学习把 teacher 蒸馏到只用 27 维 sparse proprioception + 26 步历史(63 维×1638)+ motion goal 的学生策略(50Hz),学生输出关节位置目标,经 200Hz PD 控制器执行。
-
通用控制接口:VR 头显实时遥操作;语音指令经 MDM(motion diffusion model)生成运动目标;单目 RGB 相机经人体/手部姿态估计生成目标;也可由 GPT-4o 或扩散策略根据遥操作数据集自主生成动作目标。
-
灵巧手:body pose 走学生策略,hand pose 经 IK 直接到手部控制器,解耦身体平衡与手部操作。
-
OmniH2O-6 数据集:首个开源人形全身控制数据集,6 个日常任务。
-
真机:Unitree H1 全尺寸人形(带灵巧手);端到端延迟约 185 ms(VR 模式)。
关键创新点:
-
「运动学姿态即通用接口」的抽象设计,使 VR / RGB / 语音 / LLM / diffusion policy 都能共用同一底层执行策略。
-
sim-to-data 可行性过滤:先用 privileged imitator 筛掉人形学不会的人类动作,从源头保证训练数据可行。
-
教师(privileged)到学生(sparse sensor)蒸馏范式,使真机只用板载传感器。
数据/算力/训练成本: 人类 MoCap:大规模公开动捕(具体小时数未单独披露)。真机数据:OmniH2O-6,6 个日常任务。GPU 数量与时长:未公开【推测为单节点多卡 GPU 并行 PPO + 监督蒸馏】。仿真:Isaac Gym;真机 Unitree H1。
特点与局限:
-
优势:接口通用性极强;真机能打运动、搬物、交互;开源数据集降低复现门槛。
-
局限:VR 模式不控制脚(foot control 被排除以降延迟,后续 ExtremControl 等工作指出这一点);学生策略仍需 per-task 训练扩散策略才能自主;对长时序复杂任务的鲁棒性有限。
与同领域其他工作的关系:
-
是前作 H2O(IROS 2024,Learning Human-to-Humanoid Real-Time Whole-Body Teleoperation,RGB 相机实时遥操作)的扩展,H2O 偏「单目 RGB 遥操作」,OmniH2O 偏「多接口通用 + 自主学习」。
-
与 HOVER 同源同团队,HOVER 可视为其底层控制模式的进一步统一。
-
与 HumanPlus 对照:HumanPlus 用单 RGB + 自研 HST/HIT 做 shadowing + imitation,OmniH2O 用 VR/多接口 + privileged 蒸馏做 teleop + 自主。
读后心得: 别在硬件上死磕遥操作延迟,把所有输入都翻译成「目标姿态」这一种语言,底层控制器只学一次,上层想接 VR、接 GPT-4、接扩散模型都随你。
来源链接:
HumanPlus(Humanoid Shadowing and Imitation from Humans)
一句话定位: Stanford(Xue Bin Peng / Chelsea Finn 团队,Mark Fine 等)提出的全栈人形系统:用单 RGB 相机让人类实时「shadow」人形(HST 低层策略),再通过 shadowing 采集真机第一视角数据,训练 HIT 模仿策略,使人形用最多 40 条示范自主完成穿鞋起身、仓库卸货、叠衣服、打字、打招呼等全身任务(60 至 100% 成功率)。
核心设计思路: 人形学全身技能有两个数据瓶颈:(1) 仿真里难做真实软物体/复杂任务的 RGB 渲染;(2) 真机遥操作贵且难。HumanPlus 的直觉是分两层:先用大规模离线人类动捕数据在仿真里 RL 训一个「影子」低层策略(HST),让人站在机器人旁边用单 RGB 摄像头就能实时遥控它——这相当于把人形变成一个「低成本遥操作舱」;然后用这个影子系统在真机上采第一视角演示数据,再训练高层视觉模仿策略(HIT)做自主。
技术核心机制:
-
HST(Humanoid Shadowing Transformer,低层):decoder-only Transformer,50 Hz,上下文长度 8;输入:人形本体感知(root 角速度、关节位置/速度、上一动作)+ 目标姿态(目标前/侧向速度、roll/pitch、yaw 速度、目标关节角);输出:19 维身体关节位置 setpoints,经 1000 Hz PD 转力矩;训练:PPO 在仿真中用 AMASS 数据集(40 小时、11000+ 序列,SMPL-X 参数化),按关节对应做简单欧拉角重定向;奖励 = target xy/yaw 速度 + target 关节角 + target roll/pitch + energy + feet contact matching + feet slipping penalty + alive;domain randomization:base payload 正负 3kg、末端负载 0 至 0.5kg、质心偏移正负 0.1m、电机强度 0.8 至 1.1、摩擦 0.3 至 0.9、控制延迟 0.02 至 0.04s;零样本部署真机,WHAM(单 RGB 实时人体姿态估计)+ HaMeR(单 RGB 手部姿态估计)跑在 RTX 4090 上(身体 25fps、手 10fps)。
-
HIT(Humanoid Imitation Transformer,高层):把 Action Chunking Transformer (ACT) 的 encoder-decoder 改成 decoder-only;输入:双目第一视角 RGB 图像(预训练 ResNet 编码特征)+ 本体感知 + 固定位置编码;一次预测 50 步目标姿态 chunk(25 Hz 机载运行),异步送给 HST;关键技巧:在预测未来图像特征 token 上加 L2 feature loss,迫使 transformer 同时做「动作预测」和「前向动力学预测」,防止视觉策略忽略图像特征、过拟合到本体感知。
-
硬件:自研 33-DoF 180cm 人形(基于 Unitree H1 + Inspire-Robots RH56DFX 灵巧手 + 1-DoF 腕部 + 双目 Razer Kiyo Pro)。
关键创新点:
-
「shadowing」作为人形数据采集新范式:单 RGB 摄像头即可全身遥操作,成本 50 美元(对比 ALOHA 7050 美元、Meta Quest 250 美元),且支持全身。
-
HIT 的 decoder-only + 前向图像特征预测 loss,解决高 DoF + 双目视觉下 BC 容易无视视觉的问题。
-
40 条示范即可学全身自主技能,数据效率高。
数据/算力/训练成本: 离线训练:AMASS 40 小时 / 11000+ 序列;仿真 PPO。真机演示:每任务最多 40 条;60 至 100% 成功率。GPU:RTX 4090 用于实时推理;训练 GPU 数/时长未公开【推测为单/多 GPU 仿真训练】。代码开源:github.com/MarkFzp/humanplus。
特点与局限:
-
优势:shadowing 硬件成本极低;数据效率高(40 demo);全栈系统完整可复现。
-
局限:shadowing 依赖人站在机器人旁边 line-of-sight,不适合长距离/危险场景;HIT 仍需 per-task 数据;动作偏日常 manipulation + 直立行走,不跑高动态 parkour;自研硬件平台非通用。
与同领域其他工作的关系:
-
与 OmniH2O 互为对照:OmniH2O 走 VR + privileged teacher 蒸馏,HumanPlus 走单 RGB shadowing + BC;两者都验证了「人类数据到人形技能」的可行性。
-
HIT 是 ACT 的人形改造版,后续被大量全身 VLA 工作(π0.5 / OpenHLM 等)参考。
-
与 HOVER 互补:HOVER 提供多模式底层控制,HumanPlus 提供数据采集与高层模仿。
读后心得: 人形机器人数据采集最贵的不是算法,是让人愿意站在机器人旁边举着摄像头——HumanPlus 把这件事压到 50 美元和 40 条演示,门槛一降,全身学技能这件事就平民化了。
来源链接:
上海 AI Lab BFM(行为基座模型,原论文)
编号澄清: arXiv:2506.20487 实际是 BFM 综述论文;上海 AI Lab 的 BFM 原论文是 arXiv:2509.13780(Weishuai Zeng, Shunlin Lu, ..., Jingbo Wang, Jiangmiao Pang;北大 + 港中深 + 上交 + 复旦 + 上海人工智能实验室)。
一句话定位: 北大 / 港中深 / 上交 / 复旦 / 上海人工智能实验室提出的首个面向人形全身控制的「行为基座模型」(Behavior Foundation Model, BFM):在大规模行为数据集上预训练一个生成式模型,把「导航、速度跟踪、关键点跟踪、关节角跟踪、任意组合」等所有 WBC 任务统一进一个 CVAE + 掩码在线蒸馏框架,使同一模型无需重训即可响应任意控制模式,并支持行为组合、调制与残差微调快速获得新行为。
核心设计思路: 现有 WBC(locomotion / teleop / motion tracking)虽强,但都是任务特化、靠 reward engineering,换任务就要重训。作者复盘后发现:所有这些任务的共同目标都是「生成引导机器人到达期望目标状态的合适行为」——差别只在于「目标状态/控制信号长什么样」。BFM 的直觉是不要为每种控制模式训一个策略,而是学一个行为分布 P ( a t ∣ s p , s g , m ) P(a_t | s^p, s^g, m) P(at∣sp,sg,m),其中 m 是一个「掩码向量」指示当前用哪种控制接口;通过掩码,同一模型既能当速度跟踪器、又能当关键点跟踪器、又能当关节角跟踪器,还能任意组合。CVAE 负责建模行为的多模态分布(同一目标状态下人体本就有多种合理走法),掩码在线蒸馏负责把大规模 MoCap 数据转成机器人可执行的行为数据集。
技术核心机制:
- 三阶段 pipeline: 1. 1. 1. Human Motion Retargeting:SMPL 人类动作重定向到人形,并抽取 motion phase ϕ \phi ϕ(运动相位)。 2. 2. 2. Proxy Agent Training(行为数据生成):在仿真里先用大规模 motion imitation 训练一个 proxy agent(教师策略),让它能在各种目标状态下生成机器人可执行的行为 rollout,产出大规模行为数据集 { s p , s i m , s g , s i m , a t , m t } \{s^{p,sim}, s^{g,sim}, a_t, m_t\} {sp,sim,sg,sim,at,mt}。 3. 3. 3. BFM Pretraining(掩码在线蒸馏 + CVAE)。
- 统一控制接口与掩码策略:控制接口分三类——Root(线速度/位置/相位/朝向)、Kinematic Position(关键点速度/位置/相位)、Joint Angle(关节速度/位置/相位)。掩码 m m m 属于 { 0 , 1 } N \{0,1\}^N {0,1}N 是一个 binary 向量,1=该通道 active、0=inactive;通过掩码组合可表达「只要 root 速度」「只要手部关键点位置」「任意组合」等任意控制模式。
- CVAE 建模行为分布:Encoder 输入 s p , s i m s^{p,sim} sp,sim(proprioception)+ s g , s i m s^{g,sim} sg,sim(goal state)+ m t m_t mt(掩码),输出 Δ z \Delta z Δz 属于 N ( μ , σ 2 ) \mathcal{N}(\mu,\sigma^2) N(μ,σ2);Prior 输入 s p , r e a l s^{p,real} sp,real + s g , r e a l s^{g,real} sg,real,输出 z z z 属于 N ( μ p , σ p ) \mathcal{N}(\mu^p, \sigma^p) N(μp,σp);KL-Divergence 约束把 encoder 后验拉向 prior;Decoder 输入 z z z + proprioception( q t , q ˙ t , ω t , g t , a t − 1 q_t, \dot q_t, \omega_t, g_t, a_{t-1} qt,q˙t,ωt,gt,at−1)到动作 a t a_t at;训练目标 = 动作重建 MSE + KL 散度项。
- Masked Online Distillation(掩码在线蒸馏):proxy agent 在仿真中在线持续 rollout,按当前掩码 m t m_t mt 采样(即随机屏蔽部分控制通道,模拟任意控制模式),把生成的 s , s g , m , a p r o x y s, s^g, m, a_{proxy} s,sg,m,aproxy 在线喂给 BFM 做行为克隆式蒸馏;这与静态离线数据集的区别是——proxy 能在仿真里持续探索,BFM 见到的行为分布随 proxy 能力增长而扩展。
- 推理时:encoder 被丢弃,只用 prior 采样 z z z 属于 N ( μ p , σ p ) \mathcal{N}(\mu^p, \sigma^p) N(μp,σp),再由 decoder 出动作(这就是 masked inpainting 思想:masked 通道的 goal 被丢弃,模型用学到的行为先验补全)。
- 三种下游用法: 1. 1. 1. Behavior Composition:对两种控制模式的隐变量 z z z 做线性插值,合成融合两种行为的新动作; 2. 2. 2. Behavior Modulation: z = ( 1 + λ ) μ p ( s , s g ) − λ ⋅ μ p ( s , ∅ ) z = (1+\lambda)\mu^p(s, s^g) - \lambda\cdot\mu^p(s, \emptyset) z=(1+λ)μp(s,sg)−λ⋅μp(s,∅),沿隐空间线性外推放大/调制某控制模式的影响; 3. 3. 3. Efficient Behavior Acquisition(残差学习):冻结 BFM 的 Prior + Decoder,只训练一个小型 Residual Decoder 输出残差 Δ a t \Delta a_t Δat,快速获得新行为(对比 from-scratch RL,样本效率显著提升)。
关键创新点:
-
首次把「控制模式」本身作为可学习的掩码变量,使一个生成式模型同时覆盖 root velocity / keypoint / joint / 任意组合,而非为每种模式训策略。
-
CVAE + 掩码在线蒸馏:CVAE 建模行为多模态性,掩码在线蒸馏保证训练数据分布与推理时任意控制模式对齐。
-
显式支持隐空间行为组合/调制/残差微调三种下游接口,把「行为」真正变成可调用的身体 API。
数据/算力/训练成本: 行为数据:由 proxy agent 在仿真中大规模 motion imitation 生成(基于 SMPL MoCap 重定向),具体小时数/GPU 数未在 arXiv 摘要与项目页公开【推测为单/多节点 GPU 并行仿真 + Transformer CVAE 训练,规模与 SONIC 等 WBT 训练同量级或略小】。真机部署:物理人形平台(未在摘要具名,项目页展示游泳、坐地、坐椅、起身、回旋踢、上篮、前滚翻、蝴蝶踢、侧手翻、侧空翻、RC 遥控行走、HybrIK 全身遥操作等)。代码:项目页标注 “Code (In Coming)”;后续 Scaling 版本(ScaleBFM)已开源。
特点与局限:
-
优势:一模型多模式;隐空间可组合/调制;残差微调显著优于 from-scratch RL;无需为新模式重训。
-
局限:依赖 proxy agent 的质量(proxy 不行 BFM 也学不到);CVAE 隐空间可控性仍弱于扩散模型;真机复杂接触动作(游泳等)仍需特殊处理;未跨本体验证。
与同领域其他工作的关系:
-
与 SONIC / MimicLite 等跟踪监督式路线的区别:SONIC 等是「给定参考运动到策略忠实跟踪」,模型本身不建模行为分布、不支持任意控制模式切换;BFM 是「学行为分布 P(a|s,g,m)」,掩码 + CVAE 使其天生支持多模式与隐空间组合。SONIC 是 goal-conditioned tracking 路线的规模化代表,BFM 是 generative / representation-based 路线的代表。
-
与 BFM-Zero / UFO 等无监督表征式路线的关系:BFM-Zero 用无监督 RL 学可提示潜空间,BFM 用掩码蒸馏 + CVAE 学可掩码行为分布;两者同属「无监督/生成式行为基座」谱系,但 BFM-Zero 靠 intrinsic reward / successor features,BFM 靠 proxy 蒸馏 + 显式控制接口。
-
与 HOVER 的关系:HOVER 也做「多模式统一」,但走 teacher-student RL 蒸馏、显式 mode 切换;BFM 走生成式 CVAE + 掩码隐空间,把多模式问题转化为「条件行为分布建模」。HOVER 是 BFM 在 goal-conditioned 分组里的近邻工作。
-
在 BFM 综述五类分类中,BFM 原论文落在 02 Goal-conditioned 学习 组(#13),但其掩码隐空间思想也与 01 Forward-backward 表征、04 Adaptation 两组交叉。
读后心得: 人形机器人不需要「会走路的模型 + 会伸手的模型 + 会跳舞的模型」三个模型,只需要一个「知道人在各种目标下会怎么动」的模型——剩下的只是你告诉它「现在看哪个目标、屏蔽哪些通道」。
来源链接:
BFM 综述(A Survey of Behavior Foundation Model,IEEE TPAMI 2025)
论文:arXiv:2506.20487(Mingqi Yuan, Tao Yu, ..., Xin Jin;LimX Dynamics 等),IEEE TPAMI 2025 正式发表,19 页 / 10 图。配套论文页 bfm4humanoid.github.io 与 awesome-bfm-papers 列表(41 篇 BFM 论文 + 10 个数据集)。
配套数据集:AMASS、KIT-ML、LAFAN、BABEL、HumanML3D、PoseScript、Motion-X、Motion-X++、PHUMA、Humanoid-X。
分类体系(五类问题):
| 组 | 篇数 | 核心问题 | 代表工作 |
|---|---|---|---|
| 01 Forward-backward 表征 | 6 | 多任务能否压进可调用的身体潜空间 | BFM-Zero、MetaMotivo、FB-AW、Fast Imitation、Successor States |
| 02 Goal-conditioned 学习 | 19 | 动作跟踪/全身技能/遥操作/HOI 的覆盖面 | SONIC、OpenTrack、AMS、TWIST/TWIST2、BFM4Humanoid、HOVER、InterMimic、MaskedMimic、ASE/CALM/CASE、PHC |
| 03 Intrinsic reward 预训练 | 5 | 无明确任务时身体先积累可迁移探索经验 | APS、Proto-RL、RE3、RND、DIAYN |
| 04 Adaptation | 3 | 预训练 BFM 如何低成本进新任务/新动力学/新机 | Task Tokens、Unseen Dynamics、Fast Adaptation(含 Any2Any) |
| 05 Hierarchical control | 8 | 语言/VLA/扩散/规划器如何调用底层身体 | SENTINEL、BeyondMimic、LeVerb、LangWBC、TokenHSI、CLoSD、UniPhys、UniHSI |
核心结论:
-
BFM 不等于更大动作库:价值在于把「动作能力」推进到身体接口层——VLA、世界模型、语言规划最终都要落到走、平衡、起身、接触、抗扰恢复等可调用身体能力。
-
BFM 是三股线的交汇:AMP / 运动先验(自然身体分布)+ motion tracking / mimic / 遥操作(动作与交互数据)+ VLA / 语言 / 扩散 / 规划(身体 API 化)。
-
数据侧关键不在「动作越多越好」,而在能否把 MoCap 加工成机器人可信、可执行、可迁移的训练材料(重定向可行性、接触保持、增广是核心)。
来源:
补充工作:数据与重定向
BONES-SEED(大规模人形运动数据集)
-
定位:Amazon FAR(Jiaman Li 等)发布的面向人形控制的大规模结构化运动数据集,142,200 条运动序列,覆盖 locomotion 与 object interaction,提供 SOMA / Unitree G1 (MuJoCo) / Vicon 三种骨架格式,每条运动带最多 6 条自然语言描述,学术与合格创业公司可申请。
-
要点:是 SONIC / 下游 WBT 工作的重要参考运动来源;与 LAFAN1/AMASS 相比更面向人形控制而非纯动画。SONIC 公开版 BONES-SEED 即此数据集(288h 子集)。
MoReFlow(Motion Retargeting via Flow Matching)
-
定位:基于 flow matching 的无监督跨形态运动重定向(arXiv 2509.25600),结合 character-specific VQ-VAE + 条件 flow model,在 tokenized motion space 做可控可逆跨角色迁移,无需配对数据,覆盖人形与四足。
-
来源:arXiv
AdaMorph(Unified Motion Retargeting via Embodiment-Aware Adaptive Transformers)
-
定位:本体感知自适应 Transformer 的统一运动重定向(arXiv 2601.07284,2026.1)。
-
来源:arXiv
Human2Humanoid: Physics-Aware Cross-Morphology Motion Retargeting
-
定位:CycleGAN + skeleton-aware GCN 的无监督跨形态重定向(arXiv 2606.03476),解决未配对数据下的尺度 mismatch。
-
来源:arXiv
学习范式
本层覆盖连接"纯模仿跟踪"与"泛化/适应/组合"的算法范式。
HIL(Hybrid Imitation Learning for Dynamic Athletic Control)
一句话定位: CMU + NVIDIA(Jiashun Wang, Yifeng Jiang, ..., Jessica Hodgins, Xue Bin Peng)提出的混合模仿学习框架,把「运动跟踪(motion tracking)」与「对抗模仿学习(adversarial imitation, AIL)」并行塞进同一套策略,让虚拟角色既高精度复现跑酷参考动作,又能在未见地形上自适应组合技能。
核心设计思路: 纯 motion tracking(DeepMimic 式)保真度高但死板、换环境就崩;纯 adversarial imitation(AMP 式)适应性强但动作自由度乱、容易丢参考动作的「味道」。HIL 的直觉是不要二选一:用 tracking 分支把动作「钉」在参考轨迹的自然性上,用 AIL 分支给策略注入「在新环境里自己找路」的适应能力,两者在共享观测/动作空间下并行训练、互相喂梯度。
技术核心机制:
-
两分支并行环境:并行多任务环境里同时跑 (a) 参考运动跟踪任务(目标 = 给定 reference motion,复现它)和 (b) 对抗模仿任务(目标 = 在程序化生成的跑酷障碍场地上,让状态分布匹配参考数据分布)。
-
统一观测空间 + goal-conditioned 表示:把两类任务的观测统一编码,用 goal-conditioned embedding 让两个分支共享策略网络、实现跨任务知识迁移;这是「混合」能真正发生而不是两个网络各训各的关键。
-
损失组成:tracking 分支沿用 DeepMimic 式 reward(关节位置/速度、肢体朝向、root 线/角速度、feet contact 等);AIL 分支沿用 AMP 式 discriminator 分类真假轨迹 + RL 最大化判别奖励;总 reward 加权混合。
-
训练范式:PPO 在 GPU 并行仿真(Isaac Gym 类)里同时采样两类环境,策略在两类 rollout 上联合更新。
-
任务验证:跑酷式障碍穿越(跨障、跳台、钻洞)+ heading control(朝向控制);程序化生成新任务测试泛化。
关键创新点:
-
首次把 motion tracking 的「保真」与 AIL 的「适应/组合」在同一策略、同一并行训练循环里系统融合,而不是先 tracking 后 finetune 的两段式。
-
goal-conditioned 统一观测使「混合」不是简单 reward 相加,而是网络层面共享表征。
-
在动态运动(athletic/parkour)这一最容易 tracking 与适应冲突的场景上验证。
数据/算力/训练成本: 参考运动来源:公开跑酷/运动 MoCap 数据(论文未给具体小时数)。GPU 数量与时长:未公开【推测为 NVIDIA 内部多 GPU 并行仿真训练,与 AMP/DeepMimic 类工作同量级】。仿真环境:Isaac Gym 类 GPU 并行刚体仿真;本工作为虚拟角色(physics-simulated character),未部署真实人形机器人。
特点与局限:
-
优势:动作自然度显著优于纯 AIL,环境泛化/任务完成率显著优于纯 tracking;支持技能组合(同一控制器跨越障 + 朝向控制)。
-
局限:目前只在仿真虚拟角色上验证,未上真实人形;tracking 与 AIL 的权重调参仍需工程经验;本质仍需参考 MoCap,不解决「从野外视频直接学」。
与同领域其他工作的关系:
-
谱系上是 DeepMimic(tracking)与 AMP(adversimal prior)的统一体;与 ExBody2 / OmniRetarget 这种「重定向 + RL tracking」路线互补——HIL 解决的是「tracking 太死」的问题,ExBody2 解决的是「tracking 保真度不够」的问题。
-
与 H2O/OmniH2O 的「privileged teacher 蒸馏到 sparse sensor student」不是同一类混合(HIL 是 tracking+AIL 的混合,不是 teacher-student 混合)。
读后心得: 模仿学习界的「鱼与熊掌」问题——要像还是要活——HIL 的答案是别在 loss 层面和稀泥,直接在并行环境里让策略同时打两份工,自然性靠 tracking 焊死,适应性靠 AIL 兜底。
来源链接:
BeyondMimic(From Motion Tracking to Versatile Humanoid Control via Guided Diffusion)
一句话定位: UC Berkeley + Stanford 等在 Science Robotics(2026.8)发表——不直接模仿参考动作,而是从海量人类运动数据学动作「分布」,执行未知任务时用引导扩散模型实时合成技能;统一训练设置下学数百种动作(侧手翻、旋踢、冲刺、舞蹈)并 sim2real。
核心设计思路: 传统 motion tracking 要求逐段给定参考动作;BeyondMimic 反过来——先学一个动作分布的生成模型,执行时不回放固定轨迹,而是用引导信号(文本/目标姿态/奖励函数)在扩散过程中实时"生成"合适动作,实现"想做什么就现编什么"。
技术核心机制:
-
从大规模人类运动数据学习动作分布的扩散模型;
-
执行时通过引导(guidance)在去噪过程中注入任务目标;
-
RL 训练跟踪/执行能力,与扩散模型配合;
-
在 Science Robotics 发表,系统验证 sim2real。
关键创新点:
-
把"跟踪固定轨迹"升级为"实时合成新动作";
-
扩散模型 + RL 的混合范式;
-
在统一设置下学数百种动作。
数据/算力/训练成本:大规模人类运动数据;具体 GPU 数/时长未公开【推测为大规模 GPU 并行训练,与 SONIC 同量级或略小】。
特点与局限:
-
优势:不依赖固定参考轨迹,实时合成动作,泛化性强。
-
局限:扩散模型推理延迟 vs 实时控制的 trade-off;引导信号设计仍需工程经验。
与同领域其他工作的关系:
-
在 BFM 综述五类分类中落在 05 Hierarchical control 组(扩散/规划器调用底层身体);
-
与 HIL 的区别:HIL 是 tracking+AIL 混合,BeyondMimic 是 tracking+扩散生成;
-
RGMT 用它的奖励设计作为基线。
读后心得: 别把参考动作当圣旨——学会"人会怎么动"的分布,需要时现编一段比回放旧录像更灵活。
来源链接:
HDMI(Learning Interactive Humanoid Whole-Body Control from Human Videos)
一句话定位: 从人类 RGB 视频直接学习人形交互全身控制的三阶段框架(arXiv 2509.16757,2025.9):从 RGB 视频提运动轨迹到 RL 训练交互策略到部署;解决人-物交互(HOI)数据稀缺与 RL 训练难题。
核心设计思路: 人形交互全身控制需要人-物交互数据,但动捕昂贵且难覆盖交互场景。HDMI 直接从野外 RGB 视频提取运动轨迹,经三阶段 pipeline 转成可执行策略。
技术核心机制:
-
阶段一:从 RGB 视频提取人体运动轨迹;
-
阶段二:RL 训练交互全身控制策略;
-
阶段三:部署到真机。
关键创新点: 从人类 RGB 视频直接学交互控制,绕开动捕瓶颈。
数据/算力/训练成本: 人类 RGB 视频;具体 GPU 未公开。
特点与局限:
-
优势:数据来源广(野外视频),覆盖交互场景。
-
局限:视频提取的轨迹噪声大;三阶段 pipeline 误差累积。
与同领域其他工作的关系:
-
与 Visual Imitation、RoboMirror 同属"视频到策略"端到端路线;
-
与 ExBody2 对照:ExBody2 从 MoCap 学,HDMI 从视频学。
读后心得: 动捕房里录不出所有交互场景——把人类随手拍的视频用起来,数据瓶颈就破了一半。
来源链接:arXiv
Visual Imitation Enables Contextual Humanoid Control
一句话定位: 从 123 段手机随手拍视频(坐、站起、上下楼梯、踩砖块等)学习上下文人形控制,稠密点云重建 + ego-view RGB-D 渲染(arXiv 2505.03729,2025.5)。
核心设计思路: 用手机拍 123 段日常动作视频,稠密点云重建环境,渲染第一视角 RGB-D 观测,训练能根据上下文(地形/障碍)自适应的人形控制策略。
技术核心机制:
-
123 段手机视频采集;
-
稠密点云重建;
-
ego-view RGB-D 渲染;
-
上下文条件化人形控制策略。
关键创新点: 极简数据采集(手机随手拍);稠密点云重建 + 渲染生成训练观测。
数据/算力/训练成本: 123 段手机视频;具体 GPU 未公开。
特点与局限:
-
优势:数据采集成本极低;上下文条件化。
-
局限:仅 123 段,覆盖有限;点云重建质量依赖拍摄。
与同领域其他工作的关系:
-
与 HDMI、RoboMirror 同属"视频到策略"路线;
-
与 HumanPlus 对照:HumanPlus 用 shadowing 实时采集,Visual Imitation 用事后视频重建。
读后心得: 123 段手机视频就够了——数据量不是瓶颈,关键是怎么把视频里的上下文信息用对。
来源链接:arXiv
RoboMirror(Understand Before You Imitate for Video to Humanoid Locomotion)
一句话定位: 智源 + 港科大等(arXiv 2512.23649),从视频到人形运动「先理解再模仿」,解决直接视频到策略的语义 gap。
核心设计思路: 直接从视频端到端学策略存在语义 gap——视频里的动作语义和机器人可执行的运动之间没有直接映射。RoboMirror 的直觉是:先"理解"视频中的动作语义(什么动作、什么场景),再"模仿"——把理解和模仿解耦。
技术核心机制:
-
先理解:视频动作语义识别/理解;
-
后模仿:基于理解结果生成/执行运动策略。
关键创新点:"先理解再模仿"范式,解决视频到策略的语义 gap。
数据/算力/训练成本: 具体数据/GPU 未公开。
特点与局限:
-
优势:理解层缩小语义 gap。
-
局限:理解模块本身的误差会传递到模仿层。
与同领域其他工作的关系:
-
与 HDMI、Visual Imitation 同属"视频到策略"路线,但 RoboMirror 多了显式理解步骤;
-
与 Ψ0 的"人机数据不对齐"论点呼应——RoboMirror 用理解层做翻译。
读后心得: 直接把视频像素映射到关节角太粗暴了——先搞懂"这个人在干嘛",再让机器人照着做,中间多一层理解反而更准。
来源链接:项目页
感知运控
分类订正说明: AME-2、SOLO、PHP 是纯深度+本体输入,实际属感知运控方向,本层如实归入。本层核心输入是视觉(深度图/高程图/点云)+ 本体感,无语言接口。
SSR:Scaling Surefooted and Symmetric Humanoid Traversal to the Open World
一句话定位: 浙大提出的单阶段端到端人形视觉行进框架,用「预想落脚点引导 + 等变潜空间对称增强 + 地形专属多判别器 AMP」三件套,让扁平足人形机器人只用一个前置深度相机就在开放世界走得稳、走得对称、走得自然。
核心设计思路: 把安全落脚、左右对称、人类风格三个目标塞进同一个 PPO 训练流程。直觉是:传统 RL 只在脚踩地时才给安全信号(太稀疏),所以在摆动阶段就「想象」脚会落在哪、那块地够不够支撑,提前把脚往平地引;左右对称不需要在高维图像上做镜像增强,而是在紧凑潜空间做镜像,省算力又保留探索自由度;不同地形用不同判别器,避免一个全局人类风格被楼梯/平地冲突掉。
技术核心机制:
- 观测/动作:本体感知 72 维(基座角速度、投影重力、速度指令、关节位置/速度、上一步动作,堆叠历史)+ 36×36 深度图;动作 = 21 维关节位置目标。Critic 用特权信息(真值基座速度、足端速度、接触状态、足/身体周围高程图)。
- 网络结构:CNN 编码深度到 MLP 编码本体到 GRU 融合成三头潜表示 z = [ z f , z b , z p ] z=[z_f, z_b, z_p] z=[zf,zb,zp],其中 z f z_f zf/ z b z_b zb 解码足/身体周围高程图(监督重建), z p z_p zp 用 VAE 预测下一步本体感知;另有独立 MLP estimator 从历史本体预测基座速度;Actor 是 MoE 结构。
- 三个训练期机制: a a a 预想落脚点引导——训练时用 foothold imagination model 从特权状态+动作预测摆动脚的高斯接触分布 μ , σ \mu,\sigma μ,σ,再计算脚底 22.5cm×10cm 区域的支撑缺失度 ρ \rho ρ,摆动脚用 E q [ ρ ] \mathbb{E}_q[\rho] Eq[ρ]、支撑脚用当前 ρ \rho ρ,合成 r f r^f rf 奖励; b b b 等变潜空间对称增强——encoder 设计为镜像等变,只需对紧凑潜表示做镜像变换,无需重编码高维图像; c c c 地形专属多判别器 AMP——不同地形用不同 discriminator,捕获地形条件化风格。
- 训练:PPO + 非对称 actor-critic,三个 critic 分别对应任务/落脚/风格奖励。
关键创新点:
-
把「落脚安全」从接触时刻稀疏信号变成摆动阶段密集预测引导(implicit foothold imagination),这是对传统 foot-placement RL 信号稀疏性的直接攻击;
-
等变 encoder + 潜空间镜像,在视觉策略下做对称学习的算力-灵活性折中,优于输入级增强和严格等变架构;
-
地形专属多判别器 AMP,解决单一人类风格在不同地形间的冲突。
数据/算力/训练成本:仿真环境为自研(Isaac Gym/Lab 类),真机为宇树/类人平台(具体型号未在摘要明确,视频显示为白色双足人形)。GPU 数量与时长未公开。仅用机身前置单目深度相机,单阶段训练,无需提前建图。【推测】仿真训练规模与典型人形 RL 相当(数千并行环境 × 数亿步),但论文未披露。
特点与局限:
-
优势:单阶段端到端、无需多阶段蒸馏、无需显式建图;跨平台验证(论文有附录E);90cm 跨距、45cm 高台、长时室外行进。
-
局限:仅深度视觉,无语义理解;动作空间仍为速度指令 + 关节位置目标,非语言驱动;MoE actor 增加了部署复杂度;长时室外仅展示路线,未做系统性的失败率统计。
与同领域其他工作的关系: 属于「teacher-free 单阶段视觉 locomotion」路线,与 SOLO(teacher-student 三阶段蒸馏)形成方法论对比;其等变对称学习承接了 Legged Robots 中 symmetry augmentation 的传统,但把它移到潜空间;多判别器 AMP 是对 Escontrela AMP 框架的地形条件化扩展。与 Berkeley Humanoid Parkour(arXiv 2410.03654)同属视觉地形自适应流派,但 SSR 更强调安全落脚与对称性,后者更强调野外徒步鲁棒性。
读后心得: 别等脚踩空了才后悔——在摆动阶段就「脑补」落脚点安不安全,比事后惩罚有用得多。
来源链接:
AME(AME-2):Agile and Generalized Legged Locomotion via Attention-Based Neural Map Encoding
一句话定位: ETH Zurich Marco Hutter 组提出的「注意力式神经地图编码器」RL 框架,把局部高程图特征用 attention 聚焦到 salient 区域,让四足+双足机器人在敏捷性与泛化性之间取得平衡,被 IEEE T-RO 接收。
核心设计思路: 现有方法的两难:端到端 sensorimotor 模型跑得快但不可解释、泛化差;显式建图+MPC 泛化好但不敏捷。AME 的直觉是:不搞端到端黑盒,也不搞经典高程图+MPC,而是学一个「不确定性感知的快速建图 pipeline」把深度转成带不确定度的局部高程,再用 attention encoder 从这张图里挑重要区域喂给 RL policy——既有地图的可解释性和泛化性,又有学习的敏捷性。
技术核心机制:
-
建图 pipeline:神经网络把单帧深度转成局部高程(带不确定度),与里程计融合;与并行仿真集成,支持在线建图训练(sim-to-real 时建图延迟/噪声一致)。
-
注意力地图编码器:从地图提取 local + global mapping 特征,用 self-attention 聚焦 salient 区域(如台阶边缘、碎石),输出可解释、可泛化的 embedding 给 RL policy。
-
验证平台:四足(ANYmal 类)+ 双足人形。
-
训练:PPO + domain randomization,建图 pipeline 在线训练,与 policy 联合。
关键创新点:
-
学习式建图替代手工高程图,自带不确定度,对噪声/遮挡鲁棒;
-
attention encoder 让 policy 「看哪里」可解释,而不是端到端黑盒;
-
首次在同一框架里同时验证四足和双足,且敏捷性达到 parkour 级别。
数据/算力/训练成本:ETH Robotic Systems Lab 标准配置(大规模 GPU 并行仿真),具体 GPU 数与时长未公开。真机 ANYmal 四足 + 双足人形。
特点与局限:
-
优势:可解释性强(attention 权重可视化);对遮挡/噪声鲁棒;四足双足统一框架;T-RO 级系统性工作。
-
局限:仍依赖显式建图中间表示,而非纯端到端像素到动作;双足验证规模有限(论文摘要提及但未展开复杂 parkour);建图 pipeline 增加了系统复杂度。
与同领域其他工作的关系: 是 ETH 组从「Learning robust perceptive locomotion for quadrupedal robots in the wild」(arXiv 2201.08117,高程图+RL)到 ANYmal Parkour(Science Robotics 2024)的技术演进。关键关系:SOLO 论文明确将 AME 作为其 teacher/student 的 backbone(引用 [6]),即 SOLO = AME backbone + Query Reconstructor + TA-MSE,为直接继承关系。在技术谱系上,AME 是「地图中间表示 + 学习编码器」路线的代表作,与纯端到端视觉策略(如 SSR、Humanoid Parkour Learning)形成对比。
读后心得: 别在「端到端黑盒」和「显式建图」之间二选一——学一个带不确定度的快速地图,再让 attention 自己挑该看哪里,两边的好处都能拿到。
SOLO:Stable Omni-terrain Long-Horizon Perceptive Humanoid Locomotion
一句话定位: 中科大 AGI 研究所 + X-Humanoid 提出的人形感知行进框架,用「Query Reconstructor 保地形边缘锐度 + TA-MSE 轨迹级蒸馏信用分配」两个机制,解决长时部署中「地形重建糊掉关键细节 + 逐帧模仿没有时间信用分配」两大失效模式,zero-shot 走完 1.5km 室外路线。
核心设计思路: 长时部署时策略为什么会崩?两个原因:(1) 传统地形重建器用 CNN-RNN 共享瓶颈压缩深度历史,把台阶边缘、垫脚石边界这些「动作敏感细节」给平滑掉了;(2) teacher-student 蒸馏只匹配当前帧动作 MSE,不知道「现在这个动作会导致未来踩空」。SOLO 的解法:感知端用 cell-query 逐条检索(不要共享瓶颈),策略端把「下一步 teacher 会怎么说」的分歧直接塞进 PPO reward,让 GAE 自动往前传信用。
技术核心机制:
- Teacher-Student 设置:Teacher 看特权高程图 + 真值基座速度 + 本体(84维),输出 25 维关节偏移;Student 看 4 帧 D455 深度历史 + 10 帧本体历史,由 QR 重建出高程图和基座速度后再决策。两者共享 AME backbone + LSTM bypass。
- Query Reconstructor Q R QR QR:ResNet 编码每帧深度成 visual tokens,MLP 编码本体历史,加时序位置 embedding,拼接后过 Transformer encoder 得到 sensor memory M t M_t Mt;对高程图每个 cell 做 Fourier 坐标编码到 query,通过 cross-attention 从 M t M_t Mt 检索 cell-specific 证据,再 decode 高度值;另有独立 velocity query 检索 3-DoF 基座速度。
- TA-MSE Distillation:保留标准当前帧 MSE 辅助损失 L a u x L_{aux} Laux;在 s t s_t st 到 s t + 1 s_{t+1} st+1 后,计算 student 和 teacher 在 s t + 1 s_{t+1} st+1 的动作分歧 l ˉ t + 1 = s t o p _ g r a d ∥ μ θ ( h t + 1 S ) − μ T ( o t + 1 T ) ∥ 2 \bar{l}_{t+1} = \mathrm{stop\_grad}\left\|\mu_\theta(h^S_{t+1}) - \mu_T(o^T_{t+1})\right\|^2 lˉt+1=stop_grad μθ(ht+1S)−μT(ot+1T) 2,塞进 reward r t = r t a s k − β ⋅ l ˉ t + 1 r_t = r^\mathrm{task} - \beta\cdot\bar{l}_{t+1} rt=rtask−β⋅lˉt+1;通过 GAE,未来分歧惩罚自动传播到当前动作,无需额外 critic 或 teacher rollout。
- 三阶段训练:Stage I 训特权 teacher(AMP-regularized PPO);Stage II 迁移 AME 参数到 student,TA-MSE 蒸馏(特权地形输入);Stage III 用 QR 替换特权地形,联合微调 student + QR。
- 部署:仅 chest-mounted D455 深度 + 本体,50Hz 运行。
关键创新点:
-
Query Reconstructor 用 Fourier cell queries + cross-attention 替代 dense decoder,高程图 L1 误差降低 3.3 至 4.0 倍,垫脚石成功率从 0 至 3% 拉到 96%;
-
TA-MSE 把 next-state teacher-student 分歧直接作为 PPO reward 的一部分,实现轨迹级信用分配,无需额外 critic;
-
长时部署验证——1.5km 连续室外 + 室内混合地形,而非短片段 reset。
数据/算力/训练成本: Isaac Lab 大规模并行仿真,具体 GPU 数与时长未公开。真机为 X-Humanoid 自研 Omni 平台。stress-test 地形上 97.5% 平均穿越成功率、96% 垫脚石成功率。
特点与局限:
-
优势:直击长时部署两大失效模式;感知重建精度定量验证(3.3 至 4.0 倍 L1 降低);1.5km 室外连续部署是少有的长时验证。
-
局限:仍为速度指令条件策略,非语言/任务驱动;teacher-student 三阶段训练 pipeline 较复杂;QR 依赖深度历史窗口(4帧),对突发遮挡的鲁棒性未充分讨论;动作空间仅 25 维关节偏移,不含手臂操作。
与同领域其他工作的关系:技术上直接继承 ETH AME backbone(teacher/student 均基于 AME);感知层对比 START(dense recurrent decoder)和 DPL(cross-attention terrain reconstructor),QR 在 cell 级保真度上超越两者;蒸馏层对比 PPO 和 MSE+PPO baseline。与 SSR 同属「视觉地形自适应人形行进」但方法论不同:SSR 是单阶段 teacher-free,SOLO 是三阶段 teacher-student。与 Berkeley Humanoid Parkour(arXiv 2410.03654)的 4-mile 徒步形成长时部署竞赛。
读后心得: 长时跑不下来不是因为动作不够帅,而是地图把台阶边缘糊成了斜坡、蒸馏又只看当前帧不管将来——把「将来会错」现在就罚,比「现在像老师」更管用。
来源链接:
PHP:Perceptive Humanoid Parkour: Chaining Dynamic Human Skills via Motion Matching
一句话定位: UC Berkeley + Amazon FAR(C. Karen Liu / Pieter Abbeel / Angjoo Kanazawa 等)提出的模块化跑酷框架,用「motion matching 组合原子人类技能 + 深度蒸馏学生策略」,让 Unitree G1 自主选动作跳过、爬上、翻越、滚下障碍,最高爬上 1.25m 高台(机器人身高的 96%)。
核心设计思路: 人形跑酷需要三件事:低层级鲁棒、人类动作表现力、长时技能组合与感知驱动决策。PHP 的直觉是:不要端到端从零学所有技能(难收敛、动作丑),而是把人类动捕原子技能重定向到机器人,用 motion matching(最近邻检索)在特征空间里实时拼接成长时运动轨迹,再用 RL 训练 tracking expert,最后蒸馏成单策略深度学生——感知负责「选技能」,tracking 负责「做出来」。
技术核心机制:
-
数据 pipeline:人类动捕原子技能(跳、攀、翻、滚等)到 retargeting 到 Unitree G1 到形成技能库。
-
Motion Matching 组合:在特征空间(运动状态特征)做最近邻检索,实时拼接原子技能为长时运动轨迹,保证技能间平滑过渡、保留人类动作优雅性。
-
RL Expert 训练:对每条组合轨迹训练 motion-tracking RL expert policy。
-
学生蒸馏:用 DAgger + RL 组合,把多 expert 蒸馏成单 depth-based 多技能学生策略。
-
感知决策:仅用车载深度 + 离散 2D 速度指令,机器人自主判断障碍几何/高度,选择 step over / climb onto / vault / roll off。
-
真机:Unitree G1,1.25m 攀爬(96% 身高),长时多障碍穿越 + 实时扰动闭环适应。
关键创新点:
-
Motion matching(游戏动画领域技术)首次系统性引入人形跑酷技能组合,实现「人类动作优雅性 + 技能灵活拼接」;
-
感知驱动的自主技能选择——不是人工指定走哪条路线,而是机器人看障碍自己决定用什么技能;
-
模块化框架(技能库到 motion matching 到 tracking expert 到蒸馏学生),可扩展性强,新增技能只需扩充动捕库。
数据/算力/训练成本:人类动捕数据量未公开;Unitree G1 真机验证;训练算力未公开。RSS 2026 接收。
特点与局限:
-
优势:动作表现力极强(人类动捕先验);技能组合灵活可扩展;1.25m 攀爬是人形跑酷新高度;闭环扰动适应。
-
局限:依赖人类动捕数据(数据瓶颈);motion matching 检索延迟与特征空间设计敏感;学生策略仍为深度+速度指令,非语言驱动;技能库覆盖范围决定上限。
与同领域其他工作的关系: 与 Humanoid Parkour Learning(清华,arXiv 2406.10759,无 motion prior 端到端跑酷)形成鲜明方法论对比:PHP 走「人类数据先验 + motion matching + 蒸馏」,后者走「零先验 RL 从头学」。与 SSR/SOLO 同属视觉感知跑酷,但 PHP 的技能层次更高(vault/roll 等复合动作),SSR/SOLO 更偏向连续地形行进。同一团队(C.K. Liu)的 OmniRetarget 是其数据生成 pipeline 的延伸。
读后心得: 别让 RL 从零学「怎么翻墙」——把运动员的动作录下来,让机器人自己查字典选最像的那一段,优雅和灵活同时到手。
来源链接:
-
RSS 2026
Humanoid Parkour Learning(清华,CoRL 2024)
一句话定位: 端到端视觉人形跑酷策略,无需任何 motion prior,直接从深度+本体到关节动作,让 H1 人形跳 0.42m 高台、跨 0.8m 沟、1.8m/s 野外奔跑。
核心设计思路: 传统人形跑酷需要多阶段 pipeline 或运动先验;这篇工作证明:给足够强的 domain randomization + teacher-student 蒸馏,单阶段端到端 RL 就能从零学会多种 parkour 技能。
技术核心机制: 特权 teacher 用完整地形信息训练到蒸馏到仅深度+本体的学生策略;无 motion prior;多种 parkour 技能(跳台、跨沟、跨栏)在统一策略中学得;可迁移到 mobile manipulation。
关键创新点: 证明「无 motion prior 端到端视觉 parkour」可行,打破了跑酷必须依赖动捕先验的假设。
数据/算力/训练成本:仿真训练,GPU 配置未公开。真机 H1。
特点与局限:
-
优势:无需动捕数据、端到端、多技能统一策略。
-
局限:动作表现力不如人类先验路线;技能种类有限;早期工作,长时部署验证不足。
与同领域其他工作的关系: 是 SSR/PHP/SOLO 等 2026 年工作的「基线」——它们的对比实验常引用此工作。在技术谱系上属于「teacher-student 蒸馏 + 视觉 parkour」开山之作之一。
读后心得: 跑酷不一定需要运动员——把仿真地形随机化得够狠,RL 自己就能学会跳。
Learning Humanoid Locomotion over Challenging Terrain(UC Berkeley,2024)
一句话定位: Berkeley 人形平台(Berkeley Humanoid)配套的视觉地形行进工作,在 Berkeley 地区完成 5+ 英里野外徒步,在旧金山 31% 坡度街道上稳定行走。
核心设计思路: 强调「野外真实场景验证」而非实验室技能堆砌——用视觉策略在真实徒步路线和极陡街道上测试,证明 sim-to-real 泛化。
技术核心机制: 视觉输入(深度)+ 本体到 RL 策略;domain randomization;与 Berkeley Humanoid 硬件平台配套。
关键创新点: 长距离野外部署(4+ miles)和极端坡度(31% grade)的真实世界验证,比实验室技能展示更有说服力。
数据/算力/训练成本:Berkeley Humanoid 自研平台;具体 GPU未公开。
特点与局限:
-
优势:真实场景覆盖广(徒步、陡坡街道)。
-
局限:无复杂 parkour 技能;策略细节在 Berkeley Humanoid 平台论文中。
与同领域其他工作的关系: 与 SOLO 的 1.5km 室外路线同属「长时室外部署」竞赛;是 Berkeley Sferrazza/Shi 组在 PHP 之前的 locomotion 基础工作。
读后心得: 机器人能走多远,比能跳多高更能说明问题——在旧金山 31% 的坡上走下来,比实验室跳箱有说服力。
来源链接:arXiv
Hiking in the Wild(2026)
一句话定位: 可扩展的端到端人形感知徒步框架,单阶段 RL 把原始深度+本体直接映射到关节动作,用 MoE 架构处理高维视觉和多地形技能。
核心设计思路: 不要复杂模块化 pipeline,单阶段端到端 + MoE 就够。核心安全机制:地形边缘检测 + 足部体素点结合的「落脚安全机制」防止边缘打滑。
技术核心机制: 单阶段 RL:深度+本体到关节动作;MoE 处理多地形技能;Terrain Edge Detection + Foot Volume Points 防边缘打滑;无需外部状态估计。
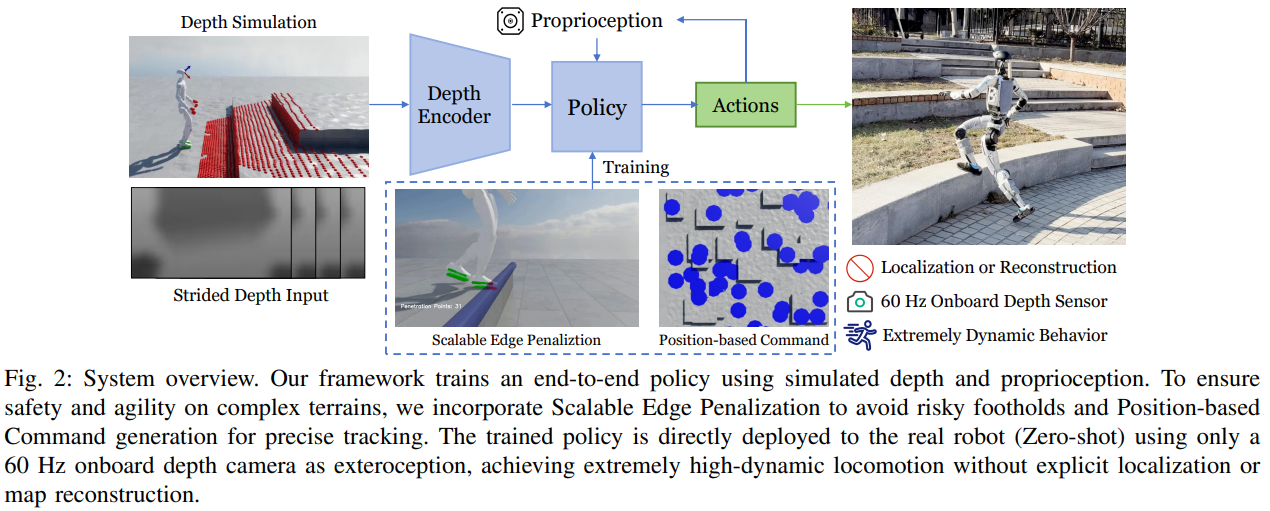
关键创新点:「可扩展」定位——MoE 让新增地形技能不需重训全策略;落脚安全机制轻量有效。
数据/算力/训练成本:未公开。
特点与局限:
- 优势:单阶段、轻量安全机制、MoE 可扩展。
- 局限:技能种类偏徒步而非激进 parkour;MoE 路由机制未深入分析。
与同领域其他工作的关系: 与 SSR 同属单阶段端到端视觉 locomotion 路线,但 SSR 更侧重对称+人类风格,Hiking in the Wild 更侧重可扩展性。
读后心得: MoE 不只是大模型的专利——给 locomotion 也搞个专家混合,新地形来了只加专家不用重训。
来源链接:
ParkourFormer(2026)
一句话定位: Transformer 序列建模框架,把人形跑酷重新定义为「未来状态条件化序列预测」,解决传统反应式 RL 策略不预判接触切换和身体动力学的问题。
核心设计思路: 现有 RL 策略是 reactive 的(观测到动作),不建模未来;ParkourFormer 引入 predictive supervision + sequence modeling,让策略在做当前动作时就预期未来身体状态和接触切换。
技术核心机制: Transformer 序列建模;预测监督(predictive supervision)让策略预测未来身体状态;将 locomotion 重构为 future-conditioned sequence generation。
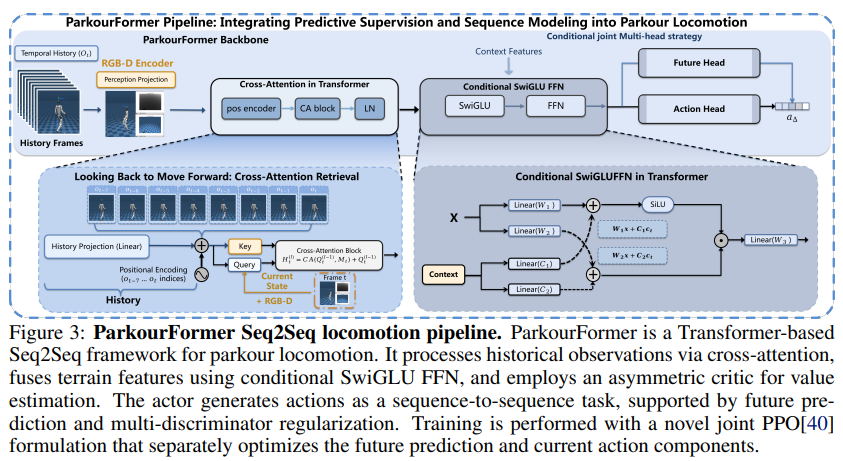
关键创新点: 首次将 Transformer 序列建模系统性引入人形跑酷,从 reactive 转向 predictive。
数据/算力/训练成本:未公开。
特点与局限:
- 优势:理论上对动态接触预判更优。
- 局限:Transformer 推理延迟 vs 实时控制的 trade-off 需验证;真机部署证据待补充。
与同领域其他工作的关系: 与 SSR 的 foothold imagination 异曲同工——都在解决「预判未来」问题,但 ParkourFormer 用 Transformer 序列建模,SSR 用显式 foothold prediction。
读后心得: 跑酷的难点不是跳得高,而是知道下一个接触什么时候来——Transformer 恰好擅长这个。
来源链接:arXiv
Deep Whole-body Parkour(2026)
一句话定位: 将人类演示重定向与感知控制统一到单一可扩展训练框架,让人形直接从人类演示 + 车载传感学习敏捷物理交互。
核心设计思路: 标准 motion tracking 不看环境,纯感知控制不学动作表现力;这篇把两者统一,即tracking + perceptive control 在同一端到端 pipeline 里。
技术核心机制: 人类演示到 retargeting 到统一 tracking + perceptive RL 训练;深度视觉对环境干扰鲁棒;端到端训练含外感知。
关键创新点: 统一 motion tracking 与 perceptive control 的单一框架,而非分层。
数据/算力/训练成本:未公开。
特点与局限:
- 优势:动作表现力 + 环境适应兼得。
- 局限:框架细节公开有限;与 PHP 的 motion matching 路线竞争。
与同领域其他工作的关系: 与 PHP 同属「人类数据先验 + 感知控制」路线,但 PHP 用 motion matching 显式拼接,这篇用端到端统一训练。
读后心得: 别把「学动作」和「看路」分成两个网络——放一起训,反而更稳。
来源链接:arXiv
全身VLA与Loco-Manipulation
本层覆盖视觉-语言-动作(VLA)模型直接输出全身运动指令、实现"边走边操作"(loco-manipulation)的技术栈。大脑做语义理解,小脑做运动执行。SONIC 已成为 loco-manipulation 的事实底层控制器,ω-0、OpenHLM、GR00T N1.x 均接 SONIC 作为执行层。
Figure Helix 02(Figure AI)
一句话定位: Figure AI 的双系统 VLA,首个用「System 2 慢思考 VLM + System 1 快反应 diffusion transformer」直接从像素+语言控制人形全身(含手指、手腕、头、躯干)的模型;Helix 02(2026.01)扩展到全身行走+操作一体。
核心设计思路: 快与慢的矛盾:VLM 通用但慢(7 至 9Hz),motor policy 快但不通用。Helix 把两者解耦:System 2(7B VLM)负责场景理解和语言推理,输出中间语义表示;System 1(diffusion transformer)以 200Hz 输出高频连续控制。两者紧耦合联合训练。
技术核心机制:
- System 2:7B 参数 VLM,7 至 9Hz,视觉+语言到语义 token。
- System 1:diffusion transformer,200Hz,语义 token + 本体到全身连续动作(手腕、躯干、头、手指)。
- Helix 02:扩展到 walking + manipulation + balancing 一体化。
- Project Go-Big:互联网规模预训练 + 纯人类视频 zero-shot 迁移(无需机器人数据)。
- S0(2026.04):给全身控制加视觉感知,替代手工 mode switch。
关键创新点:
- 首个全身高频连续控制 VLA(含手指级);
- 双系统紧耦合联合训练而非简单分层;
- 纯人类视频到机器人 zero-shot 迁移(Project Go-Big)。
数据/算力/训练成本: 未公开具体 GPU 数;真机 Figure 02/03;大量人类视频 + 真机遥操作数据。【推测】训练规模在万卡级 H100 量级。
特点与局限:
- 优势:全身高频控制、双系统架构、商业化落地最成熟。
- 局限:未开源;技术细节以博客/视频为主,缺乏同行评审论文;Sim-to-real 与长时可靠性的独立验证有限。
与同领域其他工作的关系: 与 NVIDIA GR00T N1 的双系统架构几乎同期但独立发展(都引用 System1/System2 认知科学灵感);Helix 02 与 GR00T N1.5/N1.6 在全身 loco-manipulation 上直接竞争。
读后心得: 机器人不需要一个超级大脑——一个慢慢看路的「思考者」加一个快快出拳的「执行者」,拼起来就是全身 VLA。
来源链接:
NVIDIA GR00T N1 / N1.5 / N1.6 / N1.7
一句话定位: NVIDIA 开源人形机器人 VLA 基础模型,双系统架构(VLM System 2 + diffusion transformer System 1),2.2B 参数,跨本体通用,120Hz 动作输出;N1.5/N1.6/N1.7 持续迭代 loco-manipulation 能力。
核心设计思路: 与 Helix 类似的快慢双系统,但走开源路线——跨本体(单臂到全身人形),统一异构数据(人类视频 + 仿真 + 真机遥操作)联合训练。
技术核心机制:
-
System 2(VLM):视觉+语言到语义理解。
-
System 1(diffusion transformer):语义 + 本体到高频动作(120Hz)。
-
两模块紧耦合端到端联合训练。
-
N1.6:加入数千小时真机遥操作数据(YAM 双臂、Agibot Genie-1、Unitree G1),提升双手协作和全身 loco-manipulation。
-
N1.7(2026-07,Apache-2.0,3B VLA,Cosmos-Reason2/Qwen3-VL 主干):通过 UNITREE_G1_SONIC embodiment 标签调用 GEAR-SONIC 作为低层全身控制器,VLA 输出紧凑 latent action token,由学习型全身控制器解成全身关节指令。
关键创新点:
- 首个开源的人形 VLA 基础模型;
- 跨本体统一;
- 与 Isaac Lab / LeRobot 生态深度集成;
- N1.5/N1.7 直接接入 SONIC 作为低层全身控制器。
数据/算力/训练成本: 2.2B 参数(N1 初始);N1.7 为 3B VLA;训练数据含人类视频 + 仿真 + 真机遥操作;GPU 规模未公开(【推测】万卡级)。真机验证:GR-1、YAM、Agibot Genie-1、Unitree G1。
特点与局限:
- 优势:开源、跨本体、生态完善。
- 局限:开源版性能与闭源商业版有差距;全身 loco-manipulation 仍需 post-training;动作生成 diffusion 延迟需工程优化。
与同领域其他工作的关系: 是学术界最常用的人形 VLA 底座——SONIC、WholeBodyVLA、OpenHLM、POT-VLA 等工作常接 GR00T 作为高层 VLA。与 Figure Helix 形成「开源 vs 闭源」双雄。SONIC 作为其低层控制器,GR00T 到 SONIC 构成"大脑到小脑"的事实标准架构。
读后心得: GR00T 就是人形机器人界的 Llama——不追求最强,但追求谁都能拿来改。
来源链接:
WholeBodyVLA(复旦 + 港大 + 智元,ICLR 2026)
一句话定位: 首个面向全身 loco-manipulation 的统一潜空间 VLA,从无标注人类视频预训练运动表征(LAM),配合面向 loco-manipulation 的 RL 策略(LMO),让智元灵犀 X2 在大空间里边走边搬箱子。
核心设计思路: 全身 loco-manipulation 的核心难点是「行走和操作不是两件事,而是一件事」。WholeBodyVLA 的直觉:从无标注人类视频学行走/操作的统一运动潜表征(LAM),再用一个专门的 RL 策略(LMO)确保行走核心动作(前进/转弯/蹲下)精确稳定,VLA 负责语义到全身动作的映射。
技术核心机制:
- LAM(Loco-manipulation Action Model):从无标注人类视频预训练,学习行走/操作统一潜空间。
- LMO(Loco-manipulation Oriented):面向 loco-manipulation 的 RL policy,精确控制前进/转弯/蹲下。
- WholeBodyVLA:统一潜空间 VLA,语言+视觉到全身动作,在 AgiBot X2 上验证大空间 loco-manipulation,比 baseline 提升 21.3%。
关键创新点:
- 从无标注人类视频预训练全身运动表征,绕开真机遥操作数据瓶颈;
- LAM + LMO 分层:VLA 管语义,RL 管运动稳定;
- 真机大空间 loco-manipulation 验证。
数据/算力/训练成本:无标注人类视频预训练 + AgiBot X2 真机;具体 GPU未公开。ICLR 2026。
特点与局限:
- 优势:人类视频预训练降低数据成本;真机大空间验证。
- 局限:LAM/LMO 分层仍非完全端到端;操作任务复杂度中等(搬箱子);跨本体泛化未验证。
与同领域其他工作的关系: 是智元生态的代表性全身 VLA 工作;与 GR00T N1 竞争但更聚焦 loco-manipulation;与 EgoVLA(从第一视角视频学操作)同属「人类视频预训练」路线;与 Ψ0 的人机数据对齐论点相关。
读后心得: 机器人不用每一步都从真机学——先看人类怎么边走边干活,再微调几个真机例子就行。
来源链接:
Tesla Optimus(Tesla,端到端神经网络)
一句话定位: Tesla Optimus 采用与 FSD 同源的端到端神经网络架构,单网络从多相机像素 + 本体感知直接输出连续控制,Gen 3 引入 VLA 模型支持自然语言指令。
核心设计思路: 与 FSD v12 完全相同的哲学:「输入像素,输出控制」,不要模块化 pipeline。同一套神经网络架构同时驱动自动驾驶和人形机器人。数据飞轮:第一视角人类视频 + Cortex 超算(67,000+ H100 等效 GPU)+ World Simulator 生成 36Hz 合成数据。
技术核心机制: 单一端到端神经网络(FSD v15 架构适配);多相机 + 关节本体感知 + 力/触觉到连续控制;Grok 4.0 视觉模型提供空间理解;World Simulator(Digital Dreams)生成合成训练数据;Gen 3 引入 VLA 支持自然语言命令。
关键创新点:
- 自动驾驶与机器人共用神经网络架构和训练基础设施;
- 超大规模合成数据生成(World Simulator);
- 无云端、全机载推理。
**数据/算力/训练成本:**Cortex 超算 67,000+ H100 等效 GPU;数据以第一视角人类视频为主;1000+ 台 Gen 3 在 Tesla 工厂部署。
特点与局限:
- 优势:工程化最成熟(千台级量产);数据规模最大;端到端架构统一。
- 局限:无同行评审论文;技术细节以 CEO 演讲和博客为主;失败模式不透明。
与同领域其他工作的关系: 与 Figure Helix 并列为人形 VLA 商业化双雄,但 Tesla 走「自动驾驶技术迁移」路线,Figure 走「机器人原生 VLA」路线。与学术界的 GR00T/WholeBodyVLA 不在同一开源生态。
读后心得: 特斯拉做机器人的思路和做自动驾驶一模一样——别管什么 VLA 不 VLA,一个大网络吃像素出控制,数据喂够就行。
来源链接:Tesla AI
银河通用 AstraBrain-WBC 0.5
一句话定位: 银河通用发布的全球首个「人形机器人通用小脑 GPT」基础模型,用 GPT 式因果 Transformer 把全身实时控制重构为连续序列预测问题。
核心设计思路: 把全身运动控制当成 GPT 做语言的方式——给定动作历史,预测下一步动作。因果 Transformer 自回归生成,让机器人面对陌生地形有「直觉」。
技术核心机制: GPT 风格因果 Transformer;全身实时控制到连续序列预测;AstraSynth 百亿级合成数据基建;GraspVLA(arXiv 2505.03233)为其抓取子模型;LDA-1B 跨本体隐式世界-动作模型(RSS 2026)。
关键创新点:
- 把 GPT 式自回归范式引入全身实时运动控制(「小脑」而非「大脑」);
- 百亿级合成数据 pipeline。
数据/算力/训练成本:AstraSynth 百亿级合成数据;具体 GPU未公开。Galbot G1 真机,2025 年出货 1200+ 台。【推测】1B 参数级模型。
特点与局限:
- 优势:合成数据驱动降低真机依赖;零售场景商业化落地。
- 局限:学术论文少,技术细节不透明;GPT 式自回归 vs 实时控制频率的 trade-off 存疑。
与同领域其他工作的关系: 与 SONIC(运动追踪基础模型)定位类似——都是「全身控制底座」,但银河通用走 GPT 自回归路线,SONIC 走 MLP tracking policy 路线。与 Any2Track 同属银河通用/北大/清华系。
读后心得: 把机器人走路当写文章——给前面一个词(动作历史),GPT 猜下一个词(关节位置)。
来源链接:
- 银河通用官网
- GraspVLA:arXiv 2505.03233
ω-0(Omega-0):Latent Predictive World Action Model
一句话定位: 北大 + NTU + 港科广 + 智源(2026.8),潜空间预测式世界动作模型,抛弃像素级视频重建,用「未来观测 embedding」做监督,扩散生成适配 SONIC 底层控制器的全身动作潜变量;三阶段训练(动作 VLM 到人类数据潜空间迁移到真机微调),11 项居家任务真机验证。
核心设计思路: 视频世界模型太重(像素级重建计算量大),ω-0 的直觉是:机器人不需要「看见」未来,只需要「知道」未来——学一个紧凑的未来观测嵌入作为预测目标,既轻量又保留了视觉预见力。
技术核心机制:
- 输入:语言指令 + 当前视觉观测 + 本体状态。
- 预测目标:未来观测嵌入(future observation embeddings),而非未来视频帧。
- 动作生成:扩散模型生成控制器兼容的全身动作潜变量(6D pose + 关节位置)。
- 执行:动作潜变量到 SONIC 转全身关节指令。
- 三阶段训练:动作 VLM 到人类数据潜空间迁移到真机微调。
- 数据集:ω-HOME(家庭环境 loco-manipulation 数据集,真机采集)。
- 真机:Unitree G1,81.8% 家庭任务成功率。
关键创新点:
- 抛弃像素级视频重建,改用轻量未来嵌入预测;
- 视觉预见 + 动作扩散在潜空间耦合;
- 与 SONIC 解耦执行——证明 SONIC 作为 loco-manipulation 事实底层控制器的地位。
数据/算力/训练成本: ω-HOME 数据集(真机采集);具体 GPU未公开 。
特点与局限:
- 优势:轻量世界模型 + 全身动作扩散;真机家庭任务 81.8%。
- 局限:依赖 SONIC 作为底层执行;未来嵌入的可解释性和保真度有限;家庭场景泛化待验证。
与同领域其他工作的关系: 与 Being-M0.7(潜世界-动作模型)同属「latent world-action model」路线;与 GR00T N1(diffusion transformer System 1)在动作生成机制上相似,但 ω-0 强调未来预测;直接接 SONIC 作为执行层,与 OpenHLM、GR00T N1.7 共同构成"上层 VLA/世界模型到 SONIC 执行"的事实架构。
读后心得: 机器人不需要在脑子里放电影——知道下一步大概什么样就够了,轻量的未来想象比重现像素画面实用得多。
来源链接:arXiv
Ψ0(Psi-Zero):Open Foundation Model for Universal Humanoid Loco-Manipulation(RSS 2026)
一句话定位: 开放的人形 loco-manipulation 基础模型,核心论点:人类数据和人形机器人数据因为运动学/动力学根本差异,简单混合 co-training 是次优策略,需要专门的对齐方法。
核心设计思路: 现有方法把人类和机器人数据混在一起训,但人类和人形机器人的运动学结构差太多(关节数、质心、接触模式),简单 co-training 数据效率低。Ψ0 提出更聪明的对齐策略。
技术核心机制:具体架构细节未完全公开;核心论点为「人机数据不对齐问题」;RSS 2026 接收;开放基础模型。
关键创新点: 明确指出「人类+机器人混合 co-training」的次优性,提出数据对齐新范式。
数据/算力/训练成本:未公开。
特点与局限:
- 优势:开放模型;直击人机数据对齐痛点。
- 局限:公开细节有限;与 EgoHumanoid(人机 co-training)路线的实验对比需关注。
与同领域其他工作的关系: 与 EgoHumanoid(RSS 2026,人机 co-training)形成学术辩论——Ψ0 认为混合次优,EgoHumanoid 认为 co-training 可行。与 WholeBodyVLA(人类视频预训练)路线相关;与 RoboMirror 的"先理解再模仿"呼应——都在解决人机数据翻译问题。
读后心得: 人和机器人身体不一样,直接把人类动作数据喂给机器人不一定好——得先把「翻译」做对。
来源链接:
-
RSS 2026
AMO:Adaptive Motion Optimization(UCSD, RSS 2025)
一句话定位: UCSD Xiaolong Wang 组提出的全身控制框架,结合 RL 与轨迹优化(TO),在 Unitree G1(29 DoF)上实现实时自适应全身运动控制,突破传统工作空间限制。
核心设计思路: RL 全身模仿容易受 motion clip 的 distribution bias 限制;AMO 把轨迹优化的「动态可行」约束注入 RL,让策略不只是「模仿得像」,而是「动得合理」。
技术核心机制: RL + trajectory optimization 混合;DDP(differential dynamic programming)生成动态可行参考;RL 跟踪参考;Mitigate distribution bias in motion imitation RL;开源。
关键创新点:
- RL + TO 混合,解决纯模仿 RL 的动态可行性问题;
- 29 DoF G1 全身超灵活控制。
数据/算力/训练成本:Unitree G1;开源(GitHub);具体 GPU未公开。RSS 2025。
特点与局限:
- 优势:动态可行性强;开源;工作空间大。
- 局限:仍为 tracking 范式,非感知/语言驱动;TO 计算开销。
**与同领域其他工作的关系:**与 SONIC(数据规模化 tracking)路线竞争——AMO 走模型优化+RL,SONIC 走纯数据驱动。是 G1 全身控制的代表性 baseline。
读后心得: 光模仿人类动作不够——得先确认这个动作在物理上站得住,轨迹优化就是那个「物理判官」。
来源链接:
OpenHLM:An Empirical Recipe for Whole-Body Humanoid Loco-Manipulation(2026)
一句话定位: 系统性实证研究:「到底怎么搭一个全身原生 VLA」——从全身遥操作、VLA 模型设计、异构 co-training 三阶段做 one-variable-at-a-time 实验,给出可复现 recipe。
核心设计思路: 不追求新算法,而是把「怎么做全身 VLA」这件事拆开做消融,告诉社区每个设计选择的得失。
技术核心机制: 三阶段:(1) 全身遥操作接口对比(关节级 vs 末端级);(2) VLA 模型设计消融;(3) 异构 co-training。发现:关节级全身遥操作接口优于仅双臂接口;SONIC 作为运控底层 + π0.5 作为 VLA 初始化的组合有效;HuMI(基于 UMI 改造的全身数采设备)。
关键创新点: 系统性 recipe 而非新算法——「论文即实验日志」。
数据/算力/训练成本:Unitree G1;具体 GPU未公开。
特点与局限:
- 优势:实验设计严谨,社区可复现;选型建议明确。
- 局限:无根本性算法创新;实验结论依赖特定硬件。
与同领域其他工作的关系: 是 GR00T + SONIC 技术栈的系统性验证论文;与 WholeBodyVLA、Ψ0 并列为人形全身 VLA 的实证参考。直接验证了"SONIC 做执行层 + π0.5 做 VLA 大脑"这一组合。
读后心得: 不知道怎么搭全身 VLA 就抄这份 recipe——别人把每个旋钮拧过一遍告诉你哪个该拧多大。
来源链接:arXiv
VLK:Vision-Language-Kinematics(Berkeley + Stanford + CMU + Amazon FAR, 2026)
一句话定位: 用 48,000 条合成轨迹(3DGS 重建室内场景 + 特权信息合成导航/交互轨迹),让人形机器人零样本学会「行走+抓取」一体化。
核心设计思路: 真机遥操作数据太贵——VLK 用 3D Gaussian Splatting 重建真实室内场景,在里面用特权信息合成导航+物体交互轨迹,渲染第一视角观测,全自动生成训练数据。
技术核心机制: 3DGS 重建度量尺度室内环境;特权场景信息合成导航+交互轨迹;事后渲染第一视角观测;48,000 条配对轨迹;VLK policy 端到端训练;配合 SceneBot 全身跟踪。
关键创新点:
- 零人工干预的数据生成 pipeline;
- 合成数据实现 zero-shot 行走+抓取;
- 3DGS 重建 + 轨迹合成的新范式。
数据/算力/训练成本: 48,000 条合成轨迹;真机验证;具体 GPU未公开。
特点与局限:
- 优势:数据生成全自动;zero-shot loco-manipulation。
- 局限:合成到真实的 gap 仍在;3DGS 场景重建依赖扫描;复杂交互(柔性物体)未覆盖。
与同领域其他工作的关系: 与 LEGS(Gaussian Splatting 仿真器)同属「3DGS 合成数据」路线;与 ω-0(ω-HOME 真机数据)形成「合成 vs 真机」数据路线对比。
读后心得: 不想花钱做遥操作?把房间扫成 3DGS,让机器人在里面随便走随便抓,48000 条数据一夜生成。
来源链接:
HAF:Humanoid Adaptation Framework(2026)
一句话定位: 把现成通用 VLA 底座适配到人形全身 loco-manipulation 的两阶段框架——层级 action flow 把全身动作去噪拆成三阶段,谱潜空间 RL 做高效微调。
核心设计思路: 通用 VLA(如 π0)的动作空间是为单臂设计的,直接套全身 loco-manipulation 维度不匹配。HAF 不从头训,而是「改」现有 VLA:层级 flow matching + 谱潜空间 RL。
技术核心机制:
-
HAF-VLA:基于预训练 flow-matching VLA,全身动作去噪拆成三阶段(stage embeddings + cross-stage KV cache)。
-
HAF-Steer:谱潜空间 RL 微调。
-
目标:off-the-shelf VLA 到人形全身 loco-manipulation。
关键创新点:
-
不从头训 VLA,而是适配现有通用 VLA;
-
层级动作去噪解决高维全身动作生成。
数据/算力/训练成本:未公开。
特点与局限:
- 优势:复用现有 VLA 底座,成本低。
- 局限:适配层增加复杂度;适配上限受限于原 VLA。
与同领域其他工作的关系: 与 OpenHLM(recipe)、Ψ0(人机对齐)同属「如何把已有 VLA 用到人形全身」的技术流派。
读后心得: 通用 VLA 是给单臂用的,要让人形全身也能用,别从头训——把动作去噪拆成三步走就行。
来源链接:arXiv
POT-VLA:Persistent 3D Object Tokens(2026)
一句话定位: 在人形 VLA 中引入持久化 3D 物体 token,实现可验证的 loco-manipulation 闭环——机器人不仅「看到」物体,还能跟踪物体在 3D 空间中的身份和位置。
核心设计思路: 传统 VLA 的视觉 token 是帧级的,物体换个角度就认不出。POT 让 3D 物体 token 在时间上持久化,机器人能记住「那个杯子在哪」,实现闭环操作。
技术核心机制: Persistent 3D Object Tokens:跨帧持久化的 3D 物体表示;在 Unitree G1 上直接 GR00T-N1.7 对比验证,POT-VLA 提升 loco-manipulation 成功率。
关键创新点: 3D 物体 token 的时间持久性——闭环 loco-manipulation 的关键缺口。
数据/算力/训练成本:Unitree G1;具体数据量未公开。
特点与局限:
- 优势:解决物体身份漂移;闭环操作可验证。
- 局限:3D token 的计算开销;动态物体跟踪未验证。
与同领域其他工作的关系: 与 VLK(合成数据)、HAF(VLA 适配)互补——POT 关注 VLA 的感知闭环质量。基于 GR00T-N1.7 验证,间接接 SONIC 执行层。
读后心得: 机器人抓不住东西往往不是手不行,是「忘了东西在哪」——给物体发个永久身份证,跨帧不丢。
来源链接:arXiv
PhysiFlow:Physics-Aware Humanoid Whole-Body VLA(2026)
一句话定位: 多脑(multi-brain)潜流匹配 + 鲁棒跟踪的人形全身 VLA 系统,在 Unitree G1 上实现端到端 VLA 全身大空间连续任务(走到指定物品到坐下/拿取)。
核心设计思路: 全身 VLA 需要物理一致性——纯数据驱动的动作生成可能违反动力学约束。PhysiFlow 把物理感知注入 flow matching 动作生成。
技术核心机制: Multi-brain 架构;潜流匹配(latent flow matching)生成全身动作;鲁棒跟踪控制器执行;Unitree G1 大空间连续自主任务。
关键创新点: 物理感知注入 VLA 动作生成;多脑架构解耦不同时间尺度。
数据/算力/训练成本:Unitree G1;具体未公开。
特点与局限:
- 优势:物理一致性;大空间连续任务。
- 局限:多脑架构工程复杂度;与 SONIC/AMO 等底层控制器的关系未明确。
与同领域其他工作的关系: 与 WholeBodyVLA(LAM+LMO 分层)思路类似——都在 VLA 和执行器之间加物理层。
读后心得: VLA 生成的动作可能「看着对但站不住」——把物理规律塞进动作生成器,比事后摔了再修强。
来源链接:arXiv
MotionWAM:Foundation World Action Models for Real-Time Humanoid Loco-Manipulation(2026)
一句话定位: 实时世界动作模型,从单目第一视角相机驱动自主人形 loco-manipulation,用视频世界模型的中间去噪特征作为策略条件,统一预测全身运动 token(行走+躯干+高度+足部交互+手部操作)。
核心设计思路: 不要上下身分开控制——用一个统一运动潜变量,把行走、躯干、高度调节、足部交互、手部操作全部塞进一个动作空间。视频世界模型的去噪过程本身就是「理解物理」的过程,把中间特征拿来当策略条件。
技术核心机制: 视频世界模型中间去噪特征到策略条件;统一 motion latent 覆盖全身所有自由度;三阶段学习框架逐步适配视频世界模型到 loco-manipulation。
关键创新点:
- 上下身统一动作空间(不拆分);
- 视频世界模型中间特征作为策略条件;
- 单目相机实时。
数据/算力/训练成本:未公开。
特点与局限:
-
优势:真正端到端统一全身;世界模型特征提供物理先验。
-
局限:视频世界模型计算量大;实时性需工程优化。
与同领域其他工作的关系: 与 ω-0(潜预测世界动作模型)同属「world action model」流派;与 WholeBodyVLA(上下身分离 LAM+LMO)形成方法论对比。
读后心得: 上下身为什么要分开控制?一个网络同时输出走路和拿东西,反而更协调。
来源链接:arXiv
附录
全部工作速查表
| 工作名 | 机构 | 年份 | 层次 | 路线 | 一句话定位 | arXiv 编号 |
|---|---|---|---|---|---|---|
| SONIC | NVIDIA/CMU | 2026 | 运控基座 | A | 运动跟踪规模化顶点,1亿帧/42M参数/21k GPU·h,FSQ token空间接VLA | 2511.07820 |
| Any2Any | LimX追势 | 2026 | 跨机型迁移 | A后训练 | 1%算力把SONIC权重跨机型迁移到Oli/Luna/H1,运动学对齐+动力学LoRA | 2605.23733 |
| MimicLite | RoboParty | 2025 | 运控基座 | A | 单卡92 GPU·h、0.08s前瞻的开源轻量跟踪器,对标SONIC | GitHub |
| BFM-Zero | CMU LeCAR/Meta | 2025 | 行为基座 | B | 首个真实G1上promptable行为基座,FB-CPR潜空间统一动作/目标/奖励 | 2511.04131 |
| UFO | RoboParty | 2025 | 行为基座 | B | FB训练3天压到6h,内置TeCH对比时序距离,绕开线性MDP假设 | 项目主页 |
| RGMT | 北理工+人形(上海) | 2026 | 运控基座 | A | 动力学条件化交叉注意力选择性信参考,单卡3.5h数据对标SOTA | 2601.23080 |
| Any2Track | 银河通用+北大清华 | 2025 | 运控基座 | A | 两阶段解耦:先追任意动作再外挂抗扰adapter,踹不倒 | 2509.13833 |
| OmniRetarget | Amazon FAR/MIT/Berkeley | 2025 | 数据重定向 | - | 交互网格Laplacian变形+硬约束,一份MoCap变出整套任务数据 | 2509.26633 |
| ExBody2 | UCSD/Berkeley/ByteDance | 2024 | 跟踪/数据 | A | 解耦keypoint跟踪与速度控制+privileged蒸馏,高保真表现力全身跟踪 | 2412.13196 |
| HOVER | CMU/NVIDIA/UCSD | 2024 | 多模式控制 | - | 全身姿态=所有控制模式公共抽象,一套策略通吃导航/操作/模仿 | 2410.21229 |
| OmniH2O | CMU/上海交大 | 2024 | 遥操作 | - | 运动学姿态通用接口+teacher-student蒸馏,VR/RGB/语音/GPT-4o即插即用 | CoRL 2024 |
| HumanPlus | Stanford | 2024 | 数据/模仿 | - | 50美元单RGB shadowing+40条demo学全身技能,HIT decoder-only | 2406.10454 |
| 上海AI Lab BFM | 上海AI Lab/北大等 | 2025 | 行为基座 | - | CVAE+掩码在线蒸馏,一模型多控制模式,隐空间可组合/调制/残差微调 | 2509.13780 |
| BFM综述 | LimX等/IEEE TPAMI | 2025 | 综述 | - | 41篇BFM论文五类分类:FB表征/goal-conditioned/intrinsic reward/adaptation/hierarchical | 2506.20487 |
| HIL | CMU/NVIDIA | 2025 | 学习范式 | - | tracking保自然性+AIL增适应,并行环境混合模仿 | 2505.12619 |
| BeyondMimic | UC Berkeley/Stanford | 2026 | 学习范式 | - | 引导扩散实时合成技能,从动作分布生成而非回放固定轨迹 | 2508.08241 |
| HDMI | - | 2025 | 学习范式 | - | 人类RGB视频直接学交互全身控制,三阶段pipeline | 2509.16757 |
| Visual Imitation | - | 2025 | 学习范式 | - | 123段手机视频+稠密点云重建+ego-view渲染学上下文控制 | 2505.03729 |
| RoboMirror | 智源/港科大 | 2025 | 学习范式 | - | 先理解再模仿,解决视频到人形运动的语义gap | 2512.23649 |
| SSR | 浙大 | 2026 | 感知运控 | - | 预想落脚点引导+等变潜空间对称+多判别器AMP,单阶段视觉行进 | 2605.30770 |
| AME-2 | ETH Zurich | 2026 | 感知运控 | - | 注意力神经地图编码器,带不确定度的快速建图+attention选区域,SOLO backbone | 2601.08485 |
| SOLO | 中科大/X-Humanoid | 2026 | 感知运控 | - | QR保地形边缘锐度+TA-MSE轨迹级蒸馏信用分配,继承AME backbone,1.5km室外 | 2608.26583 |
| PHP | Berkeley/Amazon FAR | 2026 | 感知运控 | - | motion matching拼接人类原子技能+深度蒸馏,G1爬1.25m高台 | 2602.15827 |
| Humanoid Parkour | 清华赵航组 | 2024 | 感知运控 | - | 无motion prior端到端视觉parkour,H1跳0.42m/跨0.8m沟 | 2406.10759 |
| Berkeley Challenging Terrain | UC Berkeley | 2024 | 感知运控 | - | 5+英里野外徒步+31%坡度街道行走,真实世界验证 | 2410.03654 |
| Hiking in the Wild | - | 2026 | 感知运控 | - | MoE可扩展端到端徒步+落脚安全机制 | 2601.07718 |
| ParkourFormer | - | 2026 | 感知运控 | - | Transformer序列建模,从reactive转向predictive跑酷 | 2605.25782 |
| Deep Whole-body Parkour | - | 2026 | 感知运控 | - | 统一motion tracking与perceptive control的单一框架 | 2601.07701 |
| Figure Helix 02 | Figure AI | 2026 | 全身VLA | - | 双系统VLA:7B VLM慢思考+diffusion transformer 200Hz快反应,全身含手指 | 官方博客 |
| GR00T N1.x | NVIDIA | 2025 | 全身VLA | - | 开源双系统VLA底座2.2B到3B,N1.7接SONIC低层控制器,跨本体 | 2503.14734 |
| WholeBodyVLA | 复旦/港大/智元 | 2025 | 全身VLA | - | 无标注人类视频预训练LAM+RL管运动稳定LMO,大空间边走边搬 | 2512.11047 |
| Tesla Optimus | Tesla | 2025 | 全身VLA | - | FSD同源端到端网络,67k H100 Cortex超算+World Simulator,千台量产 | 官网 |
| AstraBrain-WBC | 银河通用 | 2025 | 全身VLA | - | GPT式因果Transformer把全身控制当序列预测,百亿级合成数据 | 官网 |
| ω-0 | 北大/NTU/港科广/智源 | 2026 | loco-manipulation | - | 潜预测世界动作模型,未来观测embedding监督+扩散动作喂SONIC执行 | 2608.06375 |
| Ψ0 | - | 2026 | loco-manipulation | - | 人机数据不对齐:简单co-training次优,需专门对齐方法 | 2603.12263 |
| AMO | UCSD Xiaolong Wang | 2025 | loco-manipulation | - | RL+轨迹优化混合,DDP生成动态可行参考,29DoF G1全身控制 | 2505.03738 |
| OpenHLM | - | 2026 | loco-manipulation | - | 全身VLA实证recipe:关节级遥操作+SONIC底层+π0.5初始化 | 2606.22174 |
| VLK | Berkeley/Stanford/CMU | 2026 | loco-manipulation | - | 3DGS重建室内+特权合成48000条轨迹,zero-shot行走+抓取 | 2606.30645 |
| HAF | - | 2026 | loco-manipulation | - | 通用VLA适配全身:层级flow去噪三阶段+谱潜空间RL微调 | 2608.16837 |
| POT-VLA | - | 2026 | loco-manipulation | - | 持久化3D物体token跨帧跟踪,闭环loco-manipulation可验证 | 2607.18016 |
| PhysiFlow | - | 2026 | loco-manipulation | - | 多脑潜流匹配+物理感知注入VLA动作生成,G1大空间连续任务 | 2603.05410 |
| MotionWAM | - | 2026 | loco-manipulation | - | 视频世界模型中间去噪特征做策略条件,统一运动潜变量覆盖全身 | 2606.09215 |
术语表
| 术语 | 全称/解释 |
|---|---|
| BFM | Behavior Foundation Model,行为基座模型——在大规模行为数据上预训练的生成式模型,统一多种控制模式,支持行为组合/调制/残差微调 |
| FB | Forward-Backward,前向-后向无监督RL框架(Touati & Ollivier 2021),通过前向映射F(s,a)和后向映射B(s)在潜空间学可提示行为表征 |
| CPR | FB-CPR(Tirinzoni et al. 2025),Forward-Backward + Critic Pessimism Regularization,在线训练 + mocap上的策略正则。不是"Control as Probabilistic Reasoning" |
| WBC | Whole-Body Control,全身控制——协调全身所有自由度(腿、躯干、手臂、头)实现指定任务的控制方法 |
| WBT | Whole-Body Tracking,全身运动跟踪——用RL训练策略跟踪参考运动捕捉数据的全身关节轨迹 |
| VLA | Vision-Language-Action,视觉-语言-动作模型——直接从视觉输入和语言指令输出机器人动作策略的端到端模型 |
| loco-manipulation | 移动操作——机器人在行走/移动的同时进行物体操作,要求下肢 locomotion 与上肢 manipulation 协调 |
| Sim-to-Real | 仿真到现实——在仿真环境中训练策略,通过domain randomization等手段直接部署到真实机器人,无需或极少真机微调 |
| PPO | Proximal Policy Optimization,近端策略优化——on-policy强化学习算法,人形运控领域最常用的RL训练算法 |
| URL | Unsupervised Reinforcement Learning,无监督强化学习——在无任务奖励的前提下通过内在动机/自监督信号学习通用行为表征 |
| MPJPE | Mean Per-Joint Position Error,平均逐关节位置误差——跟踪精度的标准评价指标,单位mm |
| FSQ | Finite Scalar Quantization,有限标量量化——SONIC使用的动作token化方法,非VQ-VAE,避免codebook坍缩 |
| DAgger | Dataset Aggregation,数据集聚合——on-policy模仿学习算法,通过迭代收集专家数据训练策略 |
| AMP | Adversarial Motion Priors,对抗运动先验——用判别器区分专家与策略行为,把策略行为拉回人类自然分布 |
| AIL | Adversarial Imitation Learning,对抗模仿学习——通过判别器学习专家行为分布,无需逐任务reward |
| MoE | Mixture of Experts,专家混合——用多个子网络(expert)按输入条件动态路由,提升模型容量而不显著增加计算 |
| CVAE | Conditional Variational Autoencoder,条件变分自编码器——建模行为的多模态分布,上海AI Lab BFM的核心生成模型 |
| 3DGS | 3D Gaussian Splatting,3D高斯溅射——一种新的3D场景重建/渲染技术,VLK用其重建室内场景合成训练数据 |
| PD | Proportional-Derivative,比例-微分控制器——人形机器人最常用的底层关节力矩控制器 |
| DoF | Degrees of Freedom,自由度——机器人可独立运动的关节数量 |
来源汇总
本报告所有事实性内容均以 arXiv 论文、项目主页、GitHub 仓库原文为准。主要来源类别:
- arXiv 论文:覆盖全部 40+ 项工作的技术细节、实验数据与结论,编号见速查表。
- 项目主页 / 演示视频:SONIC、UFO、BFM-Zero、OmniRetarget、HumanPlus、PHP、SOLO、SSR、VLK 等工作的项目页面提供了实机演示视频与补充技术说明。
- GitHub 开源仓库:SONIC(GR00T-WholeBodyControl)、MimicLite、UFO、HumanPlus、AMO、OpenHLM 等工作开源了训练代码与数据。
- 数据集:BONES-SEED(HuggingFace)、AMASS、LAFAN1、OmniH2O-6、ω-HOME。
- 企业技术博客:Figure AI Helix/Helix 02、NVIDIA GR00T、Tesla AI、银河通用。
报告说明: 所有「未公开」字段表示原始论文/技术报告中未披露该信息。标注【推测】的内容为基于领域常识的合理推断,非原文事实。SONIC 与 ω-0 已按去重规则处理:SONIC 以第一层详细版本为准,其余位置仅做交叉引用;ω-0 以第五层详细版本为准。AME-2、SOLO、PHP 归入感知运控层。
注:仅用作个人笔记,部分内容由 AI 生成,且后续会补充和更正。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献8条内容

所有评论(0)