0.09美元追平GPT-5.6,纯国产AI芯片运行!智谱AI新开源模型杀疯了
智谱AI刚刚开源了重磅新模型GLM-5.3-Flash,原生支持多模态,100万上下文窗口。
最大亮点就是这个模型是完全基于国产AI芯片部署运行的,降低了对国外芯片的依赖。
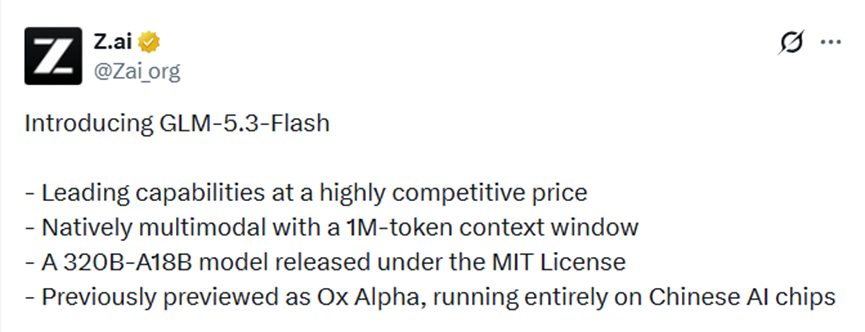
开源地址:https://huggingface.co/zai-org/GLM-5.3-Flash
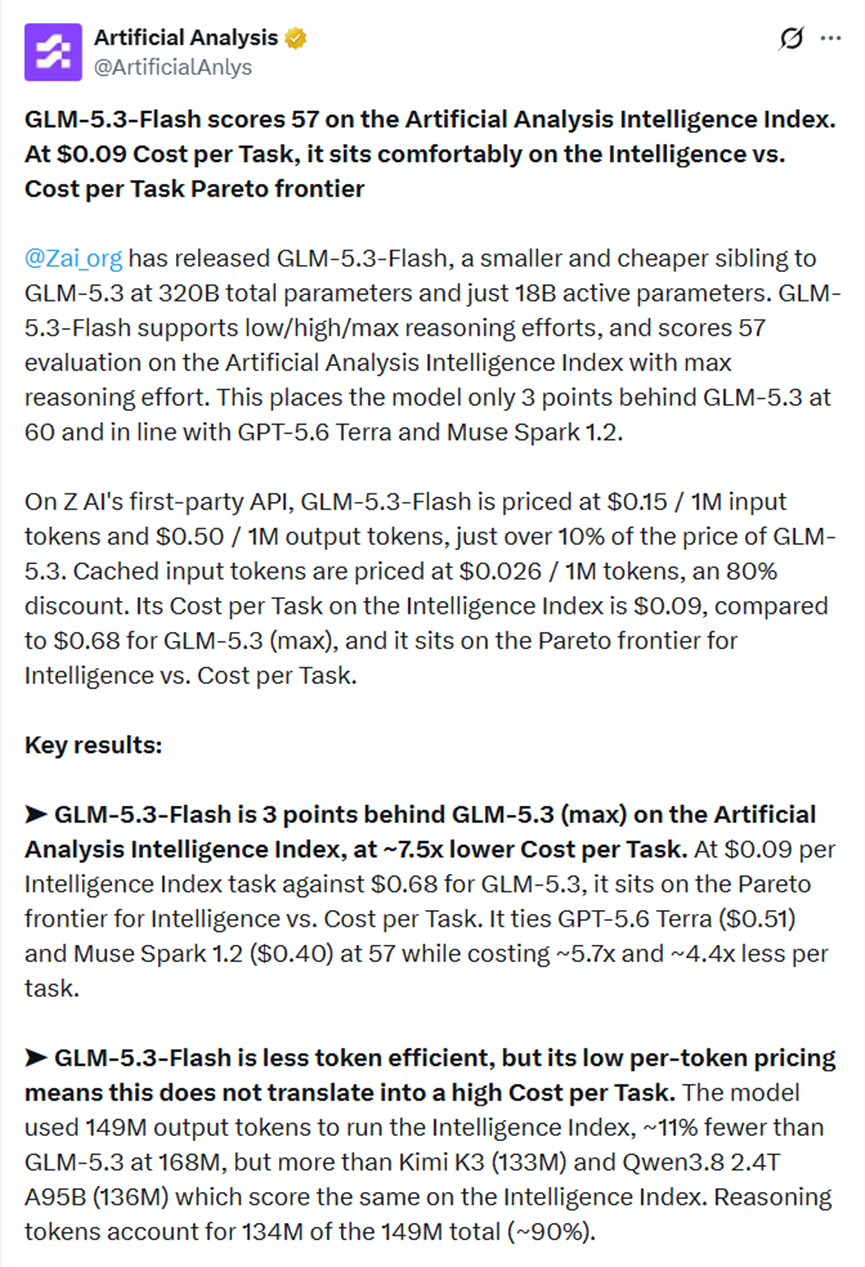
今天凌晨1点20,知名大模型分析平台Artificial Analysis对GLM-5.3-Flash进行了深度分析。
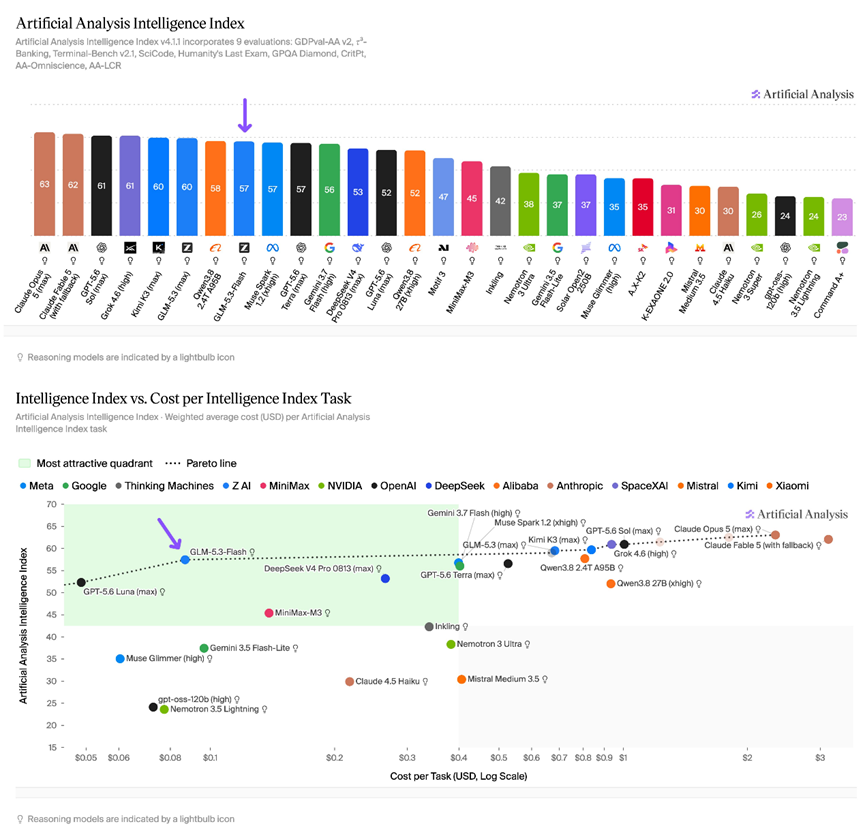
干货测试挺多的,我选重点和大家唠唠。GLM-5.3-Flash在智能指数上拿了57分,单看分数可能觉得没啥。
但把价格摆出来就有点吓人了,单任务成本只要0.09美元,换算下来六毛多钱。
六毛钱能做到什么程度?跟GPT-5.6Terra和Muse Spark1.2完全平起平坐,后两位的单任务成本分别是0.51和0.40美元,差了五倍。
跟自家大哥GLM-5.3比,分数只差3分,价格却便宜了7.5倍。
换句话说,以前你花一块钱买到的东西,现在一毛多就能拿下,性能还没怎么打折。
真实干活的表现也挺稳。智能体测试里拿的分数跟GLM-5.3和Grok4.6差不多在同一水平线上,只在一些特定场景比如银行类任务里落后约3%。
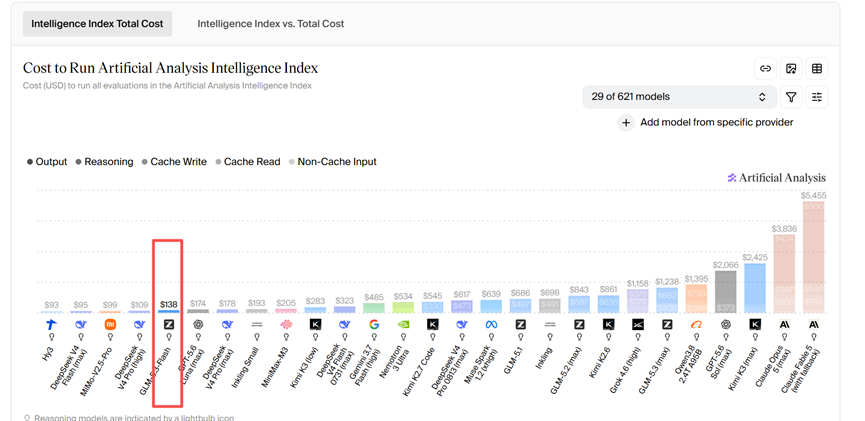
其实根据最新的AI成本排行榜也能看出来GLM-5.3-Flash强大的优势,只有DeepSeek-flash、DeepSpekV4Pro(high)、小米V2.5pro和混元3比它低一点。
此外,GLM-5.3-Flash在GDPval-AAv2上的得分为1770,高于GLM-5.3(max)的1766。
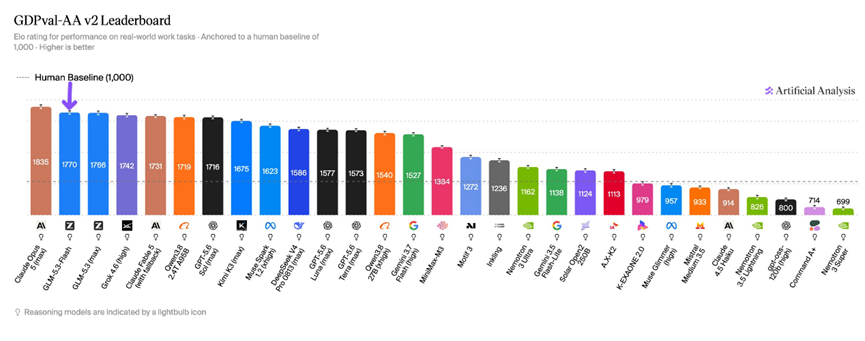
咱们在看一下性能排在GLM-5.3-Flash前面的模型都是哪些大神,2.4万亿参数的Qwen-3.8,2.8万亿参数的Kimi-K3,还有Grok-4.6,Claude-Fable-5等顶尖闭源模型。
而GLM-5.3-Flash只有3200亿参数,所以这个模型是相当能打的,属于本地能部署的最强开源大模型之一了。
GLM-5.3-Flash极致架构优化
能做到性能强还很便宜,主要是GLM-5.3-Flash对模型进行了大幅度优化。总参数是3200亿,但日常运行激活只有180亿。
对比前代GLM4.5系列,它把原本92层的网络结构精简到45层,几乎砍掉一半冗余结构,既保留了完整的思考能力,又大幅降低了运行负担,这也是低成本高效率的核心秘诀。
但让我真正觉得有意思的是架构层面的选择。这是开源前沿模型里第一个把稀疏注意力和线性注意力混合在一起用的。
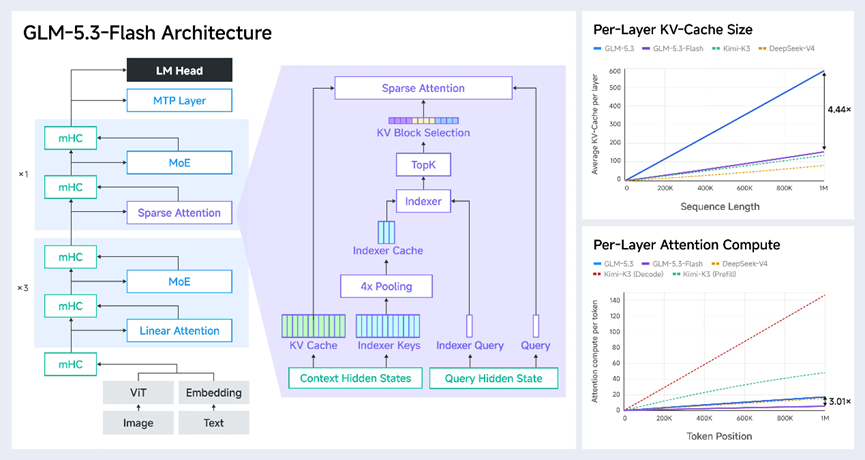
说得通俗点,传统注意力机制就像你每次翻书都要把整本书从头到尾重新扫一遍才能找到关键信息,而这套混合架构相当于给模型装了一个智能索引系统,大部分内容快速略过,只在真正重要的段落精读。
官方给的数据是,相比GLM-5.3,注意力计算量降了3倍多,缓存占用降了4倍多。对于跑AI服务的人来说,这就是实打实的成本断崖。
原生多模态适配全场景
原生多模态是GLM-5.3-Flash最大的突破之一,就是真正落地了实用的视觉多模态能力,不再是简单的看图说话。
以往很多AI的视觉功能都很鸡肋,只能识别图片文字、基础画面,没法深度联动工作场景。
但GLM-5.3-Flash的视觉能力是深度融入工作流程的,特别适配前端开发、游戏制作、三维仿真这类需要可视化输出的工作。
可以自主完成画面观察、效果校验、自我修正的完整闭环。比如我们做网页开发时,写完代码后模型能主动渲染预览效果,发现布局错乱、样式违和等问题,自主迭代优化,不用我们人工反复核对调试。
制作图表、演示文稿、可视化报表时,不仅能保证内容准确,还能兼顾画面美观度和交互体验。
这种能力延伸到了全品类办公场景,面对文档、表格、数据看板、软件界面等各类图文混合信息,都能统一解析理解。
纯国产AI芯片
我觉得这款模型值得国人骄傲的一点,就是全程基于国产AI芯片完成大规模部署运行。
以往顶级大模型大多依赖海外高端芯片,不仅成本高,还存在诸多限制,而这次智谱AI彻底突破了这个壁垒。
针对国产芯片单卡算力、内存有限的特点,团队专门定制了专属推理引擎,还巧用模型自身的智能能力辅助优化系统,形成自我迭代的良性循环。
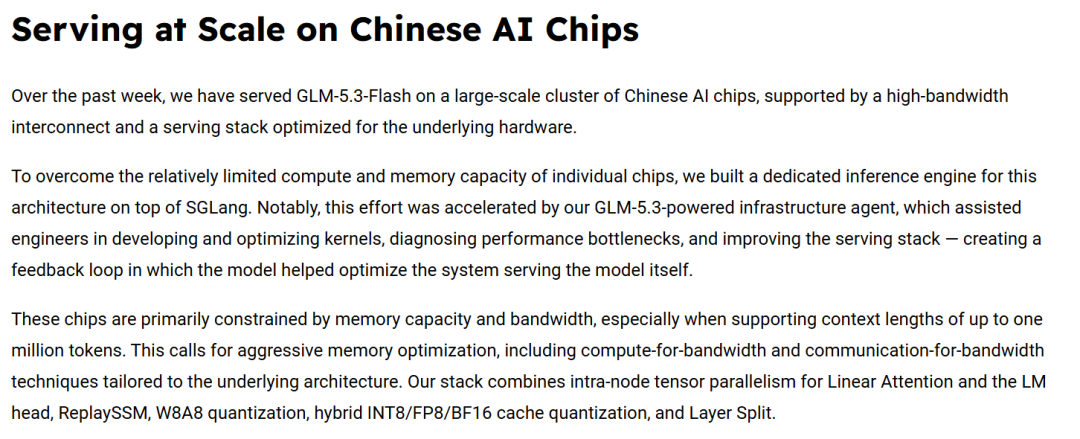
通过混合量化、结构拆分、并行计算等多项精细化优化,充分压榨硬件性能,完美适配百万级超长文本的推理需求。
集群部署层面采用了分层独立调度模式,把画面编码、文本预处理、内容生成等环节拆分独立运行,能够同时调动数万颗国产加速卡稳定工作。
优化后的整体服务性能提升3倍,硬件利用率和单字推理成本,已经追上主流海外高端显卡的水准,实实在在证明国产硬件完全能撑起顶级AI模型的规模化商用。
说点自己的感受
说实话咱们以往介绍的超强开源模型不少,但这次GLM-5.3-Flash给我的震撼还是挺大的。
不是因为跑分又涨了多少,而是让我第一次真切地感觉到,有些东西正在从根上长出来。
以前我们聊国产AI,总带着一种追赶者的焦虑,参数差多少、性能差几代、AI芯片被卡了怎么办满满的紧绷感。
但今天看着这个模型跑在纯国产芯片上,6毛钱就能干顶级模型的活,突然没那么焦虑了。不是问题都解决了,而是终于有人把路蹚出来了,而且比想象中稳。
黄仁勋提过一个概念叫“主权AI”,大意是每个大国都应该有自己的AI模型。因为只有本土开发的模型才能真正理解这片土地上的语言、文化和表达方式,同时摆脱对国外的依赖。
其实大家平时用国外模型处理中文内容,多数情况下应该能感觉到那种微妙的隔阂感,不是写错了,就是味不对。
AI大模型这条路还很长,你追我赶可能下个月就有人会超越GLM-5.3-Flash。
但今天,我们可以踏实一点了,真正做到了主权AI。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 6
 0
- 0


 已为社区贡献4条内容

所有评论(0)