YOLO乒乓球比赛落点与旋转类型目标检测数据集
YOLO乒乓球比赛落点与旋转类型目标检测数据集
低数据量条件下的 YOLO26 检测模型训练
📊 数据集基本信息
- 目标类别: [‘landing-point’, ‘negative-slope’, ‘other’, ‘positive-slope’, ‘zero-slope’]
- 中文类别:[‘落点’, ‘下旋球’, ‘其他’, ‘上旋球’, ‘平击球’]
- 训练集:61 张
- 验证集:17 张
- 测试集:9 张
- 总计:87 张
📄 data.yaml 配置信息
该数据集提供了data.yaml文件,内容如下:
train: ../train/images
val: ../valid/images
test: ../test/images

nc: 5
names: ['landing-point', 'negative-slope', 'other', 'positive-slope', 'zero-slope']
🖼️ 标注可视化
数据集下载
小郭AI日志:
https://mp.weixin.qq.com/mp/appmsgalbum?__biz=MzYzNTg4ODk4NA==&action=getalbum&album_id=4497813105477042181&scene=126#wechat_redirect @image:image.dbe2d44a14.png
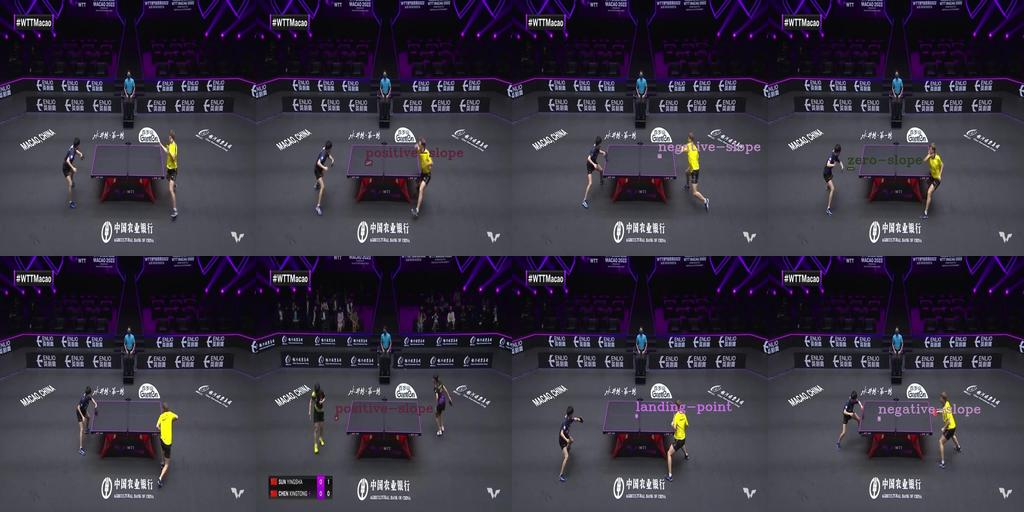
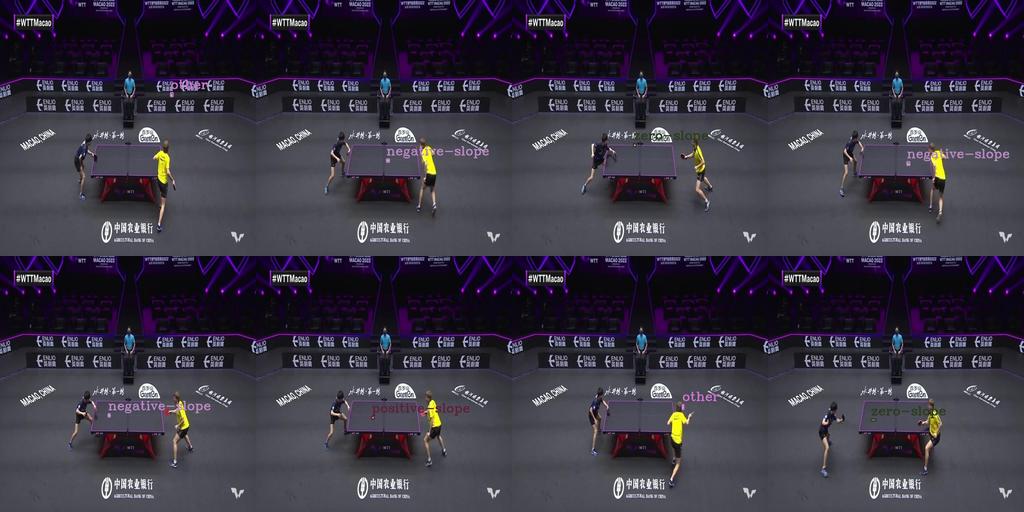
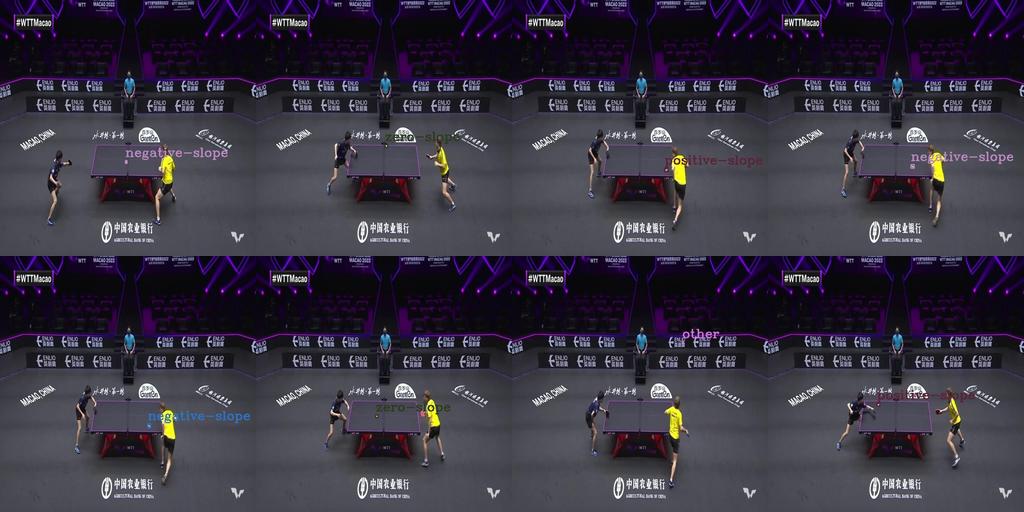
数据集详细介绍
YOLO乒乓球比赛落点与旋转类型目标检测数据集聚焦于乒乓球运动中的关键视觉特征,旨在为计算机视觉在体育赛事分析中的应用提供高质量的标注数据。该数据集名称明确指向其应用场景,即通过图像识别技术对乒乓球比赛中的球体落点位置及旋转方式进行分类和定位,适用于智能裁判系统、运动员动作分析、赛事回放辅助等场景。此类数据能够支持实时视频流中对球体轨迹和运动状态的精准识别,具有较高的实际应用价值。
数据集包含87张图片,覆盖了乒乓球比赛中常见的5种类别,包括不同旋转类型的球体以及落点区域的标记。虽然具体类别名称未完全列出,但结合其英文类别的命名逻辑可推测,可能涵盖正手、反手、上旋、下旋及侧旋等常见旋转类型,以及球落地的特定区域如台面左右半区或边线内外等。尽管数据量较小,但每张图片均经过精细标注,确保了数据的可用性与准确性,适合用于小样本目标检测任务的实验验证与模型优化。
在标注规范方面,该数据集采用了标准的YOLO格式进行标签存储,每个样本包含图像文件和对应的标签文件,标签文件中记录了目标的边界框坐标及类别标签。这种规范化的标注方式有利于直接用于YOLO系列模型的训练,提升了模型训练的效率与效果。同时,由于数据集中包含了多种旋转类型和落点信息,对于研究乒乓球运动中的动力学特征与视觉识别问题具有重要参考意义。
该数据集的典型应用方向包括体育赛事智能分析系统、运动员技战术评估工具以及教学辅助平台的开发。针对其数据规模较小的特点,建议在实际应用中结合数据增强技术提升模型泛化能力,或与其他类似数据集进行融合以扩展训练样本。此外,可进一步探索多模态数据(如视频序列、声音信号)的联合分析,以提升对乒乓球运动状态的全面理解与预测能力。
YOLO26 目标检测算法原理
从工程角度看,YOLO26 最有价值的改进就是干掉了 NMS 后处理,这对部署来说省了太多事。
端到端无 NMS 推理:传统 YOLO 模型在推理后需要执行非极大值抑制(NMS)来去除冗余检测框,这增加了后处理延迟和部署复杂度。YOLO26 默认采用一对一(one-to-one)检测头,直接输出每张图像最多 300 个检测结果 (N, 300, 6),完全省去 NMS 步骤,推理流水线大幅简化。在 CPU 上的 ONNX 推理速度相比 YOLO11n 提升高达 43%。
无 DFL 回归:YOLO26 移除了分布焦点损失(Distribution Focal Loss, DFL)结构,检测头更加轻量。边界框回归不再受限于预设的离散区间,既降低了模型复杂度又保持了同等甚至更优的回归精度。
Progressive Loss 与 STAL:训练过程中通过渐进损失(Progressive Loss)将监督信号逐步从辅助头部转移到推理阶段的主头部。小目标感知标签分配(STAL)策略特别提升小目标的正样本标签覆盖率,改善小物体检测性能。
MuSGD 混合优化器:创新性地将大语言模型常用的 Muon 优化器与 SGD 结合,实现更稳定高效的训练收敛。相比纯 SGD,MuSGD 在大 batch 训练时收敛更快且不易震荡。
模型尺度与 COCO 性能:YOLO26 提供 N/S/M/L/X 五种尺度:
| 模型 | mAP50-95 | CPU ONNX(ms) | T4 TensorRT(ms) | 参数量 |
|---|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 | 2.4M |
| YOLO26s | 48.6 | 87.2 | 2.5 | 9.5M |
| YOLO26m | 53.1 | 220.0 | 4.7 | 20.4M |
| YOLO26l | 55.0 | 286.2 | 6.2 | 24.8M |
| YOLO26x | 57.5 | 525.8 | 11.8 | 55.7M |
Nano 版本参数量仅 2.4M,CPU 推理速度比 YOLO11n 快 43%,适合边缘设备和小数据集;X 版本 mAP 达 57.5,适用于对准确率要求极高的场景。
双头架构设计:YOLO26 检测模型内置两个检测头——一对一(默认,无 NMS,输出 300 个检测框)和一对多(需 NMS,输出 8400 个候选框)。训练时一对多头作为辅助监督信号加速收敛,推理时默认使用一对一头实现端到端输出。
YOLO26 支持全部七大视觉任务:检测、实例分割、语义分割、深度估计、分类、姿态估计和定向边界框检测(OBB),一个框架覆盖从 2D 检测到 3D 感知的完整需求。
YOLO 数据增强策略
小数据集训练的关键是数据增强,YOLO 内置的这几个增强手段很实用。
Mosaic 拼接:将 4 张训练图像随机缩放后拼接为一张,大幅增加场景组合的多样性。对背景复杂、目标尺寸差异大的场景特别有效。训练最后 10 轮通过 close_mosaic=10 自动关闭 Mosaic,让模型适应真实数据分布。
MixUp 混合:两张图像按一定比例(α=0.3)线性混合,标签也按同比例混合。能平滑模型决策边界,对小数据集防过拟合效果显著。
HSV 色彩空间扰动:在 HSV 通道上对图像进行随机偏移(色相 ±0.015、饱和度 ±0.7、明度 ±0.4),模拟不同光照和色彩条件下的拍摄效果,提升模型对光照变化的鲁棒性。
几何变换:随机水平翻转(fliplr=0.5)、随机缩放(scale=0.5)、随机平移(translate=0.1),帮助模型学习位置不变性特征。
Copy-Paste 增强:将目标实例复制到另一张图像的随机位置,增加目标实例多样性。通过 copy_paste=0.3 控制概率。
增强参数配置(data.yaml 中可选覆盖):
hsv_h: 0.015
hsv_s: 0.7
hsv_v: 0.4
degrees: 0.0
translate: 0.1
scale: 0.5
shear: 0.0
perspective: 0.0
flipud: 0.0
fliplr: 0.5
mosaic: 1.0
mixup: 0.1
copy_paste: 0.1
小数据集实战调优技巧
数据不够是常态,不是例外。几十张、几百张图训目标检测模型,靠的是策略而不是蛮力。下面这些方法在小数据集上反复验证过。
1. 预训练权重选择:务必使用预训练模型,不要从零开始训练。YOLO26 提供 COCO 预训练权重,骨干网络已学会通用特征。在目标数据集上只需微调(fine-tuning),通常 50-80 轮即可收敛。
2. 冻结骨干网络:训练时冻结骨干网络前 10 层,只训练 Neck 和 Head 部分:
yolo detect train data=data.yaml model=yolo26n.pt epochs=80 freeze=5
3. 降低学习率:小数据集梯度方向波动大,使用较低学习率配合余弦衰减能让模型更平稳收敛:
yolo detect train data=data.yaml model=yolo26n.pt epochs=80 lr0=0.002 cos_lr=True
4. 更强的正则化:
weight_decay=5e-4:增大权重衰减,抑制参数过度增长dropout=0.2:分类头添加 Dropout,随机丢弃 20% 神经元label_smoothing=0.1:防止模型对训练样本过度自信
5. 验证策略:小数据集建议使用 K-Fold 交叉验证(如 5-Fold),获得更可靠的性能评估。总数据量不足 50 张时保留 1-2 折作为测试集即可。
6. 早停策略:设置较严格的早停条件(patience=30),验证指标不再改善时及时停止训练。
7. 使用轻量级模型:在 Nano 或 Small 版本上训练,参数量小(2.4M-7.6M),过拟合风险远低于 Large(24.3M)或 XLarge(41.3M)。
YOLO 系列算法演进史
从 2015 年 YOLOv1 初代论文发表算起,YOLO 系列已经走过了超过十年的演进历程。每一代都在前作的基础上解决一两个关键痛点。
YOLOv1 (2015):将检测问题建模为单一回归问题,直接在输出层预测边界框和类别概率。速度极快但定位精度较差。
YOLOv2/YOLOv3 (2016-2018):引入 anchor box 机制、特征金字塔(FPN)和多尺度训练。YOLOv3 的 Darknet-53 骨干网络成为经典架构,至今仍被广泛使用。
YOLOv5 (2020):Ultralytics 在 PyTorch 上的实现,带来了完善的训练框架、自动锚框聚类和数据增强 pipeline,大幅降低了使用门槛。
YOLOv8 (2023):统一了检测、分割、分类和关键点任务的框架,引入 C2f 模块和无锚框(anchor-free)检测头。
YOLOv9 (2024):提出 GELAN(通用高效层聚合网络)和 PGI(可编程梯度信息),同等参数量下精度提升显著。
YOLOv10/YOLOv11 (2024):YOLOv10 首次提出无 NMS 端到端检测。YOLOv11 进一步优化骨干网络和训练策略,在速度和精度之间取得新平衡。
YOLO26 (2026):集历代之大成,核心创新包括:① 端到端无 NMS 一对一检测头 ② 无 DFL 的简化回归头 ③ Progressive Loss 渐进式监督转移 ④ STAL 小目标感知标签分配 ⑤ MuSGD 混合优化器。
关键设计演进总结:
- Anchor-based → Anchor-free(v8 起)
- C3 → C2f → C3k2(骨干模块持续优化)
- 多任务统一框架(v8 起)
- NMS 后处理 → 无 NMS 端到端(v10/v26)
- 单一损失函数 → 多任务联合损失(Box + Cls + DFL,v26 可去 DFL)
部署与应用建议
小模型的部署哲学:87 张训练集训出来的模型,别追求大而全。YOLO26n 是最好的选择——2.4M 参数在目标这么少的情况下刚好够用,再大的模型只会过拟合。
导出建议:
from ultralytics import YOLO
model = YOLO("runs/detect/train/weights/best.pt")
# 推荐 ONNX Runtime(CPU)+ int8 量化
model.export(format="onnx", imgsz=416)
# 如果部署在树莓派/Jetson Nano 上
model.export(format="ncnn", imgsz=416)
精度提升路径:当前数据集规模下,指望单靠调参大幅提升精度不太现实。更实际的路线是:① 先把现有模型部署上线,收集误检漏检的案例 ② 用收集到的难例扩充训练集 ③ 在扩充后的数据集上重新训练。这个"训练→部署→收集→再训练"的循环,是小数据集场景下最有效的提升手段。
小样本训练的幸存者指南:几十张图训练目标检测模型,听起来像天方夜谭,但只要方法对头,效果完全可以接受。
有个反直觉的认知——小数据集用大尺寸输入不一定是好事。640×640 意味着每个像素的感受野要覆盖大量空间,几十张图的多样性根本填不满。建议从 320 开始,训到 loss 不降了再升到 416。这和绝大多数教程说的"越大越好"背道而驰,但在小样本场景下是我的血泪经验。
第二个要命的是学习率。默认的 0.01 对小数据集太高,梯度震荡厉害。从 0.001 起步、cos_lr 衰减,训练会平稳得多。配合 freeze=10 冻住骨干网络,参数更新量直接砍掉 70%,过拟合风险大幅降低。
第三个容易被忽略的是标签文件本身。用 LabelImg 或 CVAT 打开十几张标签,检查框是否紧贴目标、是否有重复标注。小数据集里哪怕 3-5 个标注问题,模型性能都会明显下降。这几个方向调好后,通常 60-80 轮就能收敛到一个可用的模型。
你可能还需要知道的几个细节:YOLO26 的文档很全,但有些实战经验不在文档里。
① imgsz=416 和 imgsz=640 的差异比你想象的大。416 下每张图的训练时间短大约 30%,但对小目标的召回率可能差 5 个点以上。如果你的数据集中小目标(小于 32×32 像素)占比超过 30%,建议用 512 或 640。
② AMP(自动混合精度)默认开启,但这在 GTX 16 系列等不支持 TensorCore 的 GPU 上反而拖慢训练。如果遇到训练速度异常慢,试试关掉 AMP:amp=False。
③ close_mosaic=10 意味着最后 10 轮关闭 Mosaic 数据增强。这个设置很关键——如果不关,模型始终在"拼贴图"上评估,没见过真实数据的分布,最终部署时精度会掉一大截。
④ 训练数据里有大量重复或高度相似的图片时(比如视频截帧),split='val' 自动划分可能导致训练和验证集高度相似,验证指标虚高。建议手动划分或使用按场景/时间分割的策略。
⑤ workers=8 是默认值,但如果你的硬盘是机械硬盘而非 SSD,并发读图可能会成为瓶颈。CPU 占用率满但 GPU 利用率低时,试着降低 workers 到 2-4。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献48条内容

所有评论(0)