AI 驱动的数据分析:从海量日志到智能洞察的工程实践
AI 驱动的数据分析:从海量日志到智能洞察的工程实践
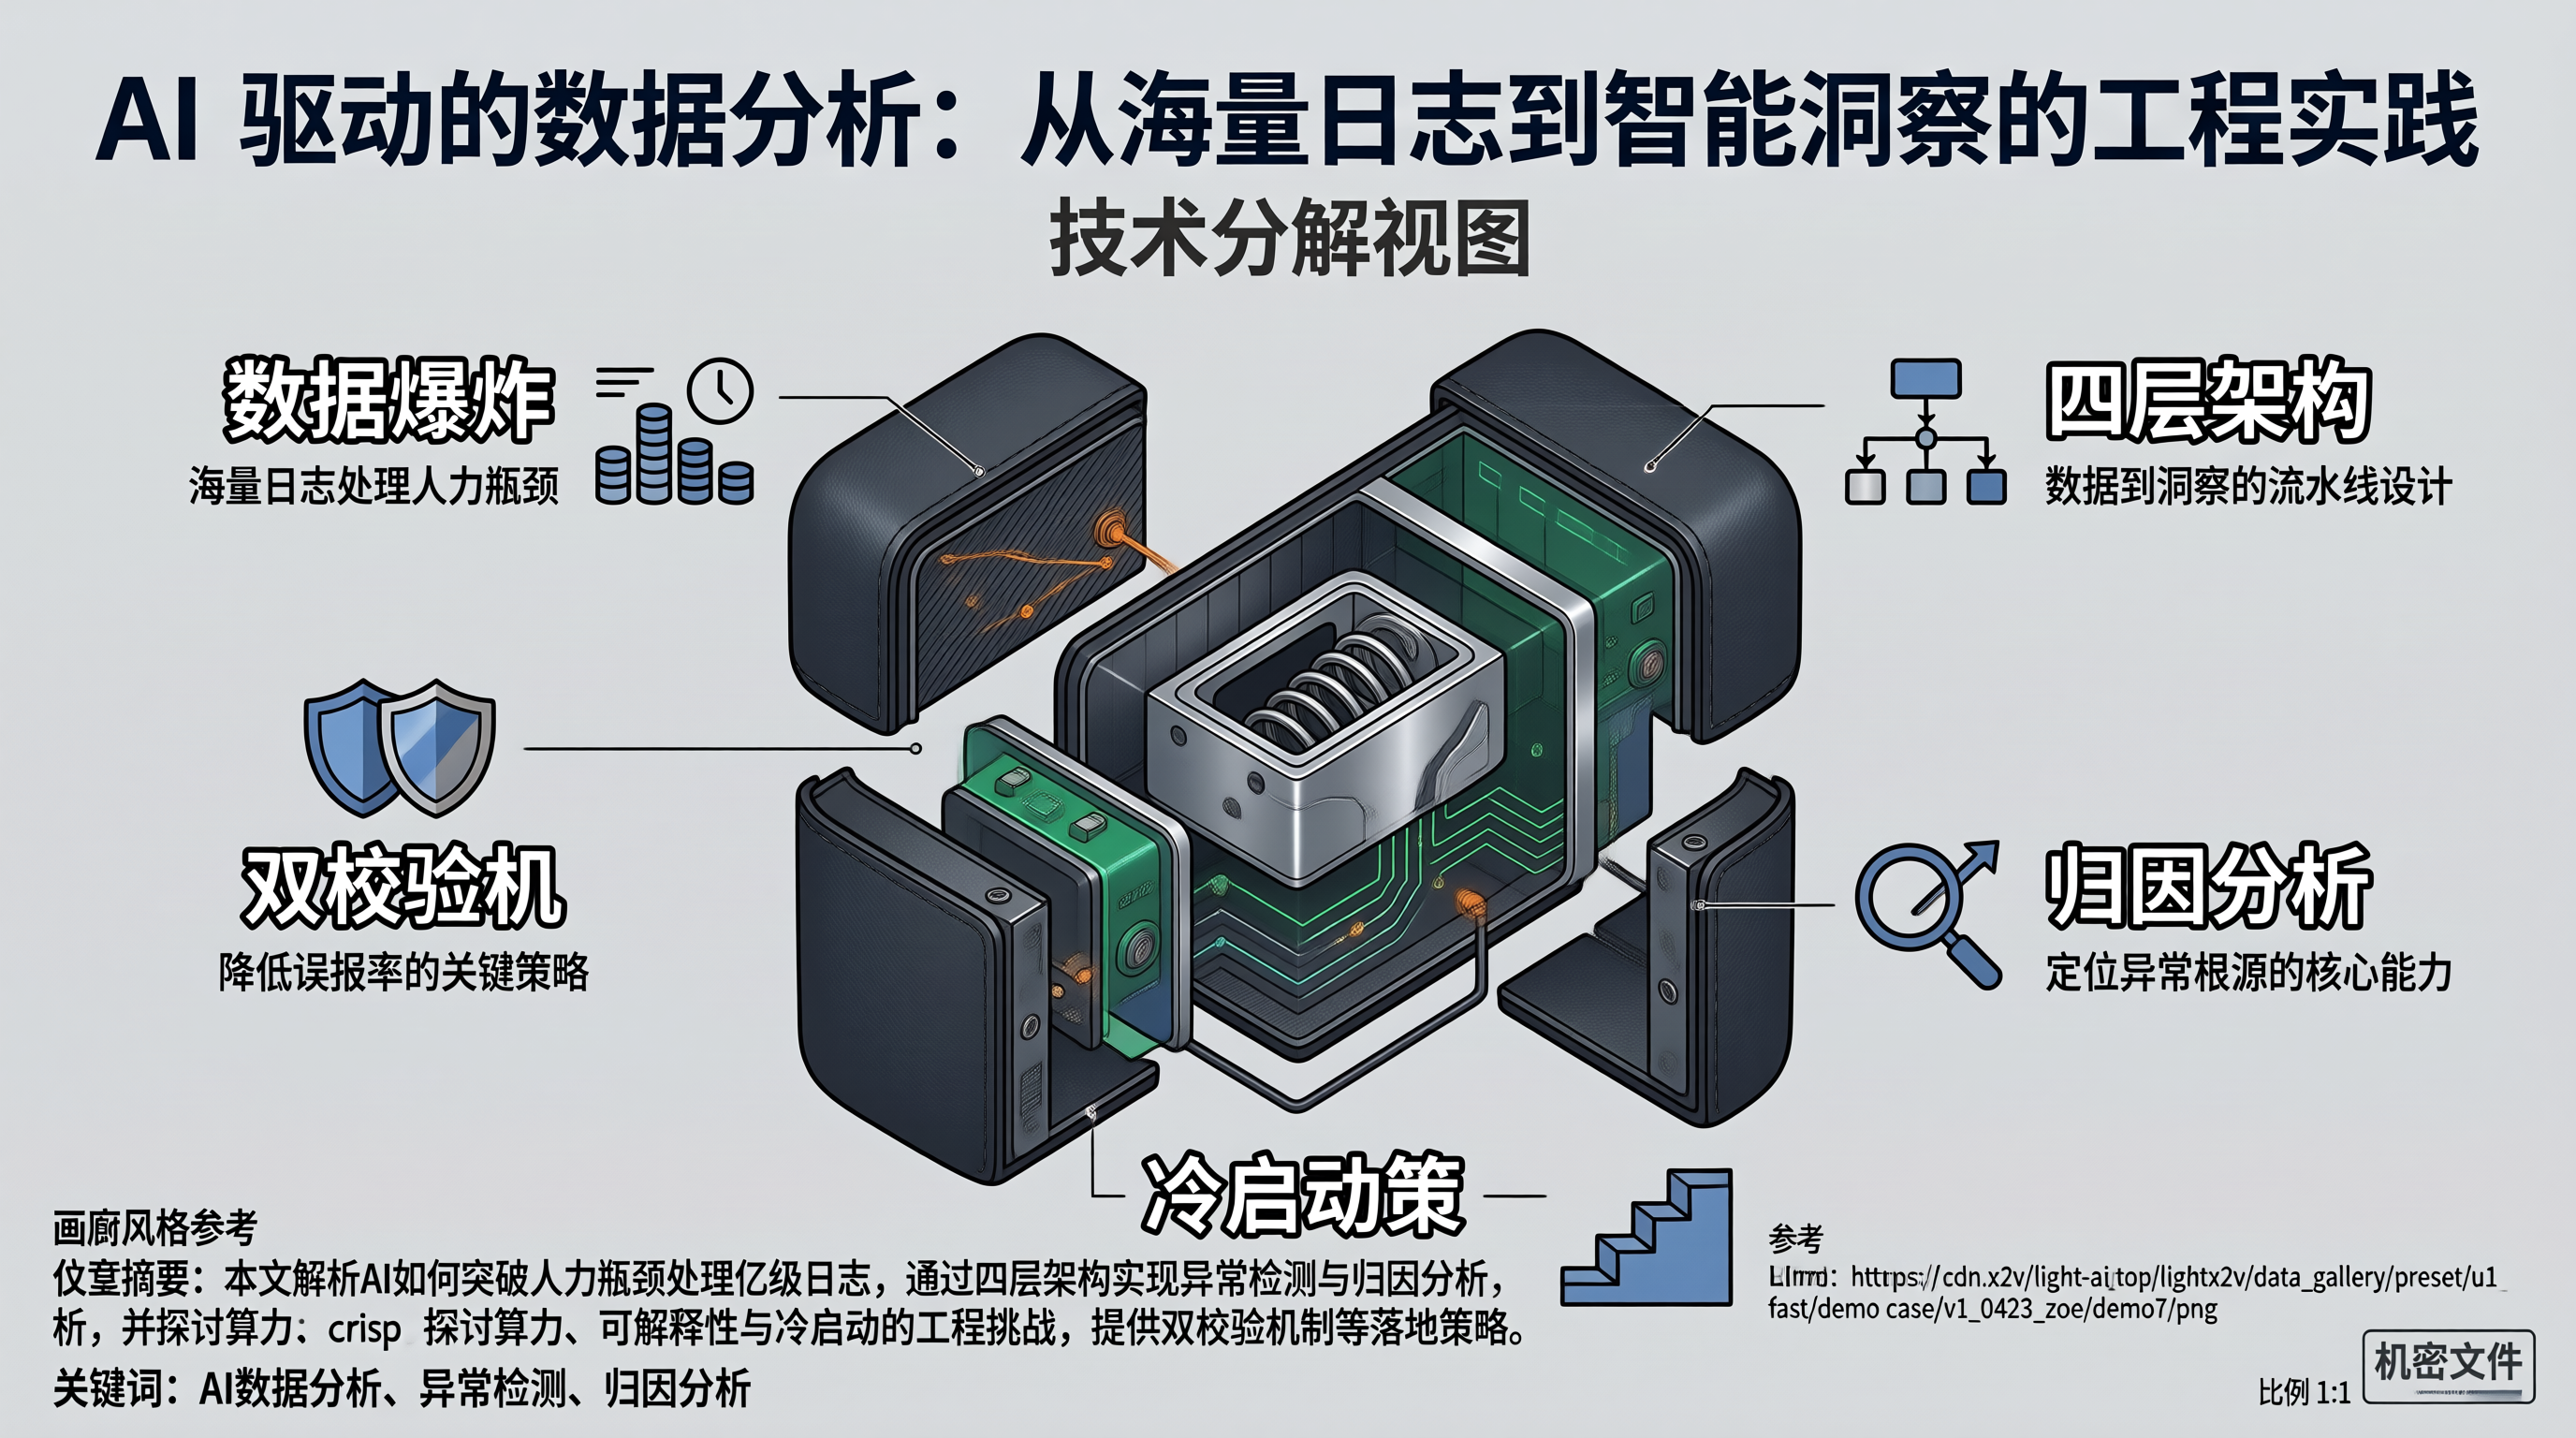
一、凌晨三点的日志与 30 分钟的决策窗口
每天凌晨三点,数据团队的服务器准时吐出超过 2 亿条用户行为日志。这些日志散落在 Kafka 的不同 Topic 里,格式各异、字段残缺、时区混乱。分析师拿到这堆数据后的标准动作通常是:先跑一轮清洗脚本,再写几十行 SQL 做聚合,最后手动拼一份 Excel 报告——整个过程至少耗时 4 小时,而业务方期望的决策窗口只有 30 分钟。
这在电商大促、金融风控、广告投放等场景中非常普遍。数据产生的速度远超人工分析能消化的极限。传统 BI 看板只能回答"发生了什么",却无法主动告诉你"为什么发生"以及"接下来会怎样"。当数据量从百万级跃迁到亿级,人工排查异常波动的效率趋近于零。
AI 数据分析的价值,在于让机器替代人工完成重复性的模式识别与异常检测,把分析师的精力释放到真正需要判断力的环节。这不是要用 AI 取代分析师,而是给分析师装上一双能穿透噪声的"透视眼"。
二、AI 分析引擎的架构拆解
理解 AI 数据分析的工作原理,先要拆解它的架构。一个典型的智能分析引擎由四层组成:数据接入层、特征工程层、模型推理层和洞察输出层。数据从原始日志流入,经过层层加工,最终以自然语言或可视化图表的形式输出可操作的洞察。
flowchart TB
    A[原始数据源] --> B[数据接入层<br/>Kafka/Flume/SDK]
    B --> C[特征工程层<br/>清洗/聚合/衍生特征]
    C --> D[模型推理层<br/>异常检测/趋势预测/归因分析]
    D --> E[洞察输出层<br/>NLG自然语言生成/可视化]
    C --> F[特征存储<br/>Redis/Feature Store]
    F --> D
    D --> G[模型注册中心<br/>MLflow/自研平台]
    G --> D

    style A fill:#e1f5fe
    style D fill:#fff3e0
    style E fill:#e8f5e9
关键机制
特征工程层是整个引擎的"消化系统"。原始日志中的时间戳需要统一到 UTC 后再按业务时区转换;用户 ID 需要跨设备做归一化映射;连续型指标(如支付金额)需要做分桶离散化。这些看似琐碎的预处理步骤,直接决定了下游模型的输入质量。垃圾进,垃圾出——这条铁律在 AI 分析中尤其残酷。
模型推理层通常不是单一模型,而是一个模型组合。异常检测用 Isolation Forest 或统计控制图(如 3-sigma 规则);趋势预测用 Prophet 或 LSTM;归因分析用 Shapley Value 或因果推断框架。不同模型各司其职,通过编排引擎串联成一条推理流水线。
洞察输出层是连接机器与人的桥梁。它需要把模型输出的概率值、特征重要度等"机器语言"翻译成业务人员能理解的结论。例如,"支付转化率下降 12%,主要归因于 iOS 端的页面加载耗时从 1.2s 升至 3.8s"——这比一堆 p-value 和 SHAP 值有用得多。
三、生产级 AI 数据分析流水线实现
下面是一个基于 Python 的智能异常检测与归因分析流水线。它从 Kafka 消费实时指标,自动检测异常并输出归因结论。
import numpy as np
import pandas as pd
from sklearn.ensemble import IsolationForest
from datetime import datetime, timedelta
import logging

# 配置日志,生产环境必须结构化输出
logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s [%(levelname)s] %(message)s'
)
logger = logging.getLogger("ai_analyzer")


class MetricAnomalyDetector:
    """指标异常检测器,基于 Isolation Forest + 统计控制图双校验"""

    def __init__(self, contamination: float = 0.02, window_size: int = 1440):
        # contamination 控制异常比例阈值,默认 2%
        # window_size 为滑动窗口大小(分钟),默认 1 天
        self.contamination = contamination
        self.window_size = window_size
        self.model = IsolationForest(
            n_estimators=200,
            contamination=contamination,
            random_state=42,
            # 开启并行加速,生产环境根据 CPU 核数调整
            n_jobs=-1
        )
        # 存储历史基线,用于统计控制图校验
        self._baseline_mean: float | None = None
        self._baseline_std: float | None = None

    def fit_baseline(self, historical_data: pd.Series) -> None:
        """用历史数据拟合基线,统计控制图需要均值和标准差"""
        if len(historical_data) < self.window_size:
            logger.warning(
                f"历史数据量 {len(historical_data)} 不足窗口大小 "
                f"{self.window_size},基线可能不稳定"
            )
        self._baseline_mean = historical_data.mean()
        self._baseline_std = historical_data.std()
        # 同步训练 Isolation Forest,让它学习正常模式
        features = self._extract_features(historical_data)
        self.model.fit(features)
        logger.info(
            f"基线拟合完成: mean={self._baseline_mean:.4f}, "
            f"std={self._baseline_std:.4f}"
        )

    def detect(self, current_values: pd.Series) -> pd.DataFrame:
        """双校验检测:IF 预测 + 3-sigma 规则,两者同时命中才判定异常"""
        features = self._extract_features(current_values)
        if_pred = self.model.predict(features)

        results = []
        for i, (val, pred) in enumerate(zip(current_values, if_pred)):
            # 统计控制图校验:超出 3 倍标准差
            sigma_flag = False
            if self._baseline_mean is not None and self._baseline_std > 0:
                z_score = abs(val - self._baseline_mean) / self._baseline_std
                sigma_flag = z_score > 3.0

            # 双校验:IF 判定异常 AND 超出 3-sigma
            is_anomaly = (pred == -1) and sigma_flag

            results.append({
                "timestamp": current_values.index[i],
                "value": val,
                "if_anomaly": pred == -1,
                "sigma_anomaly": sigma_flag,
                "confirmed_anomaly": is_anomaly
            })

        return pd.DataFrame(results)

    @staticmethod
    def _extract_features(series: pd.Series) -> np.ndarray:
        """从时序数据中提取多维特征,提升检测灵敏度"""
        values = series.values.reshape(-1, 1)
        # 这里可以扩展:滑动均值、变化率、周期特征等
        return values


class AttributionAnalyzer:
    """归因分析器:定位异常指标的贡献维度"""

    def __init__(self, dimension_cols: list[str]):
        self.dimension_cols = dimension_cols

    def attribute(
        self,
        df: pd.DataFrame,
        metric_col: str,
        baseline_period: str,
        anomaly_period: str
    ) -> pd.DataFrame:
        """
        基于贡献度分解的归因分析
        思路:计算每个维度值在基线期和异常期的指标差,
        按绝对贡献度排序,找出最大的变化来源
        """
        baseline_df = df[df["period"] == baseline_period]
        anomaly_df = df[df["period"] == anomaly_period]

        attributions = []
        for dim in self.dimension_cols:
            # 按维度值分组,计算基线期和异常期的指标总和
            base_grouped = baseline_df.groupby(dim)[metric_col].sum()
            anomaly_grouped = anomaly_df.groupby(dim)[metric_col].sum()

            # 对齐索引,缺失值填 0(维度值可能只出现在某一期)
            all_keys = base_grouped.index.union(anomaly_grouped.index)
            base_aligned = base_grouped.reindex(all_keys, fill_value=0)
            anomaly_aligned = anomaly_grouped.reindex(all_keys, fill_value=0)

            delta = anomaly_aligned - base_aligned
            total_delta = delta.sum()

            for key in all_keys:
                contribution = delta[key] / total_delta if total_delta != 0 else 0
                attributions.append({
                    "dimension": dim,
                    "dimension_value": key,
                    "baseline_value": base_aligned[key],
                    "anomaly_value": anomaly_aligned[key],
                    "delta": delta[key],
                    "contribution_pct": contribution
                })

        result = pd.DataFrame(attributions)
        # 按绝对贡献度降序排列,快速定位最大贡献维度
        result["abs_contribution"] = result["contribution_pct"].abs()
        return result.sort_values("abs_contribution", ascending=False)


# ===== 使用示例 =====
if __name__ == "__main__":
    # 模拟 7 天的分钟级指标数据
    np.random.seed(42)
    dates = pd.date_range(
        end=datetime.now(), periods=10080, freq="min"
    )
    values = np.random.normal(100, 5, len(dates))
    # 注入异常:第 5 天出现突降
    values[7200:7260] = np.random.normal(70, 3, 60)

    series = pd.Series(values, index=dates, name="conversion_rate")

    # Step 1: 用前 4 天数据拟合基线
    detector = MetricAnomalyDetector(contamination=0.01)
    detector.fit_baseline(series[:5760])

    # Step 2: 检测第 5 天数据
    result = detector.detect(series[5760:7200])
    anomalies = result[result["confirmed_anomaly"]]
    logger.info(f"检测到异常点数量: {len(anomalies)}")

    # Step 3: 归因分析(假设有维度数据)
    # attribution = AttributionAnalyzer(["platform", "channel", "region"])
    # attr_result = attribution.attribute(detail_df, "pay_amount", "baseline", "anomaly")
代码设计要点
- 双校验机制:Isolation Forest 容易对局部波动过度敏感,3-sigma 规则则对缓慢漂移不敏感。两者取交集,大幅降低误报率。
- 贡献度分解而非 SHAP:在实时归因场景中,SHAP 的计算开销过高。贡献度分解虽然精度略低,但能在秒级返回结果,满足实时性要求。
- 缺失值填 0 而非丢弃:维度值可能只出现在异常期(如新上线的渠道),填 0 能确保这类"新增维度"不被遗漏。
四、工程落地的三个坑
AI 数据分析不是银弹,它在工程落地中面临三重核心约束。
算力与延迟的矛盾。Isolation Forest 的推理速度在万级数据量下表现良好(毫秒级),但当指标维度扩展到数百个、时间粒度细化到秒级时,特征提取和模型推理的耗时急剧上升。在实时风控场景中,如果异常检测的延迟超过 500ms,预警就失去了意义。解决方案是做分层检测:先用轻量级统计规则做初筛,只有触发阈值的数据才送入 AI 模型做精排。
可解释性的缺失。Isolation Forest 能告诉你"这个点是异常的",但无法直观解释"为什么异常"。业务方需要的是可操作的归因结论,而不是一个 -1 标签。这就是为什么代码中引入了独立的 AttributionAnalyzer——用可解释的贡献度分解来弥补黑盒模型的不足。但贡献度分解本身也有局限:它假设各维度之间相互独立,忽略了维度间的交互效应。
冷启动问题。AI 模型需要足够的历史数据来学习正常模式。一个新上线的业务,前两周可能根本没有足够的基线数据。此时 Isolation Forest 的 contamination 参数无论怎么调,误报率都会居高不下。务实的做法是:在冷启动阶段降级为纯统计规则(3-sigma + 同环比),等数据积累到至少一个完整周期后再切换到 AI 模型。
此外,数据质量是所有 AI 分析的地基。如果上游的日志采集存在延迟或丢失,模型再精巧也无法产出可靠结论。在投入 AI 分析之前,先确保数据管道的 SLA 达标——这比调参重要一百倍。
五、落地建议
AI 数据分析的工程落地,核心在于三个关键决策:
第一,检测策略要务实。双校验机制(统计规则 + AI 模型)比单一模型更可靠,误报率的降低直接决定了业务方对系统的信任度。
第二,归因能力比检测能力更重要。发现异常只是起点,定位原因才是终点。贡献度分解在实时性和可解释性之间取得了较好的平衡,但要注意维度独立性的假设局限。
第三,冷启动阶段不要强行上 AI。先用统计规则跑通流程,等数据积累充分后再逐步引入模型,这是工程上最稳妥的路径。
落地路线建议:从单一核心指标(如支付转化率)的异常检测切入,验证双校验机制的有效性;稳定运行后扩展到多指标联动检测;最后引入归因分析,形成"检测-归因-推送"的闭环。每一步都要有明确的业务验收标准,而不是追求技术上的"全覆盖"。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 12
 0
- 0


 已为社区贡献13条内容

所有评论(0)