使用新数据集评估YOLO变体在SAR图像小目标检测中的有效性
点击蓝字
关注我们
关注并星标
从此不迷路
计算机视觉研究院

公众号ID|计算机视觉研究院
学习群|扫码在主页获取加入方式
https://pmc.ncbi.nlm.nih.gov/articles/PMC12749477/pdf/41598_2025_Article_28755.pdf
计算机视觉研究院专栏
Column of Computer Vision Institute
由于专用数据集的可获得性有限,SAR图像中的小目标检测仍然具有挑战性。
PART/1
概述
本文提出了一个新的、专为小目标检测设计的SAR数据集。鉴于目前缺少公开可用的、专门用于卫星雷达图像车辆检测的数据集,我们利用Capella和ICEYE图像构建了一个包含23,644个手动标注车辆的自定义数据集。同时,本文还给出了三种YOLO架构(版本7、8和12)在雷达图像小车辆检测任务上的广泛对比分析结果。研究还考虑了图像滤波对检测效果的影响。实验结果为专门针对合成孔径雷达(SAR)图像小目标检测的YOLO架构微调提供了新的见解。此外,研究中还使用了SIVED(用于车辆检测的SAR图像数据集)数据集(高分辨率机载图像)。模型性能在多种配置下以及使用Lee、Frost和GammaMAP滤波器的情况下进行了测试。同时,对模型稳定性进行了详细分析。实验结果表明,所测试模型之间的性能存在显著差异。YOLOv8模型在SIVED数据集上取得了最高的检测性能,在未滤波情况下的F1分数为0.958,mAP@[0.5:0.95]为0.838,并且对阈值参数变化具有较高的稳定性。YOLOv12模型在经过Lee滤波后表现最佳(F1分数=0.951,mAP@[0.5:0.95]=0.774),表明其对输入数据质量更为敏感。相反,YOLOv7模型对置信度阈值的变化表现出高度敏感性,因此需要精确的参数调优。所开展的研究表明,尽管YOLOv8未引入先进的自注意力机制,但在卫星雷达图像样本上仍能取得更优的检测性能。本文的工作为雷达图像中的自动目标检测做出了重要贡献,并为根据SAR数据特性选择和配置YOLO模型提供了实用指导。
PART/2
背景
合成孔径雷达(SAR)领域的技术进步导致高分辨率图像数量迅速增加。对这类数据的人工分析正变得越来越低效且容易出错。因此,人们对用于处理和分析SAR数据的现代自动化方法的需求不断增长,尤其是在目标检测与识别方面。
SAR系统已广泛应用于民用领域,例如关键基础设施监测、城市区域观测、自然灾害检测(洪水、地震和滑坡)以及海上交通监视。数据质量取决于天线尺寸、合成孔径长度等技术参数,也取决于所使用的信号处理算法(距离多普勒、ChirpScaling、Omega-K、SPECAN等)。
近年来,商业领域发展迅速——ICEYE、CapellaSpace、Umbra和Synspective等公司正在稳步扩展其SAR卫星星座。因此,雷达数据的获取频率不断提高,其分辨率和质量也在系统地改善。
在雷达成像的背景下,小目标检测是一项重大研究挑战。如MSCOCO等标准基准所定义的,小目标通常指占用少于32×32像素或不到图像尺寸10%的目标,这类目标特别难以检测。
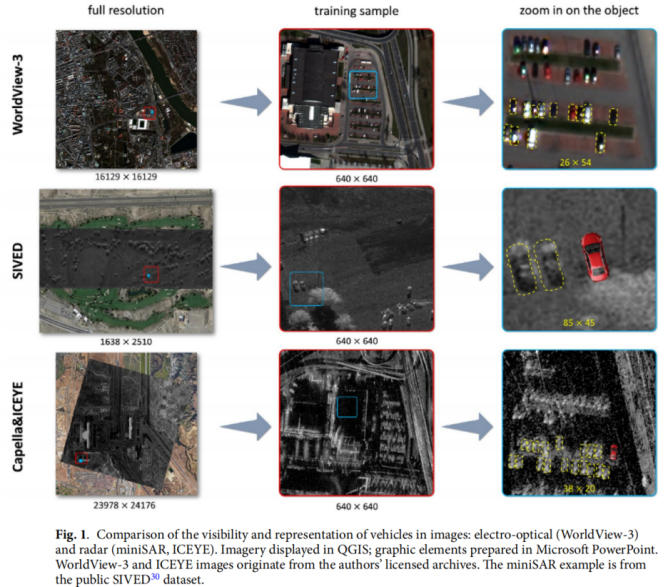
图1说明了在不同类型的图像数据中,尤其是SAR雷达图像中,小目标检测所面临的挑战规模。第一列展示源图像:WorldView-3获取的光学场景、miniSAR系统的机载SAR场景(如SIVED数据集中的场景),以及ICEYE卫星获取的星载SAR图像。第二列显示用于训练的640×640像素样本裁剪图,通常用于YOLO等检测模型。第三列显示这些数据中单个车辆的放大图。目标表示的差异显而易见:在光学图像中,一辆乘用车仅占26×54像素,尽管尺寸有限,但仍可以识别物体的形状和上下文。而在雷达数据中,目标的特征包含的信息要少得多——SIVED数据集中的车辆占85×45像素,而在高分辨率星载SAR数据中仅占38×20像素,这大大限制了准确解释和区分目标的可能性。
值得注意的是,EO光学数据(例如来自DOTA数据集的数据)相比雷达图像更容易判读,尤其是来自星载SAR系统的雷达图像。
PART/3
新算法框架解析
合成孔径雷达(SAR)图像中的目标检测在过去几十年中得到了广泛研究。尽管技术不断进步,但这一过程仍然面临重大挑战——其中最主要的是相干雷达系统特有的噪声。
相干斑噪声对目标检测的影响
如前所述,相干斑噪声是SAR图像分析中的主要障碍之一。它源于成像的相干特性:单个分辨单元内众多随机分布散射体反射的电磁波相互干涉,从而产生SAR图像特有的颗粒状外观。与加性噪声不同,相干斑是乘性且非线性的,因此在不牺牲重要几何和结构特征的前提下难以有效滤除。
许多经典的相干斑抑制方法基于自适应统计滤波器,例如Lee、Frost或Gamma-MAP滤波器,它们利用局部强度统计特性。这些滤波器能够提高信噪比,但在许多情况下会过度平滑图像并模糊关键边缘,从而降低小目标检测的精度。相比之下,Hasnaouy和Kasapoglu在特征提取之前引入了一种平均滤波器,并研究了其对SAR自动目标识别(ATR)分类精度的影响。滤波后,RBF-SVM分类器的准确率从97.69%提升至98.43%。研究人员指出,降低相干斑噪声对目标识别精度具有显著影响。Huang等人提出了一种名为相干降低斑噪声(CRSN)的创新算法,该算法利用了SAR成像的相干特性。Wang等人使用了一个包含五个卷积层和ReLU激活函数的卷积神经网络(CNN),并去除池化层以保留特征图的原始尺寸。Kwak等人提出了另一种基于CNN的方法,他们设计的模型包含一个正则化项,用于平衡从原始图像和滤波后图像中提取的特征,从而即使在高噪声数据中也能保留重要的目标信息。Huang等人提出了一种完全不同的方法,他们开发了联合低秩和稀疏多视图去噪(JLSMD)方法,将低秩和稀疏建模与多视图分析相结合。JLSMD能够在有效抑制相干斑噪声的同时保留关键目标特征。作者证明,将JLSMD与基于稀疏表示的分类器(SRC)结合使用,比传统滤波方法能取得更好的结果。Chen等人提出了一种基于低秩和空间-角度连续性的方法。
基于卷积神经网络(CNN)的雷达图像目标检测
目前,使用卷积神经网络(CNN)进行雷达图像目标检测是ATR研究的核心方向之一。这些框架通常分为两类:两阶段检测器和单阶段检测器。
两阶段架构(如FasterR-CNN)首先生成区域提议(RegionProposalNetwork),然后对边界框进行分类和回归。这类模型的特点是精度高,尤其在小目标检测方面表现出色,但计算量较大。通过锚点调整、难负样本挖掘以及针对SAR数据特性的适配(例如DAPN),它们在SAR应用中的性能得到了进一步提升。研究过程中,科学家们发现,当标注数据有限时,使用在大型光学数据集(如ImageNet)上预训练的模型进行迁移学习,是将CNN适配到SAR数据的关键步骤。从光学图像中学习到的预估计网络权重比随机初始化提供了更好的起点,从而提高检测精度并缩短训练时间。这些研究的另一个结论是,锚点调整和难负样本挖掘对小目标和密集目标的检测具有积极影响。
第二类是单阶段模型,近年来其性能开始超越两阶段方法。最具代表性的包括YOLO、SSD、RetinaNet和CornerNet。这些模型在单个步骤中同时预测目标类别和位置(同时检测边界框并进行分类),从而显著减少预测时间。通过注意力机制(例如YOLO中的应用)、多尺度特征融合(例如SSD中的FPN)以及无锚点方法(例如CornerNet)等技术,这些模型能够有效应对SAR图像中的典型挑战,如相干斑噪声和目标方向变化。最新的实现方案在实时运行的同时达到了超过90%的精度。采用特征金字塔网络(FPN)的架构(类似于SSD)以及针对SAR目标的自适应锚点,在每秒111帧的速度下实现了94.13%的精度。
小目标检测
在SAR图像中检测小目标仍然是基于AI的目标检测领域中最大的挑战之一。目标尺寸小、图像分辨率低以及相干斑噪声的存在,意味着小目标通常仅由少数几个像素表示。因此,尽管卷积神经网络(CNN)在传统计算机视觉任务中表现出色,但在可靠检测此类目标时往往面临困难。
文献中已经提出了多种用于SAR图像小目标检测的方法。Zhang等人¹⁷证明,诸如多视处理和MUSIC算法等质量增强技术能够显著提高分辨率并抑制背景,将虚警数量减少三倍以上。另一方面,Xu等人提出了一种基于Alpha稳定分布的改进CFAR算法,该算法在处理高度非均匀杂波方面优于传统的高斯和K-CFAR方法。在深度学习领域,Chen等人对特征金字塔网络(FPN)进行了改进,应用基于形状相似度的k-means算法对参考框进行聚类。该方法在港口环境中实现了超过98%的检测率。
同时,Ge等人对YOLOv7进行了改进——在主干网络中引入坐标注意力(CA),并将PANet替换为BiFPN结构以进行多尺度特征提取——从而提高对浅层信息的利用并提升检测精度。与标准YOLOv7相比,这些改进使精度提升了3.82%。Sun等人提出了一种轻量级FFCLC网络,整合了用于特征融合的注意力机制、深度可分离卷积(DWConv)以及多尺度检测。该模型在SSDD数据集上进行了测试,实现了超过97%的平均精度均值(mAP)。
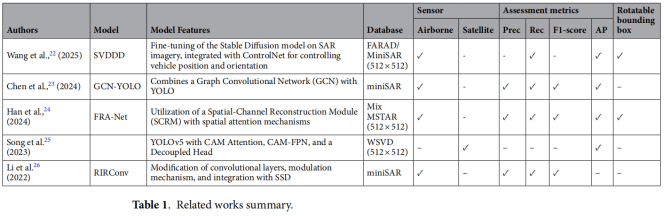
表1总结并比较了所提出的解决方案。对这些研究的分析表明,大多数研究依赖于机载数据(例如miniSAR、MSTAR)。只有一项解决方案使用了星载图像;遗憾的是,该研究中使用的数据集并未公开。评估策略差异很大——尽管平均精度(AP)仍然是最常用的指标,但只有部分作者包含了诸如精确率(Prec)、召回率(Rec)和F1分数等额外指标,这些指标能够更全面地评估检测性能。此外,我们的分析显示,近年来的研究中出现了越来越多使用可旋转边界框的趋势。
用于小型车辆检测的数据集
随着地球观测系统的快速发展以及雷达卫星数量的不断增加,SAR数据的可获得性正在稳步提升。因此,近年来用于检测和分类等任务的公开SAR数据集显著增多。新的数据集通常包含来自多种传感器和频段的高分辨率图像。表2概述了适用于雷达图像中车辆检测和分类的数据集。
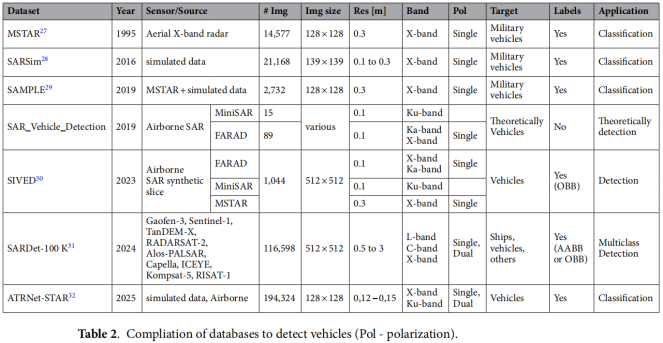
随着地球观测系统的快速发展以及雷达卫星数量的不断增加,SAR数据的可获得性正在稳步提升。因此,近年来用于检测和分类任务的公开SAR数据集显著增多。新的数据集通常包含来自多种传感器和频段的高分辨率图像。表2概述了适用于雷达图像中车辆检测和分类的数据集。
在车辆分类领域,已有三十年历史的MSTAR数据集(包含超过14,000幅X波段雷达图像)仍然是一个关键基准。然而,由于其在类别多样性和成像场景方面的局限性,研究人员开发了更新的替代方案,例如SARSim和SAMPLE,它们结合了合成数据和混合数据。为了满足对更大规模和更高真实性数据的需求,ATRNet-SAR数据集于2025年初发布,包含超过190,000幅雷达图像,描绘了具有不同地形、观测角度和采集模式的真实场景。该数据集不仅规模庞大,而且类别覆盖范围更广,包含从小型乘用车(MiniCar)到工程车辆(ShovelLoader)在内的40种车辆类型。相比之下,MSTAR仅包含10个类别。凭借其丰富的几何和语义信息,ATRNet-SAR有望成为SAR图像车辆分类的新研究标准,支持对场景和成像条件变化具有鲁棒性的模型开发。
构建用于SAR图像车辆检测的数据集比分类数据集更加耗时和困难,主要原因是需要精确的空间标注。2023年发布的SIVED数据集是一项重要进展——它是首个提供有向边界框(OBB)标注的公开SAR数据集。该数据集整合了来自MiniSAR、FARAD和MSTAR的图像。在较新的成果中,SARDet-100K也值得关注——这是一个大规模数据集,包含超过100,000幅来自高分三号、Capella、ICEYE和Sentinel-1等雷达卫星的图像。其传感器、空间分辨率(0.5至3m)和极化模式(单极化和双极化)的多样性,使训练对不同成像条件具有鲁棒性的检测模型成为可能。
然而,需要注意的是,SARDet-100K包含多种目标类别——不仅包括车辆和船舶,还包括桥梁、机场和港口等基础设施。另一个稍早的数据集是SAR_Vehicle_Detection,它提供了来自MiniSAR和FARAD系统(Ku、Ka和X波段)的数据,但缺乏定位标注,限制了其实际应用价值。
总体来看,大多数数据集来自机载平台或合成来源。虽然一些项目(如SARDet-100K)包含卫星数据,但它们通常是包含多种目标类别的通用数据集。对于检测乘用车等小目标的任务,SARDet-100K可以作为更专业数据集的补充资源;然而,由于目标尺度变化较大,其单独使用可能受到限制。
研究动机
正如我们的文献综述所示,在SAR图像中检测车辆等小目标仍然是一项重大挑战。尽管已经提出了许多方法,包括注意力机制、多尺度特征融合和锚点优化,但目前仍缺乏对现代YOLO系列模型在SAR数据上性能的系统评估。
YOLO(YouOnlyLookOnce)系列模型因其速度快、文档丰富、实现方式多样以及持续更新而被广泛使用。文献研究也表明,YOLO在检测精度和计算效率方面均优于常用的两阶段解决方案(如FasterR-CNN和Detectron2)。在本研究中,我们重点关注三个版本:
•YOLOv7–基于锚点的目标检测模型,
•YOLOv8–无锚点结构,采用解耦头,
•YOLOv12–最新版本,融合了R-ELAN和FlashAttention机制。
尽管文献中的研究人员最常关注对YOLO各版本的性能评估,并提出各种改进方法以提升其性能³⁶,³⁷,但在我们的实验中,我们着重于对不同超参数配置进行系统分析。所引入的修改旨在充分发挥每个模型的潜力,并确定在SAR图像车辆检测任务中最有效的配置。我们的研究旨在回答以下关键问题:
•YOLO模型能否有效应用于SAR数据中的小目标检测?
•机载SAR图像与星载SAR图像之间的检测性能差异如何?
•相干斑噪声滤波是否能提高检测精度?
•FlashAttention(如YOLOv12中所使用的)是否能改善小目标检测?
•哪些指标和评估策略最适合基于SAR的检测任务?
SIVED
为了将我们的结果与文献中报道的结果进行比较,我们使用了SIVED(用于车辆检测的SAR图像数据集),该数据集在数据特征方面是最接近的公开参考之一。它包含1044个图像块,来源于三个不同平台:FARAD(Ka/X波段)、MiniSAR(Ku波段)和MSTAR(X波段)。这些图像同样具有非常高的空间分辨率,范围从0.1m(FARAD、MiniSAR)到0.3m(MSTAR)。
SIVED包含12013个带标注的车辆,使用有向边界框(OBB)进行标注,与传统的轴对齐边界框(AABB)不同,OBB能够更精确地表示目标的方向和几何形状。该数据集分为三部分:训练集(837幅图像,9561辆车)、验证集(104幅图像,1222辆车)和测试集(103幅图像,1230辆车)。由于其高质量的标注和真实城市场景的存在,SIVED被广泛用作旋转感知目标检测研究中的基准数据集。在我们的工作中,我们将该数据集作为参考,并将有向边界框转换为标准矩形格式(AABB),以便在YOLO等传统检测模型中使用。该数据集的详细特征,包括年份、传感器/来源、图像数量、图像尺寸、空间分辨率、光谱波段、极化方式、目标类型和标注格式,总结在表2中。
在我们的实验中,我们使用了YOLO模型的三个版本——v7、v8和v12。这些模型具有多样化的架构设计,能够深入分析特定组件在SAR图像这一具有挑战性的场景中,对小目标检测性能的影响。表3详细对比了它们的特征。
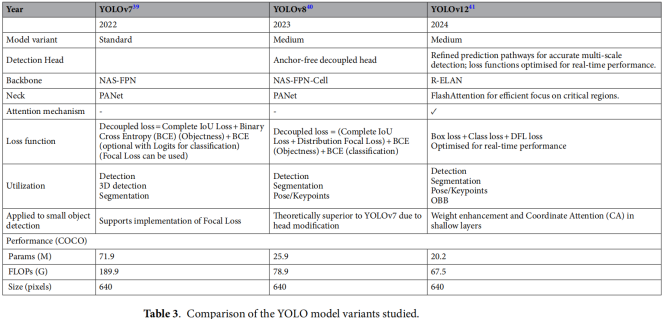
YOLOv7因其开源架构和出色的性能在研究界获得了广泛关注,非常适合进行适配与修改,尤其适用于小目标检测任务。YOLOv8引入了显著改进,它摒弃了锚点机制,转而采用无锚点方法,旨在更好地检测不规则或非标准形状的目标。它还采用了解耦头结构——将分类和回归分支分离——从而提升了定位精度并减少了小目标的误检。YOLOv12作为最新版本,集成了先进的改进,包括自注意力机制(如BiFormerAttention)、用于特征融合的增强型颈部模块,以及包含分布焦点损失(DistributionFocalLoss)和SoftNMS的现代损失函数。这些改进有助于检测紧密排列或部分遮挡的目标,这一点对于SAR图像中密集分布的车辆尤为重要。
这三个版本的纳入使得我们能够进行代际比较:从经典的基于锚点检测(YOLOv7),到无锚点建模(YOLOv8),再到融合注意力机制且经过优化调优的模型(YOLOv12)。这种全面的评估可以系统性地分析架构改进如何影响SAR数据中的小目标检测性能。
为了进一步提升SAR图像中的车辆检测性能,我们针对YOLOv7、YOLOv8和YOLOv12优化了部分超参数。默认配置并非专门针对小目标检测的挑战设计,尤其在几何复杂度高、对比度低的数据中,可能会限制模型的有效性。
我们定义了四种超参数配置变体:默认设置(YOLOv7,版本0)和三种改进版本(1-3),每种版本都旨在更好地适配小目标检测场景。
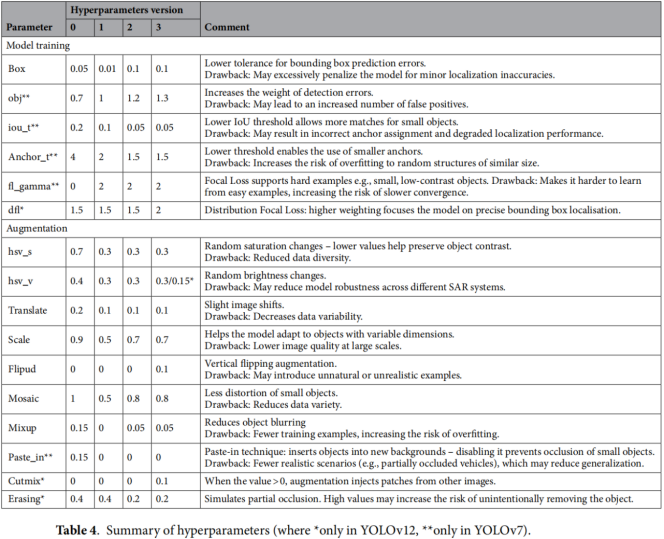
考虑到SAR数据的特性——尤其是相干斑噪声的存在(如相关工作部分所述)——我们还研究了去噪对检测质量的影响。为此,我们应用了常用的自适应滤波器,这类滤波器通过两阶段过程工作:首先,通过评估局部邻域的亮度方差识别边缘像素。高方差通常表示边缘区域,这对定义目标边界至关重要。
在第二阶段,使用平均滤波器对非边缘区域进行平滑处理。这一步的效果很大程度上取决于选择合适的窗口尺寸:在高变异性区域使用较小的窗口,在均匀区域使用较大的窗口以提高处理效率。然而,由于窗口尺寸通常在整个图像中是固定的,这可能导致异质区域的细节丢失。在SAR图像处理中最常用的自适应滤波器包括Lee滤波器、Gamma-MAP滤波器和Frost滤波器。
PART/4
实验及可视化
硬件说明
本研究将在一个专用于深度学习任务的高性能计算平台上开展。计算环境包含一颗英特尔®至强®金牌6348处理器(2.60GHz)和128GB内存,可高效处理大型数据集和内存密集型运算。该平台的核心组件是一块配备80GB显存的NVIDIAA100GPU,我们将使用CUDA12.4和深度神经网络库(CUDNN)8.8.1来加速模型训练。
实验流程
本研究使用了两个SAR数据集:SIVED和Capella&ICEYE,对二者采用了相同的研究方法。基于SIVED数据集的实验流程如图3所示。
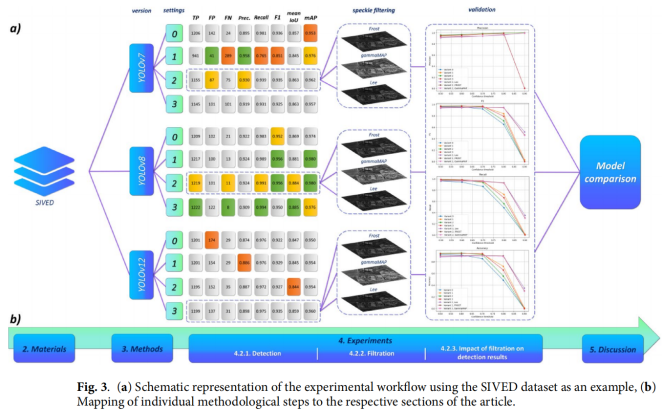
在研究的第一阶段,我们测试了YOLOv7、YOLOv8和YOLOv12模型的多种超参数配置(见方法部分)。通过分析检测结果,我们为每种架构选择了性能最优的配置(见4.3.1节)。
在接下来的阶段,我们考察了传统相干斑噪声抑制滤波器(Frost、GammaMAP、Lee)的应用是否会影响小目标的检测质量(见4.3.2节)。随后,我们在不同置信度阈值下对训练好的模型进行了定性评估(见4.3.3节)。在第5节中,我们对得到的结果进行了详细讨论。
检测结果
为评估车辆检测模型的有效性,我们对YOLOv7、v8和v12三种架构进行了对比研究,采用了多种训练变体。分析涵盖了机载数据(来自SIVED数据集)和星载图像,能够全面评估模型在不同条件下的性能(见表6和表7)。
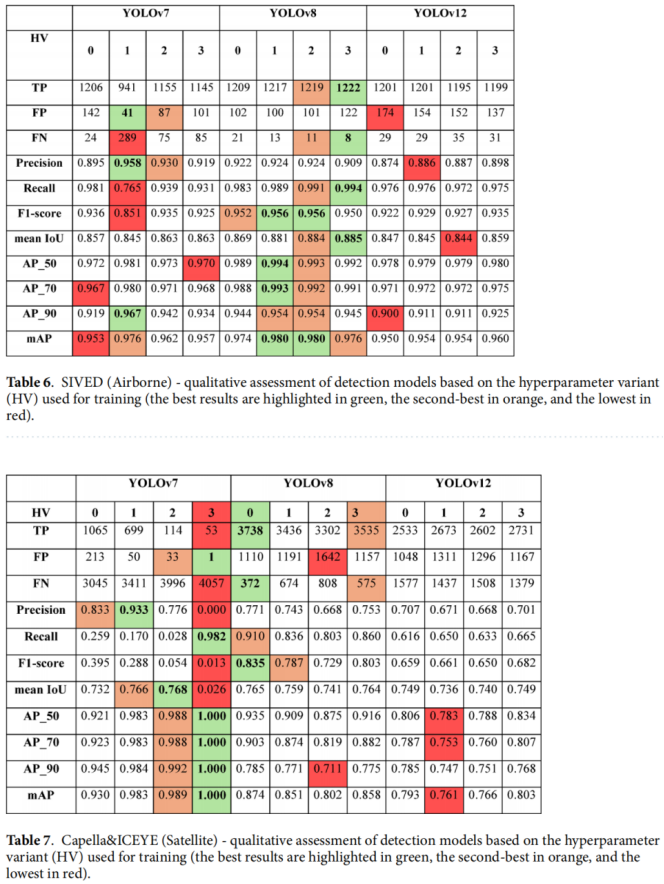
YOLOv12同样表现出强劲性能。在变体4上取得了最佳结果(mAP=0.960,AP₉₀=0.925),所有变体的F1分数范围为0.922至0.935。尽管该模型表现有效,但并未超越YOLOv8。不过,与YOLOv7相比,它对超参数变化的鲁棒性更强。
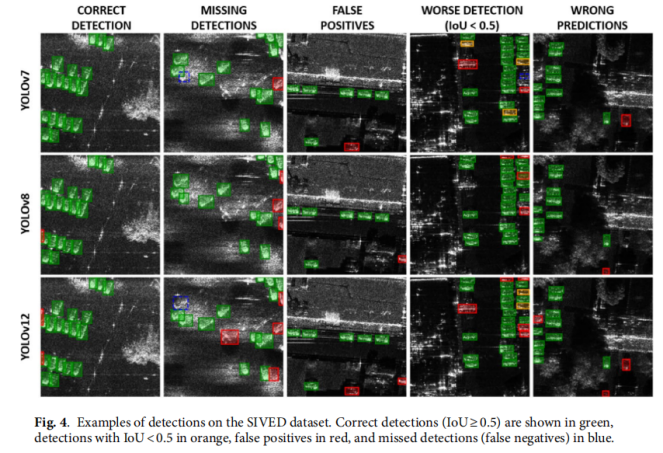
YOLOv7对训练变体表现出显著的敏感性。在变体1中性能最差(召回率=0.765,F1=0.851),而在变体2中性能最佳(mAP=0.972,F1=0.935)。图4展示了使用不同YOLO模型进行车辆检测的示例。
在研究的第二部分,我们在更具挑战性的条件下评估了检测质量——具体而言,是车辆像素占比显著更小的卫星图像。实验结果证实,YOLOv8仍然是小目标检测最有效的模型,在F1、mAP和AP₉₀上均取得了最高分数。值得注意的是,它在所有训练变体中都保持了稳定的性能,进一步印证了其对此类任务的适用性。
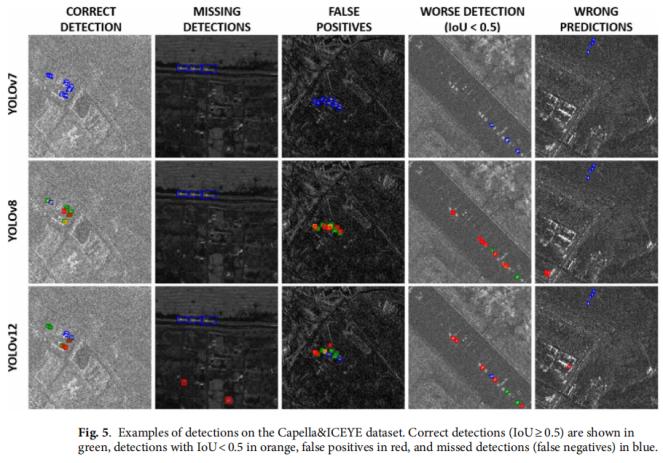
YOLOv12也表现出良好的稳定性,但其较低的召回率意味着更高的漏检率。YOLOv7尽管在机载数据上取得了不错的结果,但在卫星图像上表现不佳。其有限的敏感性和对特定超参数配置的强烈依赖,使其不适用于星载SAR图像中的小目标检测。图5展示了使用不同YOLO模型进行车辆检测的示例。
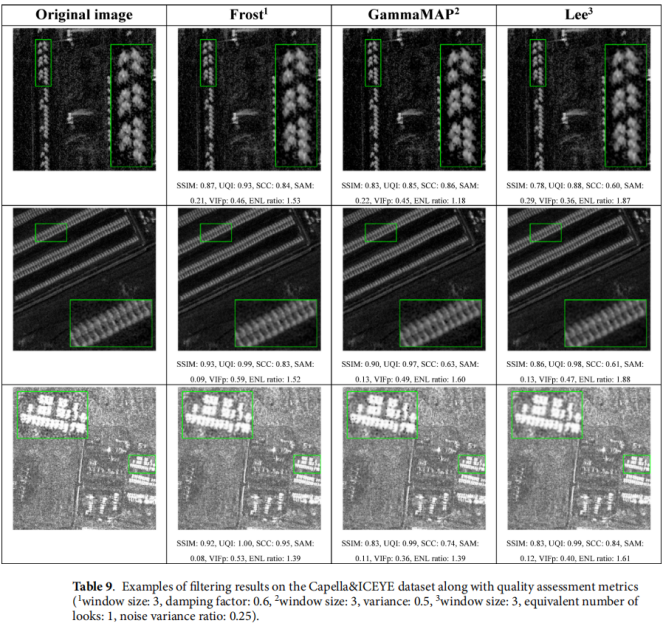
在Capella&ICEYE数据集上观察到的整体ENL提升幅度更大,这可能源于其图像特征:更高的基线噪声水平或更均匀的区域,这使得滤波器更容易区分和抑制相干斑噪声。Frost滤波器在此数据集上的优势进一步印证了滤波策略需要适配每个SAR系统的具体特性。ENL比的分析也再次强调了平衡噪声抑制与结构保真度的重要性:Frost滤波器提供了最有利的权衡,而Lee滤波器则以牺牲空间细节为代价来强调去噪。滤波结果的示例如表9所示。
有相关需求的你可以联系我们!

END
转载请联系本公众号获得授权

计算机视觉研究院学习群等你加入!
ABOUT
计算机视觉研究院
计算机视觉研究院主要涉及深度学习领域,主要致力于目标检测、目标跟踪、图像分割、OCR、模型量化、模型部署等研究方向。研究院每日分享最新的论文算法新框架,提供论文一键下载,并分享实战项目。研究院主要着重”技术研究“和“实践落地”。研究院会针对不同领域分享实践过程,让大家真正体会摆脱理论的真实场景,培养爱动手编程爱动脑思考的习惯!
往期推荐
🔗

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 12
 0
- 0


 已为社区贡献125条内容

所有评论(0)