如何使用通义千问3.0构建一个RAG(检索增强生成)系统?
最近,两款全新的通义千问模型发布了:Qwen3-4B-Instruct-2507 和 Qwen3-4B-Thinking-2507。这两款模型都拥有高达256K的超长上下文长度,这让我不禁思考:“何不利用这个长上下文能力来搭建一个RAG系统呢?”值得一提的是,通义千问系列模型种类繁多,涵盖了用于代码、思维、嵌入和重排等多种用途的模型。为了以最佳方式构建我们的RAG,本文将使用通义千问3.0的嵌入模型和重排模型。
我们不会直接开始构建RAG,而是先逐一了解这些模型,然后再开始搭建系统。
通义千问3.0模型背景
由阿里云开发的多款通义千问3.0模型于几个月前发布。作为这些模型的改进版本,最近又推出了两款新模型:Qwen3-Instruct-2507 和 Qwen3-Thinking-2507,共有三种尺寸:235B-A22B、30B-A3B和4B。请注意,本文我们将主要关注 ‘Qwen3-Instruct-2507’ 的4B版本。所有这些模型都是开源的,在Hugging Face和Kaggle上均可获取。同样值得一提的是,通义千问3.0模型支持多达119种语言和方言。接下来,让我们先来实际体验几款通义千问3.0模型,然后再开始构建我们此行的主要目标——RAG系统。
通义千问3.0模型演示
我们从文本生成模型开始,但在此之前,请务必从https://huggingface.co/settings/tokens获取您的Hugging Face访问令牌。
注意:我们将在Google Colab上进行此演示。打开新笔记本后,请务必在左侧的“秘密”(secrets)选项卡中将访问令牌添加为 HF_TOKEN。请确保开启了对该笔记本的访问权限,同时将运行时类型更改为T4 GPU以处理该模型。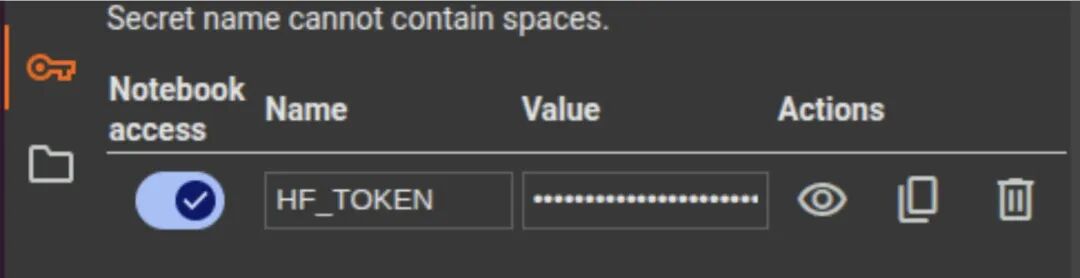
Qwen3-4B-Instruct-2507
这是通义千问3.0-4B非思维模式的更新版本,拥有高达256k的超长上下文长度。顾名思义,该模型拥有40亿参数,相对轻量,非常适合在Colab上使用。让我们使用Hugging Face的transformers库来启动这个模型,看看它的实际表现。
# 安装和依赖import torchimport torch.nn.functional as Ffrom transformers import AutoModelForCausalLM, AutoTokenizer, AutoModel# Instruct模型(文本生成)tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-4B-Instruct-2507")model = AutoModelForCausalLM.from_pretrained( "Qwen/Qwen3-4B-Instruct-2507", torch_dtype="auto", device_map="auto")prompt = "用简单的语言解释什么是机器学习。"messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)generated_ids = model.generate( **model_inputs, max_new_tokens=256)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()response = tokenizer.decode(output_ids, skip_special_tokens=True)print(response)
这是我提问“用简单的语言解释什么是机器学习”后得到的输出:
当然!简单来说,**机器学习**是一种让计算机无需被明确编程,仅通过学习数据就能提升任务执行能力的方法。想象你有一个机器人,它要学会识别照片里的猫。我们不需要一步步地编写指令,比如“寻找一个圆脸、大眼睛和鼻子”,你只需要给它看很多猫的照片和狗的照片。随着时间的推移,这个机器人就会自己开始弄清楚猫和狗的区别——它通过这些例子自己学习。这就是机器学习:计算机查看数据(比如图片、数字或文本),从中发现规律,并基于这些规律更好地进行预测或决策。可以把它想象成一个孩子通过反复观看不同的动物来学习识别它们。机器所做的也类似——它从经验(数据)中学习,并随着时间变得更“聪明”。总而言之:**机器学习 = 教计算机从数据中学习并自我提升。** 😊
Qwen3-Embedding-0.6B
这是一个嵌入模型,用于将文本转换为密集的向量表示,以理解文本之间的关系。这是我们稍后将要构建的RAG系统中的重要组成部分。嵌入模型构成了 检索增强生成(RAG)中“检索器”(Retriever)的核心。
让我们定义一个可重用的函数,并计算嵌入来衡量文本之间的相似性。我将4个字符串(文本)放入了名为texts的列表中。
# Qwen3-Embedding-0.6B(文本嵌入)def last_token_pool(last_hidden_states, attention_mask): left_padding = (attention_mask[:, -1].sum() == attention_mask.shape[0]) if left_padding: return last_hidden_states[:, -1] else: sequence_lengths = attention_mask.sum(dim=1) - 1 batch_size = last_hidden_states.shape[0] return last_hidden_states[torch.arange(batch_size, device=last_hidden_states.device), sequence_lengths]tokenizer = AutoTokenizer.from_pretrained('Qwen/Qwen3-Embedding-0.6B', padding_side='left')model = AutoModel.from_pretrained('Qwen/Qwen3-Embedding-0.6B')texts = [ "机器学习是人工智能的一个子集。", "Python是一种流行的编程语言。", "今天天气很晴朗。", "人工智能正在改变各行各业。"]batch_dict = tokenizer( texts, padding=True, truncation=True, max_length=8192, return_tensors="pt",)outputs = model(**batch_dict)embeddings = last_token_pool(outputs.last_hidden_state, batch_dict['attention_mask'])embeddings = F.normalize(embeddings, p=2, dim=1)scores = (embeddings @ embeddings.T)print(scores.tolist())
输出:
[[1.0, 0.4834885597229004, 0.3609130382537842, 0.6805511713027954], [0.4834885597229004, 1.0000001192092896, 0.44289979338645935, 0.4494439363479614], [0.3609130382537842, 0.44289979338645935, 1.0000001192092896, 0.4508340656757355], [0.6805511713027954, 0.4494439363479614, 0.4508340656757355, 1.0]]
我们通过计算文本相互之间的相似性分数得到这个矩阵。为了便于理解,我们只看矩阵的第一行。如您所见,相同文本的相似性分数始终为1,次高分是0.68,它介于关于人工智能和关于机器学习的句子之间,而关于天气和人工智能的句子之间的相似性分数并不高,这很符合常理。
Qwen3-Reranker-0.6B
我们可以将通过嵌入模型进行向量搜索所获得的检索块传递给重排器模型。重排器模型会根据查询对每个检索块进行评分,以重新排序文档列表并分配优先级,或者使用这些分数来筛选检索到的文档块。为了更好地理解,我们将在接下来的部分直接演示这个模型的实际应用。
使用通义千问模型构建RAG
我们将使用三个指定的通义千问3.0模型,基于Analytics Vidhya博客文章(约40篇)构建一个RAG。我们将按顺序处理数据并使用这些模型。为了高效处理,我们将在使用模型时进行加载/卸载,以节省内存。让我们看看具体步骤,然后深入研究脚本。
步骤1:下载数据。这里是我的仓库链接,你可以在其中找到数据和脚本。
步骤2:安装依赖:!pip install faiss-cpu PyPDF2
步骤3:解压数据到文件夹:!unzip Data.zip
步骤4:为了方便执行,您可以直接将qwen_rag.py脚本添加到Colab环境中,并使用以下命令运行:!python qwen_rag.py
脚本解析:
- 我们使用
PYPDF2库来加载PDF格式的文章内容。我们定义了一个函数来读取.txt或.pdf格式的博客内容。 - 我们将内容分割成大小为800、重叠为100的文档块,以保持连续文档的上下文相关性。
- 我们使用
FAISS来创建一个向量库,并借助我们的查询,检索出基于相似性的前15个文档。 - 现在,我们使用重排器对这15个文档进行重排,并通过以下函数获取前3个文档:
def rerank_documents(query, candidates, k_rerank=3): """使用重排器模型对文档进行重排""" print("正在对文档进行重排...") tokenizer, model = load_reranker_model() # 准备输入 pairs = [] for doc, _ in candidates: pair = f"<Instruct>: 给定一个网络搜索查询,检索能回答该查询的相关段落\n<Query>: {query}\n<Document>: {doc['content']}" pairs.append(pair) # 分词 inputs = tokenizer(pairs, padding=True, truncation=True, max_length=8192, return_tensors="pt").to(device) # 获取分数 with torch.no_grad(): outputs = model(**inputs) logits = outputs.logits[:, -1, :] # 获取“是/否”词元的分数 token_false_id = tokenizer.convert_tokens_to_ids("no") token_true_id = tokenizer.convert_tokens_to_ids("yes") true_scores = logits[:, token_true_id] false_scores = logits[:, token_false_id] batch_scores = torch.stack([false_scores, true_scores], dim=1) batch_scores = torch.nn.functional.log_softmax(batch_scores, dim=1) scores = batch_scores[:, 1].exp().tolist() # 卸载重排器模型 del tokenizer, model clear_memory() print("重排器模型已卸载") # 按分数排序 documents = [doc for doc, _ in candidates] doc_scores = list(zip(documents, scores)) doc_scores.sort(key=lambda x: x[1], reverse=True) return doc_scores[:k_rerank]
一旦我们获得了这3个排名靠前的文档,我们就将它们传递给指令模型,以从我们的检索增强生成器中获取最终输出。
输出:
问题:LoRA和QLoRA有什么区别?回答:LoRA(Low-Rank Adaptation,低秩适应)和QLoRA(Quantized Low-Rank Adaptation,量化低秩适应)都是参数高效的微调技术,用于使大型语言模型(LLM)适应特定任务。尽管它们有相似之处,但在方法和效率上有所不同。1. **LoRA (低秩适应)**: * LoRA在预训练模型的每一层的自注意力模块中引入低秩矩阵(A和B)。这些矩阵充当适配器,使模型能够为特定任务进行适应和专业化,同时最大限度地减少所需的额外参数数量。 * LoRA通过专注于优化可训练的低秩矩阵而不是微调所有参数来减少参数开销。这使得它在内存上更高效,计算成本也更低。 * LoRA允许预训练模型在多个任务之间共享,从而方便在部署过程中高效地进行任务切换。 * 与完全微调的模型相比,LoRA不会引入任何额外的推理延迟,使其适用于实时应用。2. **QLoRA (量化低秩适应)**: * QLoRA是LoRA的扩展,它进一步引入了量化,以在微调过程中提高参数效率。它在LoRA原则的基础上,引入了4位NormalFloat(NF4)量化和双重量化技术。 * NF4量化利用预训练神经网络权重的固有分布,将所有权重转换为适合NF4范围(-1到1)的固定分布。这使得有效的量化成为可能,而无需昂贵的量化估计算法。 * 双重量化通过量化量化常数本身来解决量化常数的内存开销。这在不影响性能的情况下显著减少了内存占用。 * QLoRA通过引入量化实现了更高的内存效率,这对于在资源受限的设备上部署大型模型特别有价值。 * 尽管其参数高效,QLoRA仍保持了高模型质量,在各种下游任务上的表现与完全微调的模型相当甚至更好。总而言之,LoRA专注于通过低秩适应来减少可训练参数的数量,而QLoRA则通过整合量化技术进一步增强了这种效率,使其更适合在计算资源有限的设备上部署。来源:fine_tuning.txt, Parameter-Efficient Fine-Tuning of Large Language Models with LoRA and QLoRA.pdf, Parameter-Efficient Fine-Tuning of Large Language Models with LoRA and QLoRA.pdf
注意:您可以参考日志文件rag_retrieval_log.txt,以获取有关检索到的文档、与查询的相似性分数以及重排器分数的更多信息。
总结
通过结合使用通义千问3.0的指令、嵌入和重排器模型,我们构建了一个实用的RAG管道,充分利用了它们的优势。凭借256K的上下文长度和多语言支持,通义千问系列在实际任务中展现了其多功能性。作为下一步,您可以尝试增加传递给指令模型的文档数量,或者针对不同用例使用思维模型。模型的输出也很有前景。我建议您尝试使用忠实度(Faithfulness)和答案相关性(Answer Relevancy) 等指标来评估RAG,以确保LLM在您的任务/用例中大部分没有出现幻觉。
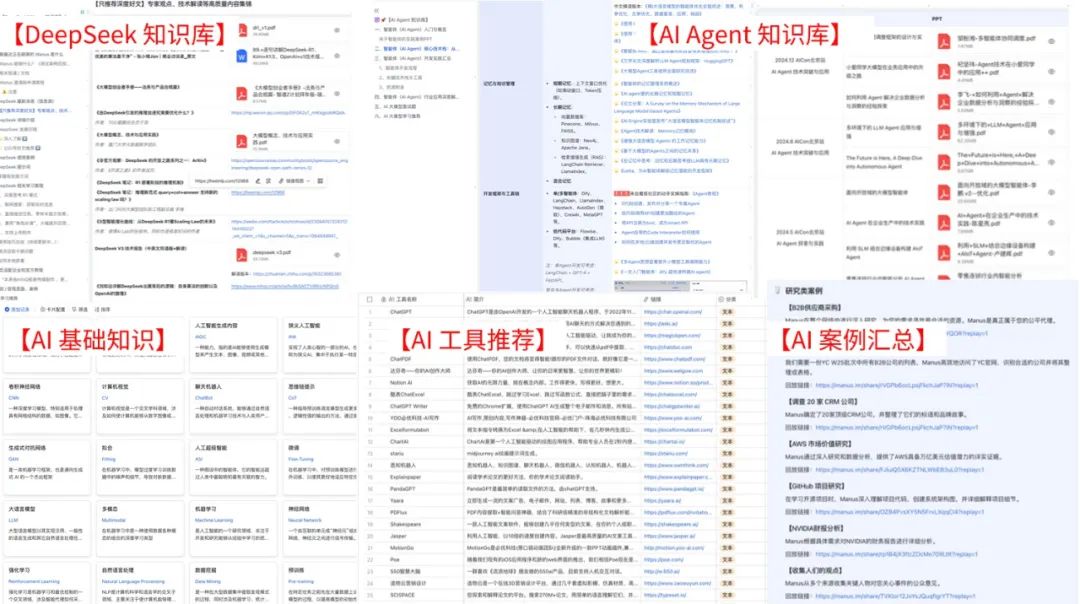
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
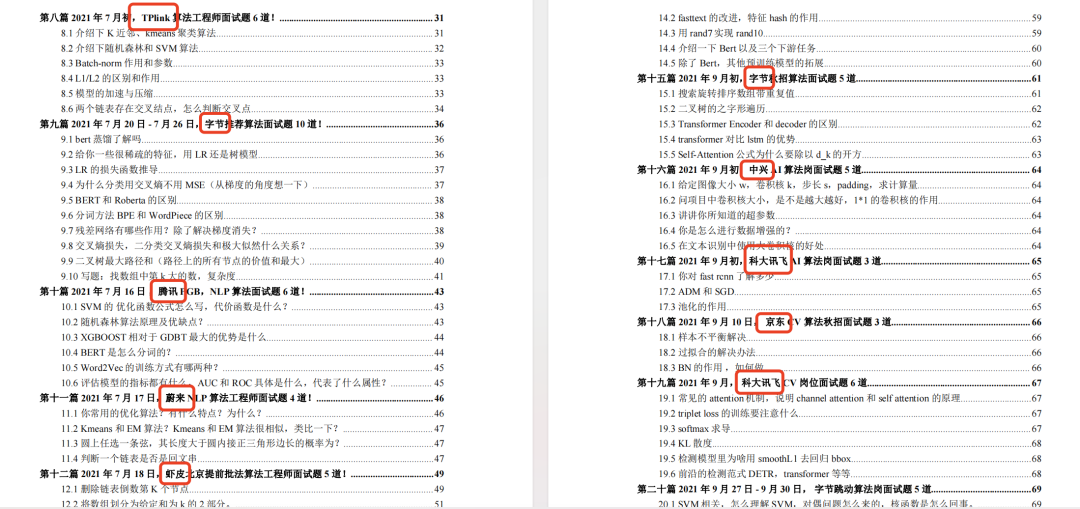
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
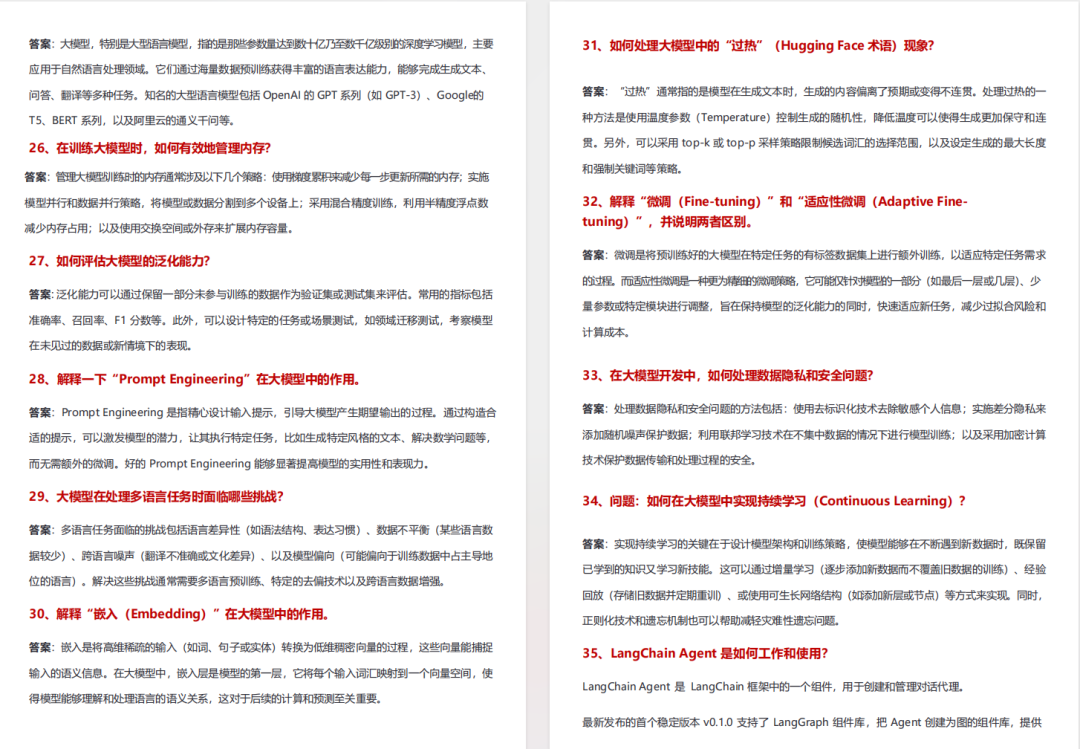
2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
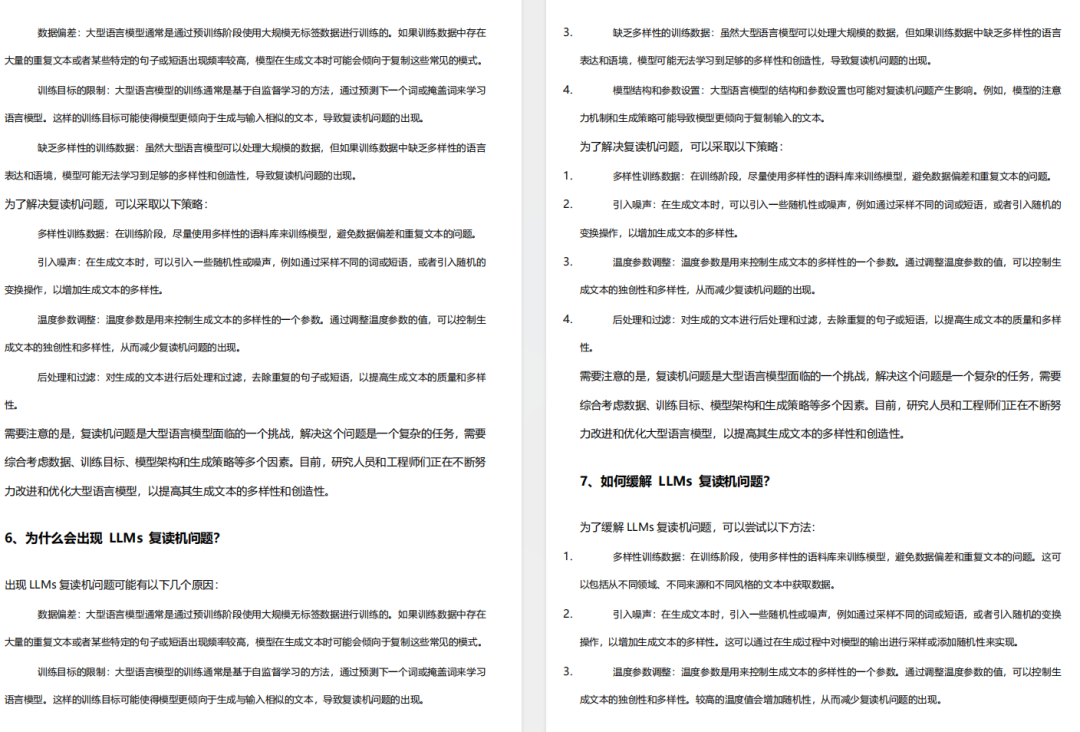
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
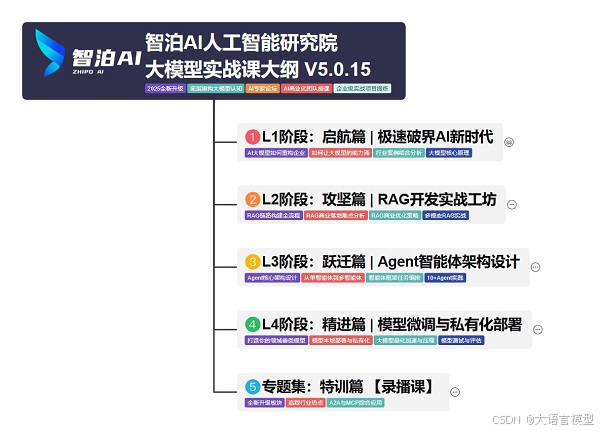
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
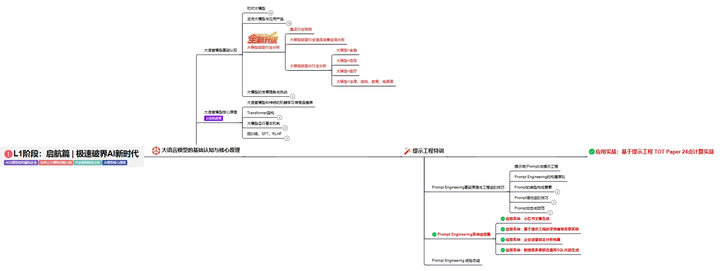
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
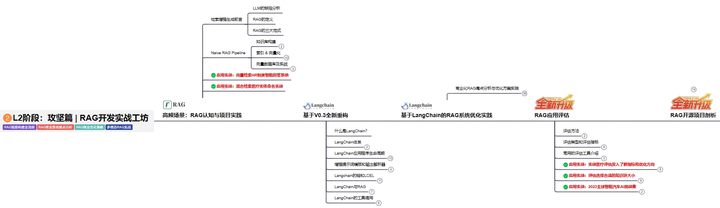
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
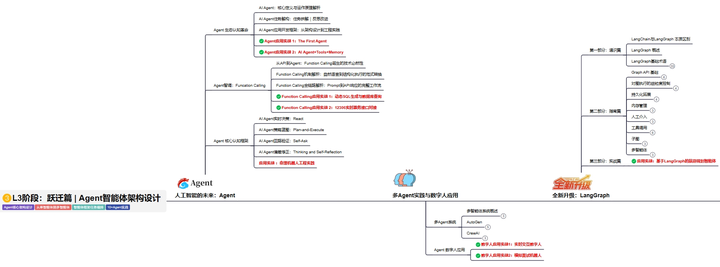
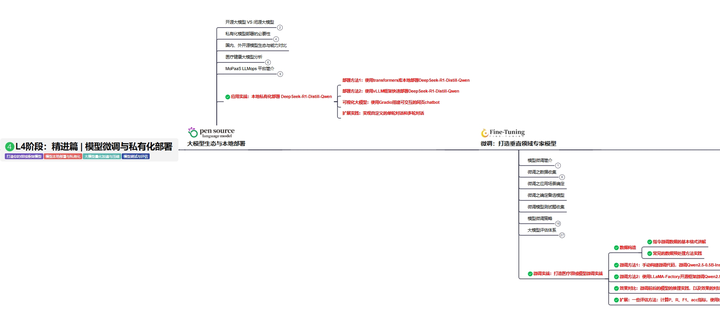
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
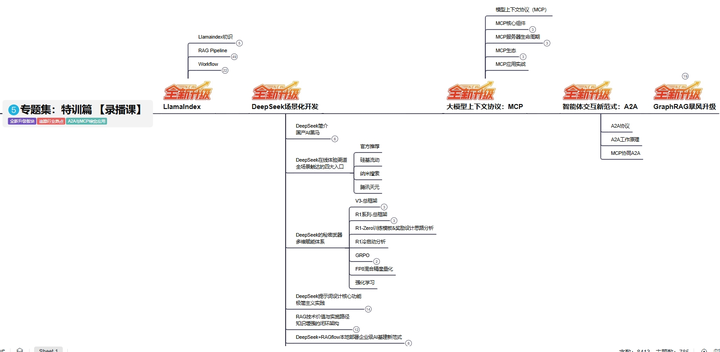
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献54条内容

所有评论(0)