Python实战:微博热搜数据爬取与可视化分析(含源码)
·
微博热搜数据爬取与可视化分析
写在开头
本项目中中所有内容仅供学习交流使用,不用于其他任何目的,严禁用于商业用途和非法用途,否则由此产生的一切后果均与作者无关!
在当今社交媒体时代,微博作为中国最主要的社交媒体平台之一,每天都会产生大量的热点话题和热搜内容。这些热搜数据不仅反映了公众的关注焦点,也蕴含着丰富的舆情信息和市场趋势。本项目介绍如何通过Python脚本爬取微博热搜数据,并生成美观的可视化图表。
一、项目背景
微博热搜榜是根据微博平台用户的搜索和讨论热度实时生成的榜单,它能够快速反映出当前关注的热点话题。通过自动化爬取这些数据并进行可视化分析,我们可以:
- 实时监控社会热点和舆情动向
- 分析公众关注焦点的变化趋势
- 为内容创作和营销策略提供数据支持
- 构建舆情监控和分析系统
本项目旨在通过API接口获取微博热搜数据,将数据保存为CSV格式,并生成具有科技感的可视化图表,便于进一步分析和展示。
二、技术栈
本项目主要使用了以下技术和工具:
- Python 3.x - 核心编程语言
- requests - 用于发送HTTP请求获取数据
- pandas - 数据处理和CSV文件操作
- matplotlib - 数据可视化库,用于生成图表
- numpy - 数值计算库,辅助数据处理
三、项目实现
关键爬取逻辑
项目主要实现逻辑如下:
- 数据获取:发送GET请求获取JSON格式的热搜数据
- 数据处理:解析返回的JSON数据,提取关键字段
- 数据保存:将数据保存为CSV格式文件
- 数据可视化:生成美观的玫瑰图展示热搜热度
# 核心爬取函数
def fetch_weibo_hot_data():
    """
    获取微博热搜数据
    :return: 热搜数据列表
    """
    print("正在获取微博热搜数据...")

    try:
        response = requests.get(API_URL, params=params, timeout=10)
        response.raise_for_status()
        data = response.json()

        if data.get('code') == 200:
            print("数据获取成功!")
            return data.get('data', [])
        else:
            print(f"API返回错误: {data.get('msg', '未知错误')}")
            return []
    except Exception as e:
        print(f"获取数据时出错: {e}")
        return []
数据处理与保存
获取到原始数据后,我们只保留热搜标题和链接地址两个关键字段,并将列名设置为中文,提高可读性:
def save_to_csv(data):
    """
    将数据保存到CSV文件
    :param data: 热搜数据列表
    """
    if not data:
        print("没有数据可保存")
        return

    # 创建DataFrame
    df = pd.DataFrame(data)

    # 只保留title和scheme两列
    if 'title' in df.columns and 'scheme' in df.columns:
        df = df[['title', 'scheme']]

    # 将列名设置为中文
    df.columns = ['热搜标题', '链接地址']

    # 生成带时间戳的文件名
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    filename = f"weibohot-{timestamp}.csv"

    # 保存到CSV文件
    df.to_csv(filename, index=False, encoding='utf-8-sig')
    print(f"数据已保存到 {filename}")
    return filename
数据可视化
为了更直观地展示热搜数据的热度差异,我们使用了美观的玫瑰图进行可视化:
def create_tech_visualization(data):
    """
    :param data: 热搜数据列表
    """
    if not data:
        print("没有数据可绘制图表")
        return

    # 取前10条数据进行可视化
    top_data = data[:10]

    # 提取标题和热度值
    titles = [item['title'] for item in top_data]
    hot_values = []

    # 处理热度值,有些可能为空或非数字
    for item in top_data:
        desc = item.get('desc_extr')
        if desc:
            # 如果是"分类 123456"格式,只取数字部分
            if ' ' in str(desc):
                desc = str(desc).split(' ')[-1]
            try:
                hot_values.append(int(desc))
            except:
                hot_values.append(0)
        else:
            hot_values.append(0)

    # 使用玫瑰图展示
    fig, ax = plt.subplots(figsize=(8, 5), subplot_kw=dict(projection='polar'))
    fig.patch.set_facecolor('#f0f0f0')

    # 角度设置
    angles = np.linspace(0, 2 * np.pi, len(titles), endpoint=False).tolist()

    # 设置颜色
    colors = plt.cm.viridis(np.linspace(0.2, 0.8, len(titles)))

    # 绘制玫瑰图
    bars = ax.bar(angles, hot_values, width=2*np.pi/len(titles), color=colors, alpha=0.8)

    # 添加标签(缩小文字比例)
    ax.set_xticks(angles)
    ax.set_xticklabels(titles, color='#333333', fontsize=7)

    # 设置标题(缩小文字比例)
    ax.set_title('微博热搜榜 Top 10 玫瑰图', color='#2c3e50', fontsize=12, pad=15, weight='bold')

    # 设置极径标签颜色和字体大小
    ax.tick_params(axis='y', colors='#666666', labelsize=7)
    ax.tick_params(axis='x', colors='#333333')

    # 优化布局
    plt.tight_layout()

    # 保存图表
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    image_filename = f"weibohot-{timestamp}.png"
    plt.savefig(image_filename, dpi=300, bbox_inches='tight', facecolor='#f0f0f0')
    print(f"图表已保存到 {image_filename}")
    plt.show()
爬取结果展示:
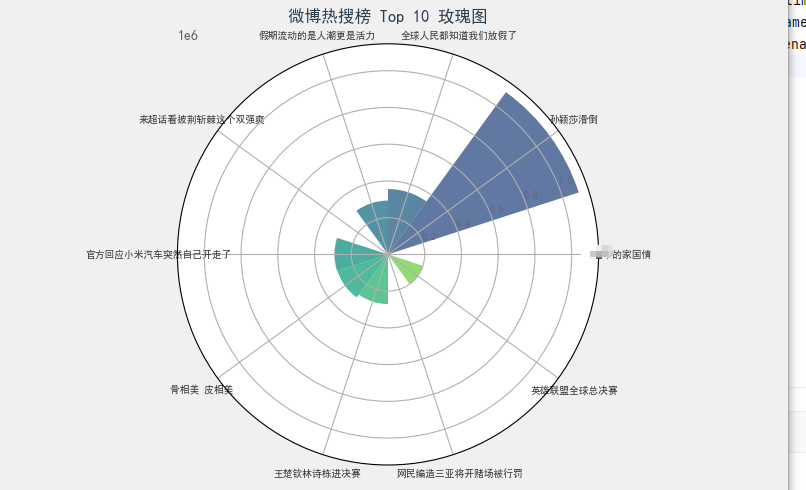
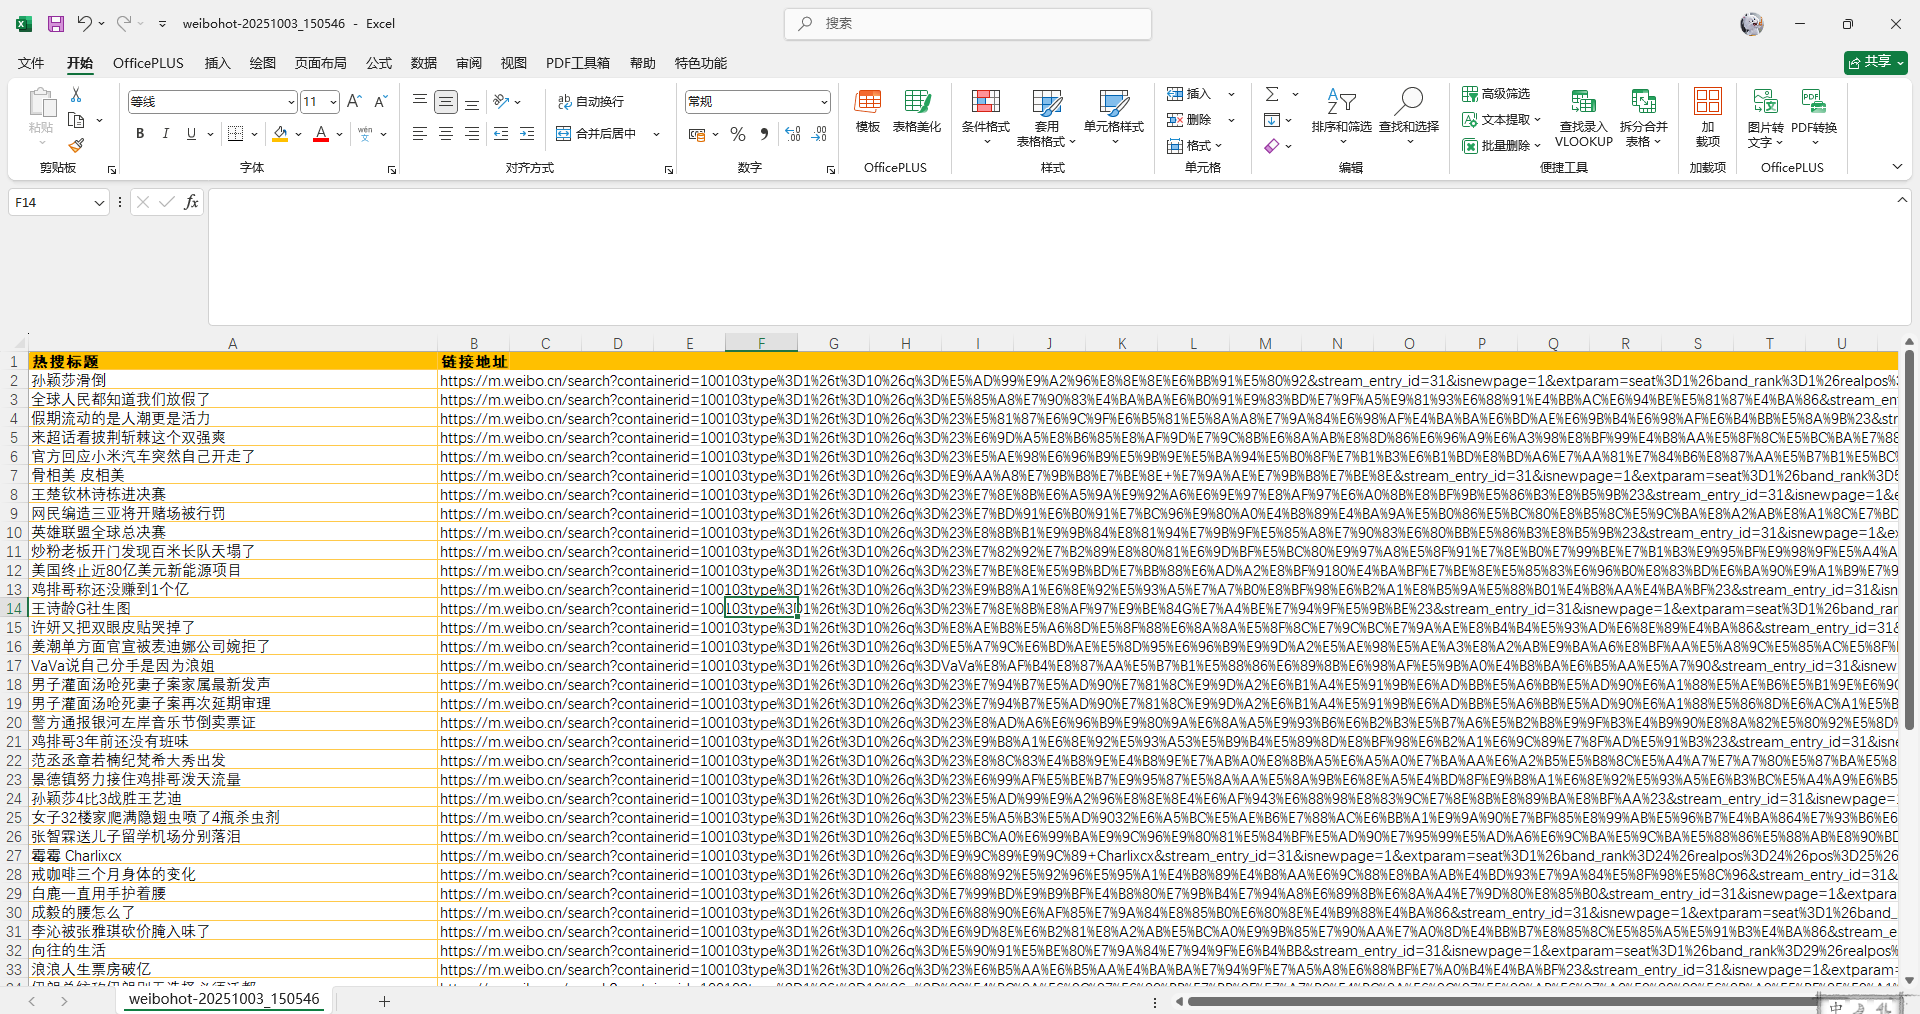
运行后将生成两个文件:
- CSV格式的数据文件,包含热搜标题和链接地址
- PNG格式的玫瑰图,可视化展示热搜热度
四、总结
本项目通过简单的Python脚本实现了微博热搜数据的自动爬取、存储和可视化展示。通过玫瑰图的形式,我们可以直观地看到各个热搜词条的相对热度,为舆情分析和热点追踪提供了有效的工具。
进一步扩展功能,如:
- 定时任务自动化执行
- 多平台热搜数据对比分析
- 热搜话题的情感分析
- 构建Web可视化仪表板

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)