(done) 并行计算 CS149 Lecture8 (并行原语 Data-Parallel Thinking)
url: https://www.bilibili.com/video/BV1du17YfE5G/?spm_id_from=333.788.videopod.sections&p=8&vd_source=7a1a0bc74158c6993c7355c5490fc600
之前的 CUDA 和 cpp 线程实验里,我们做的并行类似于从 “workers 做什么” 这个角度来理解。
现在我们要开始尝试从 “一序列数据的操作” 这个角度来理解并行算法。

合理设计算法,让它暴露出大量并行性,我们才能充分利用:
1.多 Core
2.多机器 (分布式)
3.SIMD 处理 + 多线程
4.GPU

并行编程的关键部分永远是找到程序中的依赖关系。
没有依赖意味着有并行潜力。

一个经典的并行数据模型就是把输入数据序列化(如放入矢量里),从而可以用 SIMD,多线程,GPU 等方式并行计算。

一个比较泛化的数据类型概念:序列
序列是一组有序数据的集合,在不同编程语言里有不同的具体形式。
与数组不同,数组可以直接说,我要访问 array[43] 来访问第43个元素。
序列需要特定操作才能访问(估计是封装好的操作)
(之所以要用封装好的操作,禁止用户随意使用 sequence[i] 是为了避免在程序中出现依赖关系)

先来看第一个序列的特定操作,Map,它接收两个参数,分别是一个函数指针 f,以及一个输入序列 input。
它的输出是一个序列,output = f(input)。output 长度与 input 等长。对于每个 input 的元素 input[i],output[i] = f(input[i])。
通过这种方式抽象、封装我们的代码,map 的实现者可以很轻松的去增加代码的并行化。

一个比较简单的并行化 map 的方式是:把输入序列切成多段,每一段使用多线程 map 函数去用 f 计算那一段的输出序列,最后再把输出序列拼起来。(这里似乎没用到 GPU,因此并行极限应该是核数量)

接下来介绍第二封装操作:Fold 折叠,左折叠。
具体的作用看下图

对于 fold 的并行化很简单。把输入序列切成几段,分别使用 fold f,得到单个元素,随后使用用户提供的 comb 函数把它们组合起来即可。
如果 f 本身的计算是满足结合律的(如加法),那么就不需要 comb 函数。
不需要符合交换律,因为 fold 函数并没有改变数据的计算顺序。
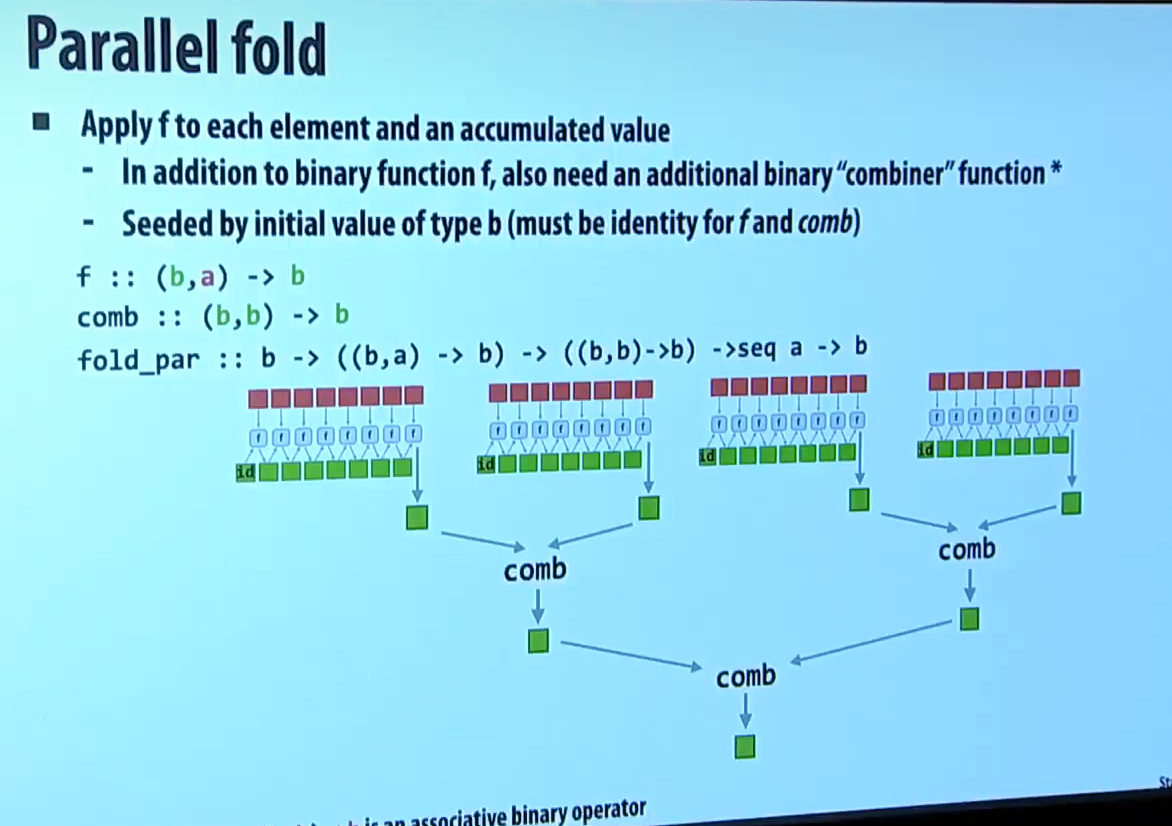
注意:常见操作“点积”就可以用 map(乘法) + fold(加法) 实现。
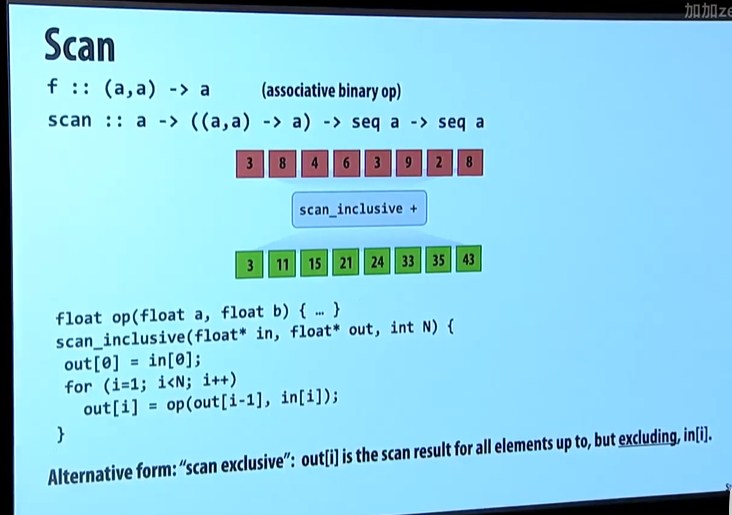
接下来看 Scan,如下图是 Scan 的作用。
它与 fold 类似,不同的是,fold 只产生一个元素,Scan 则产出一个序列。
scan 分为 inclusive_scan 和 exclusive_scan。
inclusive_scan: 包含当前元素
exclusive_scan: 不包含当前元素
两者之间的转换只需一个 加法/减法
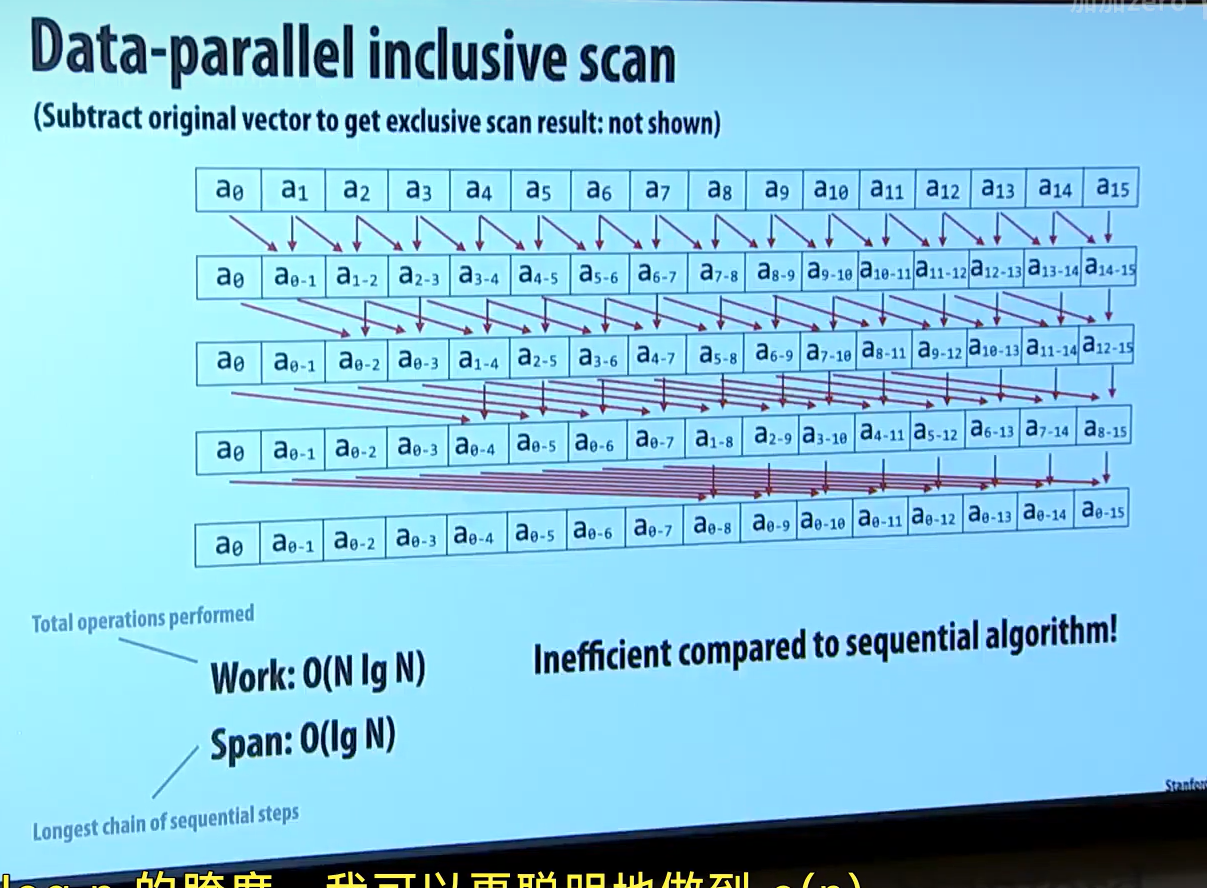
如下是 scan 的一种比较直接的并行化方法。
每一行的计算成本 O(N)
总行数 O(lgN)
在单核情况下,这实际上比串行算法更慢,串行算法是 O(N)。
如果核数量较少,比如 (8),那么当 N 的值大于 2^8 = 256 时,并行方法就比串行方法慢了。
所以这不是一个好的并行化方法。
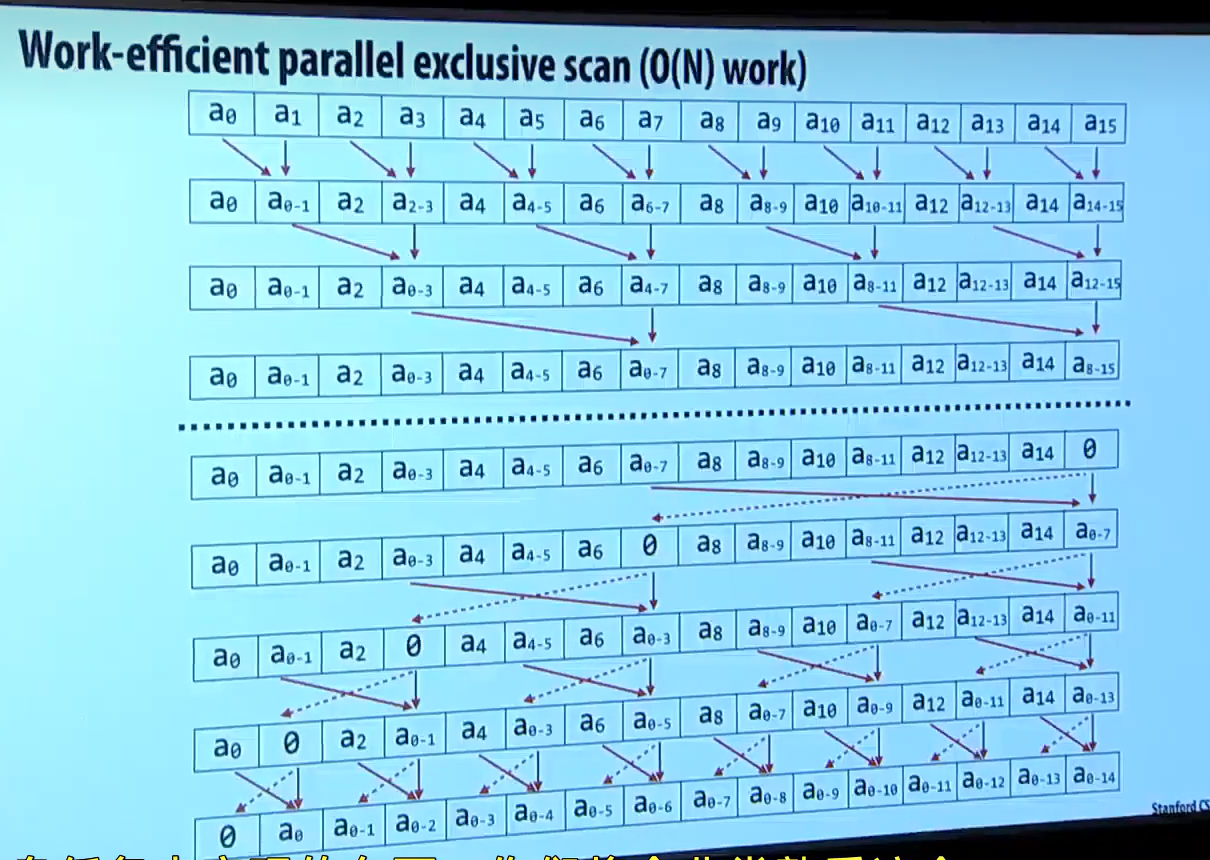
下面是一个更聪明的 O(N) 方法。分为两个阶段,上扫阶段和下扫阶段。
这个算法可能自己盯着图看更容易理解。
常数系数大概为 2。也就是只要核数量多一点,基本在任何大小的 N 都能稳定胜过串行算法。
这是一个好的并行算法。
不过需要注意的是,仔细看图,算法中并不是每一步都在使用我们所拥有的所有处理器,某些步骤只有两个计算,因此哪怕处理器数量再多也无济于事。
在现实中,要把这个算法实现得高性能,需要更多努力。
下面两张图是 Scan 算法的一个简单实现。
只考虑双核,把输入序列从中间切开,双核每次只负责自己部分的计算。
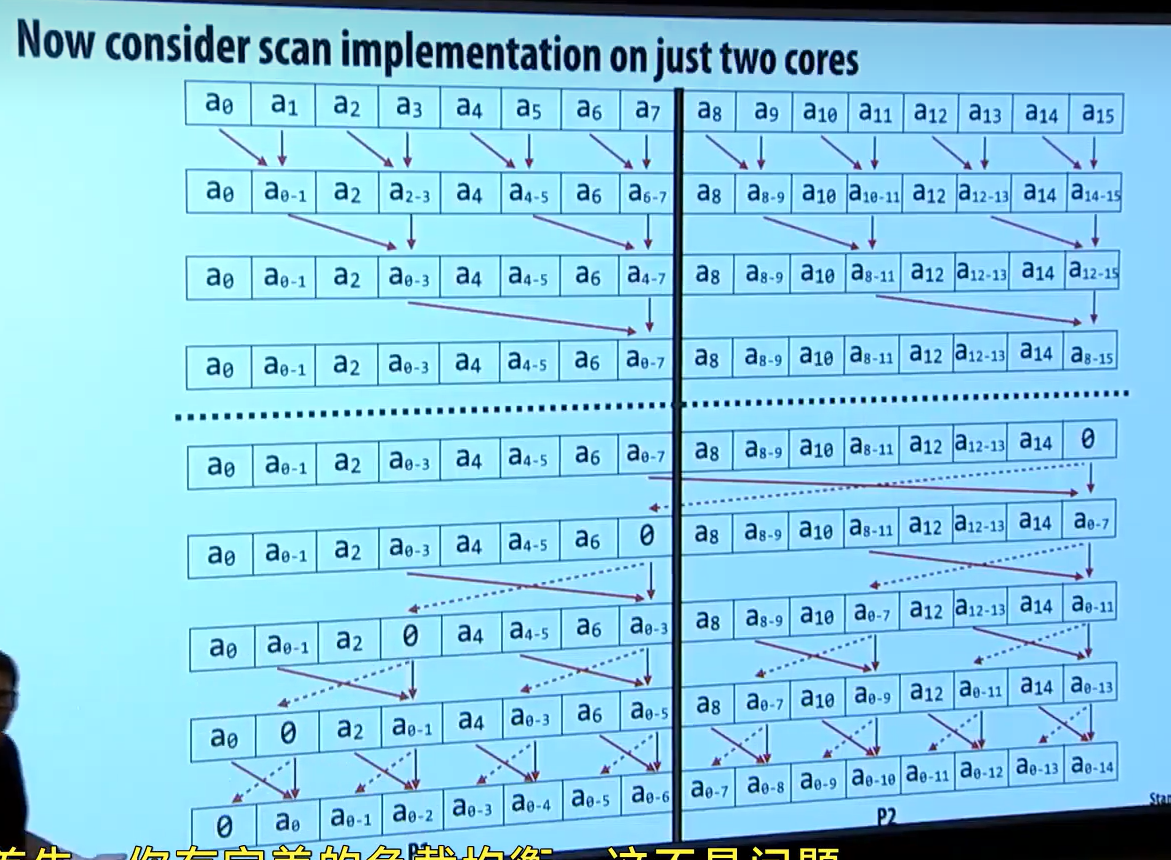
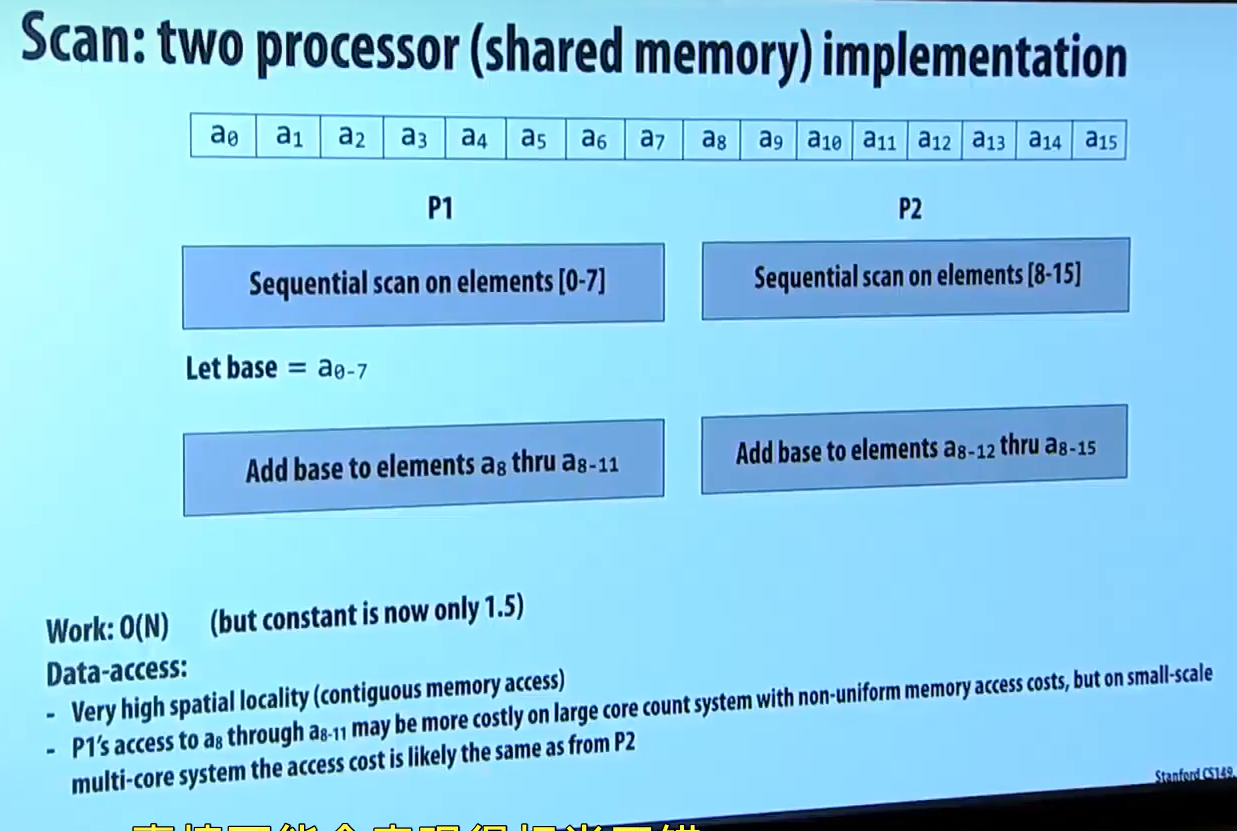
接下来考虑一个简单的 CUDA 实现 Scan:
设想输入数组只有 32 个元素。
设备函数的参数 idx 是由调用者设定的 CUDA thread 索引。
该函数没有使用我们之前说的 O(N) 算法的 Scan,而是使用了最简单的 O(NlgN) 算法的 Scan。
下图描述了这个算法的原理。易得,对于32长度的输入数组,一共需要 5 次计算。
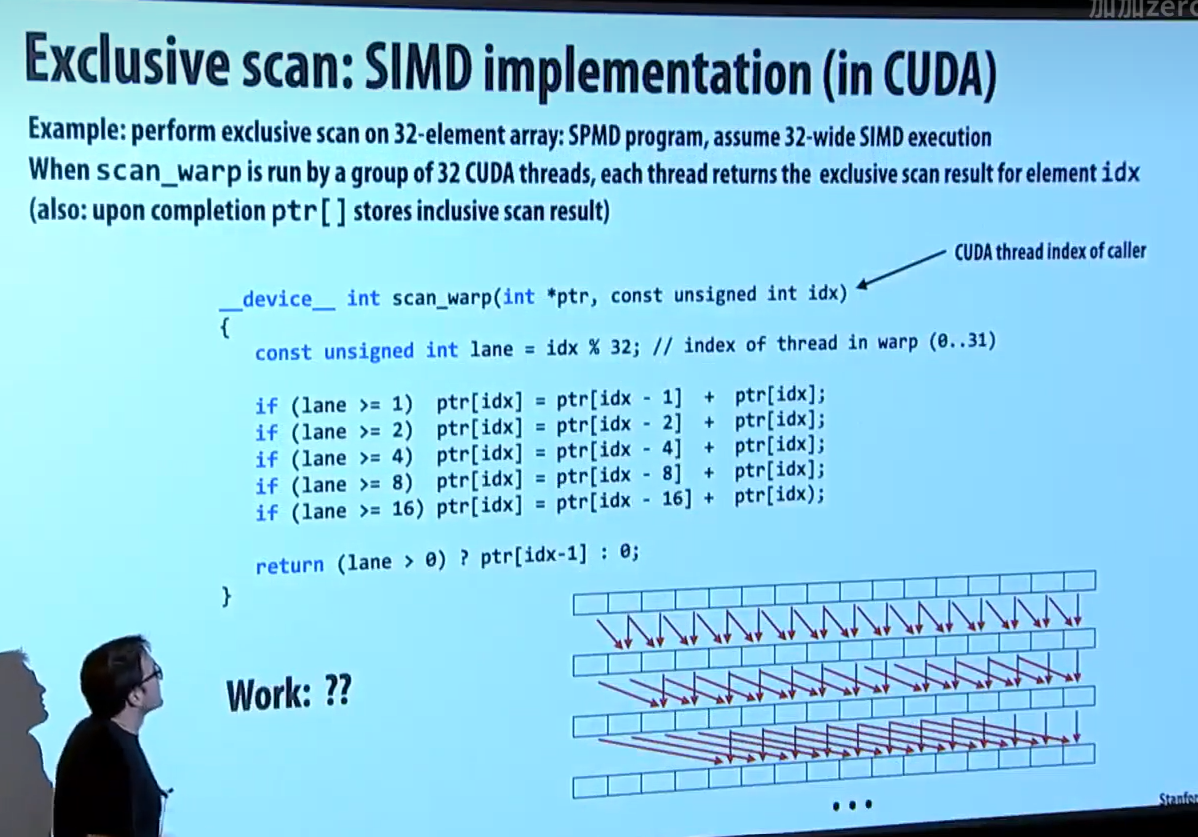
回忆一下之前的 O(N) Scan 算法,分为上扫阶段和下扫阶段两个部分。如果用类似的 CUDA 程序实现,那么将需要 5 + 5 = 10 个周期,反而慢了。
这里面的原因包括: 1. 算法的常熟不同 2. O(N) Scan 的算法通道利用率太低(CUDA 可以看作 SIMD),在部分步骤里,只有 2 ~ 4 次计算,大部分通道都没有用到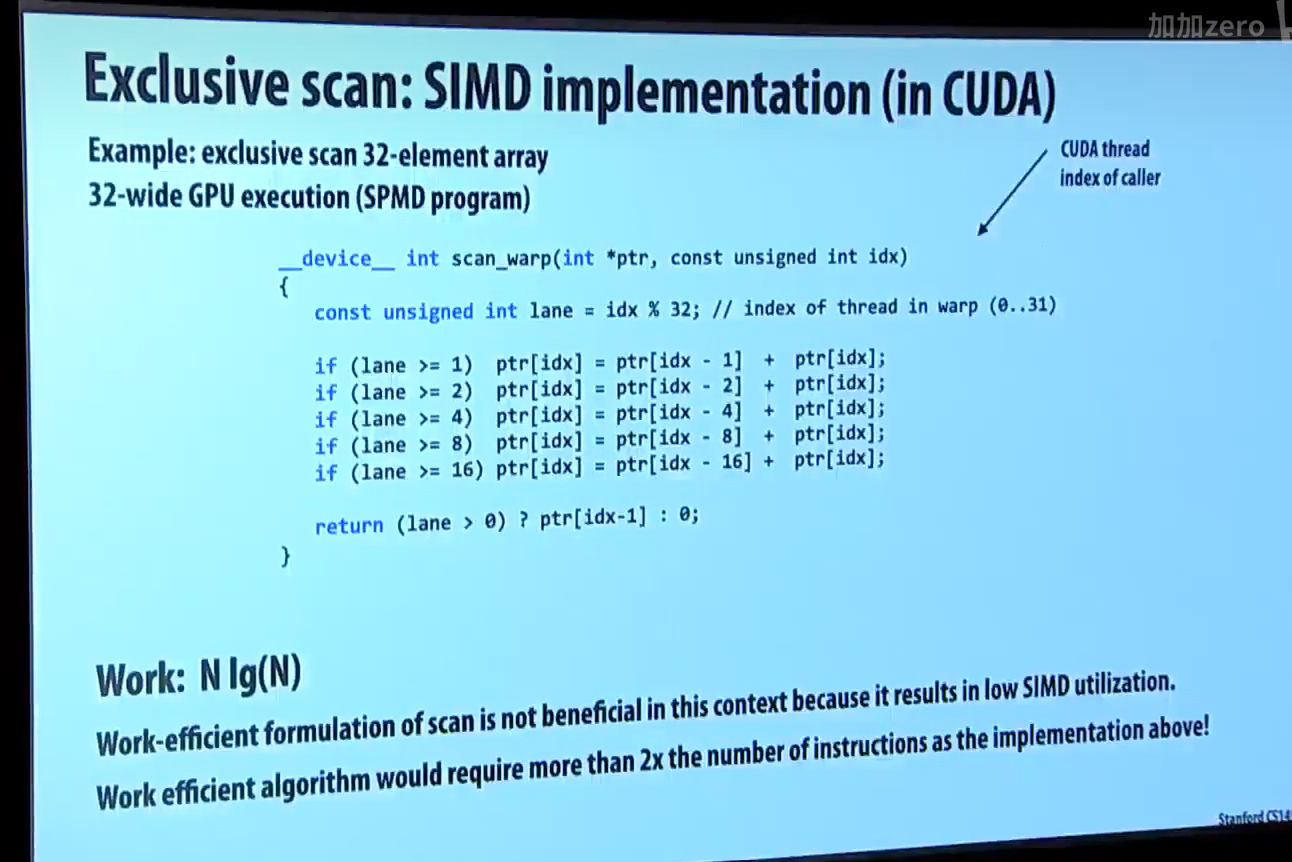
实际上,不同的机器可能适合不同的算法:
假设我们只有一台四核机器,那么 O(N) Scan 算法更合适,因为我们部分步骤只有少量计算,正好适合四核机器这种核数少的机器。
假设在 GPU (SIMD) 上,那么 O(NlgN) Scan 算法可能更合适,因为这种算法每一步骤都有大量计算,能很好地发挥 GPU 的并行能力。
看一个例子:输入数组扩展到 128(1024) 位宽。
那么先切片扫描,每32个元素一个片段,一共有 4(32) 个片段。
采用 O(NlgN) 扫描算法,花费5个周期,一共得到 4(32) 个元素。
再次花费 5 个周期,得到 4(32) 个元素。
把这些元素做加法添加到 base0, 1, 2… 里,耗费1个周期。
因此可以在硬件并行性足够的情况下,花费 11 个时钟周期 完成 128/1024 个元素的扫描。
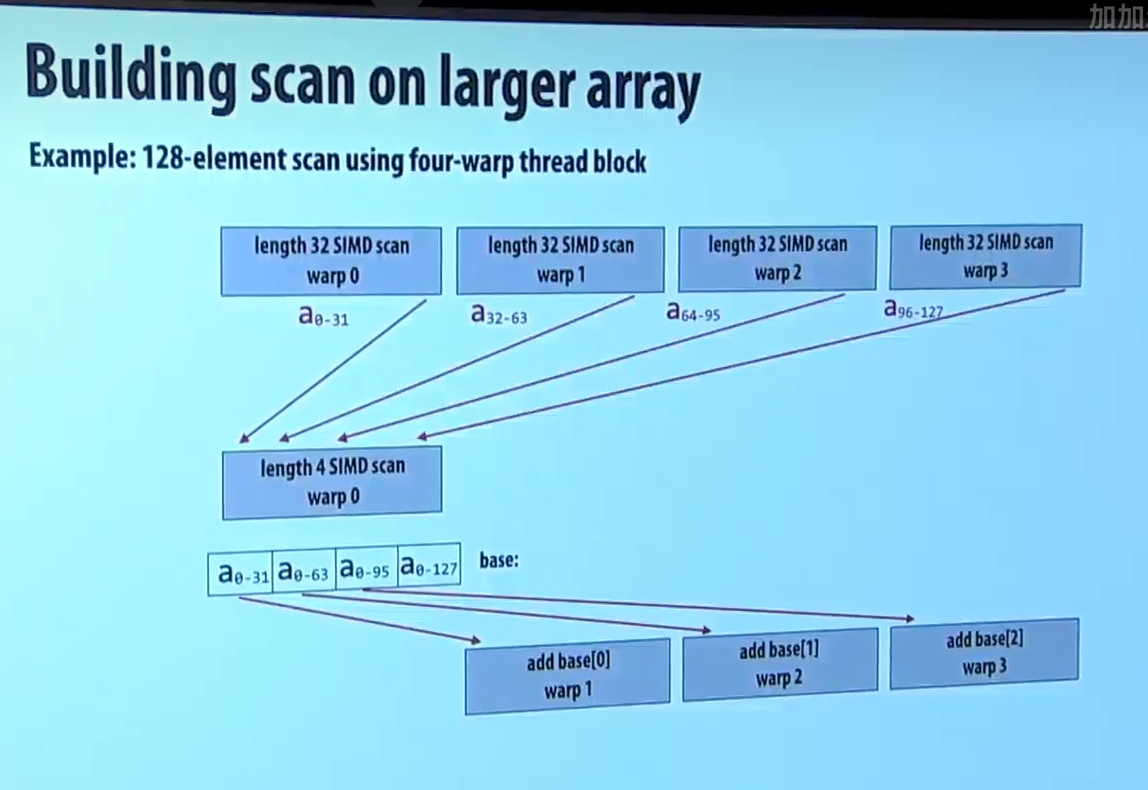
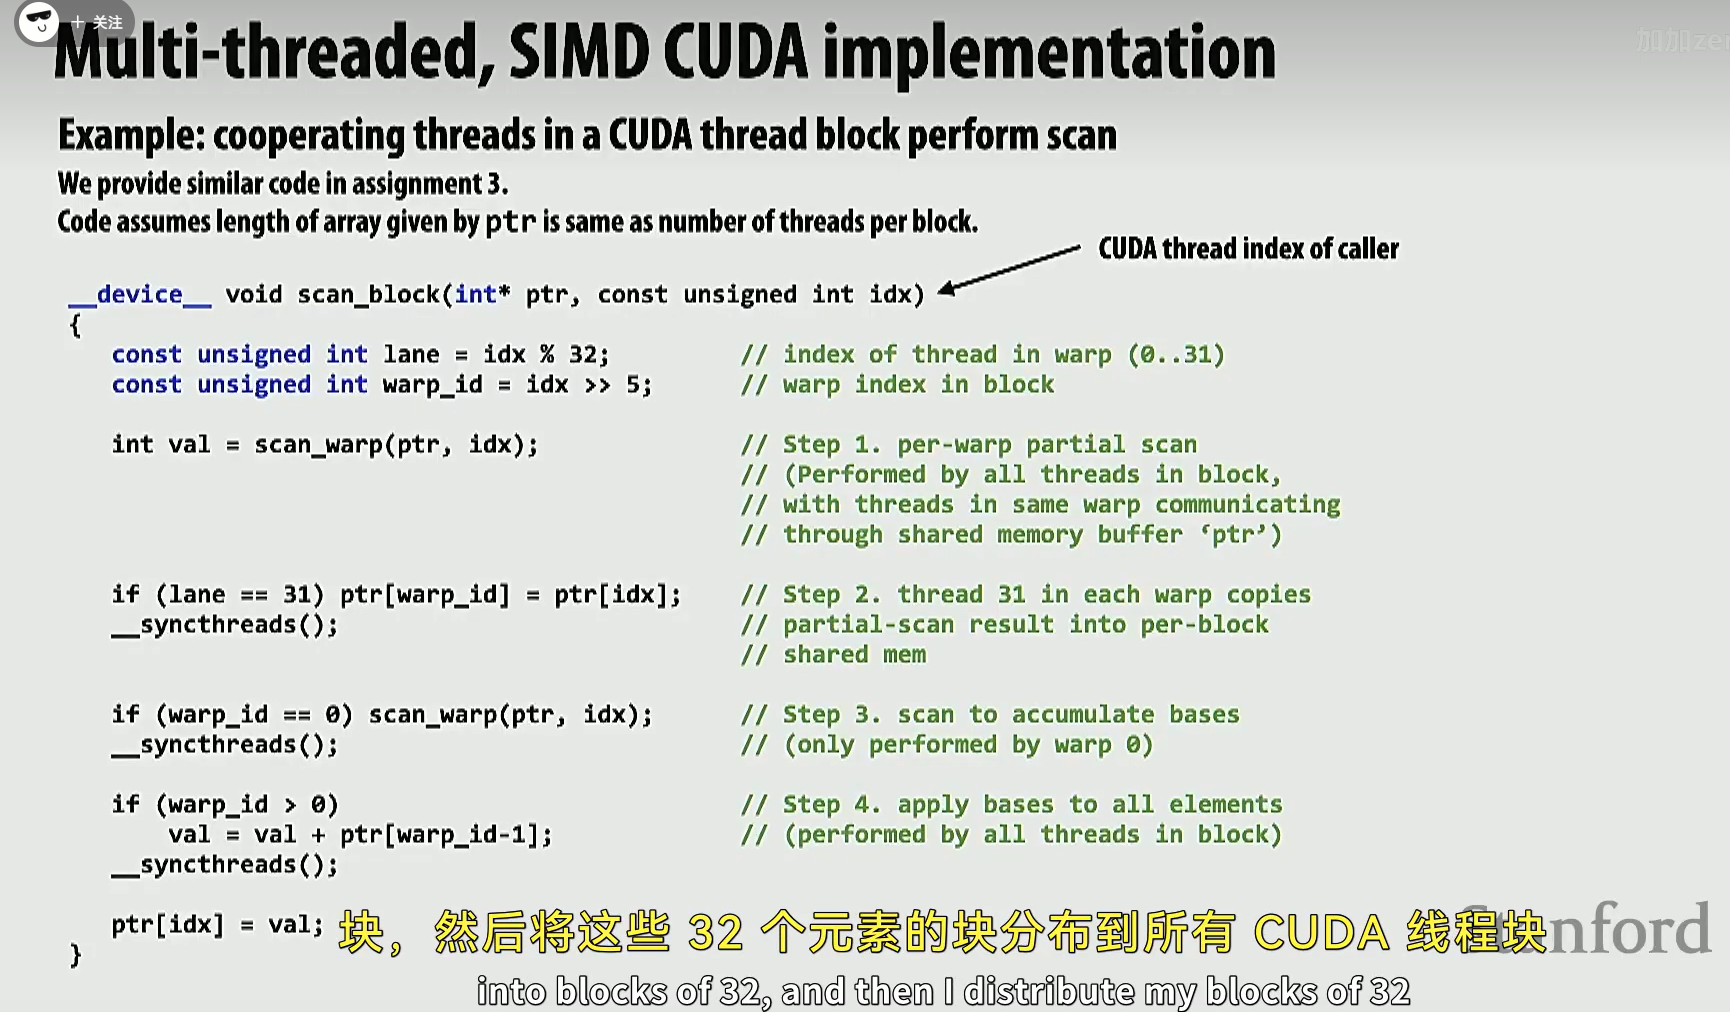
如下图是相应的 CUDA 代码。我没看懂,不过说 assignment3 会出现,做作业的时候再看吧。
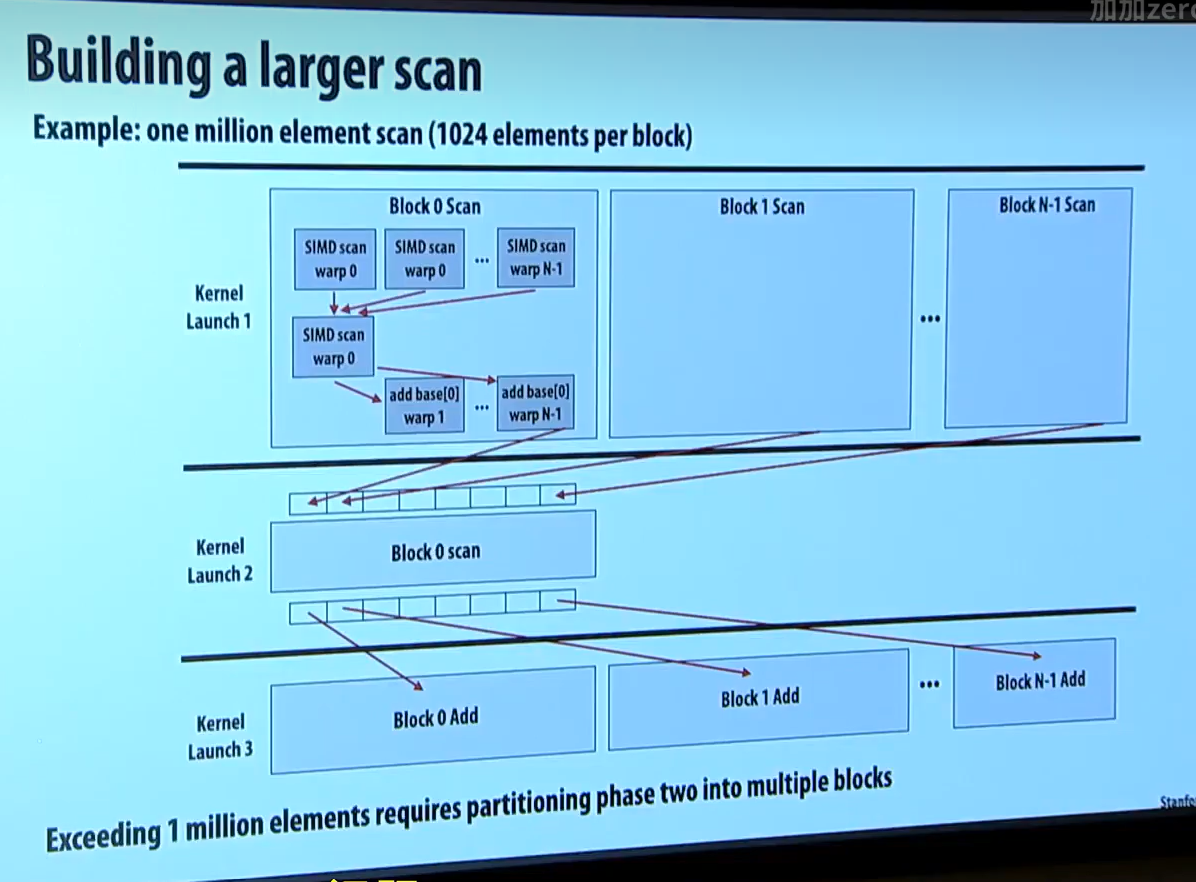
下图是一个更大型的 Scan 实现方案 (100万),自己看图应该更好理解算法流程
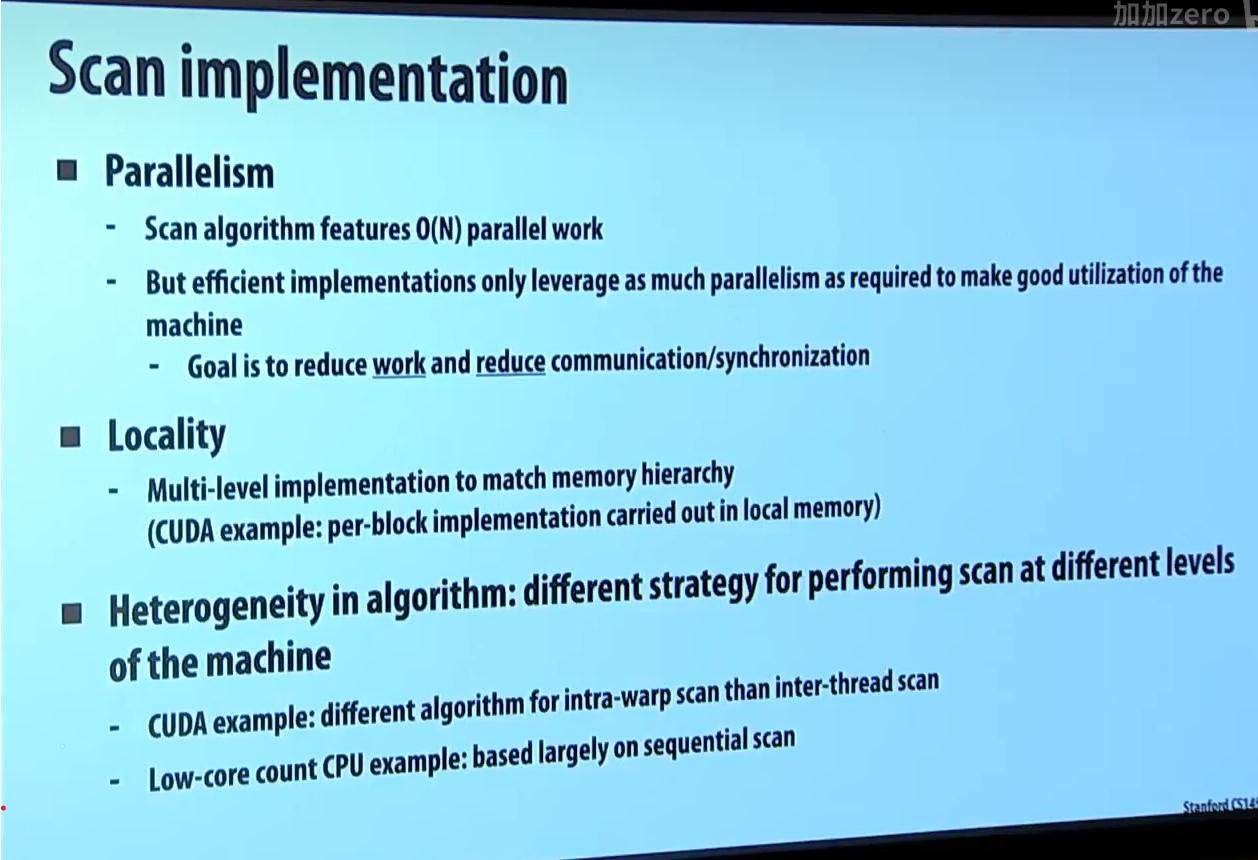
这是对前面描述的 Scan 算法的实现方案总结
我觉得最重要的就一句:算法的并行度只有在能够充分发挥硬件效力的情况下才有意义。
在现实中,我们通常不仅仅处理序列,而是处理序列的序列。
举个例子,图算法,一张图通常是 [[与第一个顶点相连的点],[与第二个顶点项链的点],…]
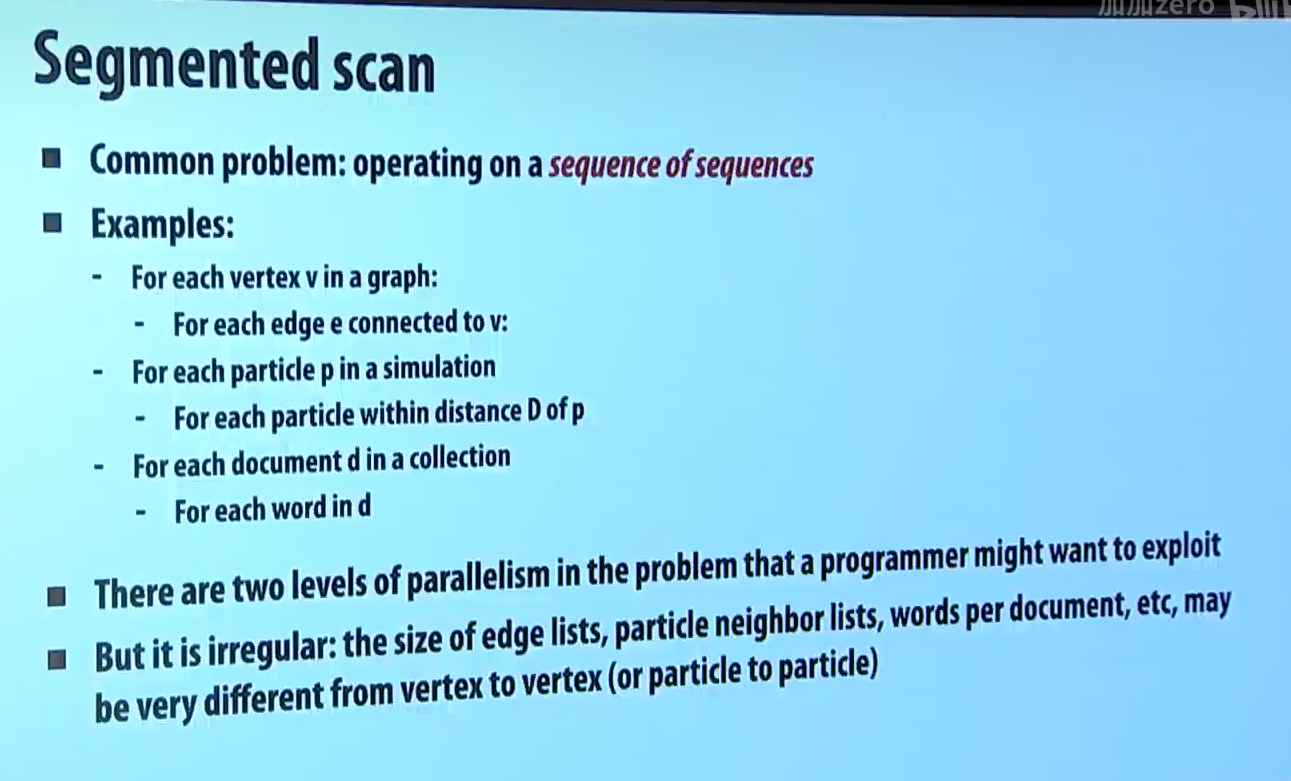
如下图是切片扫描做的事情。
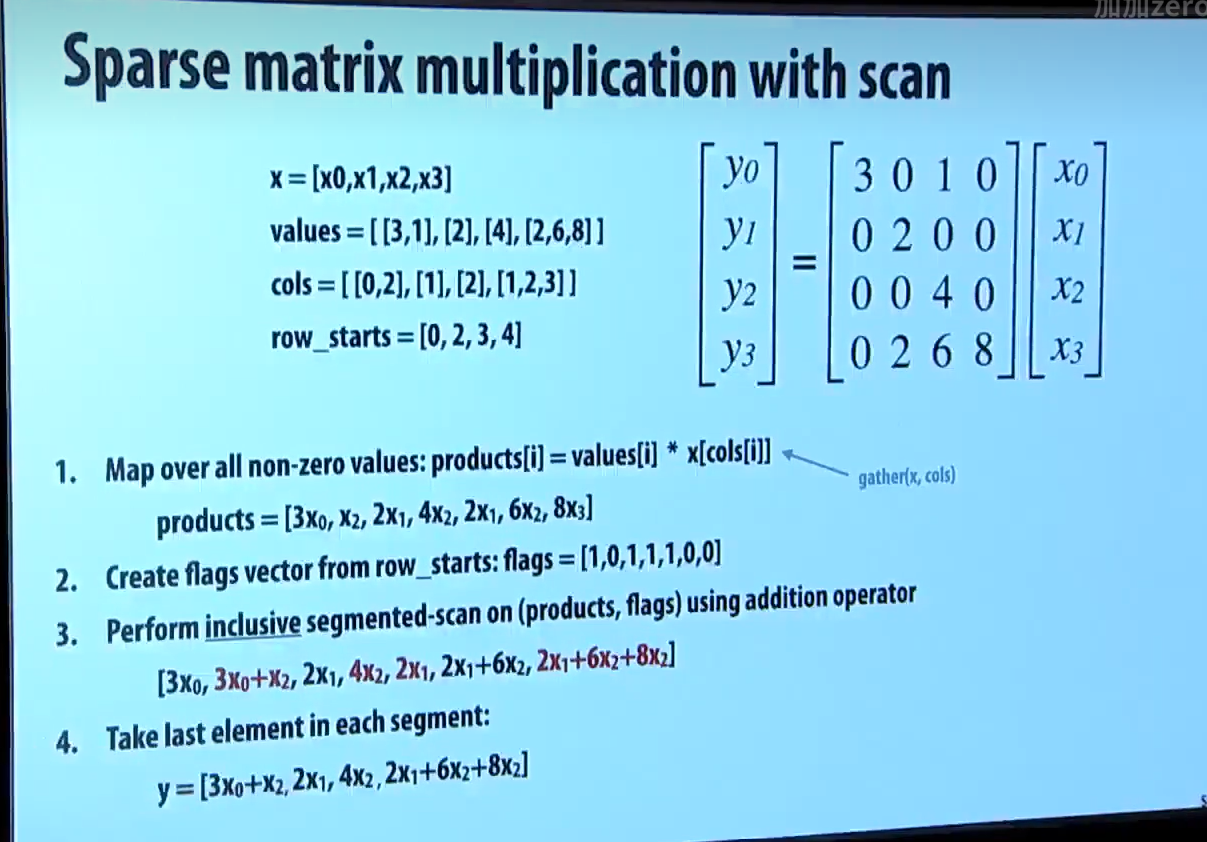
可以把序列的序列转为两个序列,一个 flag 和 一个 data,这样方便我们做并行化。
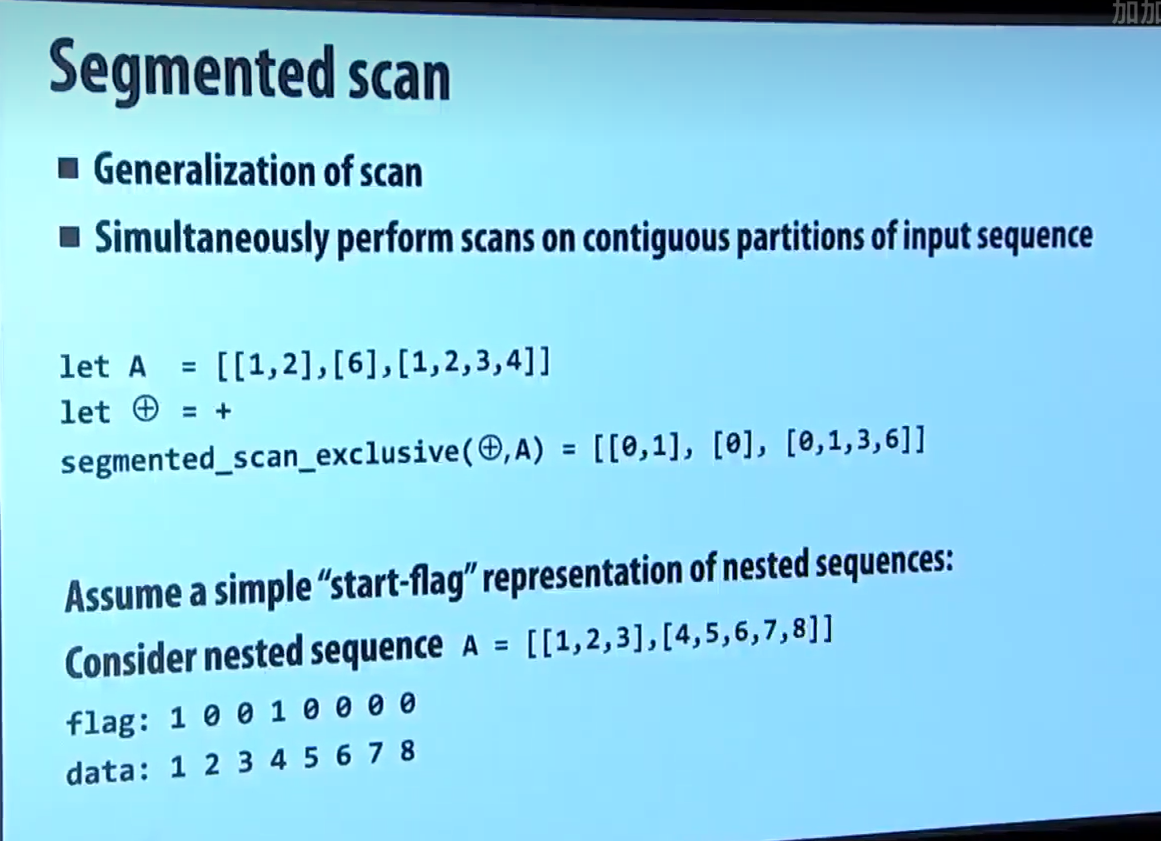
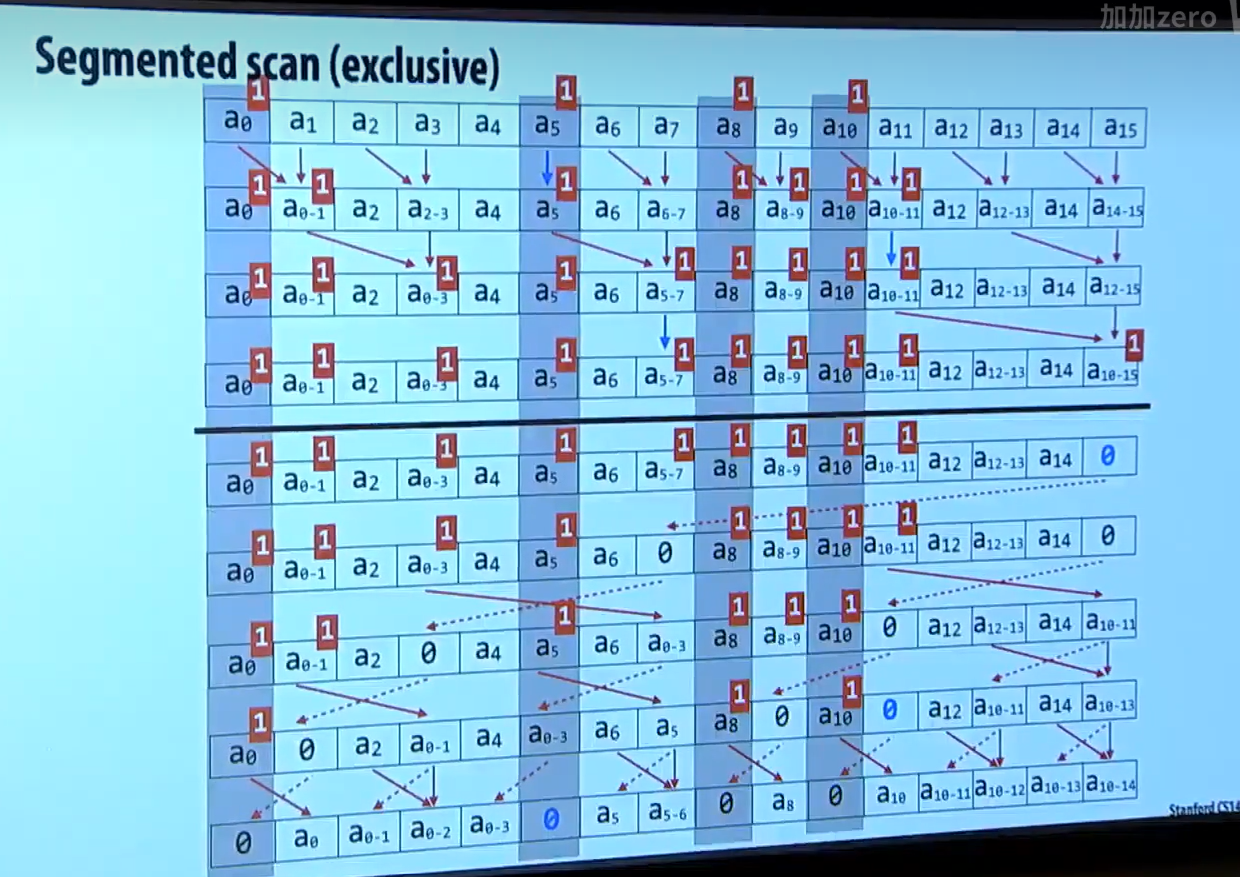
切片扫描实际上很简单,就是之前的算法加上 “屏障”,屏障由之前的 flag 序列得到。
当之前的算法遇到数据传播时,如果中间有屏障,那么则不做传播。
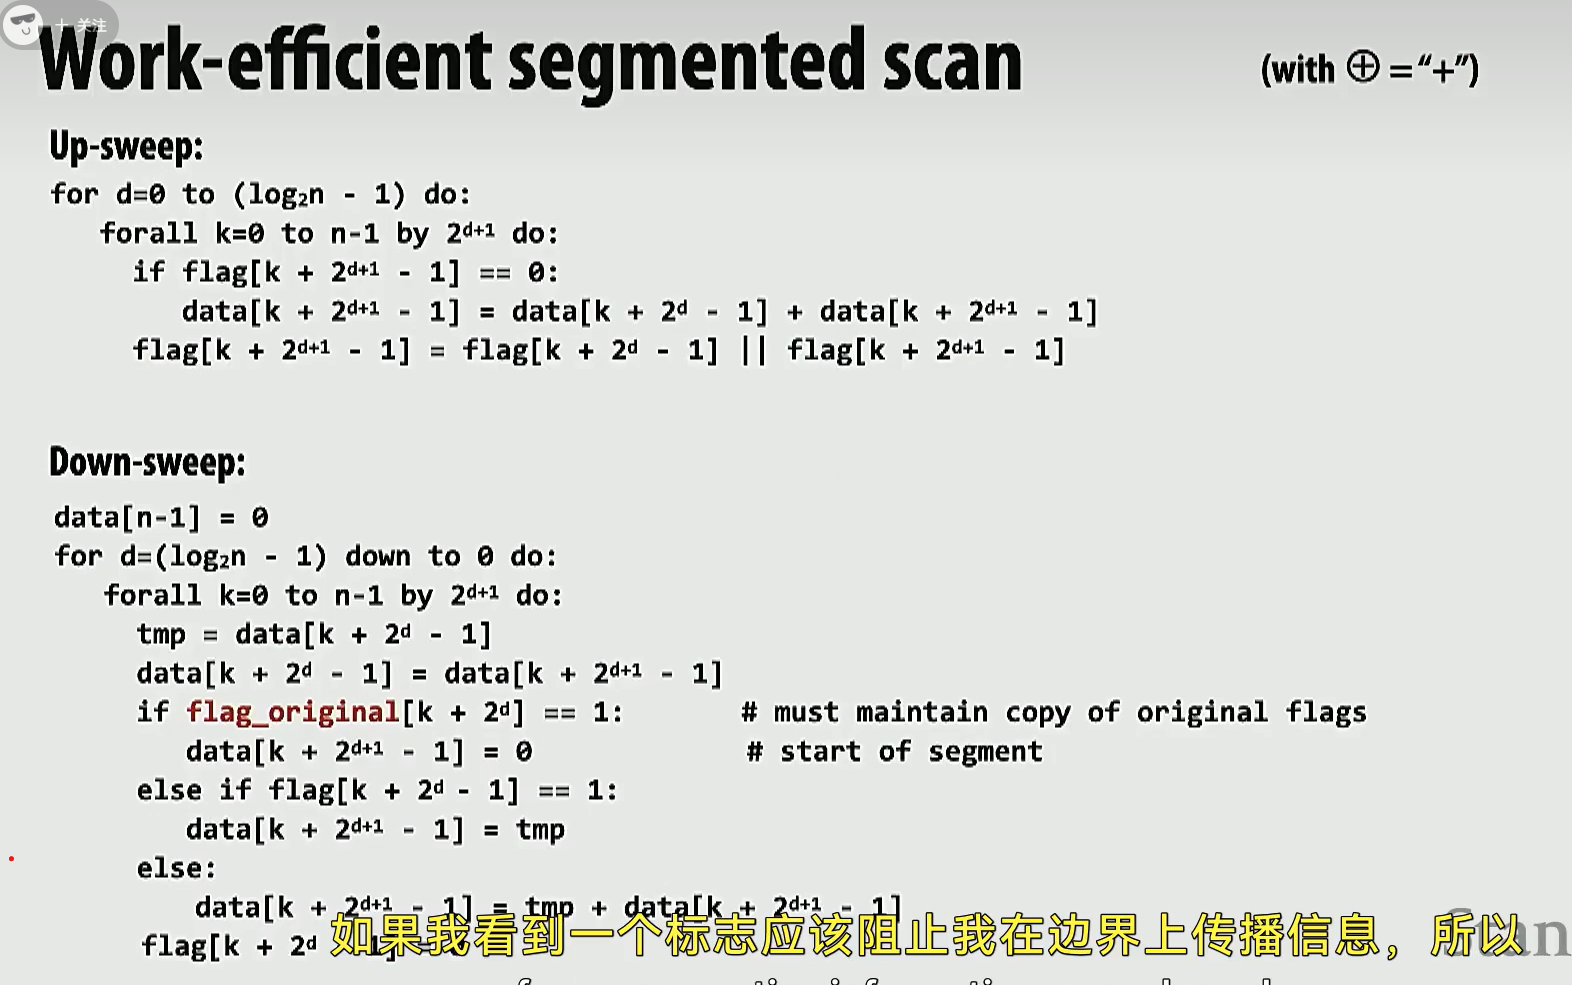
如果看伪代码,会发现就是原算法多了一些 if else:
再举个序列的序列的例子:
稀疏矩阵:大部分元素是 0 的矩阵。
如果把稀疏矩阵完整存储,占用空间很大,因此通常采用压缩方式存储。
压缩稀疏行:行优先的压缩方式。
values = [每一行的非零值序列]
cols = [每一行的非零值所在的列数序列]
row_starts = [没懂,估计 PPT 写错了]
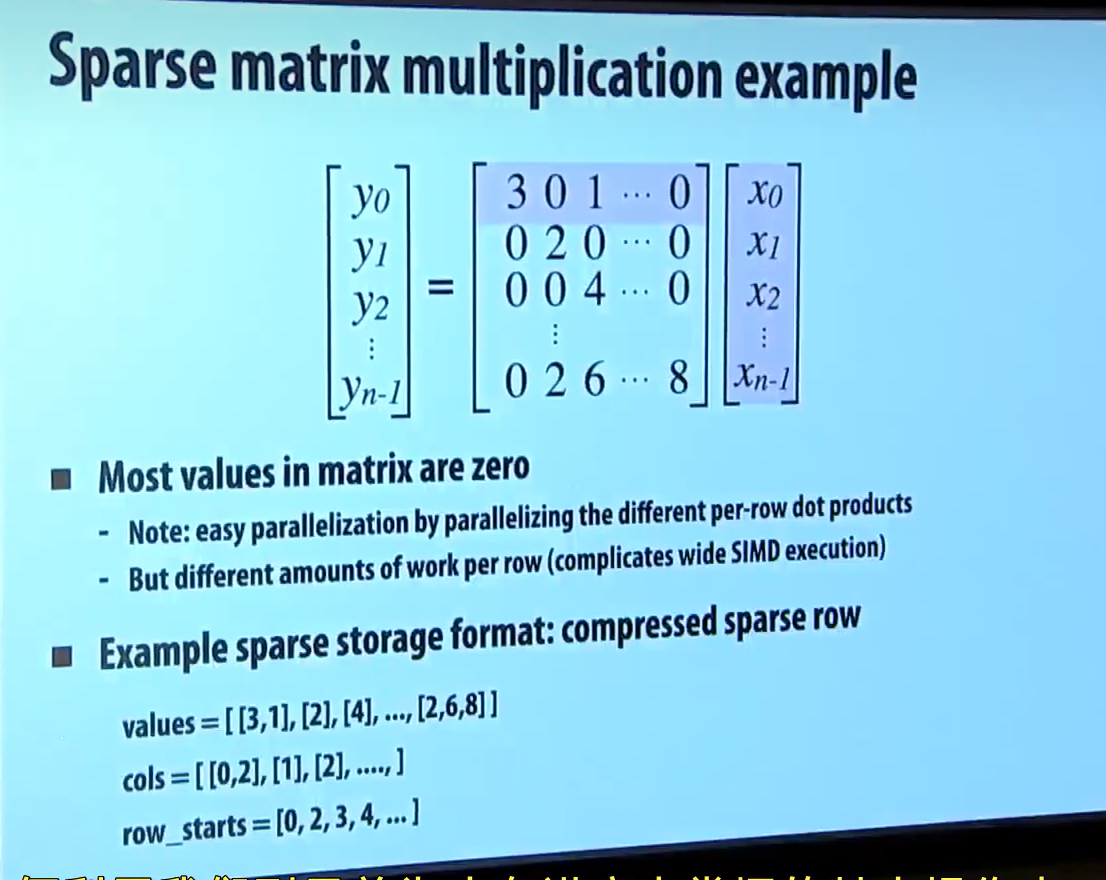
如下图是使用切片扫描 + map 实现的稀疏矩阵乘法。
简单了解即可,不用过于深入
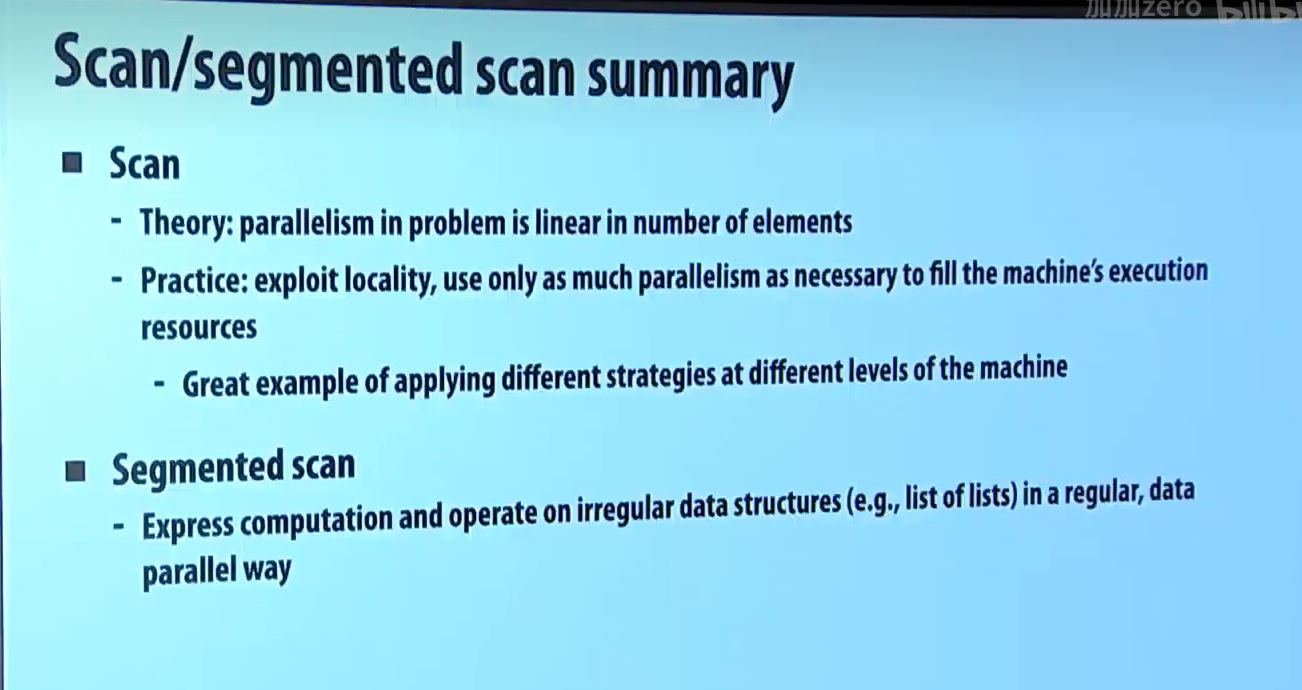
下面是扫描和切片扫描的总结
还有两个基本操作是收集和分散 gather and scatter
根据下面两张图你基本能直到 gather 和 scatter 具体在做什么
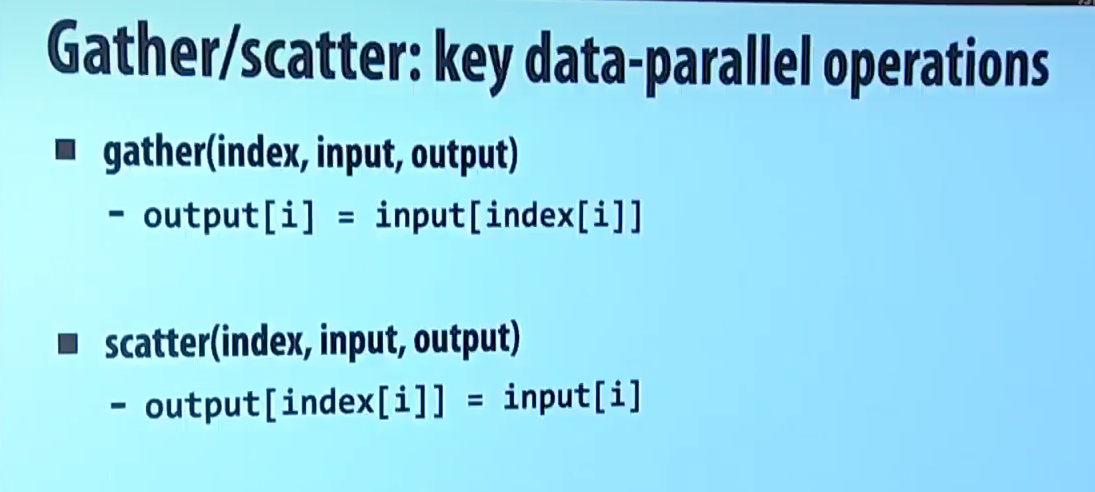
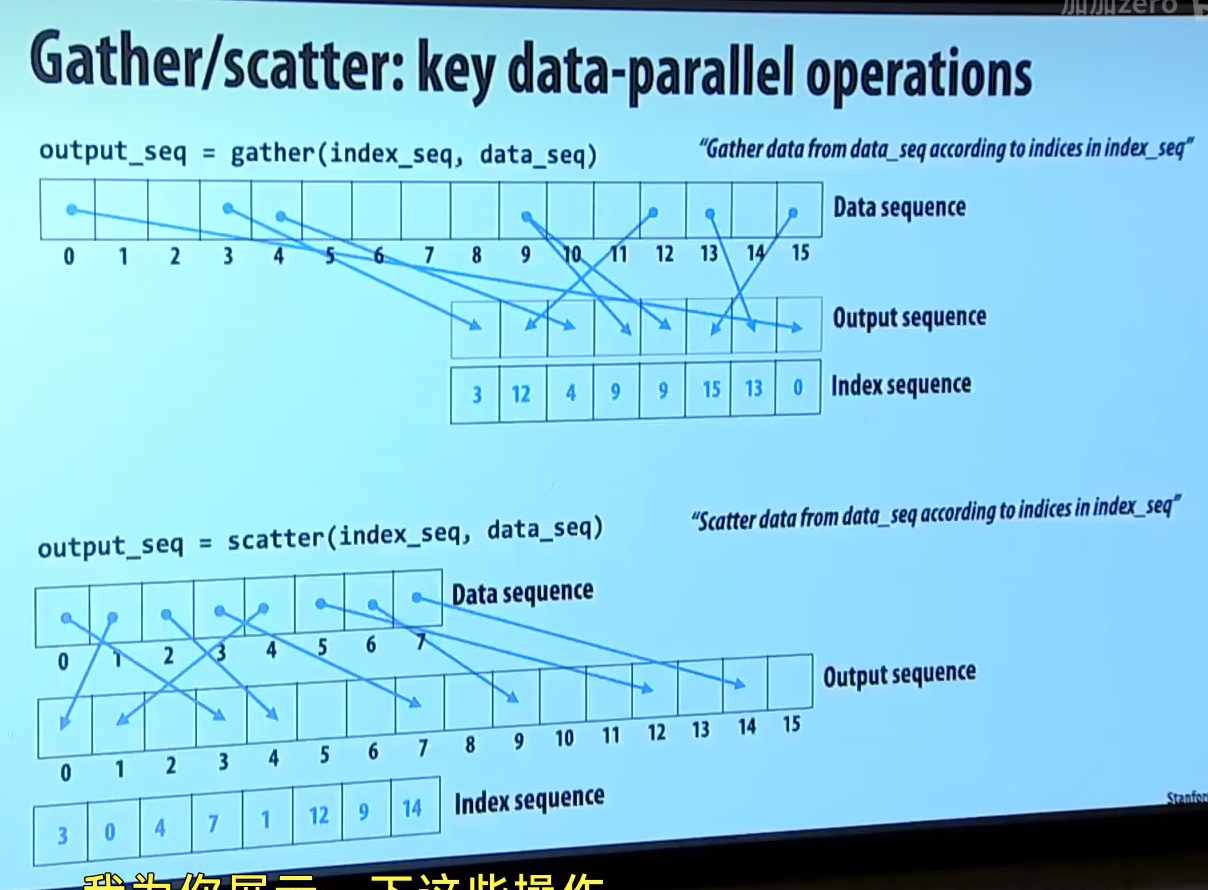
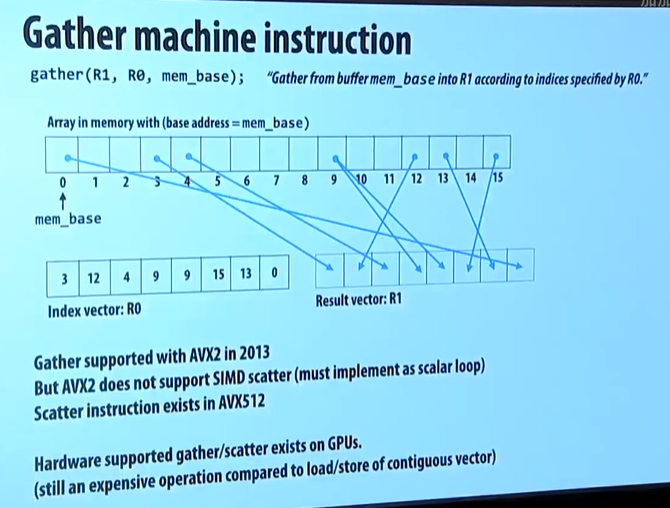
今天的处理器支持 SIMD gather,但不支持 SIMD scatter
GPU 支持 SIMD gather & scatter 指令。
相比传统的 store/load,这是很耗时的操作。因为这是不连续内存的访问, input array 的每个通道都可能导致 cache miss 以及 缺页异常。
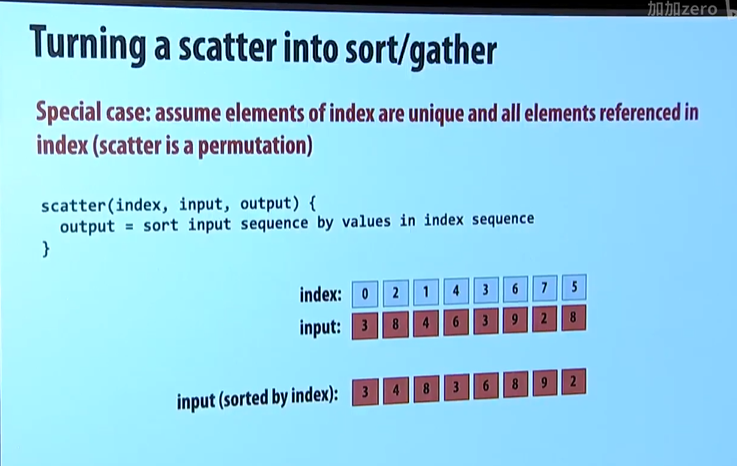
scatter 操作实际上可以由 sort + gather 转化而来
这也是为什么部分平台上仅支持 SIMD gather 但不支持 scatter
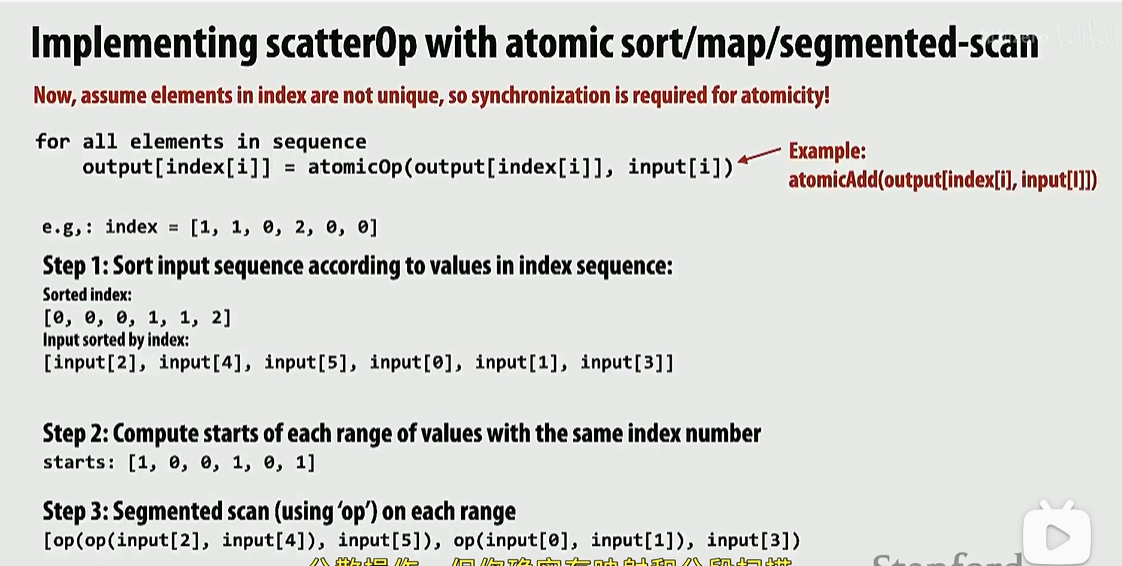
下图是使用 sort + map + segmented-scan 实现 scatter 操作的过程
其它序列操作包括 group, filter, sort 等
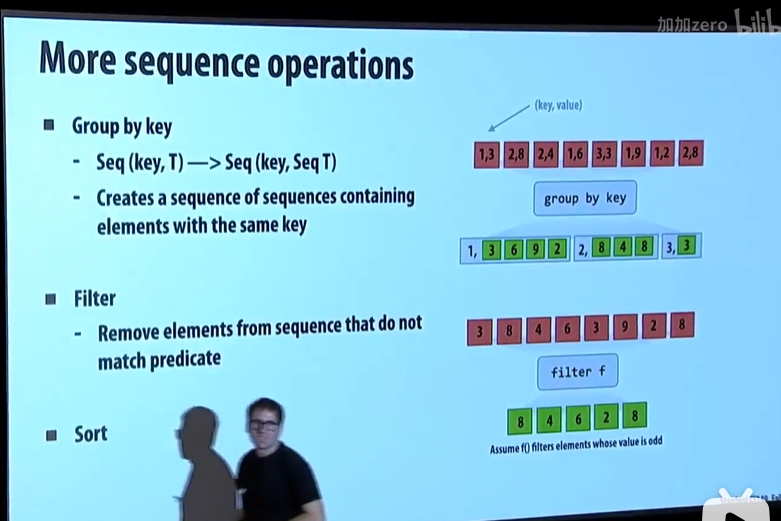
举一个例子来展示我们如何使用这些并行原语:
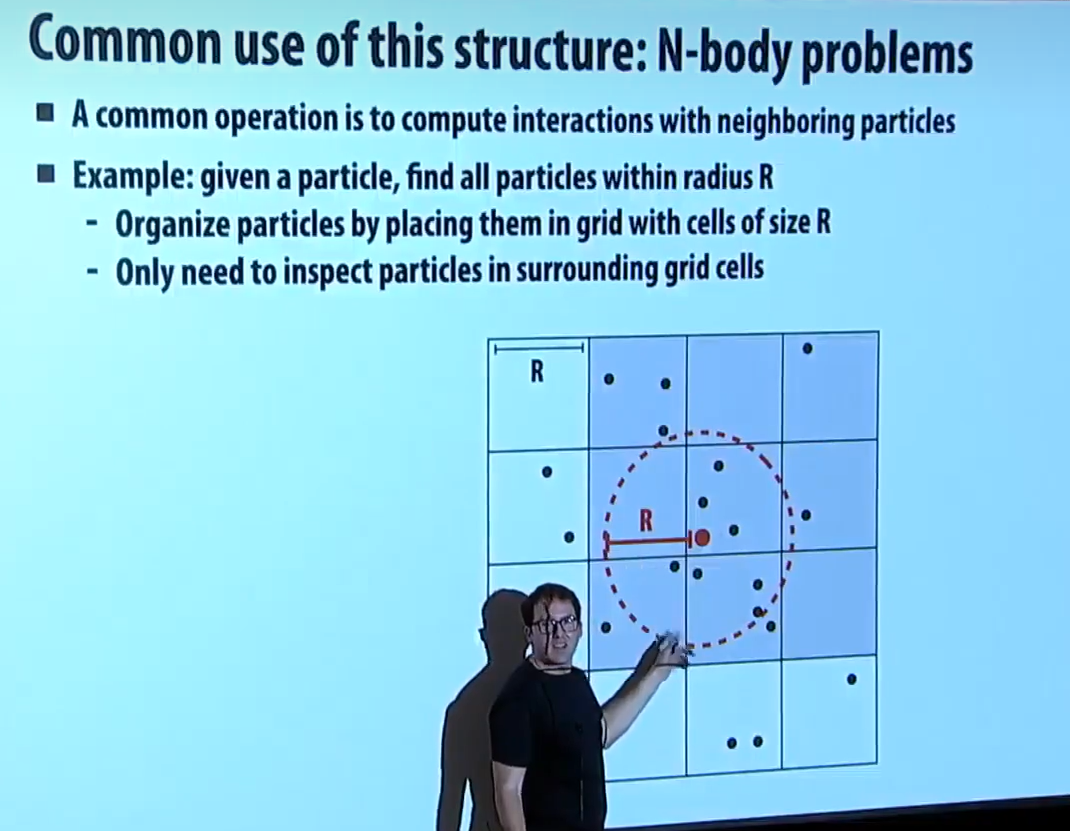
如下图,我们需要把许多粒子分类到各个格子里,从而使得我们能够计算粒子之间的作用力。这在流体力学和天文模拟中很常见。
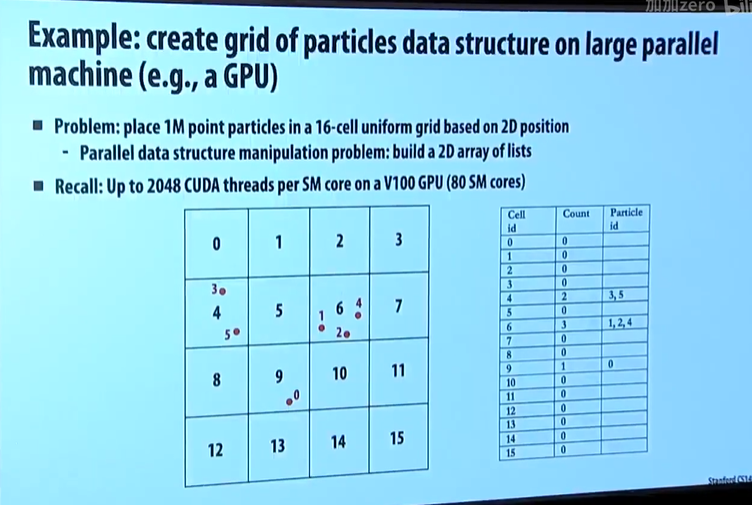
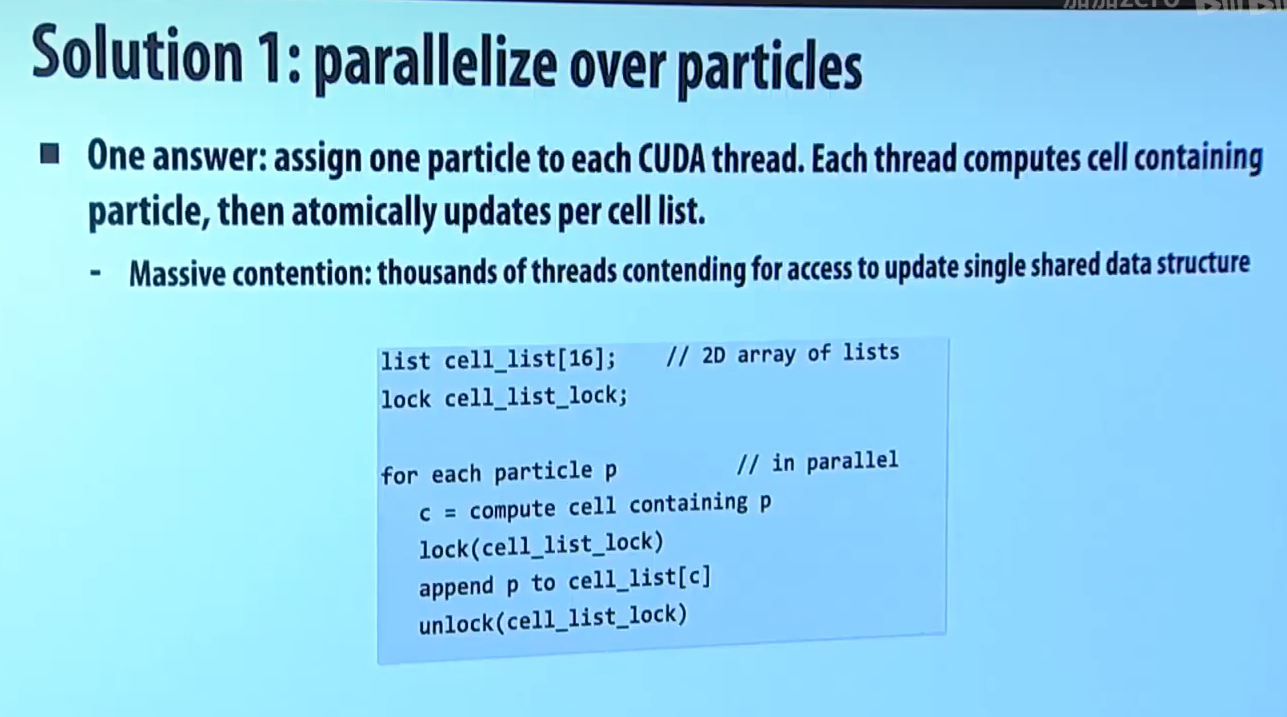
第一个方案:我们维护一个 cell_list 和一个列表锁,随后循环迭代每个例子。通过列表锁来解决数据竞争。
缺点:对于唯一的锁竞争过大,难以扩展到几千线程并行的场景
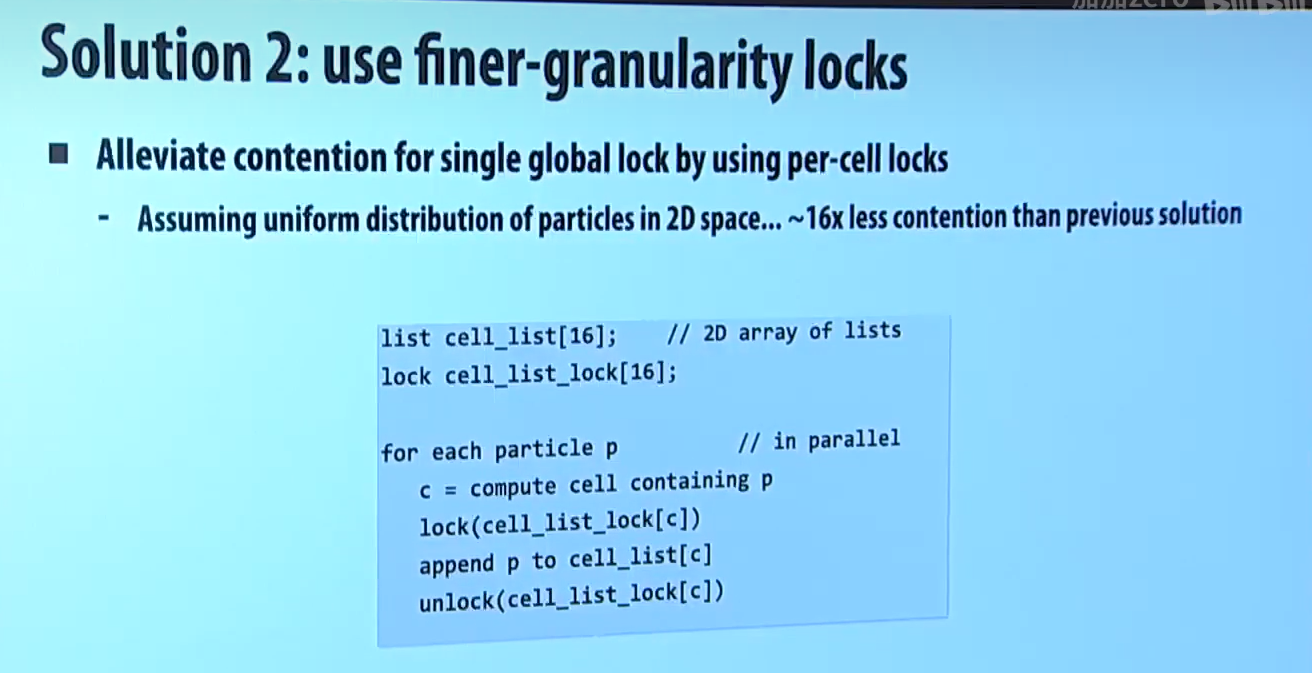
方案2:为每个单元做一个锁是个好主意,相比之前好了很多。
缺点:仍然难以扩展到数千个线程并行的场景
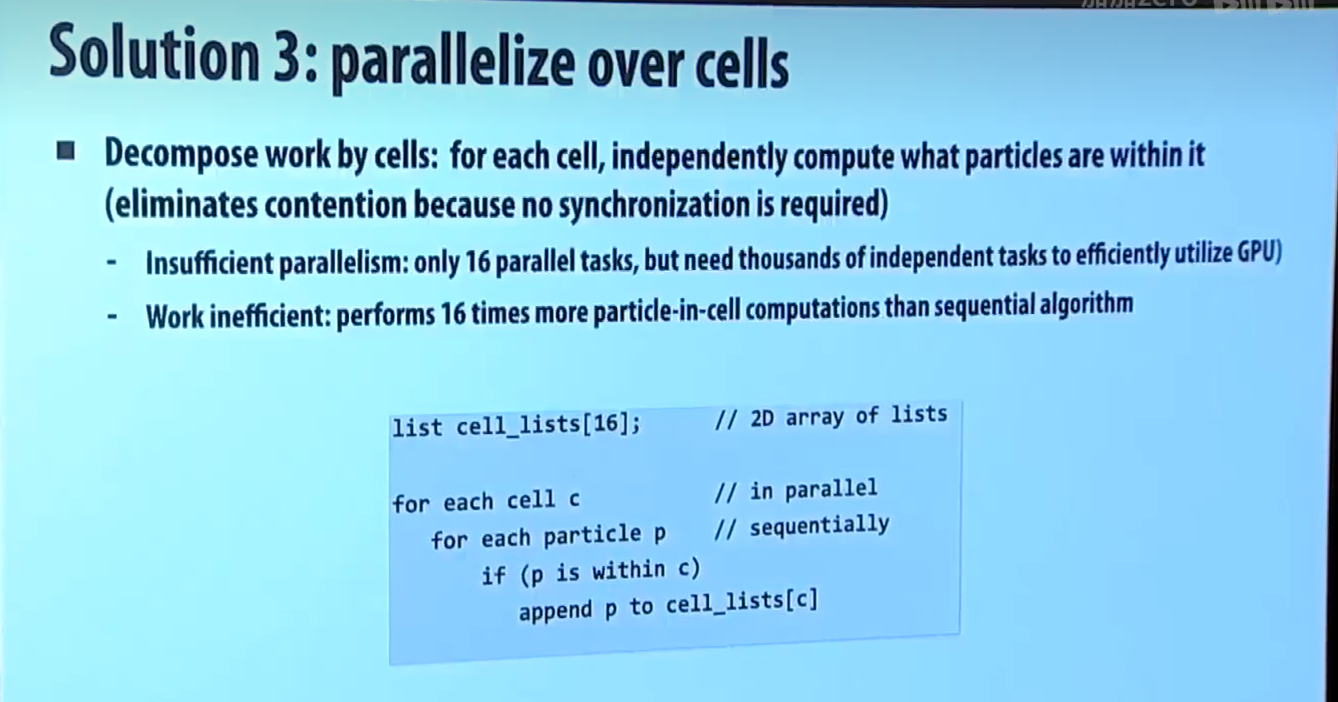
方案3:按照 cell 划分任务,cell 的数量决定了并行程度
缺点:在每个 cell 上都要计算一遍所有粒子,开销大
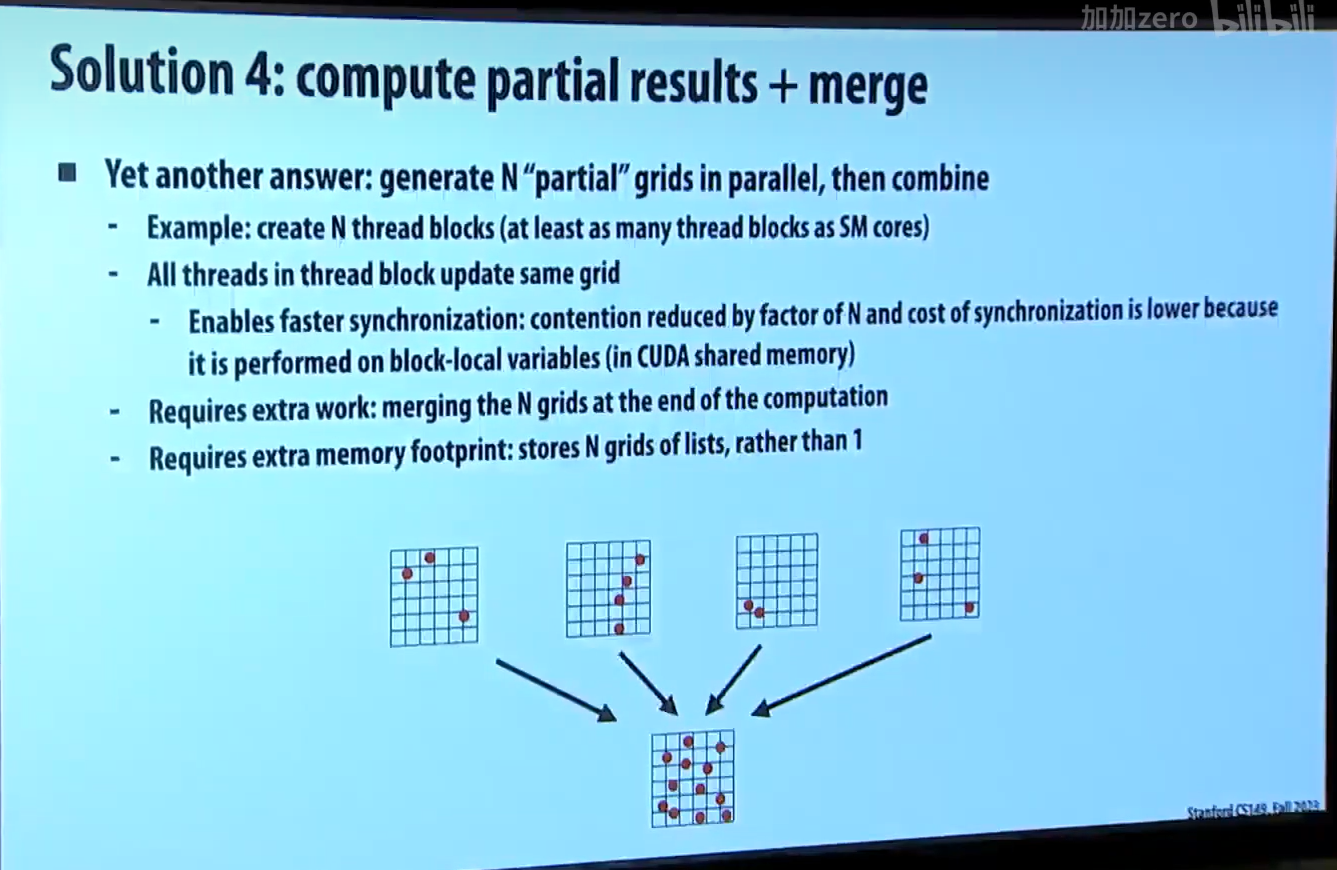
方案4:每个线程维护一个网格副本,计算完自己的部分后合并
缺点:有合并开销,创建网格副本也耗费内存
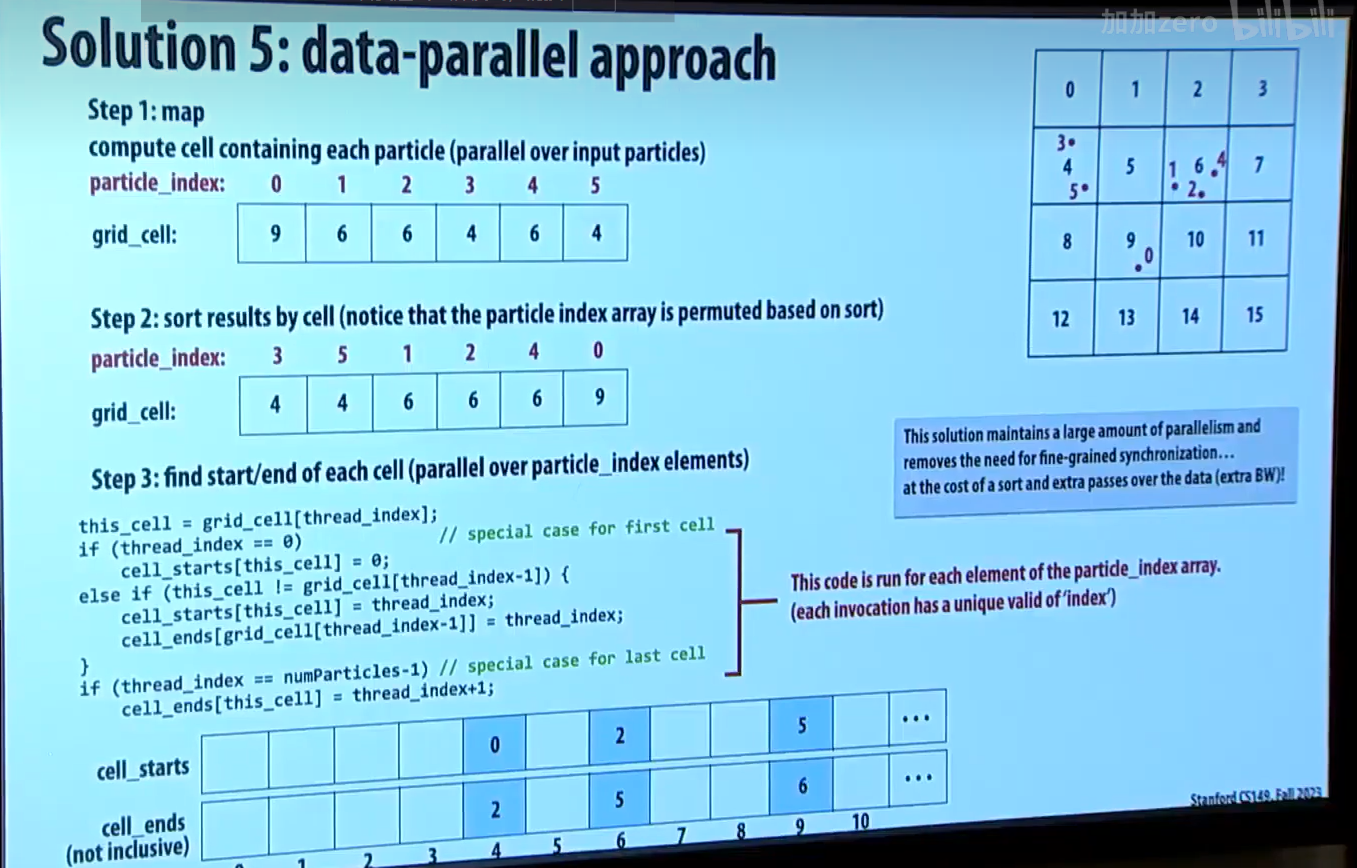
方案5:使用并行原语
step1: 使用 map + cell 计算函数,计算每个例子的网格编号
step2: 使用 sort,根据网格编号排序例子索引
step3: 再次使用 map + start/end 计算函数,计算每个 cell 在例子索引序列里的起始位置和终点位置。
最终,cell_start, cell_end 和 particle_index 三个数组共同成为 “分类结果” 的结果
好处:使用并行原语,利用别人写好的库,有大量并行性。省带宽和内存。
另一个很好的例子是计算直方图,这部分教授没细讲,有需要再了解即可
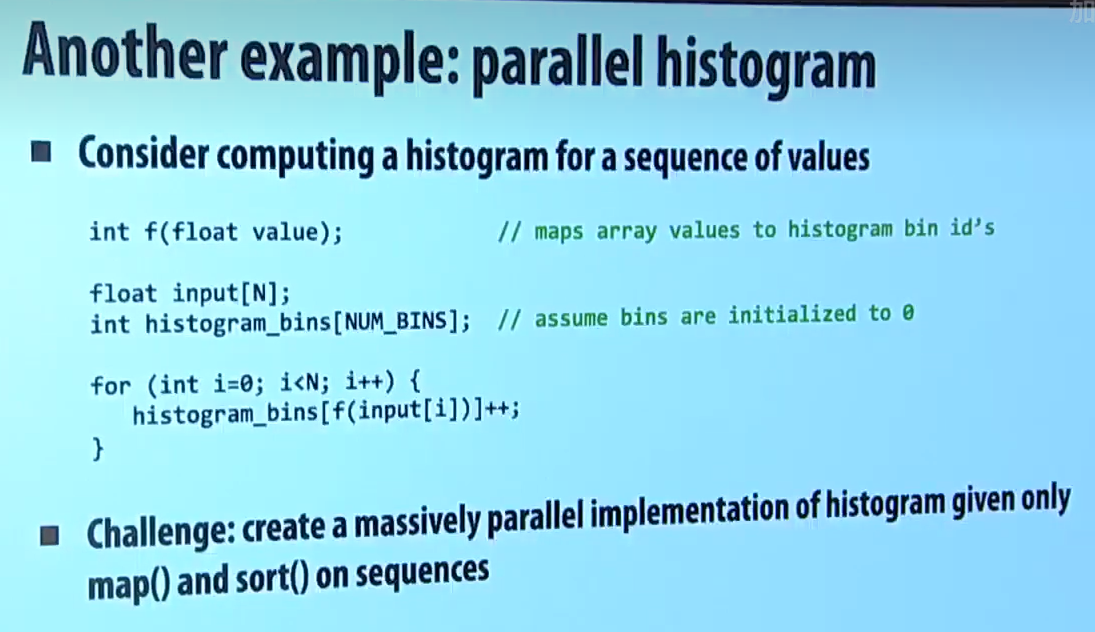
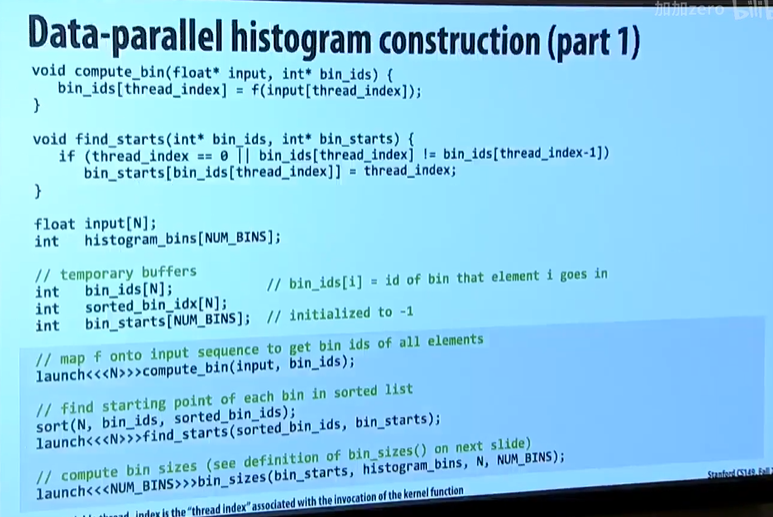
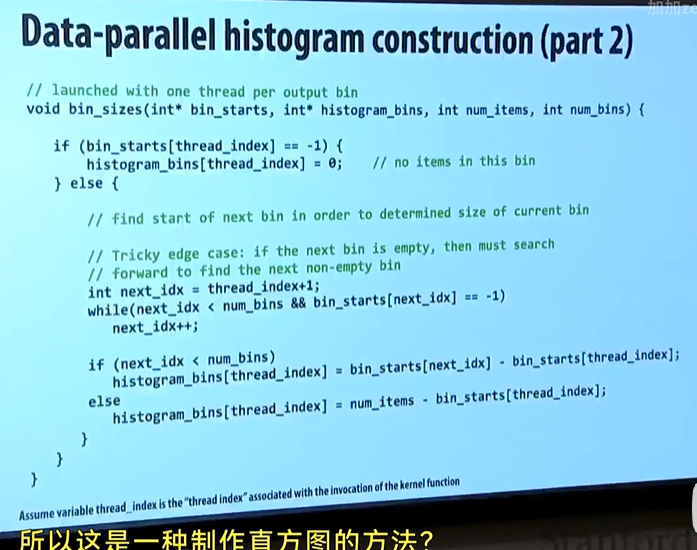
总结:
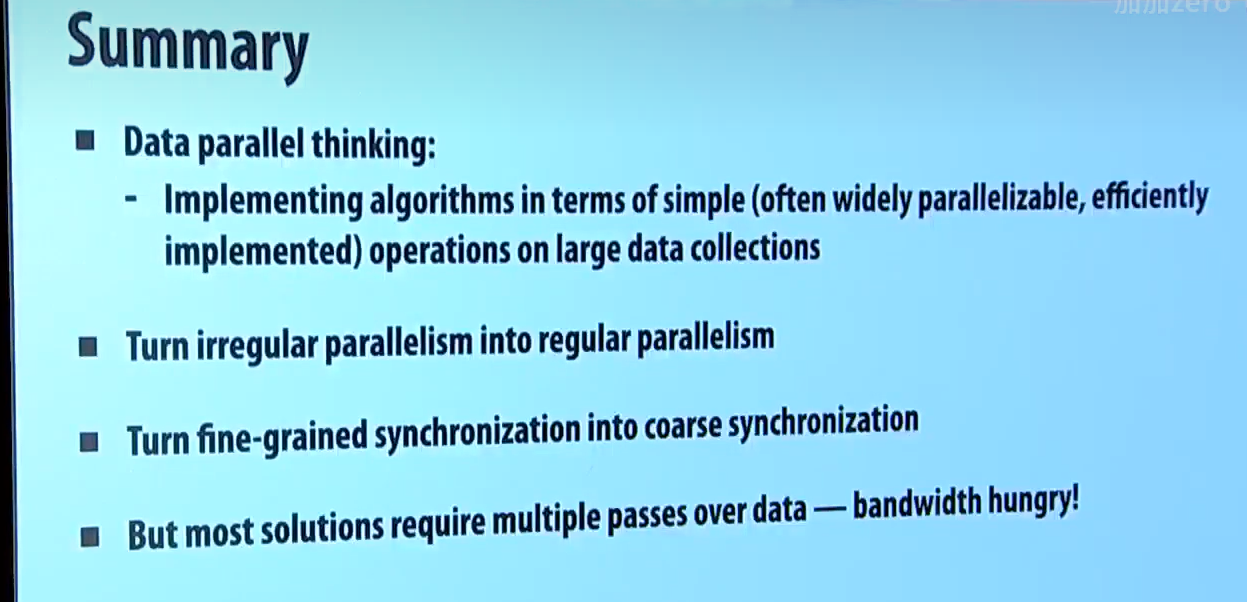
1.所谓数据并行思考,就是使用一些简单的、通常可大量并行化、已经被高效实现的并行源语来实现我们的算法。
2.有时候,我们需要把不规则并行转化为规则并行(稀疏矩阵乘法的例子)
3.大部分的方案可能需要对数据进行多次扫描,这也是为何带宽很重要
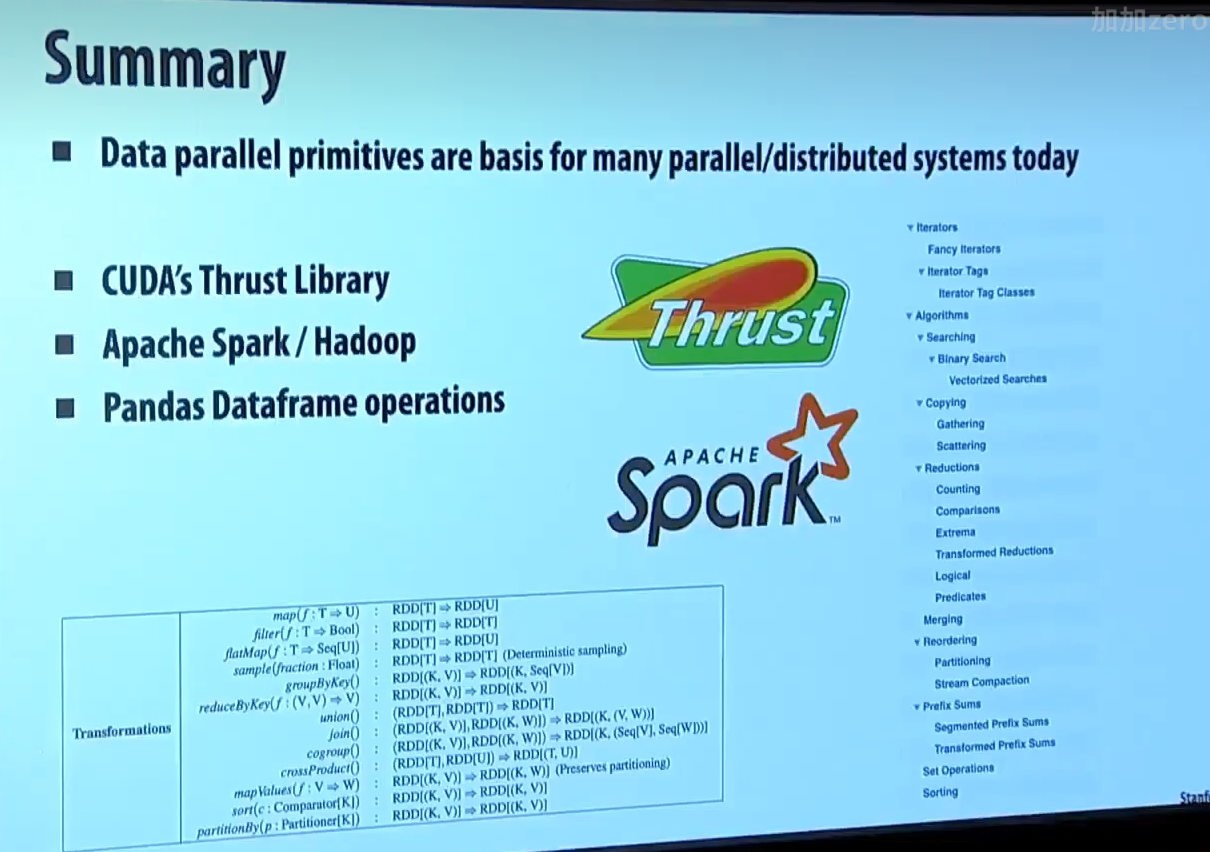
并行原语是今天的 并行/分布式 系统库的基础。
典型的有 CUDA Thrust 库,这是并行库
还有 Apache Spark / Hadoop 等并行/分布式库

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)