0923 AI前沿日报:多模态智能、统一生成框架、机器人现实强化、语音-文本自适应、人机交互澄清等方向
今天给大家带来9月22日的github和huggingface的热点论文项目,精选12篇前沿论文,覆盖多模态智能、统一生成框架、机器人现实强化、语音-文本自适应、人机交互澄清等领域,有需要开源代码和论文的,免费领取。
1、RPG: A REPOSITORY PLANNING GRAPH FOR UNIFIED AND SCALABLE CODEBASE GENERATION
作者:Jane Luo(Microsoft)
亮点:针对大语言模型难以从零生成完整代码仓库的问题,提出仓库规划图(RPG)这一持久化表示形式,通过编码能力、文件结构、数据流和函数,统一提案级和实现级规划,替代模糊的自然语言来准确表征复杂软件结构。
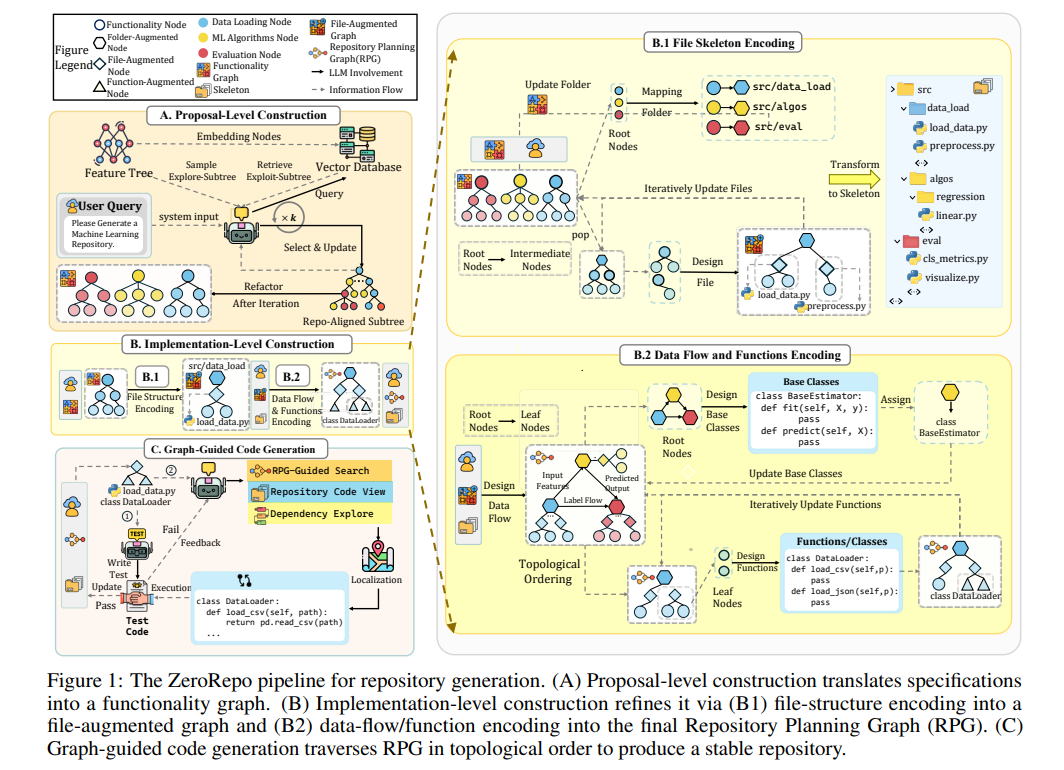
论文:https://arxiv.org/pdf/2509.16198
意义:为大语言模型生成完整、连贯且可靠的代码仓库提供了统一框架,推动代码生成从函数和文件级迈向仓库级,提升复杂软件开发效率。
2、MANZANO: A Simple and Scalable Unified Multimodal Model with a Hybrid Vision Tokenizer
作者:Yanghao Li(Apple)
亮点:为解决现有开源多模态大语言模型在理解和生成视觉内容能力间存在性能权衡的问题,提出Manzano框架,结合混合图像分词器与精心设计的训练方案,通过单个共享视觉编码器为图像到文本理解和文本到图像生成分别提供轻量级适配器,在通用语义空间内实现两种能力的协同。
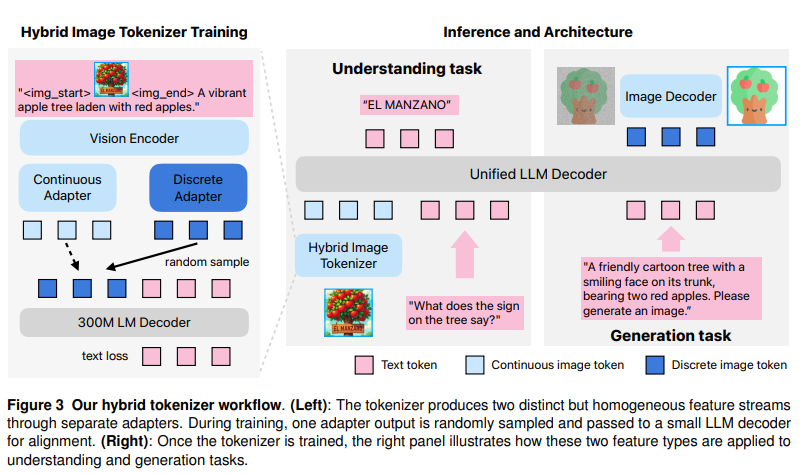
论文:https://arxiv.org/pdf/2509.16197
意义:大幅缓解多模态模型在视觉内容理解与生成间的性能矛盾,为构建简单、可扩展且高效的统一多模态模型提供了有效方案。
3、Latent Zoning Network: A Unified Principle for Generative Modeling, Representation Learning, and Classification
作者:Zinan Lin(Microsoft Research)
亮点:针对生成建模、表示学习和分类这三大机器学习核心问题的最优解决方案相互独立的现状,提出潜在分区网络(LZN),构建共享高斯潜在空间以编码所有任务的信息,并为每种数据类型配备相应机制,实现三大任务的统一处理。
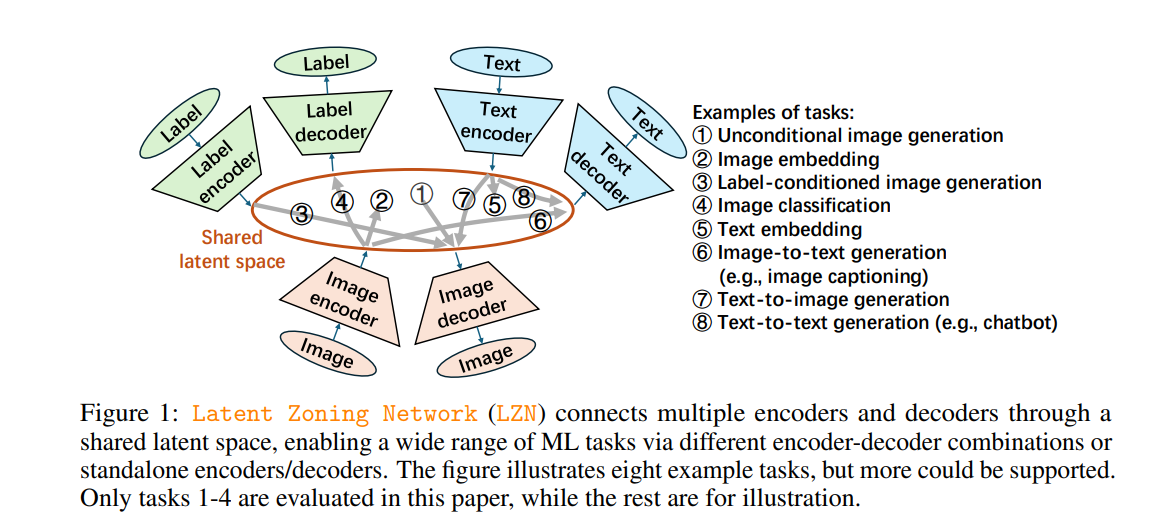
论文:https://arxiv.org/pdf/2509.15591
项目:https://github.com/microsoft/latent-zoning-networks
意义:为机器学习领域提供了统一处理三大核心任务的新原则,有助于简化机器学习流程,促进不同任务间的协同增效。
4、BaseReward: A Strong Baseline for Multimodal Reward Model
作者:Yi-Fan Zhang(ByteDance)
亮点:针对当前缺乏构建最先进多模态奖励模型(MRM)系统指南的问题,通过对MRM开发流程中奖励建模范式、奖励头架构、训练策略、数据整理、骨干模型及集成方法等关键组件的全面实验分析,提出BaseReward基准,基于Qwen2.5-VL骨干模型,采用优化的两层奖励头,在精心整理的高质量多模态数据上训练。
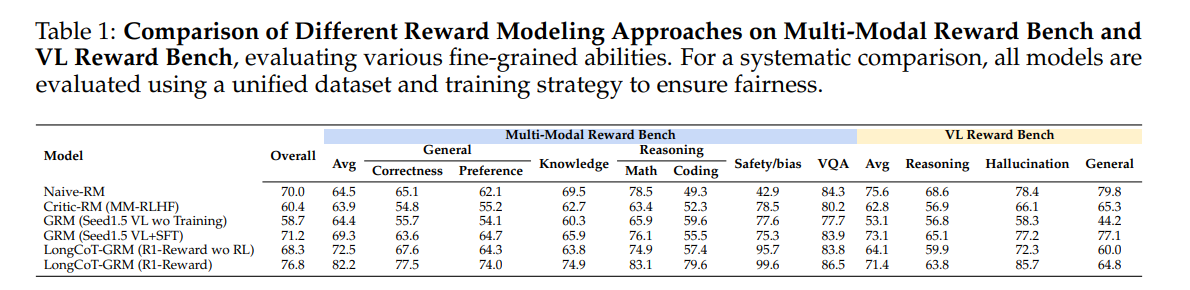
论文:https://arxiv.org/pdf/2509.16127
意义:为多模态奖励模型的构建提供了清晰的“方案”和强大高效的基准,推动多模态大语言模型更好地与人类偏好对齐。
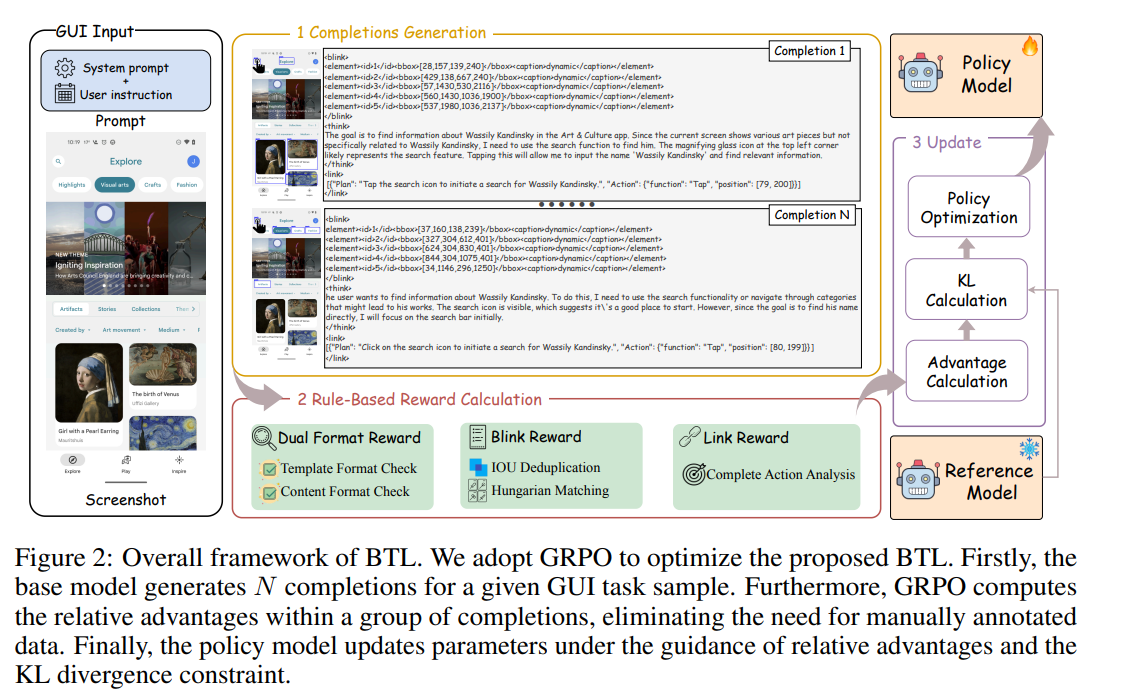
5、BTL-UI: Blink-Think-Link Reasoning Model for GUI Agent
作者:Shaojie Zhang(Xiaomi Inc)
亮点:针对AI驱动的人机GUI交互自动化中,现有模型交互逻辑与人类自然GUI沟通模式偏差较大的问题,提出受大脑启发的“眨眼-思考-链接”(BTL)框架,将交互分解为快速检测相关屏幕区域(Blink)、高层推理决策(Think)、生成交互动作(Link)三个符合生物特性的阶段。
论文:https://arxiv.org/pdf/2509.15566
项目:https://github.com/xiaomi-research/btl-ui
意义:缩小了AI模型与人类在GUI交互逻辑上的差距,提升人机GUI交互的自然性和自动化效率,推动AI驱动的GUI交互技术发展。
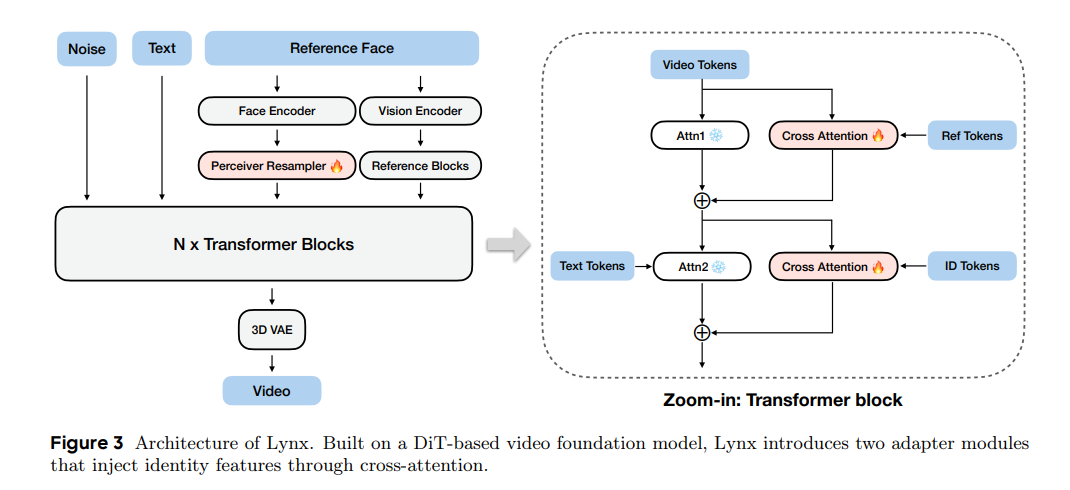
6、ByteDance Lynx: Towards High-Fidelity Personalized Video Generation
作者:Shen Sang(ByteDance)
亮点:为实现从单张输入图像生成高保真个性化视频,基于开源扩散Transformer(DitT)基础模型,提出Lynx模型,引入两个轻量级适配器——ID适配器通过感知器重采样器将ArcFace衍生的面部嵌入转换为紧凑身份令牌用于条件控制,Ref适配器整合冻结参考路径的密集VAE特征,通过跨注意力在所有Transformer层注入细粒度细节。
论文:https://arxiv.org/pdf/2509.15496
项目:https://byteaigc.github.io/Lynx/
意义:在保证身份保真度的同时,兼顾视频的时间连贯性和视觉真实性,为高保真个性化视频生成提供了有效解决方案,拓展了视频合成的应用场景。
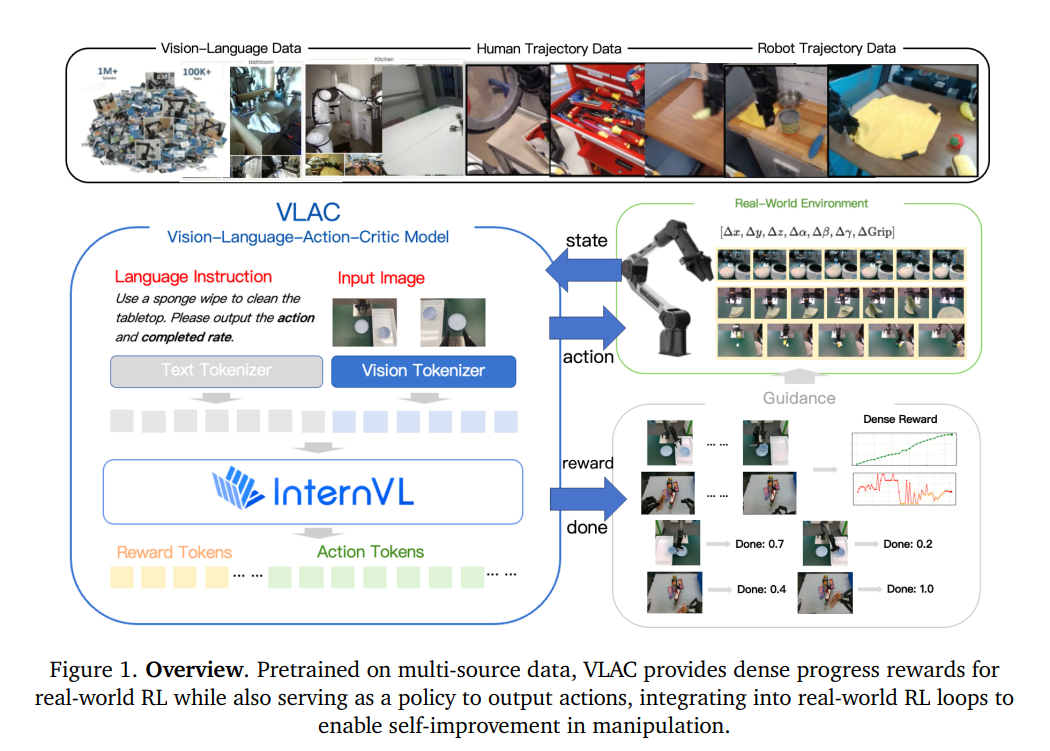
7、A Vision-Language-Action-Critic Model for Robotic Real-World Reinforcement Learning
作者:Shaopeng Zhai(Shanghai AI Lab)
亮点:针对机器人现实世界强化学习(RL)中视觉-语言-动作(VLA)模型面临稀疏手工奖励和低效探索的瓶颈,提出VLAC模型,基于InternVL构建通用过程奖励模型,在大规模异构数据集上训练,能根据成对观测和语言目标输出密集进度增量和完成信号,支持零样本上下文迁移到未见过的任务和环境,且通过提示控制统一评论家与策略。
论文:https://arxiv.org/pdf/2509.15937
项目:https://github.com/InternRobotics/VLAC
意义:无需任务特定奖励设计,加速机器人在现实世界中的探索并稳定早期学习过程,推动机器人现实世界强化学习技术的实用化。
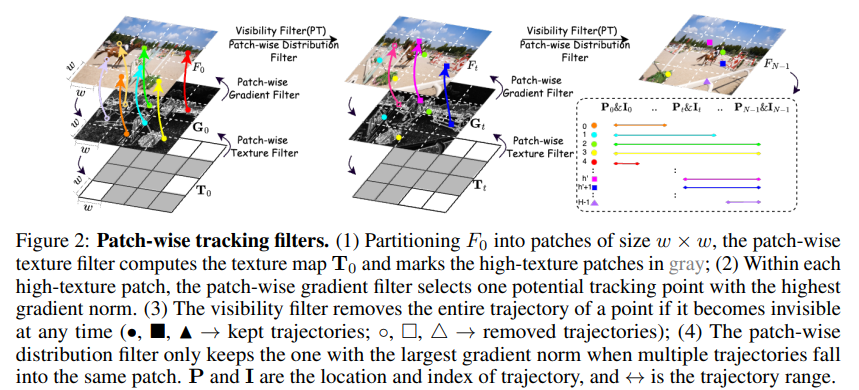
8、RGB-Only Supervised Camera Parameter Optimization in Dynamic Scenes
作者:Fang Li(University of Illinois at Urbana-Champaign)
亮点:聚焦动态场景中仅利用RGB数据进行有监督相机参数优化的问题,提出相应技术方案,在缺乏其他传感器数据的情况下,实现动态场景中相机参数的有效优化。
论文:https://arxiv.org/pdf/2509.15123
意义:降低了动态场景中相机参数优化对多传感器数据的依赖,为仅能获取RGB数据的场景提供了相机参数优化的有效途径,拓展了相机参数优化技术的应用范围。
9、DO YOU HEAR WHAT I MEAN? QUANTIFYING THE INSTRUCTION-PERCEPTION GAP IN INSTRUCTION-GUIDED EXPRESSIVE TEXT-TO-SPEECH SYSTEMS
作者:Yi-Cheng Lin(National Taiwan University)
亮点:针对指令引导式情感文本转语音(ITTS)系统中用户风格指令与听众感知对齐问题未被充分探索的现状,对ITTS系统在程度副词和分级情感强度两个情感维度的可控性进行感知分析,收集说话人年龄和词级强调属性的人类评分,构建大规模人类评估数据集E-VOC,并揭示了各ITTS模型的表现差异及现存挑战。
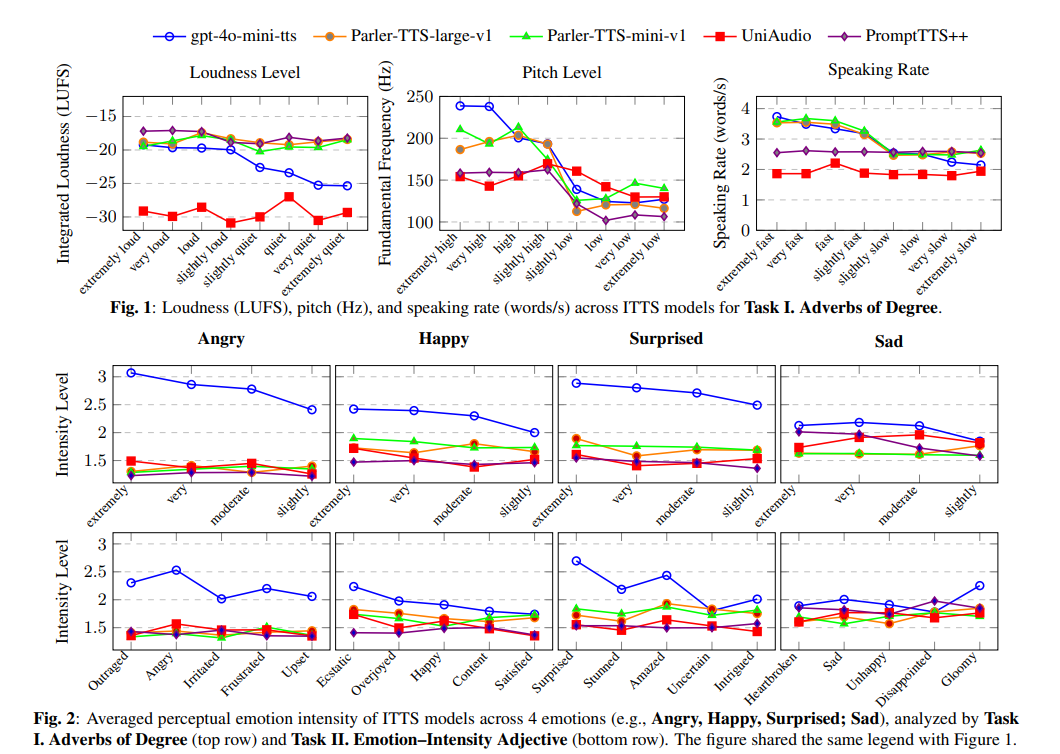
论文:https://arxiv.org/pdf/2509.13989
意义:量化了ITTS系统的指令-感知差距,为ITTS系统的优化提供了数据支撑和方向指引,有助于提升ITTS系统的用户体验和可控性。
10、Video2Roleplay: A Multimodal Dataset and Framework for Video-Guided Role-playing Agents
作者:Xueqiao Zhang(Zhejiang University)
亮点:针对现有角色扮演智能体(RPA)多关注静态角色档案、忽略人类动态感知能力的问题,提出将视频模态融入RPA以构建动态角色档案的理念,构建包含60k视频和700k相关数据的大规模高质量数据集Roleplaying-Video60k,并设计相应框架支持视频引导的角色扮演。
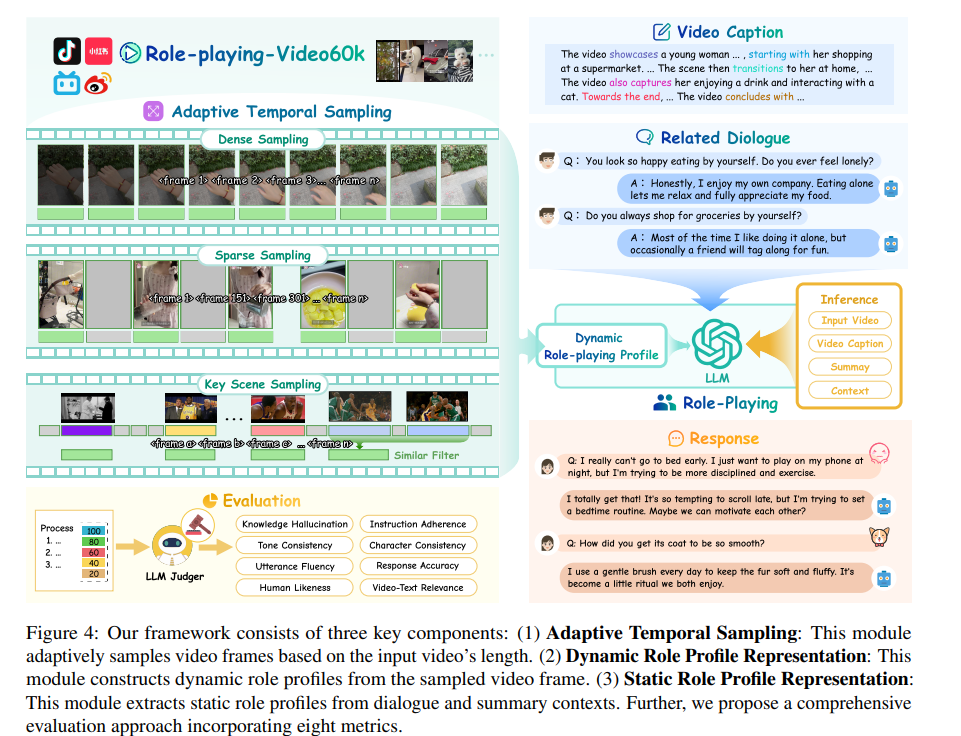
论文:https://arxiv.org/pdf/2509.15233
项目:https://github.com/zxqSled/Video2Roleplay
意义:丰富了角色扮演智能体的感知维度,提升了其交互的沉浸感和真实性,为视频引导的角色扮演研究提供了重要的数据和框架支持。
11、WHISTLE: DEEPLY SUPERVISED, TEXT-ONLY DOMAIN ADAPTATION FOR PRETRAINED SPEECH RECOGNITION TRANSFORMERS
作者:Akshat Pandey(Comcast Applied AI)
亮点:针对预训练语音识别(ASR)模型在处理未见过的词汇和用语时需领域自适应,且现实中收集语音数据不切实际的问题,提出WhisTLE方法,通过训练变分自编码器(VAE)建模文本的编码器输出,利用学习到的文本到潜在编码器微调解码器(可结合TTS自适应),推理时恢复原始编码器且无额外运行成本。
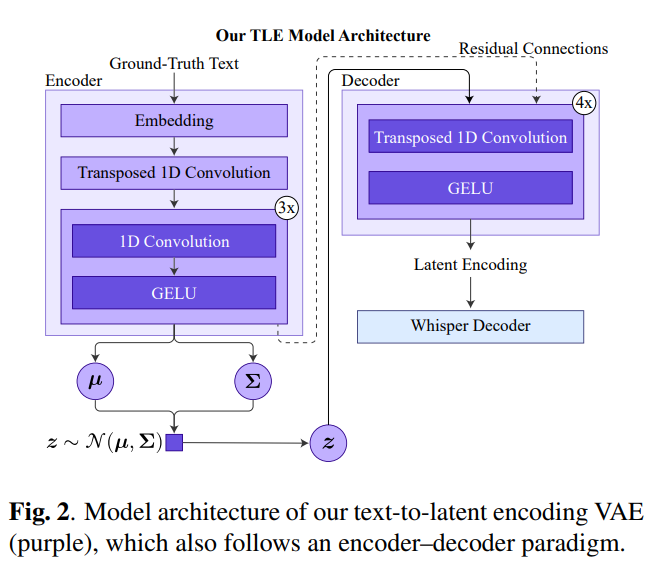
论文:https://arxiv.org/pdf/2509.10452
意义:实现了仅利用文本数据对预训练ASR模型进行领域自适应,降低了ASR模型领域自适应的数据依赖和成本,提升了其在不同领域的适用性。
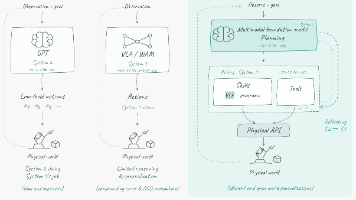
12、Ask-to-Clarify: Resolving Instruction Ambiguity through Multi-turn Dialogue
作者:Xingyao Lin(未明确提及核心机构,合作机构含多个高校及研究团队)
亮点:针对现有基于视觉-语言-动作(VLA)模型的具身智能体多为单向执行指令、无法处理模糊指令的问题,提出Ask-to-Clarify框架,通过多轮对话询问澄清问题解决指令模糊性,再端到端生成底层动作,包含用于协作的视觉-语言模型(VLM)、用于动作生成的扩散模型及连接两者的模块。
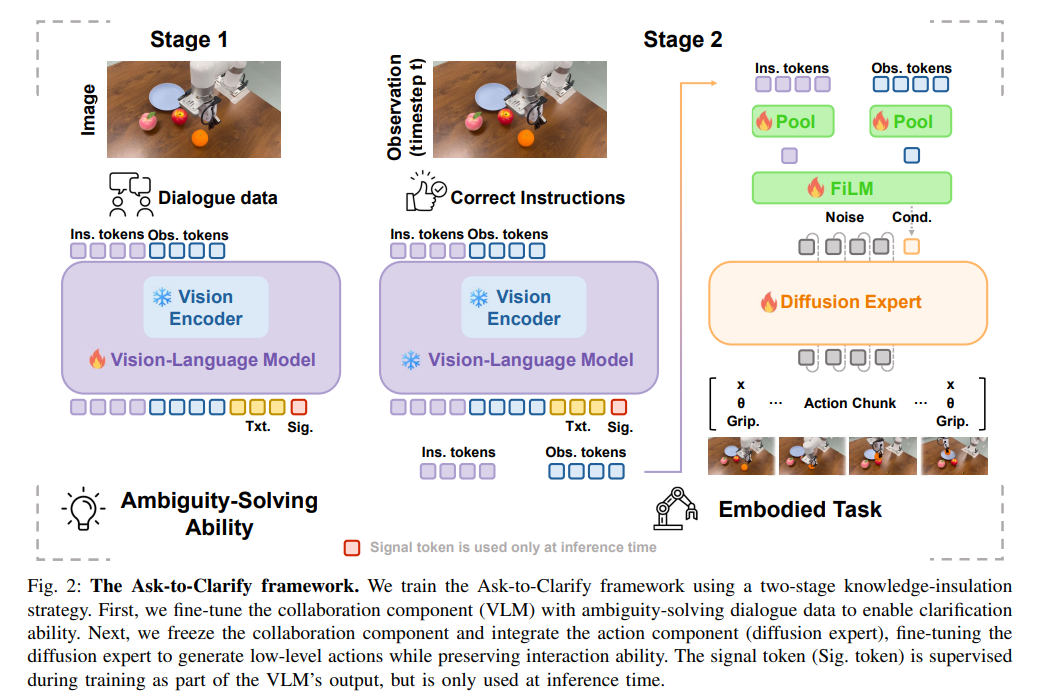
论文:https://arxiv.org/pdf/2509.15061
意义:提升了具身智能体在现实场景中处理模糊指令的能力,推动具身智能体从被动执行器向主动协作伙伴转变,增强了人机交互的有效性。
关注下方《AI前沿速递》🚀🚀🚀
各种重磅干货,第一时间送达
码字不易,欢迎大家点赞评论收藏

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 16
 0
- 0


 已为社区贡献22条内容

所有评论(0)