数学建模学习——相关性分析
目录
一、相关性分析
对变量两两之间的相关程度进行分析
1. 输入输出描述
输入:两个或者两个以上的定量变量或有序定类变量
输出:两两定类变量之间是否呈现显著性相似以及相似的程度
2.案例示例
案例一
- 人的身高和体重之间(两个数值型变量之间的线性关联——线性相关性分析)
- 空气中的相对湿度与降雨量之间的相关关系
- 收入和幸福感之间(变量之间存在关联但并非直线关系——非线性相关性分析)
- 性别与职业选择(两个分类变量间的关联——分类变量相关性分析)
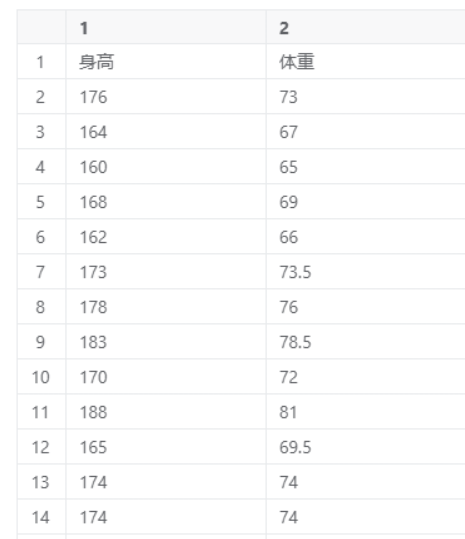
案例二
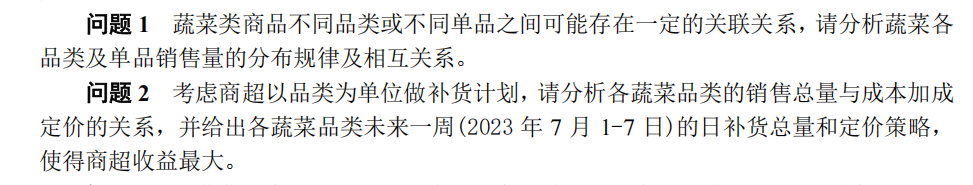
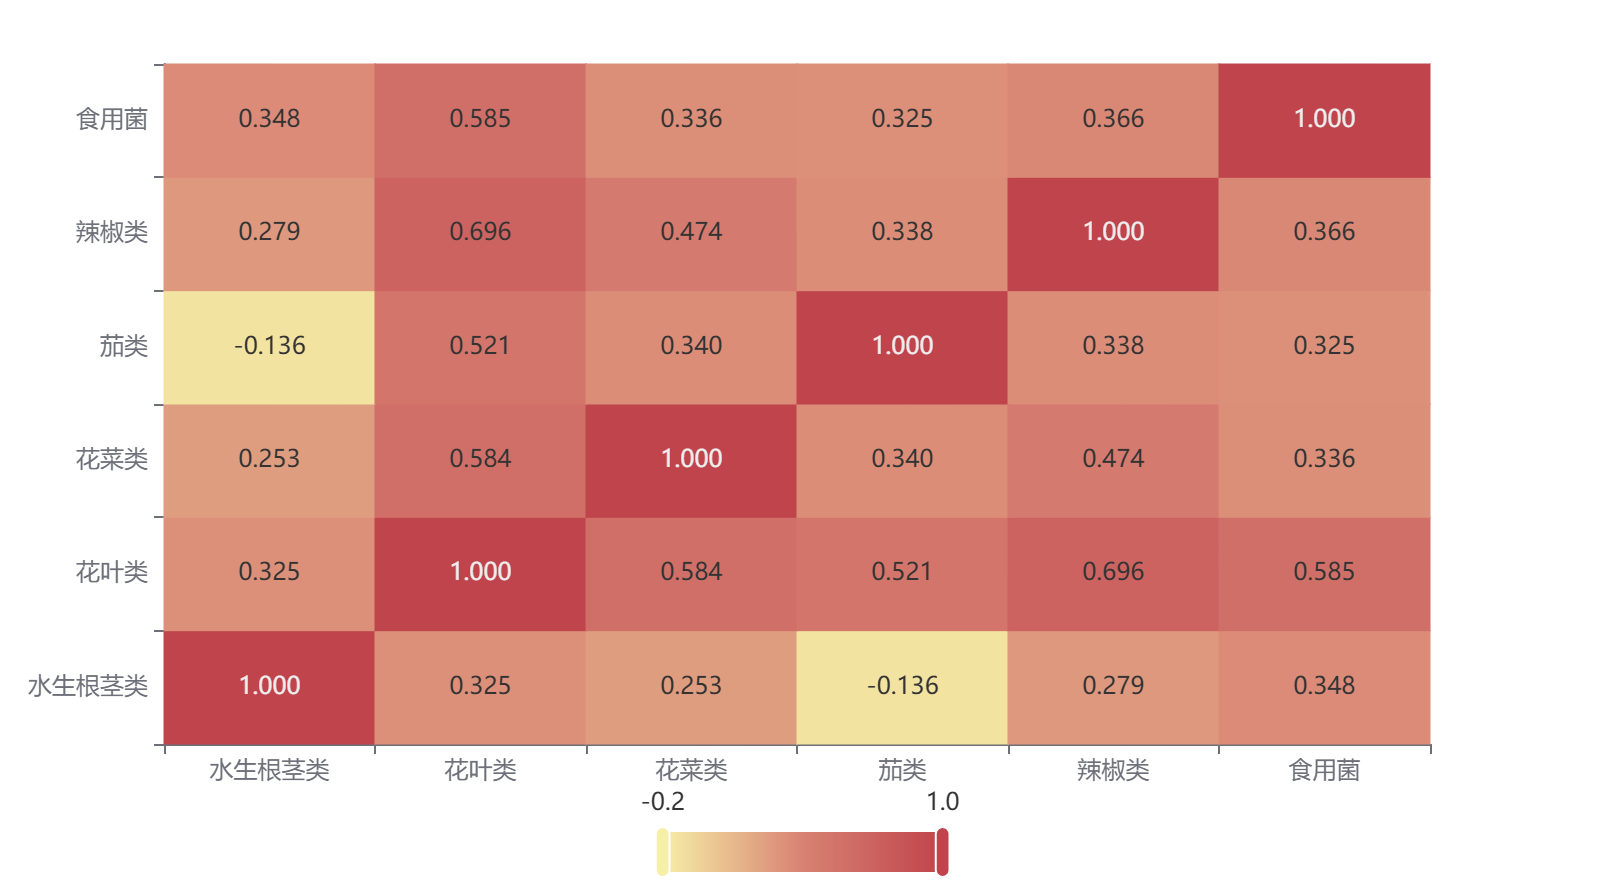
问题1中蔬菜类商品各品类销售量之间的相关关系,采用spearman相关性分析,如下图
二、常见的分析方式
- pearson相关系数
- spearman相关系数
- Kendall’s tau-b 相关系数
三、spearman相关性分析
适用条件:数据不满足正态分布时使用
1)适用条件
- 变量为数值型(含异常值 / 非正态) 或有序分类型
- 变量间存在 “单调关联”(即一个变量增大时,另一个变量持续增大或持续减小,无需是线性)
2)计算逻辑
先将两个变量的原始数据分别排序,得到每个数据的 “排名(Rank)”,再对排名计算皮尔逊相关系数,公式为:
ρ
=
1
−
6
∑
i
=
1
n
t
i
2
n
(
n
2
−
1
)
\rho = 1 - \frac{6\sum_{i = 1}^{n} t_{i}^{2}}{n(n^{2} - 1)}
ρ=1−n(n2−1)6∑i=1nti2
其中,
d
i
d_i
di 为第
i
i
i个样本在两个变量中的排名差,
n
n
n 为样本量
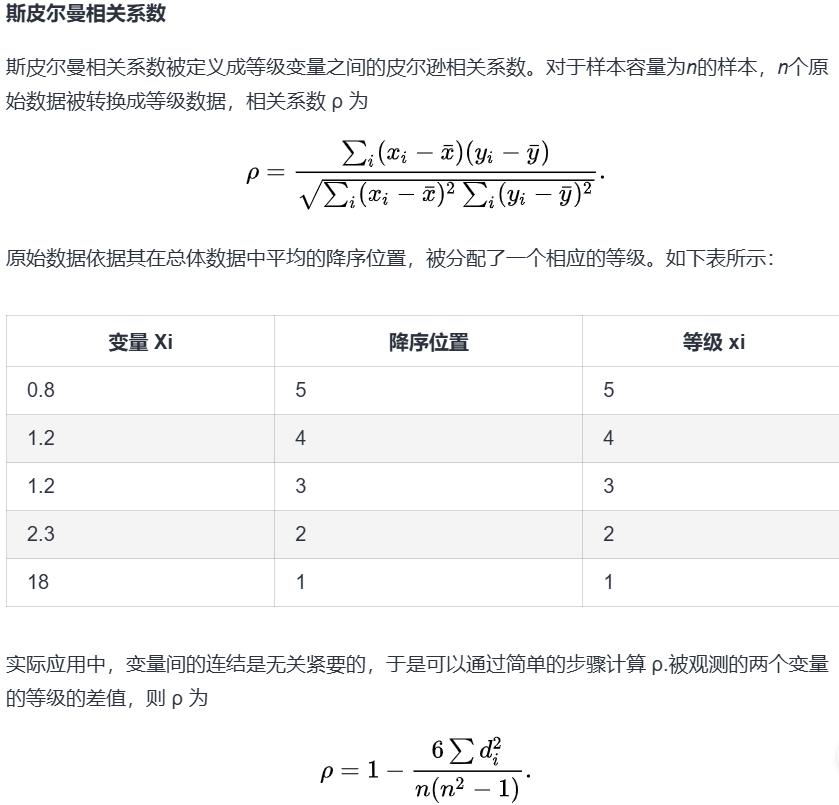
3)显著性检验
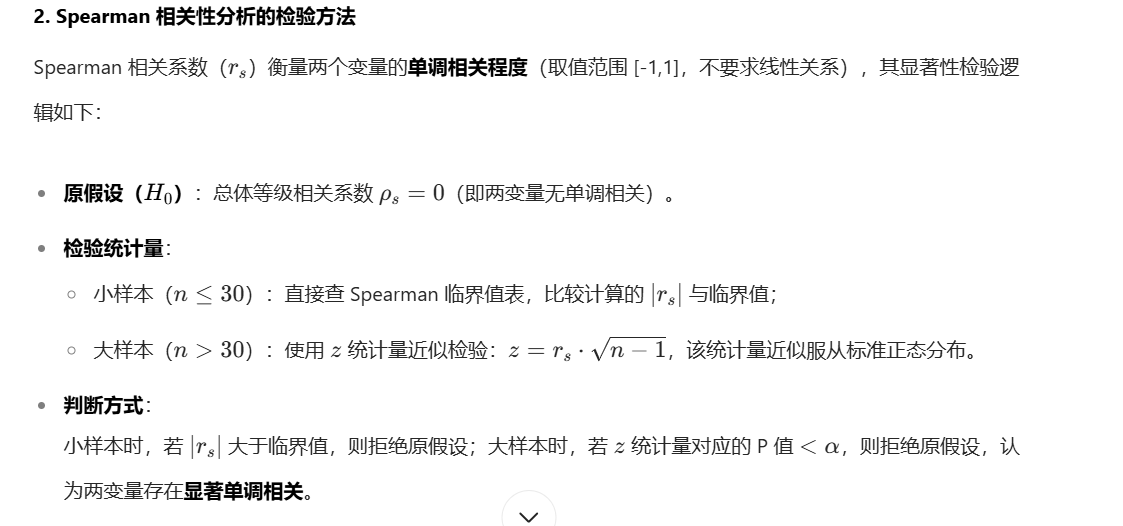
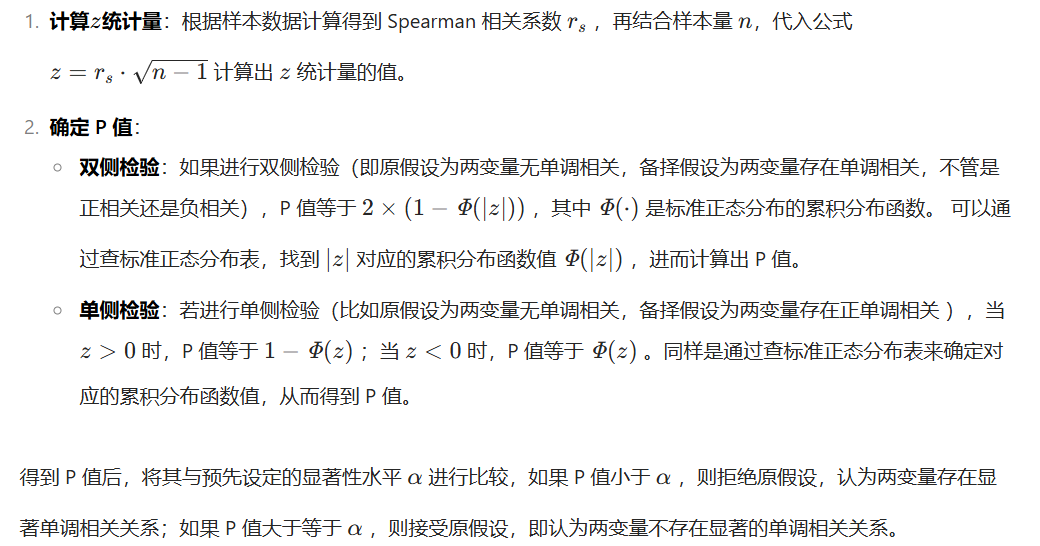
python中的stats.spearmanr()函数会自动根据样本量大小选择合适的检验方法
小样本时采用精确检验,大样本时采用基于正态分布的近似检验,无需手动计算临界值或 z z z 统计量,非常便捷
#示例
corr, p_value = stats.spearmanr(sales, price)
四、pearson相关性分析
适用于定量数据,且数据满足正态分布
适用于满足“双变量正态分布”的数值型变量
1)适用条件:
- 变量 A 和变量 B 均为连续数值型
如温度、销量、浓度 - 两者呈线性相关趋势
可通过散点图初步判断 - 数据需满足双变量正态分布
可通过 Shapiro-Wilk 检验验证(小样本)
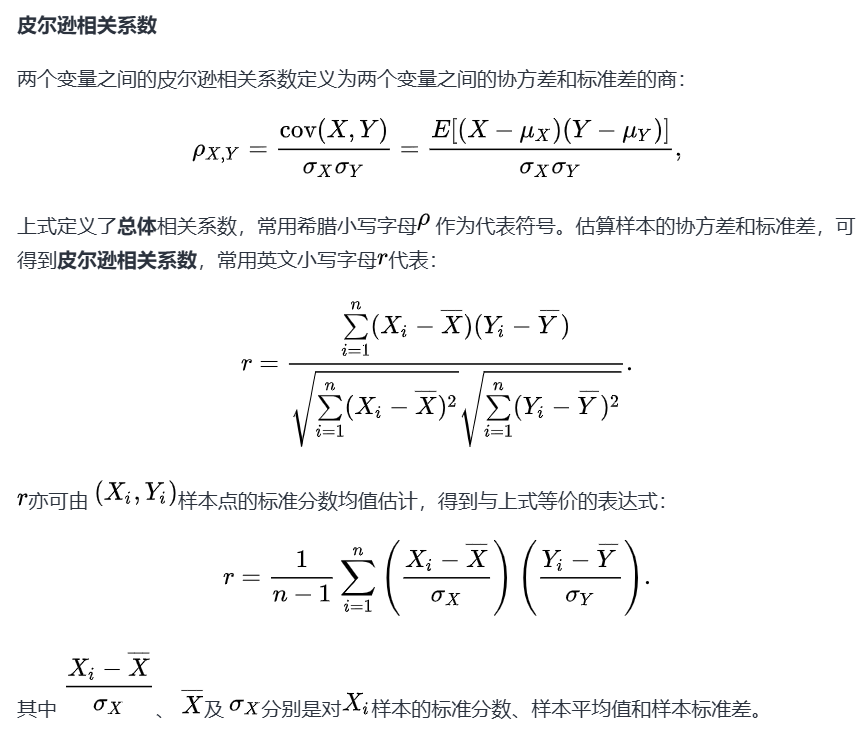
2)计算逻辑
皮尔逊相关系数的本质是两个变量标准化后的协方差,公式如下:
r = ∑ i = 1 n ( x i − x ˉ ) ( y i − y ˉ ) ∑ i = 1 n ( x i − x ˉ ) 2 ⋅ ∑ i = 1 n ( y i − y ˉ ) 2 r = \frac{\sum_{i=1}^n (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum_{i=1}^n (x_i - \bar{x})^2} \cdot \sqrt{\sum_{i=1}^n (y_i - \bar{y})^2}} r=∑i=1n(xi−xˉ)2⋅∑i=1n(yi−yˉ)2∑i=1n(xi−xˉ)(yi−yˉ)
其中:
- x ˉ \bar{x} xˉ、 y ˉ \bar{y} yˉ 分别为变量 X X X、 Y Y Y 的均值;
- n n n 为样本量;
- 分子是变量 X X X 与 Y Y Y 的离均差乘积和(反映两者的协同变化趋势);
- 分母是变量 X X X、 Y Y Y 离均差平方和的平方根乘积(标准化因子,确保系数范围在 [ − 1 , 1 ] [-1,1] [−1,1] 内)。
3)结果解读
1.取值范围
- 皮尔逊相关系数 r r r 的取值取值范围: r ∈ [ − 1 , 1 ] r \in [-1, 1] r∈[−1,1]
- 无单位
- 仅反映关联的方向与强度
2.符号意义
- 当
r
>
0
r > 0
r>0 时:两个变量呈正相关
一个变量的数值增大时,另一个变量的数值也倾向于增大(如身高与体重:身高越高,体重通常也越大) - 当
r
<
0
r < 0
r<0 时:两个变量呈负相关
一个变量的数值增大时,另一个变量的数值倾向于减小(如商品价格与销量:价格越高,销量通常越低) - 当
r
=
0
r = 0
r=0 时:两个变量不存在线性关联
注意:不排除存在非线性关联的可能,如 Y = X 2 Y = X^2 Y=X2 中 r = 0 r=0 r=0,但两者存在明确的二次函数关系
3.关联强度判断
根据 ∣ r ∣ |r| ∣r∣大小,可将线性关联强度划分为以下等级:
- ∣ r ∣ ∈ [ 0.8 , 1 ] |r| \in [0.8, 1] ∣r∣∈[0.8,1]:极强相关
- ∣ r ∣ ∈ [ 0.5 , 0.8 ) |r| \in [0.5, 0.8) ∣r∣∈[0.5,0.8):强相关
- ∣ r ∣ ∈ [ 0.3 , 0.5 ) |r| \in [0.3, 0.5) ∣r∣∈[0.3,0.5):中等相关
- ∣ r ∣ ∈ [ 0 , 0.3 ) |r| \in [0, 0.3) ∣r∣∈[0,0.3):弱相关或无相关
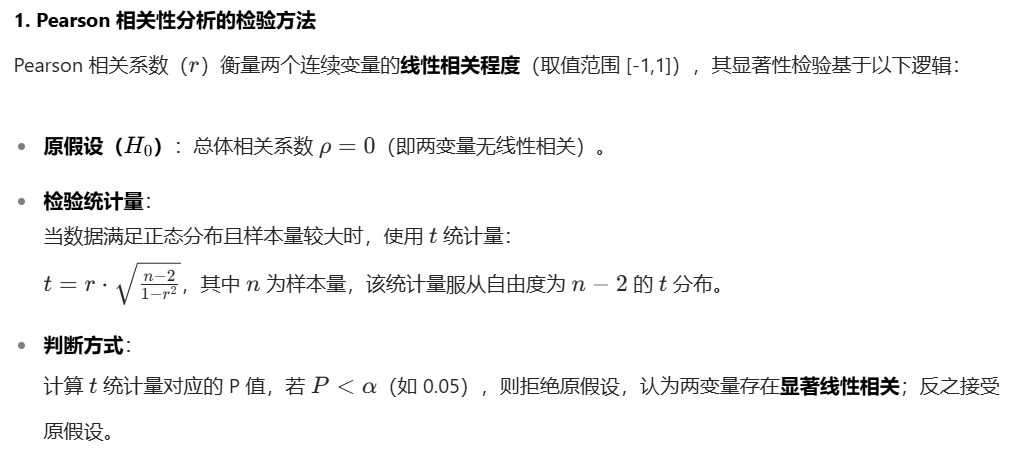
4.显著性检验( p p p 值)
仅通过
r
r
r 的大小无法判断关联是否“非偶然”,需结合
p
p
p 值进行统计显著性检验,通常
p
<
0.05
p<0.05
p<0.05认为关联非偶然
4) 建模应用
在数学建模中,皮尔逊相关系数的核心用途是快速筛选与因变量线性关联强的自变量,减少后续建模的变量维度,提升模型效率与可解释性
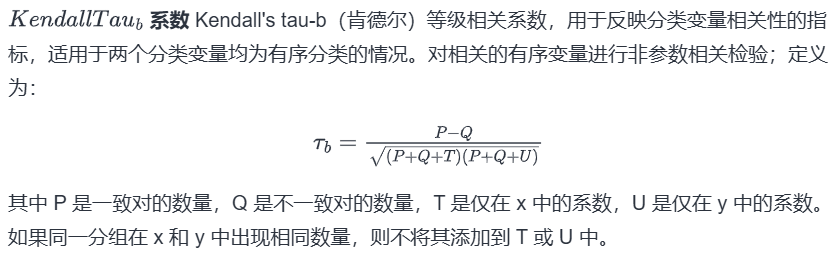
五、Kendall’s tau-b 相关系数
适用条件:有序定类变量,样本量较小( n < 30 n<30 n<30)
核心是衡量两个变量排名的一致性
计算逻辑
统计“一致对”(两个样本在 A 变量中排名高,在 B 变量中排名也高)和“不一致对”(A 中排名高,B 中排名低)的数量,公式为:
τ = C − D 1 2 n ( n − 1 ) \tau = \frac{C - D}{\frac{1}{2}n(n - 1)} τ=21n(n−1)C−D
其中,
C
C
C 为一致对数量,
D
D
D 为不一致对数量,
n
n
n 为样本量。
六、选择
pearson和spearman相关性检验用的比较多
-
选择 Pearson
Pearson 有严格的前提条件,必须先验证:
(1)变量类型检验:两变量是否均为连续型数值变量(如身高、收入、温度等)?
若为分类变量(如性别、职业)或有序分类变量(如等级),则不适用
(2)正态性检验:两变量是否均服从正态分布?
用 Jarque-Bera 检验(大样本)或 Shapiro-Wilk 检验(小样本)验证,若均满足正态分布,可继续;否则不适用
(3)线性关系检验:两变量的散点图是否呈现线性趋势?
即使满足前两个条件,若散点图呈现曲线关系(如二次曲线),Pearson 相关系数也无法准确反映关联程度(需用 Spearman 或其他方法) -
选择 Spearman 相关前的检验与判断
Spearman 对前提条件要求宽松,主要验证:
(1)变量类型检验:两变量可以是连续型数值变量,或有序分类变量(如满意度等级、成绩排名等)
无序分类变量(如颜色、血型)不适用
(2)单调关系检验:两变量的散点图是否呈现单调趋势(即一个变量增大时,另一个变量整体增大或整体减小,不必严格线性)?
若散点图无任何单调趋势(如随机分布),则相关性分析无意义
七、代码
#spearman相关性
import pandas as pd
from scipy import stats
def corr_sales_price():
    df1 = pd.read_excel('平均成本加成定价.xlsx')
    df2 = pd.read_excel('品类每日总销售量(6列横排).xlsx')

    # 获取第一行列名(列标题)的列表
    df1_columns = df1.columns.tolist()  # 转换为列表形式
    df2_columns = df2.columns.tolist()
    # print("df1的列名列表:", df1_columns)
    # print("df2的列名列表:", df2_columns)
    r_matrix=[]
    p_matrix=[]

    for i in range(6):              #i=0,1,2,3,4,5
        col1 = df1.iloc[:, i+1]
        col2 = df2.iloc[:, i + 1]  # 从第二列开始
        df1_clean = col1.fillna(col1.mean())
        df2_clean = col2.fillna(col2.mean())
        # 计算斯皮尔曼相关系数
        spearman_corr, p_value = stats.spearmanr(df1_clean, df2_clean)

        # # 打印斯皮尔曼相关系数和P值
        # print(df1_columns[i+1],":")
        # print(f"r_Spearman:{spearman_corr}")
        # print(f"P-value: {p_value}")
        #
        # if p_value < 0.05:
        #     print("在置信水平95%的情况下,接受原假设")
        # else:
        #     print("在置信水平95%的情况下,拒绝原假设")

        r_matrix.append([round(spearman_corr, 4)])
        p_matrix.append([round(p_value, 4)])

    print("spearman相关系数:\n",df1_columns[1:])
    print(r_matrix)
    print("显著性P值:\n",df1_columns[1:])
    print(p_matrix)
if __name__ == '__main__':
    corr_sales_price()
% Pearson相关性分析
% 功能:1. 读取Excel数据 2. 对各变量进行正态性检验 3. 计算并输出相关系数矩阵 4. 输出显著性检验结果

filename = '品类每日销售统计结果(含加成率).xlsx';  % 替换为你的文件名
sheetname = 'sheet1';                                   % 工作表名称
range = 'D2:E1086';                                     % 数据范围

% 读取数据
try
    data = readmatrix(filename, 'Sheet', sheetname, 'Range', range);
    fprintf('数据读取成功!共读取 %d 行, %d 列数据\n', size(data,1), size(data,2));
catch
    error('数据读取失败,请检查文件路径和数据范围是否正确');
end

% 检查数据中是否有缺失值
if any(isnan(data(:)))
    warning('数据中存在缺失值,将自动排除含缺失值的样本');
    data = rmmissing(data);  % 移除含缺失值的行
    fprintf('处理后的数据量:%d 行, %d 列\n', size(data,1), size(data,2));
end

%% 2. Shapiro-Wilk正态性检验
[n_samples, n_vars] = size(data);  % 获取样本量和变量数
sw_results = struct('h', zeros(1, n_vars), 'p', zeros(1, n_vars));  % 存储检验结果

fprintf('\n===== Shapiro-Wilk正态性检验结果 =====\n');
fprintf('变量序号\t是否拒绝原假设(1=是)\tP值\n');

for i = 1:n_vars
    % 执行 Lilliefors 检验(近似 Shapiro-Wilk 检验)
    [h, p] = lillietest(data(:, i));
    sw_results.h(i) = h;
    sw_results.p(i) = p;

    % 输出检验结果
    fprintf('%d\t\t%d\t\t\t%.4f\n', i, h, p);
end

% % 提示哪些变量不满足正态性
% non_normal = find(sw_results.h == 1);
% if ~isempty(non_normal)
%     warning('以下变量不满足正态性假设(p < 0.05):%s', num2str(non_normal));
%     fprintf('注意:不满足正态性的变量可能不适合使用Pearson相关分析\n');
% end

%% 3. 计算Pearson相关系数矩阵
fprintf('\n===== Pearson相关系数矩阵 =====\n');
[R, P] = corrcoef(data);  % R为相关系数矩阵,P为显著性p值矩阵

% 显示相关系数矩阵
disp(round(R, 5));

% %% 4. 输出相关系数显著性检验结果
fprintf('\n===== 相关系数显著性检验结果(p值) =====\n');
disp(P);

%% 5. 可视化相关系数矩阵(热图)
figure;
heatmap(R, 'Title', 'Pearson相关系数矩阵热图', ...
    'XLabel', '变量', 'YLabel', '变量', ...
    'Colormap', jet);
colorbar;  % 显示颜色刻度

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 29
 0
- 0


 已为社区贡献4条内容

所有评论(0)