Python大数据毕设指导:基于Django+Spark的烟酒成瘾个体数据分析与可视系统 毕业设计/选题推荐/深度学习/数据分析/数据挖掘/机器学习/随机森林/数据可视化/大屏
✍✍计算机毕设指导师**
⭐⭐个人介绍:自己非常喜欢研究技术问题!专业做Java、Python、小程序、安卓、大数据、爬虫、Golang、大屏等实战项目。
⛽⛽实战项目:有源码或者技术上的问题欢迎在评论区一起讨论交流!
⚡⚡有什么问题可以在主页上或文末下联系咨询博客~~
⚡⚡Java、Python、小程序、大数据实战项目集](https://blog.csdn.net/2301_80395604/category_12487856.html)
⚡⚡文末获取源码
温馨提示:文末有CSDN平台官方提供的博客联系方式的名片!
温馨提示:文末有CSDN平台官方提供的博客联系方式的名片!
温馨提示:文末有CSDN平台官方提供的博客联系方式的名片!
烟酒成瘾个体数据分析与可视系统-简介
基于Spark+Django的烟酒成瘾个体数据分析与可视化系统是一个专注于成瘾行为研究的大数据分析平台,该系统运用Hadoop分布式存储架构和Spark大数据计算引擎,结合Django Web框架构建了完整的数据处理与展示解决方案。系统核心功能涵盖人口统计学特征与成瘾行为分析、成瘾历程与戒瘾尝试分析、健康与生活方式影响因素分析以及多因素综合分析与风险评估四大模块,通过对烟酒成瘾个体的年龄、性别、教育水平、收入状况、婚姻状态等18个维度进行深度挖掘,实现了从不同年龄段成瘾行为差异到双重成瘾模式识别的全方位分析。系统采用Vue+ElementUI+ECharts技术栈构建前端可视化界面,结合Pandas和NumPy进行数据处理,通过MySQL数据库存储结构化数据,最终形成了集数据采集、清洗、分析、建模、可视化于一体的综合性成瘾行为研究平台,为相关研究人员提供了强有力的数据分析工具。
烟酒成瘾个体数据分析与可视系统-技术
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
数据库:MySQL
烟酒成瘾个体数据分析与可视系统-背景
烟酒成瘾作为全球性公共健康问题,其复杂的成因机制和多样化的表现形式一直是医学、心理学和社会学领域关注的焦点。传统的成瘾行为研究往往局限于小样本调查和单一维度分析,难以全面揭示成瘾个体的行为特征和影响因素。随着大数据技术的快速发展,利用海量数据进行深度挖掘和多维度分析成为可能,为成瘾行为研究提供了新的技术手段和研究视角。当前社会中烟酒成瘾问题呈现出年轻化趋势和复合化特征,不同人群的成瘾模式存在显著差异,这就需要更加精准和个性化的分析方法来识别高风险群体和制定针对性干预策略,而传统的统计分析方法在处理大规模、多维度数据时显得力不从心,迫切需要引入大数据技术来提升分析的准确性和效率。
本系统的研究意义体现在多个层面,从技术角度来看,系统将Spark大数据处理技术与Django Web框架相结合,为成瘾行为数据分析提供了可扩展的技术解决方案,验证了大数据技术在健康行为研究领域的应用可行性。从实际应用层面来说,系统能够帮助研究人员更好地理解不同人群的成瘾行为特征,通过多维度数据分析识别影响成瘾行为的关键因素,为制定更加精准的干预策略提供数据支撑。系统构建的成瘾风险评估模型可以辅助相关机构进行早期筛查和预警,在一定程度上提高干预效果。对于学术研究而言,系统提供的可视化分析工具能够帮助研究者更直观地观察数据规律和趋势,促进相关研究的深入开展。作为一个毕业设计项目,本系统也为大数据技术在特定领域的应用提供了实践案例,展示了现代信息技术在解决实际问题中的潜在价值,当然这些意义相对有限,主要还是作为技术学习和实践的载体。
烟酒成瘾个体数据分析与可视系统-视频展示
Python大数据毕设指导:基于Django+Spark的烟酒成瘾个体分析与可视化系统从需求到部署 毕业设计/选题推荐/深度学习/数据分析/数据挖掘/机器学习
烟酒成瘾个体数据分析与可视系统-图片展示
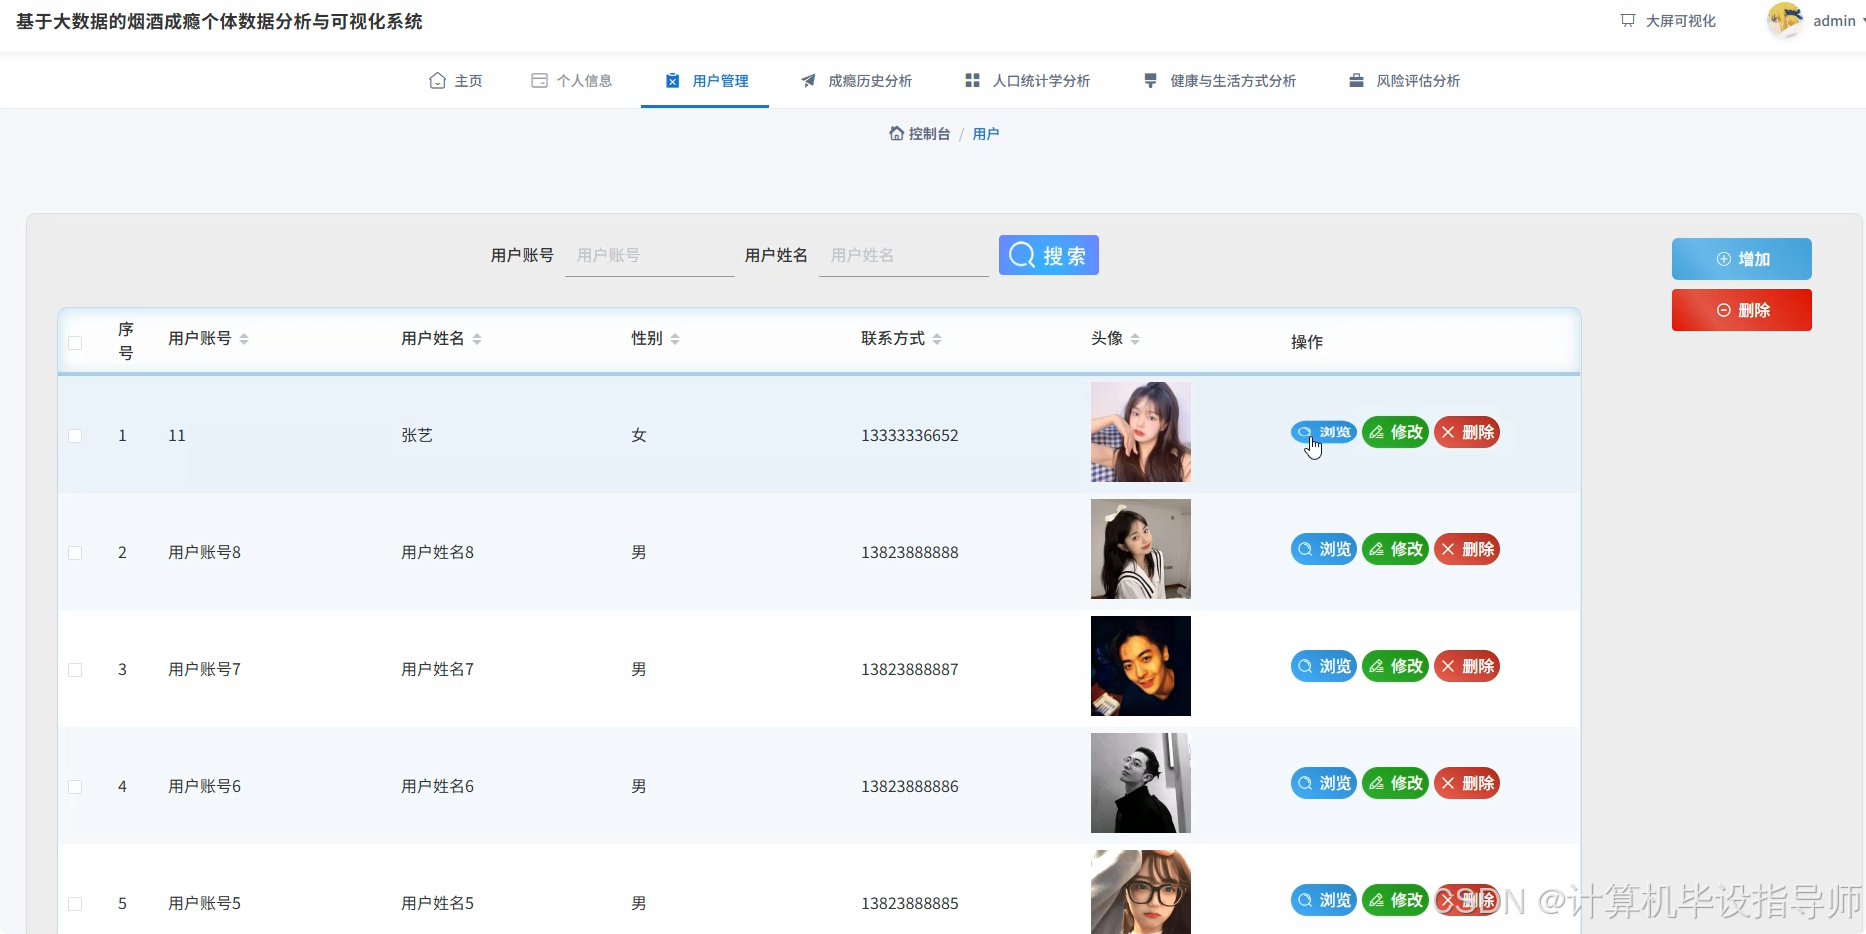

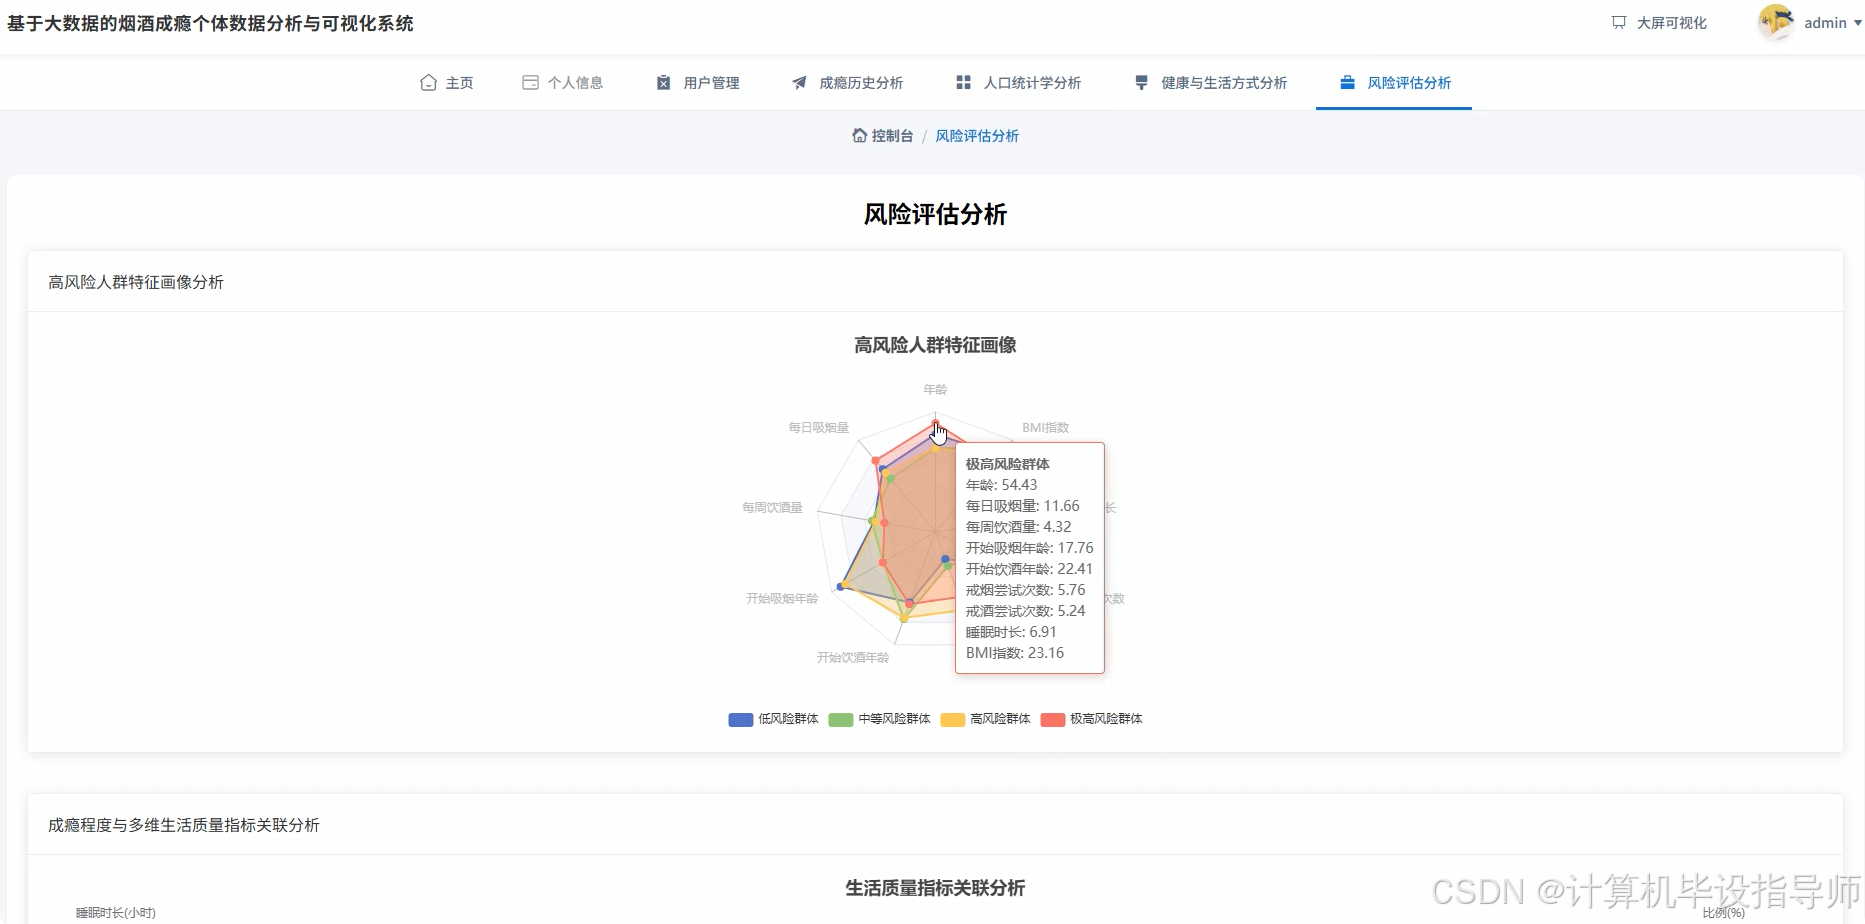
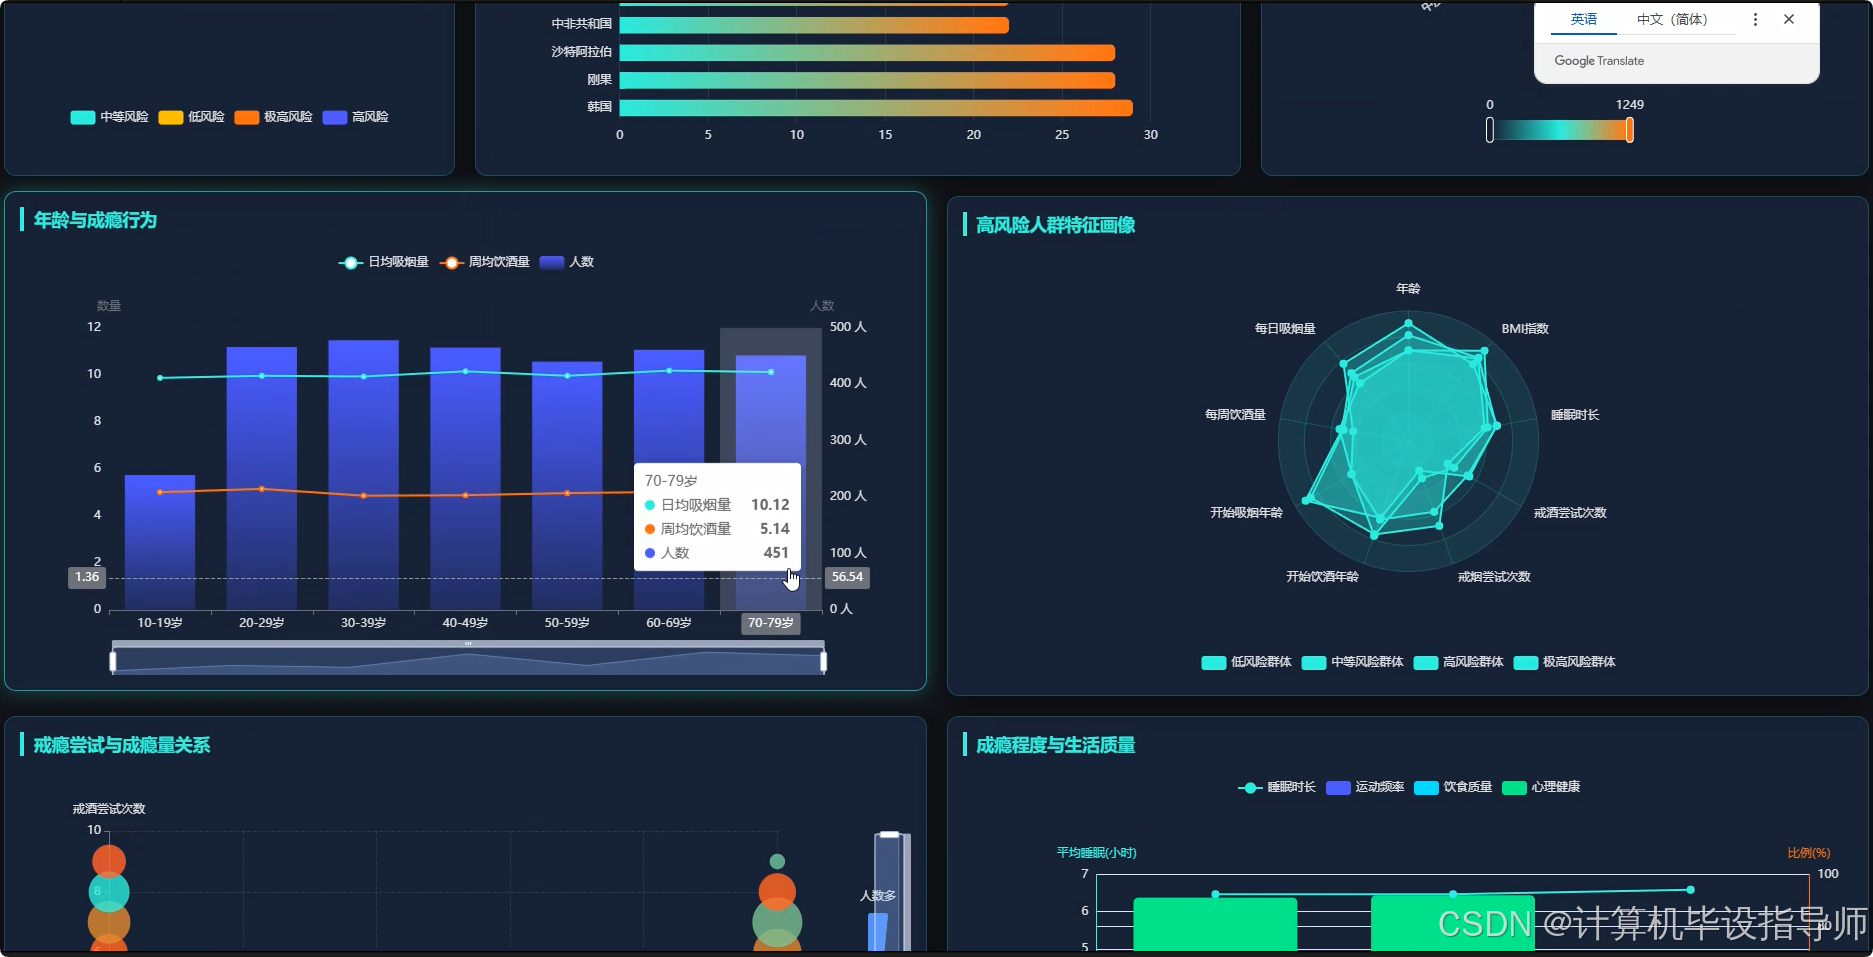
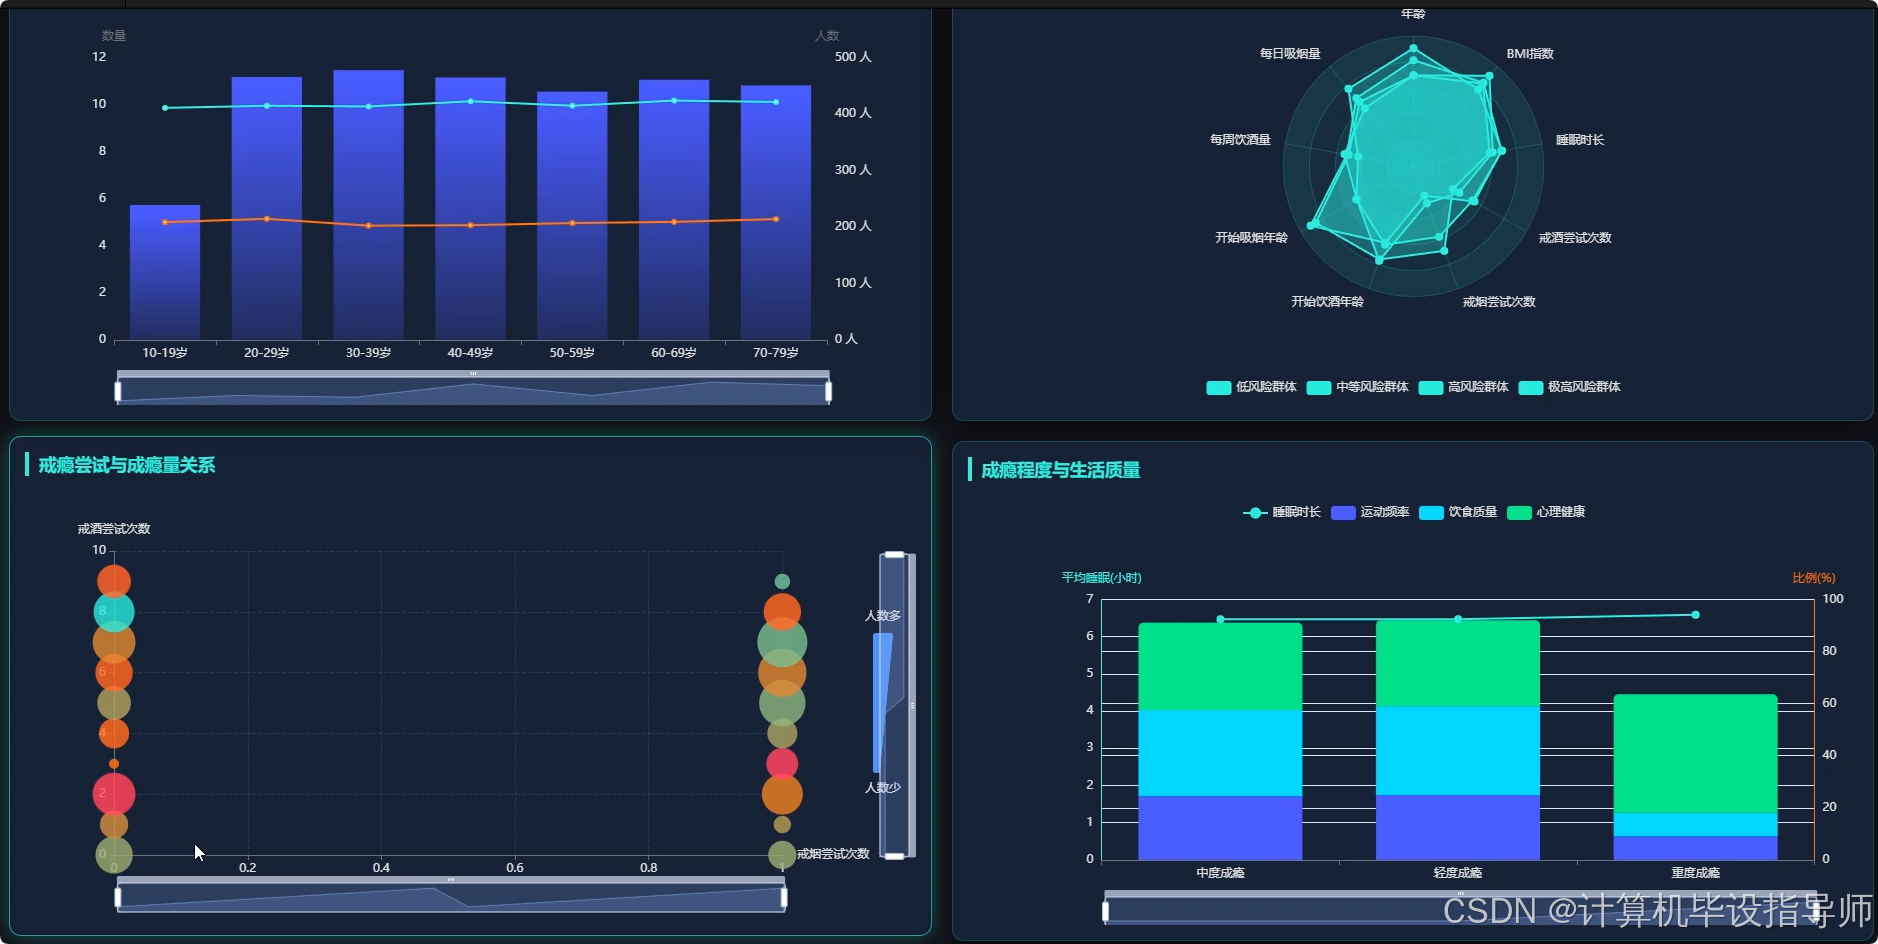
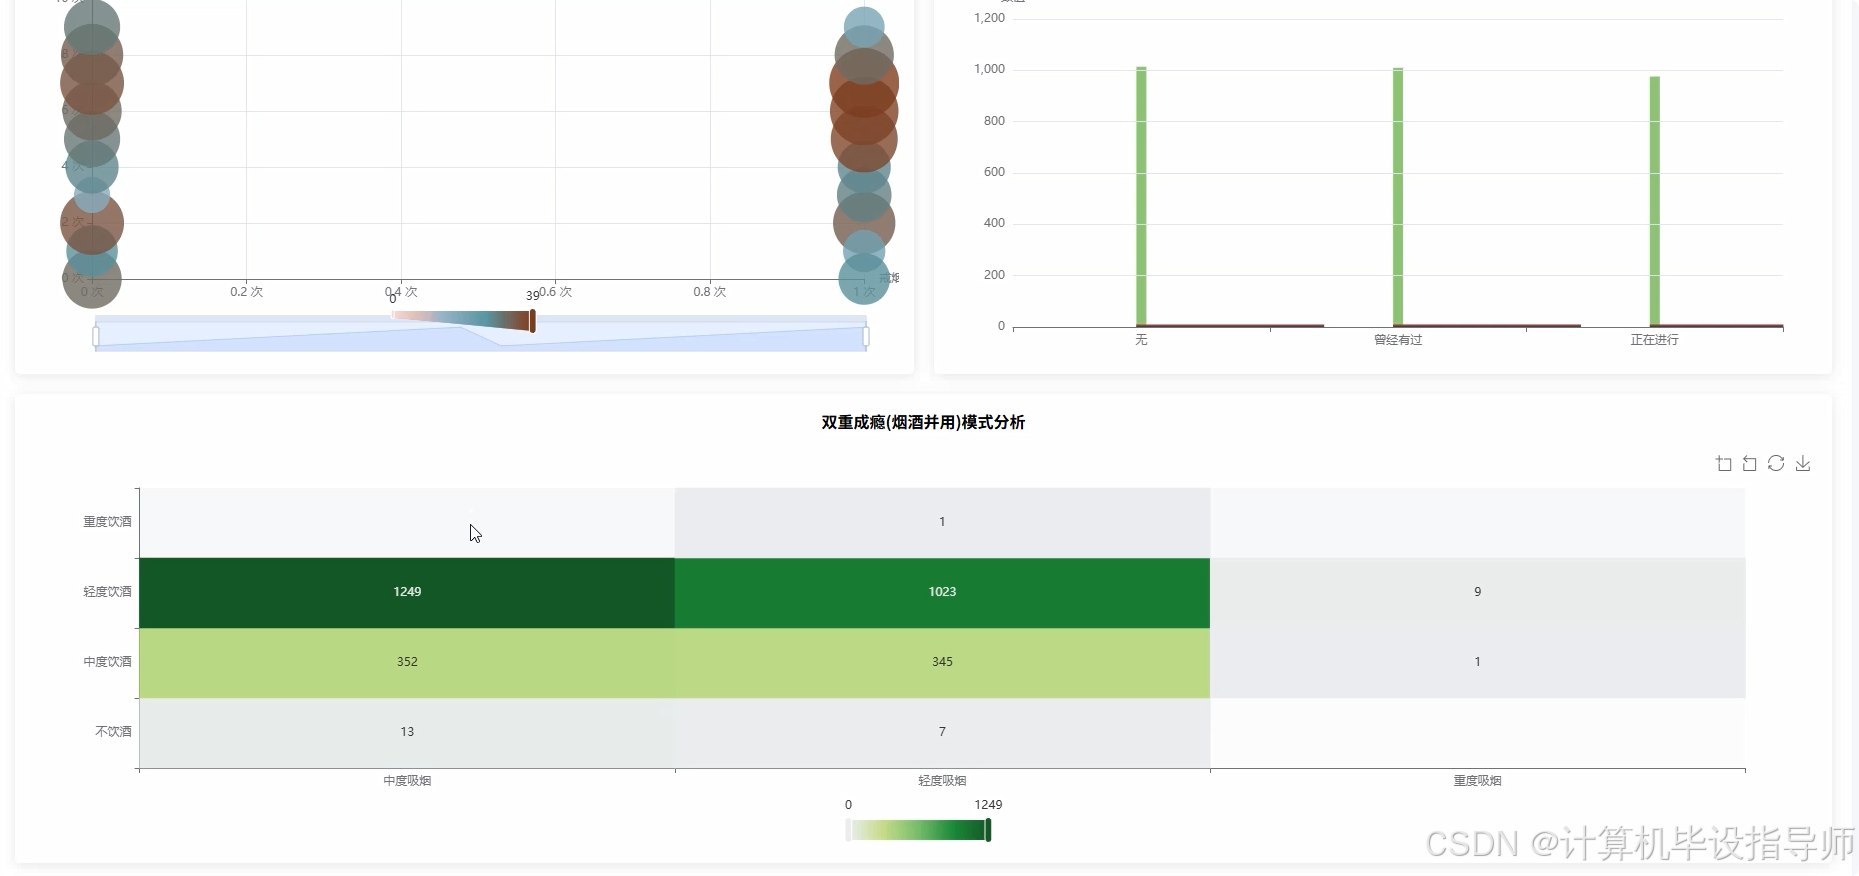
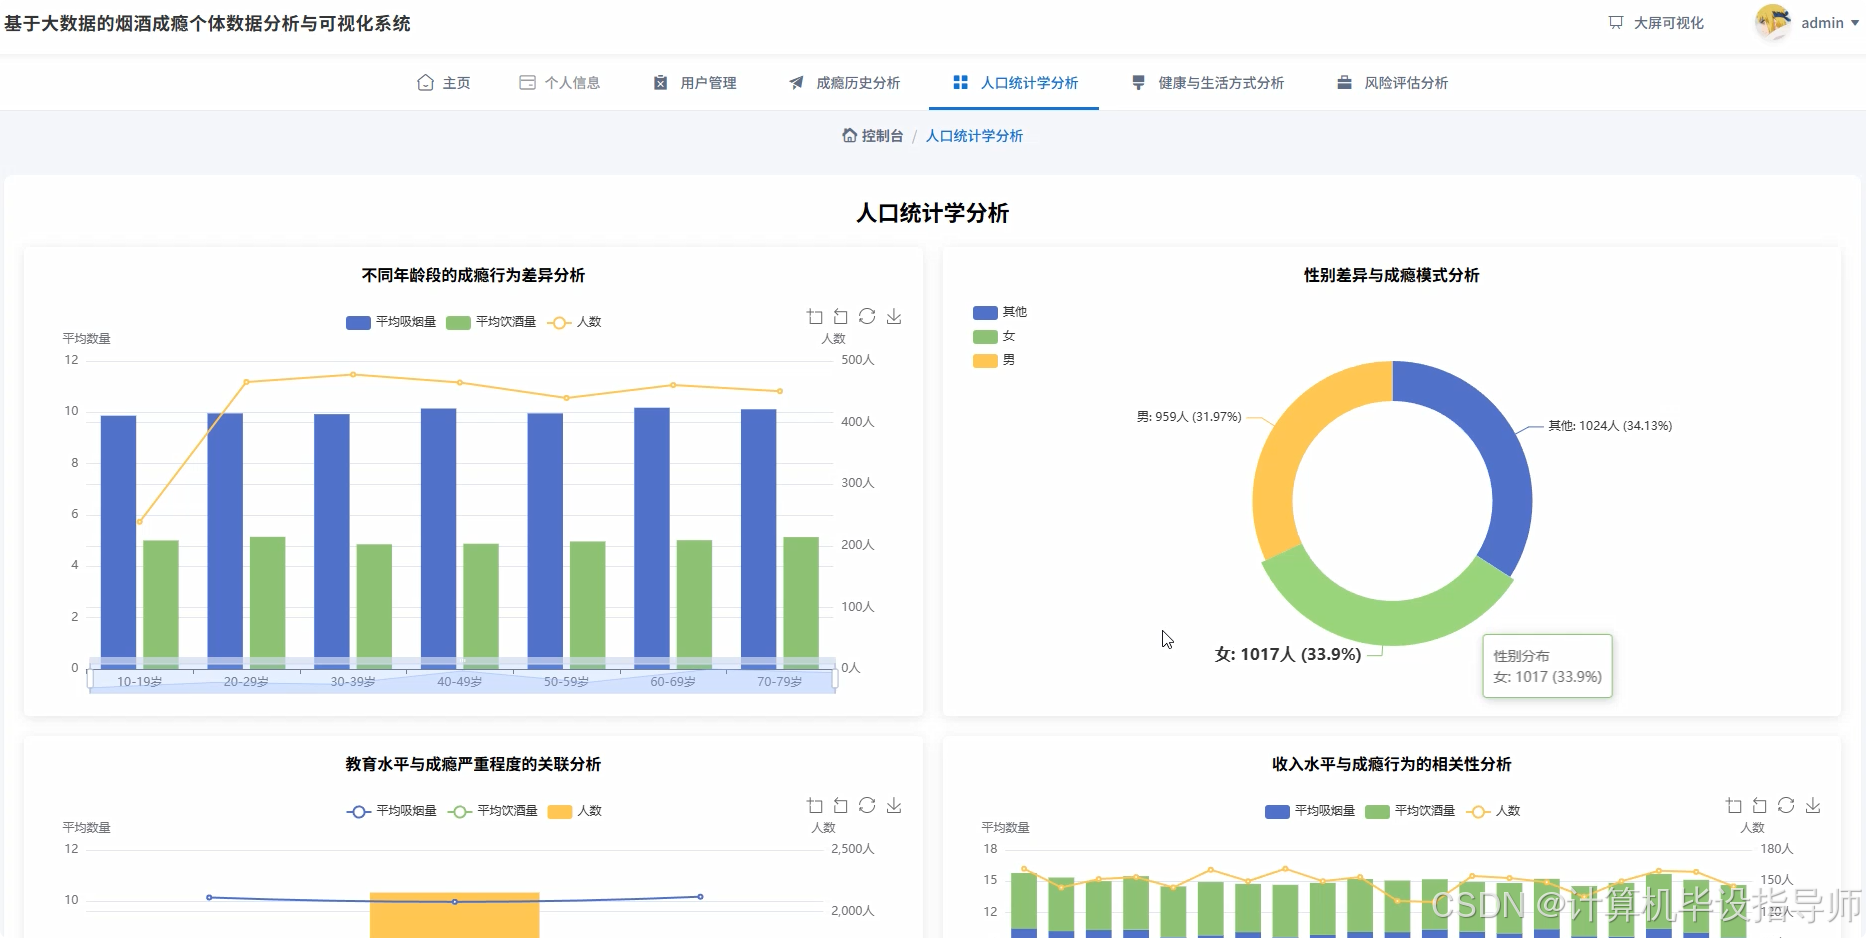
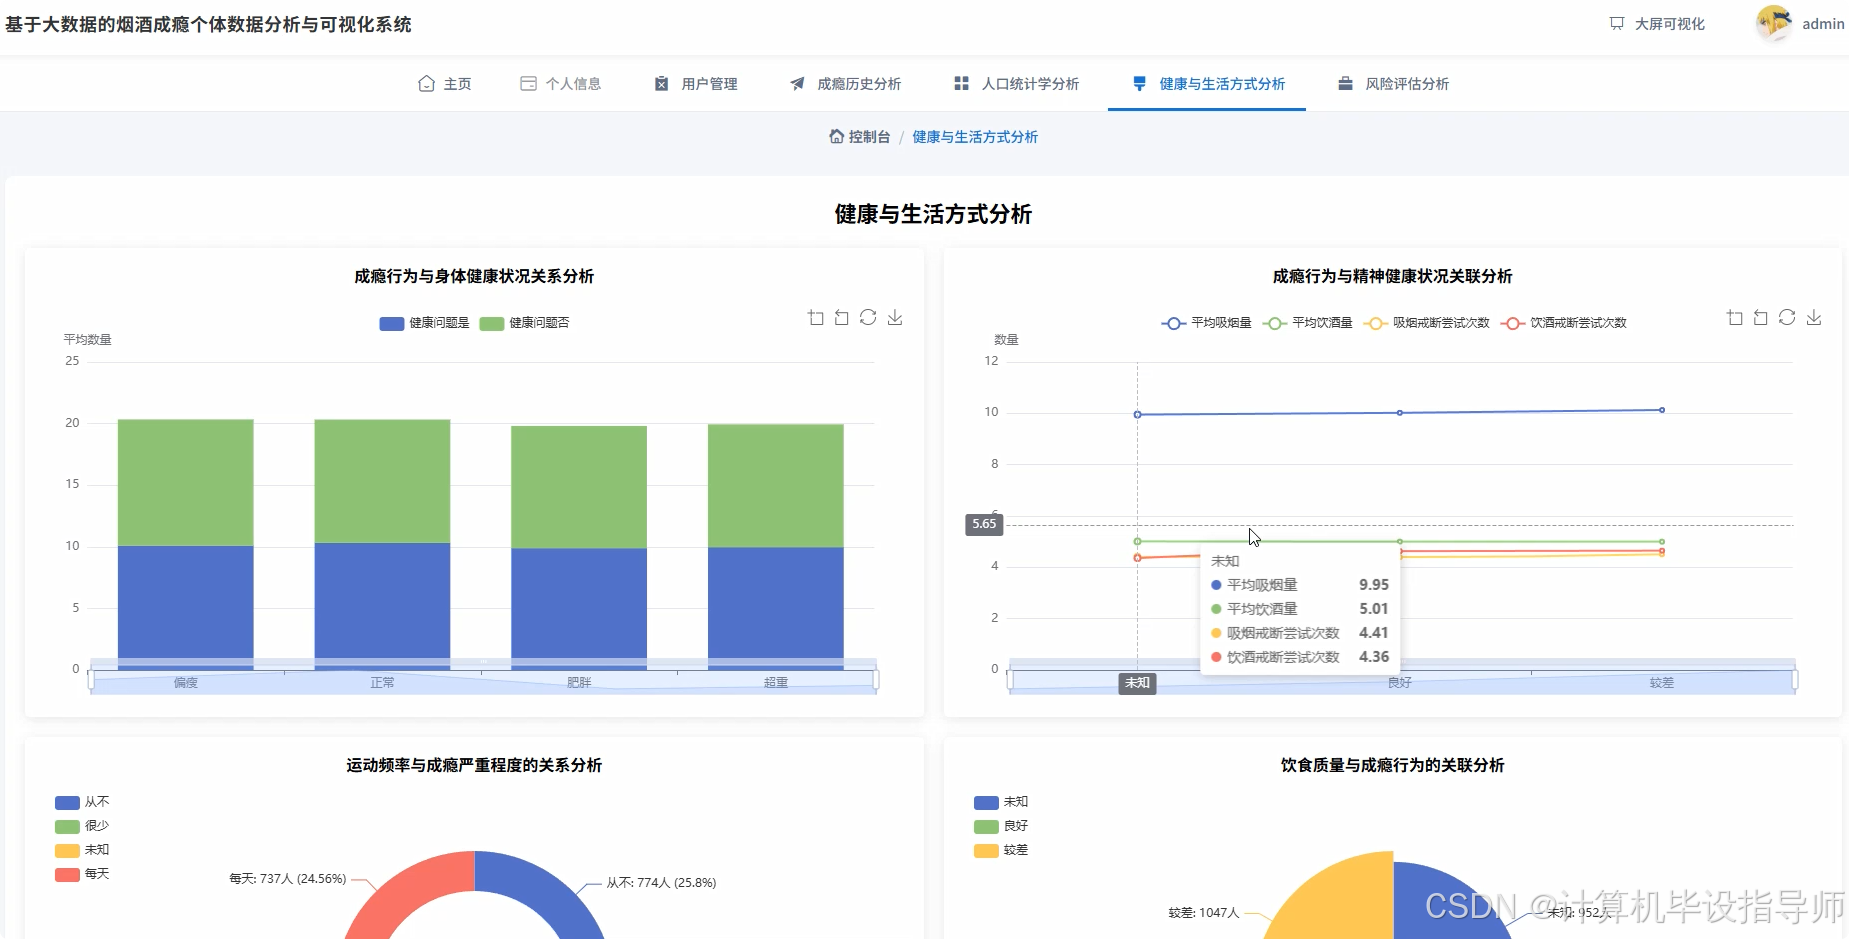
烟酒成瘾个体数据分析与可视系统-代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import *
from pyspark.sql.types import *
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
import pandas as pd
import numpy as np
import json

spark = SparkSession.builder.appName("SmokingDrinkingAnalysis").config("spark.sql.adaptive.enabled", "true").config("spark.sql.adaptive.coalescePartitions.enabled", "true").getOrCreate()

@csrf_exempt
def age_group_addiction_analysis(request):
    """不同年龄段成瘾行为差异分析"""
    df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/addiction_db").option("dbtable", "addiction_data").option("user", "root").option("password", "password").load()
    age_grouped = df.withColumn("age_group", when(col("age") < 25, "18-24").when(col("age") < 35, "25-34").when(col("age") < 45, "35-44").when(col("age") < 55, "45-54").otherwise("55+"))
    smoking_stats = age_grouped.groupBy("age_group").agg(avg("smokes_per_day").alias("avg_smokes"), count("*").alias("total_count"), stddev("smokes_per_day").alias("smokes_stddev"))
    drinking_stats = age_grouped.groupBy("age_group").agg(avg("drinks_per_week").alias("avg_drinks"), count("*").alias("total_count"), stddev("drinks_per_week").alias("drinks_stddev"))
    combined_stats = smoking_stats.join(drinking_stats, "age_group")
    addiction_severity = combined_stats.withColumn("smoking_severity", when(col("avg_smokes") > 20, "High").when(col("avg_smokes") > 10, "Medium").otherwise("Low")).withColumn("drinking_severity", when(col("avg_drinks") > 14, "High").when(col("avg_drinks") > 7, "Medium").otherwise("Low"))
    age_correlation = df.select(corr("age", "smokes_per_day").alias("age_smoking_corr"), corr("age", "drinks_per_week").alias("age_drinking_corr"))
    risk_analysis = age_grouped.withColumn("dual_addiction_risk", when((col("smokes_per_day") > 15) & (col("drinks_per_week") > 10), "High Risk").when((col("smokes_per_day") > 5) & (col("drinks_per_week") > 3), "Medium Risk").otherwise("Low Risk"))
    risk_distribution = risk_analysis.groupBy("age_group", "dual_addiction_risk").count().withColumnRenamed("count", "risk_count")
    trend_analysis = age_grouped.withColumn("addiction_score", col("smokes_per_day") * 0.6 + col("drinks_per_week") * 0.4).groupBy("age_group").agg(avg("addiction_score").alias("avg_addiction_score"), max("addiction_score").alias("max_addiction_score"))
    final_results = addiction_severity.join(risk_distribution, "age_group").join(trend_analysis, "age_group")
    results_pandas = final_results.toPandas()
    response_data = {"age_analysis": results_pandas.to_dict("records"), "correlation": age_correlation.collect()[0].asDict(), "summary": {"total_groups": results_pandas.shape[0], "highest_risk_group": results_pandas.loc[results_pandas["avg_addiction_score"].idxmax(), "age_group"]}}
    return JsonResponse(response_data, safe=False)

@csrf_exempt
def dual_addiction_pattern_analysis(request):
    """烟酒双重成瘾模式分析"""
    df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/addiction_db").option("dbtable", "addiction_data").option("user", "root").option("password", "password").load()
    dual_addiction_df = df.filter((col("smokes_per_day") > 0) & (col("drinks_per_week") > 0))
    addiction_clusters = dual_addiction_df.withColumn("smoking_level", when(col("smokes_per_day") > 20, "Heavy").when(col("smokes_per_day") > 10, "Moderate").otherwise("Light")).withColumn("drinking_level", when(col("drinks_per_week") > 14, "Heavy").when(col("drinks_per_week") > 7, "Moderate").otherwise("Light"))
    pattern_distribution = addiction_clusters.groupBy("smoking_level", "drinking_level").agg(count("*").alias("pattern_count"), avg("smokes_per_day").alias("avg_smokes"), avg("drinks_per_week").alias("avg_drinks"), avg("bmi").alias("avg_bmi"))
    severity_analysis = dual_addiction_df.withColumn("combined_severity", col("smokes_per_day") * 1.2 + col("drinks_per_week") * 0.8).withColumn("severity_category", when(col("combined_severity") > 30, "Severe").when(col("combined_severity") > 15, "Moderate").otherwise("Mild"))
    health_impact = severity_analysis.groupBy("severity_category").agg(count("*").alias("category_count"), avg("bmi").alias("avg_bmi"), sum(when(col("has_health_issues") == "Yes", 1).otherwise(0)).alias("health_issues_count"))
    correlation_analysis = dual_addiction_df.select(corr("smokes_per_day", "drinks_per_week").alias("smoking_drinking_corr"), corr("smokes_per_day", "bmi").alias("smoking_bmi_corr"), corr("drinks_per_week", "bmi").alias("drinking_bmi_corr"))
    age_pattern = dual_addiction_df.withColumn("age_group", when(col("age") < 30, "Young").when(col("age") < 50, "Middle").otherwise("Older")).groupBy("age_group").agg(avg("smokes_per_day").alias("avg_smokes"), avg("drinks_per_week").alias("avg_drinks"), avg("combined_severity").alias("avg_severity"))
    gender_pattern = dual_addiction_df.groupBy("gender").agg(count("*").alias("gender_count"), avg("smokes_per_day").alias("avg_smokes"), avg("drinks_per_week").alias("avg_drinks"), avg("combined_severity").alias("avg_severity"))
    risk_factors = dual_addiction_df.groupBy("education_level", "marital_status").agg(count("*").alias("demographic_count"), avg("combined_severity").alias("avg_severity"))
    treatment_effectiveness = dual_addiction_df.filter(col("therapy_history") == "Yes").agg(avg("attempts_to_quit_smoking").alias("avg_quit_smoking_attempts"), avg("attempts_to_quit_drinking").alias("avg_quit_drinking_attempts"), avg("combined_severity").alias("avg_severity_with_treatment"))
    final_analysis = {"pattern_distribution": pattern_distribution.toPandas().to_dict("records"), "health_impact": health_impact.toPandas().to_dict("records"), "correlations": correlation_analysis.collect()[0].asDict(), "age_patterns": age_pattern.toPandas().to_dict("records"), "gender_patterns": gender_pattern.toPandas().to_dict("records"), "treatment_data": treatment_effectiveness.collect()[0].asDict()}
    return JsonResponse(final_analysis, safe=False)

@csrf_exempt
def addiction_risk_assessment(request):
    """成瘾高风险人群特征画像与风险评估"""
    df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/addiction_db").option("dbtable", "addiction_data").option("user", "root").option("password", "password").load()
    risk_features = df.withColumn("smoking_risk_score", when(col("smokes_per_day") > 20, 4).when(col("smokes_per_day") > 10, 3).when(col("smokes_per_day") > 5, 2).when(col("smokes_per_day") > 0, 1).otherwise(0)).withColumn("drinking_risk_score", when(col("drinks_per_week") > 14, 4).when(col("drinks_per_week") > 7, 3).when(col("drinks_per_week") > 3, 2).when(col("drinks_per_week") > 0, 1).otherwise(0))
    demographic_risk = risk_features.withColumn("age_risk", when(col("age") < 25, 3).when(col("age") < 35, 2).otherwise(1)).withColumn("education_risk", when(col("education_level") == "High School or Below", 3).when(col("education_level") == "Bachelor's Degree", 2).otherwise(1)).withColumn("income_risk", when(col("annual_income_usd") < 30000, 3).when(col("annual_income_usd") < 50000, 2).otherwise(1))
    lifestyle_risk = demographic_risk.withColumn("health_risk", when(col("has_health_issues") == "Yes", 2).otherwise(0)).withColumn("exercise_risk", when(col("exercise_frequency") == "Never", 3).when(col("exercise_frequency") == "Rarely", 2).otherwise(1)).withColumn("sleep_risk", when(col("sleep_hours") < 6, 3).when(col("sleep_hours") < 7, 2).otherwise(1))
    comprehensive_risk = lifestyle_risk.withColumn("total_risk_score", col("smoking_risk_score") + col("drinking_risk_score") + col("age_risk") + col("education_risk") + col("income_risk") + col("health_risk") + col("exercise_risk") + col("sleep_risk")).withColumn("risk_category", when(col("total_risk_score") > 15, "Very High Risk").when(col("total_risk_score") > 12, "High Risk").when(col("total_risk_score") > 8, "Medium Risk").otherwise("Low Risk"))
    risk_distribution = comprehensive_risk.groupBy("risk_category").agg(count("*").alias("category_count"), avg("smokes_per_day").alias("avg_smokes"), avg("drinks_per_week").alias("avg_drinks"), avg("total_risk_score").alias("avg_risk_score"))
    high_risk_profile = comprehensive_risk.filter(col("risk_category") == "Very High Risk").groupBy("gender", "education_level", "marital_status").agg(count("*").alias("profile_count"), avg("age").alias("avg_age"), avg("annual_income_usd").alias("avg_income"))
    intervention_priority = comprehensive_risk.withColumn("intervention_urgency", when((col("total_risk_score") > 15) & (col("has_health_issues") == "Yes"), "Immediate").when(col("total_risk_score") > 12, "High Priority").when(col("total_risk_score") > 8, "Moderate Priority").otherwise("Routine"))
    intervention_stats = intervention_priority.groupBy("intervention_urgency").agg(count("*").alias("urgency_count"), avg("age").alias("avg_age"), avg("attempts_to_quit_smoking").alias("avg_quit_attempts"))
    predictive_factors = comprehensive_risk.select(corr("total_risk_score", "age").alias("age_correlation"), corr("total_risk_score", "annual_income_usd").alias("income_correlation"), corr("total_risk_score", "attempts_to_quit_smoking").alias("quit_attempts_correlation"))
    success_prediction = comprehensive_risk.filter(col("attempts_to_quit_smoking") > 0).withColumn("quit_success_likelihood", when(col("social_support") == "High", 0.7).when(col("social_support") == "Medium", 0.5).otherwise(0.3) * when(col("therapy_history") == "Yes", 1.2).otherwise(1.0)).groupBy("risk_category").agg(avg("quit_success_likelihood").alias("avg_success_rate"))
    assessment_results = {"risk_distribution": risk_distribution.toPandas().to_dict("records"), "high_risk_profiles": high_risk_profile.toPandas().to_dict("records"), "intervention_priorities": intervention_stats.toPandas().to_dict("records"), "predictive_correlations": predictive_factors.collect()[0].asDict(), "success_predictions": success_prediction.toPandas().to_dict("records"), "total_assessed": comprehensive_risk.count()}
    return JsonResponse(assessment_results, safe=False)
烟酒成瘾个体数据分析与可视系统-结语
Hadoop+Spark计算机毕设选题:烟酒成瘾数据分析系统的大数据技术栈完整实现方案
支持我记得一键三连,再点个关注,学习不迷路!如果遇到有技术问题或者获取源代码,欢迎在评论区留言!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 5
 0
- 0


 已为社区贡献35条内容

所有评论(0)