如何在你的计算机上运行OpenAI新的gpt-oss-20b LLM?
你只需要24GB 的内存,除非你的GPU自带VRAM,否则需要相当的耐心。
上周,OpenAI发布了两款流行的开放权重模型,均名为gpt-oss。由于你可以下载它们,因此可以在本地运行。
轻量版模型gpt-oss-20b有210亿个参数,需要大约16GB的可用内存。较大版模型 gpt-oss-120b有1170亿个参数,需要80GB的内存才能运行。相比之下,像DeepSeek R1这样的前沿模型拥有6710亿个参数,需要大约875GB的内存才能运行,因此LLM开发者及合作伙伴正在尽快构建大型数据中心。
除非你运行的是高端AI服务器,否则可能无法在家用系统上部署gpt-oss-120b,但许多人拥有运行gpt-oss-20b所需的内存。你的计算机需要至少配备16GB专用VRAM的GPU,或者24GB 或更多的系统内存(至少留出8GB供操作系统和软件使用)。性能将在很大程度上取决于内存带宽,因此配备GDDR7或GDDR6X内存(1000+ GB/s)的显卡其性能将远胜过普通笔记本电脑或台式机的DDR4或DDR5(20 - 100 GB/s)。
下面,我们将讲解如何在Windows、Linux和macOS上免费使用这款新的语言模型。我们将使用Ollama,这个免费的客户端应用程序使得下载和运行该LLM变得轻而易举。
如何在Windows上运行gpt-oss-20b?
在Windows上运行新的LLM很简单。为此,先下载并安装Windows版Ollama。
打开Ollama 后,你会看到一个标记为“发送消息”的字段,右下角会显示一个可用模型的下拉列表,使用gpt-oss:20b作为默认模型。你可以选择另外的模型,但不妨使用这个模型。
输入任意提示。我先输入“Write a letter”(写一封信),Ollama开始下载12.4GB的模型数据。下载速度并不快。
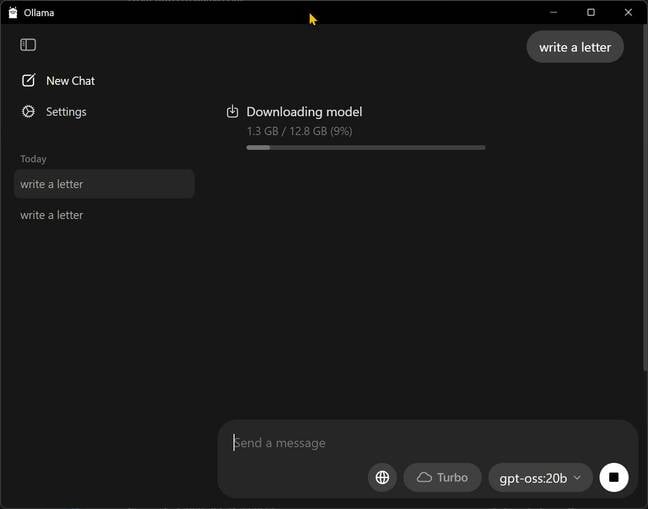
图1. 下载模型
下载完成后,你可以根据需要为gpt-oss-20b输入提示,然后点击箭头按钮提交请求。
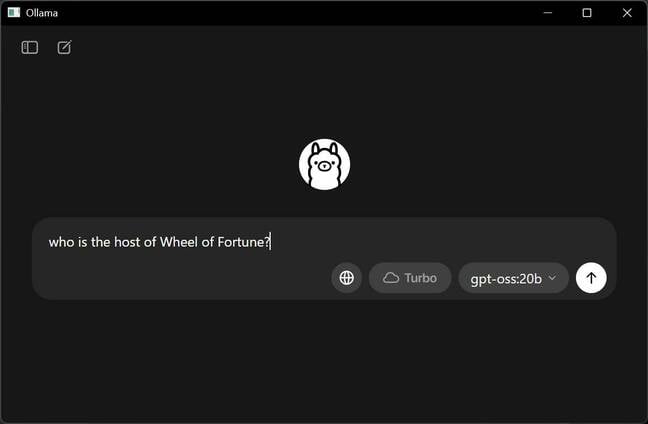
图2. 输入提示
如果你介意使用GUI,也可以从命令提示符运行Ollama。我建议这么做,因为CLI 提供了“详细模式”,可以提供性能统计信息,比如完成查询所需的时间。
要从命令提示符运行Ollama,请先输入:
复制
ollama run gpt-oss- 1.
(如果这是你第一次运行此命令,它需要从互联网下载模型。)然后,在命令提示符下输入:
复制
/set verbose- 1.
最后,输入你的提示。
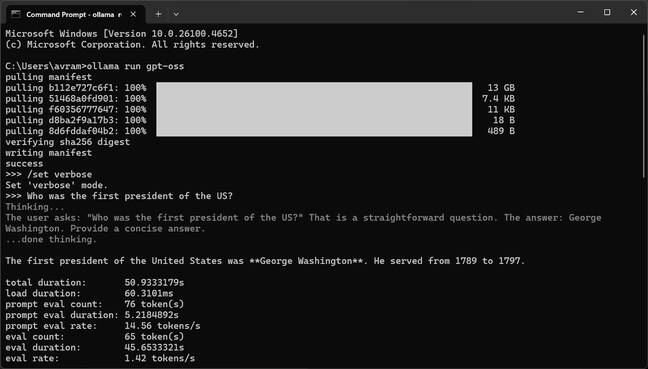
图3. 从命令行使用 Ollama
如何在Linux上运行gpt-oss-20b?
如果你尚未使用Linux 终端,请先启动终端。然后在命令提示符下输入以下命令:
复制
curl -fsSL https://ollama.com/install.sh | sh- 1.
然后,你需要等待软件下载并安装。
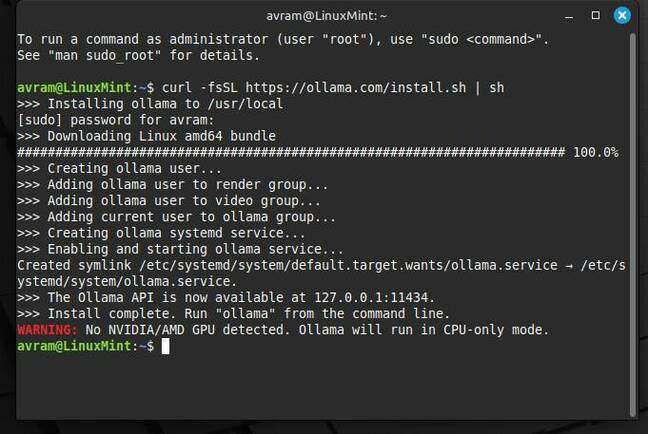
图4. 在Linux上安装 Ollama
然后输入以下命令启动 Ollama,使用gpt-oss:20b作为模型。
复制
ollama run gpt-oss- 1.
你的系统需要下载大约13GB的数据,然后你才能输入第一个提示。

图5. 在Linux 上运行Ollama
我建议通过输入以下命令打开详细模式:
复制
/set verbose- 1.
然后输入你的提示。
如何在Mac上运行gpt-oss-20b?
如果你使用现代Mac(M1 或更高版本),运行gpt-oss-20b就像在Windows上运行一样简单。先下载并运行macOS版本的Ollama安装程序。
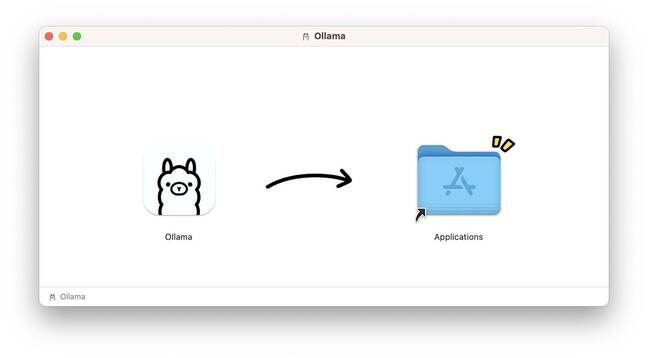
图6. 在macOS上安装 Ollama
启动Ollama,确保所选择的模型是gpt-oss:20b。

图7. 在macOS上启动Ollama
现在输入你的提示,点击向上箭头按钮,就可以上手了。
gpt-oss-20b 的性能:预期结果
为了了解gpt-oss-20b在本地计算机上的性能表现,我们在三台不同的设备上测试了两个不同的提示。首先,我们要求gpt-oss-20b“Write a fan letter to Taylor Swift, telling her how much I love her songs”(写一封信给Taylor Swift,告诉她我有多喜欢她的歌曲),然后给出简单得多的提示“Who was the first president of the US?”(谁是美国第一任总统?)。
我们使用以下硬件测试了这些提示:
- 联想ThinkPad X1 Carbon笔记本电脑,搭载酷睿Ultra 7-165U CPU和64GB LPDDR5x-6400 RAM。
- 苹果MacBook Pro,搭载M1 Max CPU和32GB LPDDR5x-6400 RAM。
- 自己搭建的PC,搭载独立英伟达RTX 6000 Ada GPU、AMD Ryzen 9 5900X CPU和128GB DDR4-3200 RAM。
在ThinkPad X1 Carbon上,性能很差,主要是由于Ollama没有充分利用其集成显卡或神经处理单元(NPU)。它花了整整10分13秒才输出一封600字长的信给Taylor Swift。与所有面向gpt-oss-20b的提示一样,系统花了一两分钟的时间在所谓“思考”的过程中展示其推理过程。之后,它会显示输出。用两句话简单地回答“谁是美国第一任总统?”用时51秒。
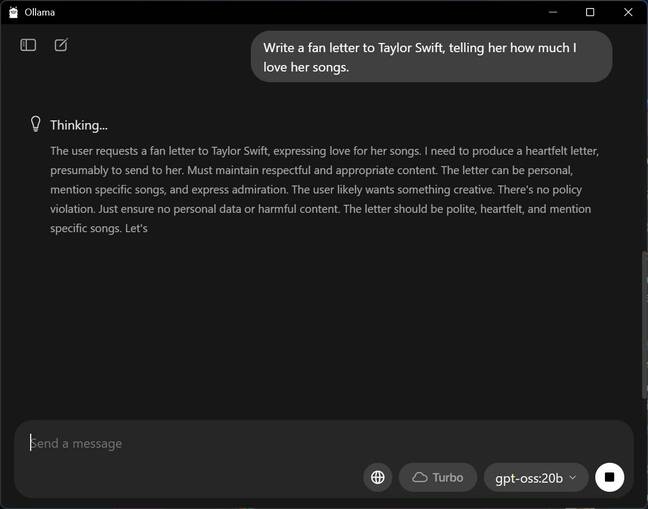
图8. gpt-oss-20b始终显示其思考过程
但至少我们写给Taylor的信充满了感人肺腑的歌词,比如:“Taylor,这不仅仅是歌曲,更是体现了你的真诚。你把你的伤疤变成了诗句,把你的胜利变成了合唱。”
尽管内存速度相同,但MacBook的表现远超ThinkPad,它在26秒内生成了粉丝来信,并在短短3秒内回答了第一任总统的问题。正如我们所料,搭载RTX 6000的台式机仅用6秒就写好了信,在不到半秒的时间内给出了第一任总统是乔治•华盛顿的回答。
总的来说,如果你在配备强大GPU的系统或新款Mac上运行该LLM,你将获得良好的性能。如果你使用基于英特尔或AMD处理器的笔记本电脑,搭载Ollama不支持的集成显卡,处理任务将被转移到CPU,你在输入提示后可能想去吃个午饭。或者,你可以试试LMStudio,这是另一个在PC上本地运行LLM的流行应用程序。
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获
四、AI大模型商业化落地方案
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 29
 0
- 0


 已为社区贡献25条内容

所有评论(0)