强化学习不能替代WBC/MPC:足式机器人混合控制架构解析
0. 前言:破除行业认知误区
过去几年,足式机器人的舆论几乎被两条平行叙事撕裂。
一条叙事来自视频:ETH RSL 的 ANYmal 在碎石堆上小跑,Unitree Go2 / G1 在展厅里跳舞、后空翻,Cassie 在田径场上跑完 5 公里。这些演示绝大多数是 Isaac Gym / Isaac Sim 大规模并行 RL 训出来的策略,外加关节 PD。于是很容易得出一个片面观点:强化学习可以替代传统模型控制,实现足式机器人的全自主运动控制。
另一条叙事来自机房和现场:Mini Cheetah 的凸 MPC 依然是教材,宇树自己仍在维护 unitree_guide 这套 FSM + 虚拟模型 / WBC 教学栈,ETH 的 OCS2 还在给 ANYmal 做全身 MPC,1X 这种“AI 优先”的人形公司反而把全身非线性 MPC 开源了出来。工厂里换一个 8 kg 负载、现场要保证摩擦锥和关节电流不爆,没有人敢把“约束”交给 reward 去“尽量满足”。
两条叙事其实并不矛盾,只是把不同层级的问题混为一谈了。RL 擅长的是:在难以解析建模的接触、地形、风格空间里,搜索出一个能用的闭环策略。MPC / WBC 擅长的是:在已知动力学与不等式约束下,每毫秒都给出可证明满足边界的力矩。把前者叫做“替代”,相当于说编译器优化已经很好,所以可以拆掉操作系统的内存保护。
在工业落地、量产机器人、行业头部方案(宇树、波士顿动力、优必选、小米人形、Google DeepMind、MIT)中真正跑在实机上的系统,几乎都是分层混合控制:RL 负责技能与适应性,MPC 负责有限时域的力与质心前瞻,WBC 负责多任务、接触约束和力矩级全身协调,最底层是关节伺服与安全状态机。所有商用、可落地、高可靠的足式机器人,无一例外都采用「RL增强 + MPC/WBC兜底」的分层混合控制架构。
下面按工程顺序把这件事拆开:Isaac 训练到底强在哪、RL 在实机上会死在哪、MPC / WBC 不可替代的原因是什么,以及四足和人形现在真正在用的分层长什么样。
1. 基于IsaacSim训练的RL的核心长处
想要客观评判RL的价值,首先要正视其优势。RL之所以成为足式机器人运动控制的核心研究方向,甚至成为行业标配的增强模块,核心依托于IsaacSim高性能仿真训练体系的加持,在复杂自适应运动场景具备传统模型控制无法企及的能力。
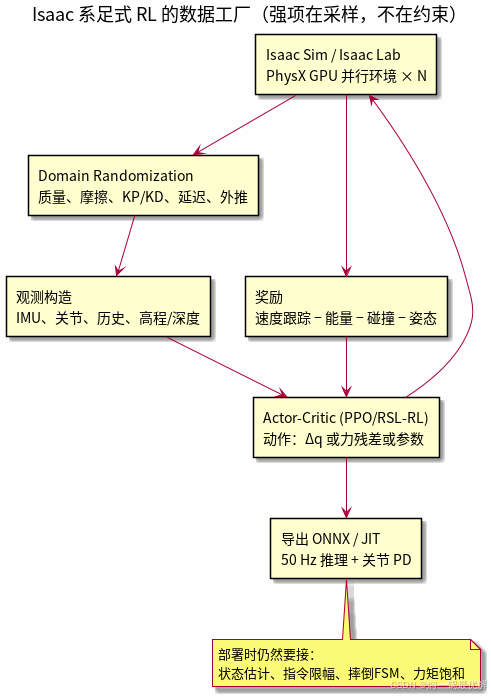
1.1 大规模并行,把非平滑接触变成可采样问题
足式控制最难的不是刚体方程,是接触:互补约束、摩擦锥、滑移、点接触到面接触的切换,解析梯度极差。MPC 通常只能用单刚体(SRBD)或质心动量模型做凸/近凸近似;一碰到复杂地形,模型误差会迅速把 QP 推到不可行。
Isaac 路线的核心不是“网络更聪明”,而是把接触交给仿真,把搜索交给并行:
- 单卡数千到上万个环境(Isaac Gym 时代常见 4096;Isaac Lab 在 Isaac Sim 上可按显存伸缩);
- PPO / RSL-RL 用同一套观测–动作接口吃掉所有 rollout;
- 几小时到一两天,就能在平地速度跟踪上收敛到可部署策略。
ETH 的 Learning to Walk in Minutes 把这件事变成了社区共识:以前在单进程 MuJoCo 里训几天的四足步态,GPU 并行后变成“喝杯咖啡”。Unitree 官方随后给出 unitree_rl_gym(Isaac Gym)和 unitree_rl_lab(Isaac Lab),覆盖 Go2、H1、G1-29DoF,说明这条训练管线已经从论文变成厂商标准零件。
1.2 超强的环境自适应与抗扰动泛化能力
IsaacSim支持批量并行仿真,单显卡可同时运行上百个机器人仿真实例,能够快速完成随机地形、随机摩擦、随机载荷、机身扰动的大规模数据训练。训练完成的RL策略,具备极强的环境自适应能力:
- 可自适应草地、碎石、斜坡、凹凸路面等非结构化地形
- 可应对机身负重、腿部磨损、外力推拉等动态扰动
- 可自主切换行走、小跑、跳跃、匍匐等多类步态
反观传统MPC/WBC,所有步态、运动参数都依赖人工整定或轨迹优化,面对超出建模范围的未知场景,极易出现步态僵硬、失衡摔倒问题。RL的泛化能力,是当前机器人实现柔性、智能运动的唯一可行方案。
1.3 复杂约束下的最优策略自主探索能力
足式机器人运动是典型的多约束优化问题:关节扭矩限制、角速度限制、接触力约束、零滑动约束、重心稳定约束等。传统控制需要工程师手动约束优化边界、设计代价函数,耗时耗力且难以找到全局最优解。
RL通过奖励函数设计,可在多约束空间中自主探索最优运动策略。针对高敏捷运动(高速奔跑、原地跳转、越障、跳跃落地),RL能够学习到人类工程师难以设计的精细化动态步态,大幅提升机器人的运动灵活性和极限性能。
小结:RL的核心价值是智能、自适应、高灵活性、低建模成本,解决了传统控制“僵硬、泛化差、建模难”的行业痛点,是机器人实现智能化运动的核心抓手。
2. RL的致命工程短板
尽管RL优势突出,但在工业落地、量产稳定性、安全可靠性层面,存在多个根本性、无法通过算力、数据、调参修复的致命短板。这些短板决定了RL永远只能做“增强模块”,无法成为足式机器人的底层控制底座。
2.1 约束只能被建议,不能被保证
这是最根本的一条。PPO 优化的是期望回报,不是可行性。摩擦锥、支撑多边形 / 零力矩点、关节力矩上限、单边接触(法向力 ≥ 0)、踝关节电流热积累,在 RL 里最多变成:
- 奖励里加一个 penalty;
- 动作后做一层 clip;
- 仿真里摔倒就 reset。
clip 不是摩擦锥。τ = clip(τ, τ_max) 只能保护电机驱动器,不能保证足端力落在 μ 锥内,也不能保证双足换步时质心投影仍在有效支撑域。你看到的“很少摔倒”,是训练分布上的统计结果;现场出现油污地面、单腿踩空、人拽着机械臂往外拉,策略没有 KKT 条件可以退守。
MPC / WBC 的不等式是求解器必须满足的约束(或带松弛但有明确优先级)。这是安全层和控制层的差别,不是“谁走得更帅”的差别。
2.2 黑盒让排障成本高于训练成本
MPC/WBC是白盒优化算法,每一步输出的控制量都满足动力学约束、安全约束,稳定性、安全性可数学证明。MPC 站不住,工程师会看:是水平力饱和、是 yaw 权重太小、还是足端估计在世界系。RL 站不住,日志里是一串 48 维观测和 12 维动作。你不知道它是把重力投影吃偏了、把历史相位用错了,还是对某种指令组合从未见过。
RL是典型的黑盒算法,策略输出的动作没有物理理论支撑,无法解释“为什么输出该扭矩、该步态”。
这带来两个致命工程问题:
- 稳定性不可控:遇到训练集外的极端场景,RL可能输出异常动作,直接导致机器人摔倒、损坏,无任何安全兜底机制。
- 故障无法定位:机器人运动异常时,无法通过理论公式溯源问题,只能反复改参数、增奖励函数,重新训练。
RL足式项目的真实工时分配,往往是:训练 20%,做状态估计和 sim2real 30%,查“为什么这次在斜坡第三级台阶向外翻” 占 50%。没有可解释中间量(期望 GRF、期望质心加速度、任务误差),现场就只能“再随机化一点、再加“penalty”。这不是研究态度问题,是产品无法迭代的问题。
2.3 策略绑定本体,负载和机构一变就要重训
QP 里质量矩阵变了,明天改 mass 和 Ixx 就能重新走。RL 策略里质量是被“吃进网络权重”的。加 5 kg 背包、换橡胶足垫、手臂伸出去做一个 2 kg 的末端工具,观测分布和动力学同时偏移。Domain randomization 只能覆盖你预算得起的分布;它不是万能外推。
工业现场最常见的需求恰恰是这些“小改动”:巡检机器狗今天背雷达、明天背机械臂;人形今天空手上楼梯,明天托着料箱。纯策略路线会把每次机构变更变成一次训练任务:数据、奖励、安全员、过拟合检查。模型基路线是一次建模、多次改参数。
2.4 组合任务几乎无法直接拼接
这是人形项目里最痛的一点。一个会走路的策略和一个会伸手的策略,不能像 WBC 任务那样 addTask(hand_pose) 就叠上去。全身 29 DoF 端到端策略可以同时学 loco-manipulation,但:
- 奖励权重会互相打架(走稳 vs 手准);
- 接触模式从“两只脚”变成“两只脚 + 一只手”,离散结构变了;
- 失败样本稀疏,学习信号极差;
- 上线后产品经理再说“希望左手无力控制、右手位置控制”,你没有任务接口可改,只能重训。
所以开源社区出现了 IsaacLab-Decoupled-WBC 这类明确的解耦:学生策略只管下肢和腰,上肢保持默认关节。这不是技术退步,这是承认:多任务优先级是 WBC 的语言,不是 MLP 的语言。
2.5 安全约束无法硬绑定,存在重大落地风险
机器人工业落地的核心底线是安全约束:关节扭矩上限、角速度上限、接触力阈值、重心稳定域、避免自碰撞等。
RL的奖励函数是软约束,只能“引导”策略趋近安全区间,无法“强制约束”。极端场景下,可能出现输入给策略的观测在训练分布之外,导致策略推理得出的actions异常,这会突破物理安全限制,输出超限扭矩、超范围动作,直接造成电机烧毁、机械结构损坏、整机倾倒等。
消费级四足摔倒是视频素材。工业四足撞到人和人形在工厂过道失去平衡,是责任事故。RL 策略没有“最坏情况约束”;功能安全(STO、力矩限、速度限、工作空间限)必须写在策略外面。
而MPC/WBC在优化求解过程中,可将所有安全约束、物理约束写入优化方程,硬绑定控制边界,无论何种场景,输出的控制量永远符合安全规范,这是量产机器人的核心安全保障。
2.6 时间尺度错配:接触事件比策略周期快一个数量级
策略常见 50 Hz,周期 20 ms。足端撞击、打滑起始、边缘失稳,是 1–5 ms 量级的事件。PD 能在 1 kHz 抗扰,但 PD 跟踪的是策略给出的 q_des;如果 q_des 本身已经把摆动腿送进奇异或把支撑腿送出摩擦锥,内环只能更准确地执行一个坏命令。
WBC / MPC 的价值就是在这个快层用当前接触力估计重解一次 QP。把快层也交给 50 Hz 策略,等于要求网络在训练时见过所有冲击相位——这在仿真里都做不到完整覆盖。
2.7 Reward hacking 与指令分布外
常见作弊包括:用高频抖动骗速度奖励、把一只脚拖在地上减碰撞项、在 yaw 跟踪里用侧向滑动代替转向。更隐蔽的是指令外推:训练时 v_x ∈ [−1, 1],操作员推到 1.3,策略可能直接跪地。MPC 在同样情况下会饱和到可行集边界,表现是“走不动”而不是“炸”。产品上,可预测的性能下降远比偶发崩溃更容易被接受。
3. MPC / WBC 为什么仍然不可替代
把 RL 的短板反过来,就是模型基控制还活着的原因。它们不是“更传统”,而是把工程必须守住的东西写成了数学对象。
3.1 MPC:在有限视界里显式做前瞻
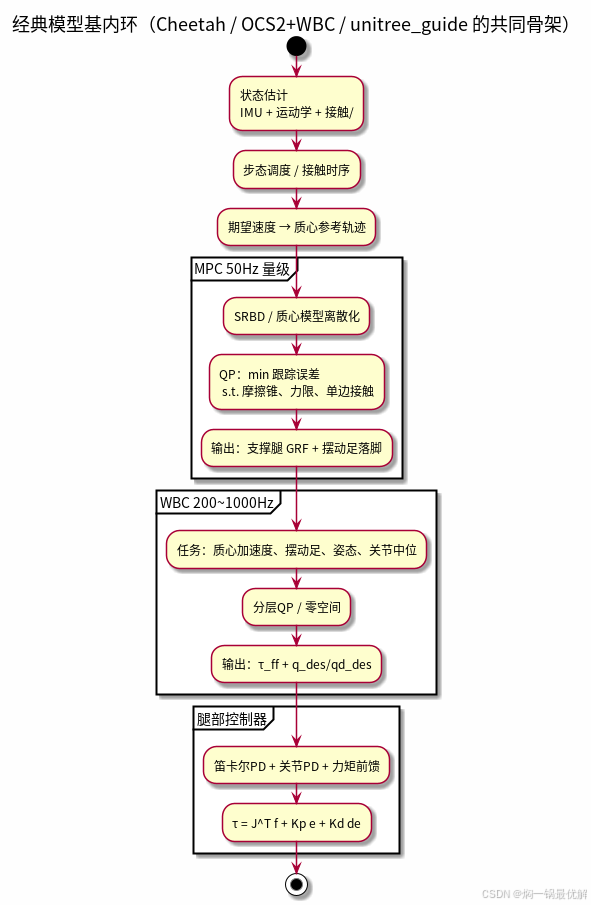
以 Mini Cheetah / Cheetah Software 的凸 MPC 为代表,四足最常用的是单刚体模型:机身 13 维状态(姿态、位置、角速度、线速度、重力),输入是四条腿的 GRF,预测视界大约 0.3–0.5 s、10 步左右。代价函数惩罚姿态、位置、速度跟踪,约束包括:
- 摆动腿力为 0、支撑腿法向力 ≥ 0;
- 摩擦锥(常线性化为棱锥);
- 力上限;
- 有时还有 ZMP / 压力中心落在足底。
MIT 的贡献不仅是“能走”,而是把这套 QP 做到 实时 30–50 Hz、求解毫秒级(OSQP / qpOASES)。开源仓库 mit-biomimetics/Cheetah-Software 仍然是这条路线的参考实现。后续 Google 的 motion imitation 栈、rl-mpc-locomotion 的 Python 移植,都是在同一套凸 MPC 接口上长出来的。
双足尤其依赖这一点:单支撑相如果只做当前时刻的 QP,就无法为即将到来的摆动落地留出储备;NMPC 则可以把接触切换写进预测视界(OCS2 的 switched system 正是为此设计)。
3.2 WBC:把“全身同时干很多事”变成可优先级的 QP
WBC 处理的问题是:给定当前接触、给定高层轨迹(来自 MPC、来自 RL、来自运动学示教),求解
M(q)q¨+h(q,q˙)=S⊤τ+Jc⊤f
M(q)\ddot{q} + h(q,\dot{q}) = S^\top \tau + J_c^\top f
M(q)q¨+h(q,q˙)=S⊤τ+Jc⊤f
同时满足任务:机身姿态、摆动足轨迹、接触不穿透、关节中位、手臂末端位姿……以及不等式:力矩限、摩擦锥、关节限。
工业实现通常是分层 QP 或零空间投影:高优先级任务(接触约束、平衡)写成硬约束,低优先级任务(姿态美观、手臂)在零空间里尽量做。这和 RL 的“一个标量 reward 里加权求和”有本质区别——优先级是结构,不是碰运气调参。
开源上,qiayuanl/legged_control 把这件事写得很清楚:OCS2 的 NMPC 给出质心和足端参考,WBC 在完整刚体动力学上求力矩,再经 ros-control 下到 A1。作者明确写了数据流:NMPC 优化状态与输入 → WBC 根据全阶动力学算出关节力矩。这不是示例代码,而是国内大量四足实验室的实机起点。
3.3 模型可改、约束可加、行为可解释
这三条合在一起,才是“工业可维护”:
- 改模型:负载从 0 到 15 kg,改质量和惯量,MPC 立刻换一套 GRF 分配。手臂伸出导致质心前移,WBC 的接触约束自动把踝力矩重新分配。
- 加约束:机械臂进入禁区?加笛卡尔不等式。某一颗电机过热?把对应力矩上限从 30 Nm 改到 18 Nm,QP 仍可能有解,最多走得更保守。
- 可解释:日志里有期望 GRF、任务误差、QP 不可行标志。现场可以画曲线,而不是只说“策略这帧的 logit 比较奇怪”。
对人形 loco-manipulation,这几乎是刚需。1X 开源的 wb_humanoid_mpc(基于扩展版 OCS2,支持 Unitree G1 的质心 MPC 与全阶全身动力学 MPC)说明:即便公司定位是数据与神经网络,实时全身 NMPC 仍被当作 loco-manipulation 的规划与控制底座。论文叙事里“统一 MPC 框架同时做行走和操作”(Sleiman 等在 ANYmal 上的工作)与此一致。
3.4 诚实对照:MPC / WBC 也有做不到的事
混合架构不是为了给模型基控制唱颂歌。它们的短板同样明确:
- 模型错了就会“自信地做错”:腿惯量忽略过多、接触估计反了,QP 仍会给出漂亮的不可行解之外的次优力;
- 代价权重是一门手艺:
rl-mpc-locomotion把 12 维 MPC 权重暴露给 RL,本身就说明靠手工很难在全工况下调好; - 复杂地形与风格运动上,SRBD + 手工步态调度打不过大规模 RL;
- 全阶 NMPC 的实时性、初始化、接触模式调度,工程量远大于“训一个 PPO”。
所以正确表述是:MPC/WBC 守住可行与可维护,RL 打开技能与适应性。谁替代谁,是伪问题。
4. 当前行业真实分层架构
把厂商 Demo 和开源仓库对着看,会发现一个非常稳定的图案:四足和人形都在用分层,只是学习模块插入的高度不同。
4.1 三种已经被开源验证的混合模式
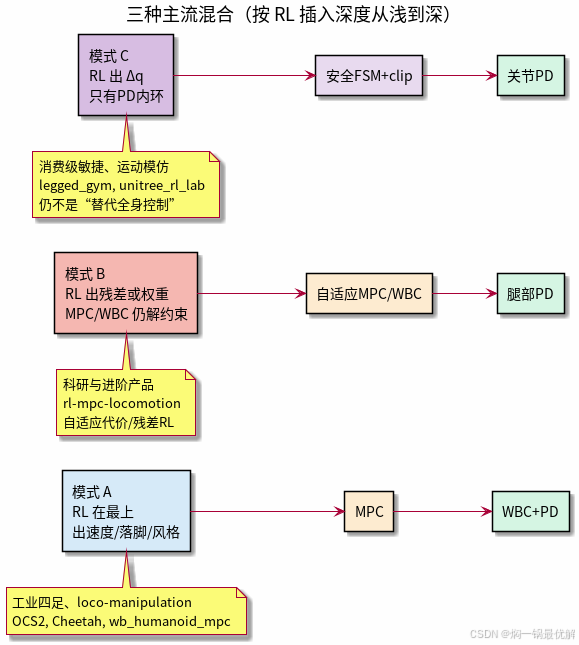
- 模式 A:高层 RL 或规划给出速度、落脚区域、操作意图;中层 MPC 管平衡与力;下层 WBC 管全身任务。适合载重、操作、要保证接触力的场合。
- 模式 B:MPC / WBC 结构保留,RL 只学人调不好的那部分(代价权重、残差力、步态相位)。约束不破,适应性上来。
- 模式 C:策略直接出关节目标,PD 跟踪。开发最快、技能上限高、约束最弱。消费级四足和人形“走路 / 跳舞”主流都在这里,但产品仍要在外面加 FSM。
同一家公司可以同时卖 A 和 C。这不是架构混乱,是场景分化。
4.2 四足:开源仓库把“双栈并存”写在明面上
(1)MIT Cheetah-Software:教材级模式 A 的下半截
仓库:https://github.com/mit-biomimetics/Cheetah-Software
凸 MPC 出 GRF,WBC 把机身任务和腿部任务合成力矩,再加笛卡尔 / 关节 PD。Mini Cheetah 能在实验室里跑、跳、受扰恢复,靠的不是端到端策略,而是 50 Hz 前瞻 + 500 Hz 全身 QP。后来几乎所有 Python/Isaac 移植(包括 rl-mpc-locomotion)都在复用这套接口:传感器进、力矩出,中间可插仿真器。
(2)宇树 unitree_guide:厂商自己的教学与基础控制栈
仓库:https://github.com/unitreerobotics/unitree_guide
这是宇树配套教材《四足机器人控制算法——建模、控制与实践》的工程实现:FSM(Passive / FixedStand / Trot …)+ 虚拟模型 / WBC 思路的底层控制。官方 README 写得很直白:基础控制器面向入门,要更好性能需要调参或上更先进方法(例如 MPC)。社区随后出现 unitreeMPC_guide、QUAD-MPC-SIM-HW 等,把凸 MPC 嵌进同一套 FSM,并在 Go1 实机上验证。
(3)宇树 unitree_rl_gym / unitree_rl_lab:厂商自己的 RL 栈
仓库:
https://github.com/unitreerobotics/unitree_rl_gymhttps://github.com/unitreerobotics/unitree_rl_lab
同一家厂商,同时维护模型基教学栈和 Isaac 训练栈。Go2、H1、G1 都可以在 Isaac Gym / Isaac Lab 里训 PPO,导出后经 MuJoCo 中转再上实机。这是目前最有说服力的行业证据:不是 RL 取代了 WBC,是产品线需要两种交付物。 展厅花活走模式 C,教材、二次开发、需要可读控制的场合走 unitree_guide。
(4)qiayuanl/legged_control:国内落地率最高的 NMPC+WBC
仓库:https://github.com/qiayuanl/legged_control
基于 ETH ocs2 + ros-control,NMPC 与 WBC 分工明确,A1 实机被大量实验室在数小时到数天内跑通。它证明模式 A 在 2020 年代依然是“要可靠性时的默认答案”。OCS2 本身(leggedrobotics/ocs2)来自 ANYmal 团队,是切换系统最优控制工具链,工业四足里“能同时走路和操作”的那一派,基本都从这里汲取方法。
(5)ETH legged_gym + 技能型 RL:模式 C 的源头
仓库:https://github.com/leggedrobotics/legged_gym
以及 walk-these-ways、Extreme Parkour。它们把 Isaac 并行 RL 做到了极致:一个策略覆盖宽指令,或直接看深度图跨障碍。实机上仍然是 PD + 估计 + 安全逻辑。ANYbotics 的产品化机器人和 ETH 论文机器人不是同一个软件栈;论文可以纯 RL,产品要过安全与维护,分层会加回来。
(6)rl-mpc-locomotion:模式 B 的完整开源切片
仓库:https://github.com/silvery107/rl-mpc-locomotion
这是理解“RL 不能替代 MPC”最合适的教学项目之一:高层策略不出力矩,只动态预测凸 MPC 的 12 维代价权重;下层完整保留 Cheetah 风格 MPC(Python + OSQP/C++ 求解器),在 Isaac Gym 里对 Aliengo 并行训练,并在真机 Aliengo 上做过 sim2real。FSM(Recovery Stand / Locomotion)、状态估计、腿部控制器全部在。下文第 5 节会把它当作范例来讲解。
4.3 人形:学习更猛,底层约束反而更硬
人形比四足多了两件事:欠驱动更严重(单支撑相支撑域很小),以及上肢任务必须和平衡抢接触力。所以开源世界里出现了一种看起来矛盾的繁荣:运动模仿 RL 极其火,全身 NMPC 也在同期开源。
(1)官方 RL:unitree_rl_lab 的 G1-29DoF 速度跟踪
模式 C。策略管全身或下肢关节目标,适合走、转、简单地形。这是把四足成功经验平移到人形,上限是“像人一样走起来”,不是“一边走一边以牛顿级精度拧螺丝”。
(2)解耦全身控制:IsaacLab-Decoupled-WBC
仓库:https://github.com/chrisyrniu/IsaacLab-Decoupled-WBC
教师策略 / 学生蒸馏,部署路径上学生管下肢和腰,上肢钉在默认位置。它被用在 Unitree G1 的 Humanoid Touch Dream 实验。名字里的 WBC 指“全身/下肢控制器”这一产品形态,架构含义更重要:人形落地会主动把上肢从平衡策略里拆出去,以便以后把上肢交给真正的任务空间 WBC 或第二个策略。
(3)运动模仿部署:wbc-g1-deploy / wbc-mjlab
ONNX 全身跟踪,一套策略切多个 NPZ 动作片段(LAFAN1 等)。这是 2024–2025 年人形最显眼的开源路线:在仿真里对齐动作,在实机用高增益 PD 跟踪。它能跳舞、能翻,但对接触力没有显式锥约束。作为技能层非常强,作为操作层不够。
(4)全身 NMPC:wb_humanoid_mpc
仓库:https://github.com/manumerous/wb_humanoid_mpc(1X Technologies 支持开源,支持 Unitree G1)
质心 MPC 优化全身运动学与质心动量;全阶全身动力学 MPC 直接在力矩级预测。依赖 OCS2、Pinocchio、HPIPM。这是模式 A 在人形上的当代形态。一个做神经网络人形的公司把这套东西开源,比任何评论都更能说明:loco-manipulation 的可行集,仍然需要在线最优控制来守。
(5)更老的工业人形栈:IHMC、mc_rtc、Drake
Atlas / Valkyrie 时代的 IHMC 开源 Java 栈、CNRS 的 mc_rtc、TRI 的 Drake,全是 QP WBC + 规划。它们不太出短视频,但工厂、航天、研究平台的全身控制文档是从这里写出来的。新一代学习型人形若要进这些场景,最后还是会把参考轨迹交给类似的 QP。
4.4 一张对照表,避免被 Demo 带跑
| 场景 | 更常见的栈 | 开源锚点 | RL 替代了什么 | RL 没替代什么 |
|---|---|---|---|---|
| 消费级四足花活 | 模式 C | unitree_rl_gym, walk-these-ways | 步态生成、风格 | 关节PD、FSM、保护 |
| 科研敏捷 / 跑酷 | 模式 C + 视觉 | Extreme Parkour, Isaac Lab | 落脚与跨越策略 | 接触约束保证 |
| 实验室载重四足 | 模式 A | Cheetah-Software, legged_control | 可选的高层指令 | MPC、WBC、估计 |
| 自适应地形四足 | 模式 B | rl-mpc-locomotion | 代价权重 / 残差 | 摩擦锥与力分配 |
| 人形走路 / 跳舞 | 模式 C | unitree_rl_lab, wbc-g1-deploy | 全身参考运动 | PD、状态机 |
| 人形行走+作业 | 模式 A 或解耦 | wb_humanoid_mpc, Decoupled-WBC | 技能与上肢策略 | 平衡约束、接触QP |
| 工业安全优先 | A + 安全层 | OCS2, mc_rtc, Drake | 至多高层规划 | 整条约束链 |
5. 解剖一个开源项目:用 RL 预测 MPC 权重
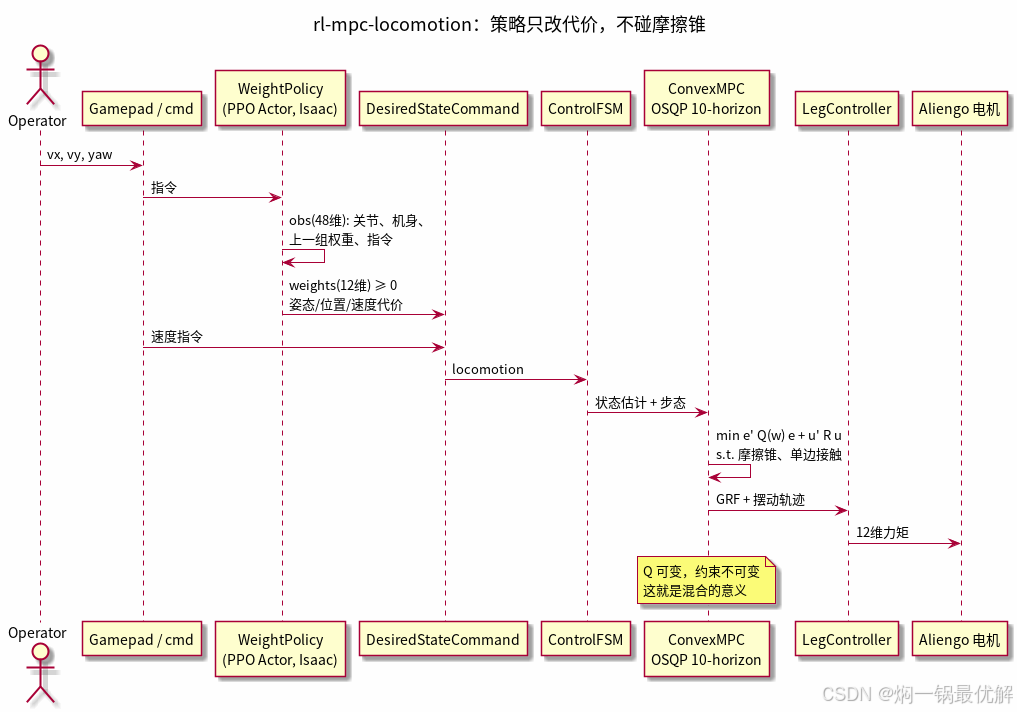
把模式 B 讲清楚,最好对着一套能跑的代码。rl-mpc-locomotion 的目标不是“用网络取代 MPC”,README 第一句就写了:高层策略网络 + 底层模型预测控制;RL 动态预测 MPC 的权重参数。
数据流可以画成:
几个工程细节值得单独拿出来,因为它们就是“为什么不能替代”的微观证据。
权重有物理含义。 12 维大致对应姿态三项、位置三项、角速度三项、线速度三项的跟踪权重(再补一个占位)。训练时把网络输出从 ([-1,1]) 仿射到正区间,并在 DesiredStateCommand 里断言所有权重 ≥ 0。网络不能把 QP 改成非凸,也不能关掉摩擦锥。
MPC 仍然按自己的频率解。 控制器 dt=0.01 s,凸 MPC 视界 10 步,OSQP 求解在 C++ 绑定下可到毫秒级。开发日志里写过一个典型权衡:策略更新和 MPC 50 Hz 并不同步,差一倍时仍可接受。如果让网络直接出力矩,你就失去了这 10 步前瞻和全部不等式。
FSM 没有被训练掉。 Recovery Stand、Passive、Locomotion 仍在。RL 训练时甚至会关掉部分安全检查以免频繁 reset,部署时再打开 FSM_check_safety。这是所有正经混合系统的共同纪律:训练分布可以冒险,部署状态机必须保守。
仿真器被当成可替换的刚体源。 控制器与 Isaac Gym API 解耦,输入只有 DOF / 刚体状态,输出只有腿力矩。这保证 MPC 可以迁到 Gazebo、实机、或其他仿真,而不把策略和渲染绑死。模式 C 的策略往往和训练环境的观测定义死绑,迁移成本更高。
真机验证说明混合是为了 sim2real,不是为了发论文。 rl-mpc-locomotion展示了 Aliengo 的 MPC 上下台阶以及 sim2real 片段。RL 的职责是让同一套 QP 在不同速度、地形下少调手工权重;摔倒恢复、站立、力限,仍然是模型基代码。
如果你正在做自己的项目,这个项目给出的接口建议非常具体:
- 让 RL 输出低维、非负、有界、有物理单位或代价含义的量;
- 让 QP 继续拥有不可学习的约束块;
- 让 FSM 继续拥有不可学习的状态切换;
- 用 Isaac 并行去搜那些手工搜不动的权重曲面,而不是去搜 12 维力矩本身。
6. 工程上怎么选、怎么接
架构选择可以按三个问题做决策,而不必站队。
第一,失败是否可接受? 展厅摔倒可以重来,选模式 C,迭代最快。近人、近设备、有负载,选 A 或 B,把摩擦锥和力矩限留在 QP 里。
第二,任务是否要在线改优先级? 今天只要走路,模式 C 足够。明天要“左臂柔顺、右臂定位、腰保持相机平视、脚还得上台阶”,必须有 WBC 任务接口。把这些塞进一个 reward,会把项目做成无限调权。
第三,本体是否频繁变? 固定结构的消费级机器狗,训一个总策略可以卖一年。模组化人形、可换末端、可换电池包,优先模型基内环,RL 只当技能插件。
接口上有几条已经被多次验证的“少后悔”设计:
- 频率分层不可倒。 策略 50 Hz,QP 200 Hz+,电流环 kHz。不要让 Python 策略去抢 WBC 的节拍。
- 动作空间尽量靠近任务。 速度、落脚、权重、笛卡尔残差,优于原始力矩。力矩学习在仿真里好看,实机上对延迟和饱和极敏感。
- 观测要对齐估计器,而不是对齐仿真真值。 Isaac 里随便拿 base lin vel,实机没有。
- 安全层写在策略外面,且默认接管。 conservatively:倾角过大切 Recovery,QP 不可行切站立阻尼,总线超时切电流零。
- 日志要记中间量。 即使模式 C,也建议在线算一个“事后 QP”做诊断:当前接触下若用 WBC 会要多少力。这能告诉你策略离可行集有多远。
Isaac Sim / Isaac Lab 在这个图景里的位置也很清楚:它是技能工厂和域随机化工厂,不是实机操作系统。用它训出 Actor,再把 Actor 嵌进有约束的运行时,这才是 2024–2026 年开源社区真正收敛的做法。
7. 结论
强化学习不能替代 WBC / MPC,是因为它们根本不是同一类部件。
Isaac 并行 RL 的长处是实打实的:它把接触丰富、模型难看的技能搜索,变成了可规模化的计算。没有它,就没有今天四足的公园跑酷和人形的运动模仿。它的致命短板同样实打实:约束是软的,本体是绑死的,任务是不可组合的,排障是不透明的,快接触事件和安全责任都不在 50 Hz 策略的能力范围内。
MPC 提供有限时域的力与质心前瞻,WBC 提供带优先级的全身可行力矩。它们在敏捷上可能输给网络,在可约束、可修改、可解释、可认证上没有替代物。宇树同时维护 unitree_guide 与 unitree_rl_lab,ETH 同时产出 OCS2 与 legged_gym,1X 在做 AI 人形的同时开源 wb_humanoid_mpc,MIT 的凸 MPC 仍被 Python 生态反复移植——这些不是历史惯性,是分层之后的稳态。
更准确的工作方式是一句话:
让 RL 去生成技能与参数,让 MPC 去分配未来几百毫秒的接触力,让 WBC 在当前时刻把多任务收成不越界的力矩,让关节伺服和 FSM 把机器人活着带回来。
参考文档与开源项目
- MIT Cheetah Software:https://github.com/mit-biomimetics/Cheetah-Software
- Unitree Guide:https://github.com/unitreerobotics/unitree_guide
- Unitree RL Gym / RL Lab:https://github.com/unitreerobotics/unitree_rl_gym ,https://github.com/unitreerobotics/unitree_rl_lab
- ETH OCS2:https://github.com/leggedrobotics/ocs2
- legged_control(NMPC+WBC):https://github.com/qiayuanl/legged_control
- ETH legged_gym:https://github.com/leggedrobotics/legged_gym
- walk-these-ways:https://github.com/Improbable-AI/walk-these-ways
- rl-mpc-locomotion:https://github.com/silvery107/rl-mpc-locomotion
- wb_humanoid_mpc(G1 全身 NMPC):https://github.com/manumerous/wb_humanoid_mpc
- IsaacLab-Decoupled-WBC:https://github.com/chrisyrniu/IsaacLab-Decoupled-WBC
- wbc-g1-deploy:https://github.com/wbc-mjlab/wbc-g1-deploy
- NVIDIA Isaac Lab 文档:https://isaac-sim.github.io/IsaacLab/
(本文观点来自开源仓库结构与可复核的工程接口,不代表各厂商未公开的量产软件全貌。产品内部往往比开源更分层。)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献8条内容

所有评论(0)