手撕语音情绪识别项目之深度学习项目python版本
一、数据集介绍
CREMA-D 是一个演员表演众包标注的多模态情绪数据集,专门用于研究多模态情绪的表达和感知。以下是其详细介绍:
- 数据来源:数据集包含 91 名演员的 7442 个原始片段,演员年龄在 20 到 74 岁之间,涵盖非裔美国人、亚裔、白人、拉丁裔等多种种族和族裔背景,其中男性演员 48 名,女性演员 43 名。
- 数据采集内容:演员们被要求大声朗读 12 个预选句子,每个句子用六种不同情绪(愤怒、厌恶、恐惧、快乐、悲伤、中性)和不同强度(低、中、高、不明确)来表达。
- 标注方式:由 2443 名众包标注者以纯音频、纯视频、视频 + 音频三种模态进行标注,每个片段在每种模态下都有情绪分类标签和强度标签。
- 数据集规模:数据集大小为 1.65GB,训练集包含 300 个样本。
- 数据子集划分:从感知模态的角度看,该数据集分为匹配、不匹配和模糊三个子集,每个子集都包含所有片段及其在该模态下的情绪标签。此外,还分出了一个具有 10 个或更多分类标注的剪辑子集(称为 MAIN set)。
- 数据特点:CREMA-D 数据集的特点在于其多模态数据的丰富性,包含音频文件、性别信息、多类型指令与答案等特征。其多样化的数据特征为情感计算、语音识别等领域提供了广泛的研究空间。
- 应用领域:适用于情感识别、语音分析及多模态学习等任务,为情感计算、语音识别及人机交互领域提供了重要的数据支持。
二、音频数据处理和深度学习模型的准备
1. 导入必要的库
-
数据处理和可视化:
pandas、numpy、matplotlib、seaborn用于数据处理和可视化。 -
音频处理:
librosa用于加载和分析音频文件,提取音频特征(如 MFCC、频谱等)。 -
机器学习工具:
scikit-learn的工具用于数据预处理(如标准化、独热编码)和模型评估(如混淆矩阵、分类报告)。 -
深度学习框架:
keras和tensorflow用于构建和训练深度学习模型,包括循环神经网络(LSTM、GRU)和卷积神经网络(CNN)。 -
音频播放:
IPython.display和Audio用于在 Jupyter Notebook 中播放音频文件,方便调试和展示。
2. 数据预处理
-
音频特征提取:使用
librosa提取音频文件的特征,如 MFCC(Mel 频率倒谱系数)、频谱图等。 -
数据标准化:使用
StandardScaler对特征进行标准化处理,使特征值分布在相似的范围内。 -
标签处理:使用
OneHotEncoder将类别标签转换为独热编码,方便模型训练。 -
数据集划分:使用
train_test_split将数据集划分为训练集和测试集。
3. 深度学习模型构建
-
模型架构:构建了一个基于
keras的深度学习模型,可能包括以下几种层:-
卷积层(Conv1D):用于提取音频信号的局部特征。
-
池化层(MaxPooling1D 或 AveragePooling1D):用于降低特征维度,减少计算量。
-
循环神经网络层(LSTM 或 GRU):用于处理时间序列数据,捕捉音频信号的时间依赖性。
-
全连接层(Dense):用于将提取的特征映射到最终的分类结果。
-
正则化层(Dropout):用于防止模型过拟合。
-
-
模型编译:使用优化器(如
SGD或其他优化器)和损失函数(如分类交叉熵)编译模型。 -
模型训练:使用训练数据训练模型,并通过回调函数(如
ModelCheckpoint)保存最优模型。
4. 模型评估
-
评估指标:使用混淆矩阵(
confusion_matrix)和分类报告(classification_report)评估模型的性能。 -
可视化:使用
matplotlib和seaborn绘制混淆矩阵等图表,直观展示模型的分类效果。
5. 代码展示
# 导入常用库
import pandas as pd  # 数据处理
import numpy as np   # 数学运算

import os            # 文件操作
import sys           # 系统设置

# 音频处理库
import librosa       # 音频分析
import librosa.display  # 音频可视化

# 数据可视化
import seaborn as sns  # 绘图
import matplotlib.pyplot as plt  # 绘图

# 机器学习工具
from sklearn.preprocessing import StandardScaler, OneHotEncoder  # 数据预处理
from sklearn.metrics import confusion_matrix, classification_report  # 模型评估
from sklearn.model_selection import train_test_split  # 数据集划分

# 音频播放
import IPython.display as ipd
from IPython.display import Audio

# 深度学习框架
import keras
from keras.preprocessing import sequence  # 序列处理
from keras.models import Sequential  # 模型构建
from keras.layers import Dense, Embedding, LSTM, BatchNormalization, GRU  # 神经网络层
from keras.preprocessing.text import Tokenizer  # 文本处理
from keras.preprocessing.sequence import pad_sequences  # 序列填充
from tensorflow.keras.utils import to_categorical  # 标签处理
from keras.layers import Input, Flatten, Dropout, Activation, Conv1D, MaxPooling1D, AveragePooling1D  # 网络层
from keras.models import Model  # 模型定义
from keras.callbacks import ModelCheckpoint  # 模型保存
from tensorflow.keras.optimizers import SGD  # 优化器

# 忽略警告
import warnings
if not sys.warnoptions:
    warnings.simplefilter("ignore")
warnings.filterwarnings("ignore", category=DeprecationWarning)

import tensorflow as tf  # 深度学习框架
print("Done")  # 完成提示
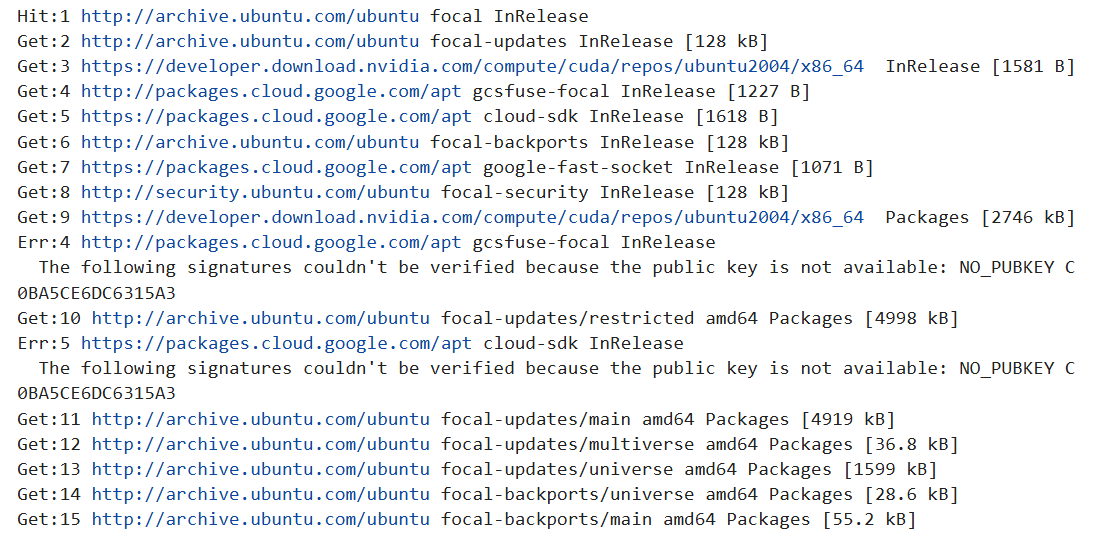
更新一下本地库和安装一下libsndfile1
!apt-get update
!apt-get install -y libsndfile1
三、导入数据
以下是按照官方RAVDESS网站的文件名标识符说明:
Ravdess Dataframe
Here is the filename identifiers as per the official RAVDESS website:
- Modality (01 = full-AV, 02 = video-only, 03 = audio-only).
- Vocal channel (01 = speech, 02 = song).
- Emotion (01 = neutral, 02 = calm, 03 = happy, 04 = sad, 05 = angry, 06 = fearful, 07 = disgust, 08 = surprised).
- Emotional intensity (01 = normal, 02 = strong). NOTE: There is no strong intensity for the 'neutral' emotion.
- Statement (01 = "Kids are talking by the door", 02 = "Dogs are sitting by the door").
- Repetition (01 = 1st repetition, 02 = 2nd repetition).
- Actor (01 to 24. Odd numbered actors are male, even numbered actors are female).
So, here's an example of an audio filename. 02-01-06-01-02-01-12.mp4 This means the meta data for the audio file is:
- Video-only (02)
- Speech (01)
- Fearful (06)
- Normal intensity (01)
- Statement "dogs" (02)
- 1st Repetition (01)
- 12th Actor (12) - Female (as the actor ID number is even)
# 准备数据集

# 定义RAVDESS数据集音频文件的存储路径
ravdess = "/kaggle/input/ravdess-emotional-speech-audio/audio_speech_actors_01-24/"

# 使用os.listdir()获取该路径下的所有文件和文件夹列表
ravdess_directory_list = os.listdir(ravdess)

# 打印查看目录内容列表
print(ravdess_directory_list)
['Actor_02', 'Actor_17', 'Actor_05', 'Actor_16', 'Actor_21', 'Actor_01', 'Actor_11', 'Actor_20', 'Actor_08', 'Actor_15', 'Actor_06', 'Actor_12', 'Actor_23', 'Actor_24', 'Actor_22', 'Actor_04', 'Actor_19', 'Actor_10', 'Actor_09', 'Actor_14', 'Actor_03', 'Actor_13', 'Actor_18', 'Actor_07']
创建表情标签:
# 创建情感标签的DataFrame
emotion_df = pd.DataFrame(file_emotion, columns=['Emotions'])  # 将情感编号列表转换为DataFrame,列名为'Emotions'

# 创建文件路径的DataFrame
path_df = pd.DataFrame(file_path, columns=['Path'])  # 将文件路径列表转换为DataFrame,列名为'Path'

# 合并两个DataFrame(横向合并)
ravdess_df = pd.concat([emotion_df, path_df], axis=1)  # 将情感和路径DataFrame按列合并

# 将数字情感编号替换为实际情感名称
ravdess_df.Emotions.replace({
    1: 'neutral',  # 1和2都对应中性情感
    2: 'neutral',
    3: 'happy',    # 快乐
    4: 'sad',      # 悲伤
    5: 'angry',    # 愤怒
    6: 'fear',     # 恐惧
    7: 'disgust',  # 厌恶
    8: 'surprise'  # 惊讶
}, inplace=True)  # 直接修改原DataFrame

# 打印DataFrame的前5行(查看头部数据)
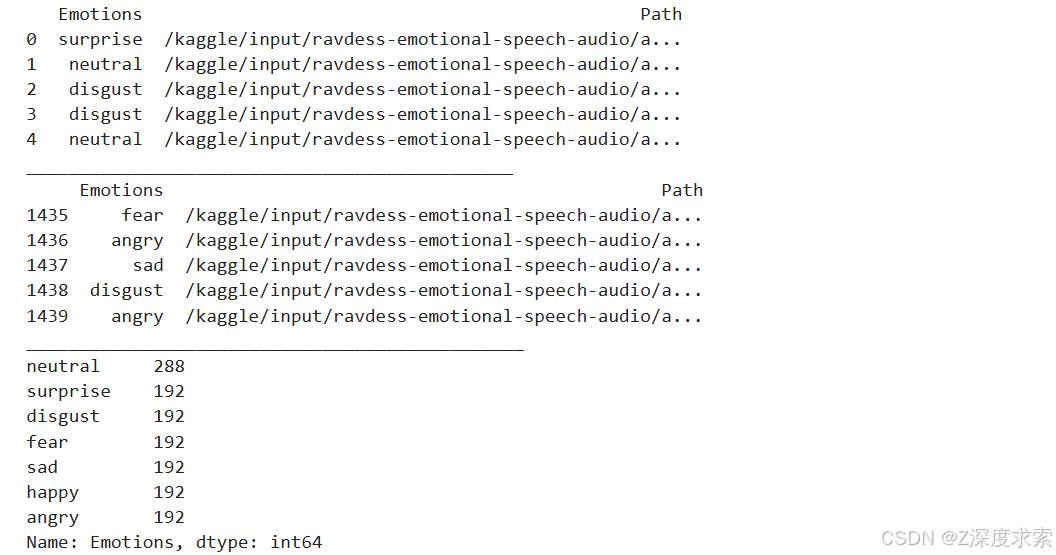
print(ravdess_df.head())
print("______________________________________________")

# 打印DataFrame的最后5行(查看尾部数据)
print(ravdess_df.tail())
print("_______________________________________________")

# 统计并打印每种情感的出现次数
print(ravdess_df.Emotions.value_counts())
CREMA-D(众包多模态情感演员数据集)是一个包含7,442条原始语音片段的数据集,采集自91名不同背景的演员,具体构成如下:
-
演员信息:
-
48名男性与43名女性演员
-
年龄覆盖20至74岁
-
涵盖多种族裔背景:非裔、亚裔、白人、拉丁裔及未注明族裔群体
-
-
语音内容:
-
采用12种标准化台词文本
-
每段台词以6种基础情感呈现:
• 愤怒(Anger)
• 厌恶(Disgust)
• 恐惧(Fear)
• 快乐(Happy)
• 中性(Neutral)
• 悲伤(Sad)
-
-
情感强度分级:
-
包含4级情感表达强度:
• 轻度(Low)
• 中度(Medium)
• 强烈(High)
• 未指定强度(Unspecified)
-
# 获取CREMA数据集目录下的所有文件列表
crema_directory_list = os.listdir(Crema)

# 初始化存储情感标签和文件路径的空列表
file_emotion = []  # 用于存储从文件名解析出的情感标签
file_path = []     # 用于存储完整的文件路径

# 遍历目录中的每个文件
for file in crema_directory_list:
    # 将完整文件路径添加到列表中
    file_path.append(Crema + file)

    # 解析文件名获取情感信息(CREMA文件名格式:1001_DFA_ANG_XX.wav)
    part = file.split('_')  # 用下划线分割文件名

    # 根据第三部分(part[2])判断情感类型
    if part[2] == 'SAD':
        file_emotion.append('sad')      # 悲伤
    elif part[2] == 'ANG':
        file_emotion.append('angry')    # 愤怒
    elif part[2] == 'DIS':
        file_emotion.append('disgust')  # 厌恶
    elif part[2] == 'FEA':
        file_emotion.append('fear')     # 恐惧
    elif part[2] == 'HAP':
        file_emotion.append('happy')    # 快乐
    elif part[2] == 'NEU':
        file_emotion.append('neutral')  # 中性
    else:
        file_emotion.append('Unknown')  # 未知情感(异常处理)

# 创建情感标签的DataFrame
emotion_df = pd.DataFrame(file_emotion, columns=['Emotions'])

# 创建文件路径的DataFrame
path_df = pd.DataFrame(file_path, columns=['Path'])

# 横向合并两个DataFrame
Crema_df = pd.concat([emotion_df, path_df], axis=1)

# 显示前几行数据(默认5行)
Crema_df.head()

# 打印每种情感的数量统计
print(Crema_df.Emotions.value_counts())
TESS(多伦多情感语音数据集)核心构成:
-
数据内容:
-
包含200个目标词汇
-
所有词汇均嵌入固定引导句"Say the word "(请说出单词)中录制
-
由2名女演员(26岁和64岁)演绎
-
-
情感维度:
-
涵盖7种情感状态:
• 愤怒(anger)
• 厌恶(disgust)
• 恐惧(fear)
• 快乐(happiness)
• 惊喜(pleasant surprise)
• 悲伤(sadness)
• 中性(neutral)
-
总计2800个音频样本(200词汇 × 7情感 × 2演员)
-
-
文件结构:
-
按演员→情感两级目录存储
-
每个情感目录包含该演员所有200个词汇的WAV格式音频
-
文件命名示例:
OAF_anger_word.wav(老年演员愤怒情绪)YAF_happiness_word.wav(年轻演员快乐情绪)
-
-
技术规格:
-
音频格式:标准WAV文件
-
采样率:44.1kHz(CD音质)
-
单声道录制
-
该数据集特点:
✓ 纯净的实验室级录音环境
✓ 严格控制的发音韵律
✓ 老年/青年演员的跨年龄对比
✓ 特别包含"pleasant surprise"(惊喜)这一细分情感类别
典型应用场景:
-
情感语音识别系统训练
-
跨年龄语音特征分析
-
情感合成数据增强
-
心理学 vocal emotion 研究
获取TESS数据集主目录下的所有子目录列表(对应不同演员/情感)
# 获取TESS数据集主目录下的所有子目录列表(对应不同演员/情感)
tess_directory_list = os.listdir(Tess)

# 初始化存储情感标签和文件路径的空列表
file_emotion = []  # 存储从文件名解析的情感标签
file_path = []     # 存储文件的完整路径

# 遍历每个子目录(格式:ActorID_Emotion)
for dir in tess_directory_list:
    # 获取当前子目录下的所有音频文件
    directories = os.listdir(Tess + dir)

    for file in directories:
        # 解析文件名提取情感信息(TESS文件名格式:OAF_anger_word.wav)
        part = file.split('.')[0]  # 去除.wav扩展名
        part = part.split('_')[2]  # 提取第三部分情感标签

        # 特殊处理"pleasant surprise"简写为'ps'
        if part == 'ps':
            file_emotion.append('surprise')  # 将'ps'转换为完整标签
        else:
            file_emotion.append(part)  # 直接使用原始标签

        # 构建完整文件路径(格式:主目录/子目录/文件名)
        file_path.append(Tess + dir + '/' + file)

# 创建情感标签的DataFrame
emotion_df = pd.DataFrame(file_emotion, columns=['Emotions'])

# 创建文件路径的DataFrame
path_df = pd.DataFrame(file_path, columns=['Path'])

# 横向合并情感和路径DataFrame
Tess_df = pd.concat([emotion_df, path_df], axis=1)

# 显示前5行数据(检查数据结构)
Tess_df.head()

# 打印情感类别分布统计
print(Tess_df.Emotions.value_counts())
SAVEE数据库
背景
SAVEE数据库的录音来自4名以英语为母语的男性说话人(代号为DC、JE、JK、KL),均为萨里大学的硕士生或研究人员,年龄在27至31岁之间。情感在心理学上被划分为离散类别:愤怒(anger)、厌恶(disgust)、恐惧(fear)、快乐(happiness)、悲伤(sadness)和惊讶(surprise)。这一分类基于Ekman的跨文化研究[6],而自动情感识别研究也主要聚焦于这些类别[12]。我们额外增加了中性(neutral)类别,从而提供7种情感类别的录音。
文本材料包括每种情感的15句TIMIT标准语句:
- 3句共用语句(所有情感相同)
- 2句情感专属语句(针对特定情感)
- 10句通用语句(每种情感不同,且保持音素平衡)
此外,3句共用语句和2×6=12句情感专属语句(6种情感各2句)也以中性方式录制,共得到30句中性语句。
内容
每位说话人总计录制120条语句,例如:
- 共用句:She had your dark suit in greasy wash water all year.(她整年都用油腻的洗衣服水泡着你的黑西装。)
- 愤怒句:Who authorized the unlimited expense account?(谁批准了这笔无限额报销?)
- 厌恶句:Please take this dirty table cloth to the cleaners for me.(请把这块脏桌布拿去干洗店。)
- 恐惧句:Call an ambulance for medical assistance.(快叫救护车寻求医疗援助。)
- 快乐句:Those musicians harmonize marvelously.(这些音乐家的和声美妙绝伦。)
- 悲伤句:The prospect of cutting back spending is an unpleasant one for any governor.(削减开支的前景对任何州长都不愉快。)
- 惊讶句:The carpet cleaners shampooed our oriental rug.(地毯清洁工清洗了我们的东方地毯。)
- 中性句:The best way to learn is to solve extra problems.(最好的学习方法是多做习题。)
数据集特点
- 说话人:4名男性,年龄27-31岁,母语为英语
- 情感类别:7种(愤怒、厌恶、恐惧、快乐、悲伤、惊讶、中性)
- 语句构成:
- 每种情感15句(3共用 + 2专属 + 10通用)
- 额外30句中性语句(共用句 + 情感专属句的中性朗读)
- 总样本量:每位说话人120条,全库共480条(4人 × 120条)
- 文件命名示例:
DC_anger_common1.wav(说话人DC,愤怒情感,共用句第1句)JE_neutral_specific2.wav(说话人JE,中性情感,专属句第2句)
应用场景
- 情感语音识别(跨说话人泛化能力)
- 语音合成的情感控制(基于特定情感的训练)
- 心理学声学研究(情感对语音特征的影响)
- 语音增强与降噪(专业录音环境下的高质量数据)
该数据集适用于需要高精度情感语音分析的学术研究和工业应用。
下期继续--------

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 18
 0
- 0


 已为社区贡献10条内容

所有评论(0)