红外小目标检测论文(ACM)学习(OUC新芽第三周)
本周学习了红外小目标检测第一篇论文(WACV2020) Asymmetric Contextual Modulation for Infrared Small Target Detection。对论文中提出的ACM模块进行了学习。
下周计划:继续学习红外小目标检测的其它论文。
论文地址:
https://arxiv.org/pdf/2009.14530v1
代码地址:
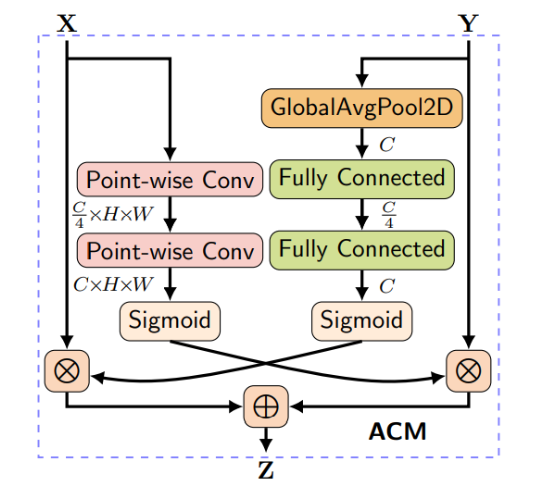
ACM模块处理流程如图所示:
-
自顶向下调制:此路径负责将深层特征的全局语义信息传递给浅层特征,实际上就是一个SENet。先对输入的深层特征图应用全局平均池化,将其压缩成一个特征向量,以此捕获全局上下文信息。然后通过一个bottleneck生成通道注意力权重,这个过程作者称为全局通道注意力调制(Global Channel Attention Modulation, GCAM)。然后将生成的通道注意力权重与输入的浅层特征图进行逐通道相乘,从而根据全局语义上下文来增强或抑制浅层特征中的不同通道,使其关注与目标相关的特征。
-
自下而上调制:此路径负责将浅层特征的精细细节信息补充到深层特征中,以防小目标在深层网络中消失。这也是作者对红外小目标特别的理解:与其它视觉任务相比,红外小目标因其本身特征容易被淹没在浩瀚的信息中,所以有必要保留和强化小目标本身微小的空间细节特征。对输入的浅层特征图直接应用两个1x1卷积,这个过程被称为逐点通道注意力调制(Pixel-wise Channel Attention Modulation, PCAM)。作者认为,对于红外小目标检测,全局池化会削弱其微弱的特征,而逐点的通道注意力能更好地保留这些关键的局部细节。然后将PCAM处理后的特征图与输入的深层特征图进行逐元素相加,从而将浅层的细节信息融入深层语义特征中,以高亮和保持小目标的特征。
-
特征融合:最后,将经过自顶向下调制后的浅层特征与经过自下而上调制后的深层特征进行逐元素相加,完成最终的特征融合,并将结果输出到网络的下一层。
作者在文中对红外小目标检测任务总结出了几个先验知识,目标极其微小且特征微弱,通常只占几个像素,并且由于低对比度和背景杂波,它们缺乏明显的形状或纹理。因此,网络设计的核心挑战和首要任务,是在网络的深层结构中有效保持并增强这些微弱特征,以防其被淹没或丢失。文中提出的自下而上调制就是解决这个问题的。此外虽然单目标情况占主导地位(约90%),但仍有相当一部分(约10%)图像包含多个目标,因此依赖“全局唯一”或“最显著”假设的方法会失效。还有与直觉相悖,目标不一定是最亮的区域。只有约35%的目标是图像中的最亮点。大多数(65%)目标的亮度与背景相似甚至更暗,这意味着基于“亮度显著性”的检测先验是不可靠的。个人认为这些知识是非常重要的,这将红外小目标检测任务与一般的语义分割任务区分开来,提供了专门的优化方向。
代码
找到ACM模块对应的代码进行了解读。
class AsymBiChaFuse(HybridBlock):
    def __init__(self, channels=64, r=4):
        super(AsymBiChaFuse, self).__init__()
        self.channels = channels
        self.bottleneck_channels = int(channels // r)

        with self.name_scope():

            self.topdown = nn.HybridSequential(prefix='topdown')  #topdown模块
            self.topdown.add(nn.GlobalAvgPool2D())
            self.topdown.add(nn.Conv2D(self.bottleneck_channels, kernel_size=1, strides=1,
                                          padding=0))
#1x1卷积实现全连接层,等价于linear,和下面的1x1卷积实现的全连接层形成bottleneck结构,论文中是把C变成C/4再变回C
            self.topdown.add(nn.BatchNorm())
            self.topdown.add(nn.Activation('relu'))
            self.topdown.add(nn.Conv2D(self.channels, kernel_size=1, strides=1,
                                         padding=0))
            self.topdown.add(nn.BatchNorm())
            self.topdown.add(nn.Activation('sigmoid'))

            self.bottomup = nn.HybridSequential(prefix='bottomup')  #bottomup模块
            self.bottomup.add(nn.Conv2D(self.bottleneck_channels, kernel_size=1, strides=1,
                                          padding=0))
#和topdown模块的bottleneck结构一样,只是这里没有经过一个GlobalAvgPool2D,作者认为

            self.bottomup.add(nn.BatchNorm())
            self.bottomup.add(nn.Activation('relu'))
            self.bottomup.add(nn.Conv2D(self.channels, kernel_size=1, strides=1,
                                         padding=0))
            self.bottomup.add(nn.BatchNorm())
            self.bottomup.add(nn.Activation('sigmoid'))


            self.post = nn.HybridSequential(prefix='post')  #后处理模块
            self.post.add(nn.Conv2D(channels, kernel_size=3, strides=1, padding=1, dilation=1))
 #经典s1k3p1卷积,特征图长宽不变
            self.post.add(nn.BatchNorm())
            self.post.add(nn.Activation('relu'))

    def hybrid_forward(self, F, xh, xl):
        topdown_wei = self.topdown(xh)
        bottomup_wei = self.bottomup(xl)
        xs = 2 * F.broadcast_mul(xl, topdown_wei) + 2 * F.broadcast_mul(xh, bottomup_wei)
        xs = self.post(xs)
return xs 
DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 36
 0
- 0


 已为社区贡献3条内容

所有评论(0)