「日拱一码」034 机器学习——插值处理
·
目录
机器学习中的插值处理方法可以分为以下几类:统计学方法、数学插值方法、基于模型的插值方法和高级插值方法。
统计学方法
均值填充
用特征列的均值替换缺失值, 适用于数值型数据,尤其是当数据分布较为均匀时
## 统计学方法
# 1. 均值填充
import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)

# 使用均值填充
imputer = SimpleImputer(strategy='mean')
df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)

print(df_imputed)
#      A          B
# 0  1.0   5.000000
# 1  2.0   7.666667
# 2  3.0   7.666667
# 3  4.0   8.000000
# 4  5.0  10.000000
中位数填充
用特征列的中位数替换缺失值,适用于数值型数据,尤其是当数据存在异常值时
# 2. 中位数填充

import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)
imputer = SimpleImputer(strategy='median')
df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)

print(df_imputed)
#      A     B
# 0  1.0   5.0
# 1  2.0   8.0
# 2  3.0   8.0
# 3  4.0   8.0
# 4  5.0  10.0
众数填充
用特征列的众数替换缺失值, 适用于分类数据或数值型数据
# 3. 众数填充

import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)
imputer = SimpleImputer(strategy='most_frequent')
df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)

print(df_imputed)
#      A     B
# 0  1.0   5.0
# 1  2.0   5.0
# 2  1.0   5.0
# 3  4.0   8.0
# 4  5.0  10.0
数学插值方法
线性插值
假设数据在缺失点之间呈线性关系,通过已知点计算缺失点的值。适用于数值型数据,且数据变化较为平缓
## 数学插值方法
#1. 线性插值

import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)
df_interpolated = df.interpolate(method='linear')

print(df_interpolated)
#      A     B
# 0  1.0   5.0
# 1  2.0   6.0
# 2  3.0   7.0
# 3  4.0   8.0
# 4  5.0  10.0
多项式插值
用多项式函数拟合已知数据点,计算缺失点的值。适用于数值型数据,且数据变化较为复杂
# 2. 多项式插值

import numpy as np
import pandas as pd

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)
df_interpolated = df.interpolate(method='polynomial', order=2)

print(df_interpolated)
#      A     B
# 0  1.0   5.0
# 1  2.0   5.5
# 2  3.0   6.5
# 3  4.0   8.0
# 4  5.0  10.0
样条插值
用分段多项式函数拟合数据,确保在连接点处光滑。适用于数值型数据,且需要高精度插值
# 3. 样条插值
from scipy.interpolate import interp1d
import matplotlib.pyplot as plt

x = np.arange(0, 10)
y = np.sin(x)
x_new = np.linspace(0, 9, 30)

# 创建样条插值函数
f = interp1d(x, y, kind='cubic')

# 计算插值结果
y_new = f(x_new)

plt.plot(x, y, 'o', label='original data')
plt.plot(x_new, y_new, '-', label='cubic spline')
plt.legend()
plt.show()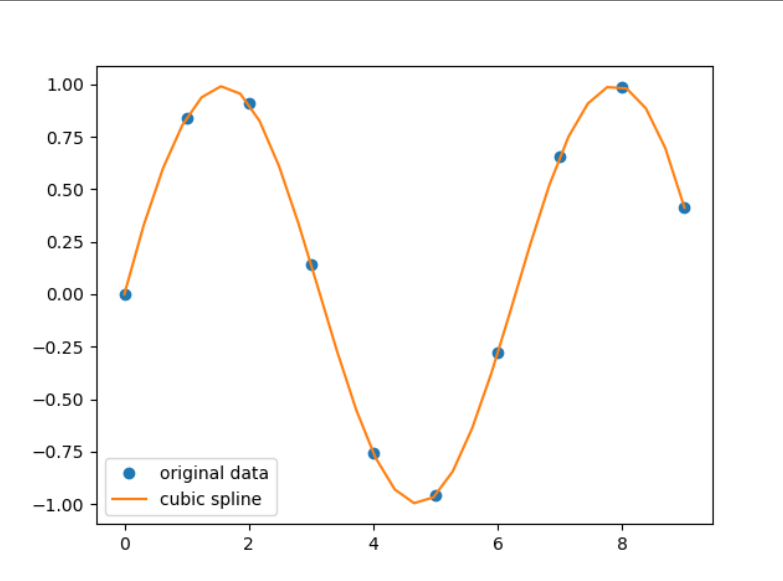
基于模型的插值方法
K-近邻填充
用缺失值的 K 个最近邻点的值进行加权平均或投票填充。适用于数值型数据或分类数据
## 基于模型的插值方法
# 1. K-近邻填充
from sklearn.impute import KNNImputer

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)
# 使用 KNN 填充
imputer = KNNImputer(n_neighbors=2)
df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)

print(df_imputed)
#      A          B
# 0  1.0   5.000000
# 1  2.0   6.500000
# 2  3.0   7.666667
# 3  4.0   8.000000
# 4  5.0  10.000000
随机森林填充
通过随机森林模型预测缺失值。适用于复杂数据,尤其是特征之间存在非线性关系
# 2. 随机森林填充
from sklearn.ensemble import RandomForestRegressor

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)

X = df.dropna().drop(columns=['B'])
y = df.dropna()['B']

# 训练随机森林模型
model = RandomForestRegressor()
model.fit(X, y)

# 预测缺失值
df.loc[df['B'].isna(), 'B'] = model.predict(df[df['B'].isna()].drop(columns=['B']))

print(df)
#      A      B
# 0  1.0   5.00
# 1  2.0   5.67
# 2  NaN   9.27
# 3  4.0   8.00
# 4  5.0  10.00
时间序列插值
利用时间序列的周期性和趋势性进行插值。适用于时间序列数据
## 高级插值方法
# 1. 时间序列插值

import pandas as pd

data = {'A': [1, 2, np.nan, 4, 5], 'B': [5, np.nan, np.nan, 8, 10]}
df = pd.DataFrame(data)
# 假设数据是时间序列
df['time'] = pd.date_range(start='2025-01-01', periods=len(df), freq='D')
df.set_index('time', inplace=True)

# 使用时间序列插值
df_interpolated = df.interpolate(method='time')

print(df_interpolated)
#               A     B
# time
# 2025-01-01  1.0   5.0
# 2025-01-02  2.0   6.0
# 2025-01-03  3.0   7.0
# 2025-01-04  4.0   8.0
# 2025-01-05  5.0  10.0
DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 16
 0
- 0


 已为社区贡献4条内容

所有评论(0)