【医疗神器】基于Hadoop的心脏病风险预测系统的设计与实现【多种机器学习对比、海量数据、大屏展示、在线交互预测】
有需要本项目的代码或文档以及全部资源,或者部署调试可以私信博主
项目介绍
基于Hadoop的心脏病风险预测系统设计与实现的主要研究内容分为以下几个内容。
本研究设计并实现了一个基于Hadoop平台的心脏病风险智能预测系统。研究数据采用美国CDC行为风险因素监测系统(BRFSS)发布的公开数据集,包含40万份健康调查记录,涉及生理指标、行为习惯和人口特征三大类数据特征。
在数据处理阶段,研究团队完成了以下关键工作:
- 数据预处理:包括异常值清洗、缺失值填补和特征标准化
- 分布式存储:基于HDFS构建数据仓库
- 自动化管道:采用Flume工具实现数据采集与传输
- 分析环境搭建:集成Hive数据仓库和MySQL关系型数据库
特征分析发现,心脏病风险与以下因素呈现显著相关性:
- 生理指标:BMI指数、行动能力
- 心理健康:近期心理状态评分
- 生活习惯:吸烟饮酒行为
针对预测模型开发,研究重点解决了以下技术难点:
- 类别不平衡问题:对比测试了SMOTE过采样、SMOTENC混合采样及欠采样三种方案
- 算法选型:评估了CatBoost和LightGBM两种梯度提升框架
- 性能优化:最终确定LightGBM+上采样组合方案,在召回率和分类准确率间取得平衡
系统架构采用前后端分离设计:
- 后端服务:基于Flask框架开发RESTful API
- 前端展示:采用Layui构建响应式界面
- 可视化模块:集成Pyecharts实现动态图表展示
系统主要功能模块包括:
- 用户权限管理
- 健康数据管理
- 风险预测引擎
- 多维分析看板
应用价值体现在:
- 临床辅助:提升高危人群筛查准确率
- 决策支持:为分级诊疗提供数据依据
- 预防医学:支持个性化健康干预方案制定

(1)数据收集:首先通过搜集关于心脏病风险预测的研究性开源数据集,数据包括人的基本信息,其他健康指标以及是否患有心脏病。数据集通过在kaggle或和鲸数据下载,数据共计31万左右,该数据集包含18个变量(9个布尔值,5个字符串和4个小数点),特征是关于受访者的个人生活习惯,基本信息,其他身体机能指标,目标特征为是否被确诊患有心脏病。
(2)数据预处理:将收集数据集进行数据预处理,其中包括重复值,缺失值,以及一些字段类型的转换,将数据格式以及编码转为结构化,且符合Hadoop大数据Hive分析的格式数据。
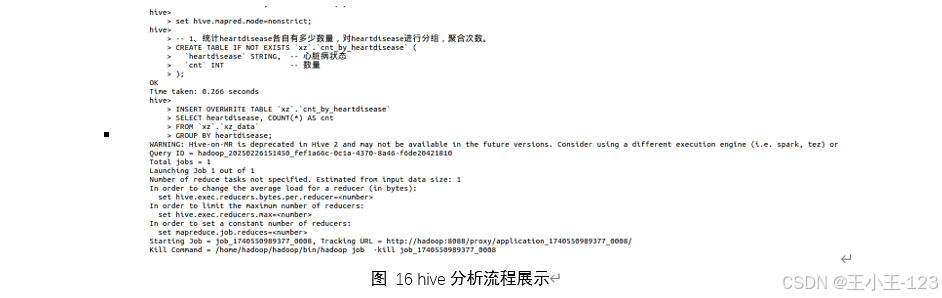
(3)Hadoop大数据分析:将预处理好的数据,上传到Hadoop虚拟机中,前期配置相关组件,包括hdfs、Hive、flume、sqoop、MySQL等组件。由于数据量很大,一般的传统软件在分析效率和性能无法达到,故通过Hadoop进行分析具有可行性和科学性。首先通过配置好flume文件,利用flume监听数据文件夹,将数据集移动到监听文件夹,实现数据的上传,以flume数据流的方式上传避免了一下子load到Hive中出现内存中断,数据无法上传完全的问题,且flume上传可以保证数据的持续性和稳健性。然后通过Hive进行大数据分析,从不同维度对本数据集进行EDA探索性数据分析,包括对受访者的个人基本情况、身体情况以及生活习惯对心脏病是否诊断进行描述性统计分析。最后将分析好的指标结果,通过sqoop命令导出到虚拟机的MySQL,方便我们管理和进行可视化。
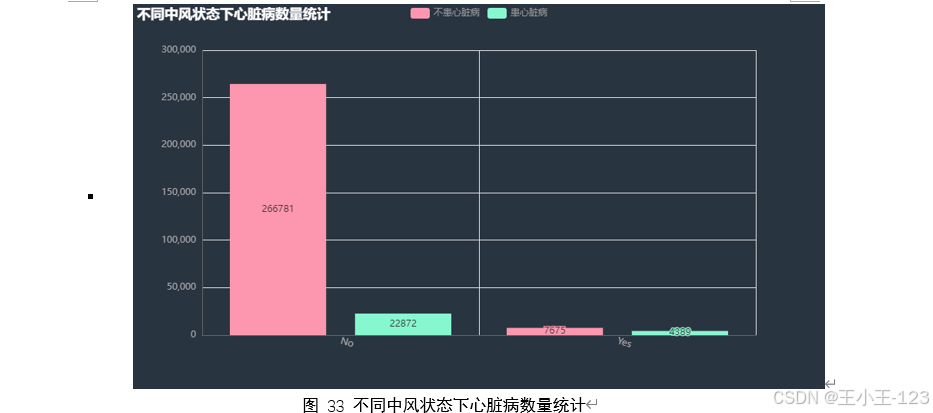
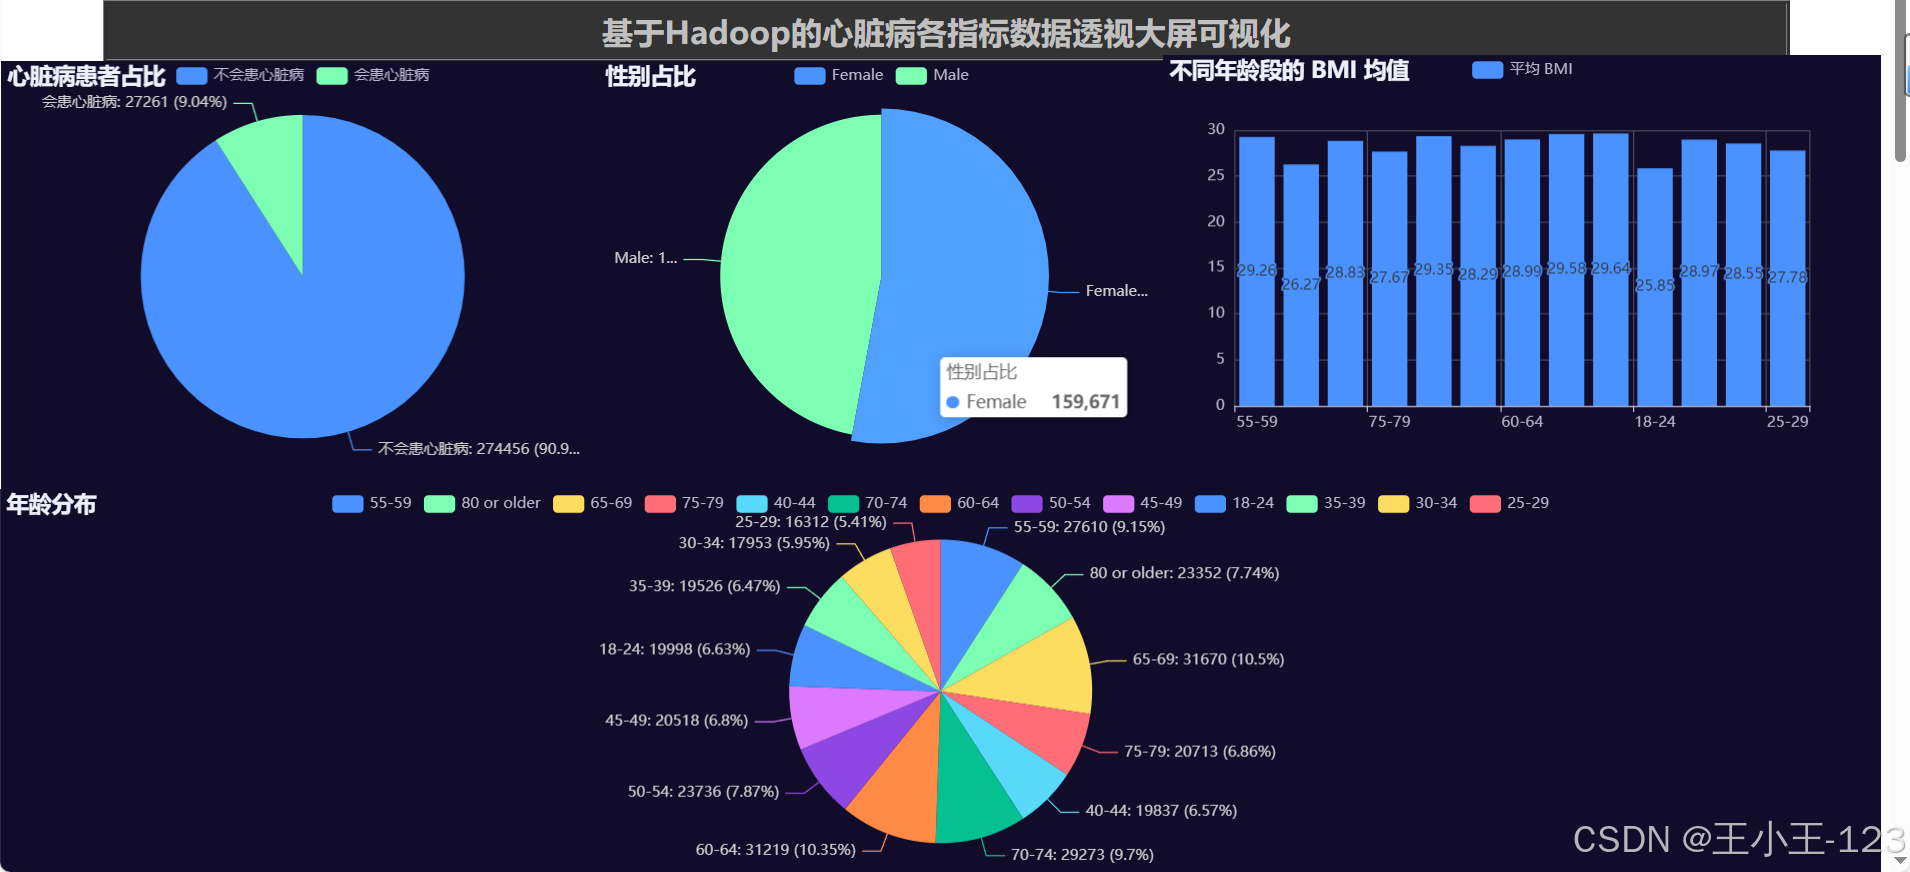
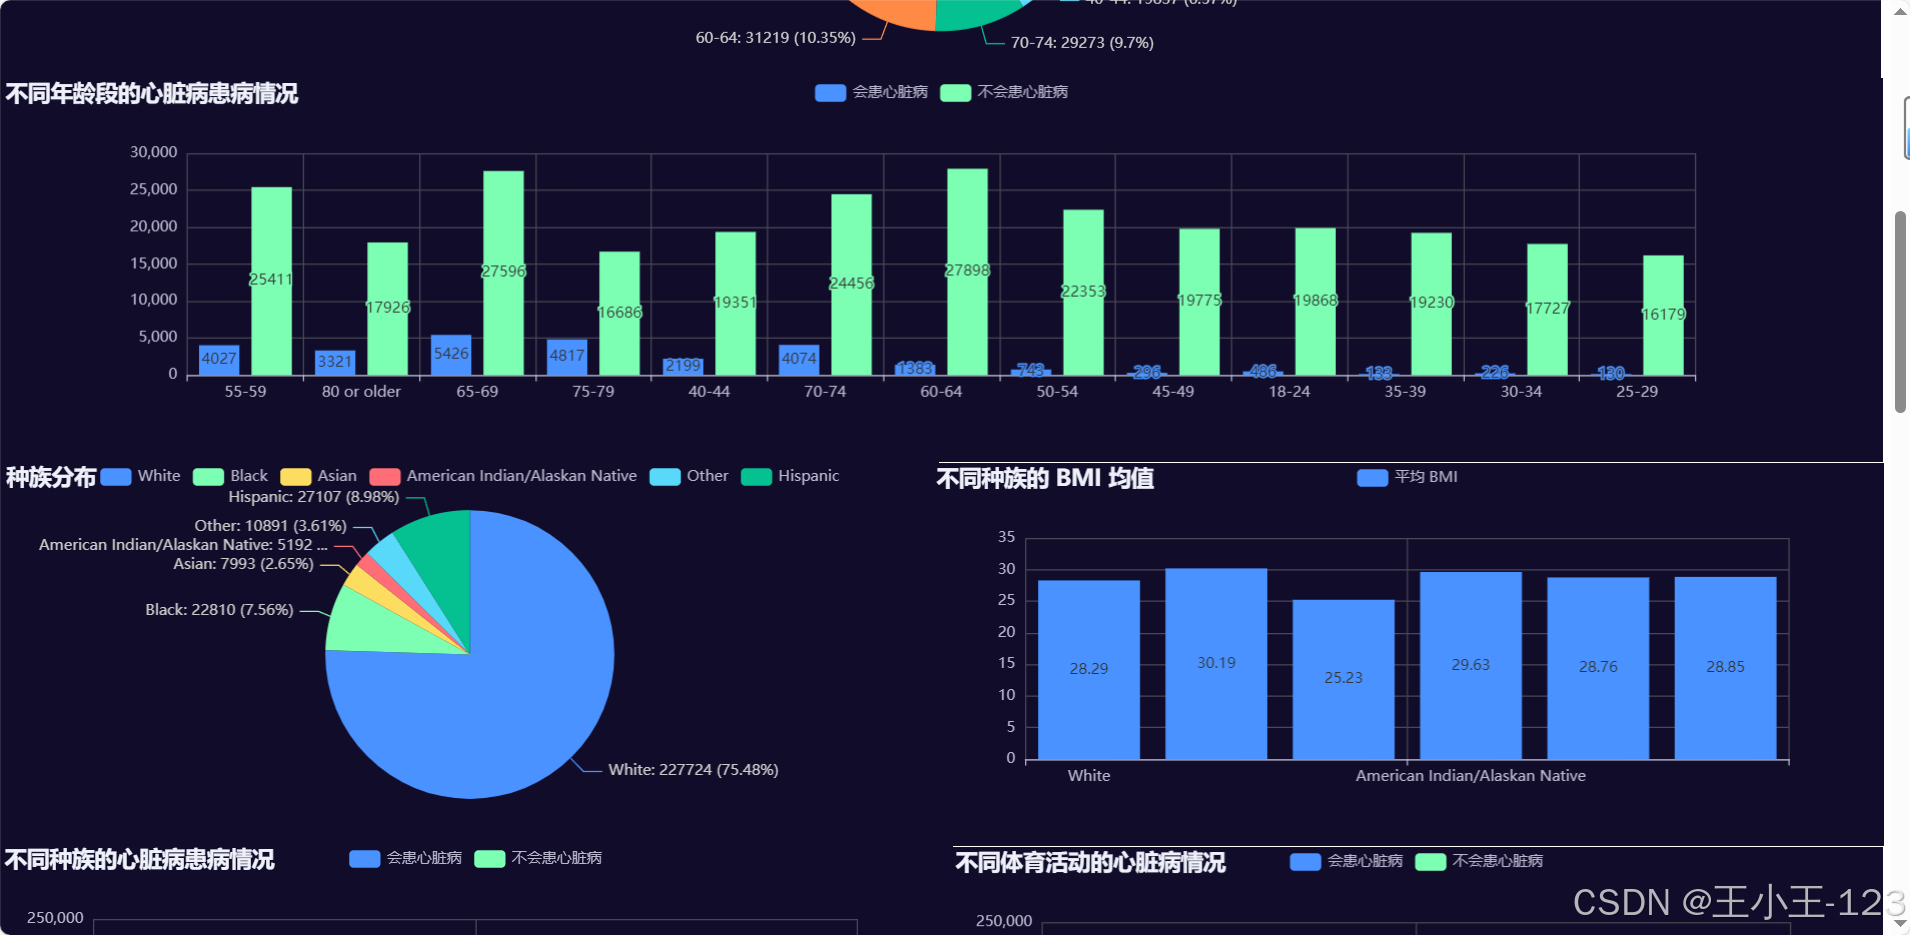
(4)数据可视化展示:将前期分析的指标存入到关系型数据库,最后通过本地的pyecharts进行可视化展示,通过这些分析好的数据指标,展示为折线图、柱状图、饼图等多维度图标。
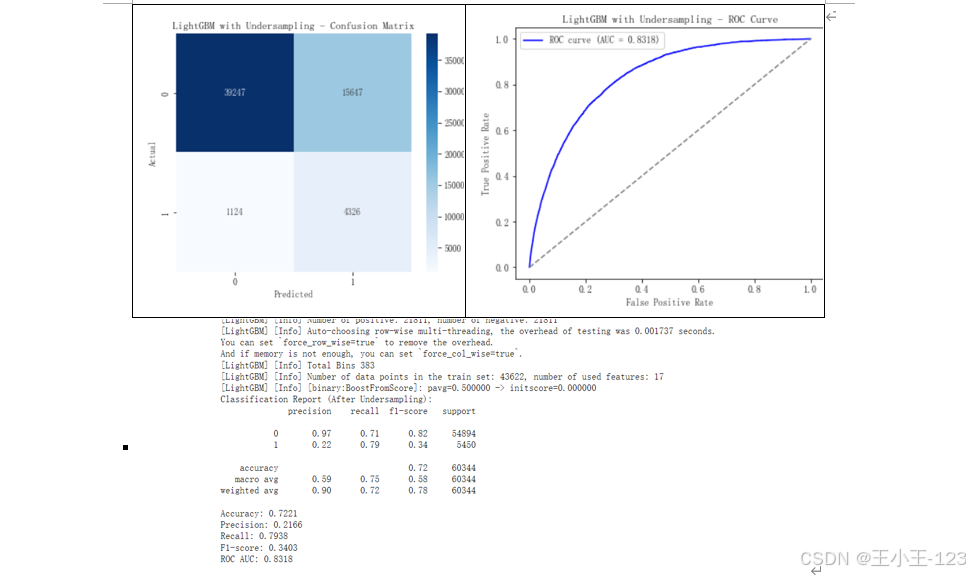
(5)心脏病风险预测:本研究数据集符合机器学习的研究范畴,通过机器学习算法模型,比如集成学习算法catboost进行对本数据集的建模,优化模型,最终实现心脏病的风险预测。具体研究首先,通过特征工程将数据转换为模型所需要的格式和类型,进行编码处理,通过机器学习下的算法,包括但不限于随机森林、XGBoost、catboost进行选取实验。由于本数据集的目标类不平衡,故进行数据优化处理,通过smote过采样、上采样、欠采样等技术进行数据平衡,以及模型的内部参数的优化,最终通过评估指标,混淆矩阵、召回率、准确度进行评估模型,进行下一步的在线应用。
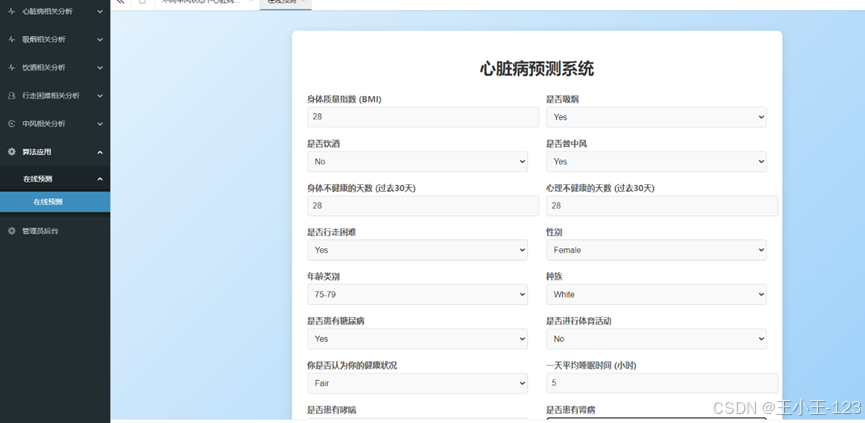
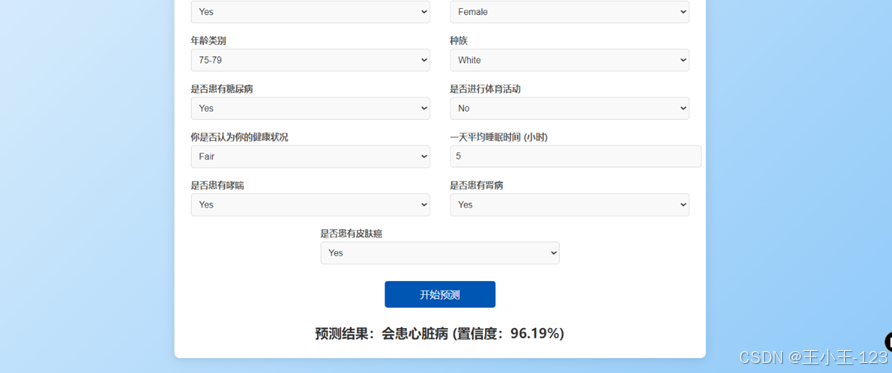
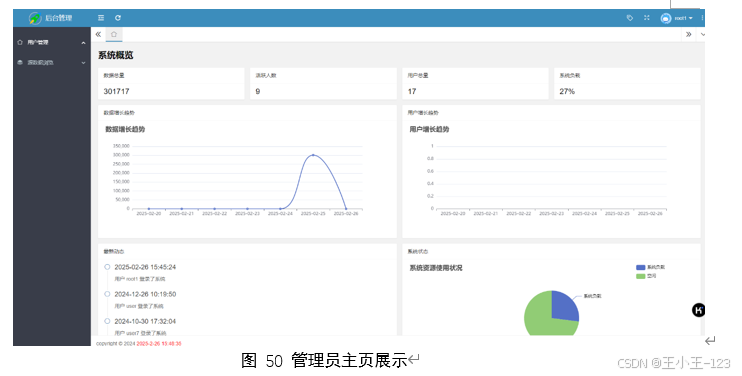
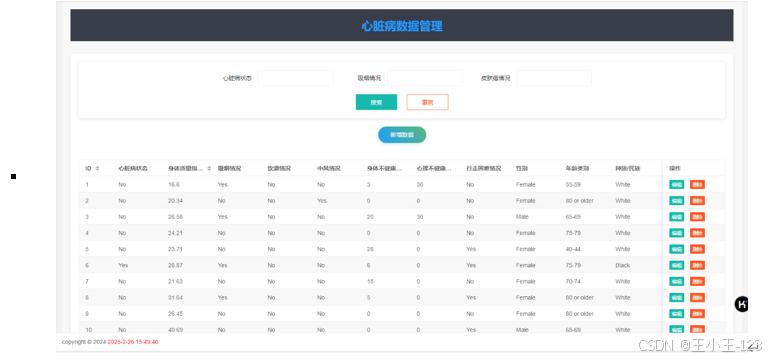
(6)可视化预测系统的实现:通过Flask系统框架,前端采用echarts、html、css、JavaScript进行渲染,后端调用分析好的指标可视化html,以及训练好的预测评估模型。系统支持用户登陆、注册、查看个人基本信息、修改个人信息、密码、主题切换、便签记录、导航标签的切换、全屏展示、超链接跳转、左侧集成了可视化展示的按钮,用户通过点击不同的标签进行展示可视化,其次模型挂载到前端进行在线应用。用户可以输入个人的基本信息,健康情况、以及生活习惯,点击提交风险预测,直接给出一个是否会患心脏病,以及风险概率值。管理员可以管理后台数据以及对用户的个人信息进行管理,对其进行增删改查操作。
项目背景
随着全球人口老龄化和生活方式的变化,心脏病已成为威胁人类健康的主要慢性疾病之一。根据世界卫生组织(WHO)的统计数据,心血管疾病是全球死亡的头号原因,每年导致数以百万计的死亡案例。早期检测和预防对于降低心脏病发病率及提高患者生活质量至关重要。然而,传统的心脏病诊断方法通常依赖于临床症状、医生经验,这可能导致误诊或延误治疗。近年来,大数据技术的发展为医疗领域带来了新的机遇。通过分析数据,可以识别出潜在的风险因素,并预测个体患心脏病的概率。因此本课题旨在结合现代信息技术与医学研究,构建一个高效、准确的心脏病风险评估工具。本课题的研究不仅有助于推动智慧医疗的发展,同时也为公共卫生活动提供了科学依据,具有重要的社会价值和广泛的应用前景。
选题意义
随着信息技术的飞速发展,大数据技术在医疗健康领域的应用研究日益深入。心脏病作为全球范围内导致死亡的主要原因之一,其早期诊断和预防至关重要。传统的心脏病风险评估方法往往依赖于有限的数据源和较为简单的统计模型,这限制了对复杂疾病机制的理解以及个性化预防策略的制定。为了克服这些局限性,本课题提出了预测心脏病患病风险的系统,通过统计心脏病发病因素,治疗率,增长率,死亡率,通过这些数据模型可以针对用户更加准确的给出健康建议,降低用户心脏病方面的发病率。
在当前医疗健康领域,尤其是面对心脏病这一全球性公共卫生挑战时,构建一个高效、准确的心脏病风险预测系统具有深远的现实意义。随着信息技术和大数据技术的发展,医药市场环境变得愈加复杂且充满竞争。企业需要更加敏锐地捕捉市场动态和客户需求,而心脏病风险预测系统的引入不仅能够为医疗服务提供者带来显著的好处,也为医药企业在激烈的市场竞争中提供了强有力的支持。对于医药企业而言,心脏病风险预测系统的应用意味着能够更加精准地把握市场需求变化趋势。
通过对销售数据的深入分析,企业可以了解哪些地区和客户群体对特定药品有较高的需求,哪些药品销售受到季节性影响等因素。基于这些信息,企业可以制定差异化的营销策略,优化库存管理和供应链运作,提高销售效率和盈利能力。此课题的研究成果不仅有助于提升心脏病防治工作的效率和质量,还为医药企业在市场竞争中提供了新的机遇。通过该系统的广泛应用,不仅可以改善患者的预后和生活质量,也能为整个社会节约大量的医疗成本,具有重要的现实意义。
关键问题
解决的关键问题主要集中在如何高效处理和分析大规模心脏病风险数据,并在此基础上进行准确的风险预测。通过引入Hadoop生态系统,解决了传统软件在处理大数据时的效率和性能瓶颈,使得数据收集、清洗、存储和分析能够在分布式环境下流畅运行。此外,通过数据预处理和特征工程,保证数据质量并适配机器学习模型的需求。
针对目标类别不平衡问题,采用SMOTE过采样技术提高了模型的预测效果。最终,通过集成学习算法优化模型性能,实现了心脏病风险的精准预测,并结合Flask和前端可视化技术,开发了一个易用的在线预测系统,帮助用户直观了解健康风险并做出决策。
技术路线
本研究的技术路线围绕心脏病风险预测系统的设计与实现展开,结合Hadoop大数据处理技术和机器学习模型,构建了一个高效的数据分析和风险预测平台。
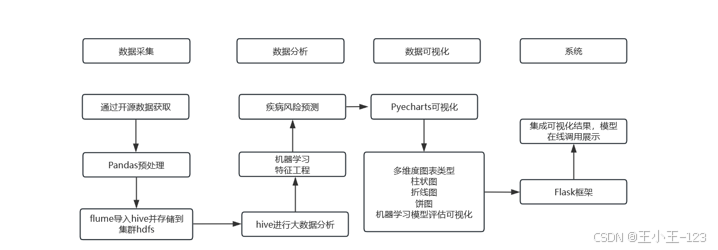
首先,通过Kaggle或和鲸等平台获取大规模开源心脏病风险预测数据集,数据集包含用户基本信息、健康指标及诊断结果。针对收集到的数据,进行清洗、去重、缺失值处理和数据类型转换,确保数据质量和一致性,使其符合Hadoop生态系统中Hive的存储和分析需求。
在数据处理阶段,将预处理后的数据上传至Hadoop集群,通过配置Flume监听文件夹,持续且稳定地将数据流式传输至HDFS,避免一次性加载引起的内存中断问题。接着,利用Hive进行大数据分析,对数据集进行多维度的探索性数据分析(EDA),挖掘影响心脏病风险的关键因素,并通过Sqoop将分析结果导出至MySQL数据库,为后续的数据可视化和模型训练提供支持。
在模型构建阶段,采用集成学习算法(如CatBoost、XGBoost和随机森林)对数据进行建模,并通过特征工程进行数据编码和转换。为解决数据不平衡问题,引入SMOTE过采样技术对数据进行平衡处理,并通过调整模型参数来优化性能。通过混淆矩阵、召回率和准确率等指标对模型进行评估,确保预测的准确性和稳定性。
综合三种模型的表现,常规模型在准确率上表现最佳,但召回率极低,导致心脏病患者的漏检率较高,难以满足实际应用需求。上采样模型通过生成新的少数类别样本,有效提高了召回率,但精确率有所下降,意味着误报率增加。欠采样模型通过减少多数类别样本数量提升了模型的识别能力,但由于数据量减少,准确率略低。
从AUC值来看,三种模型表现相近,均在0.83左右,说明在整体分类能力上差别不大。然而,考虑到心脏病预测中召回率的重要性,上采样模型在平衡召回率与精确率方面表现更优。上采样模型在召回率达到0.7868的同时,保持了相对较高的AUC值,适用于对误报容忍度较高、但对漏检敏感的应用场景。欠采样模型在保持较高召回率的同时,降低了计算资源消耗,适合资源受限但对模型精度要求较高的情况。
最后,基于Flask框架开发系统后端,前端采用Echarts、HTML、CSS和JavaScript实现数据可视化和交互功能。系统支持用户注册、登录、信息管理和主题切换,同时提供在线心脏病风险预测功能,用户输入个人信息和健康指标后,即可获得心脏病风险评估结果和概率值,实现了数据分析结果的实时应用和可视化展示。管理员可以管理用户信息,对用户进行权限升级为管理员和删除编辑其个人信息,同时对原始数据进行增删改查操作。
项目展示
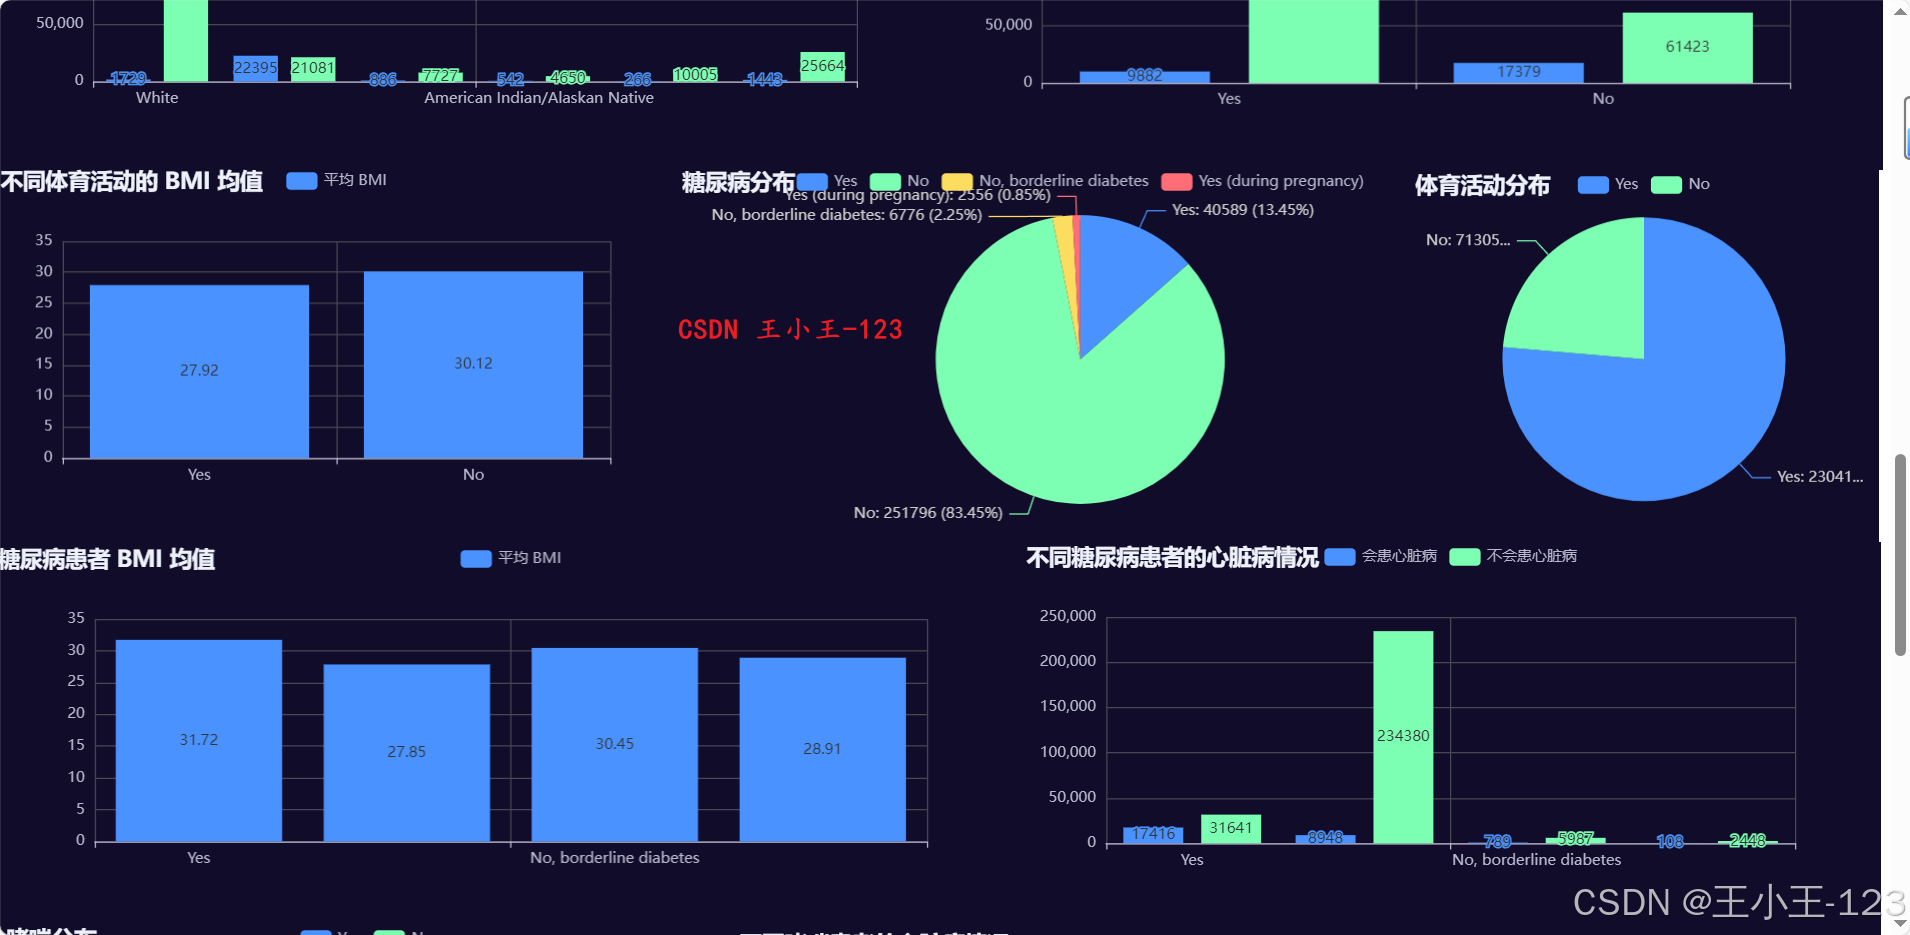
数据展示
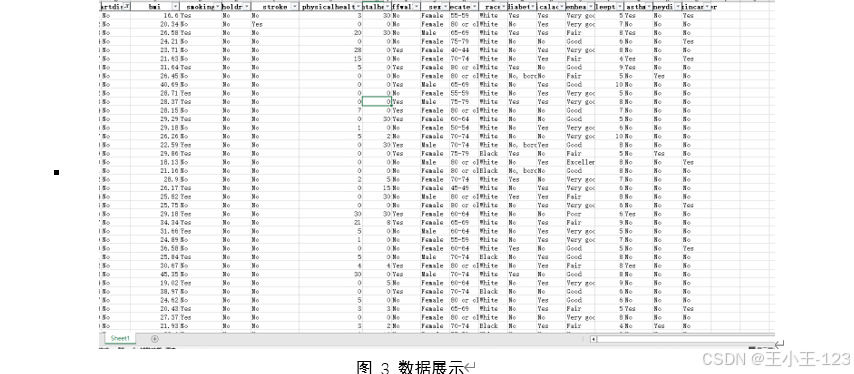
本研究采用的数据集来自Kaggle平台,原始数据由美国疾病控制与预防中心(CDC)的行为风险因素监测系统(BRFSS)提供。作为全球规模最大的持续性健康调查项目之一,BRFSS自1984年启动以来,调查范围已从最初的15个州扩展至全美50个州及多个海外领地。该系统通过电话访谈持续收集居民健康行为、慢性病状况及人口统计学数据,为公共卫生决策提供依据。
本研究分析的样本量达40万条,包含18个特征变量,涵盖以下三类数据类型:
- 布尔型(如心脏病、吸烟史等诊断指标)
- 字符串型(如性别、年龄分段等分类变量)
- 数值型(如BMI指数、睡眠时长等连续变量)
核心预测目标为HeartDisease(冠心病/心肌梗死患病状态),需注意该变量存在明显的类别不平衡问题,建模时需采用上采样、欠采样或SMOTE等算法进行处理。
关键变量说明:
- 健康指标:BMI、身体/心理健康不佳天数、步行障碍等
- 生活习惯:吸烟、饮酒、运动频率等
- 疾病史:中风、糖尿病、哮喘、肾病等
- 人口特征:年龄分段、种族、性别等
- 主观评价:自我健康评估等级
数据集核心特征:
- 样本代表性:大容量样本(40万)覆盖多元人口特征
- 特征多样性:包含生理/心理健康、生活方式等多维指标
- 建模挑战:目标变量存在1.5:98.5的类别不平衡比例
- 应用价值:丰富的心脏病风险预测特征体系,包括:
- 客观临床指标(BMI、慢性病史)
- 行为因素(运动、吸烟饮酒习惯)
- 主观健康感知
项目总结
本项目是一个非常不错的项目!优选的,有需要可以私信博主!
每文一语
优质的项目总是受人欢迎

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 41
 0
- 0


 已为社区贡献72条内容

所有评论(0)