实战Kaggle比赛:预测房价——动手学深度学习4.10
环境:PyCharm + python3.8
1. 下载和缓存数据集
import hashlib
import os
import tarfile
import zipfile
import requests下载和缓存数据集的实用类最新版:机器学习 解决相关 (自用笔记)_torch清华镜像下载命令-CSDN博客
- 首先,建立字典
DATA_HUB,它可以将数据集名称的字符串映射到数据集相关的二元组上, - 这个二元组包含数据集的url和验证文件完整性的sha-1密钥。
- 所有类似的数据集都托管在地址为
DATA_URL的站点上。
# 实用类:下载和缓存数据集
class C_Downloader:
    def __init__(self, data_url = 'http://d2l-data.s3-accelerate.amazonaws.com/'):
        # DATA_HUB字典,将数据集名称的字符串映射到数据集相关的二元组上
        # DATA_HUB为二元组:包含数据集的url和验证文件完整性的sha-1密钥
        self.DATA_HUB = dict()
        self.DATA_URL = data_url # 数据集托管在地址为DATA_URL的站点上

    ''' download
    下载数据集,将数据集缓存在本地目录(默认为../data)中,并返回下载文件的名称
    若缓存目录中已存在此数据集文件,且其sha-1与存储在DATA_HUB中的相匹配,则使用缓存的文件,以避免重复的下载
    name:要下载的文件名,必须在DATA_HUB中存在
    cache_dir:缓存目录,默认为../data
    sha-1:安全散列算法1
    '''
    def download(self, name, cache_dir=os.path.join('..', 'data')):  # @save
        """下载一个DATA_HUB中的文件,返回本地文件名"""
        # 检查指定的文件名是否存在于DATA_HUB中
        # 如果不存在,则抛出断言错误,提示用户该文件不存在
        # 断言检查:确保name在DATA_HUB中存在,避免下载不存在的文件
        assert name in self.DATA_HUB, f"{name} 不存在于 {self.DATA_HUB}"
        url, sha1_hash = self.DATA_HUB[name] # 从DATA_HUB中获取该文件的URL和SHA-1哈希值

        # 若目录不存在,则创建目录
        # exist_ok=True:若目录已存在,也不会抛出错误
        os.makedirs(cache_dir, exist_ok=True)

        # 构建本地文件路径
        # 从URL中提取文件名(通过分割URL字符串获取最后一个部分)
        # 并将该文件名与缓存目录组合成完整的本地文件路径
        fname = os.path.join(cache_dir, url.split('/')[-1])

        if os.path.exists(fname): # 检查本地文件是否已存在
            sha1 = hashlib.sha1() # 计算本地文件的SHA-1哈希值(shal.sha1():创建一个字符串hashlib_,并将其加密后传入)
            with open(fname, 'rb') as f:
                # 读取文件内容,每次读取1MB的数据块,以避免大文件占用过多内存
                while True:
                    data = f.read(1048576) # 1048576 bytes = 1MB
                    if not data:
                        break
                    sha1.update(data) # 更新哈希值

            # 比较计算出的哈希值与DATA_HUB中存储的哈希值
            if sha1.hexdigest() == sha1_hash:
                # 若哈希值匹配,说明文件完整且未被篡改,直接返回本地文件路径(命中缓存)
                return fname  # 命中缓存

        # 如果本地文件不存在或哈希值不匹配,则从URL下载文件
        print(f'正在从{url}下载{fname}...')

        # 使用requests库发起HTTP GET请求,stream=True表示以流的方式下载大文件
        # verify=True表示验证SSL证书(确保下载的安全性)
        r = requests.get(url, stream=True, verify=True)

        # 将下载的内容写入到本地文件中
        with open(fname, 'wb') as f:
            f.write(r.content) # 将请求的内容写入文件
        return fname# 返回本地文件路径

    '''
    下载并解压一个zip或tar文件
    name:要下载并解压的文件名,必须在DATA_HUB中存在
    folder:解压后的目标文件夹名(可选)
    '''
    def download_extract(self, name, folder=None):  # @save
        """下载并解压zip/tar文件"""
        fname = self.download(name) # 调用download函数下载指定的文件,获取本地文件路径
        base_dir = os.path.dirname(fname) # 获取缓存目录路径(即下载文件所在的目录)
        data_dir, ext = os.path.splitext(fname) # 分离文件名和扩展名

        if ext == '.zip':               # 如果是zip文件,使用zipfile.ZipFile 打开文件
            fp = zipfile.ZipFile(fname, 'r')
        elif ext in ('.tar', '.gz'):    # 如果是tar或gz文件,使用tarfile.open 打开文件
            fp = tarfile.open(fname, 'r')
        else:                           # 如果文件扩展名不是zip、tar或gz,抛出断言错误
            assert False, '只有zip/tar文件可以被解压缩'

        fp.extractall(base_dir) # 将文件解压到缓存目录中
        # 返回解压后的路径
        # 如果指定了folder参数,返回解压后的目标文件夹路径
        # 否则返回解压后的文件路径(即去掉扩展名的文件名)
        return os.path.join(base_dir, folder) if folder else data_dir

    # 将使用的所有数据集从DATA_HUB下载到缓存目录中
    def download_all(self):  # @save
        """下载DATA_HUB中的所有文件"""
        for name in self.DATA_HUB:
            self.download(name)
2. Kaggle
Kaggle是一个当今流行举办机器学习比赛的平台。如果我们想参加Kaggle比赛,首先需要注册一个账户:
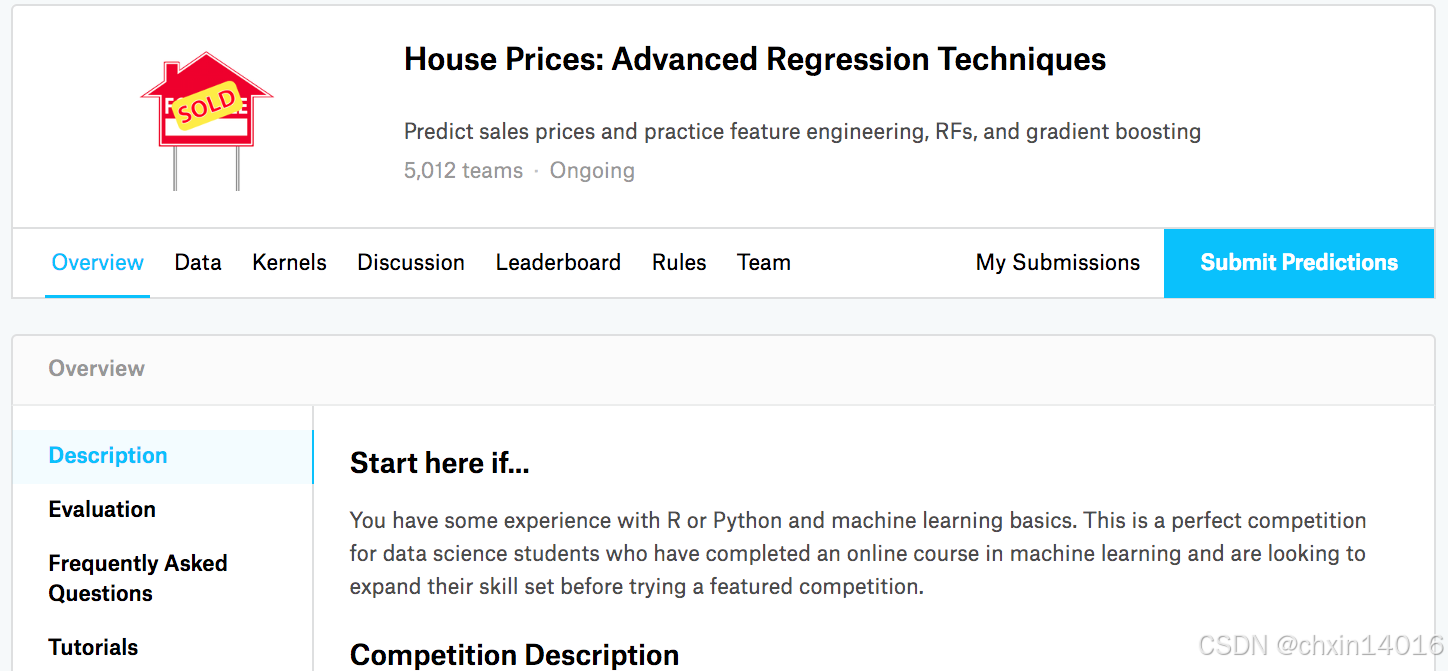
这里是房价预测比赛页面 (在页面的的“Data”选项卡下可以找到数据集):https://www.kaggle.com/c/house-prices-advanced-regression-techniques。
可以通过该网址提交预测,并查看排名。
3. 访问和读取数据集
竞赛数据分为训练集和测试集。每条记录都包括房屋的属性值和属性(特征)。
- 特征由各种数据类型组成 (可能是整数,离散类别,浮点数等)。
- 同时也存在一些数据完全丢失 (缺失值被简单地标记为“NA”)。
- 每套房子的价格只出现在训练集中 (我们可以划分训练集以创建验证集)。
- 在将预测结果上传到Kaggle之后,则只能在官方测试集中评估模型。
import os
import numpy as np
import pandas as pd
import torch
from torch import nn
import common
from common import C_Downloader
1)下载并缓存数据集
使用上面定义的脚本下载并缓存Kaggle房屋数据集
downloader = C_Downloader()
DATA_HUB = downloader.DATA_HUB
DATA_URL = downloader.DATA_URL

# 下载并缓存Kaggle房屋数据集
DATA_HUB['kaggle_house_train'] = (  #@save
    DATA_URL + 'kaggle_house_pred_train.csv',
    '585e9cc93e70b39160e7921475f9bcd7d31219ce')

DATA_HUB['kaggle_house_test'] = (  #@save
    DATA_URL + 'kaggle_house_pred_test.csv',
    'fa19780a7b011d9b009e8bff8e99922a8ee2eb90')
2)加载数据集的CSV文件
使用pandas分别加载包含训练数据和测试数据的两个CSV文件
# 调用download函数下载文件
cache_dir=os.path.join('.', 'data', 'kaggle_house') # 缓存路径为 .\data\kaggle_house
trainData_path = downloader.download('kaggle_house_train', cache_dir)
testData_path = downloader.download('kaggle_house_test', cache_dir)
print(f'【训练集】文件已下载到:{trainData_path}')
print(f'【测试集】文件已下载到:{testData_path}')

# 使用pandas分别加载包含训练数据和测试数据的两个CSV文件
train_data = pd.read_csv(trainData_path)
test_data = pd.read_csv(testData_path)
# train_data = pd.read_csv(downloader.download('kaggle_house_train'))
# test_data = pd.read_csv(downloader.download('kaggle_house_test'))
3)可视化数据集信息
- 训练数据集包括1460个样本,每个样本80个特征和1个标签
- 测试数据集包含1459个样本,每个样本80个特征
print(f"【训练集】:{train_data.shape} 包括1460个样本,每个样本80个特征和1个标")
print(f"【测试集】:{test_data.shape} 包含1459个样本,每个样本80个特征")
# 选择训练集的前4行样本数据,以及第[0, 1, 2, 3, -3, -2, -1]列的特征打印显示
print(f"查看前四个和最后两个特征,以及相应标签(房价)\n{train_data.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]]}")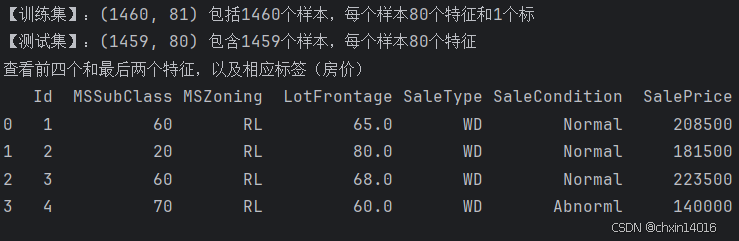
4)删除无用特征
每个样本中,第一个特征是ID,这有助于模型识别每个训练样本。但它不携带任何用于预测的信息。 因此,在将数据提供给模型之前,需先将其从数据集中删除。
- 对于每个样本:删除第一个特征ID,因为其不携带任何用于预测的信息
- 同时,将训练集中(最后一列)的标签删除
# 对于每个样本:删除第一个特征ID,因为其不携带任何用于预测的信息
# .iloc 是 Pandas 提供的基于整数位置的索引器,用于按位置选择行和列
# train_data.iloc[:, 1:-1],选择训练集的所有行,以及从第 2 列到倒数第 2 列的数据
# test_data.iloc[:, 1:],选择了测试集的所有行,以及从第 2 列到最后一列的数据
# pd.concat:Pandas 提供的函数,用于沿指定轴(默认是 axis=0,即行方向)合并多个 DataFrame 或 Series
# 将删除ID(训练集还删除了标签)后的两个数据集合并在一起
all_features = pd.concat((train_data.iloc[:, 1:-1], test_data.iloc[:, 1:]))
print(f"删除无用标签后,前四个和最后两个特征,以及相应标签\n{all_features.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]]}")
4. 数据预处理
在开始建模之前,需要对数据进行预处理。
- 缺失值替换:将所有缺失的值替换为相应特征的平均值。
- 标准化数据:通过将特征重新缩放到零均值和单位方差来标准化数据 (为了将所有数据放在共同的尺度上)。标准化数据原因有两个,如下:
- 方便优化;
- 因为不知道哪些特征是相关的,所以不想让惩罚分配给一个特征的系数比分配给其他任何特征的系数更大。
- 处理离散值,用独热编码来替换离散值。(如"MSZoning_RL"为1,"MSZoning_RM"为0)
通过将特征重新缩放到零均值和单位方差来标准化数据:

1)对数据进行标准化处理
# 若无法获得测试数据,则可根据训练数据计算均值和标准差:x←(x-μ)/σ
# 获取无法获得测试数据的数量

# 选择all_features 中所有数值类型的列(排除非数值列,如字符串或对象类型)
# all_features.dtypes:获取 all_features 中每一列的数据类型
# all_features.dtypes != 'object':筛选出非对象类型(即数值类型)的列
# .index:获取这些数值列的列名
# numeric_features中的内容是:数字类型列的名字
numeric_features = all_features.dtypes[all_features.dtypes != 'object'].index    # 选择数值特征
print(f"数值列下标:\n{numeric_features}")

# 对数值特征进行 Z-score 标准化(均值为 0,标准差为 1)
# apply(lambda x: ...):对每一列应用标准化公式
# (x - x.mean()) / (x.std()):标准化公式[(原值-均值)/标准差],其中:
# x.mean() 是列的均值
# x.std() 是列的标准差
# 标准化后,数据的均值为 0,标准差为 1
all_features[numeric_features] = all_features[numeric_features].apply(          # 标准化数值特征
    lambda x: (x - x.mean()) / (x.std()))
print(f"数据标准化后:\n{all_features.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]]}")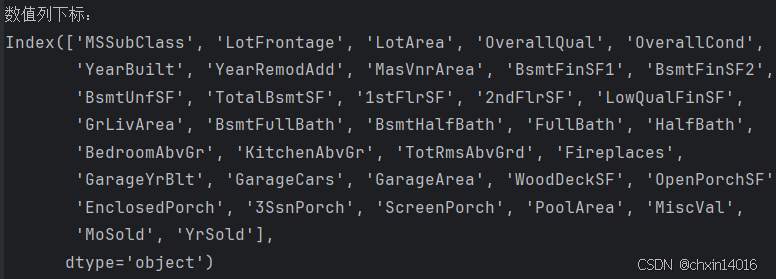

2)将缺失值进行替换
# 在标准化数据之后,所有均值消失,因此我们可以将缺失值设置为0(将标准化后的数值特征中的缺失值填充为 0)
# fillna(0):将缺失值(NaN)替换为 0
# 标准化后均值为 0,因此填充 0 是合理的(不会引入偏差)
all_features[numeric_features] = all_features[numeric_features].fillna(0)       # 处理缺失值
print(f"处理缺失值后:\n{all_features.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]]}")
3)独热编码分类特征
# 将分类特征(包括缺失值)转换为独热编码形式
# “Dummy_na=True”将“na”(缺失值)视为有效的特征值,并为其创建指示符特征
# all_features是删除ID那一列之后,将每个样本中所有的特征连接起来
# pd.get_dummies():Pandas 提供的函数,用于将分类变量转换为虚拟变量(独热编码)
# dummy_na=True:将缺失值(NaN)视为一个有效的类别,并为其创建一个额外的列(如 columnname_nan)
# 例如:某列有(A、B、缺失值)三种分类值 ,独热编码后会生成三列:columnname_A、columnname_B 和 columnname_nan
all_features = pd.get_dummies(all_features, dummy_na=True)                      # 独热编码分类特征
print(f"独热编码分类特征后:{all_features.shape}\n{all_features.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]]}")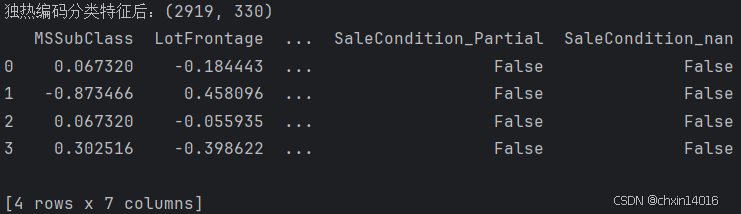
独热编码替换后,会将特征的总数量从79个增加到331个。
4)转换为张量表示
确保数据类型正确:
print(f"------- 显示all_features前几行(默认前5行):\n{all_features.head()}\n*******")
print(f"------- 显示all_features的简要摘要,包括每列的非空值数量和数据类型:\n{all_features.info()}\n*******\n"
      f"------- 显示all_features中每列的数据类型: \n{all_features.dtypes}\n*******")

# 查找混合类型列
for col in all_features.columns:
    if all_features[col].dtype == 'object':
        print(f"Column {col} contains object type data.")
        # 进一步处理这些列(如标签编码、填充缺失值等)
    elif all_features[col].apply(lambda x: isinstance(x, str)).any():
        print(f"Column {col} contains string values.")
        # 进一步处理这些列
(循环中的打印没有命中)


通过values属性,我们可以 从pandas格式中提取NumPy格式,并将其转换为张量表示用于训练
# 通过values属性将数据从pandas格式提取numpy格式,并将其转为张量用于训练
n_train = train_data.shape[0] # 获取训练集的行数,即训练集的样本总数
all_features = all_features.astype('float32') # 强制转换所有列为 float32
train_features = torch.tensor(all_features[:n_train].values, dtype=torch.float32)
test_features = torch.tensor(all_features[n_train:].values, dtype=torch.float32)

# 获取训练集的价格标签,将其转换为张量
# .reshape(-1, 1):-1表示自动计算该维度的大小(这里是样本数 n_train),1表示只有一列(加个标签)
train_labels = torch.tensor(
    train_data.SalePrice.values.reshape(-1, 1), dtype=torch.float32)
5. 训练
1)定义损失函数和模型
这里训练一个带有损失平方的线性模型。
- 线性模型很难在竞赛中获胜,
- 但线性模型有健全性检查,能查看 数据中是否存在有意义的信息。
- 若线性模型不能做得比随机猜测更好,则很可能存在数据处理错误。
- 若线性模型(如线性回归、逻辑回归)的表现显著优于随机猜测(例如,均方误差远低于随机预测的方差,或分类准确率远高于 50%),说明数据中确实存在可学习的模式。
- 若一切顺利,线性模型将作为基线(baseline)模型,让我们直观地知道最好的模型有超出简单的模型多少。
基线模型:
- 目的:提供一个简单的参考点,用于评估更复杂模型的性能。
- 方法:
- 先训练一个线性模型,记录其性能指标(如均方误差、R² 分数、准确率等)。
- 然后尝试更复杂的模型(如随机森林、梯度提升树、神经网络等),并比较它们的性能是否显著优于线性模型。
- 若复杂模型的性能提升很小 (例如,仅比线性模型好 1%-2%),可能说明:
- 数据本身更适合线性关系,复杂模型可能引入了不必要的复杂性。
- 复杂模型可能过拟合或需要进一步调参。
- 如果复杂模型的性能显著提升 (例如,比线性模型好 10% 以上),说明线性模型确实捕捉到了部分信息,但复杂模型能捕捉到更多非线性关系。
实际应用中的建议:
- 始终从线性模型开始:
- 快速验证数据是否可学习。
- 提供一个简单的基线性能。
- 逐步尝试复杂模型:
- 如果线性模型表现不佳,尝试树模型(如随机森林、XGBoost)。
- 如果数据量很大且关系复杂,尝试神经网络。
- 比较性能提升:
- 复杂模型的性能提升应显著(如 5% 以上),否则可能不值得引入复杂性。
"""
训练一个带有损失平方的线性模型:
1、损失函数为损失平方
2、线性模型作为基线模型
"""
loss = nn.MSELoss() # 使用均方误差损失函数(适用于回归任务)
in_features = train_features.shape[1] # 输入特征的维度,即为特征总数

def get_net(): # 仅返回一个简单的线性模型,将输入映射到1给输出值
    net = nn.Sequential(nn.Linear(in_features,1))
    return net
2)采用价格预测的对数来衡量差异
- 房价就像股票价格一样,关心的是相对数量,而不是绝对数量。
- 因此,更关心的是相对误差
,而不是绝对误差
。
- 所以这里用价格预测的对数来衡量差异。
- (其实比赛中官方也是用价格预测的对数来评价提交质量的误差指标)。
- 即,将
for
转换为
。
- 这使得预测价格的对数与真实标签价格的对数之间出现以下均方根误差:

# 采用价格预测的对数来衡量差异:√ ̄(1/n*(∑(logy - logy')^2))
def log_rmse(net, features, labels): # 计算对数均方根误差(Log-RMSE)
    # 为了在取对数时进一步稳定该值,将小于1的值设置为1
    # torch.clamp:将预测值裁剪到 [1, +∞) 范围内,避免对 0 或负数取对数(数学上无定义)
    clipped_preds = torch.clamp(net(features), 1, float('inf')) # 对数裁剪和变换
    # torch.log:对裁剪后的预测值和真实标签取自然对数
    # torch.sqrt:对 MSE 取平方根,得到 RMSE
    rmse = torch.sqrt(loss(torch.log(clipped_preds),
                          torch.log(labels)))
    return rmse.item() # 将张量转换为 Python 标量值(浮点数)
3)进行训练,优化器借助Adam优化器
与之前的不同,这里的训练函数将借助Adam优化器。Adam优化器的主要优势在于它对初始学习率不那么敏感。
# 优化器借助Adam优化器
"""
定义训练函数:
1、加载训练数据集
2、使用Adam优化器(对初始学习率不那么敏感)
3、进行训练:计算损失,进行梯度优化,返回训练损失和测试损失
"""
def train(net,
          train_features, train_labels,
          test_features, test_labels,
          num_epochs, learning_rate, weight_decay, batch_size):
    train_ls, test_ls = [], []
    # TensorDataset:将 train_features 和 train_labels 包装为 PyTorch 的数据集
    # DataLoader:按 batch_size 分批加载数据,并打乱顺序(shuffle=True)
    train_iter = DataLoader(
        TensorDataset(train_features, train_labels),
        batch_size, shuffle=True)
    # 这里使用的是Adam优化算法(自适应矩估计)
    optimizer = torch.optim.Adam(net.parameters(),
                                 lr=learning_rate,
                                 weight_decay=weight_decay) # 权重衰减(L2 正则化系数)
    for epoch in range(num_epochs):
        for X, y in train_iter:
            optimizer.zero_grad()   # 梯度归零(清除梯度)
            l = loss(net(X), y)     # 计算损失
            l.backward()            # 更新梯度(反向传播计算梯度)
            optimizer.step()        # 更新参数

        # 将训练损失加到训练损失列表中
        train_ls.append(log_rmse(net, train_features, train_labels))

        # 如果测试标签不为空,将测试损失加到测试损失列表中
        if test_labels is not None:
            test_ls.append(log_rmse(net, test_features, test_labels))
    return train_ls, test_ls # 返回训练集和测试集的损失列表
6. K折交叉验证
1)定义K折交叉验证
K折交叉验证 的复习内容跳转:多层感知机实现—— 动手学深度学习4.2~4.9-CSDN博客
(模型选择部分的 2.2. K折交叉验证)

K折交叉验证有助于模型选择和超参数调整。
首先需要定义一个函数,在K折交叉验证过程中返回第i折的数据。 具体地说,它选择第i个切片作为验证数据,其余部分作为训练数据。
- 注意:这并不是处理数据的最有效方法,如果数据集大得多,会有其他解决办法。
"""
定义K折交叉验证:
1、当k > 1时,进行K折交叉验证,将数据集分为K份
2、选择第i个切片作为验证集,其余部分作为训练数据
3、第一片的训练数据直接填进去,之后的使用cat进行相连接
"""
def get_k_fold_data(k, i, X, y):
    # 假设k折大于1,将数据集分成k份
    assert k > 1 # 确保k>1,至少要2折才能进行交叉验证
    fold_size = X.shape[0] // k # 每折大小(整除)
    X_train, y_train = None, None
    X_valid, y_valid = None, None
    for j in range(k):
        if j==k-1 : fold_size += X.shape[0] % k
        # slice(start, stop, step) 创建切片对象
        idx = slice(j * fold_size, (j + 1) * fold_size) # 当前折的索引范围
        X_part, y_part = X[idx, :], y[idx]

        # 将第i片数据集作为验证集
        if j == i:
            X_valid, y_valid = X_part, y_part

        # 其他余下的片作为训练集
        elif X_train is None:
            X_train, y_train = X_part, y_part

        # 使用cat()函数将余下的训练集片进行拼接
        else:
            X_train = torch.cat([X_train, X_part], 0)
            y_train = torch.cat([y_train, y_part], 0)
    return X_train, y_train, X_valid, y_valid
改进版:
# 改进版
def get_k_fold_data1(k, i, X, y):
    # 假设k折大于1,将数据集分成k份
    assert k > 1 # 确保k>1,至少要2折才能进行交叉验证
    fold_size = X.shape[0] // k # 每折大小(整除)

    X_valid, y_valid = None, None
    X_train_list, y_train_list = [], [] # 先预先分配列表,最后再一次性拼接
    for j in range(k):
        if j==k-1 : fold_size += X.shape[0] % k
        # slice(start, stop, step) 创建切片对象
        idx = slice(j * fold_size, (j + 1) * fold_size) # 当前折的索引范围
        X_part, y_part = X[idx, :], y[idx]

        # 将第i片数据集作为验证集
        if j == i:
            X_valid, y_valid = X_part, y_part
        else:
            X_train_list.append(X_part)
            y_train_list.append(y_part)
    X_train = torch.cat(X_train_list, dim=0) if X_train_list else torch.empty((0, X.shape[1]), dtype=X.dtype)
    y_train = torch.cat(y_train_list, dim=0) if y_train_list else torch.empty(0, dtype=y.dtype)
    return X_train, y_train, X_valid, y_valid
2)在K折交叉验证中训练K次
当我们在K折交叉验证中训练K次后,返回训练和验证误差的平均值。
"""
在K折交叉验证中训练K次:
1、返回训练和验证误差的平均值
2、可视化训练误差和验证误差
num_epochs:训练的周期数。
learning_rate:学习率。
weight_decay:权重衰减(L2 正则化系数)。
batch_size:批次大小
"""
def k_fold(k, X_train, y_train,
           num_epochs, learning_rate, weight_decay, batch_size):
    train_l_sum, valid_l_sum = 0, 0
    for i in range(k): # 循环 k 次,每次处理一个折
        # 进行k折交叉验证
        data = get_k_fold_data(k, i, X_train, y_train) # 获取当前折的数据
        net = get_net() # 初始化模型
        # 获取训练集和测试集的损失列表
        train_ls, valid_ls = train(net, *data, # *data 用于解包 get_k_fold_data 返回的元组
                                   num_epochs, learning_rate, weight_decay, batch_size)
        # 累加损失
        train_l_sum += train_ls[-1]
        valid_l_sum += valid_ls[-1]
        if i == 0: # 仅在第一个折时绘制训练损失和验证损失的变化曲线
            # 画图:训练损失和验证损失
            # d2l.plot(list(range(1, num_epochs + 1)), [train_ls, valid_ls],
            #          xlabel='epoch', ylabel='rmse', xlim=[1, num_epochs],
            #          legend=['train', 'valid'], yscale='log')
            plt.figure(figsize=(5, 2.5))
            plt.plot(list(range(1, num_epochs + 1)), train_ls) # 绘制训练损失的曲线
            plt.plot(list(range(1, num_epochs + 1)), valid_ls, "--") # 绘制验证损失的曲线
            plt.legend(['train', 'valid']) # 图例标签
            plt.xlabel('epoch')
            plt.ylabel('rmse')
            plt.xlim([1, num_epochs]) # x轴范围
            plt.yscale('log') # 设置y轴刻度:y轴设置为对数刻度
            plt.grid(True)
            plt.show()
        print(f'折{i + 1}, 训练log rmse{float(train_ls[-1]):f},'
             f'验证log rmse{float(valid_ls[-1]):f}')
    return train_l_sum / k, valid_l_sum / k # 返回平均损失
7. 模型选择
1)选择一组未调优的超参数
这里选择了一组未调优的超参数,并将其留给各位来改进模型。找到一组调优的超参数可能需要时间,这取决于一个人优化了多少变量。
- 数据集足够大且超参数设置合理,则K折交叉验证对多次测试具有相当的稳定性。
- 若超参数不合理,则验证效果无法代表真正的误差。
k折:5,迭代轮数:100,学习率:5,权重:0,批量大小:64
# 模型选择
# 折数,迭代轮数,学习率,权重衰减(L2正则化)的系数,批量大小
k, num_epochs, lr, weight_decay, batch_size = 5, 100, 5, 0, 64
train_l, valid_l = k_fold(k, train_features, train_labels, num_epochs, lr, weight_decay,
          batch_size)
print(f'{k}-折验证:平均训练log rmse:{float(train_l):f},'
f'平均验证log rmse:{float(valid_l):f}') 

- 注意:某组超参数的训练误差低,但K折交叉验证的误差高,则表明模型已过拟合。
- 在整个训练过程中,需要监控训练误差和验证误差这两个数字。
- 较少的过拟合可能表明现有数据可以支撑一个更强大的模型,
- 较大的过拟合可能意味着我们可以通过正则化技术来获益。
8. 提交Kaggle预测
- 若已选择好超参数,则可以使用所有数据对其进行训练 (而不是仅使用交叉验证中使用的
的数据)。
- 然后,通过这种方式获得的模型可以应用于测试集。
- 将预测保存在CSV文件中可以简化 将结果上传到Kaggle 的过程。
"""
提交Kaggle预测:
1、使用所有数据进行训练,得到模型
2、该模型可以应用到测试集上,将预测保存在csv文件
"""
def train_and_pred(train_features, test_features,
                   train_labels, test_data, # 训练集的标签数据(目标值),测试集的标签数据(目标值)
                  num_epochs, lr, weight_decay, batch_size):
    net = get_net() # 初始化模型
    # 用"_"忽略其他可能的输出
    train_ls, _ = train(net, train_features, train_labels, None, None,
         num_epochs, lr, weight_decay, batch_size)

    # d2l.plot(np.arange(1, num_epochs + 1), [train_ls], xlabel='epoch',
    #         ylabel='log rmse', xlim=[1, num_epochs], yscale='log')
    plt.figure(figsize=(5, 2.5))
    plt.plot(np.arange(1, num_epochs + 1), train_ls)
    plt.xlim([1, num_epochs])
    plt.yscale('log')
    plt.xlabel('epoch')
    plt.ylabel('log rmse')
    plt.grid(True)
    plt.show()
    print(f'训练log rmse:{float(train_ls[-1]):f}')

    # 在测试集上预测
    # detach():将张量从计算图中分离,避免梯度计算。
    # numpy():将 PyTorch 张量转换为 NumPy 数组
    preds = net(test_features).detach().numpy()

    # 将其重新格式化以导出到Kaggle(格式化并保存预测结果)
    # preds.reshape(1, -1)[0]:将预测结果 preds 从二维数组转换为一维数组
    # pd.Series(preds.reshape(1, -1)[0]):将预测结果转换为 Pandas Series
    # test_data['SalePrice'] = ...:将预测结果赋值给 test_data 的 SalePrice 列
    test_data['SalePrice'] = pd.Series(preds.reshape(1, -1)[0])
    # 将 Id 和 SalePrice 列合并为一个新的 DataFrame submission
    submission = pd.concat([test_data['Id'], test_data['SalePrice']], axis=1)
    # 将 submission 保存为 CSV 文件,不包含索引
    submission.to_csv('outputFile/submission.csv', index=False)
若测试集上的预测与K倍交叉验证过程中的预测相似,则可以把它们上传到Kaggle了。
下面的代码将生成一个名为submission.csv的文件。
train_and_pred(train_features, test_features, train_labels, test_data,
                  num_epochs, lr, weight_decay, batch_size)


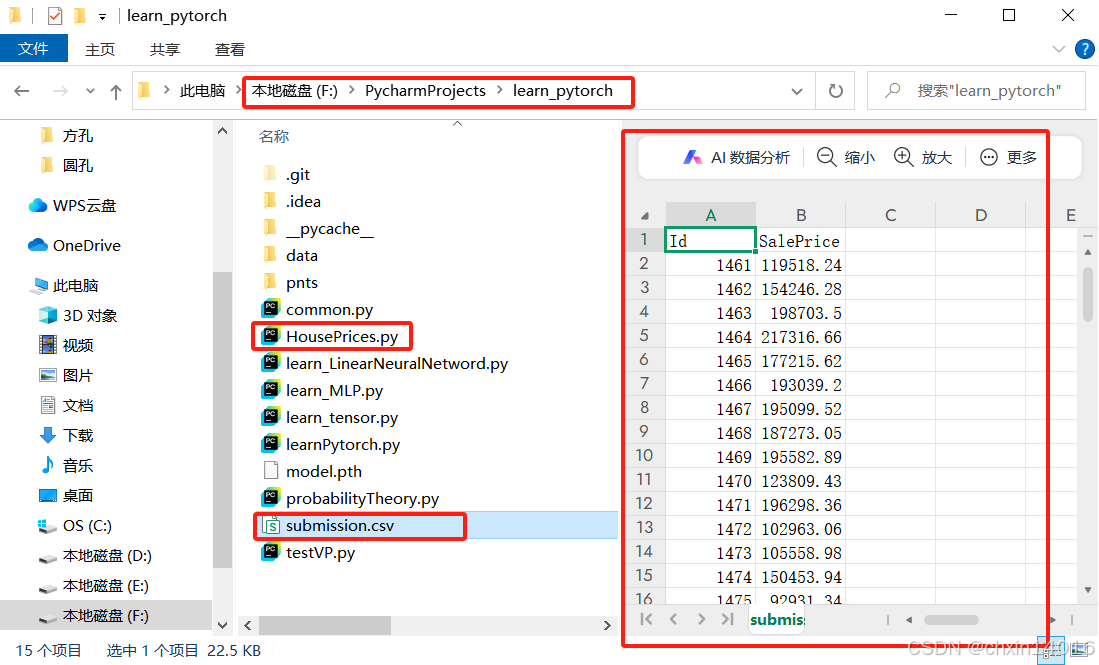
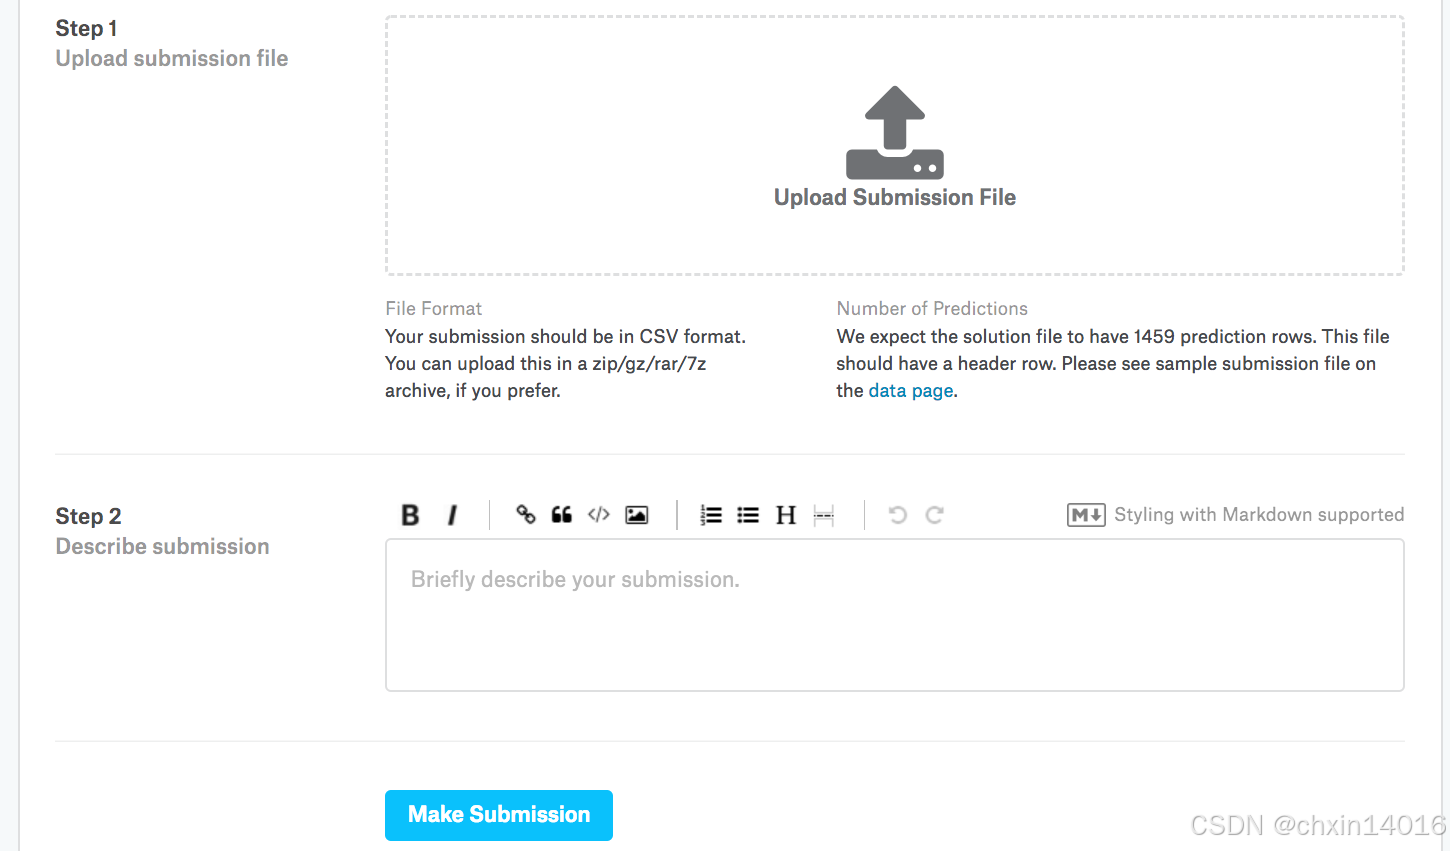
接下来,如 图4.10.3中所示,可以提交预测到Kaggle上,并查看在测试集上的预测与实际房价(标签)的比较情况。步骤如下:
- 登录Kaggle网站,访问房价预测竞赛页面。
- 点击“Submit Predictions”或“Late Submission”按钮(在撰写本文时,该按钮位于右侧)。
- 点击页面底部虚线框中的“Upload Submission File”按钮,选择要上传的预测文件。
- 点击页面底部的“Make Submission”按钮,即可查看结果。
9. 调参优化
因为之前是给的未优化的超参数,我们可以对k, num_epochs, lr, weight_decay, batch_size进行调参优化,这里给出一组超参数:
k, num_epochs, lr, weight_decay, batch_size = 8, 150, 6, 0, 64


其他的超参数可以试一下
| 组别\超参数 | k | num_epochs | lr | weight_decay | batch_size | 训练损失 | 验证损失 | 测试损失 |
|---|---|---|---|---|---|---|---|---|
| 原始 | 5 | 100 | 5 | 0 | 64 | 0.1653 | 0.1705 | 0.1628 |
| 第一组 | 5 | 100 | 8 | 0 | 64 | 0.1539 | 0.1630 | 0.1460 |
| 第二组 | 6 | 100 | 8 | 0 | 64 | 0.1534 | 0.1609 | 0.1460 |
| 第三组 | 8 | 100 | 8 | 0 | 64 | 0.1512 | 0.1593 | 0.1460 |
| 第五组 | 12 | 100 | 8 | 0 | 64 | 0.1488 | 0.1553 | 0.1456 |
| 第六组 | 20 | 100 | 8 | 0 | 64 | 0.1475 | 0.1543 | 0.1457 |
| 第七组 | 8 | 150 | 6 | 0 | 64 | 0.1447 | 0.1537 | 0.1404 |
| 第八组 | 12 | 200 | 8 | 0 | 64 | 0.1299 | 0.1432 | 0.1288 |
| 第九组 | 20 | 300 | 8 | 0 | 64 | 0.1248 | 0.1470 | 0.1247 |
| 第十组 | 8 | 100 | 8 | 0 | 32 | 0.1331 | 0.1450 | 0.1308 |
| 第十一组 | 12 | 200 | 8 | 0 | 32 | 0.1240 | 0.1470 | 0.1243 |
小结
真实数据通常混合了不同的数据类型,需要进行预处理。
常用的预处理方法:将实值数据重新缩放为零均值和单位方法;用均值替换缺失值。
将类别特征转化为指标特征,可以使我们把这个特征当作一个独热向量来对待。
我们可以使用K折交叉验证来选择模型并调整超参数。
对数对于相对误差很有用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 15
 0
- 0


 已为社区贡献3条内容

所有评论(0)