Python----目标检测(《You Only Look Once: Unified, Real-Time Object Detection》、约瑟夫-雷德蒙介绍、YOLOV1的原理与网络结构)
一、You Only Look Once: Unified, Real-Time Object Detection
1.1、基本信息
-
标题:You Only Look Once: Unified, Real-Time Object Detection
-
作者:Joseph Redmon、Santosh Divvala、Ross Girshick、Ali Farhadi
-
机构:华盛顿大学、艾伦人工智能研究所、Facebook AI Research
-
发表时间:2015年(根据arXiv编号1506.02640v5推断)
-
核心贡献:提出YOLO(You Only Look Once),一种端到端的实时目标检测框架。
论文地址:
[1506.02640] You Only Look Once: Unified, Real-Time Object Detection
1.2、主要内容
-
创新点:
-
回归问题重构:将目标检测从传统的多阶段流程(如区域建议+分类)转化为单阶段回归问题,直接预测边界框坐标和类别概率。
-
统一架构:单一卷积神经网络同时完成特征提取、边界框预测和非极大值抑制,实现端到端优化。
-
实时性:基础模型YOLO处理速度达45 FPS,Fast YOLO达155 FPS,远超同期实时检测系统(如DPM、R-CNN系列)。
-
-
技术细节:
-
网格划分:输入图像划分为S×SS×S网格,每个网格预测BB个边界框及其置信度(包含物体概率与IOU)。
-
输出张量:最终输出为S×S×(B×5+C)S×S×(B×5+C)的张量(如VOC数据集:7×7×307×7×30)。
-
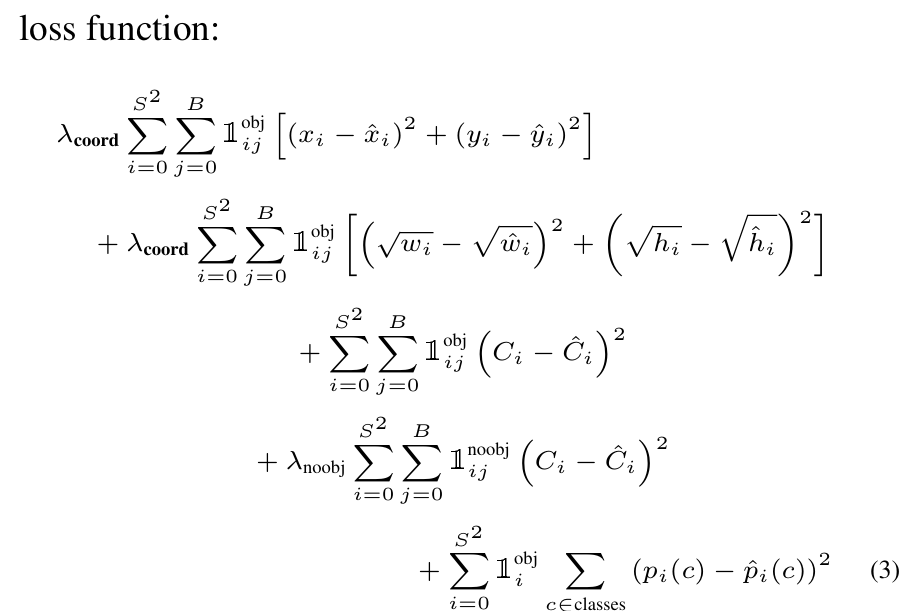
损失函数:结合定位误差(坐标、尺寸)与分类误差,通过权重参数(λcoordλcoord、λnoobjλnoobj)平衡背景与前景的梯度影响。
-
-
优势:
-
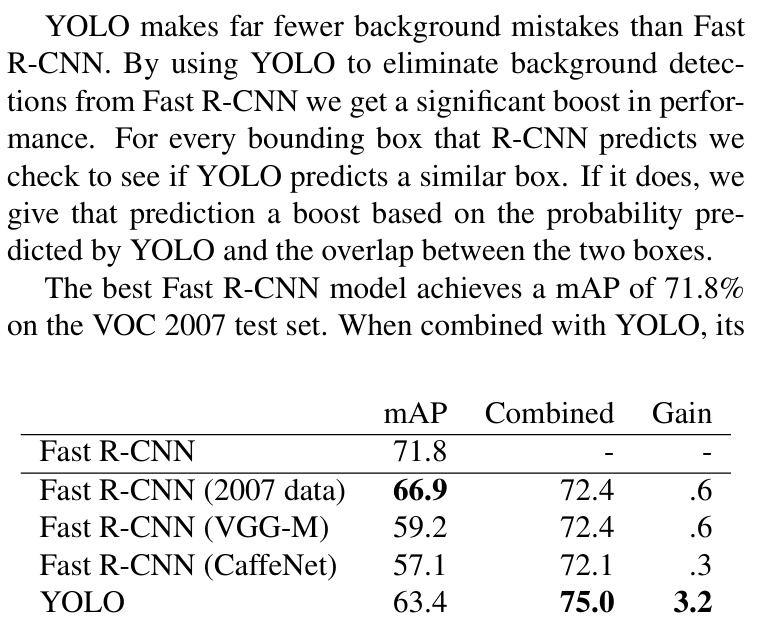
全局推理:利用全图上下文信息,减少背景误检(Fast R-CNN的背景误检率比YOLO高3倍)。
-
泛化能力强:在自然图像训练后,对艺术作品等新领域检测表现优于DPM和R-CNN。
-
高效部署:单次前向传播完成检测,无需复杂后处理,适合实时应用(如视频流、自动驾驶)。
-
-
局限性:
-
小物体检测:因下采样导致特征分辨率不足,对小物体或密集群体(如鸟群)定位精度较低。
-
定位误差:主要错误来源为边界框坐标偏差,尤其是非常规宽高比的物体。
-
1.3、影响与作用
-
学术影响:
-
范式转变:推动目标检测从多阶段向单阶段回归模型的演进,启发了后续SSD、RetinaNet等工作的设计。
-
开源贡献:公开代码和预训练模型,降低了研究门槛,加速了社区发展。
-
-
工业应用:
-
实时场景:成为自动驾驶、视频监控、机器人导航等领域的核心算法之一。
-
效率标杆:YOLO系列(v1至v8)持续优化,成为工业界部署轻量化模型的基准。
-
-
技术启示:
-
端到端设计:证明单一网络可兼顾速度与精度,挑战了传统“分治策略”的必要性。
-
跨领域泛化:为少样本迁移学习、艺术图像分析等方向提供了新思路。
-
二、约瑟夫-雷德蒙(Joseph Redmon)
留着大胡子却怀揣着少女心,技术超神却依然童心未 泯。
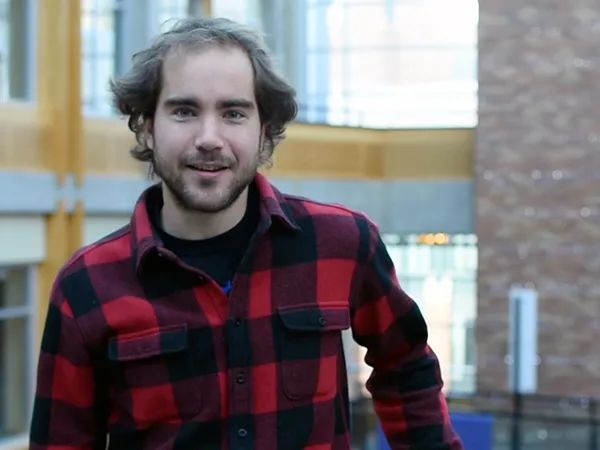
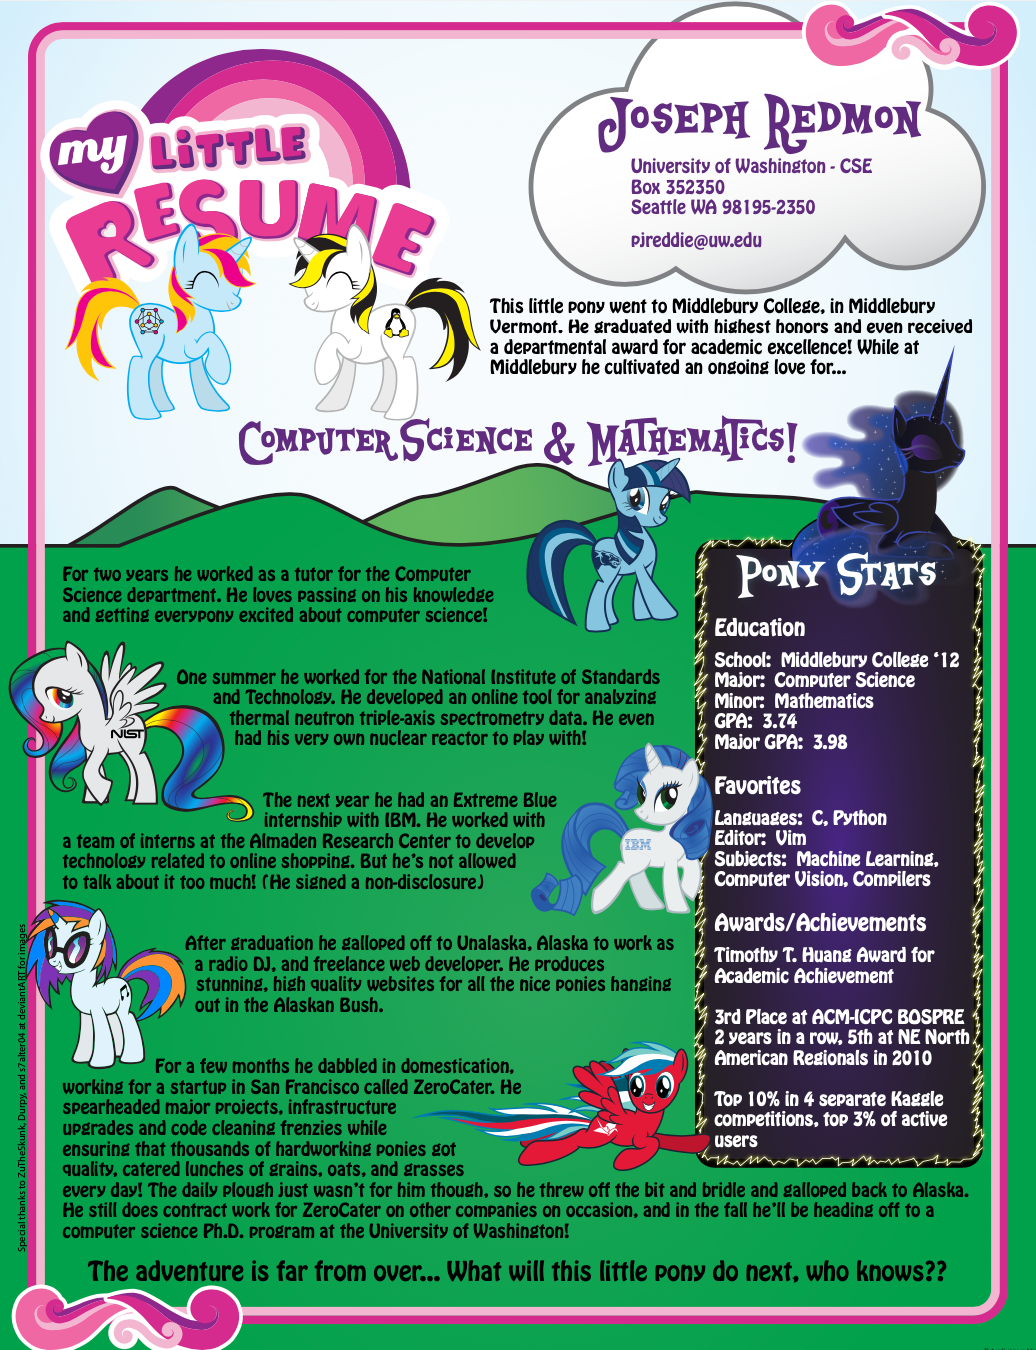
Joseph Redmon在简历中称呼自己为“小马”。小马哥毕业于一所美国非常著名的文理学院——明德学院(Middlebury College),文理学院是指奉行博雅教育、以本科教育为主、规模小而精的大学,而明德学院在全美排名第五,是一所在本科教育上丝毫不逊色于常青藤联盟的高等学府。
小马哥在明德学院主修计算机科学,并辅修数学。也是在明德学院求学期间,他对计算机科学和数学产生了强烈的好奇与持续的热爱。他以最优异的成绩毕业,还获得了系里的优秀学术奖。同时,小马哥也十分喜欢传授知识,因此,他在明德学院担任了两年助教。
期间,小马哥先是前往美国国家标准与技术研究院,他在那儿开发了一个分析热中子三轴光谱数据的在线工具,甚至还有自己的核反应堆。随后他前往IBM实习,与当时IBM的阿尔玛登研究中心(Almaden Research Center)合作,开发与网上购物相关的技术。小马哥还在当时的一家初创公司ZeroCater工作过,他在那儿负责了一些比较重要的项目。但也是在ZeroCater,这匹小马明白每日“耕作”并不适合他。于是他迅速的甩掉钻头和缰绳,飞奔回了阿拉斯加。
毕业后,不走寻常路的小马哥在阿拉斯加州的Unalaska担任了一名电台DJ,但不忘老本行,小马哥作为自由网络开发者,以及资深爱马人士,他还给阿拉斯加灌木丛里所有漂亮的小马制作了一个高质量网站。
约瑟夫-雷德蒙(Joseph Redmon)简历
三、YOLOV1
3.1、简介
“You Only Look Once”是一种使用卷积神经网络进行目标检测的算法。YOLO是其中速度较快的物体检测 算法之一。虽然它不是最准确的物体检测算法,但是在需要实时检测并且准确度不需要过高的情况下,它 是一个很好的选择。

注意:
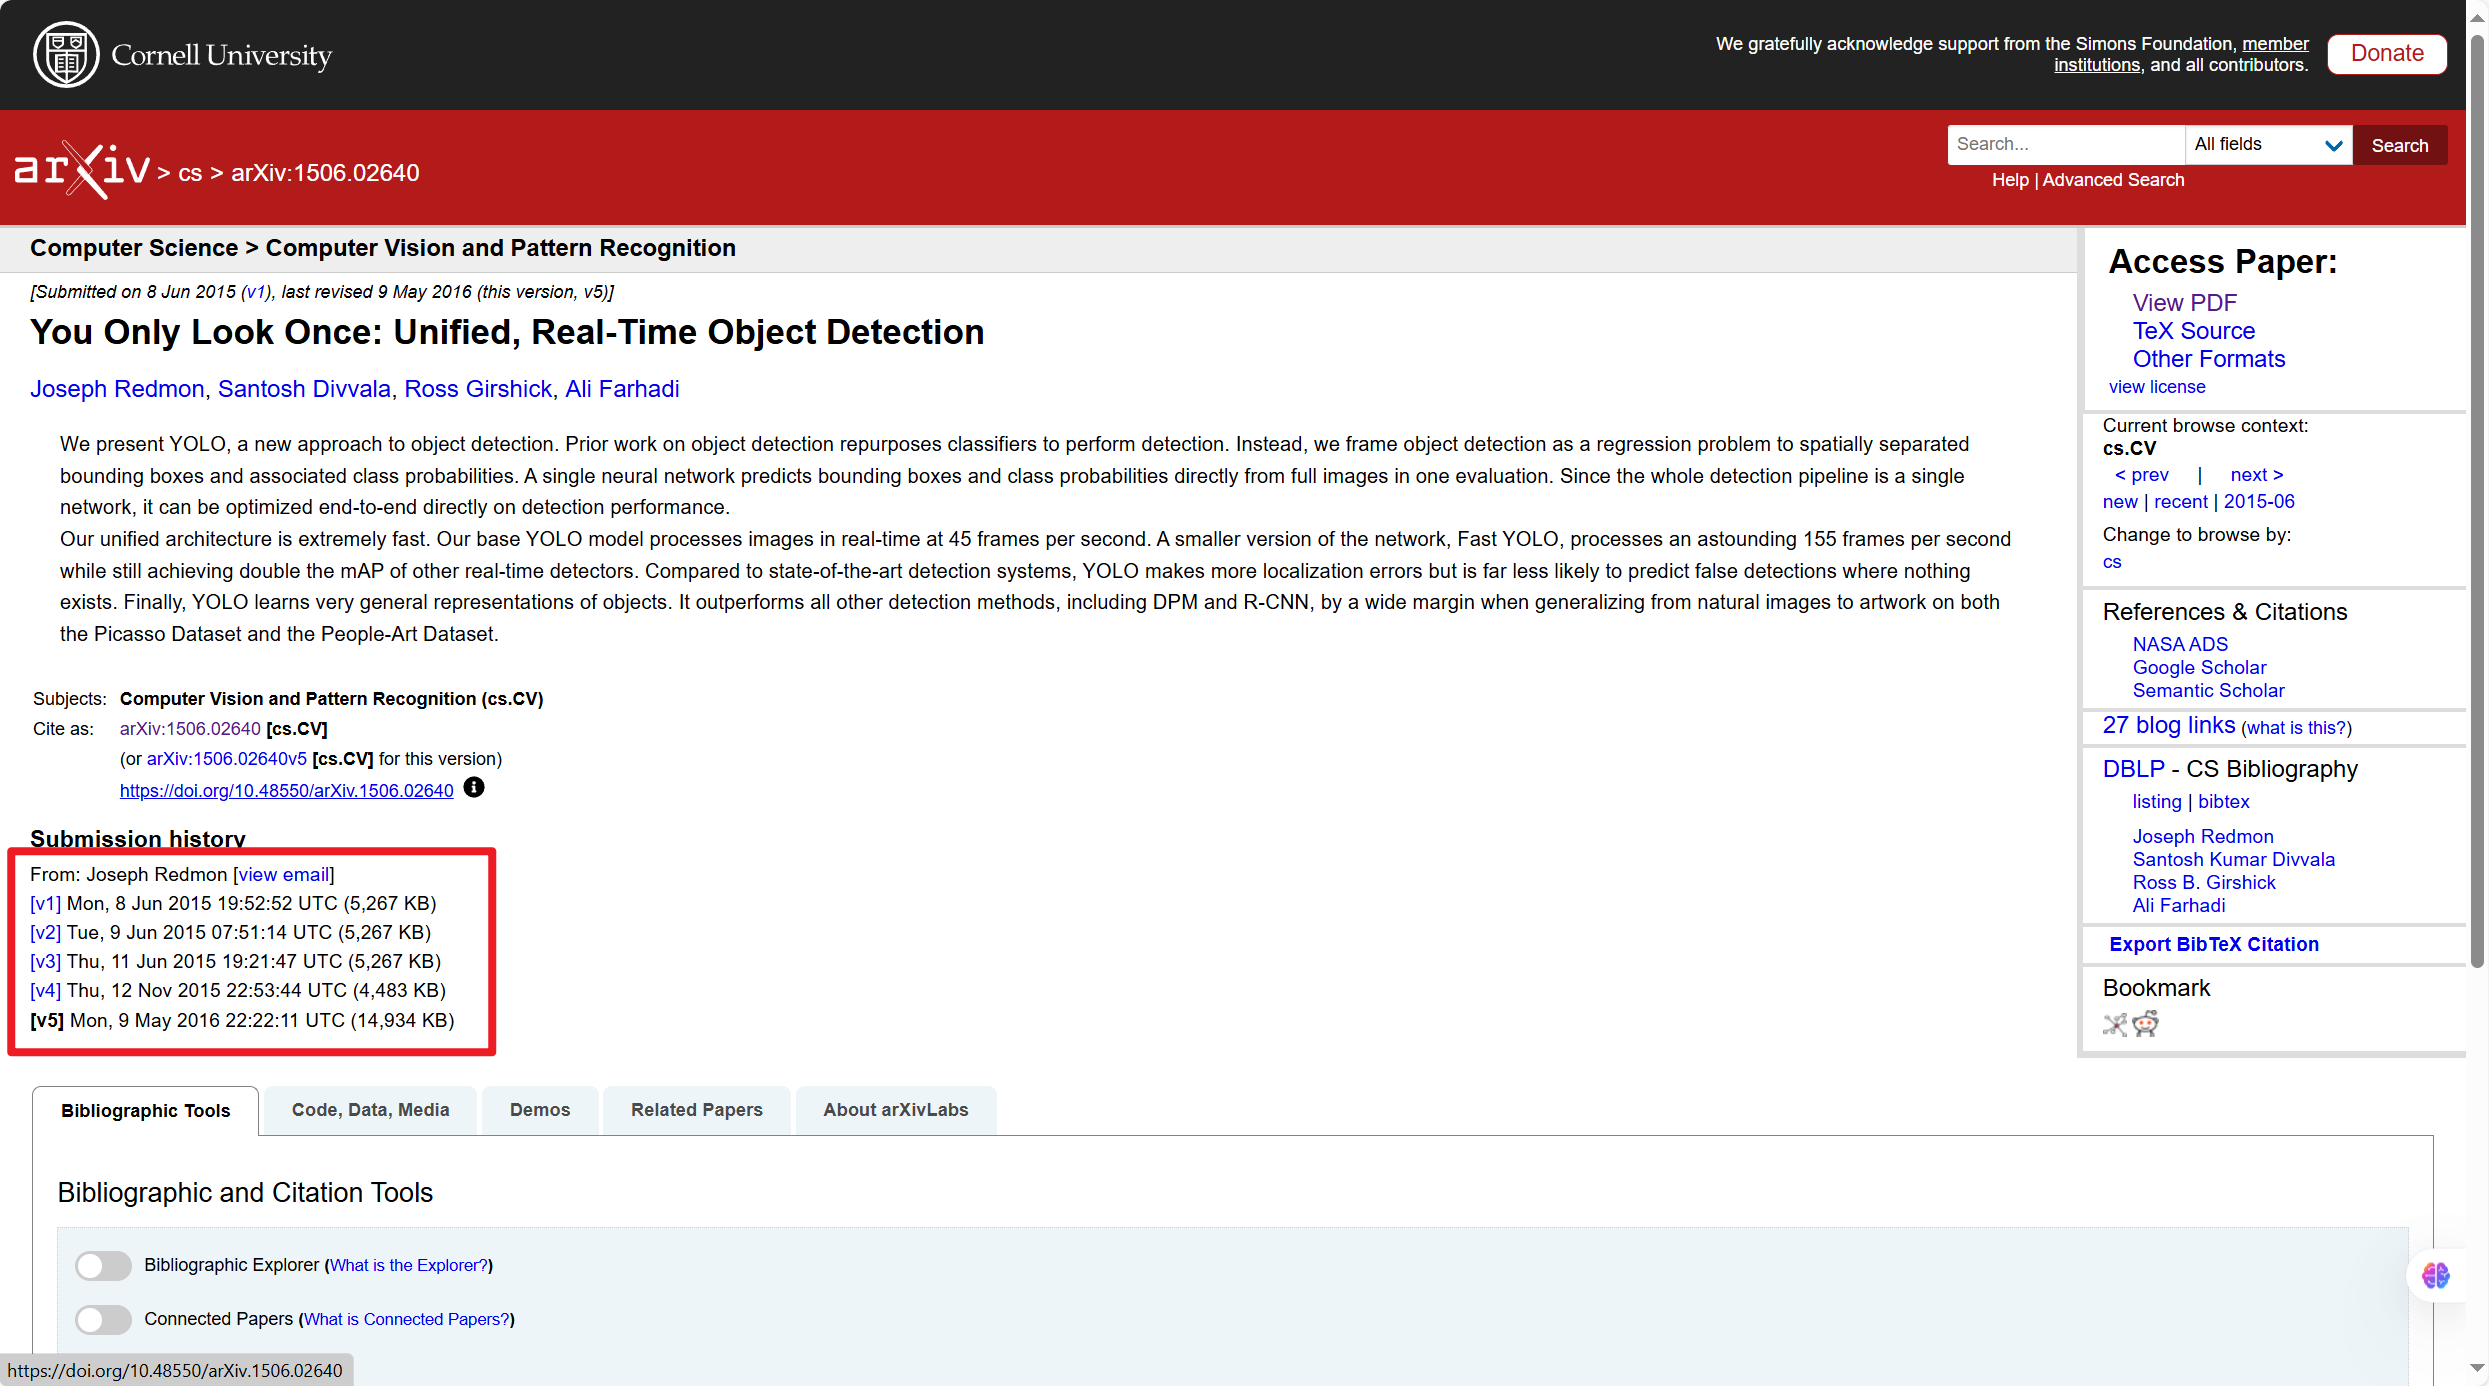
YOLOV1很多地方说是CVPR2016的论文,这是没问题的,但是需要注意的是,在arxiv,YOLO的 第一版提交是在2015年,最后一版v5是在2016年,v5是YOLOV1的第五个版本,而不是YOLOV5,也就 是说:YOLOV1最早是2015年的网络。
3.2、速度与精度

3.3、YOLO的前向实现过程

注意:
在7x7x1024之后,要经过flatten和fc(4096)得到4096节点,接下来通过fc(1470)和reshape得到 7x7x30的张量。
经过网络后得到的输出是:7x7x30。
YOLOv1的backbone结构中使用了Leaky ReLu激活函数。
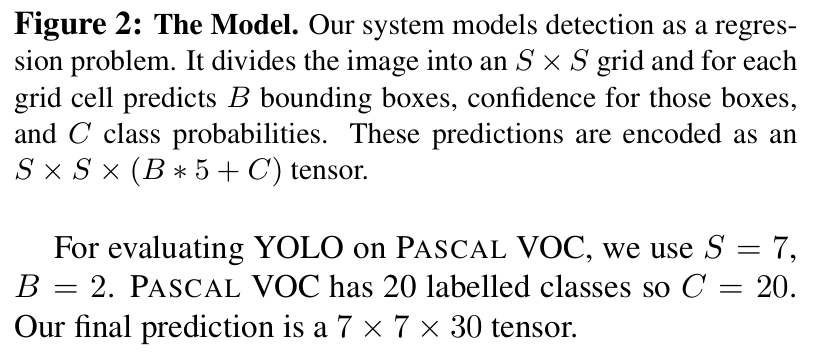
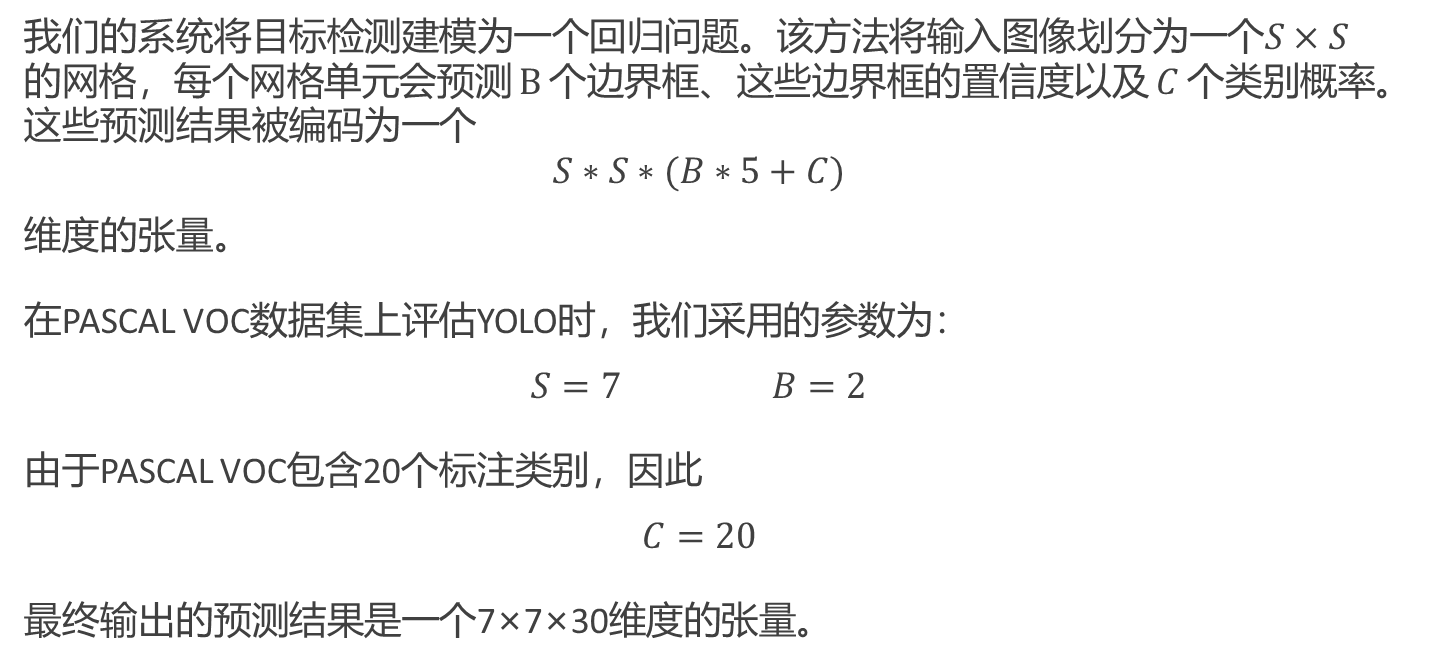
公式:S x S x (B x 5 + C)。
在YOLOV1中,他先把原图划分成7x7个网格(grid cell,超参数),每个grid cell生成两个预测框 bounding box,两个预测框的中心点都落在所在grid cell中,每个bounding box都包含四个位置参数 (xywh)和一个置信度参数。
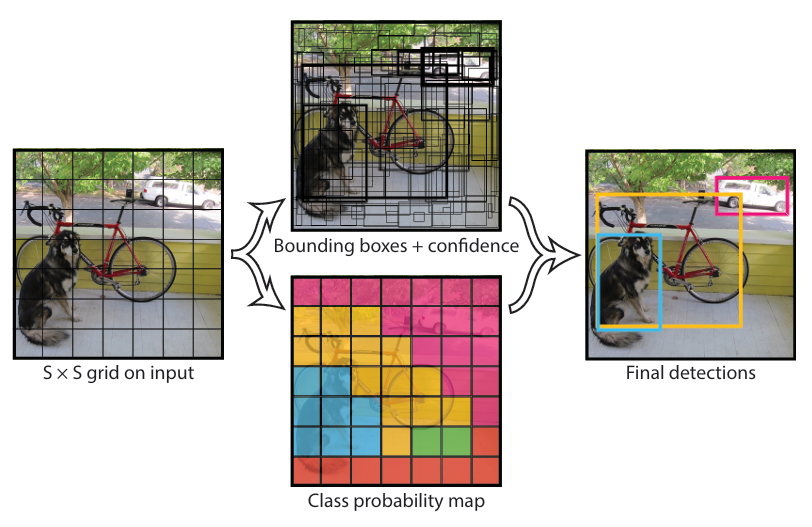
上图中Class probability map图中,黄色的grid cell是自行车的条件概率比较高的,蓝色的grid cell是狗 的条件概率比较高的。每个grid cell只能预测到一个类别(YOLOV1小目标预测差,两个bounding box都 是这个类别)。
上图中Bounding boxes + confdence图中,框框代表bounding box,粗细代表置信度。

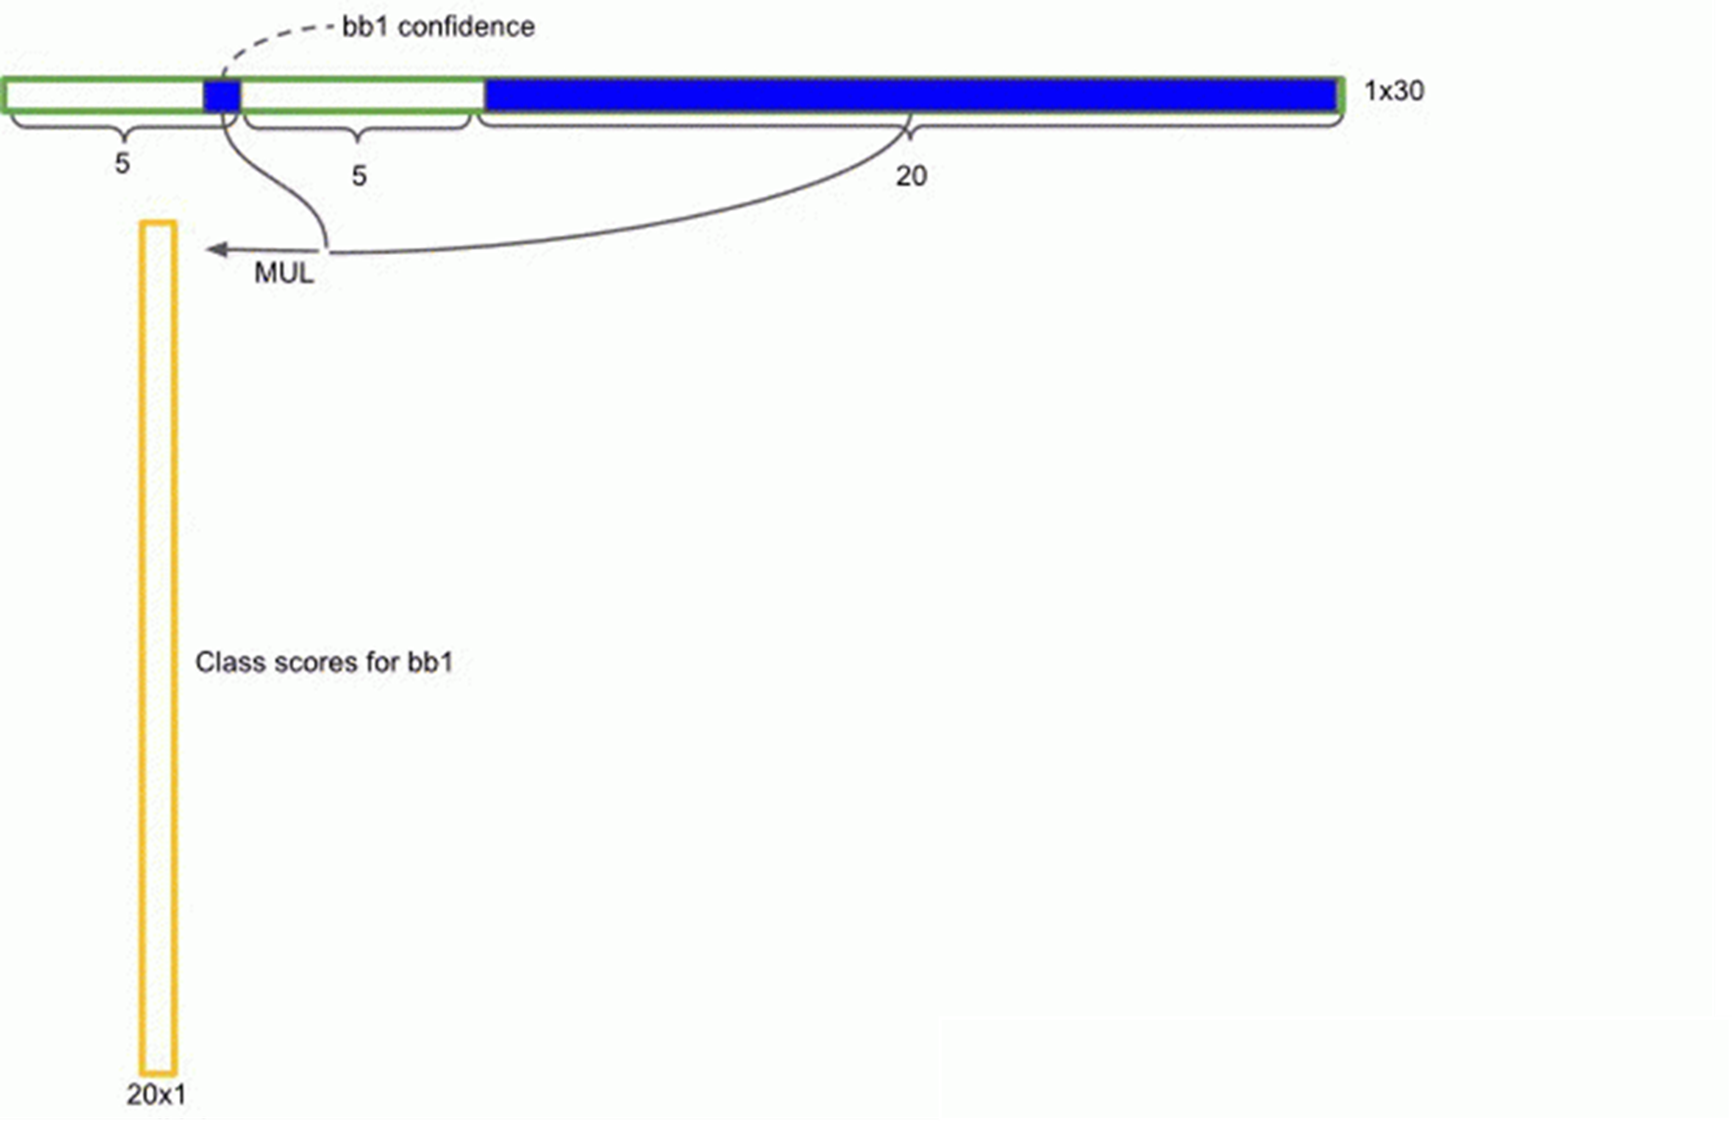
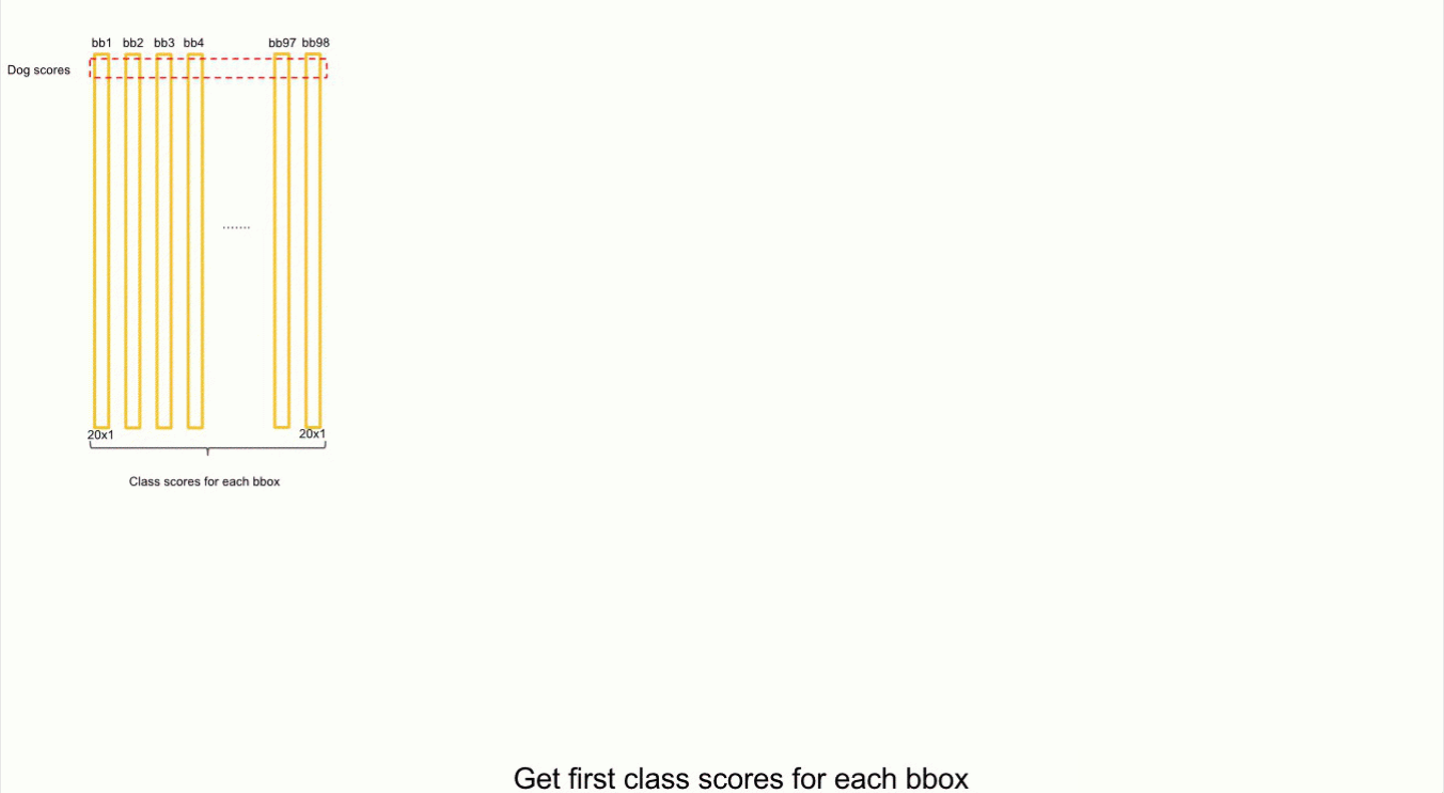
举例:对于每一个grid cell,即图中的每一行,都有2个Box,和20类的条件概率。一共有49个grid cell, 98个Box。
输出:7x7x(2x5+20)=7x7x30tensor=1470 outputs


3.4、前向的后处理
20类的输出是条件概率,例如P(Cat|Object)意思是:假设这个Bounding boxes包含物体的条 件下(类似于有无前景感觉),它是猫的概率。
每个预测框Bounding box有5个参数(xywh,置信度),这个置信度是P(Object),即 该Bounding box包含物体的概率,这个值与20类中的每一个进行相乘,例如乘以P(Cat|Object),那么就 会得到这个Bounding box是猫的概率,即P(A)=P(A|B)*P(B)。


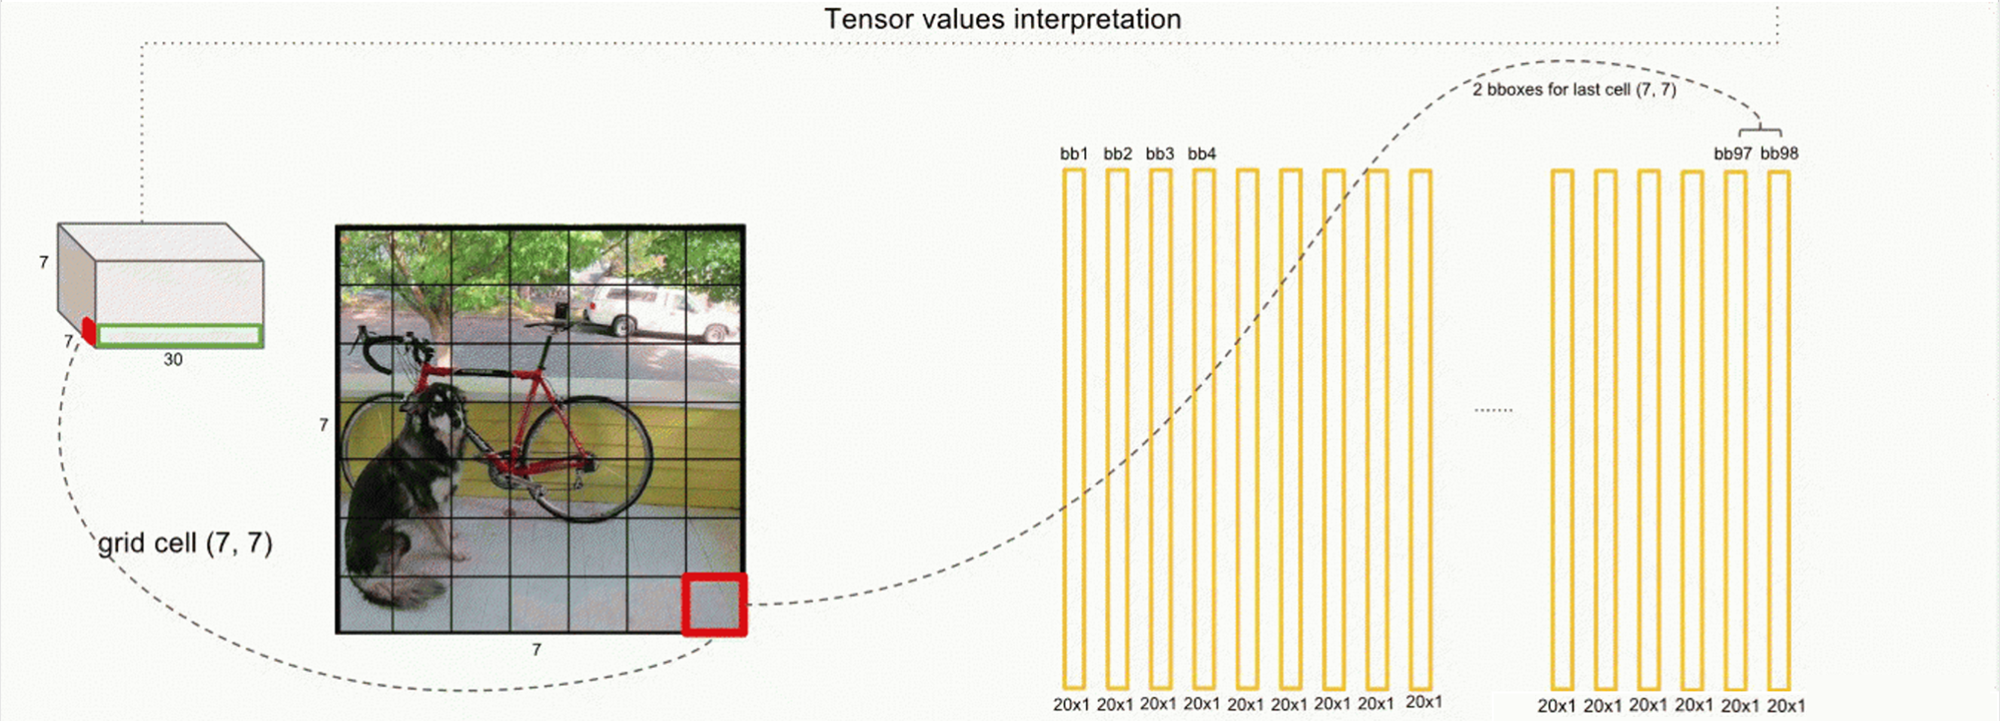
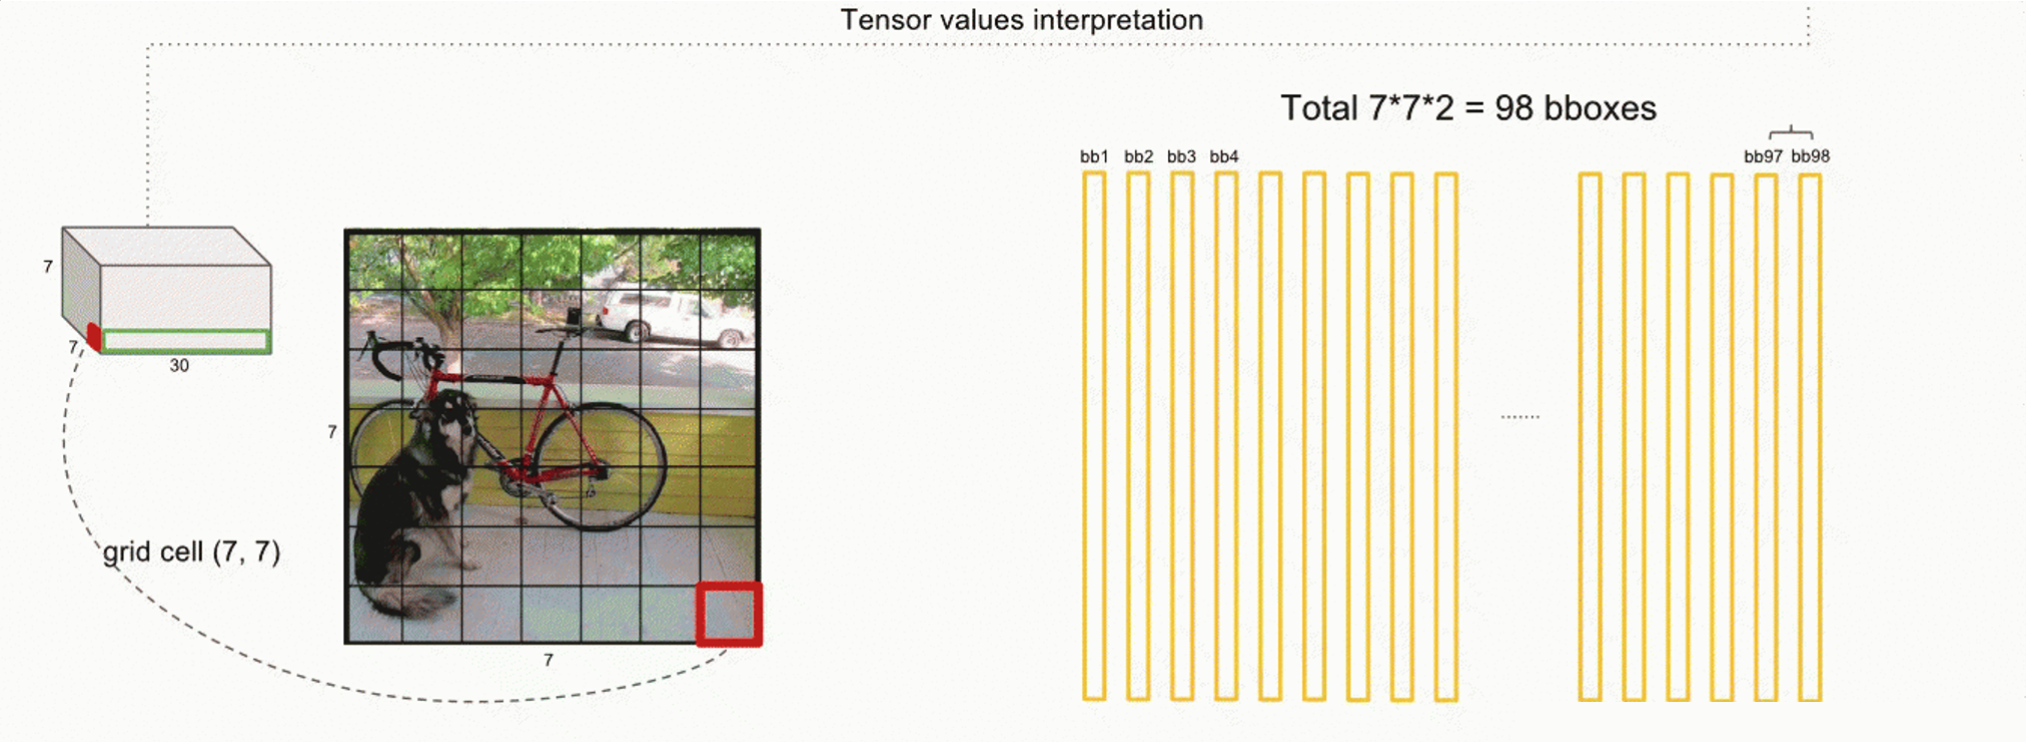
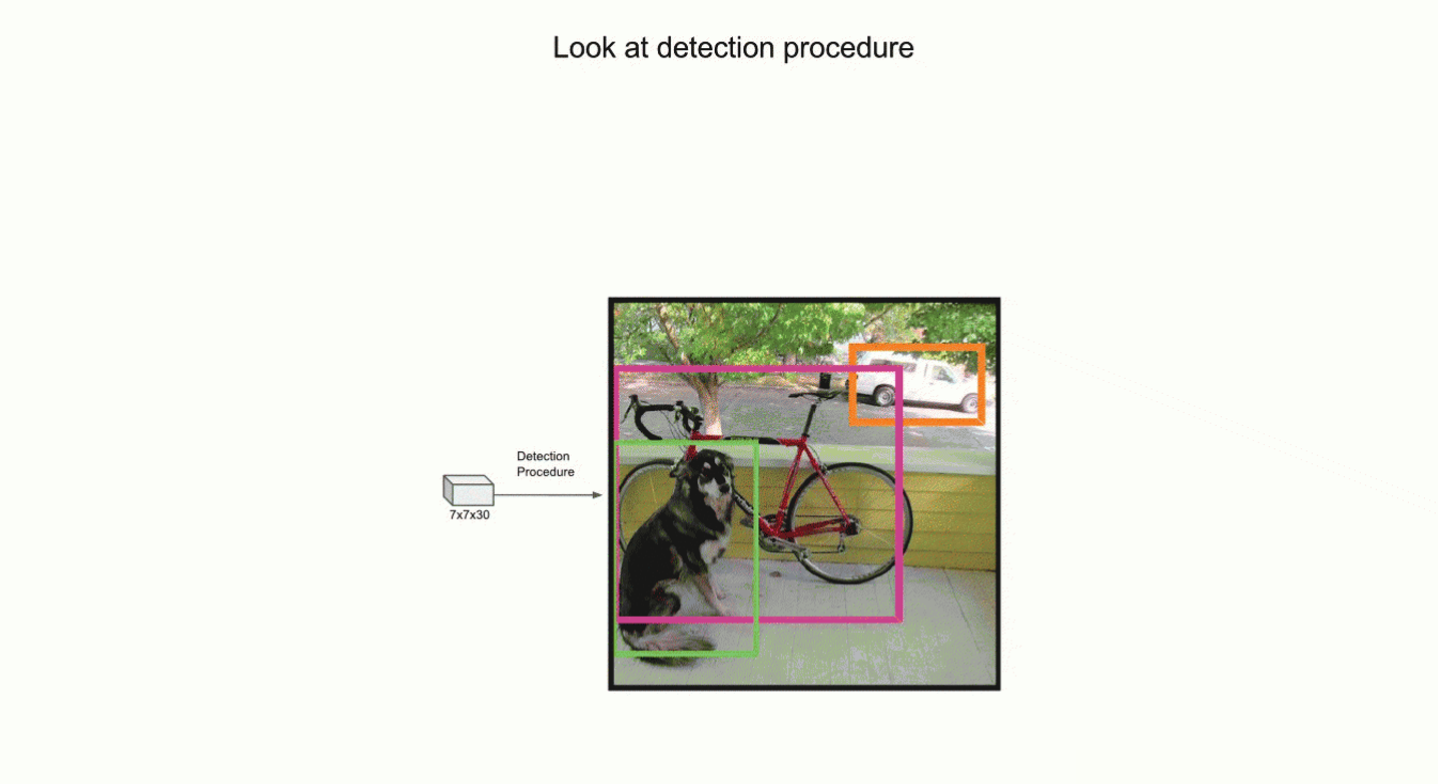
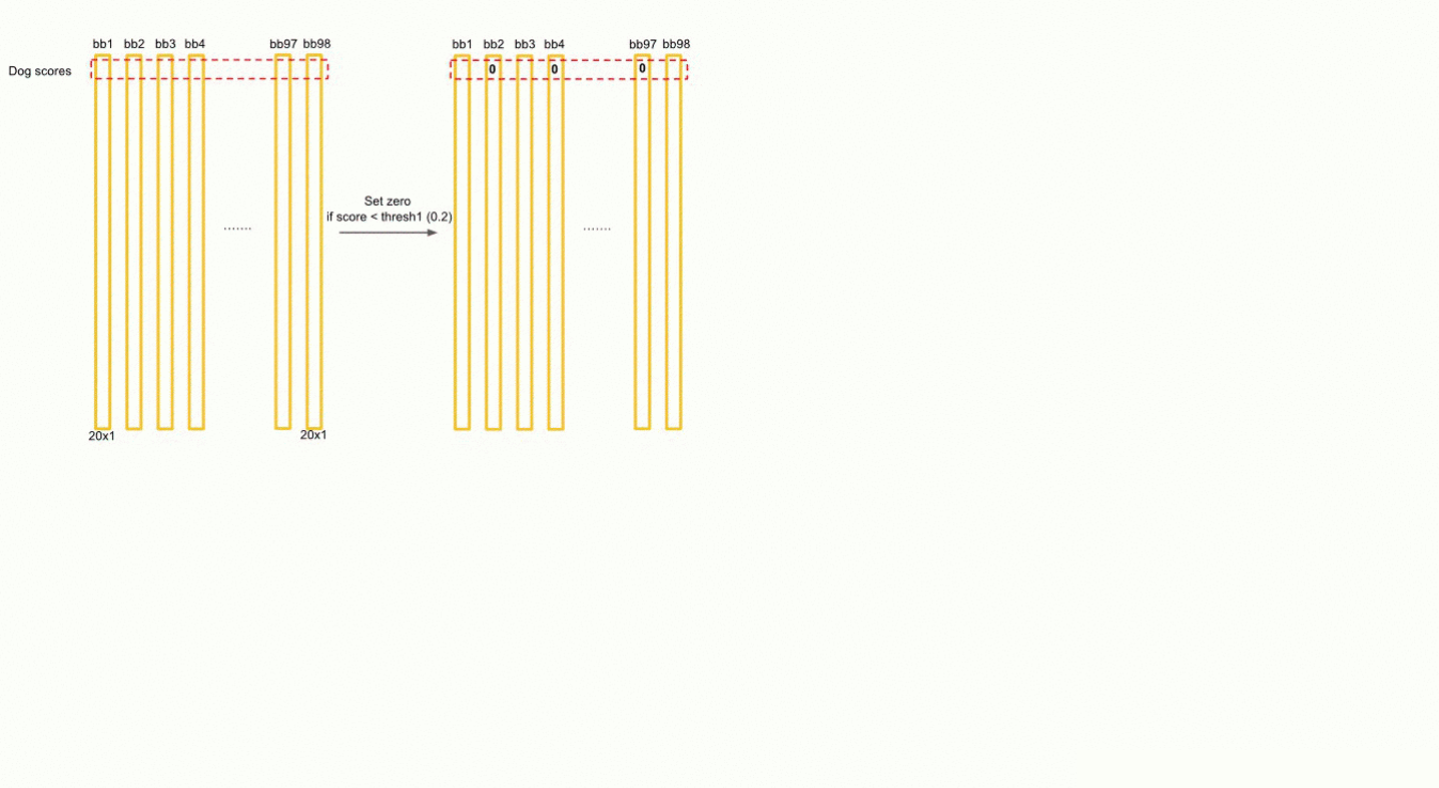
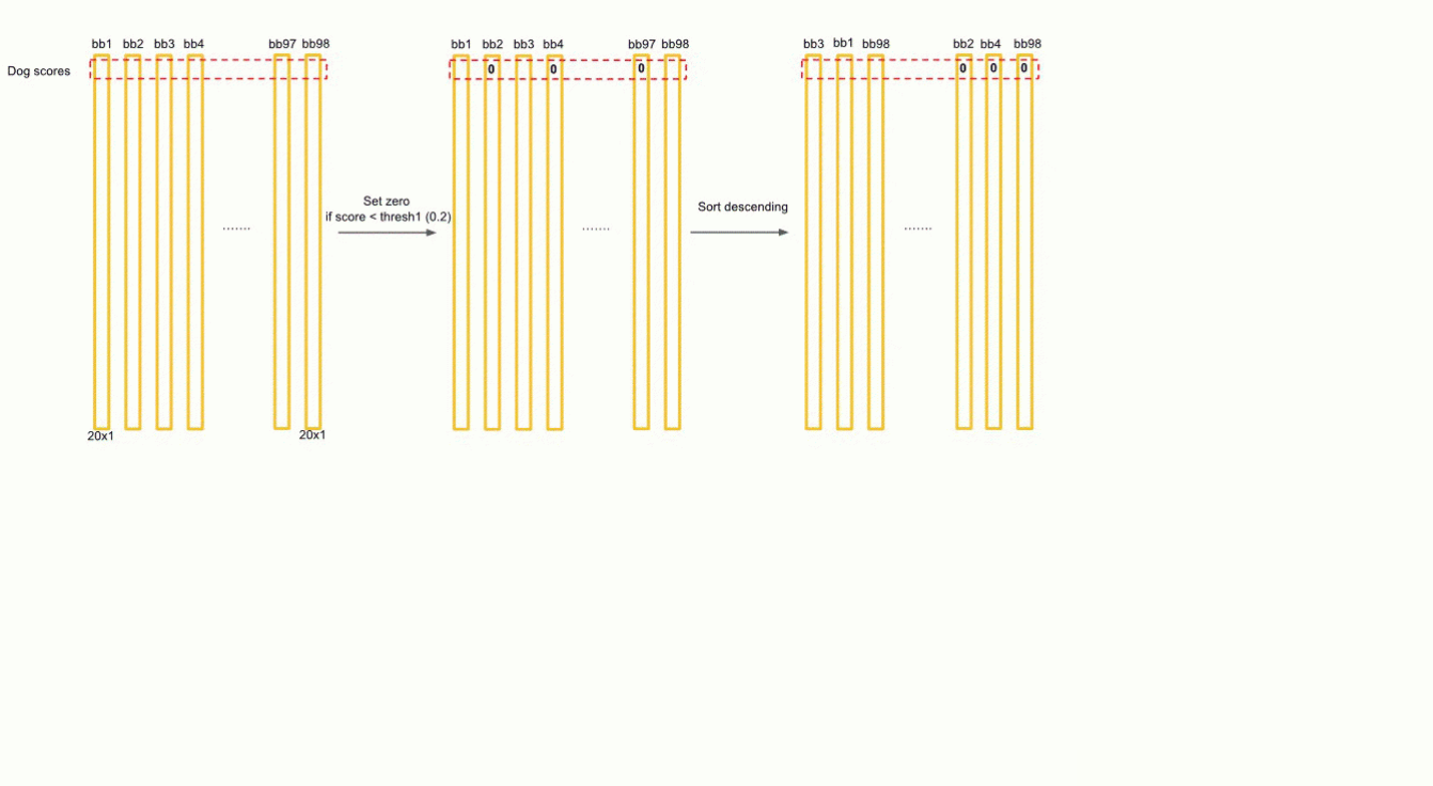
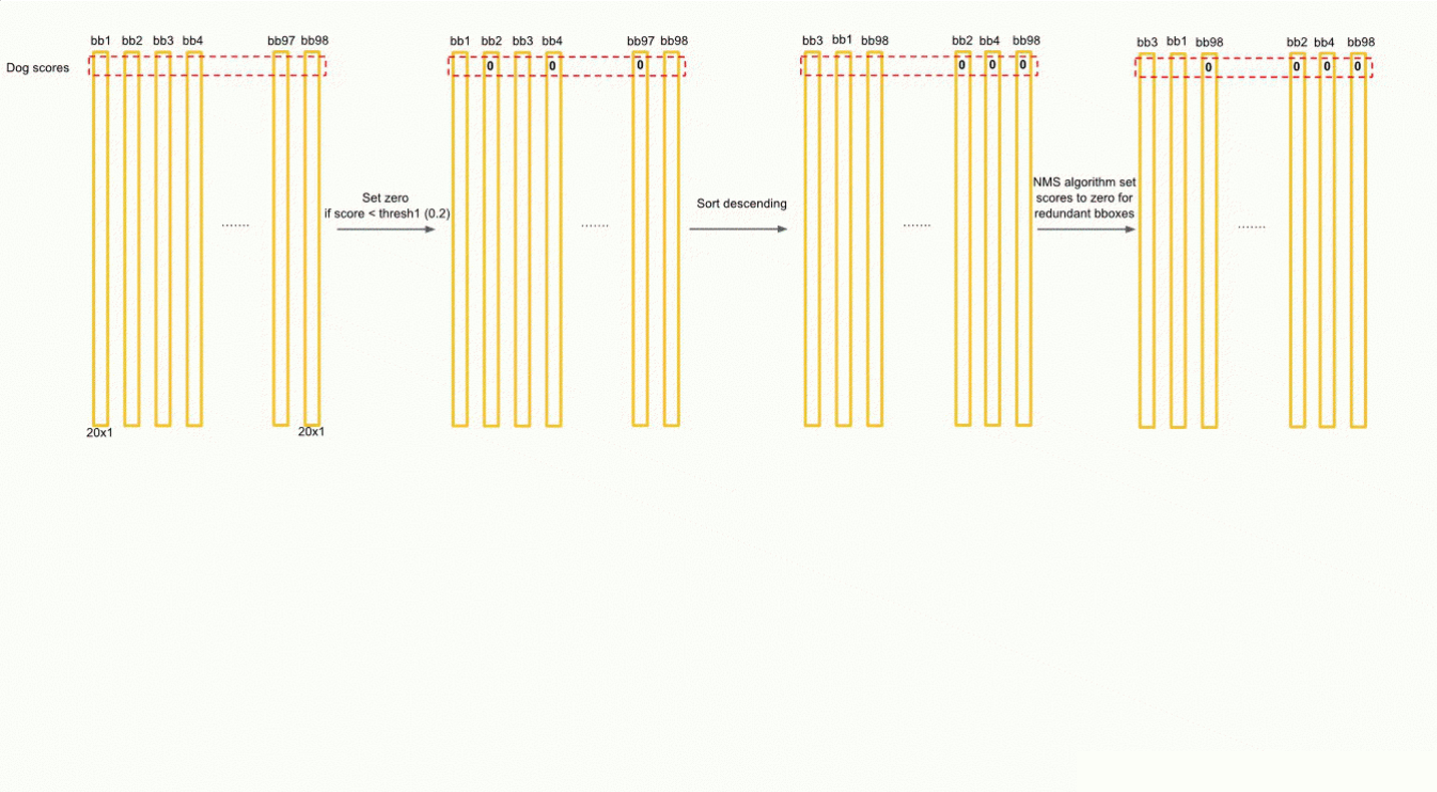
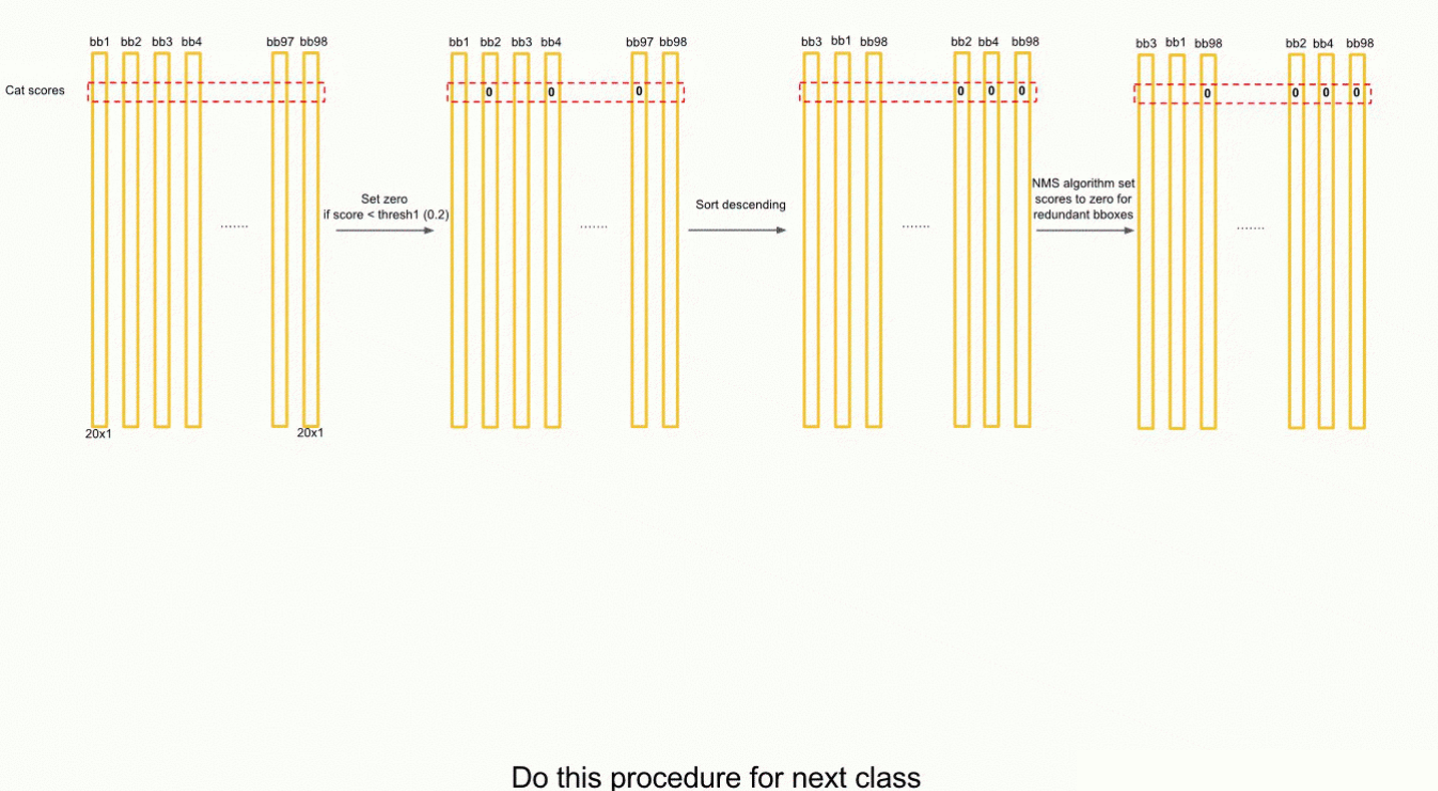
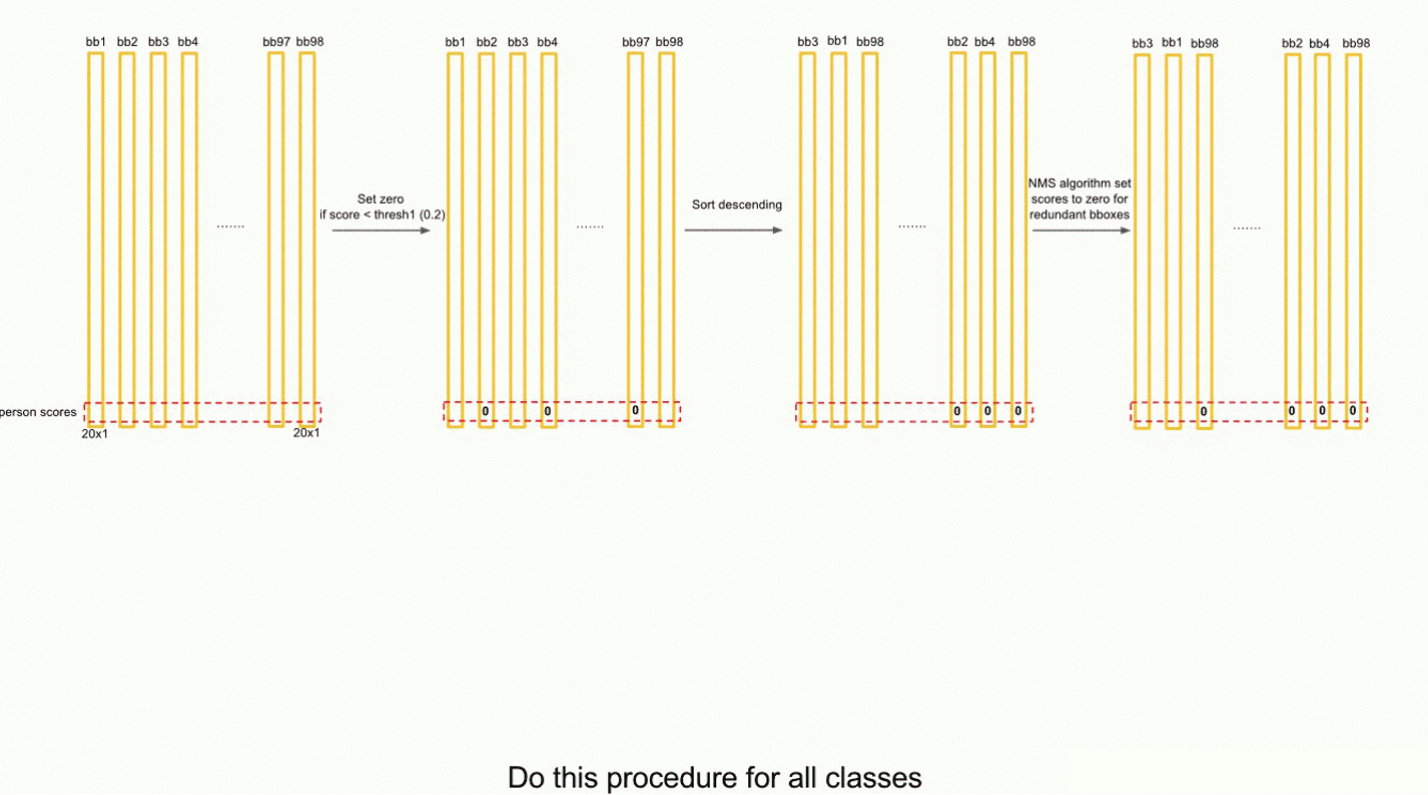
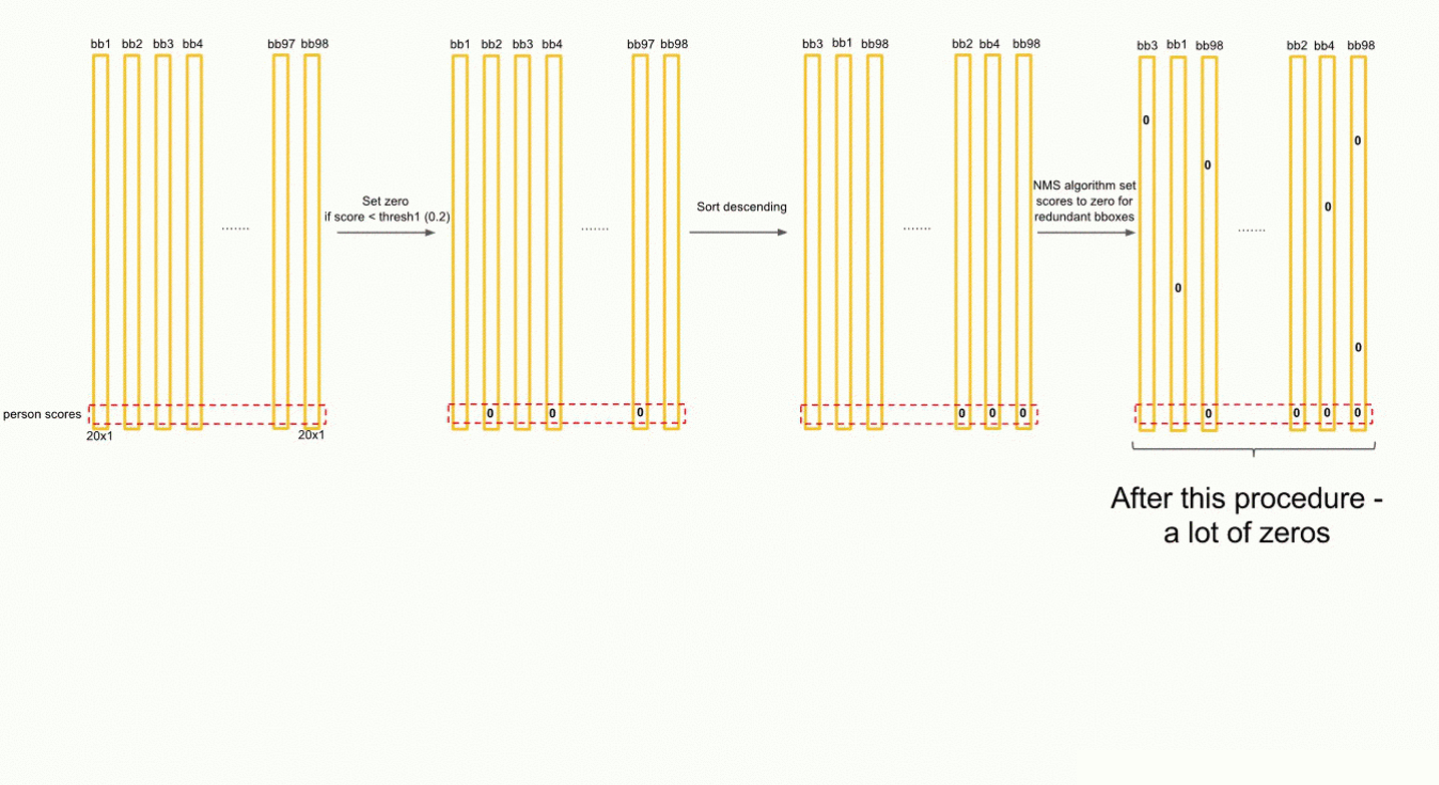
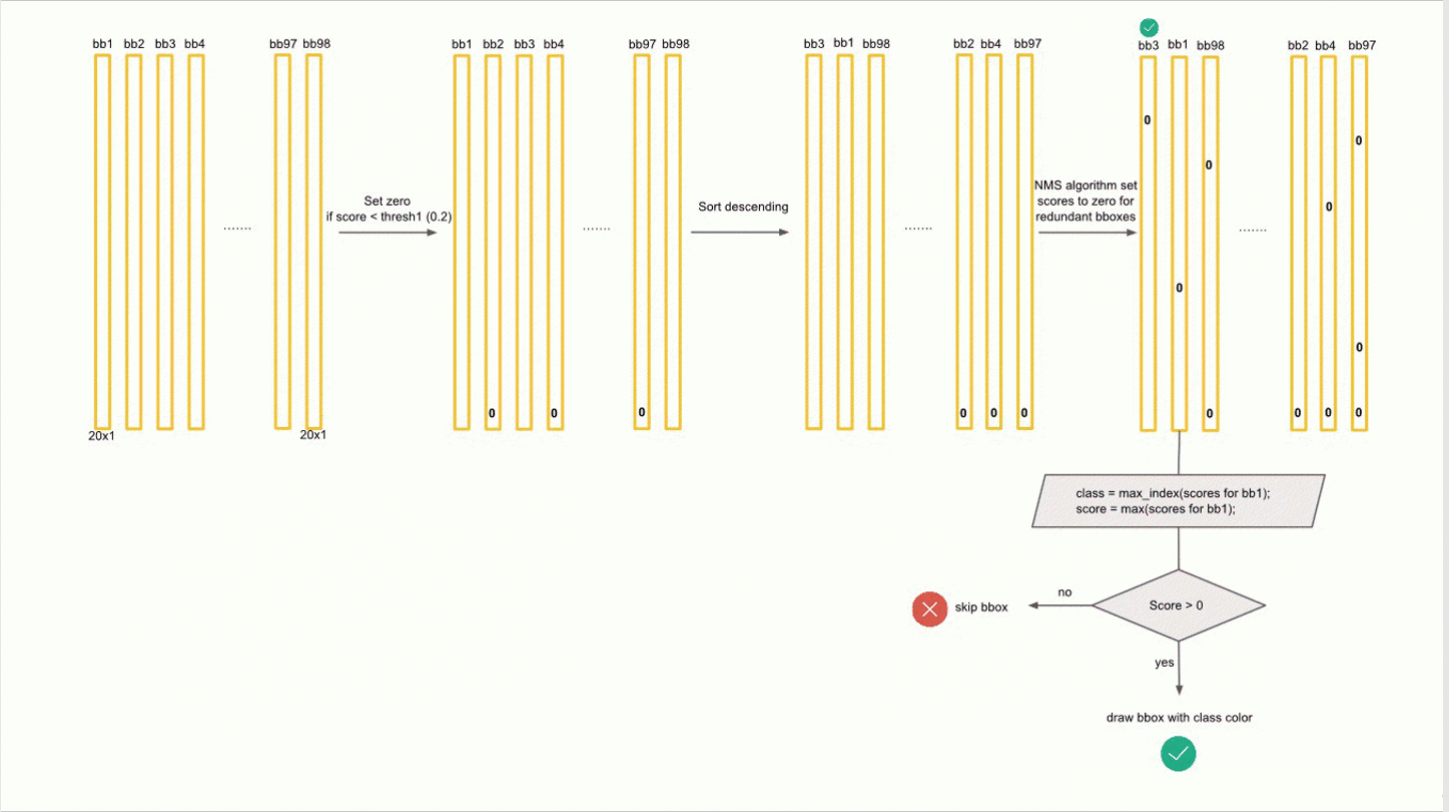
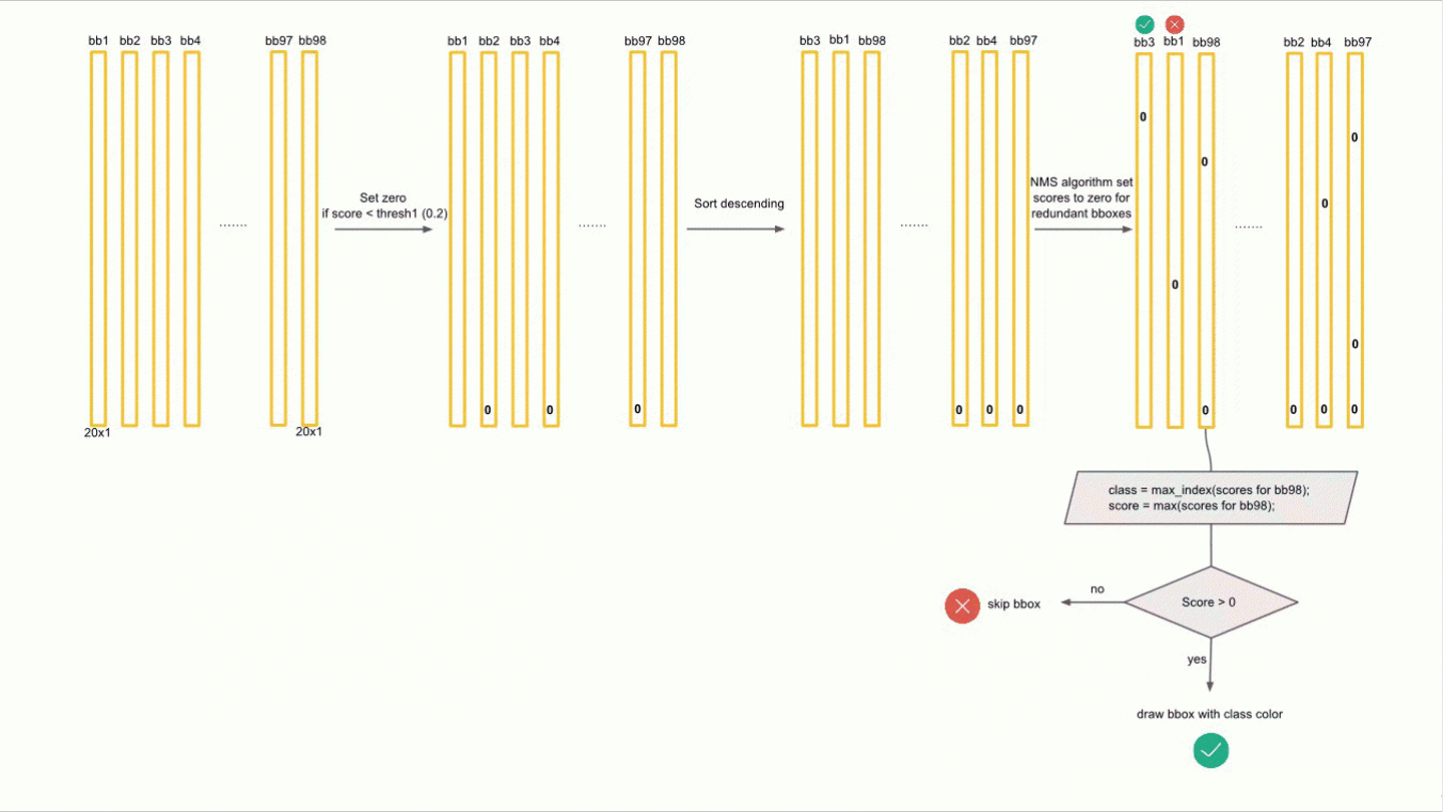
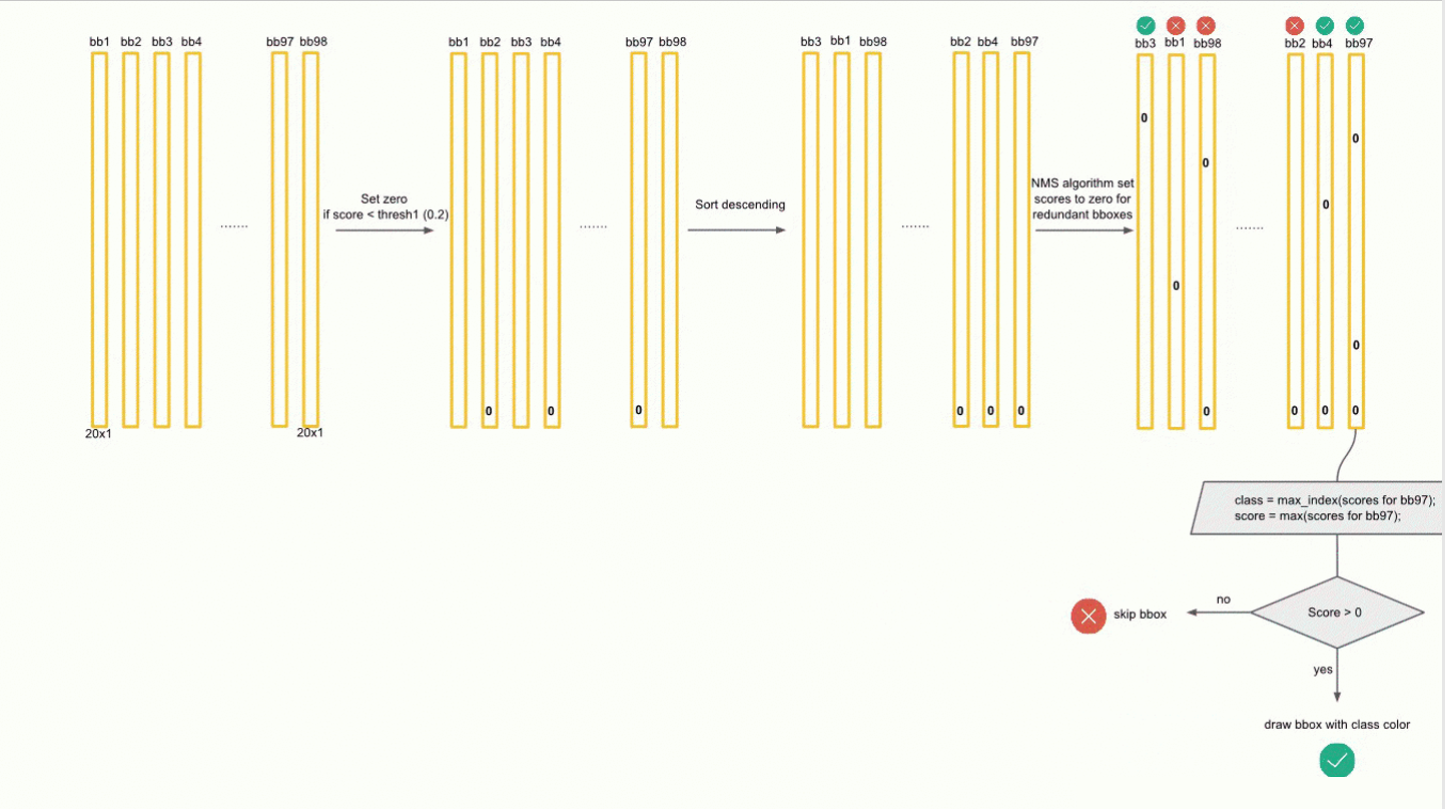
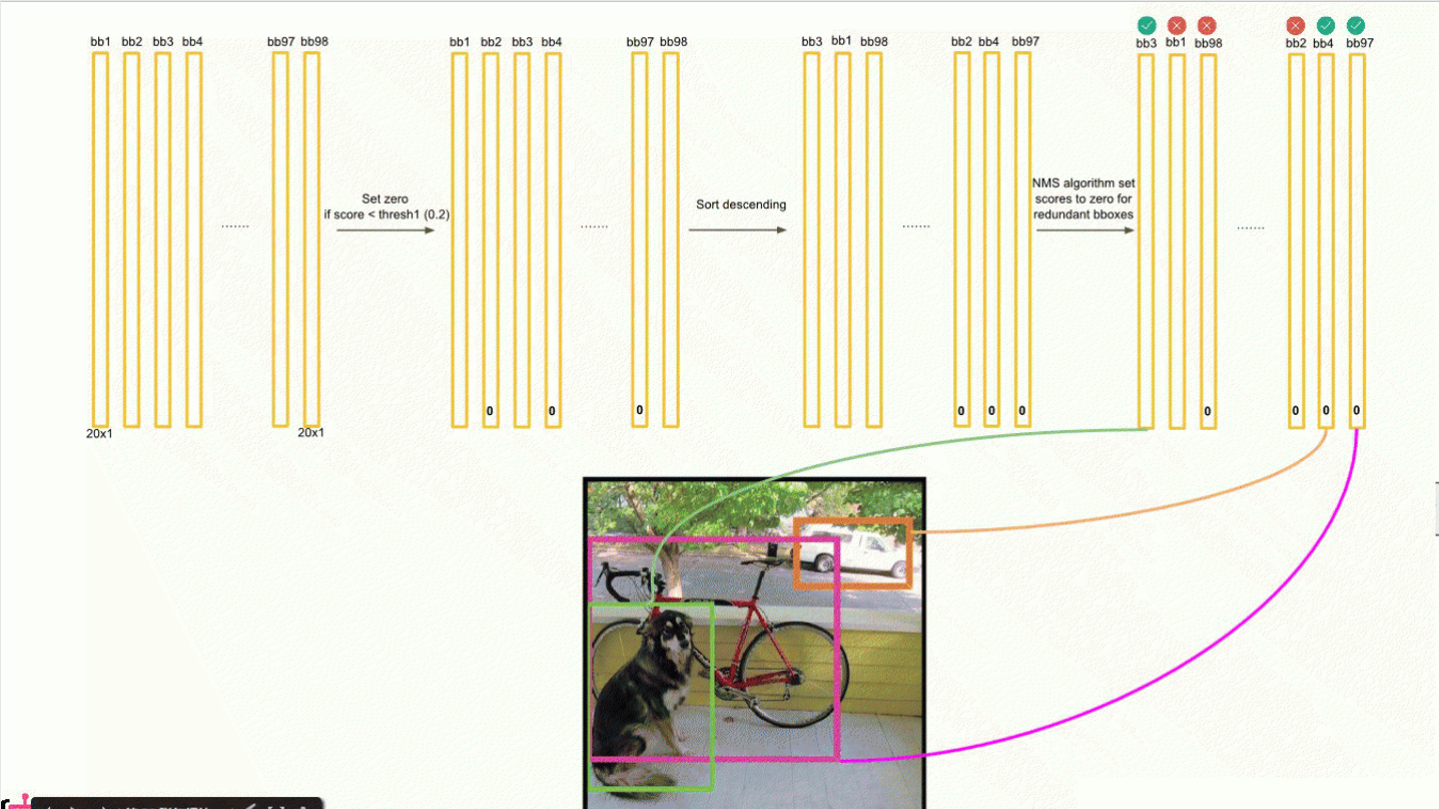
加入20类中,第一类是狗,那么所有98个20x1的向量的第一位就是每一个Bounding boxes是狗的概率, 这些概率有大有小,设置阈值0.2,让所有小于0.2的都置为0,然后按照狗的概率的高低进行排序,将高 概率的置于前面,然后将排序后的结果进行NMS,如下图所示。
NMS怎么做
计算概率最大的Bounding box与其余低概率的每一个Bounding box的IoU,当两者IoU大于0.5,那么就 将低概率的Bounding box的概率设置为0,因为预测是同一只狗。
If loU(bbox_max, bbox_cur) > 0.5 then set 0 score to bbox_cur。
1. 橙色框为bbox_max,与绿色框bbox_cur进行计算,IoU大于0.5,那么就把绿色框的概率置为0。如下 图。

2. 橙色框与蓝色框进行计算,IoU小于0.5,那么就把蓝色框保留。
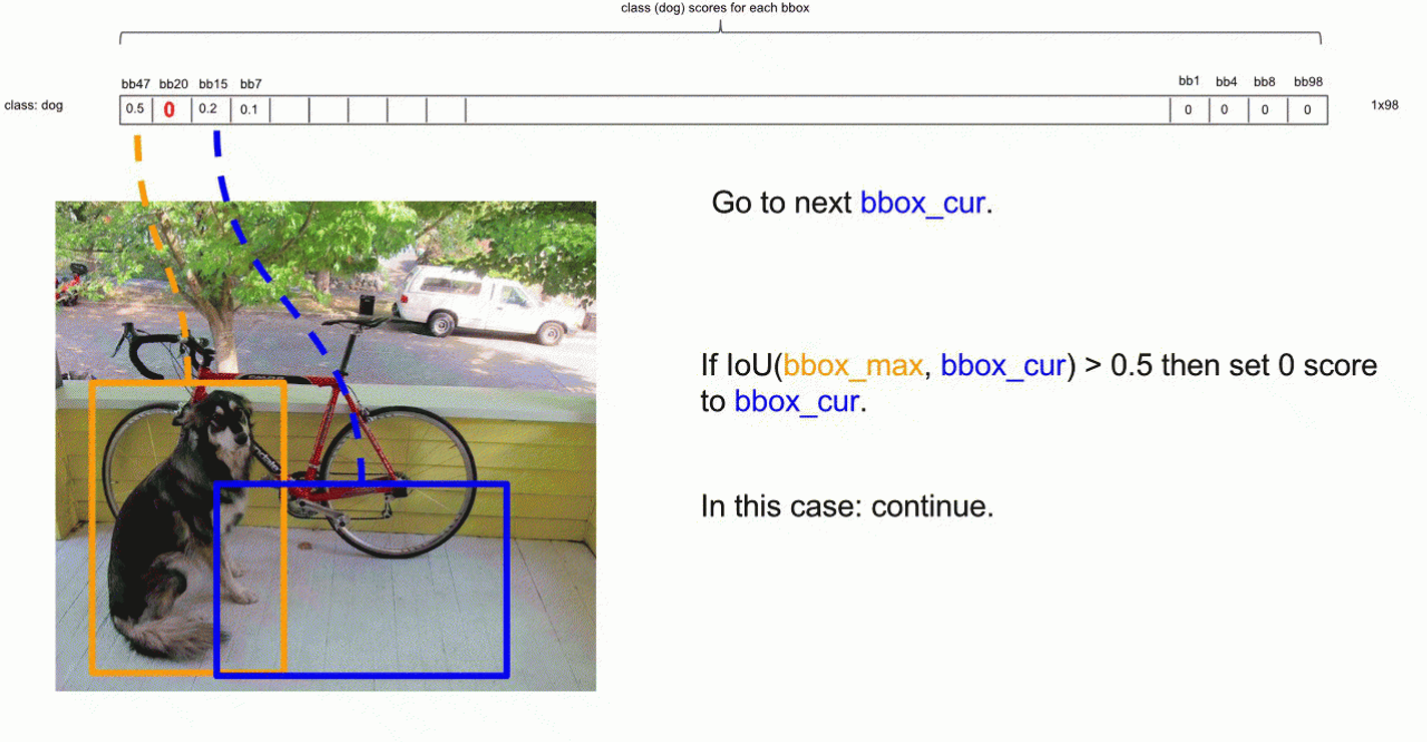
3. 橙色框与紫色框进行计算,IoU小于0.5,那么就把紫色框保留。
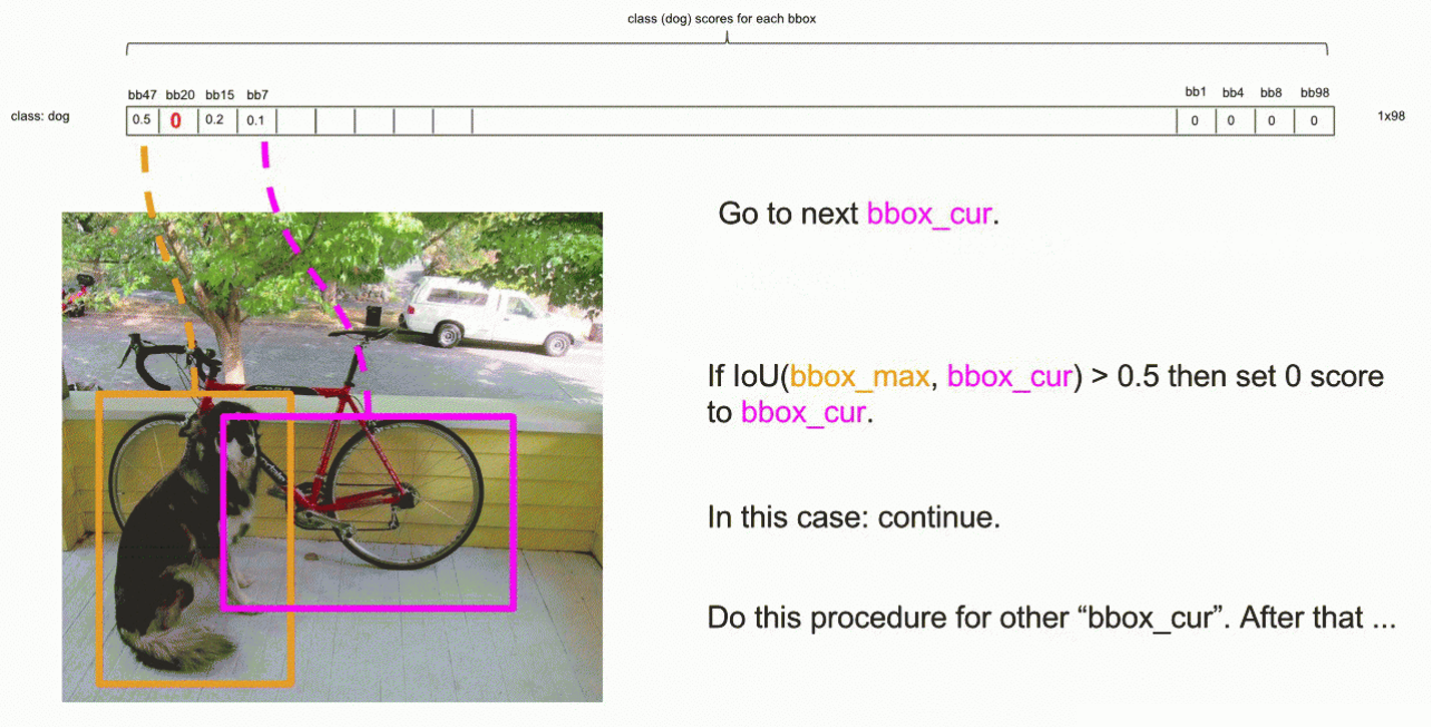
4. 接下来bbox_max是蓝色框,那么蓝色框与紫色框进行计算,IoU大于0.5,那么就把紫色框置为0。

全部跑一遍之后,得到下图结果,那么就得到狗的Bounding box。
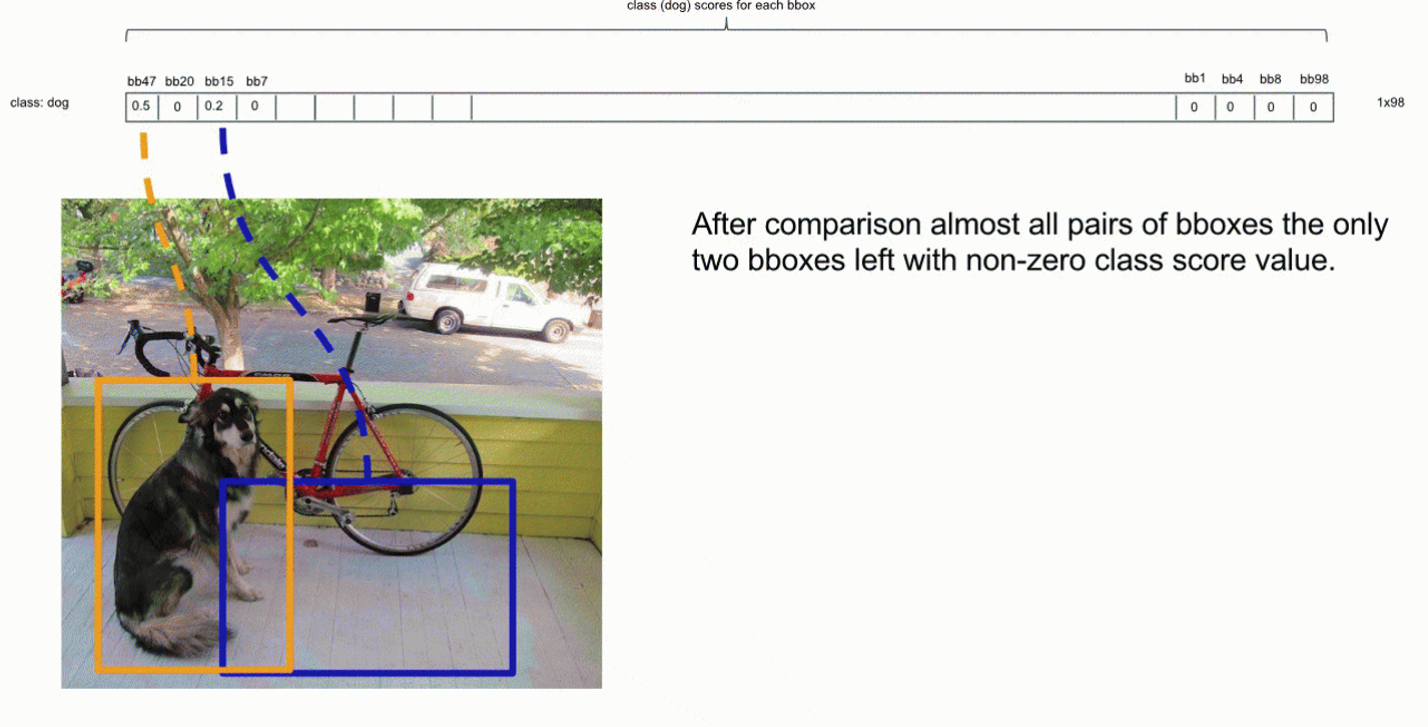
最终俩框都会被输出和显示,这时就可以控制概率来确认谁会显示,谁不会显示。
3.5、获取Object Detect 结果


四、损失函数
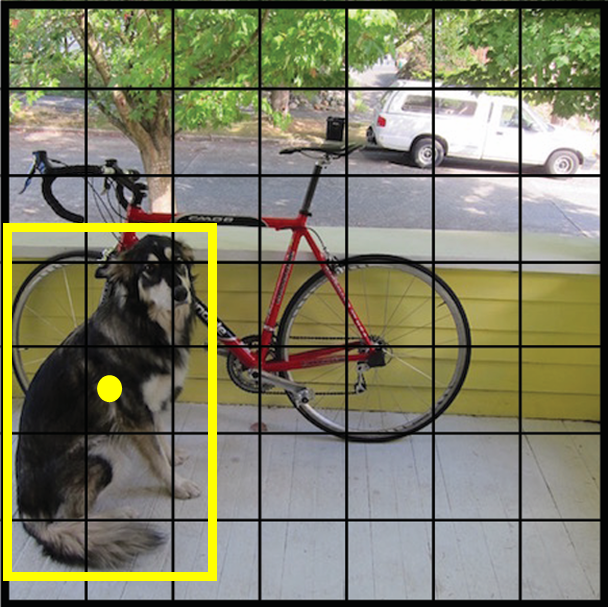
GT BOX的中心点所处的grid cell,该grid cell对应预测的Bounding box去拟合对应的GT BOX,同时该 grid cell输出的类别应该是GT BOX标注时的真实类别,所以每个grid cell只能预测出一个物体,49个grid cell只能预测49个物体。
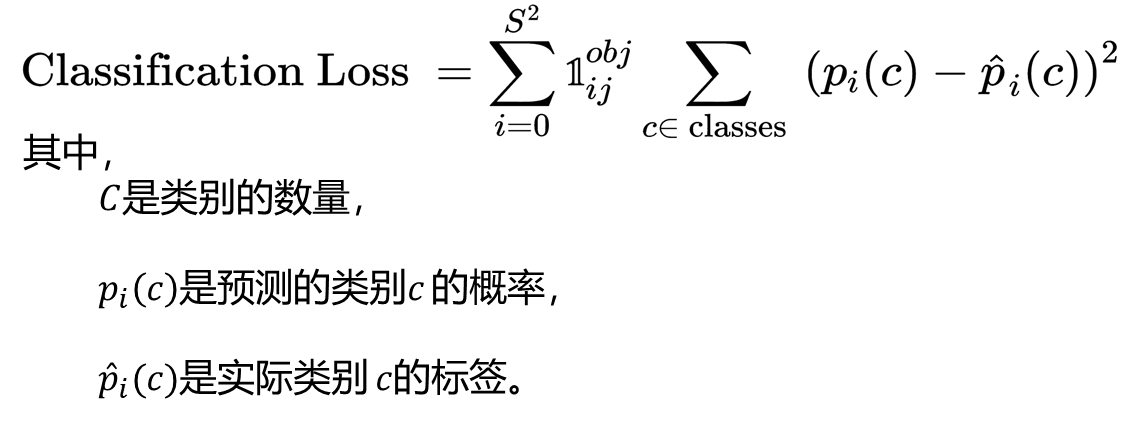
损失函数主要包括三部分:定位损失(Localization Loss)、Confidence 回归损失(Confidence Regression Loss)、分类损失(Classification Loss)。整体损失函数是这三部分的加权和。
4.1、定位损失
YOLOv1使用均方差损失(Mean Squared Error, MSE)来衡量预测框(bounding box)的位置精 度。对于每个预测框,均方差损失计算预测框的中心点坐标和宽高的预测值与真实标签之间的差异。 具体来说,对于每个边界框(bounding box),预测其中心坐标 ((x, y)),宽度 (w) 和高度 (h),与实 际标签的差异。
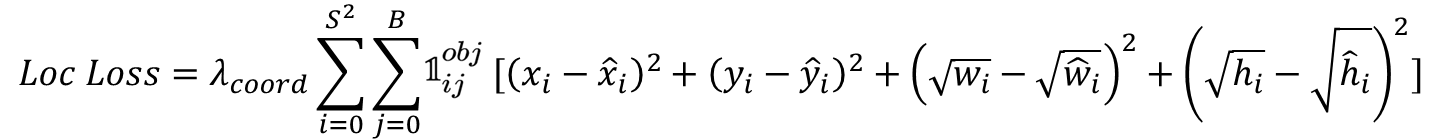
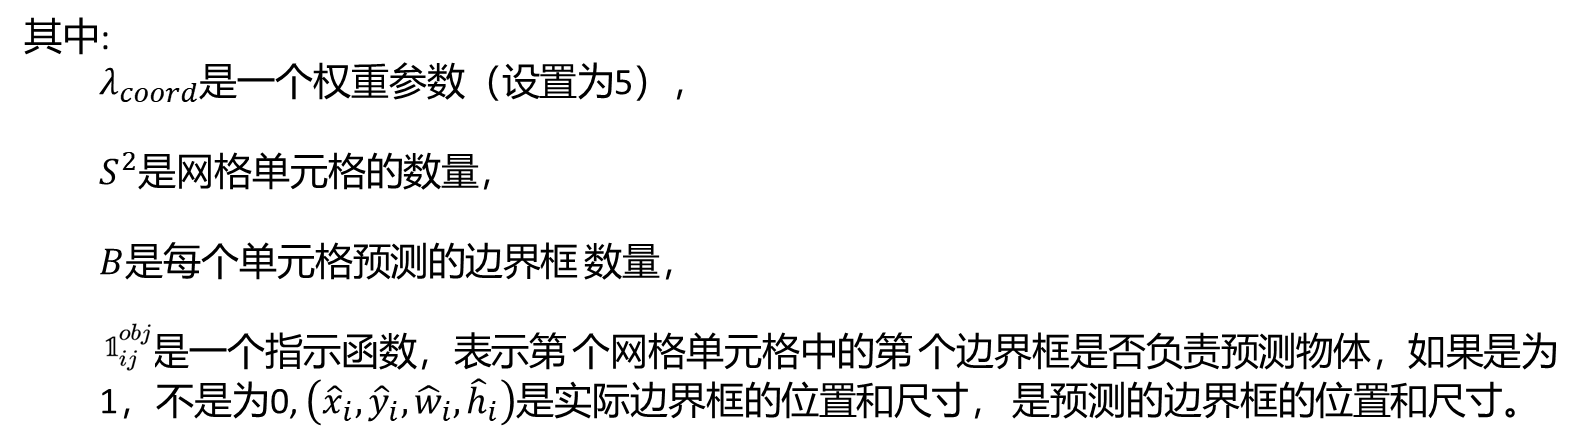
开方的目的:小目标与大目标对应的检测框会存在差异,并消除这个差异,不开根号时,损失函数往 往更倾向于调整尺寸比较大的检测框。例如10个像素的偏差,对于宽为900x900的检测框几乎没有影 响,但是对于20x20的检测框影响就很大了,900开方后就得到30,影响变大了。
4.2、回归损失
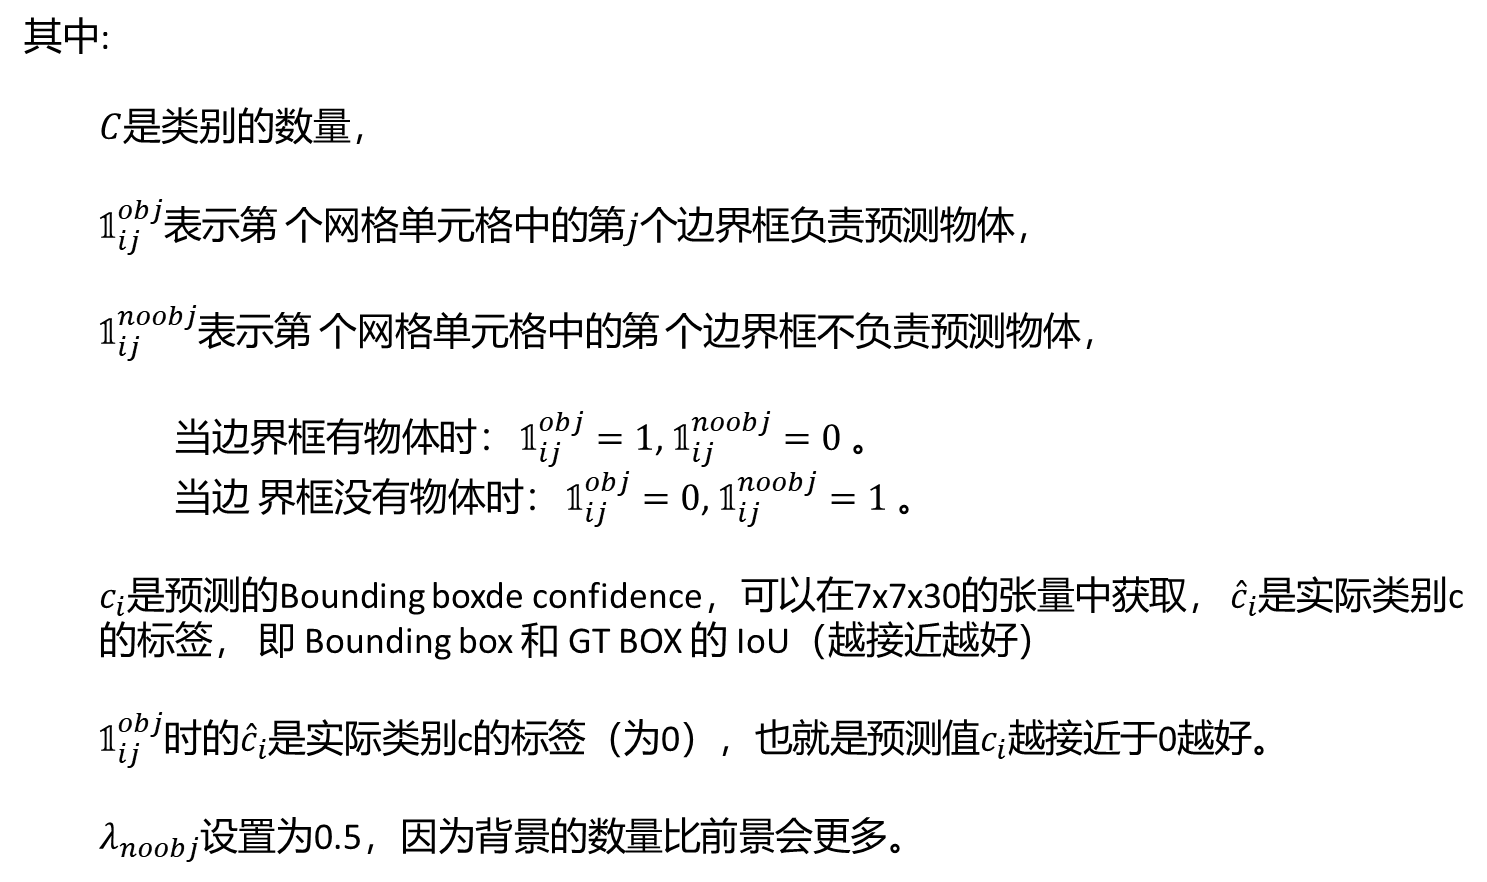
使用回归的思想来计算Bounding box的置信度的误差。
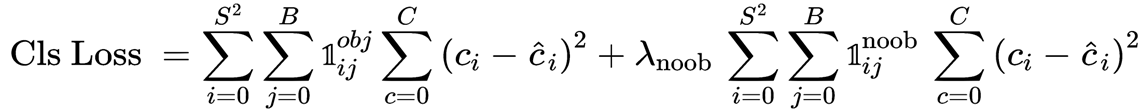
4.3、分类损失
五、总结
YOLOv1的整体结构可以分为三个主要部分:输入处理(Input)、骨干网络(Backbone)、和检测头 (Head)。
YOLOv1(You Only Look Once version 1)的整体结构可以分为三个主要部分:输入处理(Input)、骨干网络(Backbone)、和检测头(Head)。每个部分都在整个目标检测流程中扮演着重要的角色。
5.1、输入处理
输入处理阶段主要负责将原始图像转换为模型可以处理的格式。YOLOv1要求输入图像是固定大小的,通 常是 (448 x 448) 像素。因此,输入处理的步骤包括:
图像预处理:通常是将原始图像缩放到固定大小,并进行归一化(例如将像素值从 [0, 255] 缩放到 [0, 1] 或 [-1, 1])。
输入编码:将预处理后的图像转换为模型所需的张量形式,以便进行后续的计算和处理。
5.2、骨干网络
骨干网络是YOLOv1中的特征提取器,它负责从输入图像中提取高级语义特征,以便后续用于目标检测任 务。
经过之前的RCNN系列的学习以及SSD的学习,可以发现骨干网络的使用历史其实就是AI在计算机视觉的 发展史,从Alexnet到VGGNet到ResNet,并经过不断地迭代升级,使得网络更加准确和快速。
5.3、检测头
检测头是YOLOv1中负责生成和调整边界框(bounding box)以及预测类别的部分。它位于骨干网络的顶 部,接收来自骨干网络的特征图,并在此基础上进行目标检测的相关计算。
YOLO系列“简洁美”的思想,与two-stage检测算法相比,YOLO取消了RPN模块,设计了特征提取网络 Backbone+检测头Head的end-to-end整体逻辑,其对工程的友好特性让工业界顿时开满“YOLO花”,并且 YOLO的结构导致迁移价值和迭代价值都很大,更加便于发展出后续的更多的版本。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 11
 0
- 0


 已为社区贡献71条内容

所有评论(0)