MMKB-RAG: 一个多模态知识型检索增强生成框架
领子涵
北京大学
中国
lingzihan@stu.pku.edu.cn
安一
北京大学
中国
anyi@stu.pku.edu.cn
郭志尧
阿里巴巴集团
中国
guozhiyao45@gmail.com
肖帅
阿里巴巴集团
中国
shuai.xsh@gmail.com
黄逸轩
阿里巴巴集团
中国
huangyixuan@sjtu.edu.cn
兰金松
阿里巴巴集团
中国
jinsonglan.ljs@taobao.com
摘要
大型语言模型(LLMs)和多模态LLMs的最新进展令人瞩目。然而,这些模型仍然仅依赖于其参数化知识,这限制了它们生成最新信息的能力,并增加了产生错误内容的风险。检索增强生成(RAG)通过结合外部数据源部分缓解了这些问题,但对数据库和检索系统的依赖可能会引入无关或不准确的文档,从而削弱性能和推理质量。在本文中,我们提出了多模态知识型检索增强生成(MMKB-RAG),这是一种新颖的多模态RAG框架,它利用模型的知识边界动态生成用于检索过程的语义标签。该策略实现了检索文档的联合过滤,仅保留最相关和准确的参考文献。在基于知识的视觉问答任务上的广泛实验表明了我们方法的有效性:在E-VQA数据集上,我们的方法在单跳子集上的性能提高了+4.2%,在完整数据集上提高了+0.4%;而在InfoSeek数据集上,它分别在未见问题子集、未见实体子集和完整数据集上实现了+7.8%、+8.2%和+8.1%的提升。这些结果突显了我们在当前最先进的MLLM和RAG框架上的显著改进。
1 引言
大型语言模型(LLMs)和多模态大型语言模型(MLLMs)的快速发展彻底改变了自然语言处理和视觉推理任务。这些模型经过大量数据集的训练,在利用内在参数化知识生成连贯且上下文适当的回答方面表现出色。然而,一个根本性的挑战依然存在:对静态参数化知识(即预训练期间获得的知识)的依赖往往会导致错误或幻觉,特别是在需要精确、领域特定或实时信息的复杂查询时[23]。例如,
郑博
阿里巴巴集团
中国
bozheng@alibaba-inc.com

图1:示例说明RAG可能检索到无关和冗余的文档,导致不正确的结果。我们的方法利用MLLM的知识边界过滤参考文献,保留生成准确答案所需的关键证据。
在基于知识的视觉问答(VQA)任务中,如百科全书式VQA(E-VQA)[21]和InfoSeek [5],即使是最先进的MLLM也难以生成准确的答案,因为它们缺乏有效检索和整合外部知识的能力。这一缺陷凸显了当前MLLM架构中的关键差距:需要能够动态可靠地访问外部知识源的机制。
为了克服静态参数化知识的局限性,研究人员开发了检索增强生成(RAG)框架,使模型能够在推理过程中结合最新的相关信息。这些框架可以大致分为检索侧机制和生成侧机制。在检索侧,现有方法主要集中在将视觉和文本模态与外部知识源对齐。CLIP-based架构利用对比图像-文本编码器建立图像-问题对和知识条目之间的粗粒度对齐,而DPR-based架构[15, 16]通过引入细粒度特征增强了精度。例如,Wiki-LLaVA [4]采用CLIP-based多阶段检索管道以提高对齐效果,而RoRA-VLM [22]则利用对抗训练技术增强对无关内容的鲁棒性。尽管取得了这些进展,实现视觉和文本信息之间的细粒度对齐仍然具有挑战性,通常导致次优的检索结果。
在生成侧,研究人员试图通过使MLLM自主评估检索内容的相关性和准确性来改进RAG系统。例如,ReflectiVA [7]使用专用标记引导检索过程,而EchoSight [31]则通过微调重排序模块过滤掉噪声或无关文档。然而,这些自我评估策略通常依赖于外部注释管道或辅助模型,可能无法完全捕捉MLLM的内在知识边界。这一观察结果突显了对集成框架的需求,该框架可以利用MLLM的内在知识动态指导检索和过滤过程。
针对上述问题,我们提出了一种名为多模态知识型检索增强生成(MMKB-RAG)的新框架。与传统仅依赖外部检索策略的RAG系统不同,MMKB-RAG利用目标MLLM的内在知识边界动态生成专门标记以过滤检索到的文档。通过其内生注释系统,MLLM自主确定何时需要检索并验证检索知识的一致性和相关性,所有这些都基于其自身的内在知识限制。MMKB-RAG的关键创新在于其通过从外生、辅助模型依赖的注释管道过渡到内生、能力感知系统,弥合参数化知识和检索知识之间的差距,解决了多模态检索和自我评估方法的不足。
总体而言,本文的主要贡献如下:
- 标记系统框架:MMKB-RAG引入了三阶段流程以确定检索必要性、评估单个文档的相关性并验证多个文档之间的一致性,确保准确和稳健的推理。
-
- 内部知识利用:通过利用MLLM的内在知识及其与数据集的交互,MMKB-RAG自主定义知识边界并引导检索,无需依赖外部注释。
-
- 优越性能:MMKB-RAG在基于知识的VQA任务中超越了最先进的模型,特别是在处理细粒度事实查询和复杂的多模态推理挑战时表现尤为突出。
2 相关工作
多模态LLM。大规模语言模型(LLMs)[9,11,32]的出现催化了多模态LLMs(MLLMs)[6,18,30]的显著进步,使其具备基本的视觉理解和常识推理能力。值得注意的是,诸如LLaVA [18]、Qwen-VL[30]和InternVL[6]等实现已在标准视觉问答(VQA)基准测试中表现出强大的性能。
基于知识的VQA。基于知识的VQA任务要求MLLM通过利用外部知识源整合超出视觉内容的信息。早期基准如KVQA[26]、OK-VQA[20]和A-OKVQA[25]主要关注常识推理,这是大规模预训练MLLM表现良好的领域,得益于其隐含的知识表示。最近的数据集如E-VQA [21]和InfoSeek [5]已推动该领域向维基百科规模的知识整合发展,需要全面理解特定的维基百科实体和细粒度细节。尽管这些基准展示了当前系统的上限,即使是最先进的MLLM在处理详细事实查询时仍受到其参数密集型架构的限制。这种根本限制经常导致生成幻觉内容[19, 24, 29]。
RAG框架[12]通过在推理过程中动态整合外部知识解决了这些限制。通过采用多阶段推理管道将参数化知识与检索信息合并,RAG架构在缓解这些内在约束方面展现出相当大的潜力。
高级RAG。在RAG范式中,多模态检索机制通常采用两种主要策略:1) CLIP-based架构利用对比图像-文本编码器[27]建立图像-问题对与知识条目之间的粗粒度对齐;2) DPR-based架构[15, 16]引入细粒度视觉特征(例如感兴趣区域)以增强检索精度。随后,检索到的条目被整合到MLLM作为上下文参考。
最近,Wiki-LLaVA[4]通过CLIP-based多阶段检索过程整合知识,而RoRA-VLM[22]则通过查询导向的视觉标记修剪采用对抗训练以提高对无关检索内容的鲁棒性。同时,EchoSight[31]通过微调Q-Former引入多模态重排序模块。尽管现有方法主要集中在优化多模态检索,但它们忽视了MLLM在自我评估知识边界方面的内在作用。
受自RAG[2]启发,我们提出了MMKB-RAG框架,其中MLLM自主生成专门标记以确定是否需要检索并验证检索知识的一致性和相关性。尽管最近的工作ReflectiVA[7]实施了类似的专门标记机制,但其注释管道根本上不同,因为它利用不同的MLLM,从而忽视了目标模型的知识限制。相比之下,我们的框架建立了内生、知识边界感知的注释系统,直接将标签生成与目标模型对齐。这种从外生、模型依赖的注释过程到内生、能力感知的标记方法的范式转变带来了显著的性能提升。
3 提出的方法
在基于知识的视觉问答(VQA)中,系统处理图像-问题对 (I,Q)(I, Q)(I,Q) 并利用外部知识生成准确的回答。传统的多模态检索增强生成(MMRAG)方法检索
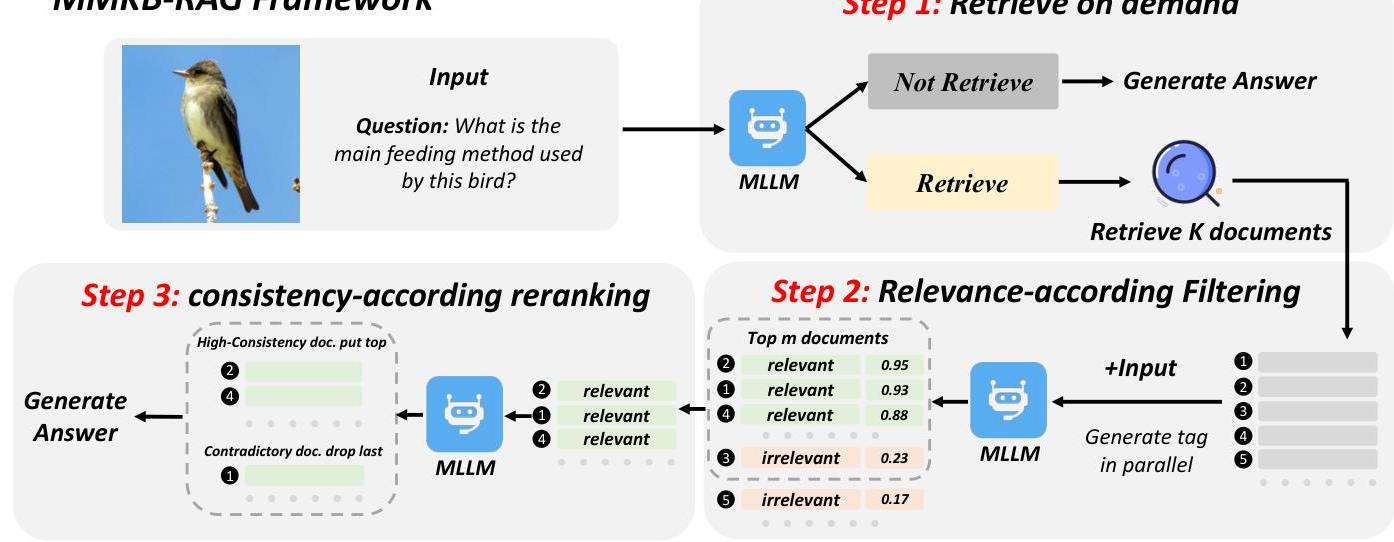
图2:MMKB-RAG流水线。给定输入查询后,MMKB-RAG最初评估检索必要性。对于依赖检索的查询,我们采用两阶段过滤过程(步骤2和3),以确保只保留高质量的参考文档。然后将此精心策划的上下文提供给MLLM以生成全面和准确的回答。
从知识库中检索相关文档以支持答案生成,公式为:
yntn=argmaxyMLLM(y∣l,Q,Dk,Pinqa ) y_{\mathrm{ntn}}=\underset{y}{\arg \max } \operatorname{MLLM}(y \mid l, Q, D_{k}, P_{\text {inqa }}) yntn=yargmaxMLLM(y∣l,Q,Dk,Pinqa )
其中 Dk={d1,d2,…,dk}D_{k}=\left\{d_{1}, d_{2}, \ldots, d_{k}\right\}Dk={d1,d2,…,dk} 表示由检索器 RRR 根据图像-问题对 (I,Q)(I, Q)(I,Q) 检索出的前 kkk 篇文档集合,Pinqa P_{\text {inqa }}Pinqa 表示为视觉问答设计的提示模板。
如图2所示,我们提出的MMKB-RAG(多模态知识型检索增强生成)通过三项关键创新扩展了传统MMRAG框架:(1) 利用模型的内部知识确定何时需要外部检索,提高效率;(2) 根据输入查询的相关性动态重新排名检索到的文档;(3) 使用一致性检查过滤掉不一致的信息,从而提高回答的可靠性和准确性。在接下来的部分中,我们将详细介绍我们的方法:第3.1节介绍MMKB-RAG使用的标记系统,第3.2节描述模型的训练方法。
3.1 MMKB-RAG的标记系统
检索标记(RET)。给定输入对 (I,Q)(I, Q)(I,Q),其中 III 表示图像,QQQ 表示问题文本,我们将输入分类为两类:(1) MLLM可以使用内部知识回答的问题,表示为[NoRet];(2) 需要外部知识检索才能准确回答的问题,表示为[Ret]。对于标记为[Ret]的输入,检索 RRR 获取前 NNN 最相关的文档,允许MLLM结合外部知识以更准确地回答;对于[NoRet]输入,MLLM直接生成答案,从而优化计算效率。微调的MLLM使用指定的提示 PRETP_{R E T}PRET 预测这些标记。
RET=MLLMft(I,Q,PRET) R E T=\operatorname{MLLM}_{f t}\left(I, Q, P_{R E T}\right) RET=MLLMft(I,Q,PRET)
我们从第一个生成的标记中提取对应于[Ret]和[NoRet]的logits,并应用softmax函数将其转换为归一化的概率得分。然后使用超参数 γ\gammaγ 调节最终预测的类别。通过改变 γ\gammaγ,我们可以控制模型执行检索操作的倾向。通常,γ\gammaγ 设置为0.5 。
RET={[Ret], if ScoreRET>γ[NoRet], otherwise Score RET=exp(zRet)exp(zRet)+exp(zNoRet) \begin{aligned} & R E T=\left\{\begin{array}{lc} {[R e t],} & \text { if } \operatorname{Score}_{R E T}>\gamma \\ {[N o R e t],} & \text { otherwise } \end{array}\right. \\ & \text { Score }_{R E T}=\frac{\exp \left(z_{R e t}\right)}{\exp \left(z_{R e t}\right)+\exp \left(z_{N o R e t}\right)} \end{aligned} RET={[Ret],[NoRet], if ScoreRET>γ otherwise Score RET=exp(zRet)+exp(zNoRet)exp(zRet)
单相关标记重排(SRT)。对于分类为[Ret]的输入,初始检索的文档 DkD_{k}Dk 仅基于嵌入相似性分数选择。然而,这可能无法与MLLM的内部知识最佳对齐,潜在地引入无关或矛盾的信息。我们建议利用MLLM的内部知识能力进行相关性判断。为此,我们引入[Rel]和[NoRel]标记,使MLLM通过专用提示 PSRTP_{S R T}PSRT 评估每个候选文档。对于给定的对 (I, Q),第 iii 个文档 did_{i}di 的预测公式如下:
SRTi=MLLMft(I,Q,di,PSRT) S R T^{i}=\operatorname{MLLM}_{f t}\left(I, Q, d_{i}, P_{S R T}\right) SRTi=MLLMft(I,Q,di,PSRT)
类似于前一节,我们计算文档 did_{i}di 的第一个标记的softmax概率,其中 zRelz_{R e l}zRel 对应于[Rel],zNoRelz_{N o R e l}zNoRel 对应于[NoRel]。我们根据[Rel]的概率对所有 kkk 检索到的文档重新排序,并选择前 KSRTK_{S R T}KSRT 个文档作为最终结果,其中 kSRT≤kk_{S R T} \leq kkSRT≤k。这个过程可以公式化为:
DkSRT={di∣i∈argTopkSRT{ScoreSRTi∣j∈[1,k]}} Score SRTi=exp(zReli)exp(zReli)+exp(zNoReli)
\begin{gathered}
D_{k_{S R T}}=\left\{d_{i} \mid i \in \arg \operatorname{Top} k_{S R T}\left\{\operatorname{Score}_{S R T}^{i} \mid j \in[1, k]\right\}\right\} \\
\text { Score }_{S R T}^{i}=\frac{\exp \left(z_{R e l}^{i}\right)}{\exp \left(z_{R e l}^{i}\right)+\exp \left(z_{N o R e l}^{i}\right)}
\end{gathered}
DkSRT={di∣i∈argTopkSRT{ScoreSRTi∣j∈[1,k]}} Score SRTi=exp(zReli)+exp(zNoReli)exp(zReli)
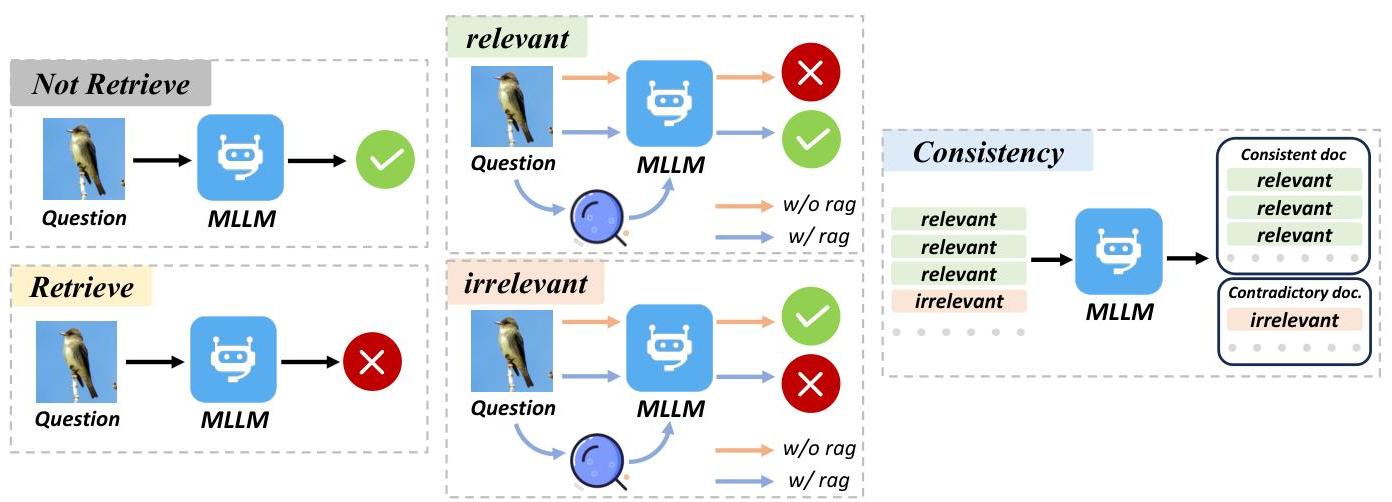
图3:标记系统的训练策略。RET根据模型的回答准确性确定是否调用检索机制;SRT通过评估模型在使用这些文档作为上下文时的表现来评估参考文本的质量;CST统一评估所有检索到的文档,以提供一致的参考文档。
多一致性过滤(MCT)。通过[Rel]标记检索出 DkSRTD_{k_{S R T}}DkSRT 文档后,需要注意的是,此标记单独评估每个文档相对于输入的相关性。然而,这种逐文档评估可能导致全局上下文缺失,或者收集到的文档虽然单独相关,但整体并不连贯。为了解决这些缺点,我们引入了一致性检查,从整体视角检查 DkSRTD_{k_{S R T}}DkSRT,以过滤掉不一致的内容,组装更可靠的参考集。具体来说,我们使用微调的MLLM和专用提示 PCSTP_{C S T}PCST。这个过程将集合精炼为 kCSTk_{C S T}kCST 文档的子集,为MLLM提供稳健的外部知识。
DkCST=MLLMft(DkSRT,PCST) D_{k_{C S T}}=\operatorname{MLLM}_{\mathrm{ft}}\left(D_{k_{S R T}}, P_{C S T}\right) DkCST=MLLMft(DkSRT,PCST)
通过标记系统获取外部知识 DkCSTD_{k_{C S T}}DkCST 后,我们可以基于此参考知识生成答案,类似于标准的MMRAG方法。标记系统的引入显著增强了检索知识的相关性和准确性,从而使MLLM能够生成更精确和可靠的答案。这个过程可以总结如下:
yatn =argmaxyMLLM(y∣I,Q,DkCST,Poqa ) y_{\text {atn }}=\underset{y}{\arg \max } \operatorname{MLLM}(y \mid I, Q, D_{k_{C S T}}, P_{\text {oqa }}) yatn =yargmaxMLLM(y∣I,Q,DkCST,Poqa )
3.2 带标记系统的训练
在前一节中,我们介绍了三种不同的标记来过滤检索到的文档,显著增强了参考材料的相关性和准确性,从而提高了MLLM的回答质量。我们的方法代表了与现有方法[2, 7]的重大偏离,后者依赖于外部注释管道或辅助模型。如图3所示,主要创新在于我们的知识边界感知范式,所有标记决策明确源自目标MLLM的内在知识范围和限制。这种自包含框架确保标记决策通过模型的自我评估机制而非外部监督产生,从而实现与模型认识边界的精确对齐。
RET。考虑到MLLM在处理VQA任务中的能力,可以观察到这些模型本身拥有大量的知识。这种内在知识使它们能够准确回答问题而无需任何外部信息检索。我们的方法独特地利用了MLLM自身现有的知识边界,以确定每个查询是否需要外部检索。
详细的算法过程如算法1所示,该算法初始化一个空数据集,并基于模型正确回答查询的能力构建训练数据集。对于正确回答的查询,我们将其标记为[Ret],因为模型的内在知识足够。相反,错误回答的查询被标记为[NoRet],表明由于知识缺口或幻觉需要检索。在数据收集之后,我们使用提示 PRETP_{R E T}PRET 微调MLLM,使其能够确定目标MLLM在给定查询下是否需要检索支持。
SRT。传统的RAG系统通常使用基于嵌入的方法检索与输入查询语义最相关的参考文档。然而,这种方法存在几个限制:(1) 仅语义相似性不能保证检索到的文档有助于正确回答问题,(2) 检索过程独立于下游MLLM,可能引入干扰内容,从而影响回答准确性。为克服这些限制,我们提出了一种新的以模型为中心的检索范式,通过目标MLLM本身的视角进行相关性评估,明确评估每个候选文档支持准确回答生成的能力。
如算法2所述,我们为训练相关性评估MLLM引入了一种新的数据收集策略。我们的方法将相关文档定义为将错误答案转化为正确答案的文档,而无关文档则是破坏
算法1 RET的数据构造
输入: 图像-问题对 ({(I1,Q1),(I2,Q2),…,(IN,QN)})(\left\{\left(I_{1}, Q_{1}\right),\left(I_{2}, Q_{2}\right), \ldots,\left(I_{N}, Q_{N}\right)\right\})({(I1,Q1),(I2,Q2),…,(IN,QN)}),目标
MLLM
输出: RET训练数据集 (DRET)(D_{\mathrm{RET}})(DRET)
初始化一个空数据集 (DRET=∅)(D_{\mathrm{RET}}=\emptyset)(DRET=∅)
for (i=1)(i=1)(i=1) to (N)(N)(N) do
将 ((Ii,Qi))(\left(I_{i}, Q_{i}\right))((Ii,Qi)) 输入到MLLM
从MLLM获取推理响应 (Ai)(A_{i})(Ai)
if (Ai)(A_{i})(Ai) 正确 then
设 (RETi=[)(\operatorname{RET}_{i}=[)(RETi=[) Ret (])(])(])
else
设 (RETi=[)(\operatorname{RET}_{i}=[)(RETi=[) NoRet (])(])(])
end if
将 ((Ii,Qi,Ri))(\left(I_{i}, Q_{i}, R_{i}\right))((Ii,Qi,Ri)) 添加到 (DRET)(D_{\mathrm{RET}})(DRET)
end for
返回 (DRET)(D_{\mathrm{RET}})(DRET)
算法2 SRT的数据构造
输入: 图像-问题对 ({(I1,Q1),(I2,Q2),…,(IN,QN)})(\left\{\left(I_{1}, Q_{1}\right),\left(I_{2}, Q_{2}\right), \ldots,\left(I_{N}, Q_{N}\right)\right\})({(I1,Q1),(I2,Q2),…,(IN,QN)}),目标
MLLM,检索器 (R)(R)(R)
输出: SRT训练数据集 (DSRT)(D_{\mathrm{SRT}})(DSRT)
初始化一个空数据集 (DSRT=∅)(D_{\mathrm{SRT}}=\emptyset)(DSRT=∅)
for (m=1)(m=1)(m=1) to (M)(M)(M) do
将 ((Im,Qm))(\left(I_{m}, Q_{m}\right))((Im,Qm)) 输入到MLLM
从MLLM获取推理响应 (Am, direct )(A_{m, \text { direct }})(Am, direct )
使用 (R)(R)(R) 检索前 (K)(K)(K) 最相似的文档 (DKm=)(D_{K}^{m}=)(DKm=)
({d1m,d2m,…,dkm})(\left\{d_{1}^{m}, d_{2}^{m}, \ldots, d_{k}^{m}\right\})({d1m,d2m,…,dkm}) 对于 ((Im,Qm))(\left(I_{m}, Q_{m}\right))((Im,Qm))
for (k=1)(k=1)(k=1) to (K)(K)(K) do
将 ((Im,Qm,dkm))(\left(I_{m}, Q_{m}, d_{k}^{m}\right))((Im,Qm,dkm)) 输入到MLLM
从MLLM获取推理响应 (Am,k)(A_{m, k})(Am,k)
if (Am, direct )(A_{m, \text { direct }})(Am, direct ) 错误且 (Am,k)(A_{m, k})(Am,k) 正确 then
设 (SRTm,k=[Rel])(\operatorname{SRT}_{m, k}=[R e l])(SRTm,k=[Rel])
else if (Am, direct )(A_{m, \text { direct }})(Am, direct ) 正确且 (Am,n)(A_{m, n})(Am,n) 错误 then
设 (SRTm,k=[)(\operatorname{SRT}_{m, k}=[)(SRTm,k=[) NotRel (])(])(])
end if
将 ((Im,Qm,dkm,SRTm,k))(\left(I_{m}, Q_{m}, d_{k}^{m}, S R T_{m, k}\right))((Im,Qm,dkm,SRTm,k)) 添加到 (DSRT)(D_{\mathrm{SRT}})(DSRT)
end for
end for
返回 (DSRT)(D_{\mathrm{SRT}})(DSRT)
最初正确的答案。这种方法创建了自然的对比对,使得通过提示 PSRTP_{S R T}PSRT 对MLLM进行有效的微调,优化其辨别有助于准确回答问题的参考文档的能力。
MCT。传统方法[2,7]仅仅依靠单相关标记只能确定查询与个别参考文档之间的相关性。这种方法无法解决同时使用多个参考文档时可能出现的矛盾、冗余和不一致,最终损害回答的准确性。为解决这一限制,我们提出了多一致性机制,该机制对多个文档进行统一过滤和清理,消除矛盾和其他负面因素,为目标MLLM保留干净、一致和连贯的参考内容,从而提高回答的准确性。
算法3概述了我们从 DSRTD_{S R T}DSRT 构建MCT训练数据的方法。我们首先利用MLLM生成 DSRTD_{S R T}DSRT 的简洁摘要,有效消除冗余信息。
算法3 MCT的数据构造
输入: (DSRT(D_{\mathrm{SRT}}(DSRT, 目标 MLLM, 负样本比例 (τ%)(\tau \%)(τ%)
输出: MCT训练数据集 (DMCT)(D_{M C T})(DMCT)
对每个唯一的 ((Im,Qm))(\left(I_{m}, Q_{m}\right))((Im,Qm)) 在 (DSRT)(D_{\mathrm{SRT}})(DSRT) 中 do
提取文档 (Sm′′={dkm∣SRTm,k=[Rel]})(S_{m}^{\prime \prime}=\left\{d_{k}^{m} \mid S R T_{m, k}=[R e l]\right\})(Sm′′={dkm∣SRTm,k=[Rel]}) 和 (Sm′′={dkm∣)(S_{m}^{\prime \prime}=\left\{d_{k}^{m} \mid\right.)(Sm′′={dkm∣)
KaTeX parse error: Expected '\right', got 'EOF' at end of input: …{SRT}_{m, k}=[) NoRel KaTeX parse error: Expected 'EOF', got '\right' at position 15: (\left.\right]\̲r̲i̲g̲h̲t̲\})
if (∣Sm′′∣>1)(\left|S_{m}^{\prime \prime}\right|>1)(∣Sm′′∣>1) then
应用摘要过程: (Sum=MLLM(Sm′′))(\operatorname{Sum}=M L L M\left(S_{m}^{\prime \prime}\right))(Sum=MLLM(Sm′′))
与无关合并: (Smmix ,Idx=Mix(Sm′′,τ%Sm′′)(S_{m}^{\text {mix }}, I d x=\operatorname{Mix}\left(S_{m}^{\prime \prime}, \tau \%\right. S_{m}^{\prime \prime})(Smmix ,Idx=Mix(Sm′′,τ%Sm′′) )
将 ((Im,Qm,Sum,Smmix ,Idx))(\left(I_{m}, Q_{m}, \operatorname{Sum}, S_{m}^{\text {mix }}, I d x\right))((Im,Qm,Sum,Smmix ,Idx)) 添加到 (DMCT)(D_{M C T})(DMCT)
end if
end for
返回 (DMCT)(D_{M C T})(DMCT)
为了增强对嘈杂参考的鲁棒性,我们有意通过引入 τ%\tau \%τ% 的无关文档 Sm′′′S_{m}^{\prime \prime \prime}Sm′′′ 来污染 Sm′′S_{m}^{\prime \prime}Sm′′,然后识别按[单相关]概率排名的 Sm′′S_{m}^{\prime \prime}Sm′′ 条目索引。这种方法训练模型在混合质量语料库 Smmix S_{m}^{\text {mix }}Smmix 中同时识别高质量文档索引并生成仅来源于这些可靠来源的综合摘要。
4 实验
4.1 数据集
数据集。我们在四个知识密集型VQA基准上评估我们的方法:(1) OKVQA [20] 包含跨多种知识类别的14,000个问题,其中5,000个验证样本用于我们的实验,使用VQA评分指标[1]进行评估;(2) E-VQA [21] 包括221,000个问答对,链接到16,700个细粒度维基百科实体,涉及单跳和双跳推理问题,我们使用5,800个测试样本,使用BEM评分[3]进行评估;(3) InfoSeek [5] 包括130万个图像-问题对,连接到大约11,000个维基百科页面,按照先前工作[31],我们在73,000个验证样本上报告结果,使用官方VQA评分脚本;以及(4) M2KR [16],一个多模态知识检索基准,处理InfoSeek和E-VQA的知识库段落级数据,我们遵循既定协议使用PreFLMR检索器进行与RA-VQA with PreFLMR基线的比较评估。
外部知识库。InfoSeek和E-VQA数据集均由维基百科文档衍生的外部知识库支持。具体来说,E-VQA数据集附带了一个由2百万维基百科页面组成的知识库。每个页面包括维基百科标题、关联的文本段落和相关图像。相比之下,InfoSeek数据集利用了一个更广泛的包含6百万维基百科实体的知识库。在我们的实验中,我们使用完整的2百万文档知识库用于E-VQA。对于InfoSeek,按照最近的研究[4, 31],我们从原始6百万文档语料库中提取了100,000页的子集。这种方法确保了高效的数据处理,同时保留了知识库的质量和覆盖范围。
1{ }^{1}1 InfoSeek使用的知识库包含与[4]相同的实体。
对于OKVQA,我们采用基于伪相关维基百科文档的知识语料库,这些文档由M2KR [16]确定。训练和测试段落语料库包括此知识语料库中的所有段落。OKVQA的评估仅在M2KR数据集上进行。
4.2 实现细节
检索知识。我们的实验特别旨在优化大型模型的知识注入和理解能力,重点关注这些模型如何在检索后处理和理解外部知识源。在我们的实验设计中,我们主要利用了EVA-CLIP-8B[28]进行图像检索。在此实验中,我们选择了图像到图像检索,评估查询图像与嵌入在维基百科文档中的图像之间的相似性以检索相应的维基百科页面。为了与ReflectiVA[7]保持一致,我们将检索到的网页数量设置为5。
模型架构和训练详细信息。我们采用Qwen2-VL-7B-Instruct [30]作为基础模型,该模型集成了675M参数的Vision Transformer(ViT)用于视觉编码和Qwen2-7B语言模型用于文本处理。架构中包含一个MLP连接器,它内在地连接图像标记和语言表示,使有效的多模态信息融合无需外部模块。为了优化计算效率,我们实施了LoRA [10]微调,批次大小为512。
训练数据收集。在我们的研究中,我们使用官方Infoseek和E-VQA训练数据集的子集训练MMKB-RAG。为了优化计算效率,我们随机采样了可用数据的10%10 \%10%用于模型训练。重要的是,我们使用回答模型本身生成微调数据,而不依赖于GPT-4o等外部模型。
MCT类型选择。在实验的MCT阶段,我们实施了三种不同的细化策略:Filter:仅使用由MLLM输出索引的文档,仅保留高质量文档;Merge:仅使用基于高质量文档生成的MLLM摘要;和Re\mathbf{R e}Re rank:优先考虑MLLM识别的高质量文档,同时保留一致性较低但仍可能包含有价值信息的文档。后续章节中提供了验证这些策略有效性的全面消融研究。
4.3 与SOTA的比较
我们在E-VQA和InfoSeek基准上评估了我们的MMKB-RAG方法与最先进的模型的性能,结果见表1。评估分为两类:(1) 无知识注入的零样本MLLM和 (2) 有知识注入的检索增强模型。对于基线比较,我们包括了在目标数据集上训练的Qwen2-VL-7B-Instruct及其微调变体Qwen2-VL-7B-Instruct(SFT)。为了公平比较Wiki-LLaVA,我们使用Contriever检索与查询最相似的前k篇文档。
MMKB-RAG在所有设置中均表现出优异的性能。在零样本场景中,我们的方法优于仅依赖预训练知识而无外部检索机制的BLIP-2和InstructBLIP等模型。在检索增强场景中,尽管Qwen2-VL-7B-Instruct及其微调版本具有相似的架构基础,MMKB-RAG仍显著超越这些模型。这种性能差距突显了我们提出的MMKB-RAG方法在大幅提升回答准确性方面的有效性。
当使用EVA-CLIP检索器进行图像到图像检索时,MMKB-RAG在EchoSight和Reflective等采用类似检索机制的竞争方法上实现了更显著的改进。这些结果表明,即使在类似的标记系统下,我们的方法也能实现卓越的性能。图4提供了不同模型之间的定性比较。
4.4 消融研究与分析
4.4.1 MMKB-RAG标记的有效性。为了评估每个标记的贡献,我们通过逐步启用框架的不同组件进行了消融研究。表2总结了这些结果,其中kkk表示检索到的文档数量。当仅启用RET时,MLLM使用默认设置(k=5)(k=5)(k=5)。相比之下,当启用SRT时,保留并按相关性降序排列相关性分数高于0.5的段落(k=(k=(k=自动)。
我们的实验揭示了每个标记的独特贡献:(1) RET在所有指标上提升了性能,但在引入其他标记时其影响减弱;(2) SRT显著提升了所有评估指标,表明虽然基于嵌入的检索可以识别语义相关的文档,但它无法保证最终答案的准确性;(3) MCT通过消除不一致或冗余的文档进一步优化结果,显著提升了超越SRT单独使用的性能。
最佳性能是在三个标记协同工作时实现的。这确认了MMKB-RAG的协同设计:RET提供基础知识,SRT确保相关性,一致性过滤去除噪声,共同在两个数据集上实现最先进的性能。图5展示了每个标记如何对性能做出贡献。
4.4.2 文档数量的有效性。在本节中,我们研究了文档数量kkk对SRT和MCT策略性能的影响。为了隔离kkk的效果,我们将检索模块始终启用。结果见表3和表4。
SRT。对于E-VQA,k=5k=5k=5达到了峰值性能,表明适度的文档数量有效地平衡了信息完整性和噪声减少。InfoSeek数据集同样偏好k=5k=5k=5,尽管在k=20k=20k=20时性能急剧下降,表明自动选择机制可能无意中丢弃了关键信息。
MCT。在InfoSeek上,基于合并的MCT表现出优越的性能,因为它通过更准确地识别一致的文档和消除冗余信息来强调精确答案。相比之下,基于重排的MCT在
表1:E-VQA测试集和InfoSeek验证集上的VQA准确率评分,其中所有检索增强模型的结果均未考虑任何重新排序阶段来重新排序检索到的网页。粗体表示最先进的,下划线表示第二佳,†\dagger†标记我们的重现结果。灰色表示由于知识库不同而无法直接比较的结果。所有检索增强结果均排除重新排序。
| E-VQA | InfoSeek | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| Model | LLM | Retriever | Feature | Single-Hop | All | Unseen-Q | Unseen-E | All | |
| Zero-shot MLLMs | |||||||||
| BUP-2 [13] | Flan-T5sL | - | - | 12.6 | 12.4 | 12.7 | 12.3 | 12.5 | |
| InstructBUP [8] | Flan-T5sL | - | - | 11.9 | 12.0 | 8.9 | 7.4 | 8.1 | |
| LLaVA-v1.5 [17] | Vicuna-7B | - | - | 16.3 | 16.9 | 9.6 | 9.4 | 9.5 | |
| LLaVA-v1.5 [17] | LLaMA-3.1-8B | - | - | 16.0 | 16.9 | 8.3 | 8.9 | 7.8 | |
| Qwen2-VL-Instruct† [30] | Qwen-2-7B | - | - | 16.4 | 16.4 | 17.9 | 17.8 | 17.9 | |
| Qwen2-VL-Instruct(sft) †\dagger† [30] | Qwen-2-7B | - | - | 25.0 | 23.8 | 22.7 | 20.6 | 21.6 | |
| Retrieval-Augmented Models | |||||||||
| Wiki-LLaVA [4] | Vicuna-7B | CLIP ViT-L/14+Contriever | Textual | 17.7 | 20.3 | 30.1 | 27.8 | 28.9 | |
| Wiki-LLaVA [4] | LLaMA-3.1-8B | CLIP ViT-L/14+Contriever | Textual | 18.3 | 19.6 | 28.6 | 25.7 | 27.1 | |
| EchoSight [31] | Mistral-7B/LLaMA-3-8B | EVA-CLIP-8B | Visual | 19.4 | - | - | - | 27.7 | |
| EchoSight [31] | LLaMA-3.1-8B | EVA-CLIP-8B | Visual | 26.4 | 24.9 | 18.0 | 19.8 | 18.8 | |
| ReflectiVA [7] | LLaMA-3.1-8B | EVA-CLIP-8B | Visual | 35.5 | 35.5 | 28.6 | 28.1 | 28.3 | |
| Qwen2-VL-Instruct† [30] | Qwen-2-7B | EVA-CLIP-8B + Contriever | Visual+Textual | 25.9 | 23.6 | 21.6 | 21.5 | 21.4 | |
| Qwen2-VL-Instruct(sft) †\dagger† [30] | Qwen-2-7B | EVA-CLIP-8B + Contriever | Visual+Textual | 32.6 | 29.9 | 23.3 | 23.8 | 23.------ | |
| 6 | |||||||||
| MMKB-RAG (Ours) | Qwen-2-7B | EVA-CLIP-8B | Visual | 39.7 | 35.9 | 36.4 | 36.3 | 36.4 |
问题
参考论文:https://arxiv.org/pdf/2504.10074

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 10
 0
- 0


 已为社区贡献37条内容

所有评论(0)