VLA 模型:概念、演进、代表工作与挑战
·
VLA 模型:概念、演进、代表工作与挑战
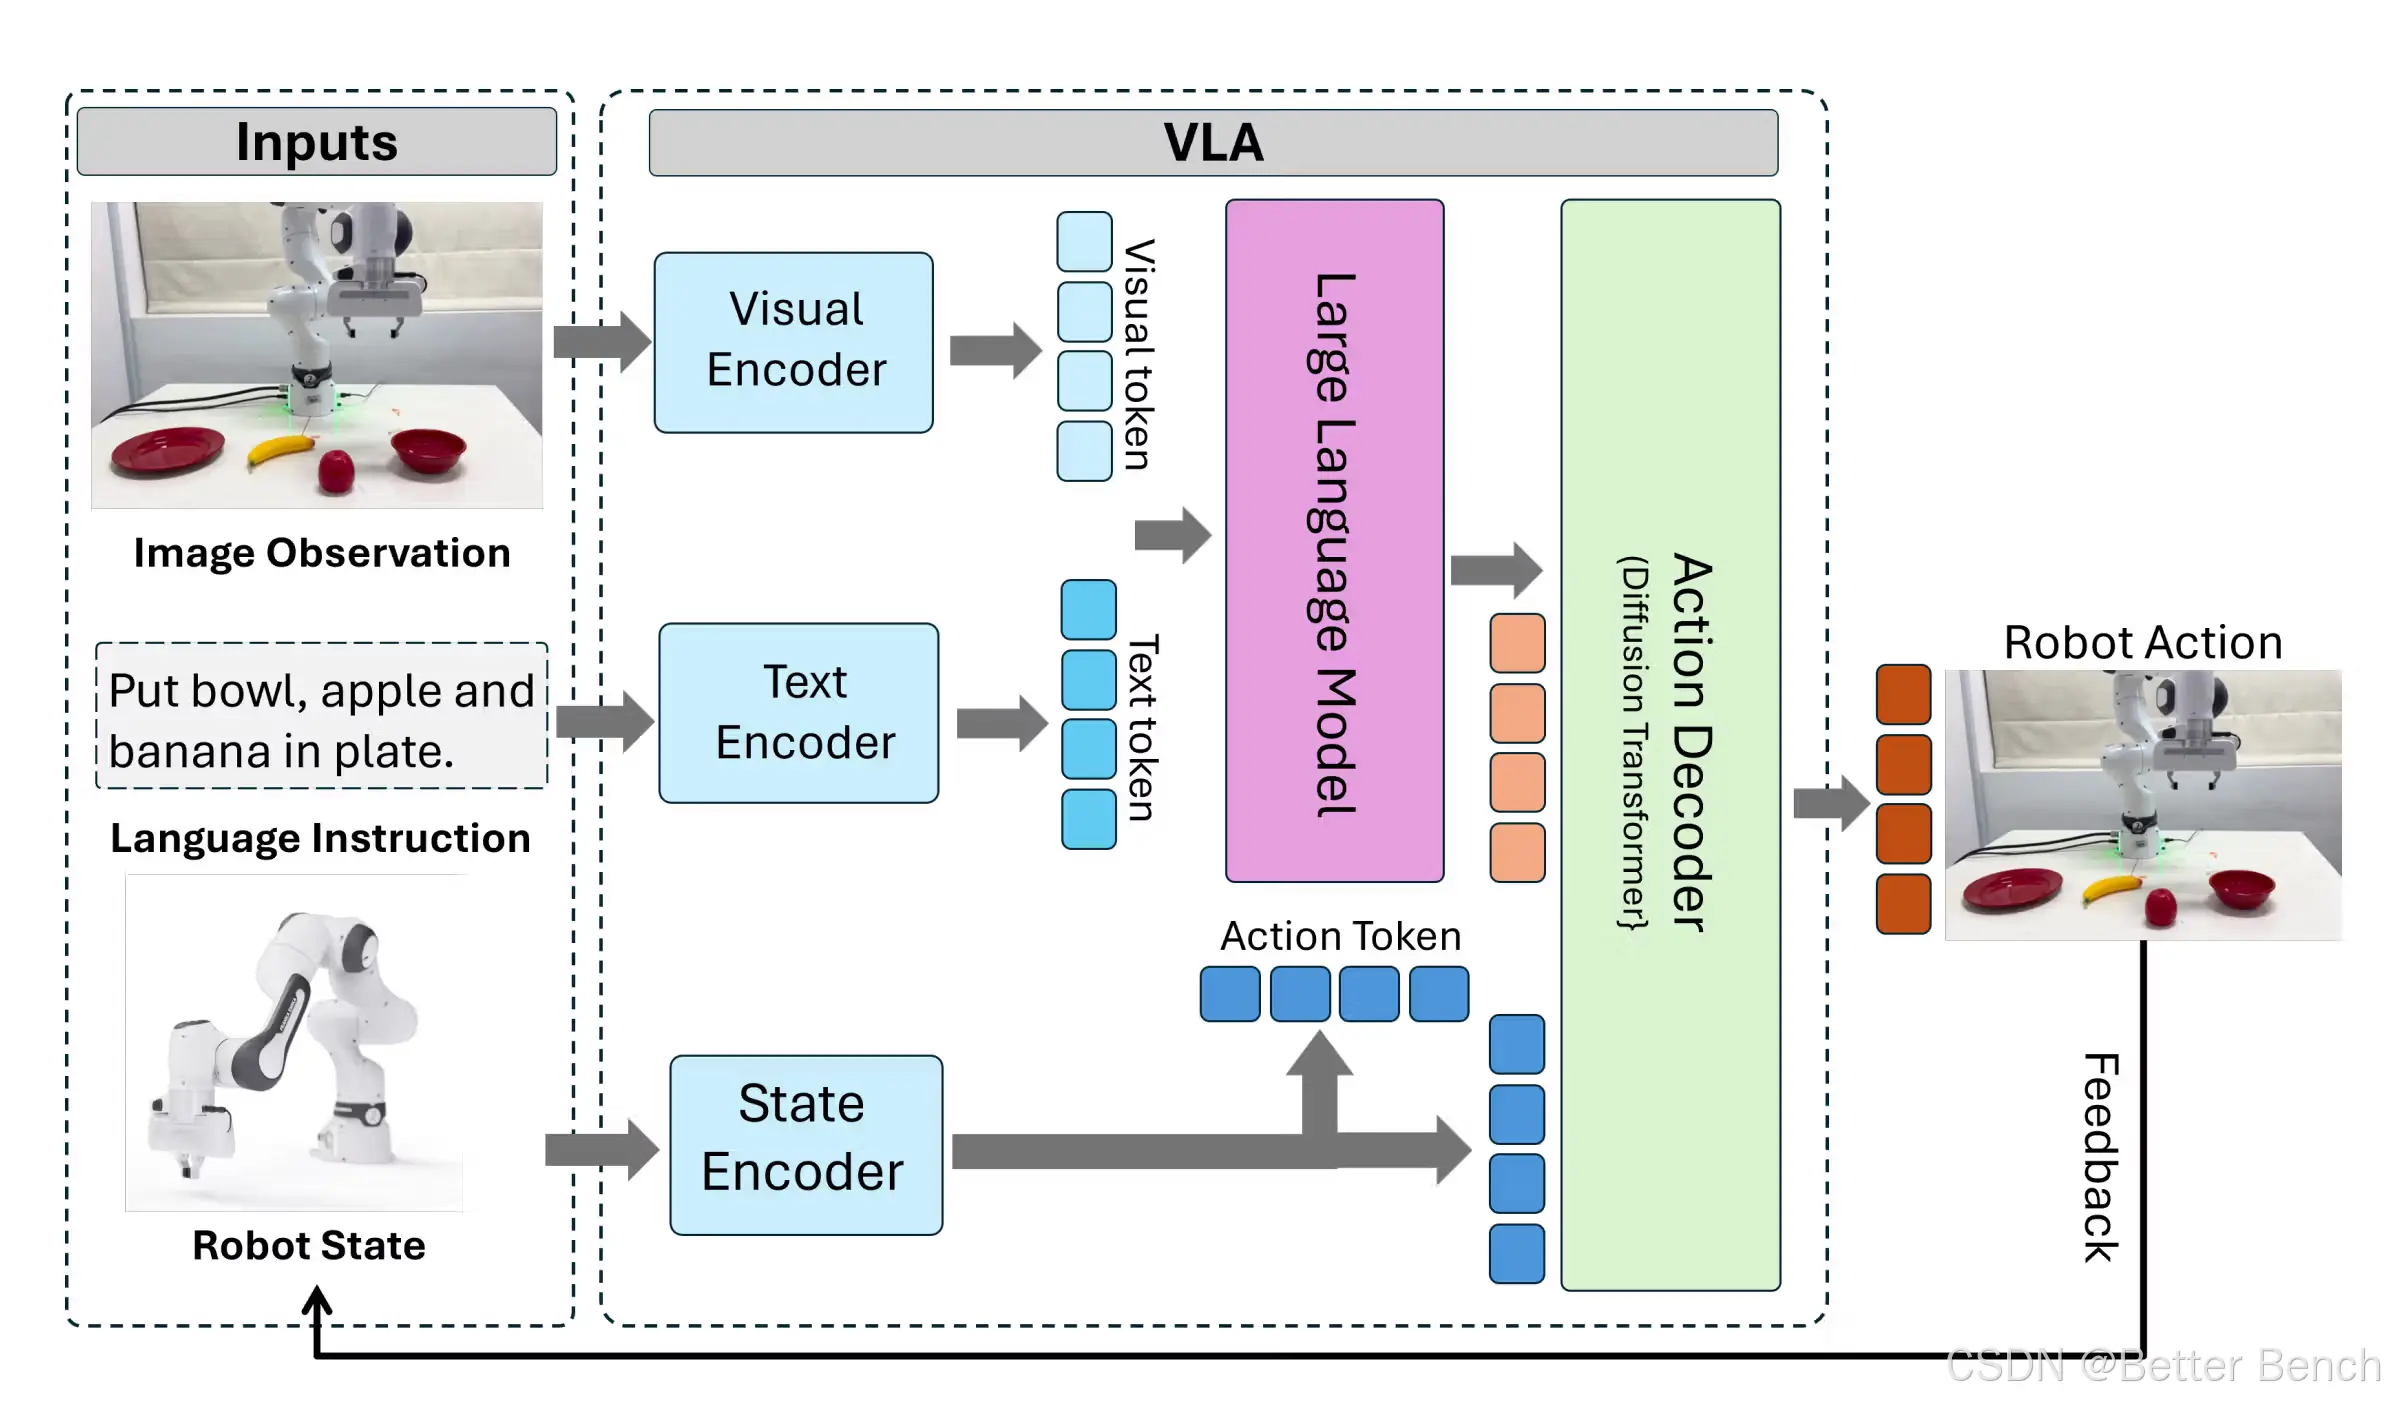
塞班是一台搭载 VLA 的移动操作机器人。给定 RGB-D 观测、本体状态和指令“把苹果拿过来”,它需要输出末端执行器位姿序列,并在闭环中完成抓取。VLA 要解决的核心问题是:将视觉感知、语言理解和物理动作生成统一到同一个条件生成框架中。
1. 概念与架构
VLA(Vision-Language-Action):输入视觉观测、语言指令、本体状态/历史,输出机器人可执行动作序列。它与 VLM 的区别在于,VLM 输出文本,VLA 输出动作。
| 模块 | 作用 | 常见实现 |
|---|---|---|
| 视觉编码器 | 提取空间、语义、时序特征 | CLIP、SigLIP、DINOv2 |
| 语言底座 | 理解指令、常识、任务上下文 | LLaMA、Qwen、DeepSeek 等 |
| 动作解码器/策略 | 将多模态表征转为控制信号 | 自回归离散 token、扩散、流匹配 |
| 本体状态编码 | 引入关节角、末端位姿、历史动作 | MLP、Transformer、状态 token |
| 动作生成路线 | 原理 | 代表 | 优点 | 局限 |
|---|---|---|---|---|
| 自回归离散 token | 动作离散为 token,逐 token 预测 | RT-2、OpenVLA | 复用 LLM 框架,训练稳定 | 频率低,离散精度损失,误差累积 |
| 扩散策略 | 从噪声逐步去噪生成动作序列 | Octo、RDT-1B、CogACT | 多峰分布,动作平滑 | 多步推理,实时性差 |
| 流匹配 | 学习噪声到动作的速度场 | π0、π0.5、GR00T N1 | 连续动作,高频灵巧,长时程 | 训练与工程门槛高 |
2. 发展脉络
| 时间 | 模型 | 机构/公司 | 核心架构 | 动作生成 | 主要贡献/局限 |
|---|---|---|---|---|---|
| 2022 | RT-1 | Google Robotics | Transformer | 离散动作 token | 早期大规模多任务机器人策略;非 LLM 底座,泛化有限 |
| 2023 | RT-2 | Google DeepMind | VLM + 动作 token | 自回归离散 | 动作作为文本 token,互联网知识迁移;闭源,高频弱 |
| 2023–2024 | Octo | UC Berkeley、Stanford、CMU、Google DeepMind 等 | Transformer + 扩散头 | 扩散 | 开源通用策略,多本体;规模较小 |
| 2024 | OpenVLA | Stanford、UC Berkeley、Google DeepMind 等 | Prismatic VLM + LLaMA 2 7B | 自回归离散 | 开源基线,易微调;推理频率低,长时程弱 |
| 2024 | π0 | Physical Intelligence | VLM + Action Expert | 流匹配 | 高频灵巧,长时程;资源门槛高 |
| 2024 | RDT-1B | 清华大学 / Spirit AI | 扩散 VLA | 扩散 | 双臂操作,1.2B;评测生态早期 |
| 2024 | CogACT | 上海人工智能实验室等 | VLM + 扩散动作头 | 扩散 | 认知与动作解耦;生态早期 |
| 2025 | π0.5 | Physical Intelligence | VLM + Action Expert | 流匹配 | 开放世界泛化,长时程;细节公开有限 |
| 2025 | GR00T N1 | NVIDIA | 双系统 VLM + DiT | 扩散/流匹配 | 人形机器人通用 VLA;依赖 Isaac/NVIDIA 生态 |
3. 代表模型优缺点对比
| 模型 | 机构/公司 | 动作生成 | 优点 | 局限 | 适用场景 |
|---|---|---|---|---|---|
| RT-1 | Google Robotics | 离散 token | 多任务规模化验证 | 泛化有限,闭源 | 研究史 |
| RT-2 | Google DeepMind | 自回归离散 | 语义泛化强,互联网知识迁移 | 闭源,推理慢,高频弱 | 语义泛化研究 |
| OpenVLA | Stanford、UC Berkeley、Google DeepMind 等 | 自回归离散 | 开源,易微调,生态成熟 | 频率低,动作离散精度损失 | 入门、复现、LIBERO 基线 |
| π0 | Physical Intelligence | 流匹配 | 高频灵巧,长时程,跨本体 | 闭源/资源门槛高 | 灵巧操作、工业 |
| π0.5 | Physical Intelligence | 流匹配 | 开放世界泛化,长时程 | 资源门槛高 | 通用机器人 |
| GR00T N1 | NVIDIA | 扩散/流匹配 | 快慢双系统,人形,仿真合成 | 依赖 NVIDIA 生态,真实部署复杂 | 人形机器人 |
| Octo | UC Berkeley 等 | 扩散 | 开源灵活,多本体 | 规模小,泛化有限 | 轻量研究 |
| RDT-1B | 清华大学 / Spirit AI | 扩散 | 双臂,1.2B | 数据/评测有限 | 双臂操作 |
| CogACT | 上海人工智能实验室等 | 扩散 | 认知与动作解耦 | 生态早期 | 认知操作研究 |
4. 主要挑战
| 挑战 | 具体表现 | 常见应对 |
|---|---|---|
| 数据稀缺 | 真机演示昂贵,动作数据远少于图文 | 仿真合成、遥操作、跨本体数据 |
| 动作异构 | 不同机器人自由度、夹爪、关节范围不同 | 统一动作空间、本体 token、适配器 |
| 实时性 | 大模型推理慢,控制需高频 | 动作 chunk、蒸馏、量化、双系统 |
| 泛化 | 新物体、新场景、新指令下性能下降 | 大规模预训练、域随机化、语言条件化 |
| 长时程 | 多步任务需要记忆、规划、错误恢复 | 层级规划、记忆检索、Agent 框架 |
| 多模态对齐 | 视觉、语言、动作时序对齐困难 | 跨模态注意力、对比损失、动作 chunk |
| 安全与可解释 | 动作有物理后果,幻觉代价高 | 验证器、约束控制、人类兜底 |
| 评测不统一 | 仿真成功不等于真机成功 | 多基准评测、真机回归、长尾测试 |
| Sim2Real | 摩擦、延迟、接触、光照差距 | 域随机化、系统辨识、真实微调 |
| 持续学习 | 学新技能遗忘旧技能 | 回放、正则、低秩适配、动态容量 |
| 部署 | 显存、延迟、功耗受限 | INT8/INT4、vLLM、TensorRT、边缘部署 |
5. 面试回答要点
VLA 是视觉-语言-动作模型,输入图像和语言,输出机器人动作。架构由视觉编码器、语言底座、动作解码器组成。动作生成分自回归离散 token、扩散、流匹配三条路线。代表工作包括 RT-2、OpenVLA、π0、GR00T N1。OpenVLA 适合开源基线,π0 适合高频灵巧,GR00T N1 面向人形双系统。核心挑战是数据、动作异构、实时性、泛化、长时程、安全、评测、Sim2Real 和持续学习。当前 VLA 仍处于快速演进期,但技术路线已经清晰:统一多模态表征,生成可执行动作,并在真实闭环中持续校正。
一句话选型:
想入门、复现、跑 LIBERO:OpenVLA;
想高频灵巧、长时程:π0 / π0.5;
想人形、双系统:GR00T N1;
想轻量开源:Octo / TinyVLA;
想双臂扩散:RDT-1B。
没有最好的 VLA,只有最适合场景的 VLA。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献34条内容

所有评论(0)