YOLOv12 实时目标检测到底强在哪?
前 言
YOLOv12 在物体检测方面真的表现更好吗?
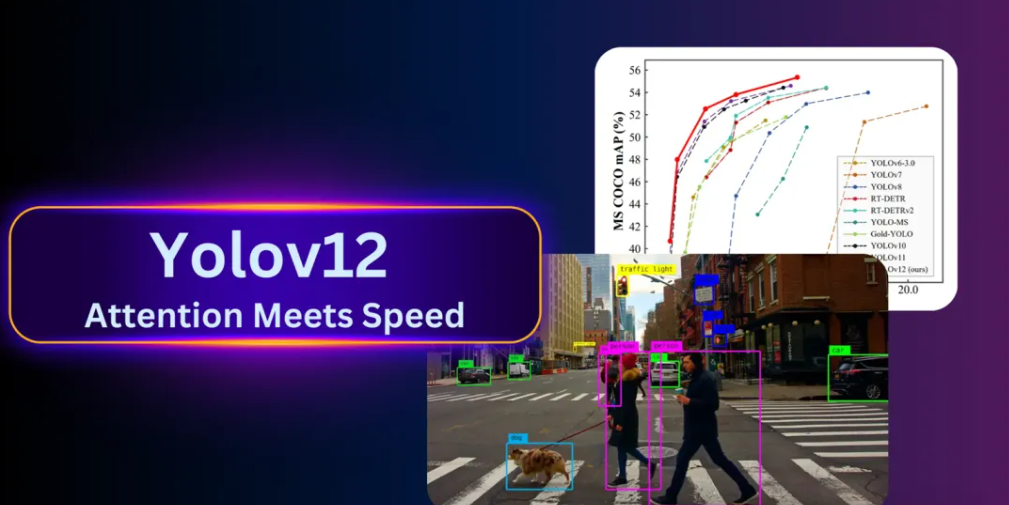
随着实时物体检测在自动驾驶汽车、医疗保健和监控等领域变得越来越重要,这是人工智能研究人员、开发人员和行业专业人士心中的问题。
YOLO(You Only Look Once)系列长期以来一直用于计算机视觉领域,因其能够在网络一次通过中预测边界框和类概率而闻名,兼具速度和准确性。
在实时监控中,即使是微小的延迟也可能意味着错过威胁。更快、更准确的物体检测对于监控繁忙区域、保护建筑物和快速应对安全问题至关重要。
例如,提前一秒发现可疑行为或检测到入侵者可以防止重大安全漏洞。
在高风险情况下,速度和准确性的提高对于保障人们的安全至关重要。
什么是目标检测
目标检测可以定位和分类图像或视频中的物体。首先,模型会分析输入,识别潜在物体的位置,并在它们周围绘制边界框。
然后,该模型为每个检测到的物体分配一个标签,从而有效地对其进行分类。这个过程使机器能够“看到”并理解视觉信息,从而使它们能够执行自动驾驶、监控和图像检索等任务。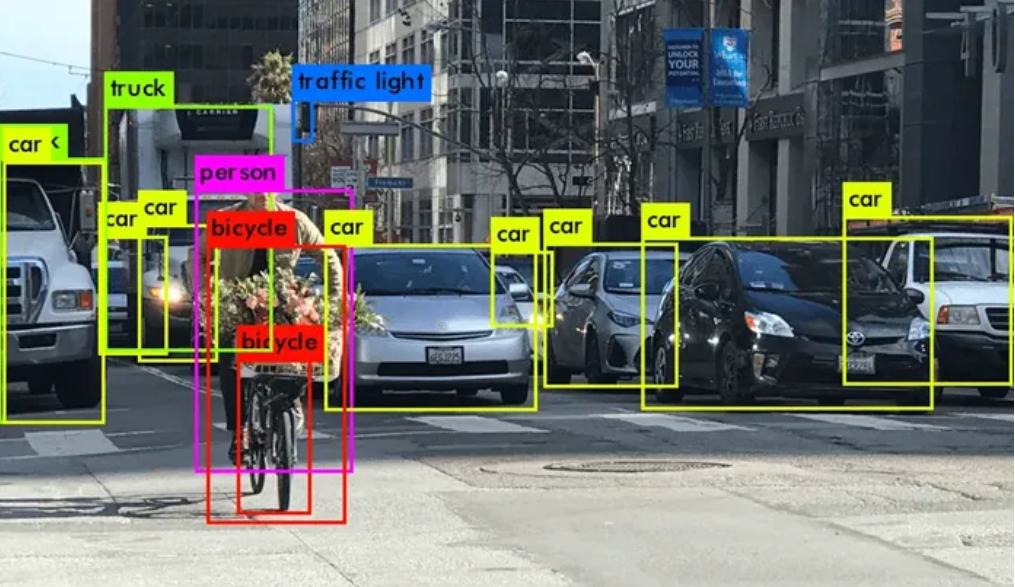
目标检测以前是如何工作的
早期的 YOLO 模型依赖于基于网格的检测,将图像分成单元来预测边界框和类概率。
YOLOv11 通过改进主干和颈部架构对此进行了改进,显著提高了特征提取能力,从而实现了更精确的物体检测和复杂任务执行。
该架构包含C3k2、SPPF、C2PSA等创新模块,有助于增强其特征提取和处理效率。
YOLOv11 与前代产品相比,在 COCO 数据集上的表现有所提升。它实现了更高的平均精度 (mAP) 得分,同时使用的参数比 YOLOv8m 少 22%。
YOLOv12 有哪些新功能
YOLOv12 是 YOLO 物体检测系统的最新版本,这是一个很大的改进。它解决了旧版本的问题,例如难以处理小物体和速度慢。它通过两个主要新功能实现了这一点:
- 区域注意力机制:这有助于模型关注图像的重要部分。
-
R-ELAN 架构:这使得模型更加高效和准确。
-
本质上,YOLOv12 在查找目标(尤其是小物体)方面更快、更好,这使其成为计算机视觉领域的一大进步。
区域注意力机制:它是如何工作的?
YOLOv12 的区域注意力机制通过以下方式加速物体检测:
-
-
划分特征图:该机制将特征图划分为更小的段或区域,从而允许其独立处理每个区域。
-
降低计算成本:通过关注较小的区域,与传统注意力机制相比,它显著降低了计算复杂度。
-
保持较大的感受野:尽管分段处理,它仍然保持较大的感受野,确保模型能够捕捉到广泛的背景。
-
本质上,这是一种更智能的方法,可以聚焦于图像的重要部分,使物体检测更快、更高效。
R-ELAN:通过残差连接增强特征学习
YOLOv12 还使用了 R-ELAN,它改进了模型理解图像的方式。它通过以下方式实现这一点:
-
-
改进特征集成:R-ELAN 主动结合各个层的特征,确保模型捕获广泛的上下文信息。
-
缓解梯度瓶颈:有助于防止训练期间的梯度瓶颈,使模型更有效地学习并保持稳定性。
-
增强特征融合:R-ELAN 优化了特征合并方式,确保利用所有相关信息,从而提高物体检测的准确性。
-
这意味着 YOLOv12 可以更好地理解图像,尤其是当图像中有不同大小的物体时。
YOLOv12 与 YOLOv11 的比较
我们以实时监控为例,用于检测场景中的目标,YOLOv11 和 YOLOv12 积极竞争,各自在准确性、速度和效率方面具有独特的优势,可满足不同的监控要求。
这是两种模型在实时监控中的比较结果。
1. YOLOv12 凭借其注意力机制,能够更好地区分不同的目标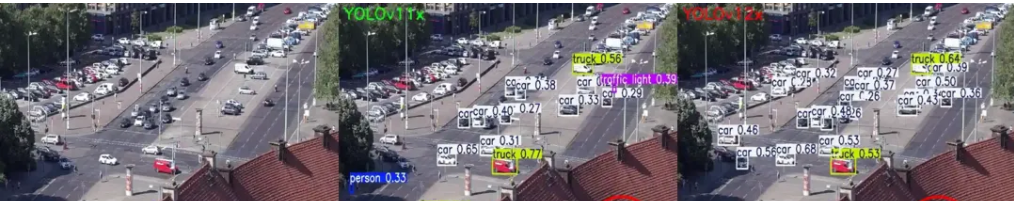
2. YOLOv12 因其 R-ELAN 架构而更擅长检测多个目标,但仅限于物体密度较高的地方。它仍然会错过物体密度较低的边缘部分。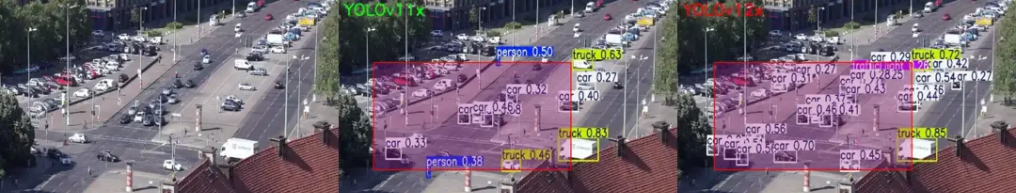
3. YOLOv11 在人员检测方面胜过 YOLOv12,因为它能够在困难的地方检测到人员。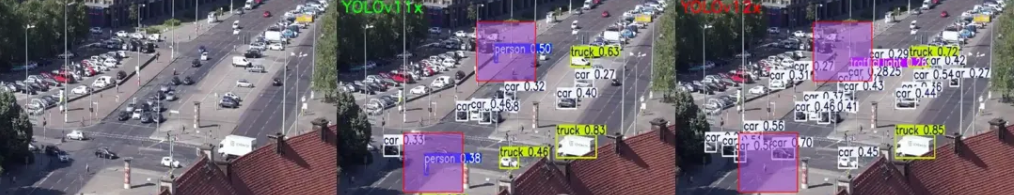
如何使用 YOLOv12
首先在系统中安装 ultralytics 模块
pip install ultralytics
使用上面命令行,您可以在系统中安装 ultralytics 模块。
然后,以下代码将用于对任何样本图像进行推理
from ultralytics import YOLO# Load a COCO-pretrained YOLO12n modelmodel = YOLO("yolo12n.pt")# Train the model on the COCO8 example dataset for 100 epochsresults = model.train(data="coco8.yaml", epochs=100, imgsz=640)# Run inference with the YOLO12n model on the 'sample.jpg' imageresults = model("path/to/sample.jpg")
结 论
YOLOv11和YOLOv12都是实时监控的有力工具,其中YOLOv11速度更快,而YOLOv12则具有更高的准确性和适应性。
它们之间的选择取决于特定的应用要求,例如需要超快速推理或卓越的检测精度。
常问问题
Q1:目标检测常用的算法有哪些?
答:流行的目标检测算法包括 YOLO(You Only Look Once)、Faster R-CNN、SSD(Single Shot MultiBox Detector)和 RetinaNet。
Q2:目标检测与图像分类有何不同?
答:图像分类为整个图像分配标签,而对象检测则识别并定位图像中的多个对象。
Q3:目标检测面临哪些挑战?
答:挑战包括物体大小、光照、遮挡、背景混乱和快速物体移动的变化。
Q4:目标检测可以实时工作吗?
答:是的,YOLO 和 SSD 等模型针对高帧率的实时物体检测进行了优化。
参考链接:
Yolov12 Github:
https://github.com/sunsmarterjie/yolov12
Yolov12 博客:
https://docs.ultralytics.com/models/yolo12/
Yolov12 论文:
https://arxiv.org/pdf/2502.12524v1

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 15
 0
- 0


 已为社区贡献17条内容

所有评论(0)