毕业设计:基于数据挖掘的疾病数据可视化分析与预测系统 机器学习 ARIMA 预测算法模型 大数据 毕业设计✅
·
博主介绍:✌全网粉丝50W+,前互联网大厂软件研发、集结硕博英豪成立软件开发工作室,专注于计算机相关专业项目实战6年之久,累计开发项目作品上万套。凭借丰富的经验与专业实力,已帮助成千上万的学生顺利毕业,选择我们,就是选择放心、选择安心毕业✌
> 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2025年计算机专业毕业设计选题汇总(建议收藏)✅
1、项目介绍
技术栈:
python 语言、Flask框架、Echarts可视化、ARIMA 预测算法模型、HTML
基于数据挖掘的医院疾病数据分析与预测系统
项目介绍:
利用数据挖掘分析某医院近几年的就诊数据,分析疾病病人年龄的平均数、众数,已婚/未婚占比,不同地区患病人数,不同职业患病人数,治愈疾病花费的钱的平均数等,根据分析得到的数据对当前疾病进行分类等功
能,同时利用机器学习算法实现对疾病的未来趋势预测。
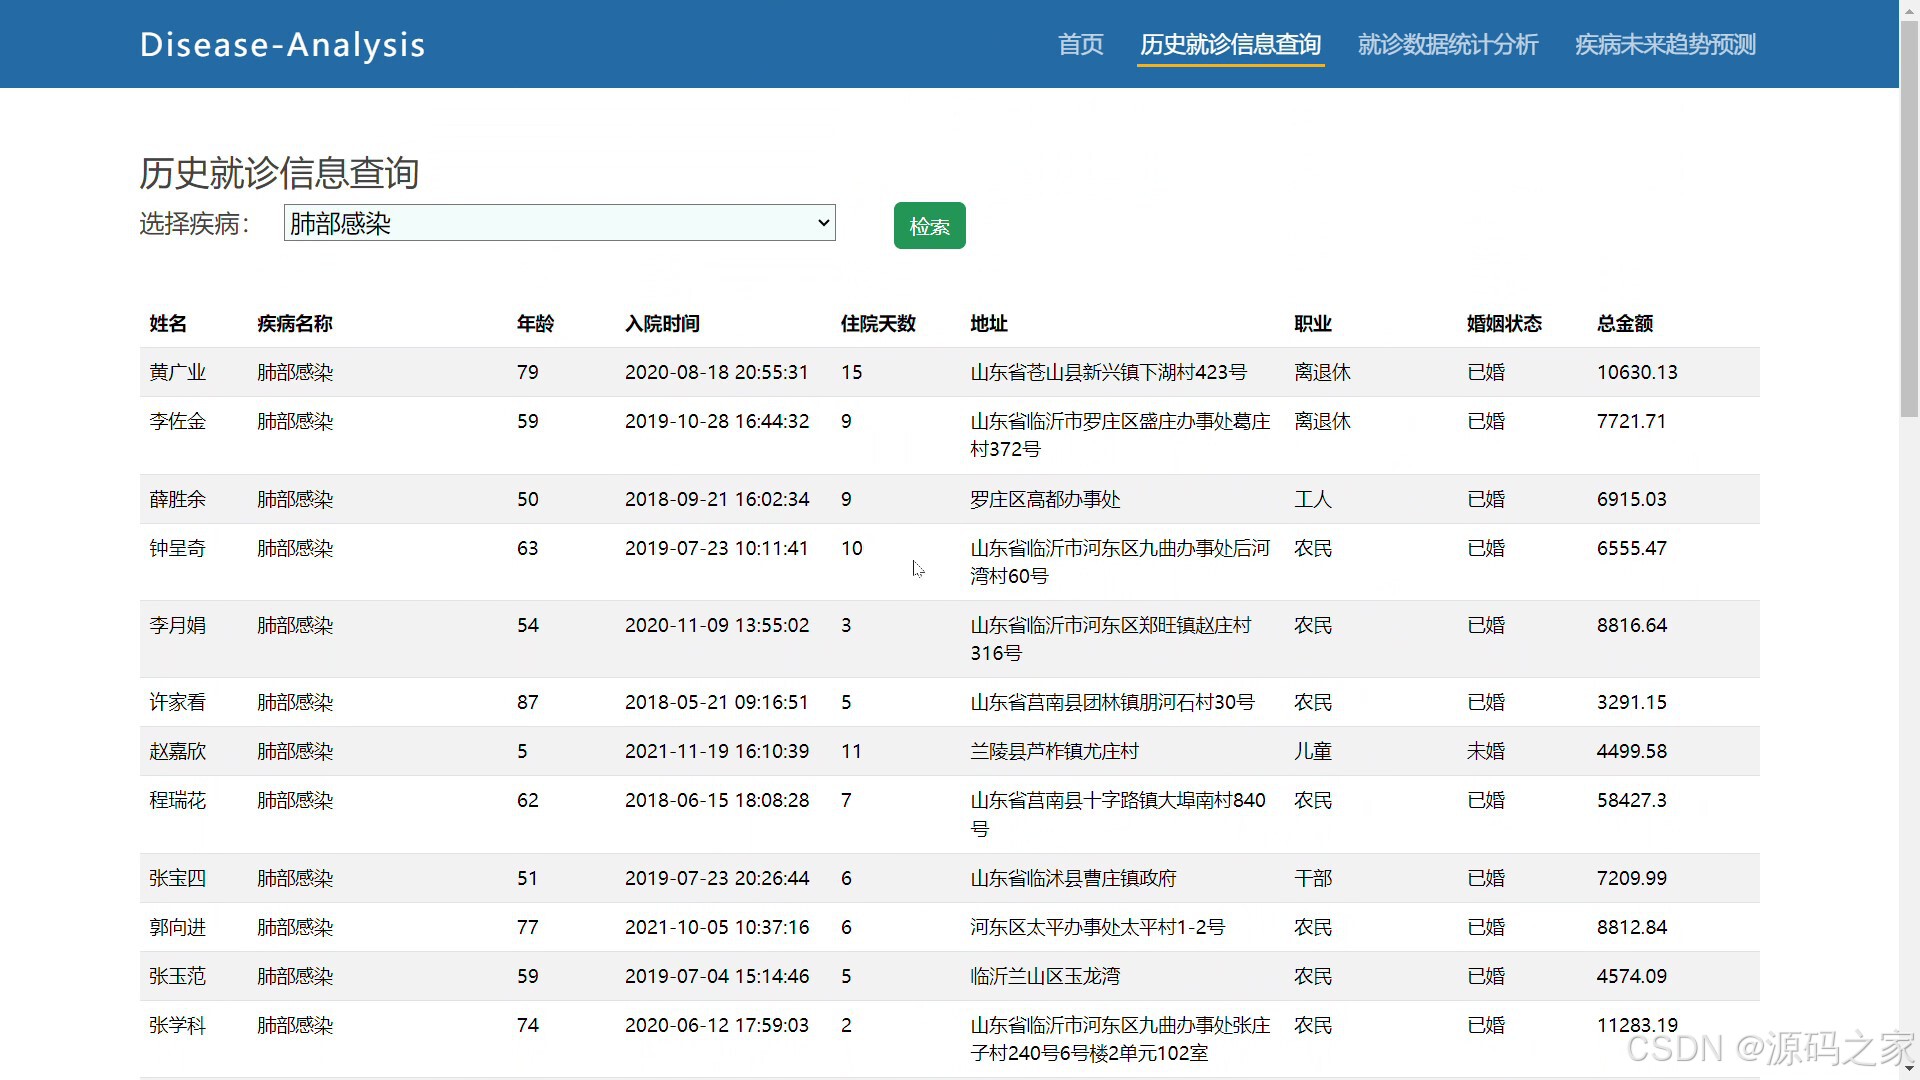
1、历史就诊信息查询
通过对不同疾病类型的医院治疗数据进行分类,前端提供查询接口,查询最新的相关疾病就诊病人信息。
2、就诊数据统计分析
利用python统计分析工具,分析惠者婚姻状况与职业分布、住院天数分布、年龄分布、所在地区的分布、每日住院人数与缴费总金额变化等。
3、疾病未来趋势预测
通过对医院就诊病人的历史数据,构建机器学习模型,并进行模型训练和验证,实现某一疾病的发病年龄、已婚率、住院天数等维度的趋势预测。
4、搭建可视化交互平台
后端利用Flask框架搭建web服务接口,前端采用Bootstrap和echarts 等框架,构建可视化交互平台,方便医院对医疗数据的分析预测。
2、项目界面
1 系统首页与注册登录

2 就诊数据统计分析
2.1 患者婚姻状况与职业分布情况分析

2.2 患者住院天数分布情况分析
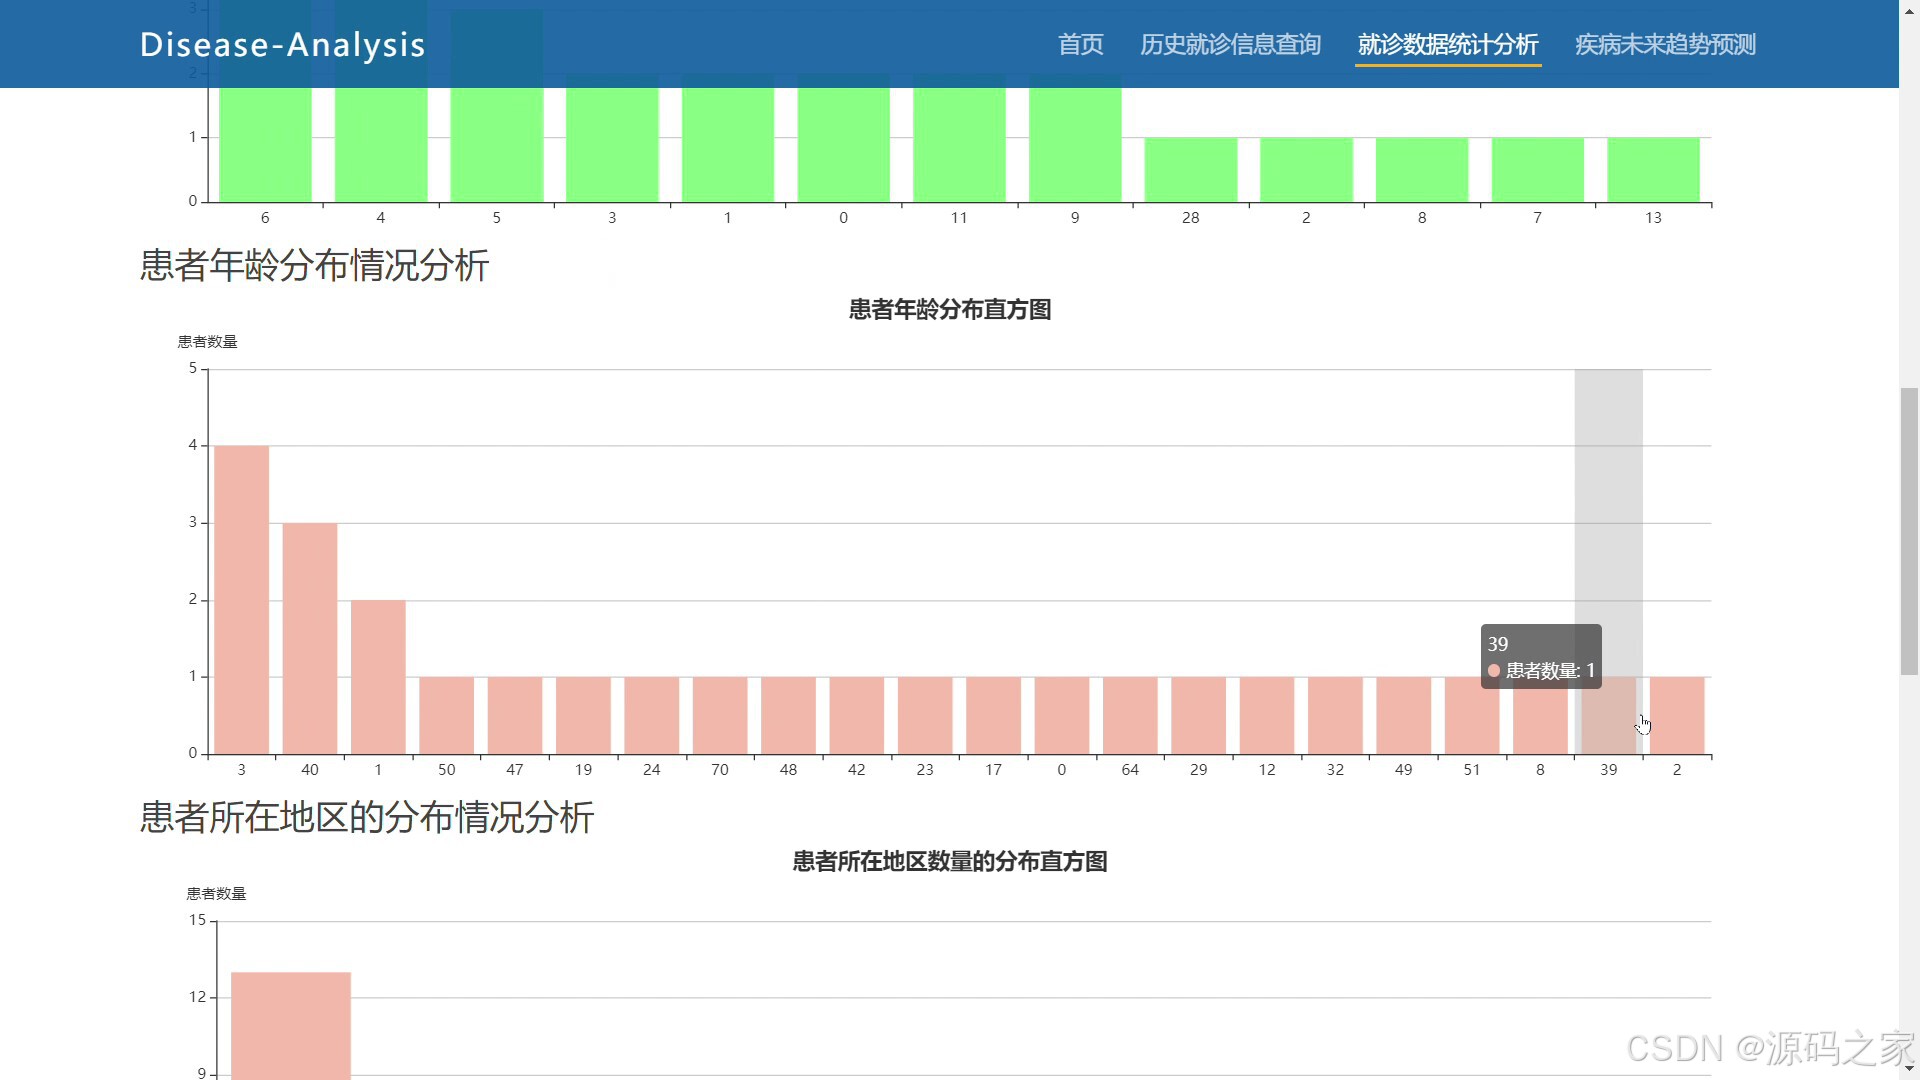
2.3 患者年龄分布情况分析

2.4 患者所在地区的分布情况分析
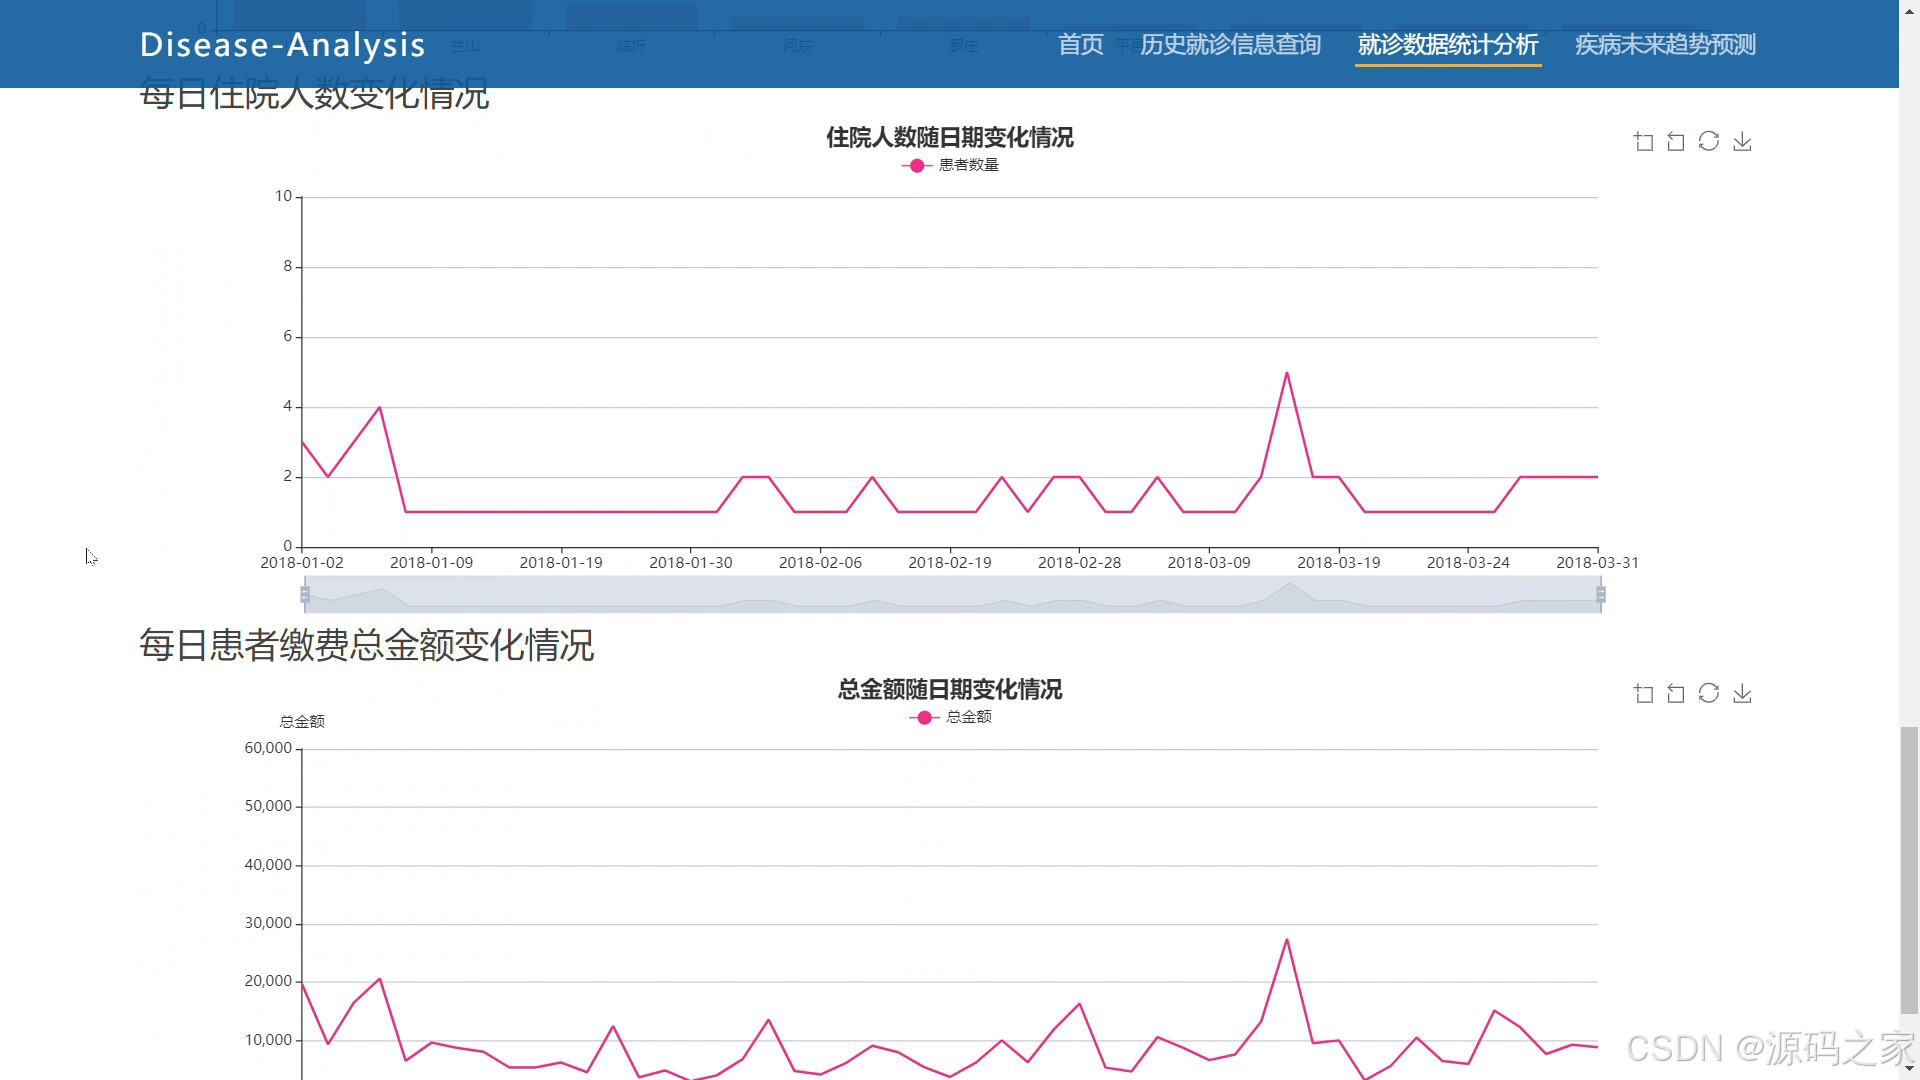
2.5 每日住院人数变化情况
2.6 每日患者缴费总金额变化情况
3 就诊数据统计分析
3.1 患者婚姻状况与职业分布情况分析
3.2 患者住院天数分布情况分析

3.3 患者年龄分布情况分析
3.4 患者所在地区的分布情况分析
3.5 每日住院人数变化情况
3.6 每日患者缴费总金额变化情况
4 疾病未来发展趋势预测
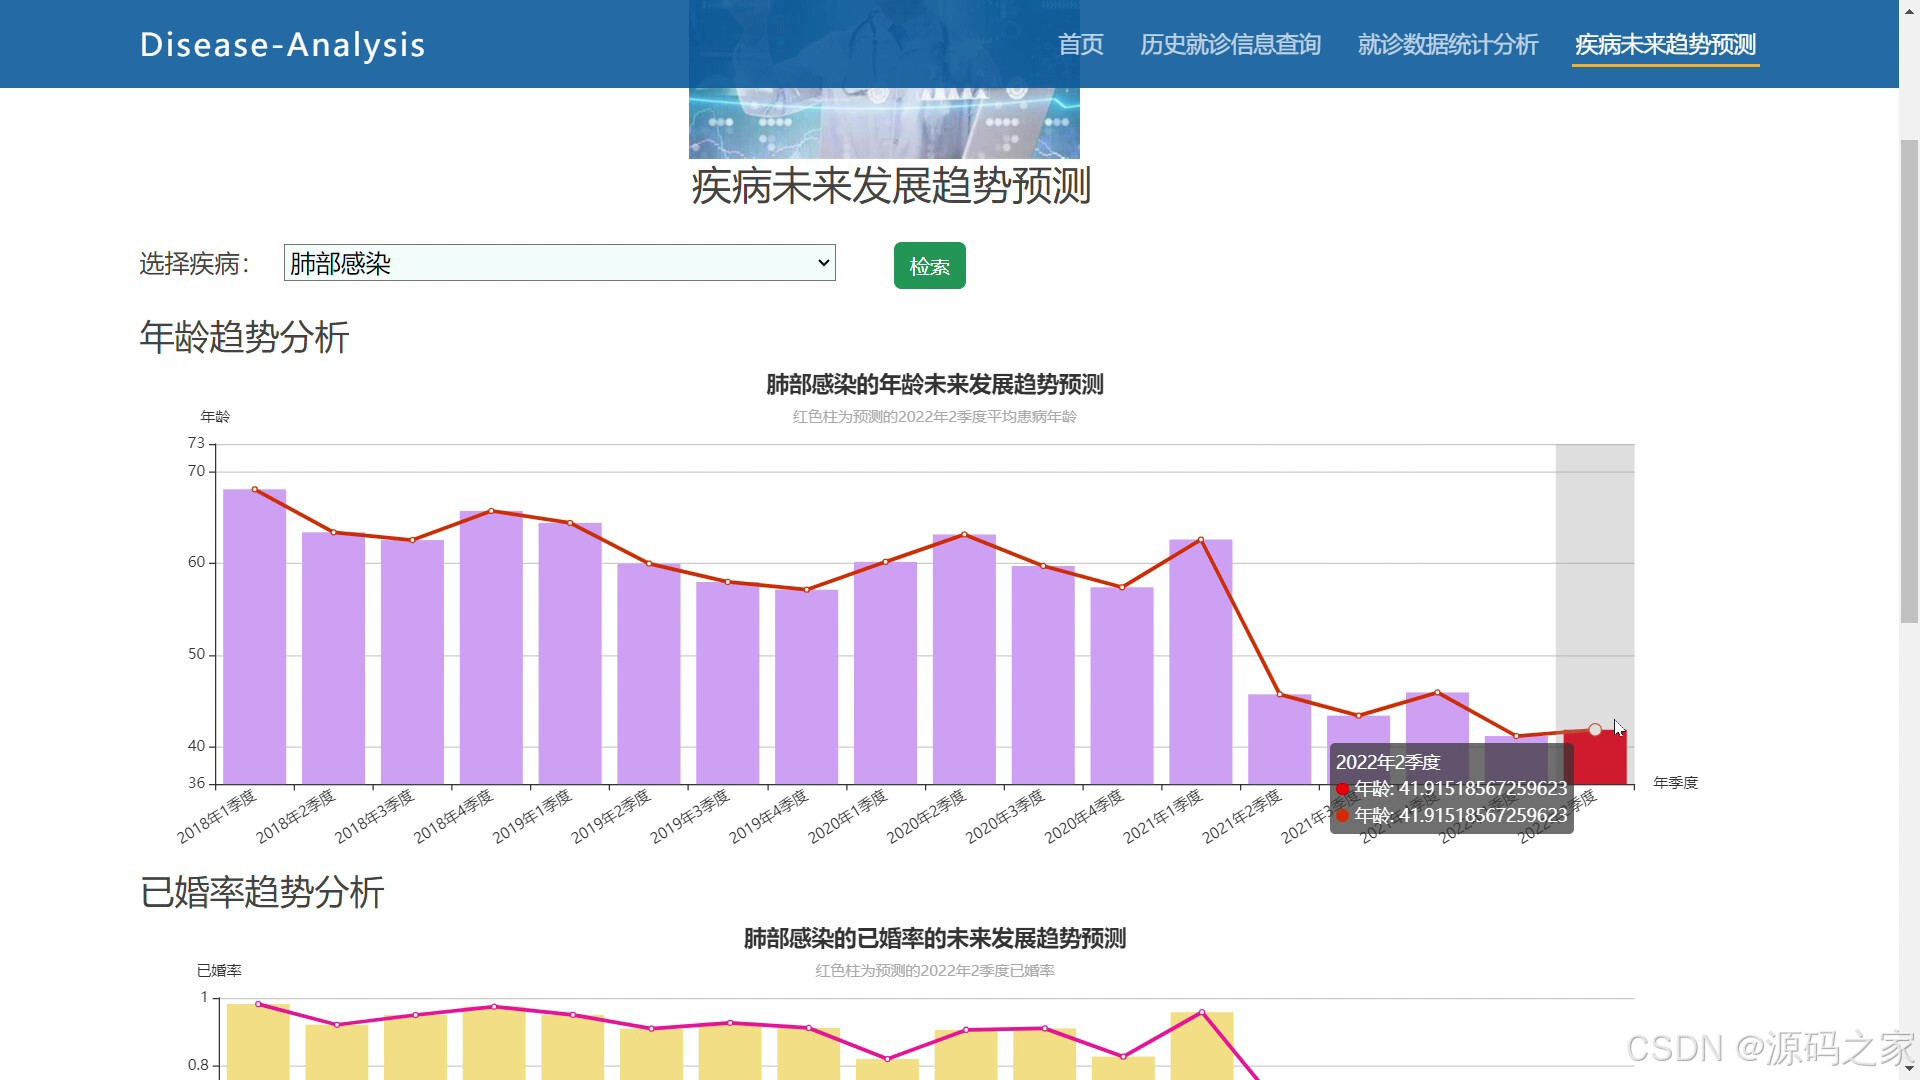
4.1 年龄趋势分析
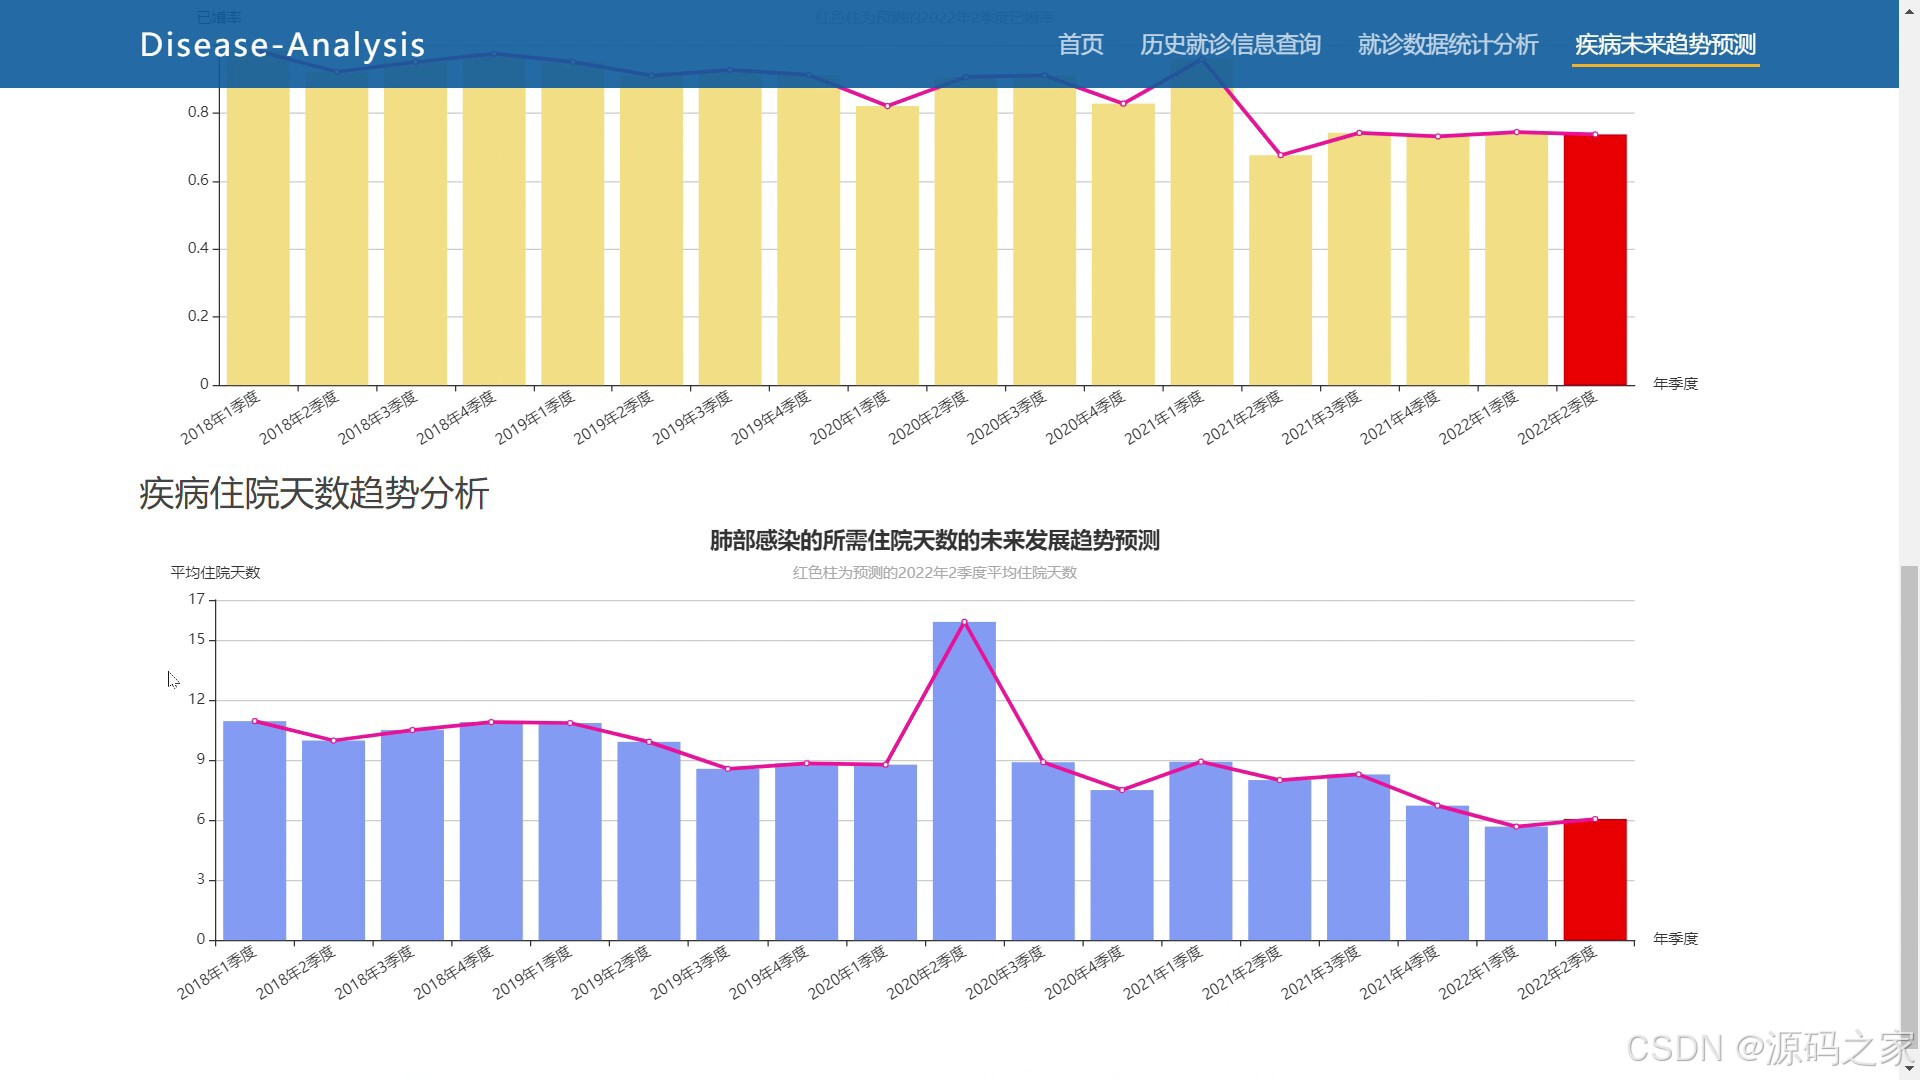
4.2 已婚率趋势分析
4.3 疾病住院天数趋势分析
5 历史就诊信息查询
3、项目说明
基于数据挖掘的疾病数据可视化分析与预测系统的主要功能包括:
1 系统首页与注册登录
2 历史就诊信息查询
3 就诊数据统计分析
3.1 患者婚姻状况与职业分布情况分析
3.2 患者住院天数分布情况分析
3.3 患者年龄分布情况分析
3.4 患者所在地区的分布情况分析
3.5 每日住院人数变化情况
3.6 每日患者缴费总金额变化情况
4 疾病未来发展趋势预测
4.1 年龄趋势分析
4.2 已婚率趋势分析
4.3 疾病住院天数趋势分析
4、核心代码
def arima_model_train_eval(history):
    # 构造 ARIMA 模型
    model = ARIMA(history, order=(1, 1, 0))
    # 基于历史数据训练
    model_fit = model.fit()
    # 预测下一个时间步的值
    output = model_fit.forecast()
    yhat = output[0]
    return yhat


@app.route('/future_predict/<disease>')
def future_predict(disease):
    df1 = df[df['疾病名称'] == disease]
    # 平均年龄
    jidu_age = df1[['年季度', '年龄']].groupby(by='年季度').mean()['年龄'].reset_index()
    # 平均住院天数
    jidu_zhuyuan = df1[['年季度', '住院天数']].groupby(by='年季度').mean()['住院天数'].reset_index()
    # 已婚未婚的占比
    nianjidu_group = df1.groupby(by='年季度')

    yihun_ratios = []
    for nianjidu, tmp_df in nianjidu_group:
        hun_dict = tmp_df['婚姻状态'].value_counts().to_dict()
        hun_count = hun_dict['已婚'] if '已婚' in hun_dict else 0
        yihun_ratio = hun_count / sum(hun_dict.values())
        yihun_ratios.append(yihun_ratio)

    # 未来趋势预测
    print(jidu_age)
    predict_age = arima_model_train_eval(jidu_age['年龄'].values.tolist())
    predict_day = arima_model_train_eval(jidu_zhuyuan['住院天数'].values.tolist())

    print(yihun_ratios)

    predict_yihun_ratio = arima_model_train_eval(yihun_ratios)

    jidu = jidu_age['年季度'].values.tolist()
    jidu.append('2022年2季度')

    age = jidu_age['年龄'].values.tolist()
    age.append(predict_age)

    day = jidu_zhuyuan['住院天数'].values.tolist()
    day.append(predict_day)

    yihun_ratios.append(predict_yihun_ratio)

    return jsonify({
        '年季度': jidu,
        '平均年龄': age,
        '平均住院天数': day,
        '已婚率': yihun_ratios
    })


if __name__ == "__main__":
    app.run(host='127.0.0.1', debug=True)
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目编程以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
5、源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 20
 0
- 0


 已为社区贡献166条内容

所有评论(0)