TipDM数据挖掘案例:电子商务网站用户分群
1、项目背景
随着计算机技术与通信技术的日益成熟和广泛应用,互联网自90年代初开始得到迅猛的发展,至今虽只有十几年时间,但已发展成为信息时代的人类生活中不可或缺的部分,成为全球范围内信息传播的主要渠道,与此同时,连入互联网的用户越来越多。目前,互联网的用户规模已不容小视,互联网市场潜力巨大,各大网站运营商都在采取积极的措施,分析用户的行为特征,对不同客户群提供差异化的服务,以达到精准营销的目的。比如,有些网站根据用户的注册资料,性别、年龄、区域、职业等信息对用户进行分群,但这种分群方式是“粗犷”的,未能考虑到用户的行为特征和兴趣偏好,分群结果难以为精准营销提供决策的支持。
网站运营商想要在浩如烟海的互联网用户中找到目标客户存在很大困难,具体表现为:运营商不知道目标用户浏览网站时有什么样的行为特征和习惯?运营商急需快速有效的方法解决用户分群问题。在这一背景下,本案例采用数据挖掘的手段分析用户过去的浏览行为,在此基础上建立用户自动分群模型。
本案例的研究对象是泰迪杯竞赛网站,泰迪智能科技是一家专门从事大数据挖掘研发、咨询和培训服务的高科技企业。泰迪杯竞赛网致力于为用户提供丰富的泰迪杯竞赛信息、数据挖掘培训咨询,并提供往届优秀作品作为参考,以及面向高校的丰富教学资源,如:案例教程、教学视频、教学书籍、建模工具等。访问用户的增加使得网站越发难以掌握用户的需求。为更好满足用户的需求,本案例依据用户的历史浏览记录,研究用户的兴趣偏好,分析需求并发现用户的兴趣点,从而将用户分成不同群体。公司后续可以针对不同群体提供差异化的服务,提高用户的使用体验。
2、项目目标
-
依据用户的历史浏览记录,分析用户的行为特征和兴趣偏好。
-
根据用户的行为特征和兴趣偏好将用户划分成不同的群体,分析各群体的属性特征。
3、项目步骤
3.1工程前期准备
3.1.1导入数据
(1)介绍数据
用户访问网站时,系统会自动记录用户访问网站的日志。该网站被访问的数据记录(部分字段),如表 3‑1所示。
表 3‑1 用户访问记录表
|
id |
page_path |
Userid |
seeeionid |
ip |
data_time |
|
1 |
/zytj/index.jhtml |
NA |
DE80E709835F8AB1A38196185B05FDBC |
218.28.23.137 |
2016/7/14 18:33 |
|
2 |
/zytj/index.jhtml |
NA |
ED095CA37DB28D1404124B4988CAFB9F |
218.28.23.137 |
2016/7/14 18:33 |
|
3 |
/xtxm/index.jhtml |
8180 |
773F9B491EF1027B76698C489DEB9DB9 |
188.165.225.224 |
2016/7/14 18:34 |
|
4 |
/notice/614.jhtml |
NA |
E32144406C1DEAB298FE4677846A449D |
180.153.214.152 |
2016/7/14 18:35 |
|
5 |
/stpj/626.jhtml |
8181 |
FBD4EB0F3E6390A493997B22B0DE51AD |
180.153.206.20 |
2016/7/14 18:35 |
|
6 |
/thirdtipdm/index.jhtml |
NA |
0430EF0B7E5CD8A3831E78290DD2CED3 |
111.206.36.19 |
2016/7/14 18:35 |
表 3‑1记录了访问序号、内容id、访问内容、用户id、ip等多项属性的记录,并针对其中各个属性进行了说明,如表 3‑2所示。
表 3‑2 访问记录属性表
|
属性名称 |
属性说明 |
属性名称 |
属性说明 |
|
id |
访问序号 |
browser_type |
浏览器类型 |
|
content_id |
内容id |
browser_version |
浏览器版本 |
|
page_path |
网址 |
platform_type |
平台类型 |
|
username |
用户名称 |
platform_series |
平台系列 |
|
userid |
用户id |
platform_version |
平台版本 |
|
sessionid |
一次浏览标识 |
data_time |
访问时间 |
|
ip |
ip地址 |
mobile_type |
手机类型 |
|
country |
国家 |
agent |
代理商 |
|
area |
区域 |
uniqueVisitorId |
唯一浏览ID |
(2)上传数据到Python数据挖掘建模平台
在新增数据源上,选择本地上传数据,如图 1所示。

图 1 本地上传数据源
在本地路径上选择文件,填写在平台新建的目标表名,如图 2所示。

图 2 本地选择文件上传
根据文件的数据,可以修改文件的字段名和类型,如图 3所示。

图 3 字段设置
上传成功,可以在平台的数据源上查看数据,单击数据源操作的查看按钮如图 4所示,数据预览如图 5所示。

图 4 单击预览数据按钮

图 5 数据预览
3.1.2新建空白工程
右击我的工程,新建一个空白的工程,如图 6所示。

图 6 新建工程
填写工程的信息,包括工程名称和工程描述,如图 7所示。
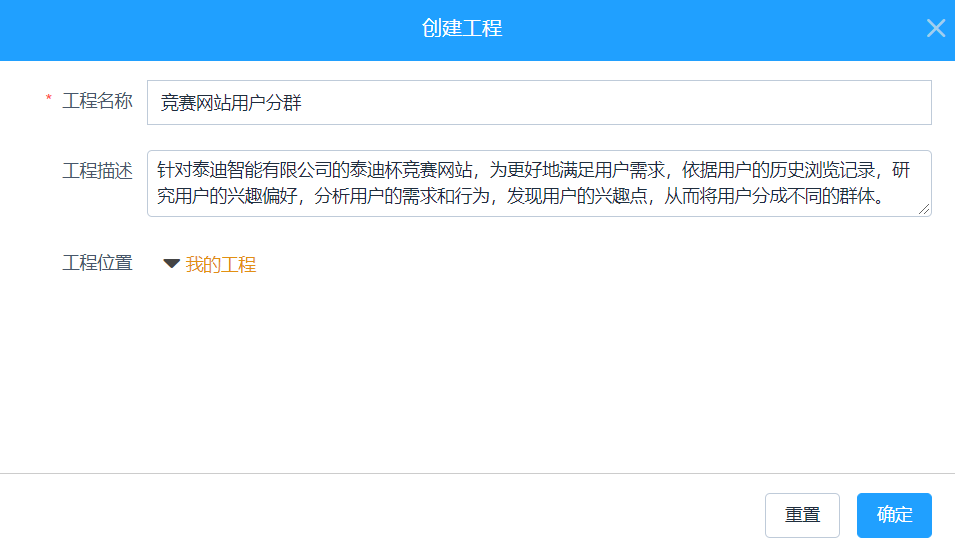
图 7 填写工程信息
3.2数据预处理
读取user_dat数据,步骤如图 8所示。
-
选择工程。
-
选择输入源组件。
-
拖入输入源组件。
-
填写数据表名。
-
单击更新按钮,更新出数据。
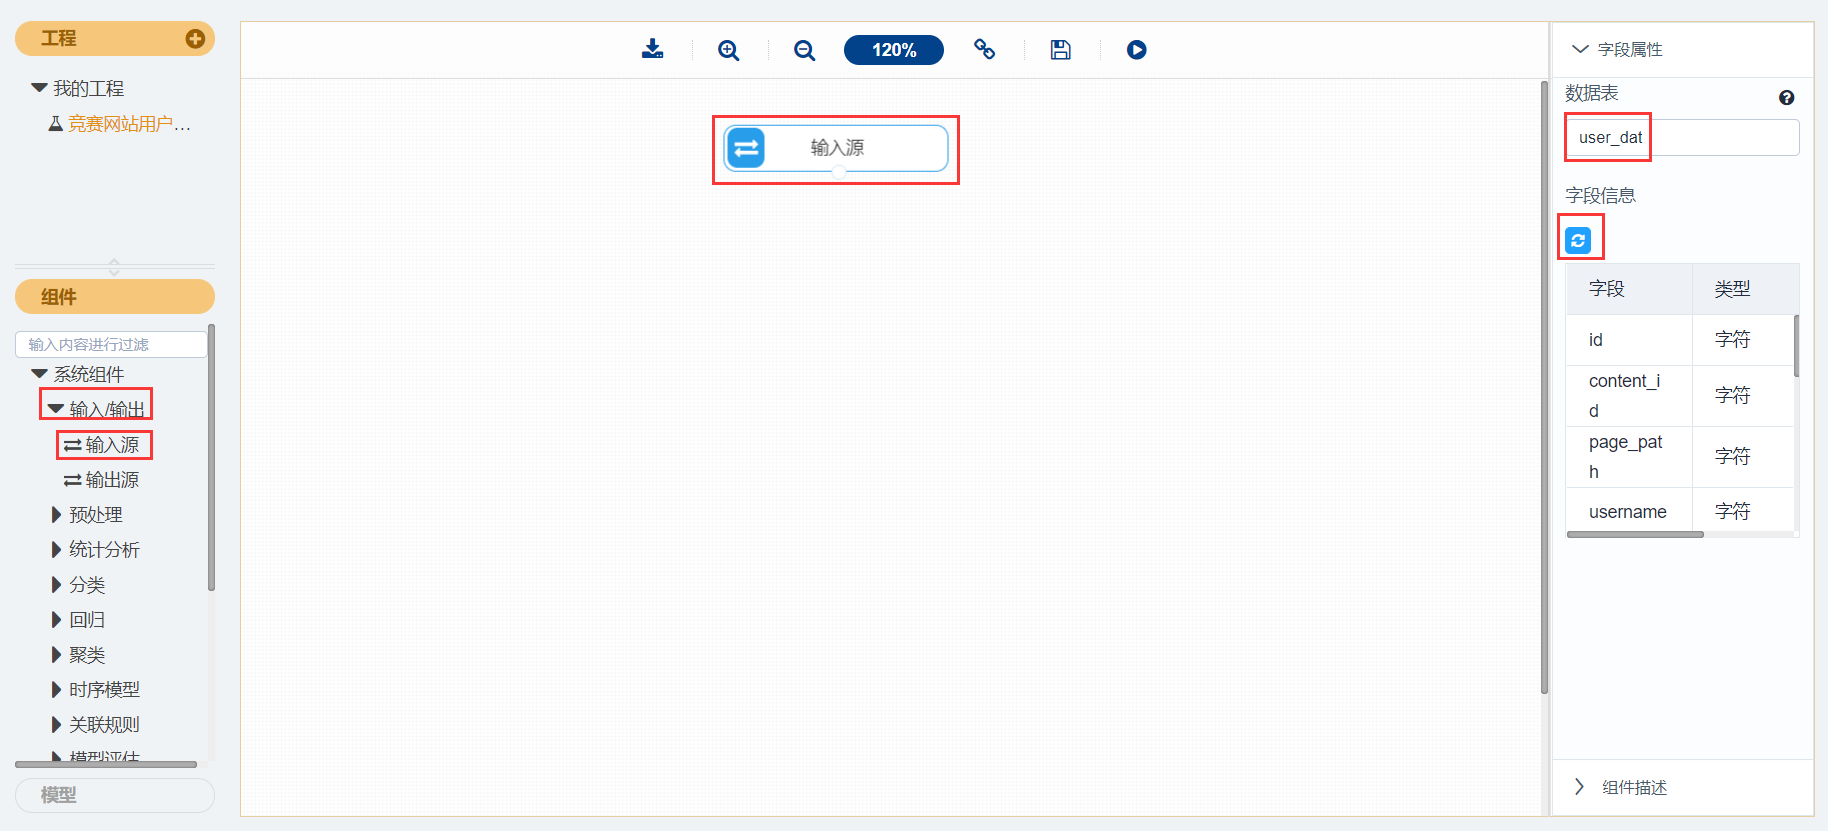
图 8 输入源组件
3.2.1属性规约
接下来进行属性规约。步骤如图 9所示。
-
找到预处理→数据筛选组件。
-
拖入数据筛选组件,并将数据源和数据筛选组件连接。
-
单击更新按钮,勾选page_path、username、userid、sessionid、ip、date_time、uniquevisitorid字段作为输出字段。
-
对数据筛选组件右键,选择运行该节点。
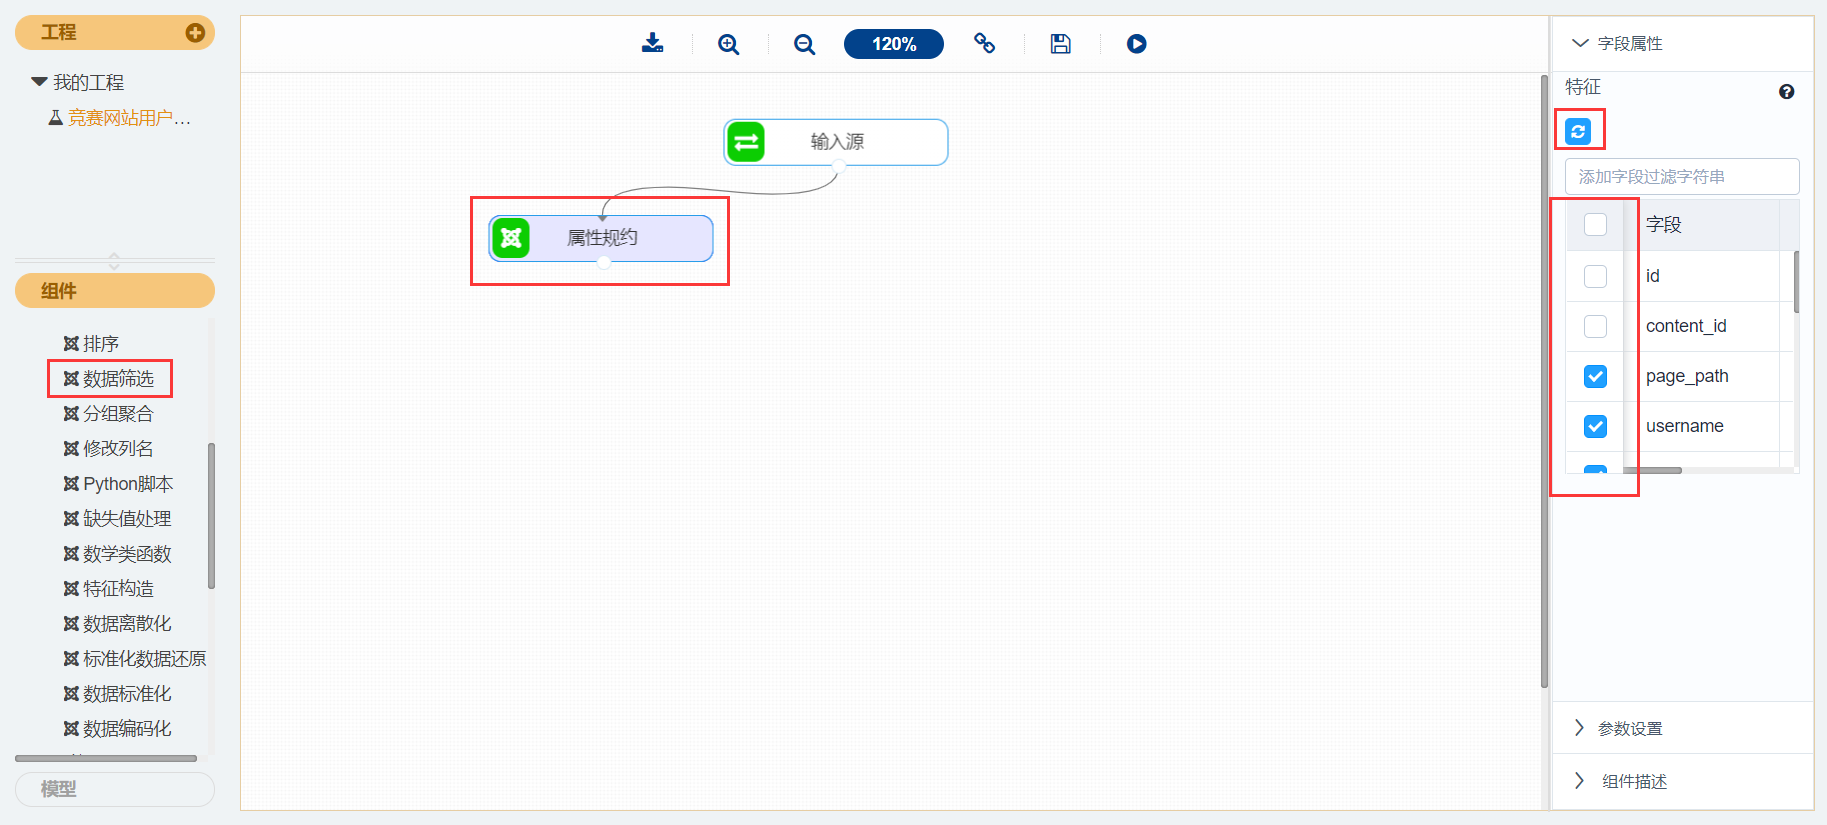
图 9 属性规约组件
-
运行完成后,对全表统计组件右键,选择查看数据。如图 10所示。
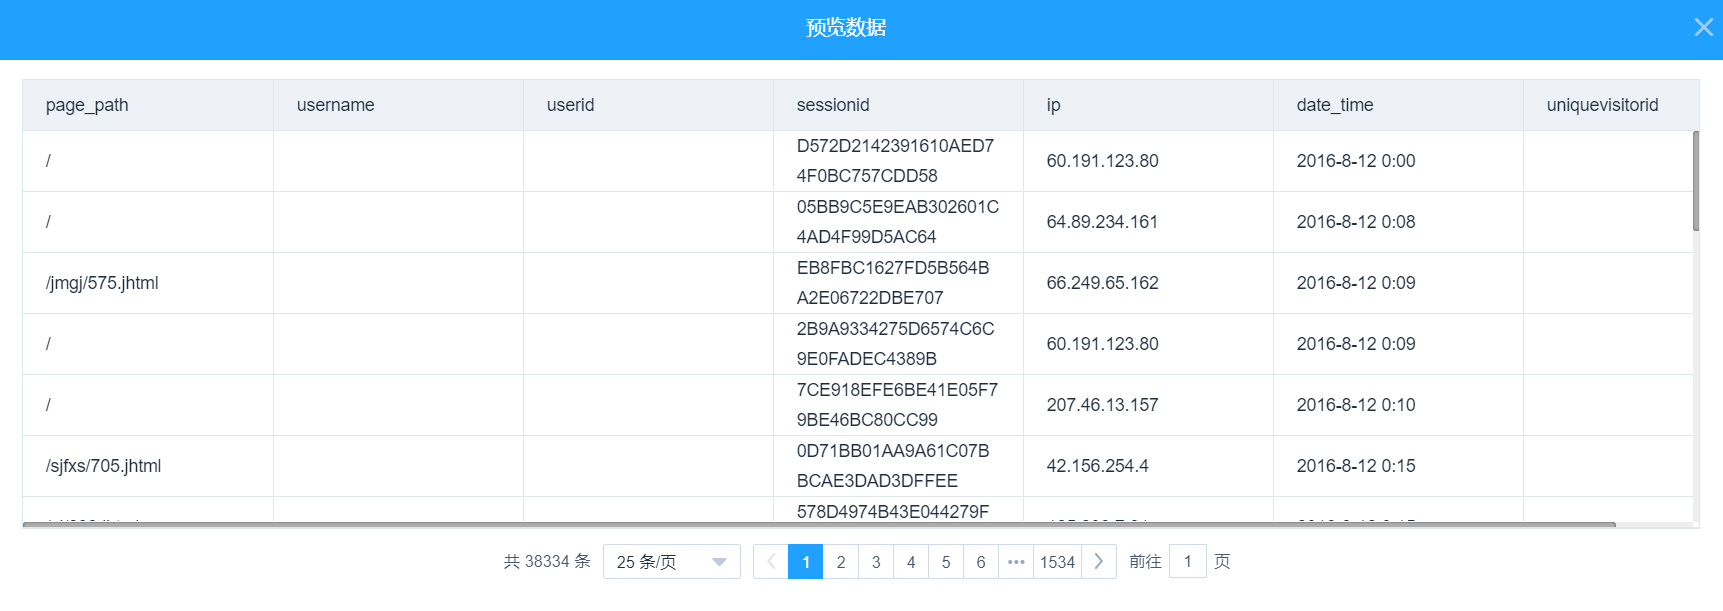
图 10 属性规约结果
-
运行完成后,对数据筛选组件右键,重命名为属性规约。
3.2.2数据变换
接下来进行数据变换,步骤如图 11所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将属性规约和Python脚本组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑3所示。
-
对Python脚本组件右键,选择运行该节点。
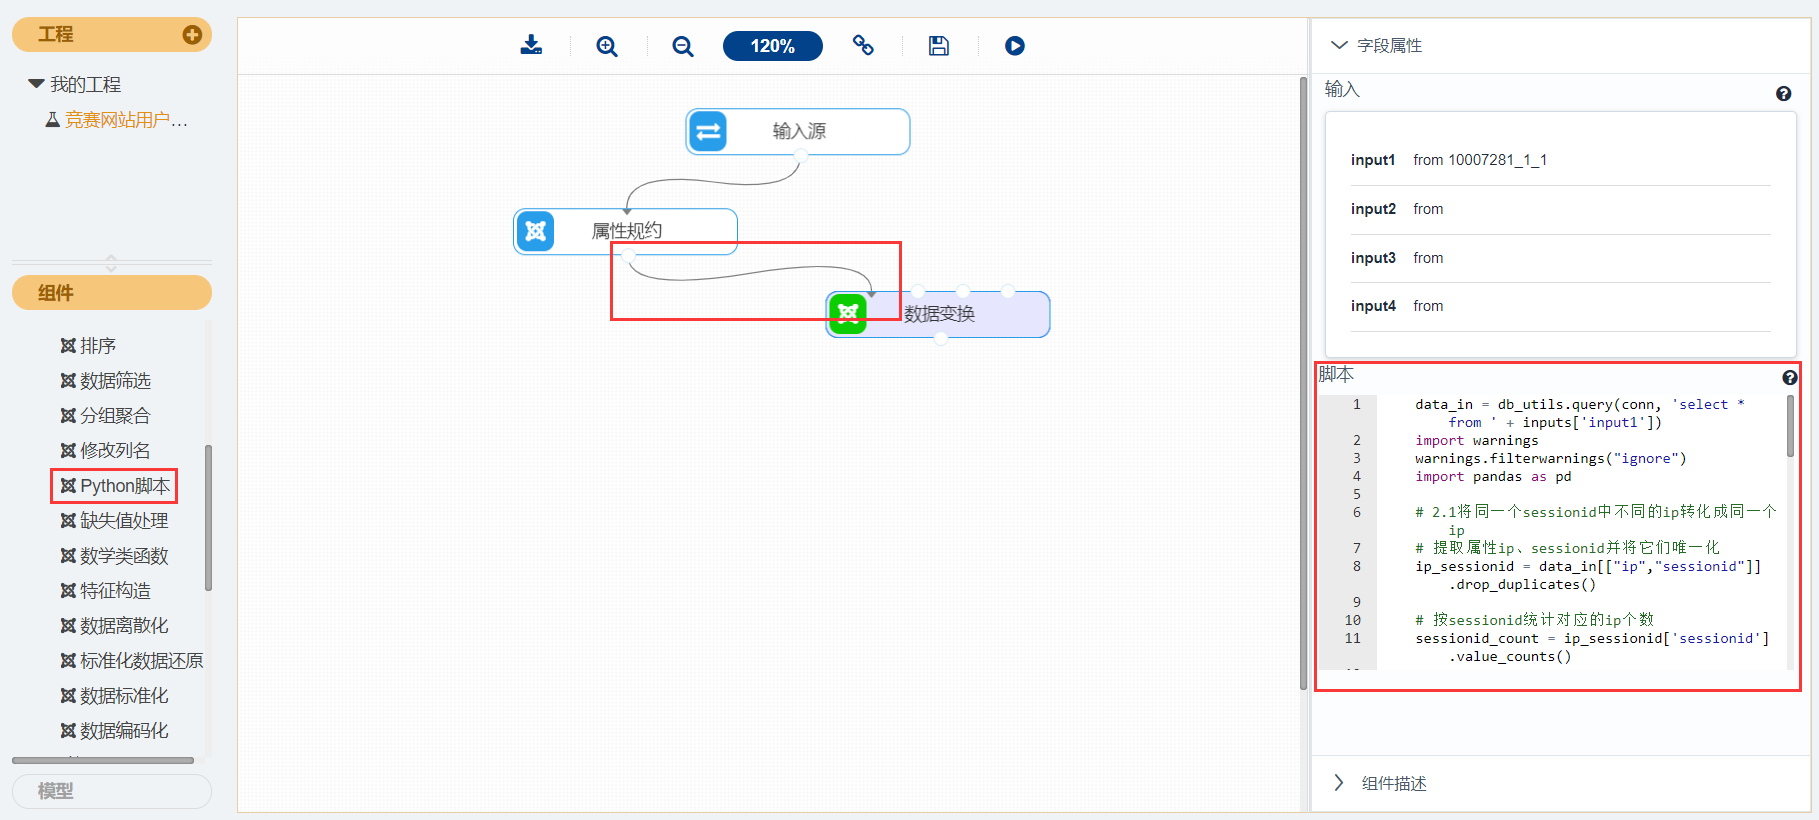
图 11 数据变换组件
表 3‑3 数据变换代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd

    # 2.1将同一个sessionid中不同的ip转化成同一个ip
    # 提取属性ip、sessionid并将它们唯一化
    ip_sessionid = data_in[["ip","sessionid"]].drop_duplicates()

    # 按sessionid统计对应的ip个数
    sessionid_count = ip_sessionid['sessionid'].value_counts()

    # 提取计数大于1对应的sessionid号
    rept_sessionid = sessionid_count[sessionid_count > 1].index

    # 计算满足条件的sessionid个数
    len = rept_sessionid.size

    # 同一个sessionid不同的ip用sessionid对应的第一个ip替换
    for i in range(len-1):
        index = data_in[data_in['sessionid'] == rept_sessionid[i]].index
        data_in.iloc[index,]['ip'] = data_in.iloc[index[0]]['ip']

    del ip_sessionid,sessionid_count,rept_sessionid,len,i

    # 2.2将一次点击中有不同的userid换成同一个userid
    import numpy as np

    # 提取属性userid、sessionid并将它们唯一化
    userid_sessionid = data_in[["userid","sessionid"]].drop_duplicates()

    # 按sessionid统计对应的ip个数
    sessionid_count_1 = userid_sessionid['sessionid'].value_counts()

    # 提取计数大于1对应的sessionid号
    rept_sessionid_1 = sessionid_count_1[sessionid_count_1 > 1].index

    # 计算满足条件的sessionid个数
    len_1 = rept_sessionid_1.size

    # 将同一个sessionid且userid为NA的userid用该sessionid不为NA的userid替换
    for i in range(len_1-1):
        index = data_in[data_in['sessionid'] == rept_sessionid_1[i]].index
        rept_dat = data_in.iloc[index]['userid']
        data_in.iloc[index,]['userid'] = rept_dat[rept_dat.notnull()].head(1)

    del userid_sessionid,sessionid_count_1,rept_sessionid_1,len_1,i,rept_dat

    data_out = data_in

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 12所示。
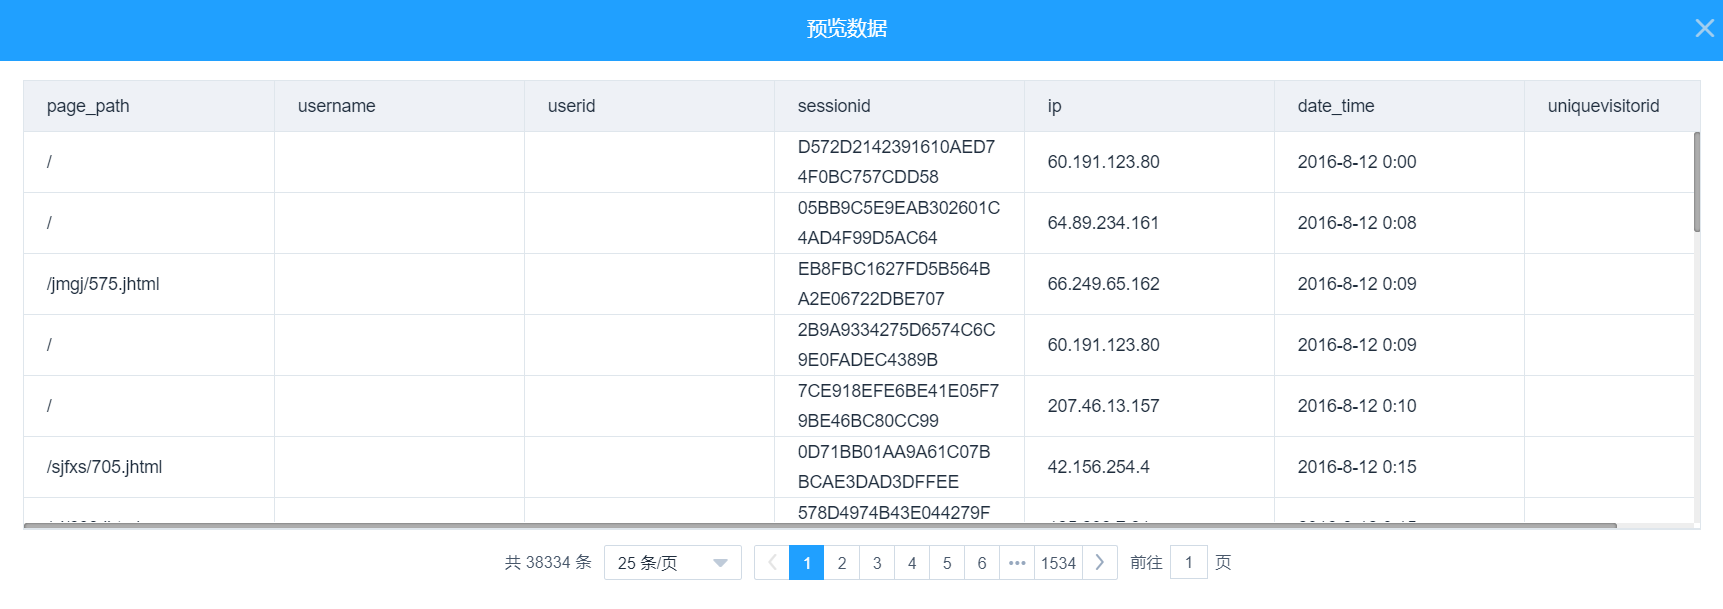
图 12 数据变换结果
-
运行完成后,对Python脚本组件右键,重命名为数据变换。
3.2.3用户识别
接下来进行用户识别,步骤如图 13所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将数据变换和Python脚本组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑4所示。
-
对Python脚本组件右键,选择运行该节点。
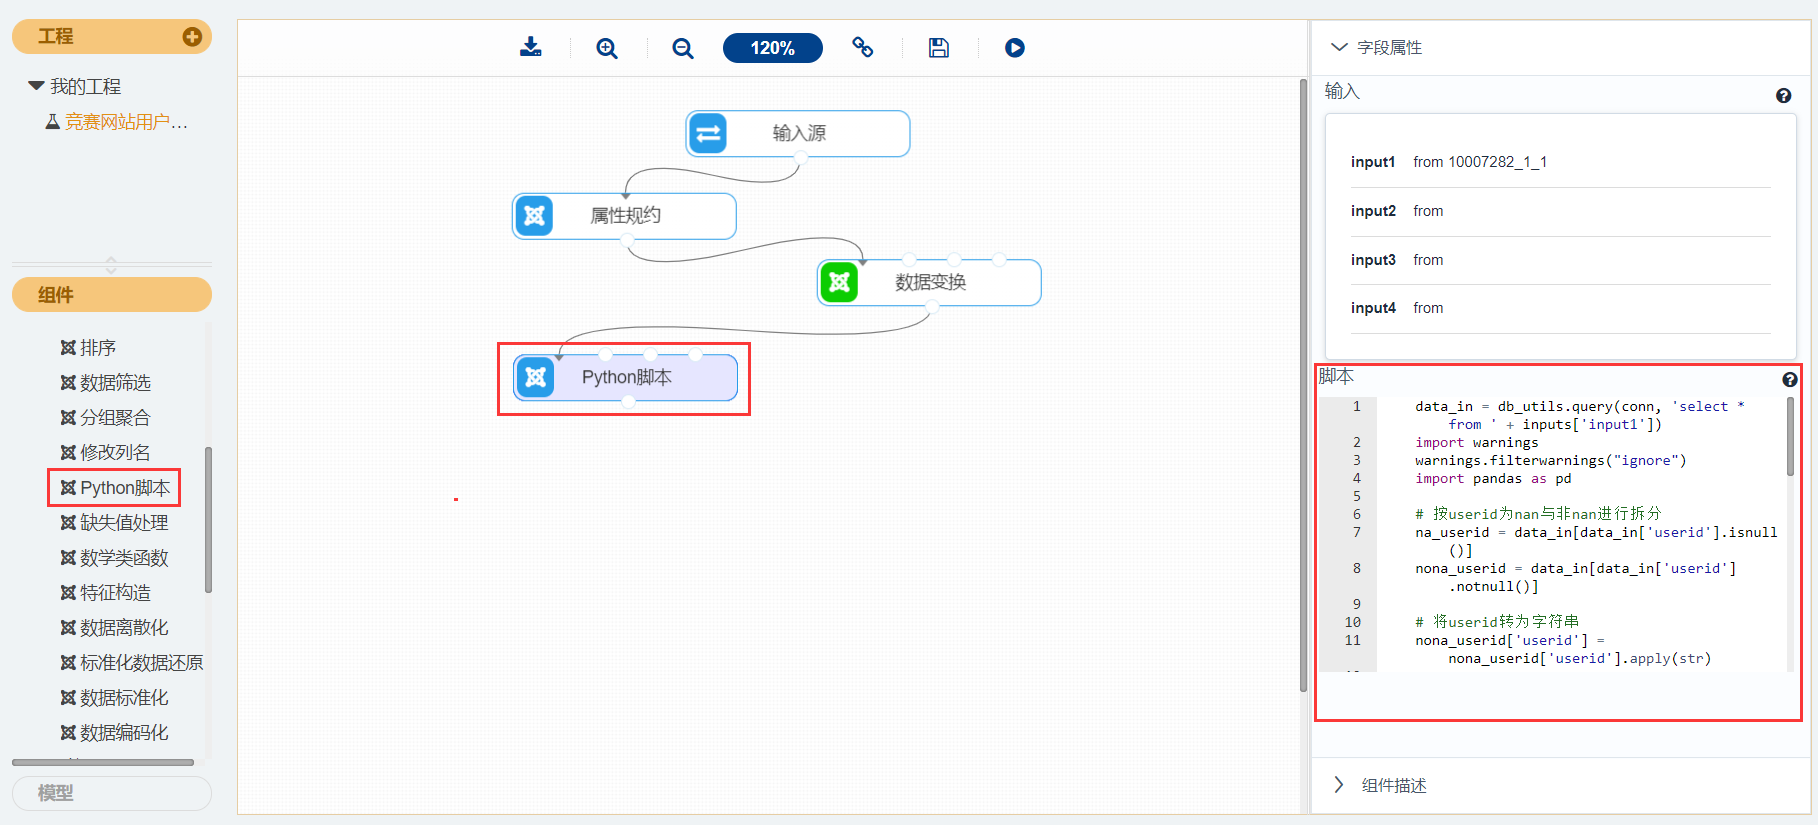
图 13 用户识别组件
表 3‑4 用户识别代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd

    # 按userid为nan与非nan进行拆分
    na_userid = data_in[data_in['userid'].isnull()]
    nona_userid = data_in[data_in['userid'].notnull()]

    # 将userid转为字符串
    nona_userid['userid'] = nona_userid['userid'].apply(str)

    # 对nona.userid数据集中的"userid"重新赋值
    # 如果uniqueVisitorId不为空则用它作为userid,若它为空则用ip作为userid
    # 将na.userid按uniqueVisitorId是否为空区分
    na_uniqueVisitiorId = na_userid[na_userid['uniquevisitorid'].isnull()]
    nona_uniqueVisitiorId = na_userid[na_userid['uniquevisitorid'].notnull()]

    # 替换
    na_uniqueVisitiorId['userid'] = na_uniqueVisitiorId['ip']
    nona_uniqueVisitiorId['userid'] = nona_uniqueVisitiorId['uniquevisitorid']

    # 数据整合
    user_data = pd.concat([nona_userid,na_uniqueVisitiorId,nona_uniqueVisitiorId])

    # 构造字段reallid
    userid = user_data['userid'].drop_duplicates()
    userid = pd.DataFrame({'userid' : userid,
                           'reallid' : range(1,userid.size+1)})
    user_data = user_data.merge(userid)

    del data_in,na_userid,nona_userid,na_uniqueVisitiorId,nona_uniqueVisitiorId,userid

    data_out = pd.DataFrame(user_data)

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 14所示。
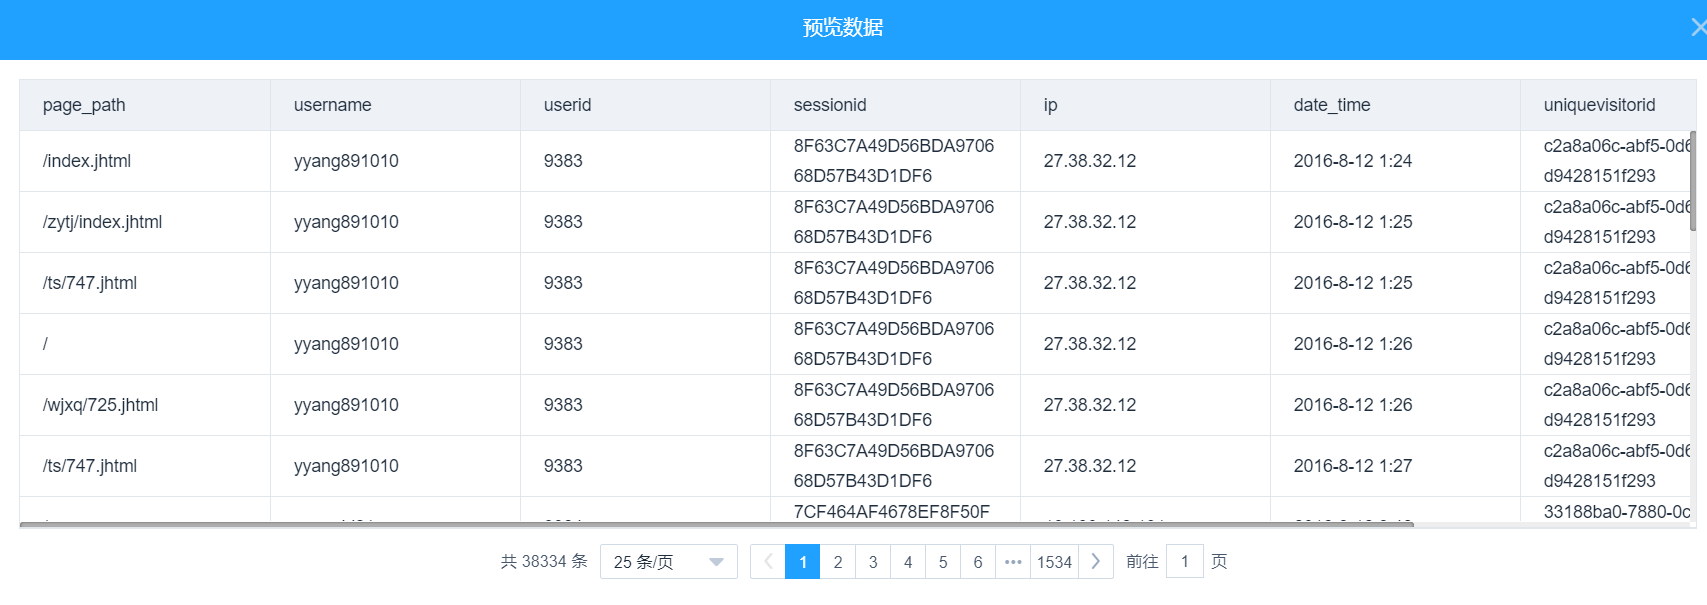
图 14 用户识别结果
-
运行完成后,对Python脚本组件右键,重命名为用户识别。
3.2.4行为分析
接下来进行行为分析,步骤如图 15所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将用户识别和Python脚本组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑5所示。
-
对Python脚本组件右键,选择运行该节点。
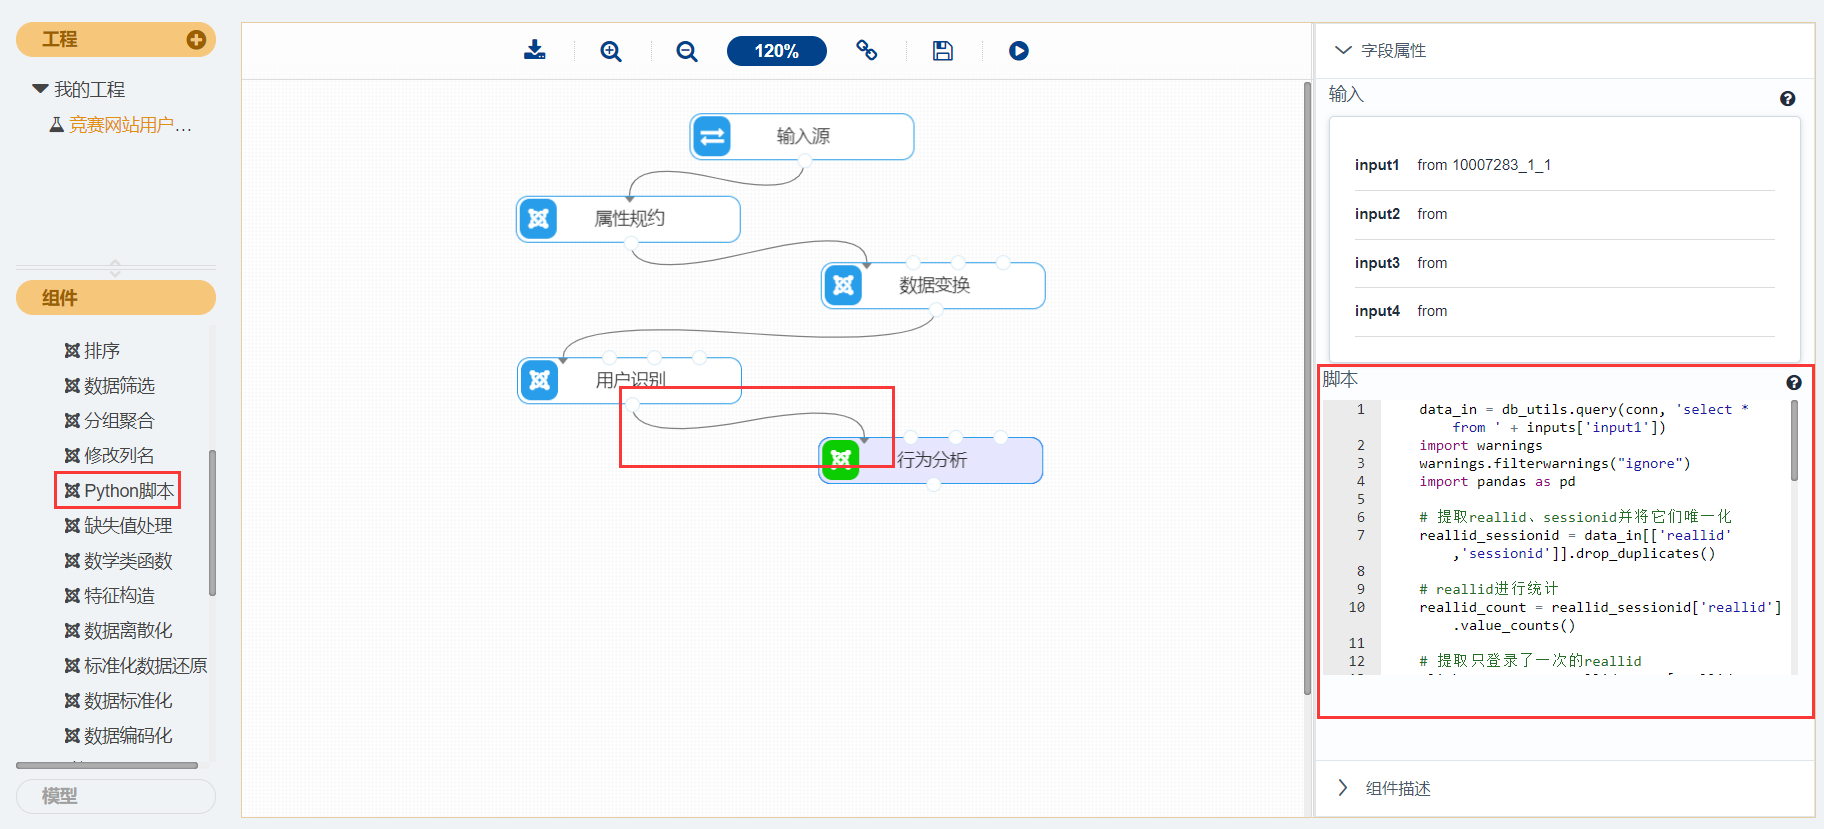
图 15 行为分析组件
表 3‑5 行为分析代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd

    # 提取reallid、sessionid并将它们唯一化
    reallid_sessionid = data_in[['reallid','sessionid']].drop_duplicates()

    # reallid进行统计
    reallid_count = reallid_sessionid['reallid'].value_counts()

    # 提取只登录了一次的reallid
    click_con_user = reallid_count[reallid_count == 1].index

    # 提取登录一次用户的原始点击数据
    click_con_data = data_in[data_in['reallid'].apply(lambda x:x in click_con_user)]

    # 按click.one.data中的reallID进行统计
    reallid_count_1 = click_con_data['reallid'].value_counts()

    # 提取只登录了一次且只点击了一个网页的用户
    one_click_user = reallid_count_1[reallid_count_1 == 1].index

    # 从原始数据中去掉闲逛人员的数据
    # 提取用户编号并唯一化
    user = data_in['reallid'].drop_duplicates()

    # 提取非"闲逛人员"的用户编号
    user_1 = pd.DataFrame(list(set(user).difference(one_click_user)))
    user_1.columns = ['reallid']

    # 提取非"闲逛人员"的原始数据
    new_data = pd.merge(data_in,user_1,how='inner',on='reallid')

    del data_in,reallid_sessionid,reallid_count,click_con_user,\
        click_con_data,reallid_count_1,one_click_user,user,user_1

    data_out = pd.DataFrame(new_data)

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 16所示。
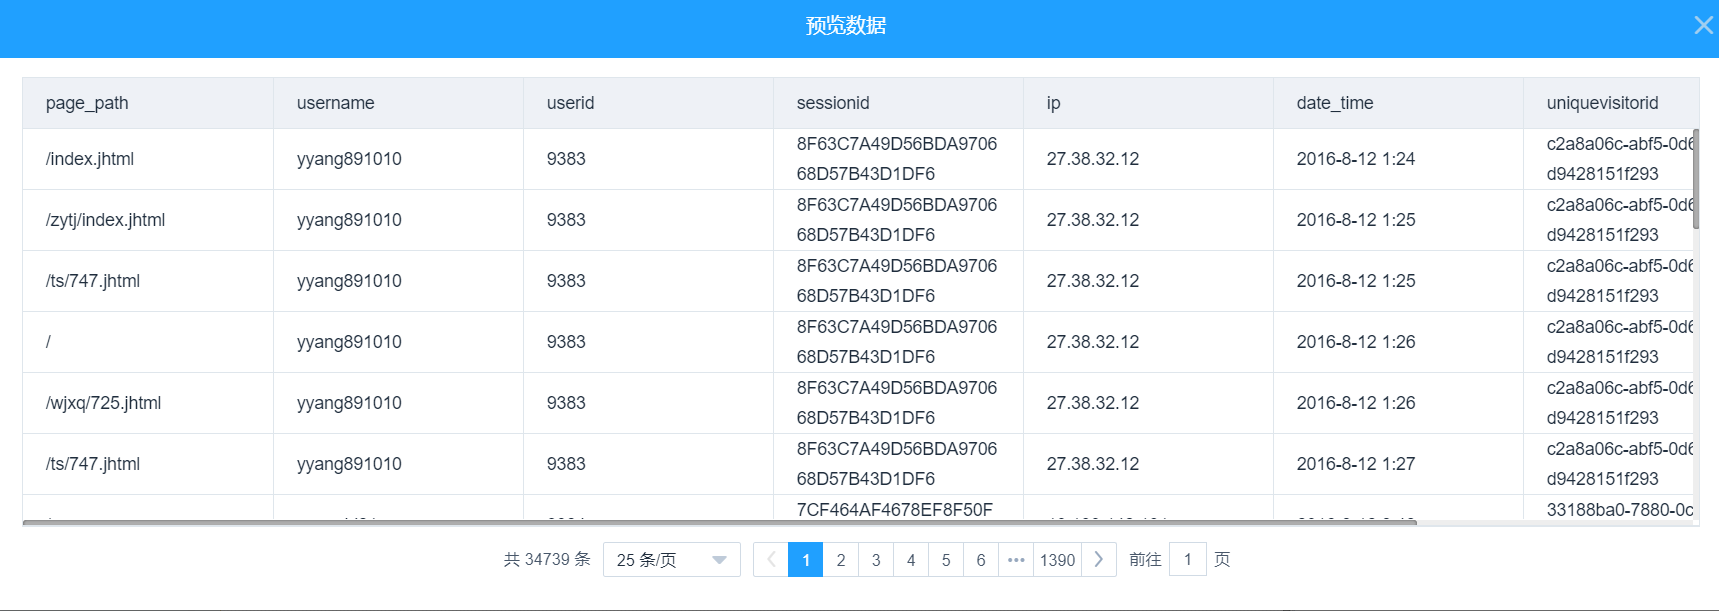
图 16 行为分析结果
-
运行完成后,对Python脚本组件右键,重命名为行为分析。
3.2.5网址分析
接下来进行网址分析,步骤如图 17所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将行为分析和Python脚本组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑6所示。
-
对Python脚本组件右键,选择运行该节点。
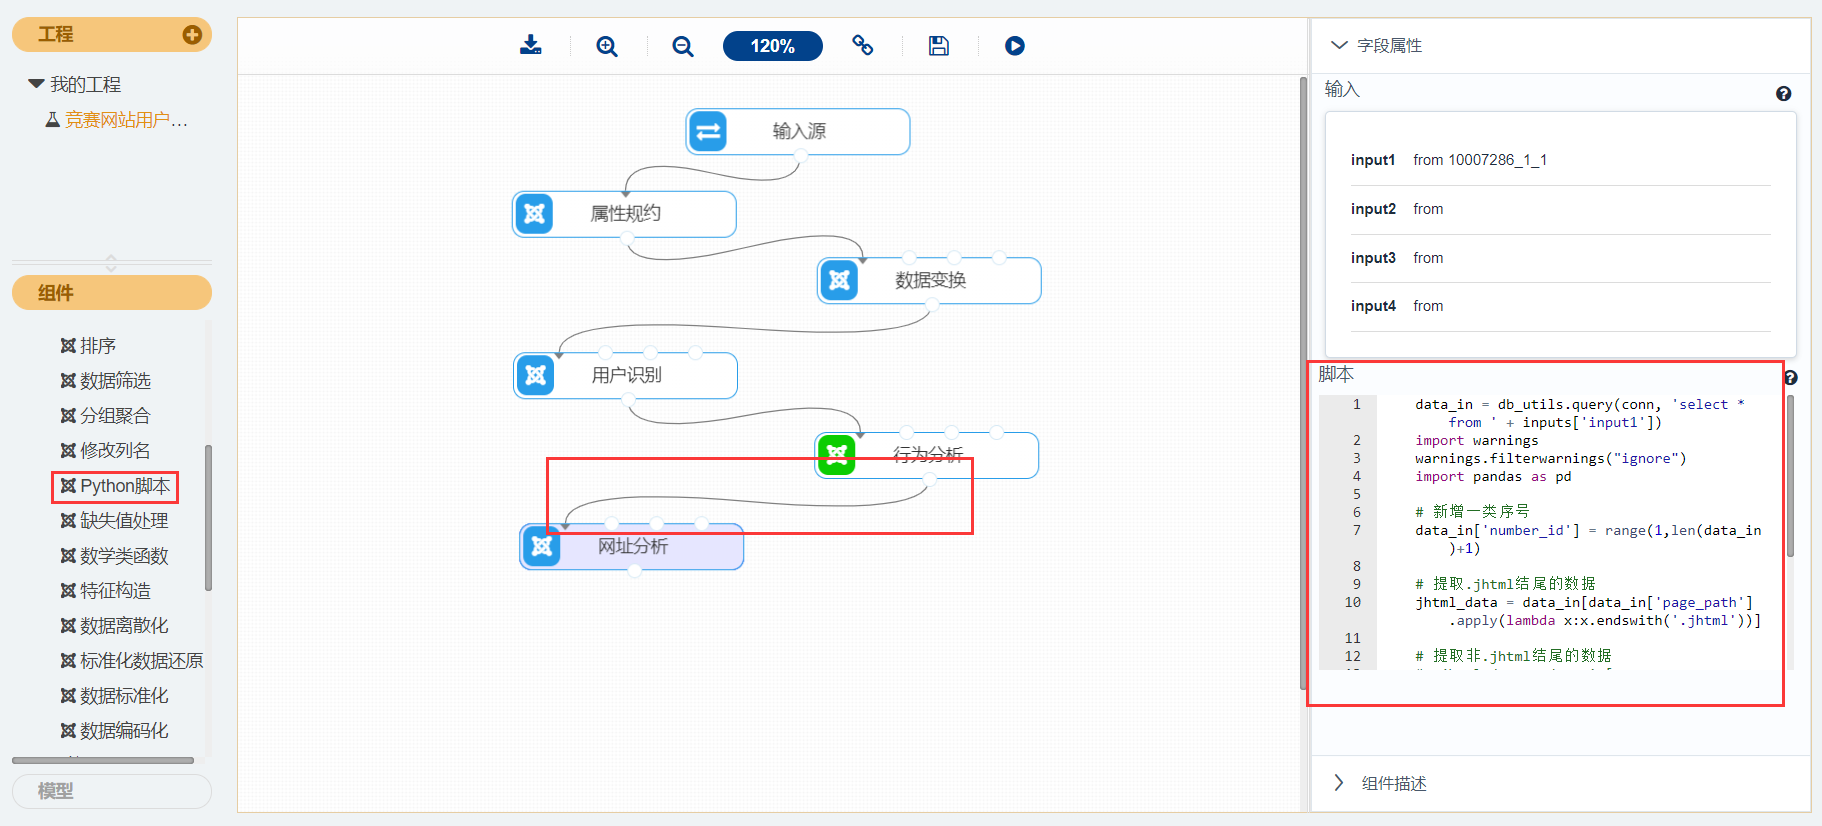
图 17 网址分析组件
表 3‑6 网址分析代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd

    # 新增一类序号
    data_in['number_id'] = range(1,len(data_in)+1)

    # 提取.jhtml结尾的数据
    jhtml_data = data_in[data_in['page_path'].apply(lambda x:x.endswith('.jhtml'))]

    # 提取非.jhtml结尾的数据
    #unjhtml_data = data_in[-data_in['number_id'].isin(jhtml_data['number_id'])]

    # 统计各非jhtml网址的个数
    #unjhtml_count = unjhtml_data['page_path'].value_counts()

    data_out = pd.DataFrame(jhtml_data)

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 18所示。
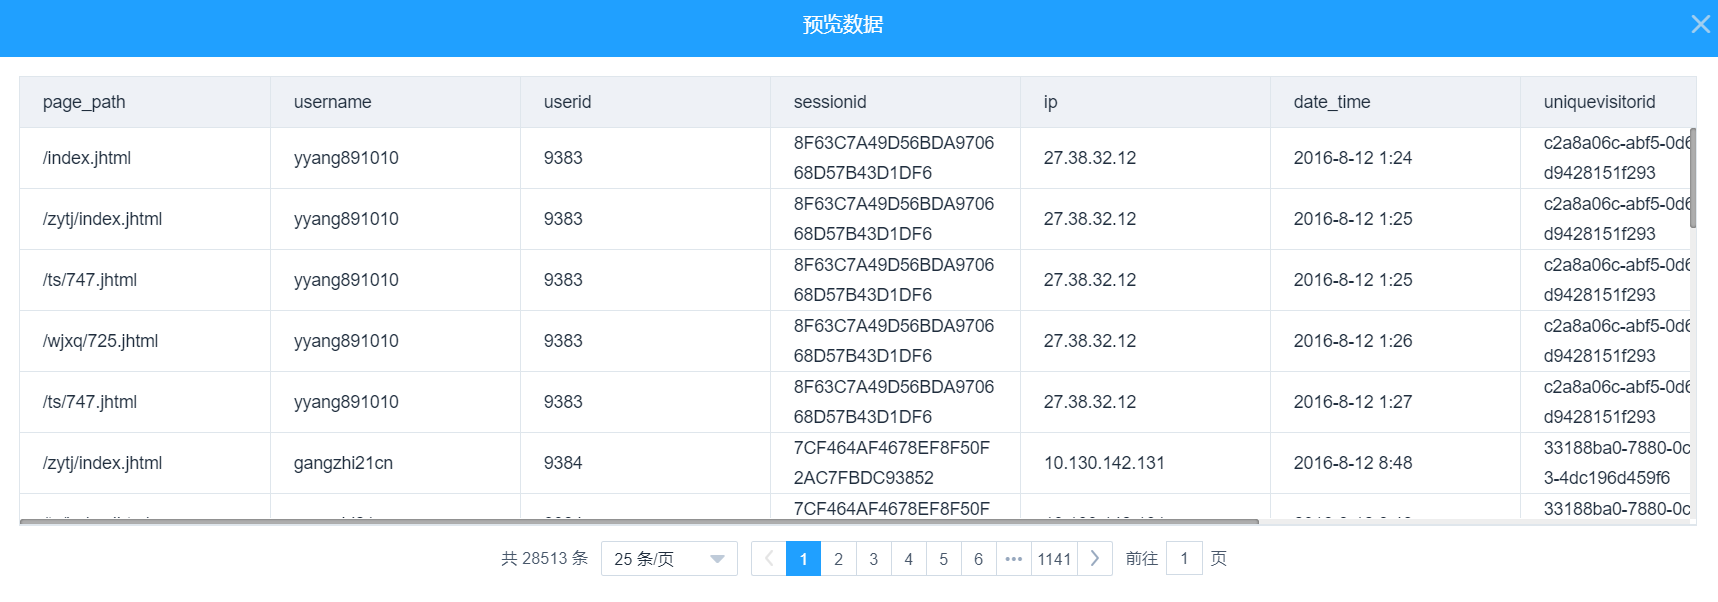
图 18 网址分析结果
-
运行完成后,对Python脚本组件右键,重命名为网址分析。
3.2.6数据清洗
接下来进行数据清洗,步骤如图 19所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将网址分析和Python组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑7所示。
-
对Python脚本组件右键,选择运行该节点。
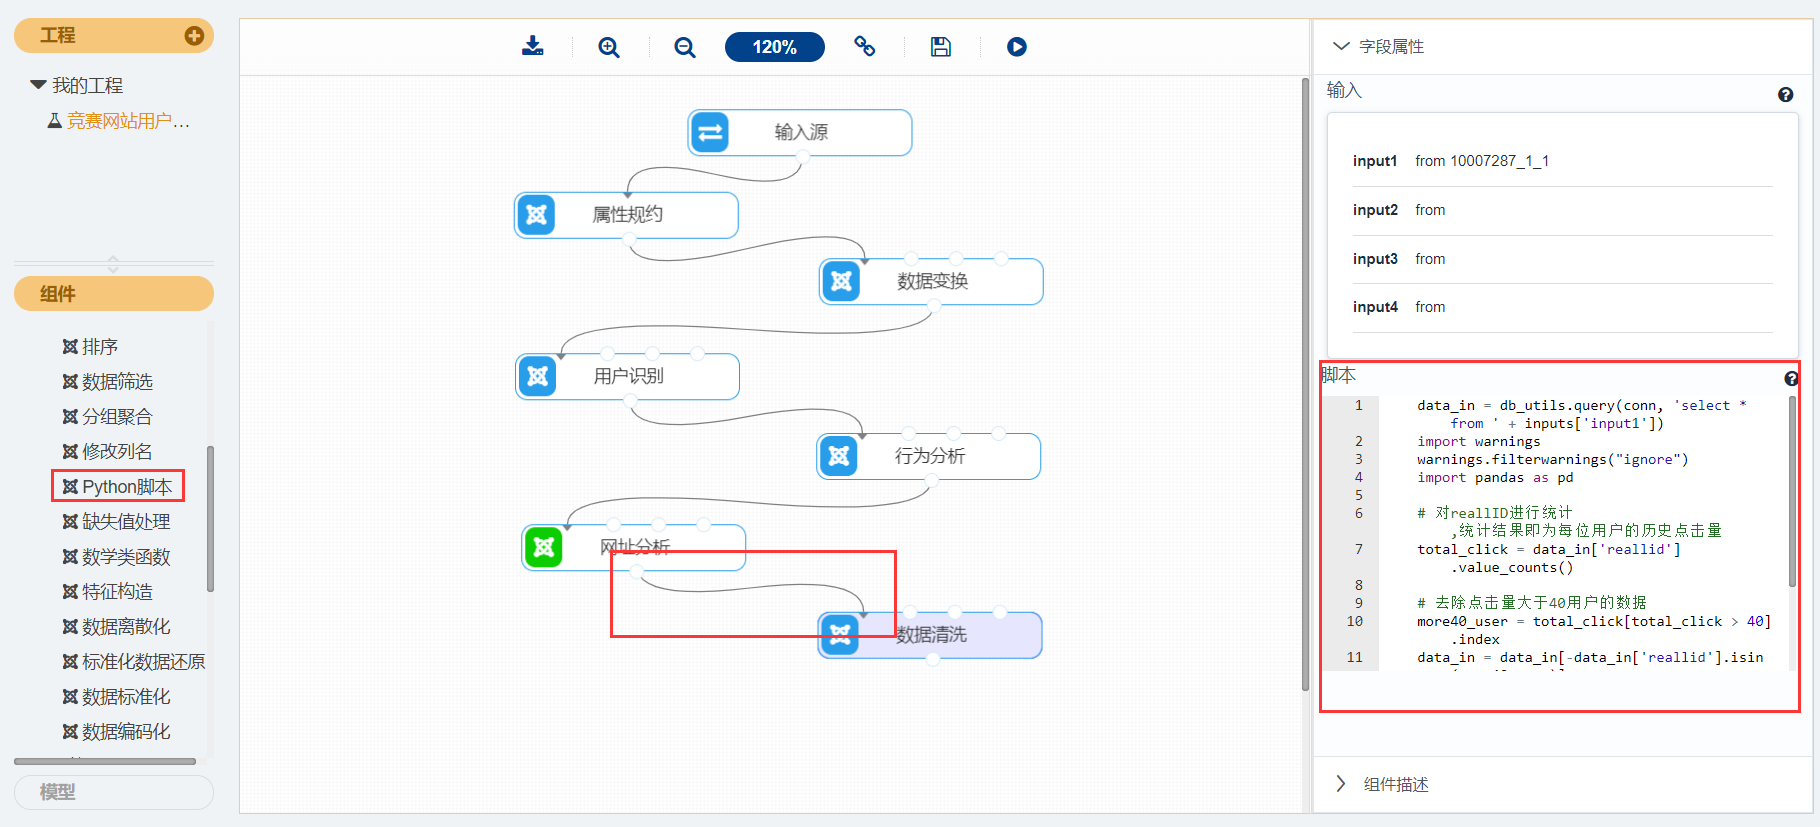
图 19 数据清洗组件
表 3‑7 数据清洗代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd

    # 对reallID进行统计,统计结果即为每位用户的历史点击量
    total_click = data_in['reallid'].value_counts()

    # 去除点击量大于40用户的数据
    more40_user = total_click[total_click > 40].index
    data_in = data_in[-data_in['reallid'].isin(more40_user)]

    del total_click,more40_user

    data_out = pd.DataFrame(data_in)

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 20所示。
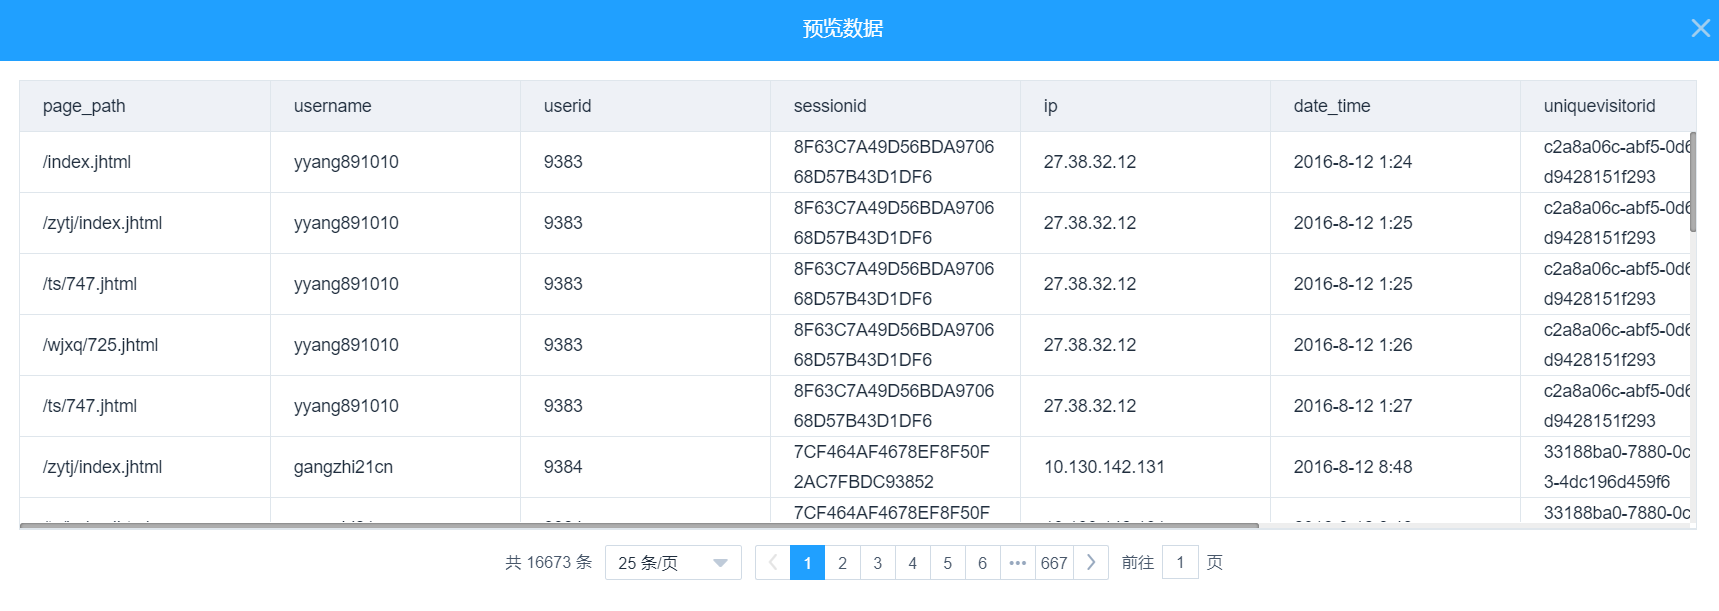
图 20 数据清洗结果
-
运行完成后,对Python脚本组件右键,重命名为数据清洗。
3.2.7网页分析
接下来进行数据清洗,步骤如图 21所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将数据清洗和Python组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑8所示。
-
对Python脚本组件右键,选择运行该节点。
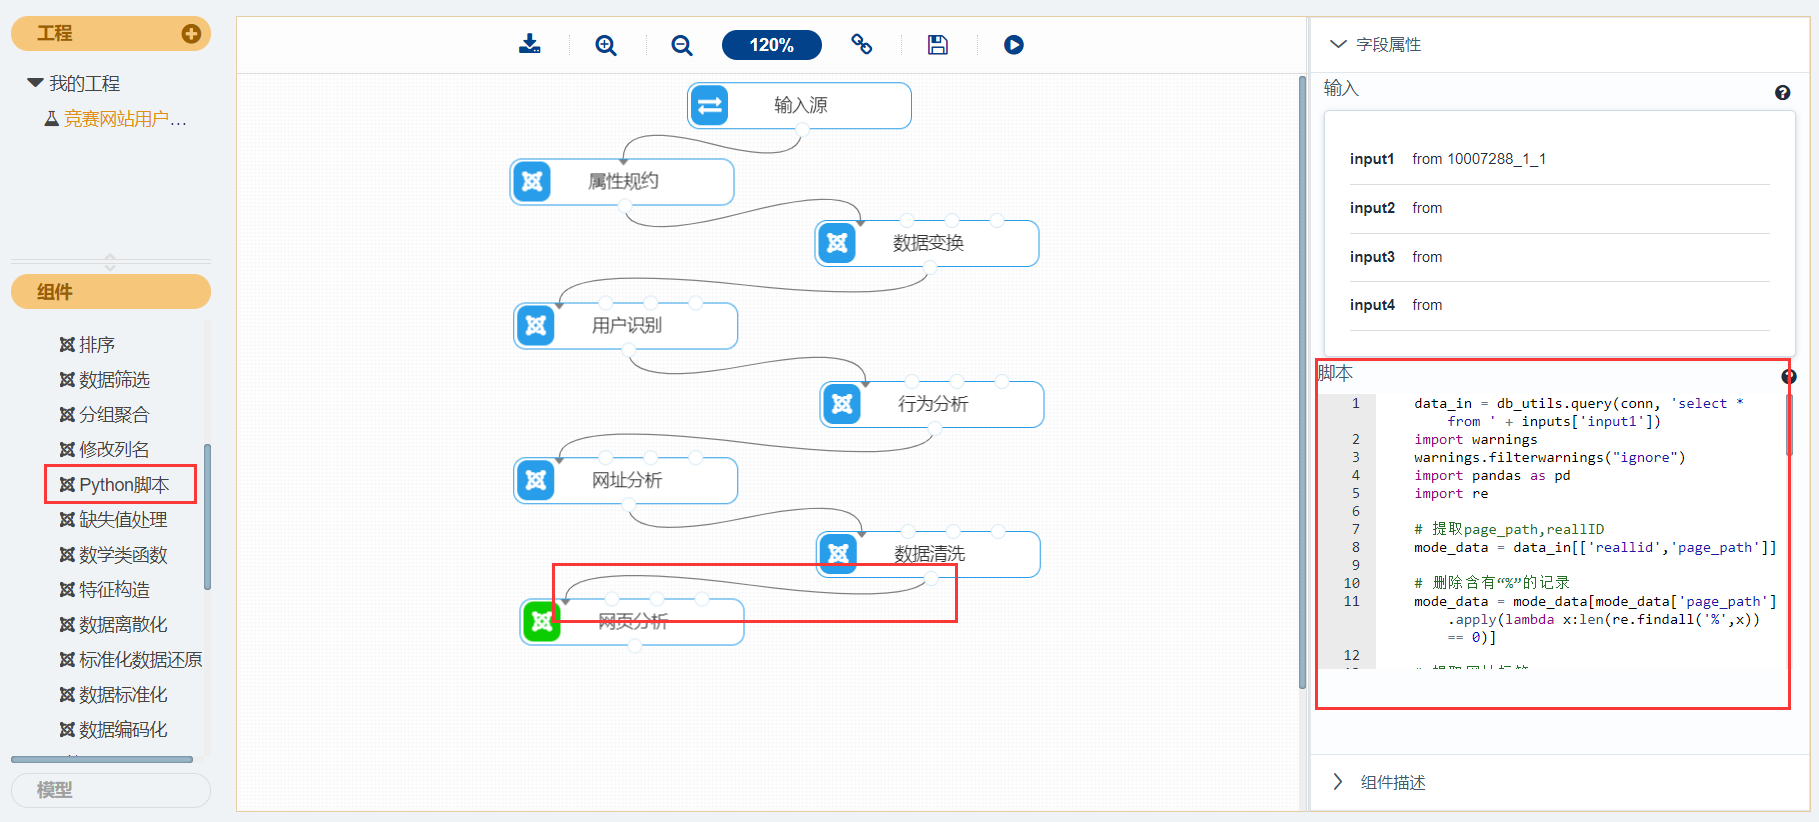
图 21 网页分析组件
表 3‑8 网页分析代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd
    import re

    # 提取page_path,reallID
    mode_data = data_in[['reallid','page_path']]

    # 删除含有“%”的记录
    mode_data = mode_data[mode_data['page_path'].apply(lambda x:len(re.findall('%',x)) == 0)]

    # 提取网址标签
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('.jhtml',''))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:re.sub('\d','',x))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('index',''))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('/',''))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('_',''))

    # 删除空数据 主页/index
    mode_data = mode_data[mode_data['page_path'] != '']

    # 统计网页内容符号数,删除一些异常的网页内容符号如:sdfasf、cook…
    url_conent = mode_data['page_path'].value_counts()
    url = url_conent.index

    error_url = ['dsjkf','sjfxs','jingsa','sdfasf','cookie','jiao','jao','asdf','sjsdf','jmg']
    url = url[~url.isin(error_url)]

    ## 网页汇总
    mode_data = mode_data[mode_data['page_path'].isin(url)]

    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('firsttipdm','yxzp'))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('secondtipdm','yxzp'))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('thirdtipdm','yxzp'))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('fourthtipdm','yxzp'))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('sm','jszz'))
    mode_data['page_path'] = mode_data['page_path'].apply(lambda x:x.replace('td','jszz'))

    mode_data = mode_data.groupby(['reallid','page_path']).size().unstack().fillna(0).reset_index()

    del url_conent,url,error_url

    data_out = pd.DataFrame(mode_data)

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 22所示。
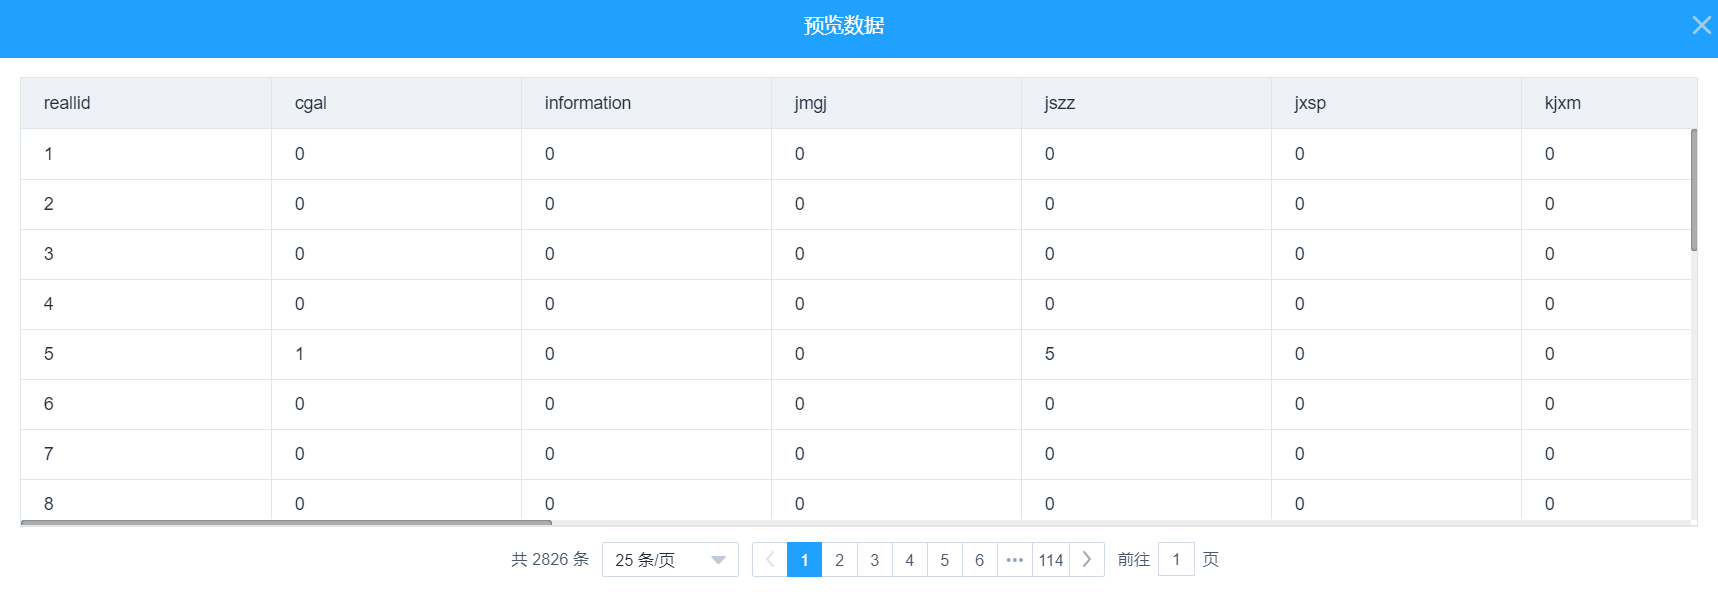
图 22 网页分析结果
-
运行完成后,对Python脚本组件右键,重命名为网页分析。
3.2.8属性构造
接下来进行数据清洗,步骤如图 23所示。
-
找到预处理→Python脚本组件。
-
拖入Python脚本组件,并将网页分析和Python组件连接。
-
选择字段属性,在脚本处填入数据变换代码,如表 3‑9所示。
-
对Python脚本组件右键,选择运行该节点。
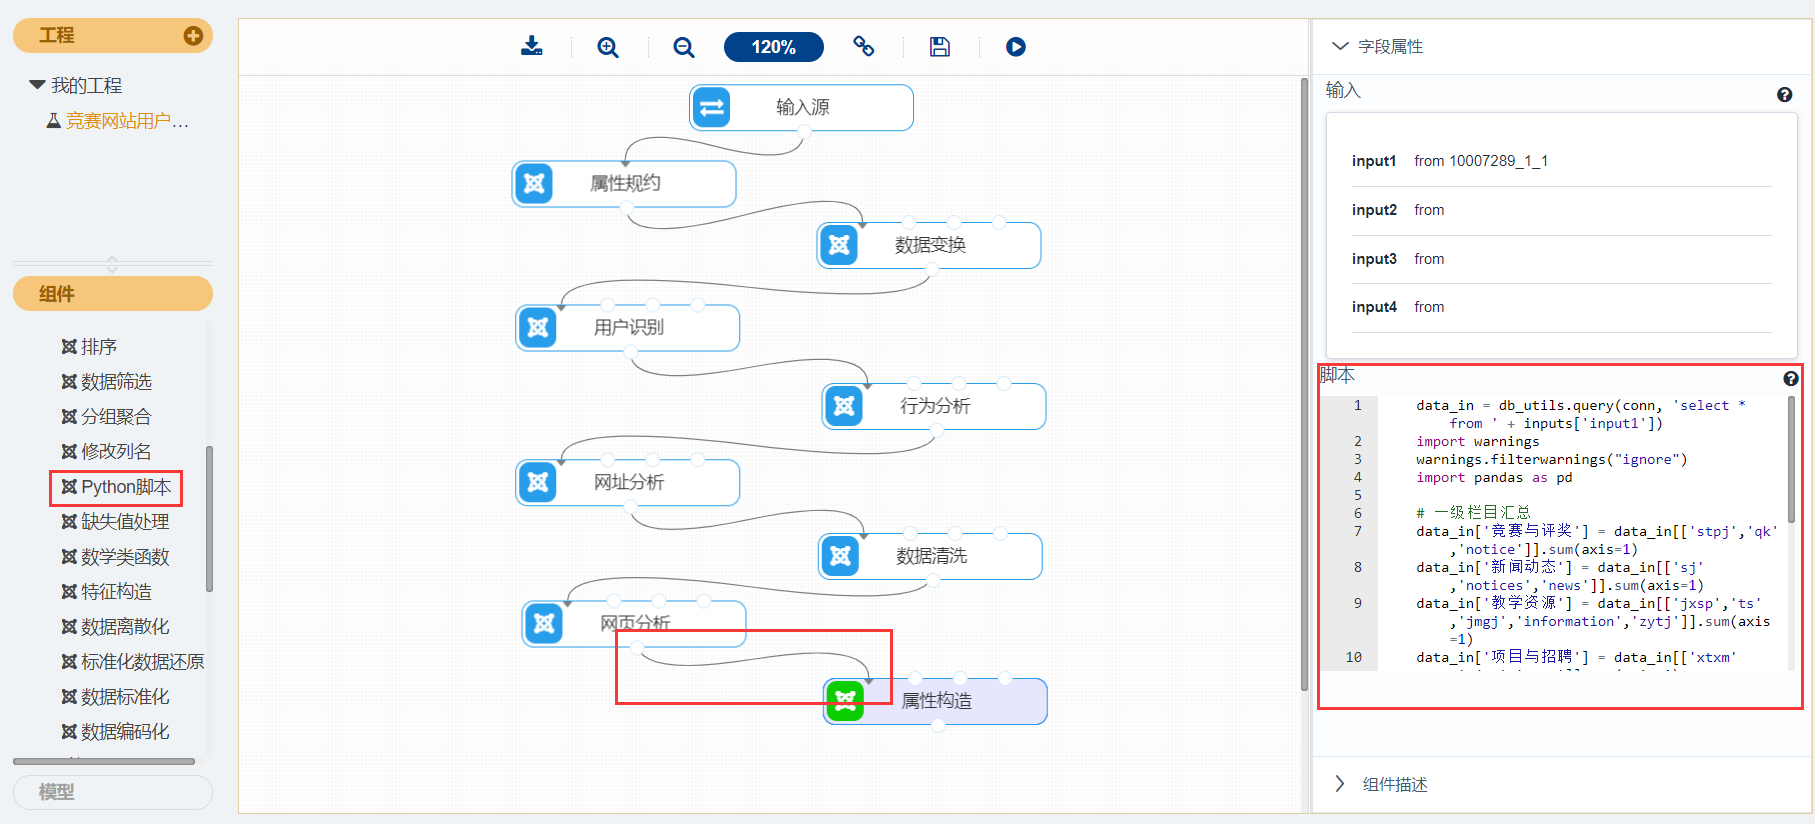
图 23 属性构造组件
表 3‑9 属性构造代码
data_in = db_utils.query(conn, 'select * from ' + inputs['input1'])
    import warnings
    warnings.filterwarnings("ignore")
    import pandas as pd

    # 一级栏目汇总
    data_in['竞赛与评奖'] = data_in[['stpj','qk','notice']].sum(axis=1)
    data_in['新闻动态'] = data_in[['sj','notices','news']].sum(axis=1)
    data_in['教学资源'] = data_in[['jxsp','ts','jmgj','information','zytj']].sum(axis=1)
    data_in['项目与招聘'] = data_in[['xtxm','wjxq','zxns']].sum(axis=1)
    data_in['创新与合作'] = data_in[['cgal','kjxm','qyal','zzszl']].sum(axis=1)
    data_in['优秀作品'] = data_in[['yxzp']].sum(axis=1)
    data_in['竞赛组织'] = data_in[['jszz']].sum(axis=1)

    # 提取建模数据,即:建模样本表
    data_in = data_in[['reallid','竞赛与评奖','新闻动态','教学资源','项目与招聘','创新与合作','优秀作品','竞赛组织']]
    data_in.rename(columns={'reallid':'用户编号'},inplace = True)

    data_out = pd.DataFrame(data_in)

    return(data_out)
-
运行完成后,对Python脚本组件右键,选择查看数据,如图 24所示。
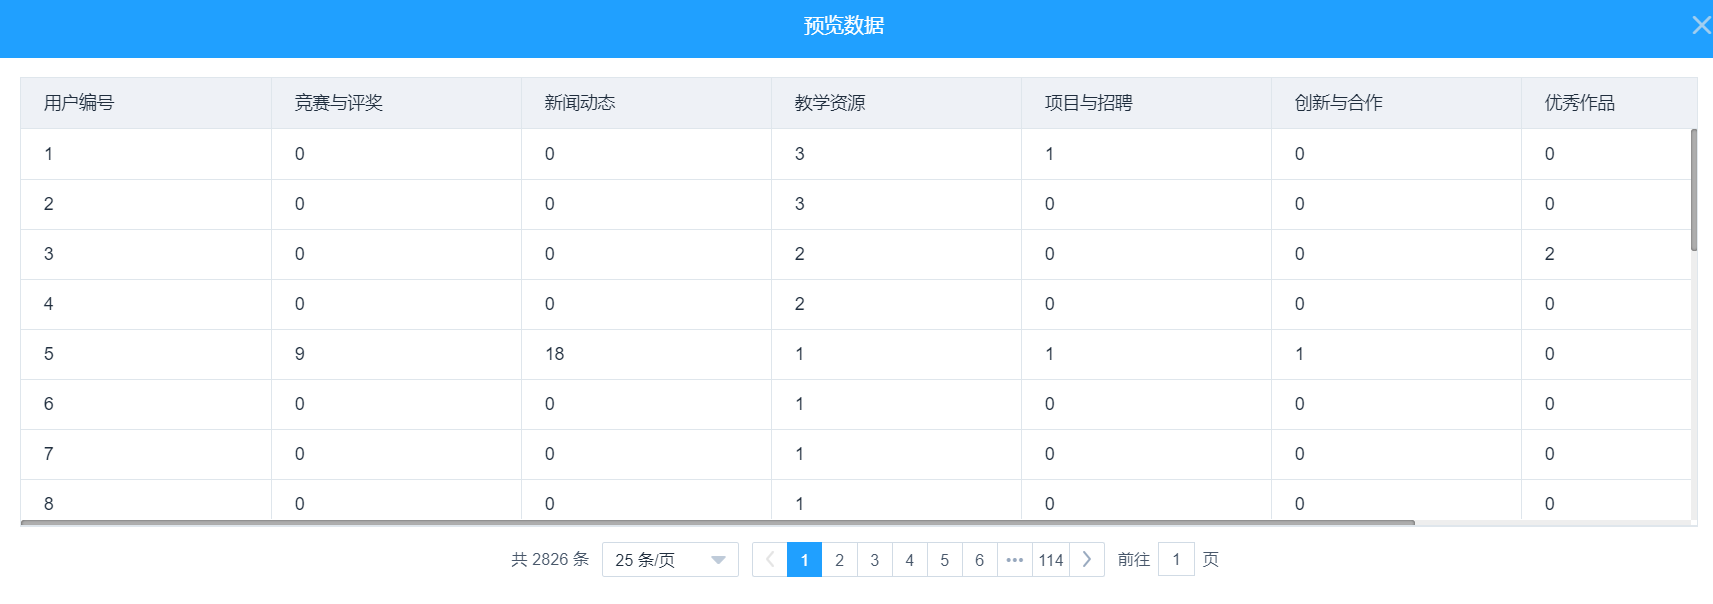
图 24 属性构造结果
-
运行完成后,对Python脚本组件右键,重命名为属性构造。
3.3模型构建
3.3.1K-Means聚类算法
选择K-Means聚类算法模型,步骤如图 25、图 26所示。
-
找到聚类→K-Means组件。
-
拖入K-Means组件,将属性构造和K-Means组件连接。
-
选择字段属性,单击更新数据,勾选除了用户编号外的全部字段。
-
选择参数设置,设置聚类数(n_clusters)的值为5,其他的参数都设置为默认值。
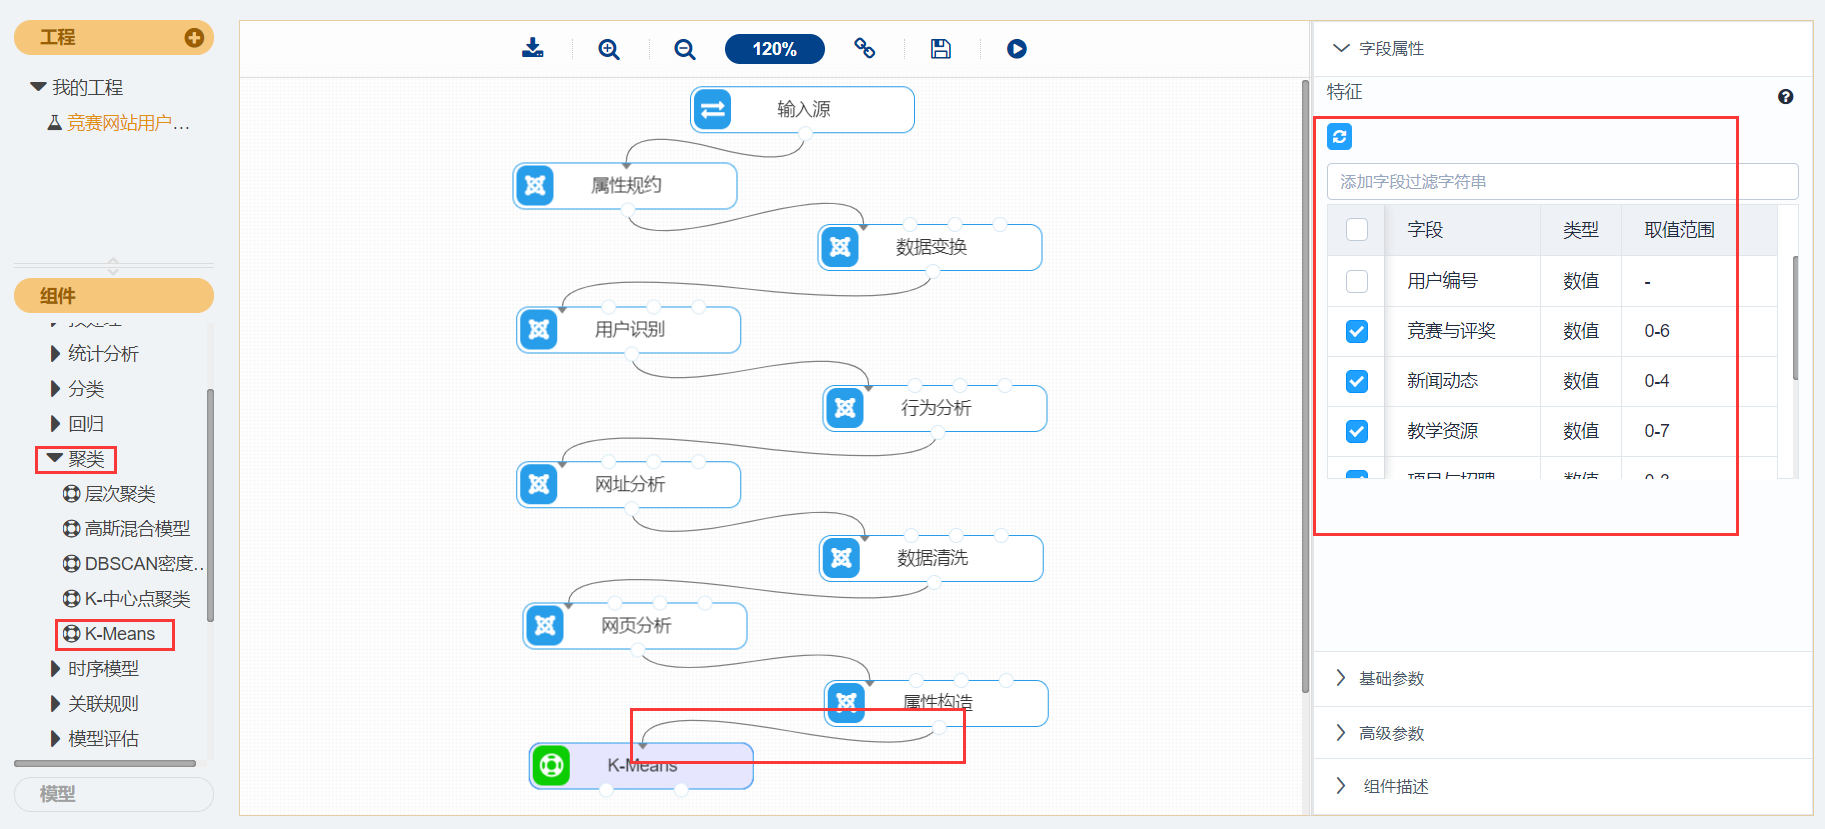
图 25 K-Means聚类组件_字段属性
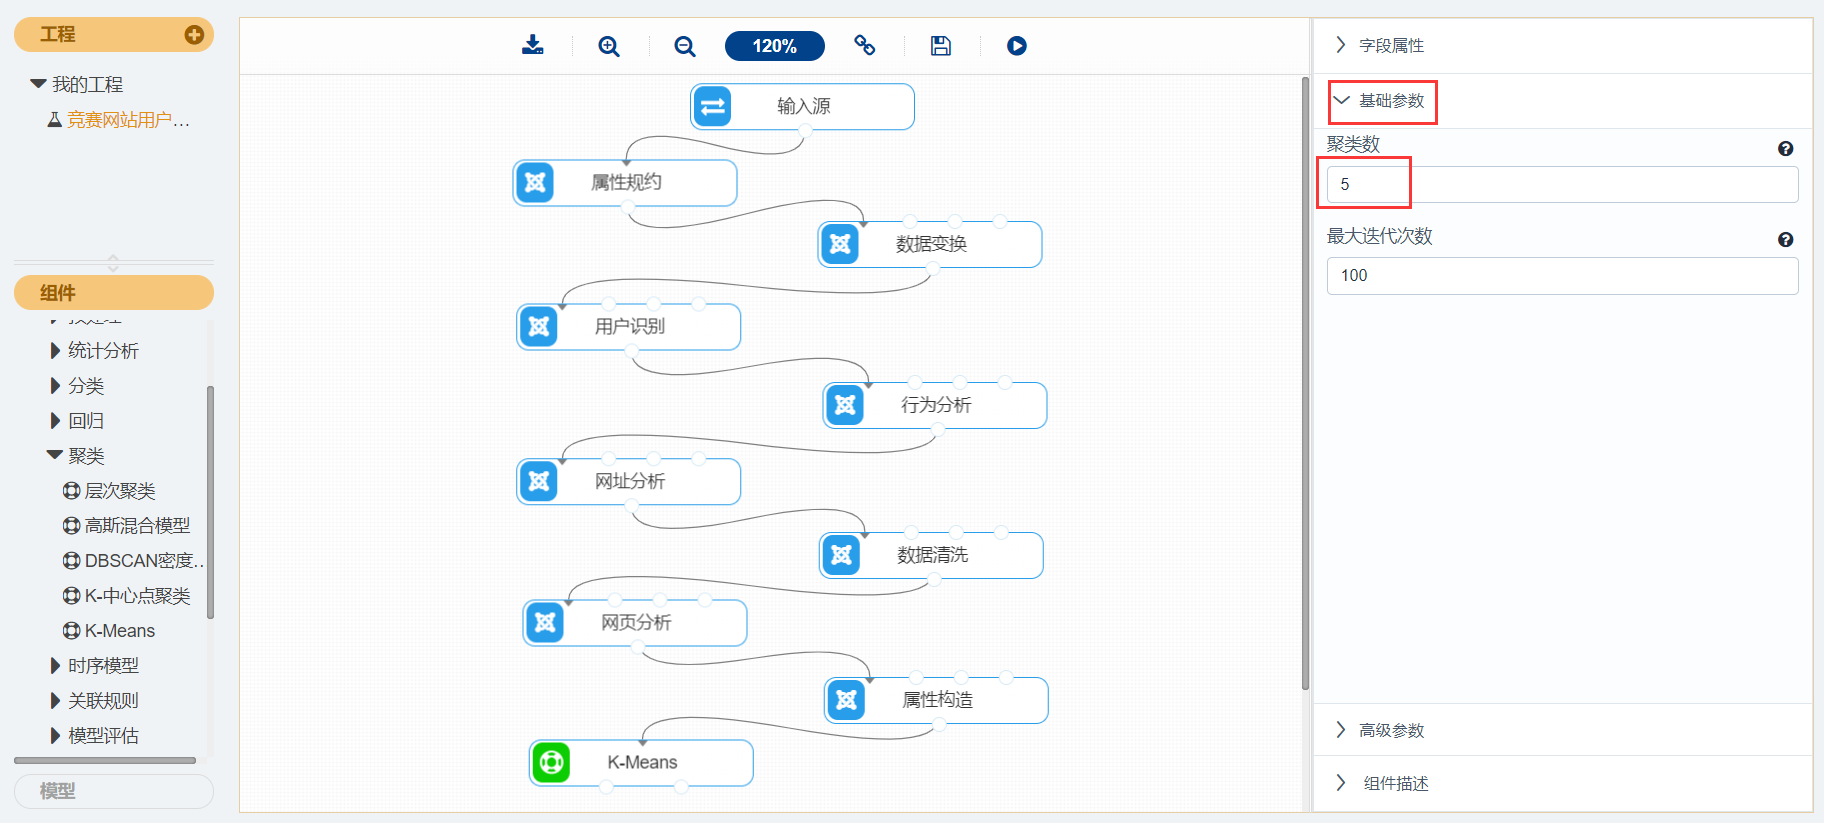
图 26 K-Means组件_参数设置
-
运行完成后,对K-Means组件右键,选择查看数据,K-Means的输出表结果如图 27所示。选择查看报告,K-Means的报告如图 28所示。
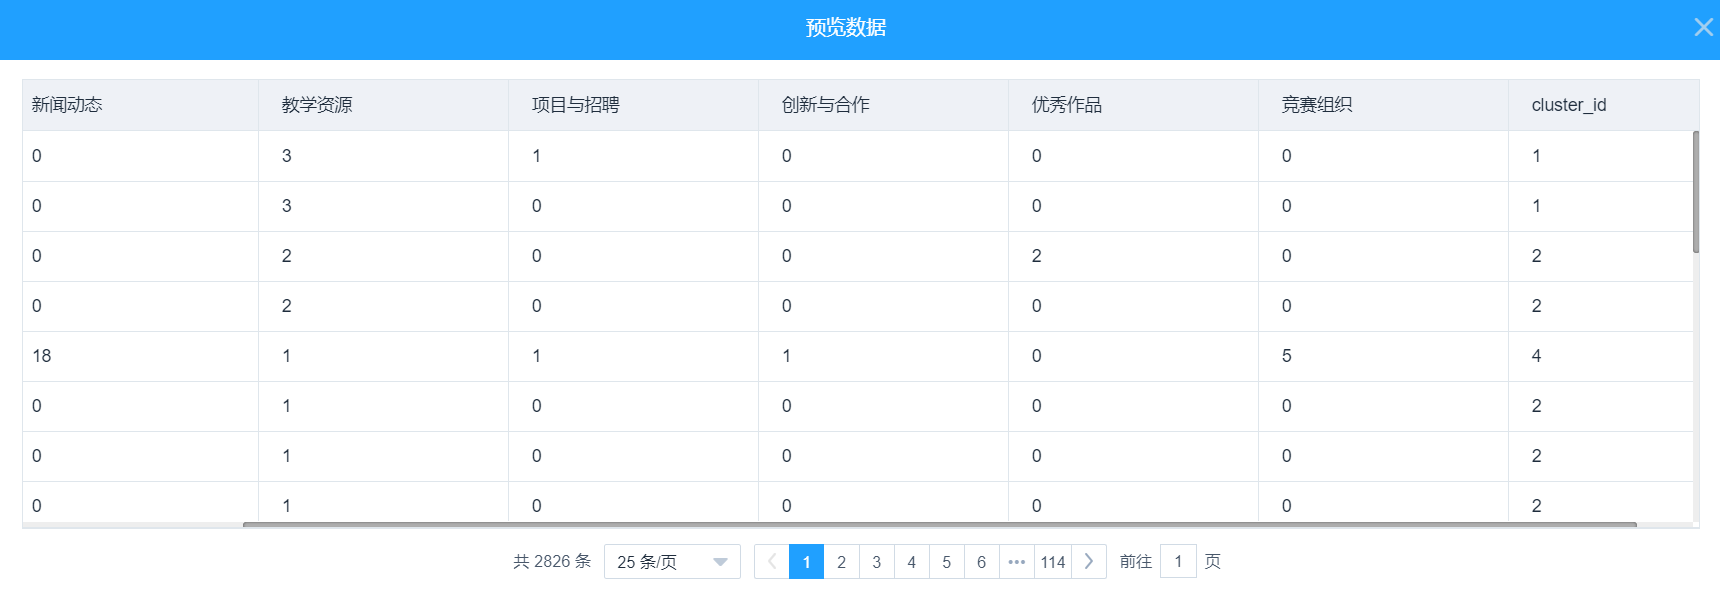
图 27 K-Means聚类算法的结果
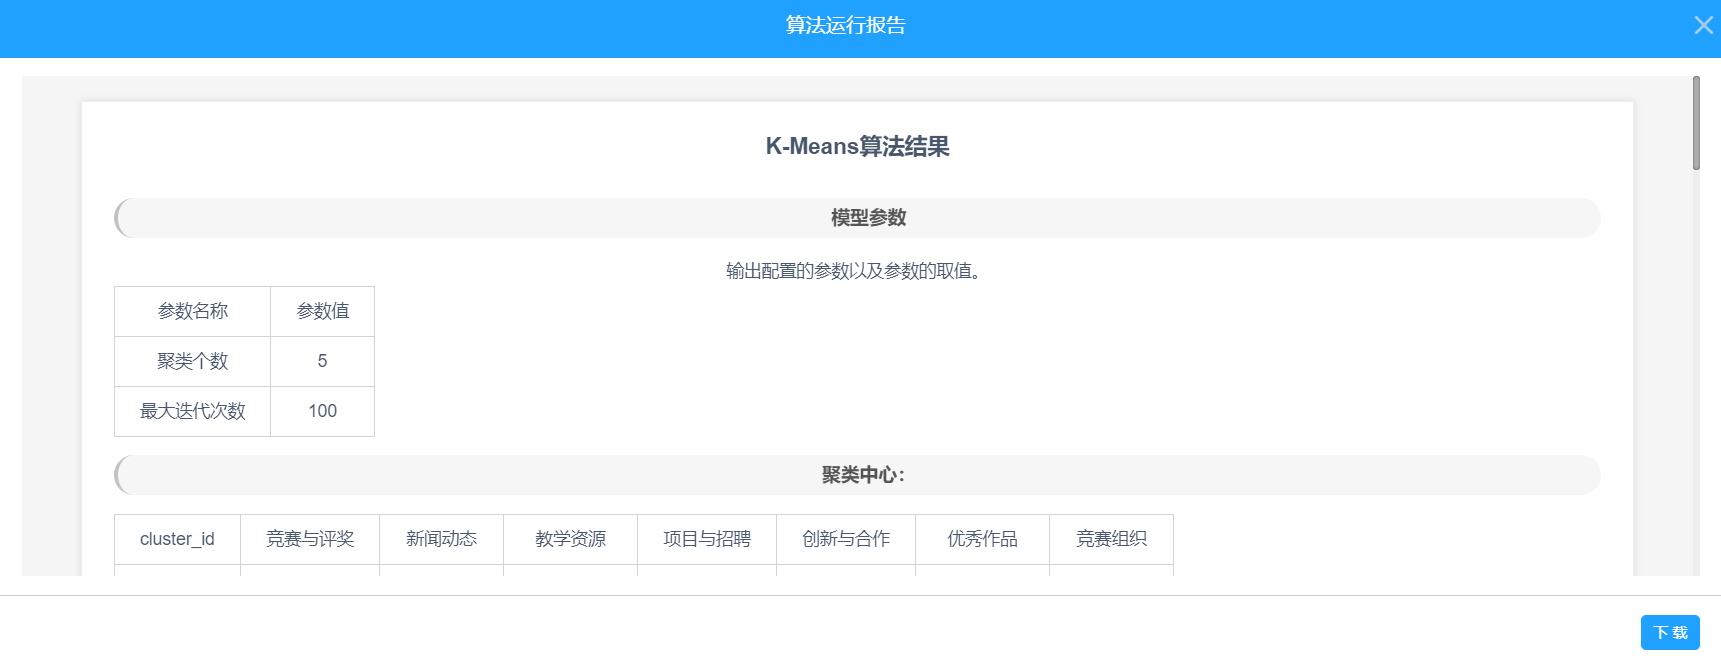
图 28 K-Means聚类算法的报告
试用请访问:https://eb.tipdm.org:10078,自行注册即可。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 33
 0
- 0


 已为社区贡献8条内容

所有评论(0)