统计学习导论—基于R应用(第四章)
第四章
# Lab: Classification Methods
#逻辑斯谛回归、LDA、QDA和KNN
## The Stock Market Data股票市场数据
###
library(ISLR2)
names(Smarket)#Smarket股票市场
dim(Smarket)#1250天里500股票指数的投资回报率
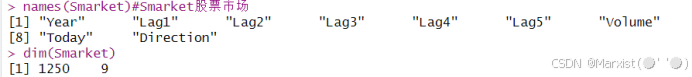
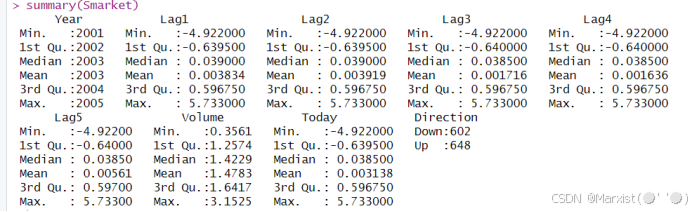
summary(Smarket)
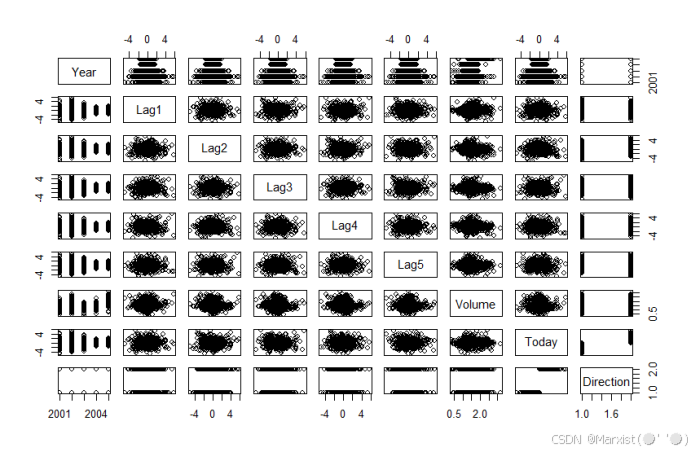
pairs(Smarket)#找出不同股票或者不同市场指标之间之间的配对关系
###
cor(Smarket)#运行错误,因为Direction变量是定性的
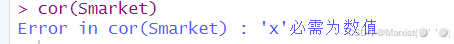
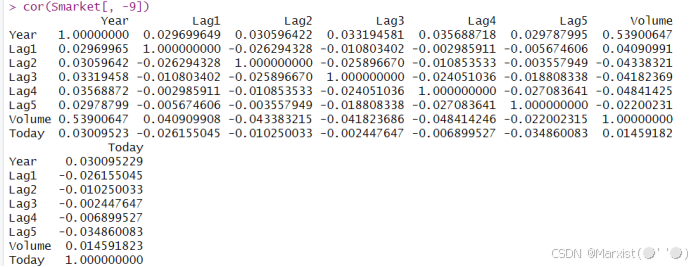
cor(Smarket[, -9])
#cor计算相关性矩阵
#[, -9]从 Smarket 数据集中删除第9列的数据,然后计算剩余列之间的相关性
###
attach(Smarket)
plot(Volume)#volume一直随时间增长,即2001年至2005年平均每日股票成交量在增长

## Logistic Regression逻辑斯谛回归
###拟合逻辑斯谛回归模型来预测Direction
glm.fits <- glm(
Direction ~ Lag1 + Lag2 + Lag3 + Lag4 + Lag5 + Volume,
data = Smarket, family = binomial
)
#glm()函数用于拟合广义线性模型
#family = binomial执行逻辑斯谛回归,而不使用其他类型的广义线性模型
summary(glm.fits)
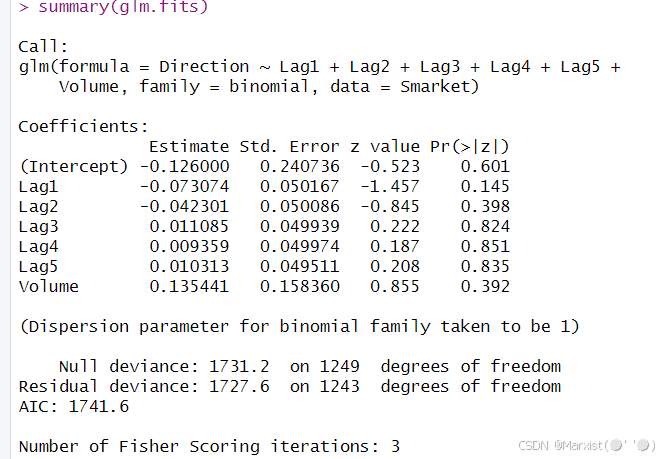
这里最小的 p值是 L.ag1的系数。预测变量负的系数表明如果市场昨天的投资回报率是正的,那么今日市场可能不会上涨。然而,p值0.15仍然是比较大的,所以没有充分的证据表明Lag1和 Direction 之间有确切的关联。
###
coef(glm.fits)#获取拟合模型的系数

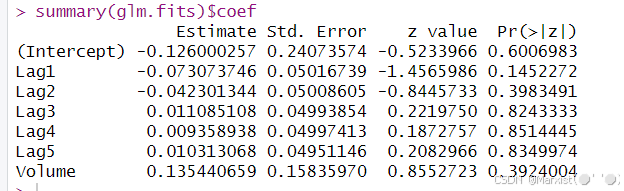
summary(glm.fits)$coef#获取拟合模型其他方面的信息
summary(glm.fits)$coef[, 4]

###
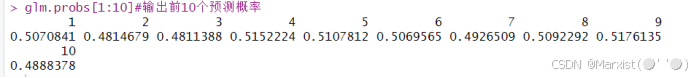
glm.probs <- predict(glm.fits, type = "response")
#predict()预测在给定预测变量值下市场上涨的概率
glm.probs[1:10]#输出前10个预测概率
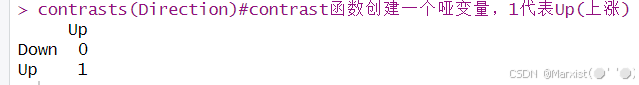
contrasts(Direction)#contrast函数创建一个哑变量,1代表Up(上涨)
###
glm.pred <- rep("Down", 1250)#创建一个由1250个Down元素组成的向量
glm.pred[glm.probs > .5] = "Up"#预测市场上涨概率超过0.5的元素转变为Up
###
table(glm.pred, Direction)#产生混淆矩阵来判断有多少观测被正确或错误的分类
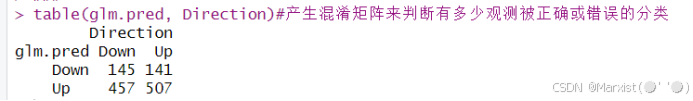
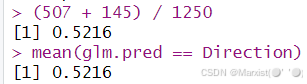
(507 + 145) / 1250#652天正确预测
mean(glm.pred == Direction)#计算正确预测比例
###
train <- (Year < 2005)#train表示2001年至2004年之间的观测
Smarket.2005 <- Smarket[!train, ]#定义余下的2005年观测数据集
dim(Smarket.2005)
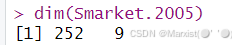
Direction.2005 <- Direction[!train]
#train是一个布尔向量,其元素只取FALSE和TRUE两个值
#布尔向量可用于获取某个矩阵的行和列子集
###
glm.fits <- glm(
Direction ~ Lag1 + Lag2 + Lag3 + Lag4 + Lag5 + Volume,
data = Smarket, family = binomial, subset = train
)
glm.probs <- predict(glm.fits, Smarket.2005,
type = "response")
###
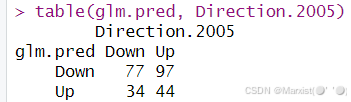
#训练只是用2005年之前的数据,而测试是使用2005年的数据,最后计算出2005年的预测并与真实的市场走势作比较。
glm.pred <- rep("Down", 252)
glm.pred[glm.probs > .5] <- "Up"
table(glm.pred, Direction.2005)
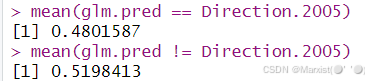
mean(glm.pred == Direction.2005)
mean(glm.pred != Direction.2005)#!=表示不等,即计算测试错误率
###只用Lag1和Lag2两个预测变量,因为它们在原逻辑斯谛回归模型中表现出了最佳的预测能力
glm.fits <- glm(Direction ~ Lag1 + Lag2, data = Smarket,
family = binomial, subset = train)
glm.probs <- predict(glm.fits, Smarket.2005,
type = "response")
glm.pred <- rep("Down", 252)
glm.pred[glm.probs > .5] <- "Up"
table(glm.pred, Direction.2005)
mean(glm.pred == Direction.2005)
106 / (106 + 76)
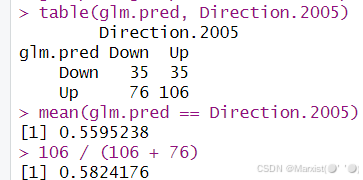
现在的结果改进了,56%的市场动向能够被正确预测。
###
predict(glm.fits,
newdata =
data.frame(Lag1 = c(1.2, 1.5), Lag2 = c(1.1, -0.8)),
type = "response"
)#预测Diretion
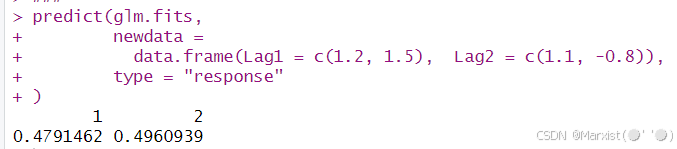
## Linear Discriminant Analysis线性判别分析
###
library(MASS)
#lda()函数拟合一个LDA模型
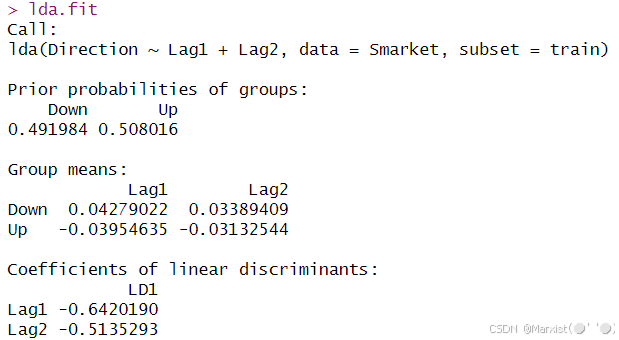
lda.fit <- lda(Direction ~ Lag1 + Lag2, data = Smarket,
subset = train)
lda.fit
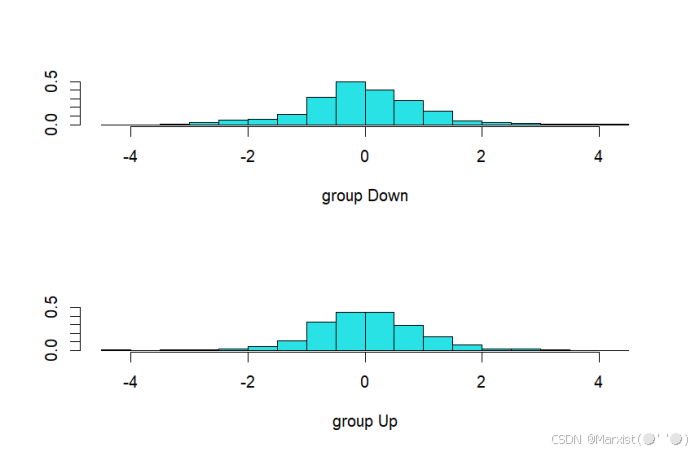
plot(lda.fit)#生成线性判别图像
###
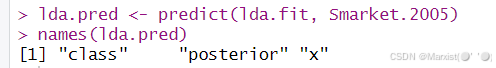
lda.pred <- predict(lda.fit, Smarket.2005)
names(lda.pred)
###
lda.class <- lda.pred$class
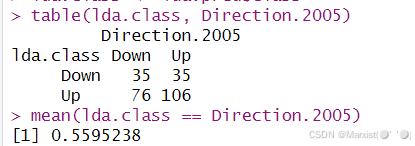
table(lda.class, Direction.2005)
mean(lda.class == Direction.2005)
#LDA与逻辑斯谛回归预测的结果几乎一样
###
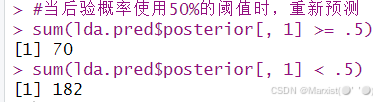
#当后验概率使用50%的阈值时,重新预测
sum(lda.pred$posterior[, 1] >= .5)
sum(lda.pred$posterior[, 1] < .5)
###
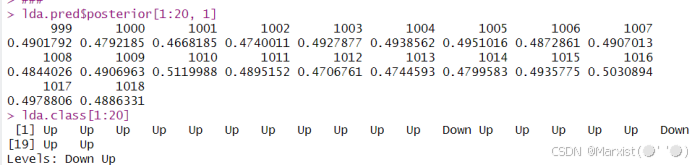
#模型的后验概率对应着市场下跌的概率
lda.pred$posterior[1:20, 1]
lda.class[1:20]
###
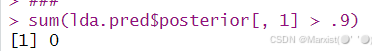
sum(lda.pred$posterior[, 1] > .9)
## Quadratic Discriminant Analysis二次判别分析
###对Smarket数据拟合QDA模型
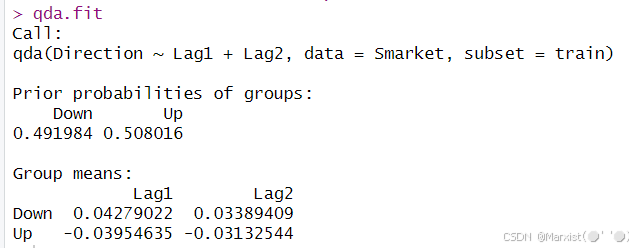
qda.fit <- qda(Direction ~ Lag1 + Lag2, data = Smarket,
subset = train)
qda.fit
###
#输出包含类平均值,但是不包含线性判别系数,因为QDA分类器是一个二次函数,不是预测变量的线性函数
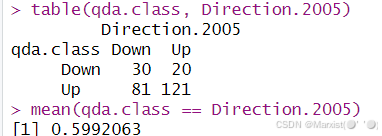
qda.class <- predict(qda.fit, Smarket.2005)$class
table(qda.class, Direction.2005)
mean(qda.class == Direction.2005)
## Naive Bayes朴素贝叶斯
###
library(e1071)
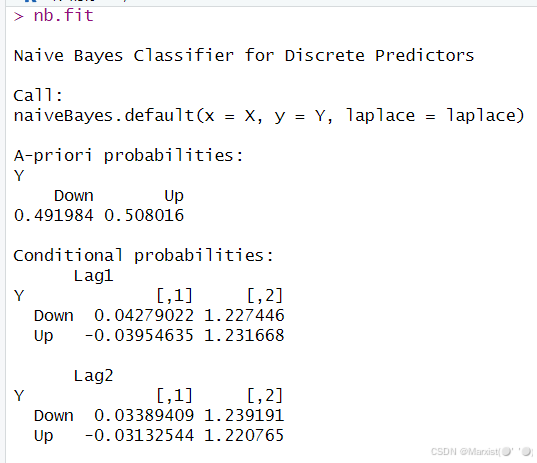
nb.fit <- naiveBayes(Direction ~ Lag1 + Lag2, data = Smarket,
subset = train)
nb.fit
###
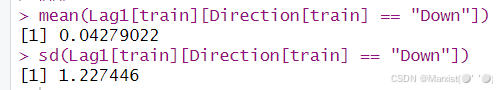
mean(Lag1[train][Direction[train] == "Down"])
sd(Lag1[train][Direction[train] == "Down"])
###
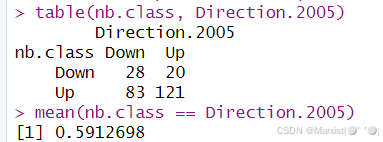
nb.class <- predict(nb.fit, Smarket.2005)
table(nb.class, Direction.2005)
mean(nb.class == Direction.2005)
###
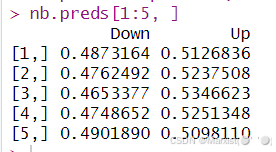
nb.preds <- predict(nb.fit, Smarket.2005, type = "raw")
nb.preds[1:5, ]
## $K$-Nearest Neighbors K最近邻法
###
library(class)
train.X <- cbind(Lag1, Lag2)[train, ]#包含与训练数据相关的预测变量矩阵
test.X <- cbind(Lag1, Lag2)[!train, ]#包含与预测数据相关的预测变量矩阵
train.Direction <- Direction[train]#包含训练观测类标签的向量
###
set.seed(1)#设置一个随机种子
knn.pred <- knn(train.X, test.X, train.Direction, k = 1)#用knn()来预测2005年市场动向
table(knn.pred, Direction.2005)
(83 + 43) / 252
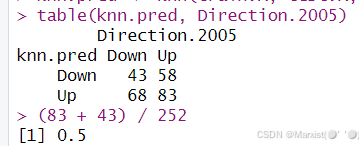
#K=1时结果不理想,正确预测概率为50%,可能因为K=1模型过于光滑
###
knn.pred <- knn(train.X, test.X, train.Direction, k = 3)#K=3
table(knn.pred, Direction.2005)
mean(knn.pred == Direction.2005)
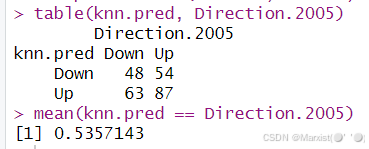
#结果略有改观,正确预测概率为53.57%
###Caravan大篷车保险数据的一个应用
dim(Caravan)
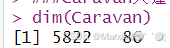
包括85个预测变量,测量了5822人的人口特征
attach(Caravan)
summary(Purchase)
348 / 5822
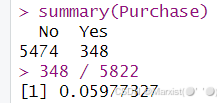
在该数据集中,只有6%的人购买了大篷车保险
###
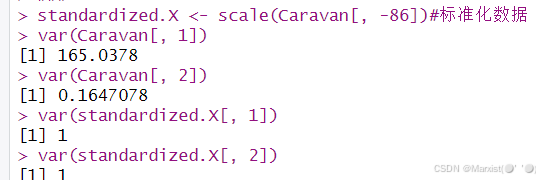
standardized.X <- scale(Caravan[, -86])#标准化数据
var(Caravan[, 1])
var(Caravan[, 2])
var(standardized.X[, 1])
var(standardized.X[, 2])
###
test <- 1:1000#把观测分为一个包含前1000个观测的测试集和一个由其余观测构成的训练集
train.X <- standardized.X[-test, ]
test.X <- standardized.X[test, ]
train.Y <- Purchase[-test]
test.Y <- Purchase[test]
set.seed(1)
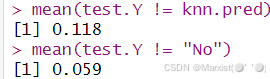
knn.pred <- knn(train.X, test.X, train.Y, k = 1)#K=1
mean(test.Y != knn.pred)
mean(test.Y != "No")
###
table(knn.pred, test.Y)
9 / (68 + 9)
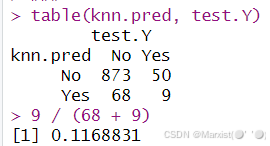
K=1时,有9名,即11.7%的人购买了保险
###
knn.pred <- knn(train.X, test.X, train.Y, k = 3)#K=3
table(knn.pred, test.Y)
5 / 26
knn.pred <- knn(train.X, test.X, train.Y, k = 5)#K=5
table(knn.pred, test.Y)
4 / 15
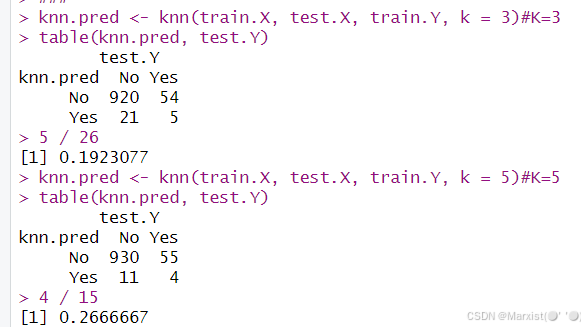
当K=3时,成功率增加至19%;K=5时,成功率变为26.7%
###
glm.fits <- glm(Purchase ~ ., data = Caravan,
family = binomial, subset = -test)
glm.probs <- predict(glm.fits, Caravan[test, ],
type = "response")
glm.pred <- rep("No", 1000)
glm.pred[glm.probs > .5] <- "Yes"
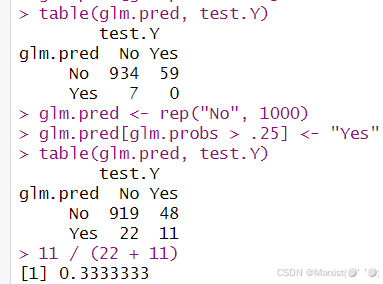
table(glm.pred, test.Y)
glm.pred <- rep("No", 1000)
glm.pred[glm.probs > .25] <- "Yes"
table(glm.pred, test.Y)
11 / (22 + 11)
## Poisson Regression泊松回归
###
attach(Bikeshare)
dim(Bikeshare)
names(Bikeshare)
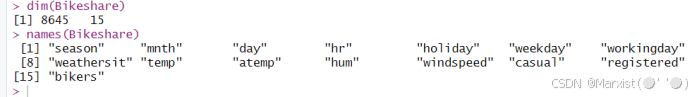
###
mod.lm <- lm(
bikers ~ mnth + hr + workingday + temp + weathersit,
data = Bikeshare
)
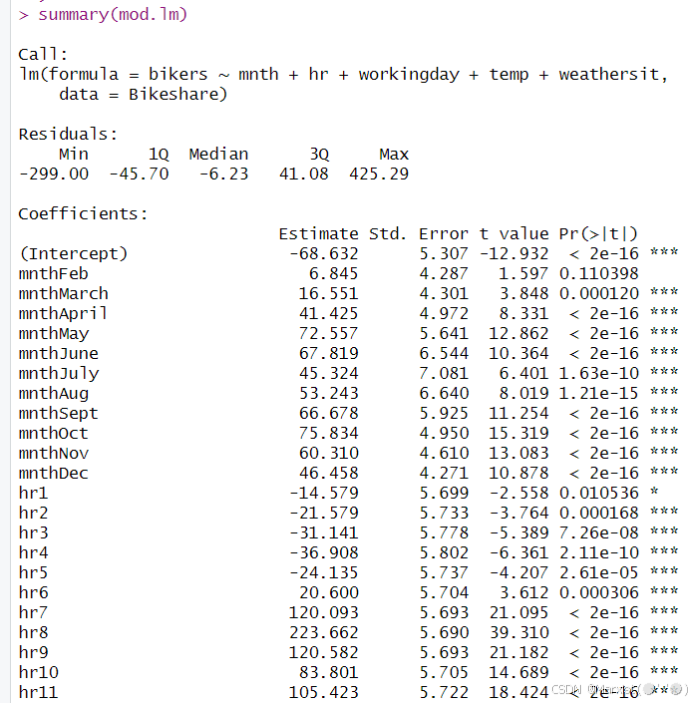
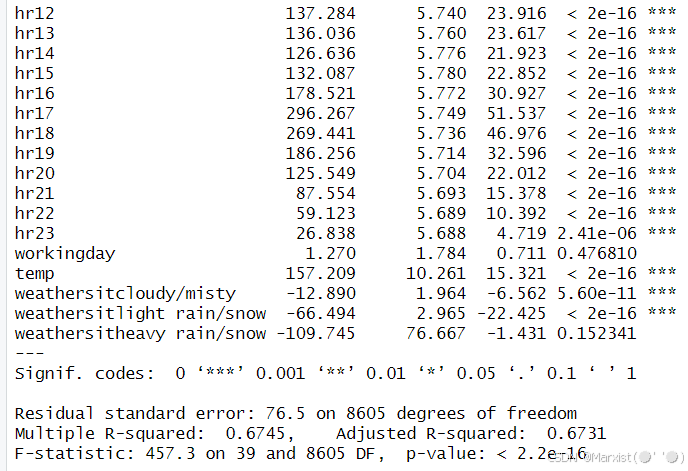
summary(mod.lm)
###
contrasts(Bikeshare$hr) = contr.sum(24)#contr.sum()函数用于创建一个对比矩阵
contrasts(Bikeshare$mnth) = contr.sum(12)
mod.lm2 <- lm(
bikers ~ mnth + hr + workingday + temp + weathersit,
data = Bikeshare
)
summary(mod.lm2)
###
sum((predict(mod.lm) - predict(mod.lm2))^2)
###
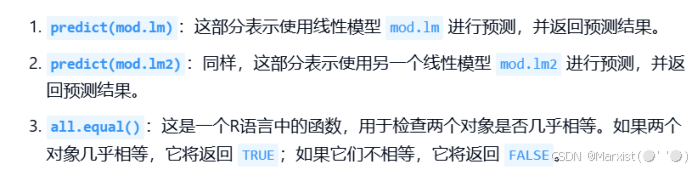
all.equal(predict(mod.lm), predict(mod.lm2))#用于比较两个预测结果是否相等的表达式
###
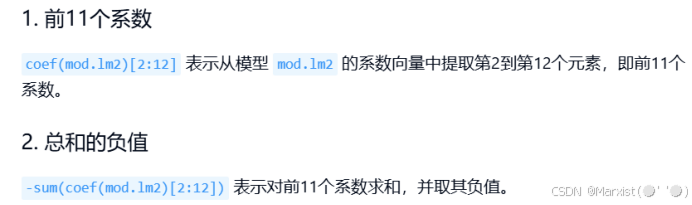
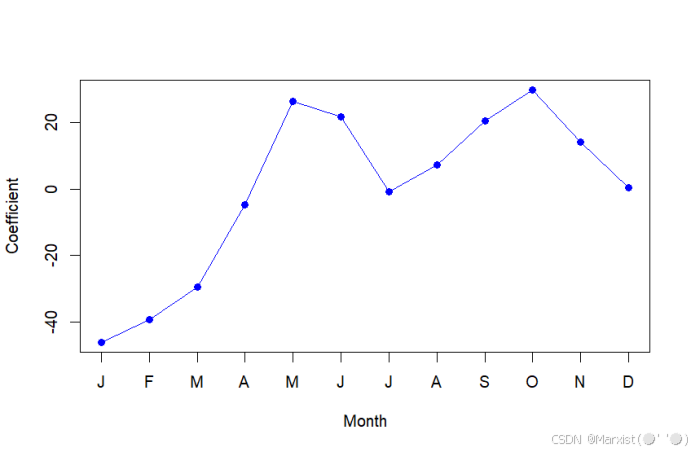
coef.months <- c(coef(mod.lm2)[2:12],
-sum(coef(mod.lm2)[2:12]))
###
plot(coef.months, xlab = "Month", ylab = "Coefficient",
xaxt = "n", col = "blue", pch = 19, type = "o")
axis(side = 1, at = 1:12, labels = c("J", "F", "M", "A",
"M", "J", "J", "A", "S", "O", "N", "D"))
###
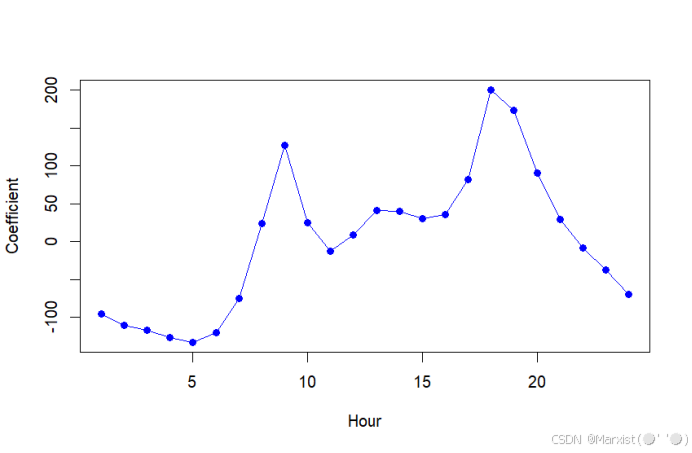
coef.hours <- c(coef(mod.lm2)[13:35],
-sum(coef(mod.lm2)[13:35]))
plot(coef.hours, xlab = "Hour", ylab = "Coefficient",
col = "blue", pch = 19, type = "o")
###
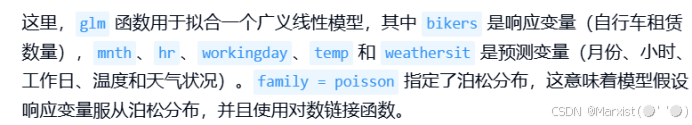
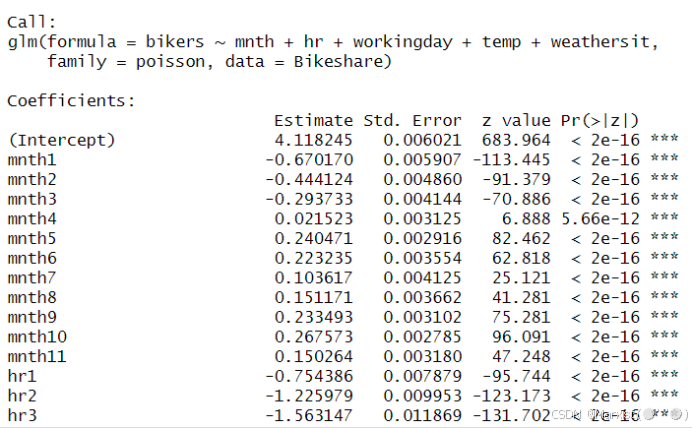
mod.pois <- glm(
bikers ~ mnth + hr + workingday + temp + weathersit,
data = Bikeshare, family = poisson
)#拟合泊松回归模型
summary(mod.pois)
###
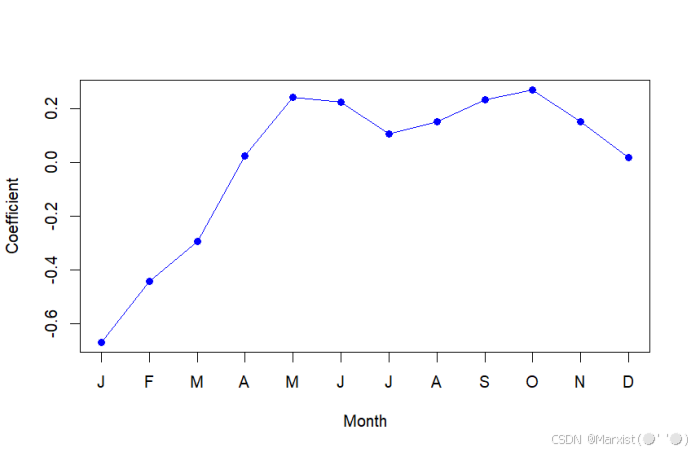
coef.mnth <- c(coef(mod.pois)[2:12],
-sum(coef(mod.pois)[2:12]))
plot(coef.mnth, xlab = "Month", ylab = "Coefficient",
xaxt = "n", col = "blue", pch = 19, type = "o")
axis(side = 1, at = 1:12, labels = c("J", "F", "M", "A", "M", "J", "J", "A", "S", "O", "N", "D"))
coef.hours <- c(coef(mod.pois)[13:35],
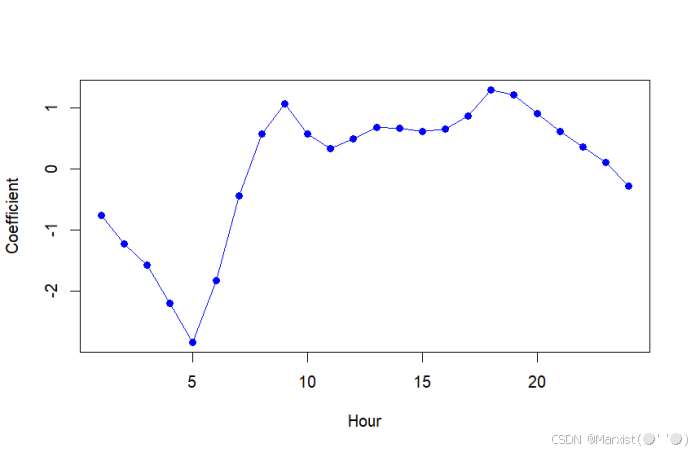
-sum(coef(mod.pois)[13:35]))
plot(coef.hours, xlab = "Hour", ylab = "Coefficient",
col = "blue", pch = 19, type = "o")
###
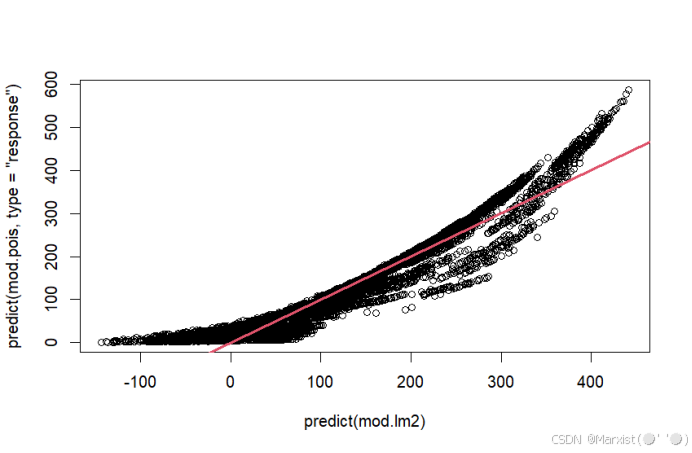
plot(predict(mod.lm2), predict(mod.pois, type = "response"))
abline(0, 1, col = 2, lwd = 3)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 42
 0
- 0


 已为社区贡献1条内容

所有评论(0)