机器学习—线性回归(Linear Regression)
回归问题是一类预测连续值的问题,而能满足这样要求的数学模型称作回归模型,线性回归就是回归模型中的一种,我们通过给模型“喂”数据来训练它,最终让它具备了预测的能力。
1.线性回归定义
给出一个点集,构造一个函数来拟合这个点集,并且尽可能的让该点集与拟合函数间的误差最小,如果这个函数曲线是一条直线,那就被称为线性回归,如果曲线是一条三次曲线,就被称为三次多项回归。回归模型正是表示从输入变量到输出变量之间映射的函数。
2.一元线性回归
一元线性回归分析预测法,是根据自变量x和因变量y的相关关系,建立x与y的回归函数进行预测的方法 y=ax+b,比如,我有一组数据画出来的散点图,横坐标客户数量,纵坐标代表销售量,线性回归就是要找一条直线,并且让这条直线尽可能地拟合图中的数据点。
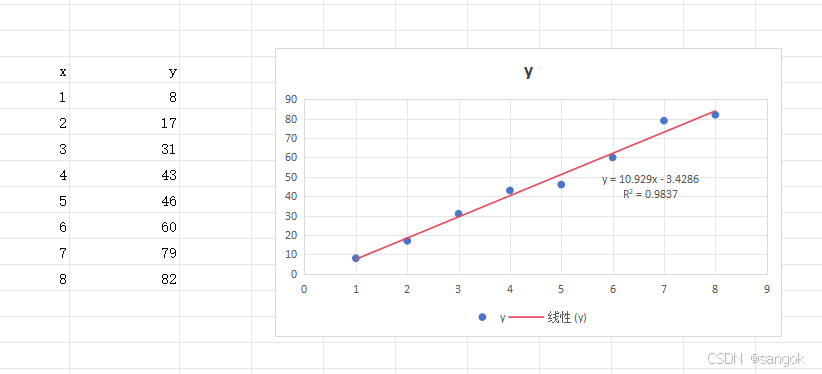
如图所示,通过训练数据拟合一个函数,就可以进行x=9的值进行预测y值的大小
3.Sklearn库使用示例
LinearRegression()模型在Sklearn.linear_model下,他主要是通过fit(x,y)的方法来训练模型,其中x为数据的属性,y为所属类型。线性模型的回归系数W会保存在他的coef_方法中。
1)加载模拟数据
import pandas as pd
data=pd.read_csv('generate_data.csv')
print(data)
#data赋值
x=data.loc[:,'x']
y=data.loc[:,'y']
print(x)
print(y)
   x   y
0  1   8
1  2  19
2  3  31
3  4  43
4  5  49
5  6  60
6  7  77
7  8  82
0    1
1    2
2    3
3    4
4    5
5    6
6    7
7    8
Name: x, dtype: int64
0     8
1    19
2    31
3    43
4    49
5    60
6    77
7    82
Name: y, dtype: int64
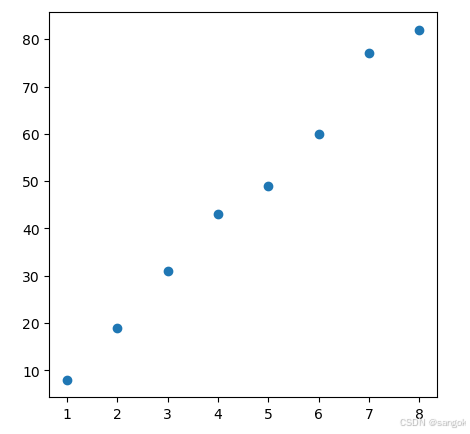
2)绘制点图
from matplotlib import pyplot as plt
plt.figure(figsize=[5,5])
plt.scatter(x,y)
plt.show()
3)进行训练
from sklearn.linear_model import LinearRegression
import numpy as np
lr_model=LinearRegression()
#print(type(x),x.shape)
x1=np.array(x)
#print(type(x1),x1.shape,x1)
x1=x1.reshape(-1,1)
#print(type(x1),x1.shape,x1)
y1=np.array(y)
#print(type(y1),y1.shape,y1)
y1=y1.reshape(-1,1)
#print(type(y1),x1.shape,y1)
lr_model.fit(x1,y1)

#对于输入的x,输出通过模型预测的y值
y1_predict=lr_model.predict(x1)
print("模型预测得到的值为:",y1_predict)
模型预测得到的值为: [[ 8.58333333]
 [19.30952381]
 [30.03571429]
 [40.76190476]
 [51.48809524]
 [62.21428571]
 [72.94047619]
 [83.66666667]]
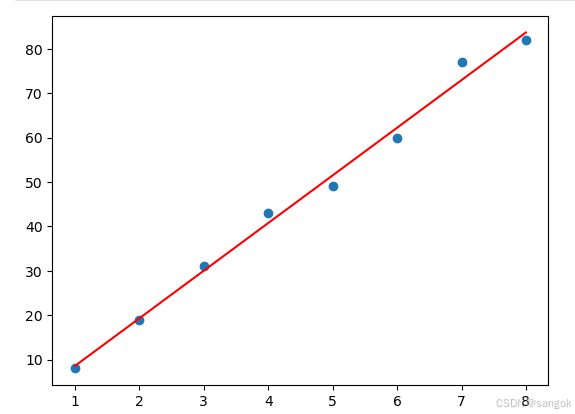
4)绘制曲线
plt.figure()
plt.scatter(x1,y1)
plt.plot(x1,y1_predict,'r')
plt.show()
4.损失函数
我们的目的是求解出具体的参数值,可以穿过这些点的直线可以有多条,如何选取呢?此时就需要引入一个评价标准。设y是待拟合的真实数据值,表示均值,
表示预测得到的值,这样我们可以引入以下2个概念:
真实值和预测值间的差值我们称之为残差 , 我们将数据中的每个点如此计算一遍,再将所有的相加,就能量化出拟合的直线和实际值之间的总误差,即残差平方和。
大多数情况下我们都使用均方误差(Mean Squared Error, MSE)均方误差是残差平方和的平均值,其计算公式为:
均方误差 MSE 是回归问题中最常用的损失函数,不仅用于统计学的线性回归,在机器学习中也经常使用。损失函数是衡量回归模型误差的函数,这个函数的值越小,说明直线越能拟合我们的数据。
#模型评分
from sklearn.metrics import mean_squared_error,r2_score
MSE=mean_squared_error(y1,y1_predict)
R2=r2_score(y1,y1_predict)
print(MSE,R2)
####4.59077380952382 0.9924569452951266
r2_score函数用于计算R²(确定系数:coefficient of determination):用来度量未来的样本是否可能通过模型被很好地预测,分值为 1 表示最好
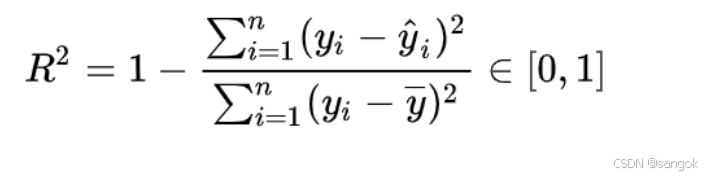
5.最小二乘法:
#模型的参数值
a=lr_model.coef_
b=lr_model.intercept_
print(a,b)
#####[[10.72619048]] [-2.14285714]
输入预测得到的函数参数y=ax+b 即:y=10.72619048x-2.14285714,从数学上来讲,如何得到这2个参数值呢,首先我们来了解一下最小二乘法

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)