【Python时序预测系列】基于CNN-Bi-LSTM-Attention实现单变量时间序列预测(案例+源码)
·
这是我的第317篇原创文章。
一、引言
在基于深度学习的方法进行单变量时间序列预测时,结合卷积神经网络(CNN)、双向长短期记忆网络(Bi-LSTM)和注意力机制(Attention)可以充分利用序列数据的时序特征。以下是一个使用Python和TensorFlow/Keras库实现这种方法的示例。
二、实现过程
2.1 读取数据集
# 读取数据集
data = pd.read_csv('data.csv')
# 将日期列转换为日期时间类型
data['Month'] = pd.to_datetime(data['Month'])
# 将日期列设置为索引
data.set_index('Month', inplace=True)
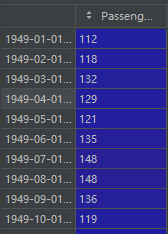
data:
2.2 划分数据集
# 拆分数据集为训练集和测试集
train_size = int(len(data) * 0.8)
train_data = data[:train_size]
test_data = data[train_size:]

# 绘制训练集和测试集的折线图
plt.figure(figsize=(10, 6))
plt.plot(train_data, label='Training Data')
plt.plot(test_data, label='Testing Data')
plt.xlabel('Year')
plt.ylabel('Passenger Count')
plt.title('International Airline Passengers - Training and Testing Data')
plt.legend()
plt.show()
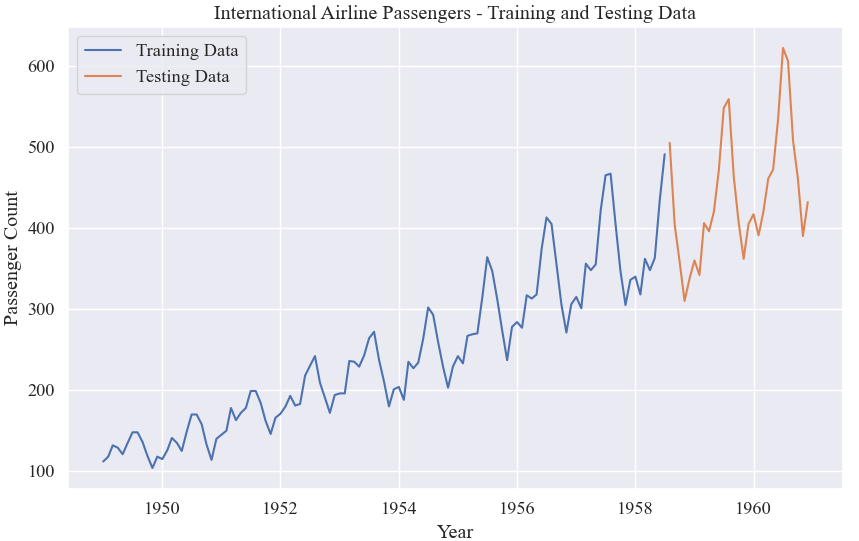
共144条数据,8:2划分:训练集115,测试集29。
训练集和测试集:
2.3 归一化
# 将数据归一化到 0~1 范围
scaler = MinMaxScaler()
train_data_scaler = scaler.fit_transform(train_data.values.reshape(-1, 1))
test_data_scaler = scaler.transform(test_data.values.reshape(-1, 1))
2.4 构造数据集
# 定义滑动窗口函数
def create_dataset(data, look_back=1):
    pass

# 定义滑动窗口大小
look_back = 3

# 创建滑动窗口数据集
X_train, Y_train = create_dataset(train_data_scaler, look_back)
X_test, Y_test = create_dataset(test_data_scaler, look_back)

# 将数据集转换为 LSTM 模型所需的形状(样本数,时间步长,特征数)
X_train = np.reshape(X_train, (X_train.shape[0],  X_train.shape[1],1))
X_test = np.reshape(X_test, (X_test.shape[0], X_test.shape[1], 1))
2.5 建立模拟合模型进行预测
# 构建模型
lstm_units = 50
dropout = 0.01

inputs=Input(shape=(look_back, 1))
my_model=Conv1D(filters = lstm_units, kernel_size = 1, activation = 'sigmoid')(inputs)#卷积层
my_model=Dropout(dropout)(my_model)#droupout层
my_model=Bidirectional(LSTM(lstm_units, activation='tanh', return_sequences=True), name='bilstm')(my_model)      #双向LSTM层
# attention = Attention()([my_model, my_model])
# attention = attention_3d_block(my_model)
attention = attention_block(my_model, look_back)
attention = Flatten()(attention)
outputs = Dense(1, activation='tanh')(attention)
my_model = Model(inputs=inputs, outputs=outputs)
my_model.compile(loss='mean_squared_error', optimizer='adam')
my_model.fit(X_train, Y_train, epochs=50, batch_size=1, verbose=2)
# 打印模型
model.summary()

# 使用模型进行预测
train_predictions = model.predict(X_train)
test_predictions = model.predict(X_test)

# 反归一化预测结果
train_predictions = scaler.inverse_transform(train_predictions)
test_predictions = scaler.inverse_transform(test_predictions)
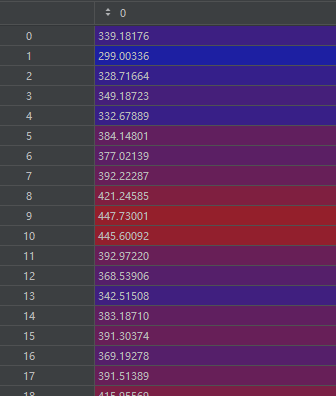
test_predictions:
2.6 预测效果展示
# 绘制测试集预测结果的折线图
plt.figure(figsize=(10, 6))
plt.plot(test_data, label='Actual')
plt.plot(list(test_data.index)[-len(test_predictions):], test_predictions, label='Predicted')
plt.xlabel('Month')
plt.ylabel('Passengers')
plt.title('Actual vs Predicted')
plt.legend()
plt.show()
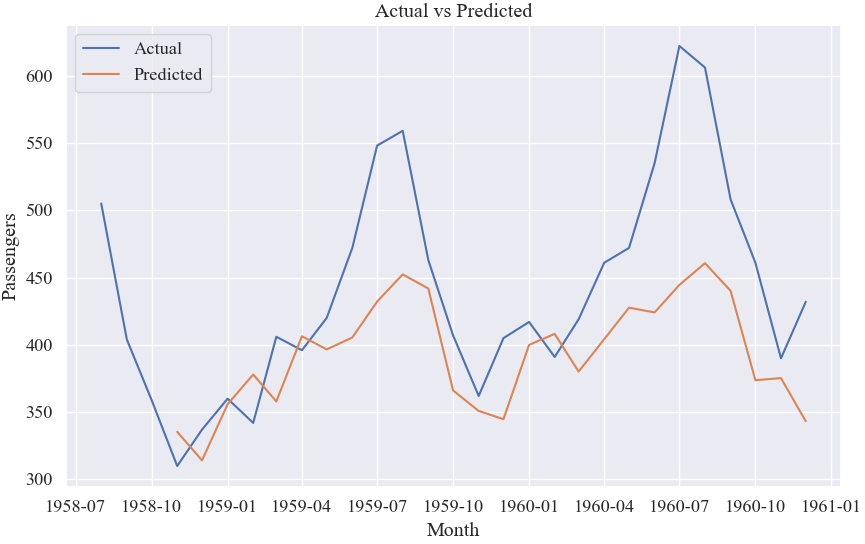
测试集真实值与预测值:
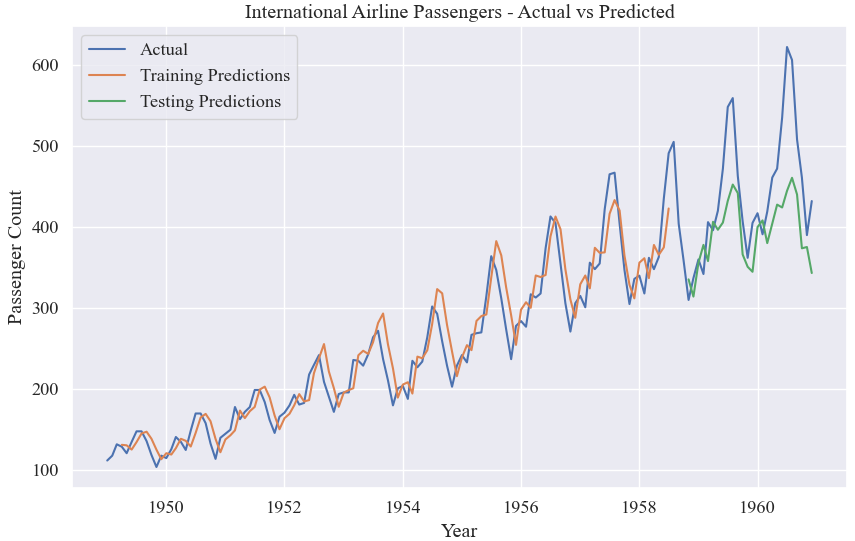
# 绘制原始数据、训练集预测结果和测试集预测结果的折线图
plt.figure(figsize=(10, 6))
plt.plot(data, label='Actual')
plt.plot(list(train_data.index)[look_back:train_size], train_predictions, label='Training Predictions')
plt.plot(list(test_data.index)[-(len(test_data)-look_back):], test_predictions, label='Testing Predictions')
plt.xlabel('Year')
plt.ylabel('Passenger Count')
plt.title('International Airline Passengers - Actual vs Predicted')
plt.legend()
plt.show()
原始数据、训练集预测结果和测试集预测结果:
作者简介:
读研期间发表6篇SCI数据挖掘相关论文,现在某研究院从事数据算法相关科研工作,结合自身科研实践经历不定期分享关于Python、机器学习、深度学习、人工智能系列基础知识与应用案例。致力于只做原创,以最简单的方式理解和学习,关注我一起交流成长。需要数据集和源码的小伙伴可以关注底部公众号添加作者微信。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 6
 0
- 0


 已为社区贡献138条内容

所有评论(0)