数据分析技术---MLP 和 BP 神经网络流程;K-means 算法流程
一、实验目的:
二、实验任务
1.使用MLP实现水果分类:
实验描述:
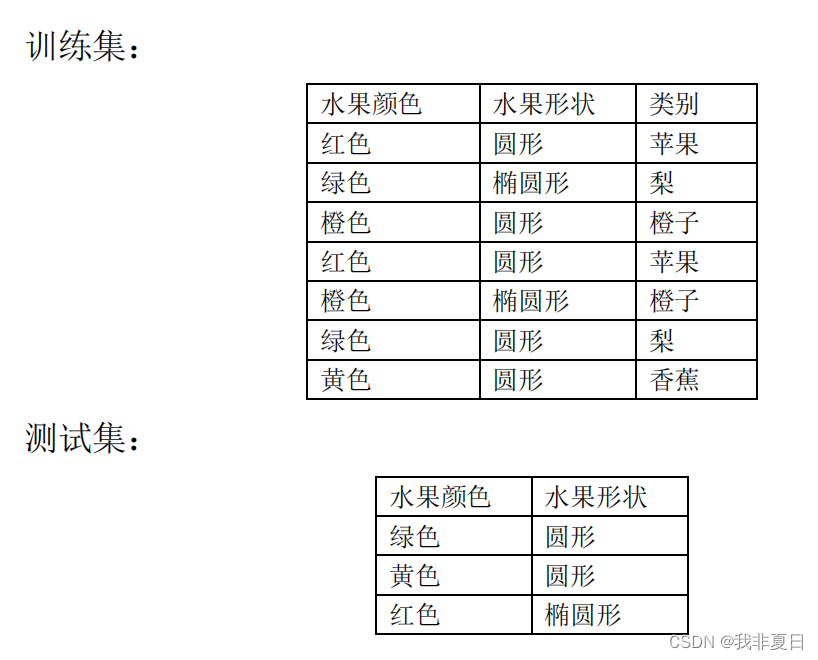
实验思路:
准备数据集,然后使用多层感知机(MLP)来训练一个模型,并使用测试集来评估模型的性能。首先,将文本数据转换为数值形式。使用独热编码(One-Hot Encoding)来处理颜色和形状特征。使用scikit-learn的OneHotEncoder或LabelEncoder与pandas库来准备数据。构建MLP模型:使用scikit-learn的MLPClassifier来构建多层感知机模型。使用训练数据来训练MLP模型。使用测试数据来评估模型的性能,通常使用准确率作为评价指标。最后预测给定水果的类别。
实验代码:
#MLP 实现水果分类
import pandas as pd
from sklearn.preprocessing import LabelEncoder, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.neural_network import MLPClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 加载数据
train_data = pd.DataFrame({
    '水果颜色': ['红色', '绿色', '橙色', '红色', '橙色', '绿色', '黄色'],
    '水果形状': ['圆形', '椭圆形', '圆形', '圆形', '椭圆形', '圆形', '圆形'],
    '类别': ['苹果', '梨', '橙子', '苹果', '橙子', '梨', '香蕉']
})

test_data = pd.DataFrame({
    '水果颜色': ['绿色', '黄色', '红色'],
    '水果形状': ['圆形', '圆形', '椭圆形']
})

# 数据预处理
label_encoder = LabelEncoder()
one_hot_encoder = OneHotEncoder(sparse=False)

# 定义特征和标签的列
feature_cols = ['水果颜色', '水果形状']
label_col = ['类别']

# 对特征和标签进行编码
ct = ColumnTransformer(
    [('one_hot_encoder', one_hot_encoder, feature_cols)],
    remainder='passthrough'
)

X_train = ct.fit_transform(train_data[feature_cols])
y_train = label_encoder.fit_transform(train_data[label_col])

X_test = ct.transform(test_data[feature_cols])

# 构建MLP模型
mlp = MLPClassifier(hidden_layer_sizes=(10,), max_iter=1000)

# 训练模型
mlp.fit(X_train, y_train)

# 预测
y_pred = mlp.predict(X_test)

# 评估模型(但测试集没有真实的标签,所以我们这里只打印预测结果)
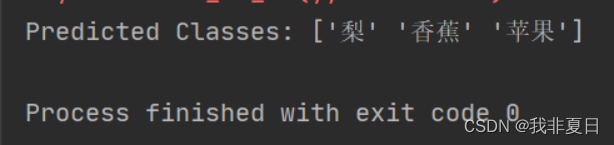
print("Predicted Classes:", label_encoder.inverse_transform(y_pred))

# 如果有真实的测试集标签,可以这样计算准确率
# y_test = label_encoder.transform(test_data['真实的类别列'])  # 假设我们有一个真实的类别列
# accuracy = accuracy_score(y_test, y_pred)
# print("Accuracy:", accuracy)
实验结果:
2.使用BP神经网络实现特征分类:
实验描述:
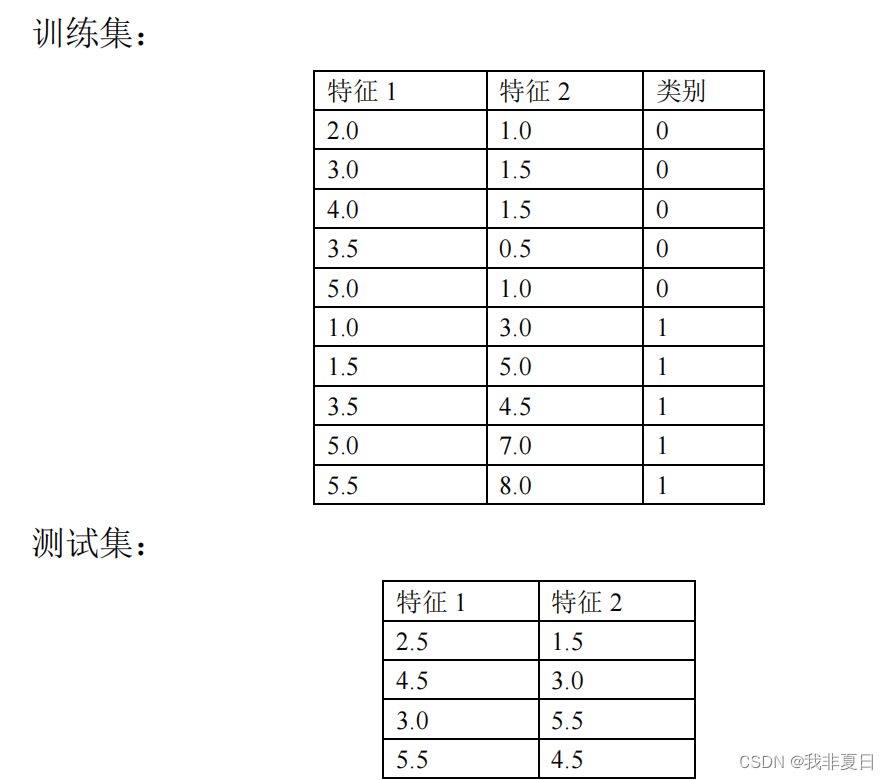
实验思路:
通过例子可知,若特征1的值大于特征2的值结果为0,反正结果为1.
首先,导入了必要的库,包括numpy用于数值计算,以及MLPClassifier和accuracy_score用于神经网络分类和性能评估。
接着,我们手动定义了训练数据集X_train和对应的标签y_train,以及一个测试数据集X_test。
然后,创建了一个MLPClassifier对象,并设置了隐藏层的大小、最大迭代次数和随机状态等参数。
使用训练数据集和标签,调用fit方法对模型进行训练。训练完成后,使用predict方法对测试数据集进行预测,并将预测结果存储在y_pred中。
实验代码:
import numpy as np
from sklearn.neural_network import MLPClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 加载和预处理数据
X_train = np.array([[2.0, 1.0], [3.0, 1.5], [4.0, 1.5], [3.5, 0.5], [5.0, 1.0],
                    [1.0, 3.0], [1.5, 5.0], [3.5, 4.5], [5.0, 7.0], [5.5, 8.0]])
y_train = np.array([0, 0, 0, 0, 0, 1, 1, 1, 1, 1])

X_test = np.array([[2.5, 1.5], [4.5, 3.0], [3.0, 5.5], [5.5, 4.5]])

# 定义BP神经网络模型
mlp = MLPClassifier(hidden_layer_sizes=(10,), max_iter=1000, random_state=1)

# 训练模型
mlp.fit(X_train, y_train)

# 预测测试集
y_pred = mlp.predict(X_test)

# 评估模型性能(如果有真实的测试集标签)
# 这里我们假设真实的测试集标签是未知的,但如果有的话,你可以这样计算准确率:
# y_test_real = np.array([...])  # 这里填入真实的测试集标签
# accuracy = accuracy_score(y_test_real, y_pred)
# print("Accuracy:", accuracy)

# 打印预测结果
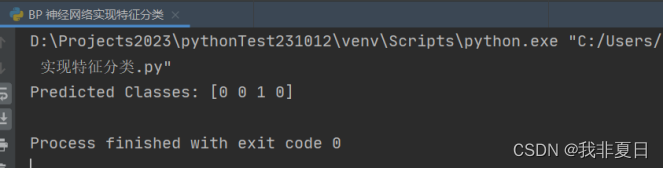
print("Predicted Classes:", y_pred)
实验结果:
3.编程实现K-Means算法:
实验描述:
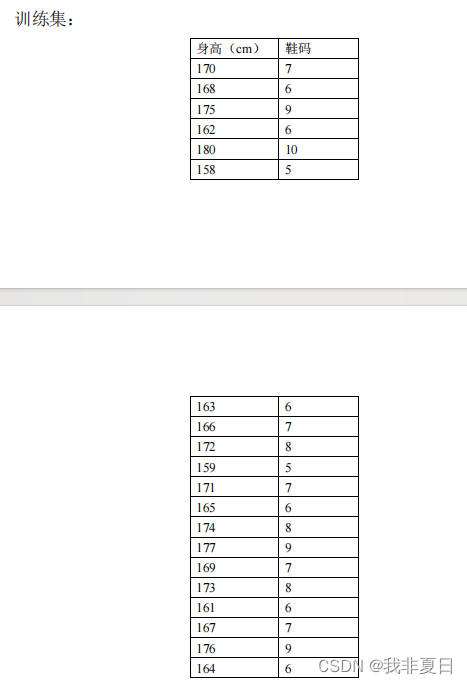
实验思路:
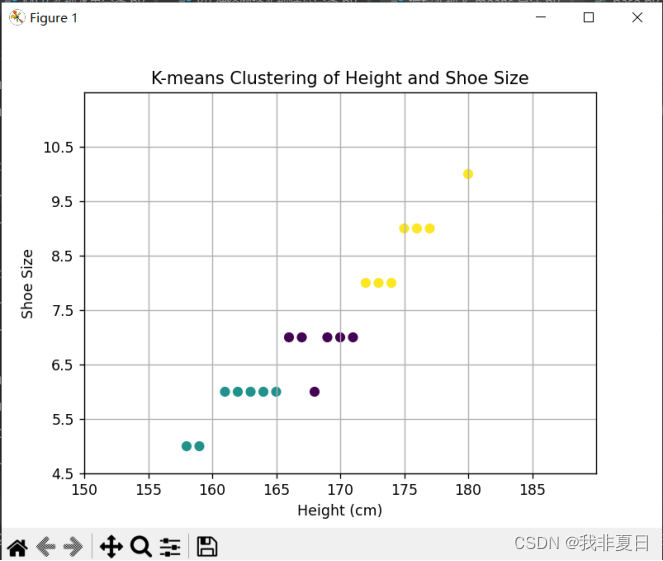
使用了 sklearn.cluster.KMeans 类来执行 K-means 聚类,并使用 StandardScaler 对数据进行标准化处理。然后,绘制了散点图来可视化聚类结果,其中每个数据点都根据其聚类标签着色,聚类中心用黑色大圆点表示。
实验代码:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

# 1. 准备数据集
data = {
    'Height': [170, 168, 175, 162, 180, 158, 163, 166, 172, 159, 171, 165, 174, 177, 169, 173, 161, 167, 176, 164],
    'ShoeSize': [7, 6, 9, 6, 10, 5, 6, 7, 8, 5, 7, 6, 8, 9, 7, 8, 6, 7, 9, 6]
}
df = pd.DataFrame(data)

# 2. 数据标准化(可选步骤,但通常有助于聚类)
scaler = StandardScaler()
scaled_data = scaler.fit_transform(df)

# 3. 使用 sklearn 的 KMeans 类进行聚类
kmeans = KMeans(n_clusters=3, random_state=0)
kmeans.fit(scaled_data)

# 获取聚类标签和聚类中心
labels = kmeans.labels_
centroids = kmeans.cluster_centers_

# 将聚类标签添加到原始数据框
df['Cluster'] = labels

# 4. 可视化聚类结果
plt.scatter(df['Height'], df['ShoeSize'], c=df['Cluster'], cmap='viridis', marker='o')
plt.scatter(centroids[:, 0], centroids[:, 1], c='black', s=200, alpha=0.5)

# 设置坐标轴范围
plt.xlim(150, 190)  # 设置横坐标(身高)范围为150-190
plt.ylim(min(df['ShoeSize']) - 0.5, max(df['ShoeSize']) + 1.5)  # 为鞋码增加一些缓冲

# 设置坐标轴刻度标签更细化
plt.xticks(np.arange(150, 190, 5))  # 横坐标(身高)每5cm一个刻度
plt.yticks(np.arange(min(df['ShoeSize']) - 0.5, max(df['ShoeSize']) + 1.5, 1))  # 纵坐标(鞋码)每1个单位一个刻度

plt.xlabel('Height (cm)')
plt.ylabel('Shoe Size')
plt.title('K-means Clustering of Height and Shoe Size')
plt.grid(True)  # 可选:添加网格线以使图表更清晰
plt.show()
实验结果:
4.使用 sklearn 库中的 K-means 方法实现鸢尾花数据集聚类任务:
实验描述:
实验思路:
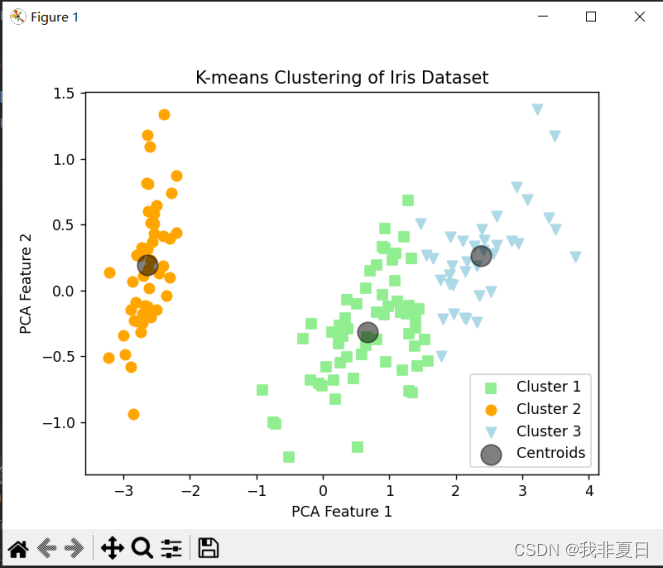
首先加载了鸢尾花数据集,并使用 KMeans 算法进行聚类。由于鸢尾花数据集有四个特征,使用了 PCA(主成分分析)将其降至二维以便可视化。然后,根据聚类标签在二维 PCA 空间中绘制了数据点,并添加了聚类中心的标记。最后,显示了整个图表。
实验代码:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn import datasets
from sklearn.decomposition import PCA  # 用于降维以便可视化

# 1. 加载鸢尾花数据集
iris = datasets.load_iris()
X = iris.data
y = iris.target

# 2. 使用 KMeans 进行聚类
kmeans = KMeans(n_clusters=3, random_state=0)
kmeans.fit(X)

# 3. 获取聚类标签
labels = kmeans.labels_

# 4. 由于有四个特征,我们使用 PCA 将其降至二维以便可视化
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

# 5. 可视化聚类结果
plt.scatter(X_pca[labels == 0, 0], X_pca[labels == 0, 1], s=50, c='lightgreen', marker='s', label='Cluster 1')
plt.scatter(X_pca[labels == 1, 0], X_pca[labels == 1, 1], s=50, c='orange', marker='o', label='Cluster 2')
plt.scatter(X_pca[labels == 2, 0], X_pca[labels == 2, 1], s=50, c='lightblue', marker='v', label='Cluster 3')

# 画出聚类中心
centers = pca.transform(kmeans.cluster_centers_)
plt.scatter(centers[:, 0], centers[:, 1], c='black', s=200, alpha=0.5, label='Centroids')

plt.xlabel('PCA Feature 1')
plt.ylabel('PCA Feature 2')
plt.title('K-means Clustering of Iris Dataset')
plt.legend()
plt.show()
实验结果:

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)