机器学习 决策树
目录
一、决策树的简介
分类决策树模型是一种描述对实例进行分类的树形结构。决策树由结点和有向边组成。结点有两种类型:内部结点和叶节点。内部结点表示一个特征或属性,叶节点表示一个类。
二、决策树原理
1.信息熵
1.1简介
●熵可以表示一个系统的混乱程度,系统越混乱,熵值越高;反之,熵值越低。
●1948年香农提出了”信息熵(Entropy)“的概念。
●假设在当前的样本集合D中第k类样本所占的比例为pk(k=1,2,3,......,n),,D表示样本的所有数量,
为第k类样本的数量。
Ent(D)的值越小,则D的纯度越高。
●计算信息熵时约定:若p = 0,则plog2p=0
●Ent(D)的最小值为0,最大值为log2|y|
●当随机变量只有两个值,例如1, 0时,即X的分布为P(X=1)=p , P(X=0)=1-p , 0<=p<=1.
则熵
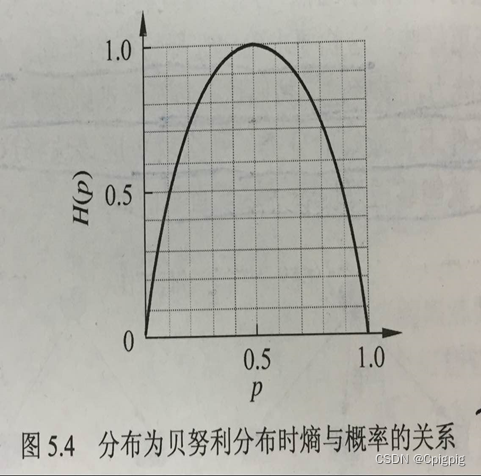
那么当p=0或者p=1是,H(p)=0,随机变量完全没有不确定性。
1.2案例
假设乒乓球比赛,有6个选手{a,b,c,d,e,f} ,他们获胜的概率分别为{1/3,1/6,1/12,1/12,1/6,1/6}
求Ent(D)的值。
答案:
2.信息增益
2.1简介
●离散属性a有V个可能的取值{ a1, a2, ..., aV},用a来进行划分,则会产生V个分支结点,其中第v个分支结点包含了D中所有在属性a上取值为av的样本,记为Dv。则可计算出用属性a对样本集D进行划分所获得的“信息增益”:
●一般而言,信息增益越大,则意味着使用属性a来进行划分所获得的“纯度提升”越大。
2.2案例
| id | 气温 | 是否有太阳 | 是否出去 |
| 0 | 高 | 有 | NO |
| 1 | 中 | 没有 | YES |
| 2 | 中 | 有 | NO |
| 3 | 低 | 没有 | YES |
| 4 | 高 | 没有 | YES |
| 5 | 低 | 没有 | YES |
| 6 | 中 | 有 | NO |
| 7 | 低 | 有 | YES |
| 8 | 高 | 没有 | YES |
| 9 | 高 | 有 | NO |
| Positive正样本 | negative负样本 | 总 | |
| 总 | 6 | 4 | 10 |
| 有太阳 | 1 | 4 | 5 |
| 没有太阳 | 5 | 0 | 5 |
| 气温高 | 2 | 2 | 4 |
| 气温中 | 1 | 2 | 3 |
| 气温低 | 3 | 0 | 3 |
出去为正样本,不出去为负样本。
●计算总体的熵:
●计算有没有太阳属性的信息熵:
●计算太阳的信息增益
3.增益率
3.1简介
●可定义增益率:
其中
IV(a) 称为属性a的“固有值”,属性a的可能取值数目越多(即V越大),则IV(a)的值通常就越大。
●增益率准则对可取值数目较少的属性有所偏好。
●C4.5 [Quinlan, 1993]采用了一个启发式方法:先从候选划分属性中找出信息增益高于平均水平的属性,再从中选取增益率最高的。
3.2案例

●计算有无太阳的增益率
4.基尼指数
4.1简介
●分类问题中,假设D有K个类,样本点属于第k类的概率为𝑝𝑘,则p_k,则概率分布的基尼值定义为:
Gini(D)越小,数据集D的纯度越高;
●反映了
4.2案例
●有无太阳的基尼指数
●再根据气温高中低来划分
| 有无太阳 | |
| 有 | 5 |
| 没有 | 5 |
| 气温高 | 气温中 | 气温低 | |
| 有太阳 | 2 | 2 | 1 |
| 没太阳 | 2 | 1 | 2 |
三、剪枝
1.简介
●为什么剪枝
–“剪枝”是决策树学习算法对付“过拟合”的主要手段
–可通过“剪枝”来一定程度避免因决策分支过多,以致于把训练集自身的一些特点当做所有数据都具有的一般性质而导致的过拟合
●基本策略
-预剪枝
-后剪枝
2.预剪枝
2.1主要方法
● 当决策树达到预设的高度时就停止决策树的生长。
● 达到某个节点的实例集具有相同的特征向量(属性取值相同),即使这些实例不属于同一类,也可以停止决策树的生长。
● 定义一个阈值,当达到某个节点的实例个数小于阈值时就可以停止决策树的生长。
● 通过计算每次扩张对系统性能的增益,决定是否停止决策树的生长。
不足之处:阈值属于超参数,很难找到过拟合--欠拟合的trade-off。
2.2 优点
●降低过拟合风险。
●显著减少训练时间和测试时间开销。
2.3 缺点
●欠拟合风险:有些分支的当前划分虽然不能提升泛化性能,但在其基础上进行的后续划分却有可能显著提高性能。预剪枝基于“贪心”本质禁止这些分支展开,带来了欠拟合风险。
3.后剪枝
3.1主要方法
●先从训练集生成一棵完整的决策树,然后自底向上地对非叶结点进行分析计算,若将该结点对应的子树替换为叶结点能带来决策树泛化性能提升,则将该子树替换为叶结点。
3.2优点
●后剪枝比预剪枝保留了更多的分支,欠拟合风险小,泛化性能往往优于预剪枝决策树。
3.3缺点
●训练时间开销大:后剪枝过程是在生成完全决策树之后进行的,需要自底向上对所有非叶结点逐一计算。
四、实战
该代码是基于ID3算法的信息增益实现的。
1. 决策树的构建
1. 1数据集创建
创建16个样本,样本有四个特征,年龄有三个属性分别是0代表青年、1代表中年、2代表老年,是否有工作两个属性0代表否1代表是,是否有自己的房子两个属性0代表否1代表是,信贷情况三个属性0代表一般1代表好2代表非常好。类别是是否给贷款no代表否,yes代表是。
def createDataSet():
    dataSet = [[0, 0, 0, 0, 'no'],
            [0, 0, 0, 1, 'no'],
            [0, 1, 0, 1, 'yes'],
            [0, 1, 1, 0, 'yes'],
            [0, 0, 0, 0, 'no'],
            [1, 0, 0, 0, 'no'],
            [1, 0, 0, 1, 'no'],
            [1, 1, 1, 1, 'yes'],
            [1, 0, 1, 2, 'yes'],
            [1, 0, 1, 2, 'yes'],
            [2, 0, 1, 2, 'yes'],
            [2, 0, 1, 1, 'yes'],
            [2, 1, 0, 1, 'yes'],
            [2, 1, 0, 2, 'yes'],
            [2, 0, 0, 0, 'no'],
            [1, 1, 0, 0, 'no']]
    labels = ['年龄', '有工作', '有自己的房子', '信贷情况']
    return dataSet, labels
1.2 计算信息熵
首先计算样本的数量,构建字典来保存每个标签出现的次数,然后对数据集进行遍历取出标签的信息,利用keys()函数返回统计次数的字典的对象来判断提取的标签是否在字典中,如果不在的话,就把该特征的次数赋为0。然后跳出if语句,该特征的次数加1,将熵的初值赋值为0,接下来套用公式计算Ent(D)。
from math import log


def calcShannonEnt(dataSet):
    numEntires = len(dataSet)#返回数据集的行数
    labelCounts = {}#保存每个标签(Label)出现次数的字典
    for featVec in dataSet:#对每组特征向量进行统计
        currentLabel = featVec[-1] #提取标签的信息
        if currentLabel not in labelCounts.keys():#如果标签没有放入统计次数的字典,添加进去
            labelCounts[currentLabel] = 0
        labelCounts[currentLabel] += 1#Label计数
    shannonEnt = 0#经验熵
    for key in labelCounts:#计算香农熵
        prob = float(labelCounts[key]) / numEntires #选择标签的概率
        shannonEnt -= prob * log(prob,2)#公式计算
    return shannonEnt
1.3 划分数据集
该函数的三个输入参数分别是待划分的数据集、划分数据集的特征、需要返回特征的值。首先创建一个空的存放数据集的列表,遍历数据集,在if语句中我们会把符合特征的数据抽取出来,并且调用extend函数将第axis+1个特征作为起始到最后添加到原来取出0到axis的列表中,然后将整个去除过特征的数据集调用append函数加到最开始创建的空数据集列表中并且返回。
def splitDataSet(dataSet,axis,value):
    retDataSet = []#创建返回的数据集列表
    for featVec in dataSet:
        if featVec[axis] == value:
            reducedFeatVec = featVec[:axis]#取出从0到第axis的特征
            reducedFeatVec.extend(featVec[axis+1:])#将符合条件的添加到返回的数据集
            retDataSet.append(reducedFeatVec)
    return retDataSet
1.4 选择最好的数据集划分方式
该函数的主要作用是选取特征,划分数据集,计算得出最好的划分数据集的特征。
首先计算特征的数量,因为在上一步的基础上减少了一个特征所以特征数量会减少1,计算减少一个特征值后的香农熵,初始化一个存放最优特征的索引值,for循环遍历数据集,获取数据集中第i个所有特征并且取出来调用set函数创建一个新的集合,把条件熵初始化为0,接下来就是遍历当前特征的中的所有唯一属性值,对每个唯一属性值划分一次数据集,对划分后的子集进行概率和熵的计算,然后算出信息增益并输出,如果该信息增益大于之前最好的信息增益值就会替换掉变成做好的。
def chooseBestFeatureToSplit(dataSet):
    numFeatures = len(dataSet[0])-1#计算特征的数量
    baseEntropy = calcShannonEnt(dataSet)#计算数据集的香农熵
    bestInfoGain = 0.0#最优特征的索引值
    bestFeature = -1
    for i in range(numFeatures):
        #获取dataSet的第i个所有特征
        featList = [example[i] for example in dataSet]
        uniqueVals = set(featList)
        newEntropy = 0.0#经验条件熵
        for value in uniqueVals:
            subDataSet = splitDataSet(dataSet,i,value)#subDataSet划分后的子集
            prob = len(subDataSet) / float(len(dataSet))#计算子集的概率
            newEntropy += prob * calcShannonEnt(subDataSet)#计算经验条件熵
        infoGain = baseEntropy - newEntropy#信息增益
        print("第%d个特征的增益为%.3f" % (i,infoGain))
        if (infoGain > bestInfoGain):
            bestInfoGain = infoGain
            bestFeature = i
    return bestFeature
1.5 递归构建决策树
majorityCnt函数用于计算classList中出现次数最多的类别,并返回该类别。它首先创建一个空的classCount字典,然后遍历classList中的每个类别,将类别作为键,出现次数作为值存储在classCount字典中。如果类别在classCount字典中不存在,则将其初始化为0,然后增加1。最后,使用operator.itemgetter(1)作为关键字对classCount进行降序排序,并返回排序后的第一个类别。
createTree函数用于递归地构建决策树。它首先检查classList中的类别是否都相同,如果是,则返回该类别。然后检查dataSet中的特征数量是否为1,如果是,则返回classList中出现次数最多的类别。然后使用chooseBestFeatureToSplit函数选择最佳特征,将其作为树的根节点。接着,删除labels中的最佳特征,并创建一个空的字典myTree来存储树的结构。然后,遍历最佳特征的所有取值,对于每个取值,创建一个子标签列表subLabels,并递归地调用createTree函数来构建子树。最后,将子树添加到myTree中,并返回myTree。
import operator


def majorityCnt(classList):
    classCount = []
    for vote in classList:
        if vote not in classCount.keys(): classCount[vote] = 0
        classCount[vote] += 1
    sortedClassCount = sorted(classCount.iteritems(),key=operator.itemgetter(1),reverse=True)
    return sortedClassCount[0][0]


def createTree(dataSet,labels):
    classList = [example[-1] for example in dataSet]
    if classList.count(classList[0]) == len(classList):
        return classList[0]
    if len(dataSet[0]) == 1:
        return majorityCnt(classList)
    bestFeat = chooseBestFeatureToSplit(dataSet)
    bestFeatLabel = labels[bestFeat]
    myTree = {bestFeatLabel:{}}
    del(labels[bestFeat])
    featValues = [example[bestFeat] for example in dataSet]
    uniqueVals = set(featValues)
    for value in uniqueVals:
        subLabels = labels[:]
        myTree[bestFeatLabel][value] = createTree(splitDataSet(dataSet,bestFeat,value),subLabels)
    return myTree
2. 使用决策树执行分类
next(iter())获取输入树的第一个特征,secondDict是获取根据第一个特征划分后的子树,然后找到第一个特征的索位置,for循环遍历子树的所有分支,如果当前特征值与当前分支的特征值相等,就进入下一个判断当前分支是否是一个字典,如果是的话还要继续向下递归分类,如果不是的话说明已经到达了叶子节点,该叶子的值就是结果。
def classify(inputTree,featLabels,testVec):
    firstStr = next(iter(inputTree))
    secondDict = inputTree[firstStr]
    featIndex = featLabels.index(firstStr)
    for key in secondDict.keys():
        if testVec[featIndex] == key:
            if type(secondDict[key]).__name__ == 'dict':
                classLabel = classify(secondDict[key], featLabels, testVec)
            else: classLabel = secondDict[key]
    return classLabel
3. 测试分类
因为之前调用分类函数会把年龄这个特征去掉所以我们要把labels把年龄的特征去掉。
dataSet,labels = createDataSet()
featLabels = labels[1:]
mytree = createTree(dataSet,labels)
testVec1 = [0,1]
testVec2 = [1,0]
testVec3 = [1,1]
testVec4 = [0,0]
result1 = classify(mytree,featLabels,testVec1)
result2 = classify(mytree,featLabels,testVec2)
result3 = classify(mytree,featLabels,testVec3)
result4 = classify(mytree,featLabels,testVec4)
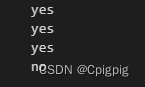
print(result1)
print(result2)
print(result3)
print(result4)
这是创建完的树

对比测试结果正确。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)