【教程】python数据分析pandas快速学习
【教程】python数据分析pandas快速学习
备注
2023/08/14 星期一
工作中接触了一个python数据分析的小项目,需要处理一些excel表格,顺便学习了pandas的数据处理,在这里记录一下
一、pandas简介
pandas是一个著名的python数据分析的开源库,他使用方便、应用广泛,与其他数据分析相关的第三方库兼容良好,是目前python数据处理的主流选择。
1.安装
在我们正常安装python之后,只需要通过pip即可安装这个库
pip install pandas
随后只需要在python文件中引入pandas就可以开始使用了
import pandas
或者也可以使用as给pandas起个别名
import pandas as pd
以上两种引入方式根据自己的喜好选一种即可
2.增强
如果你对数据分析、科学计算的需求较高你也可以配合anaconda和jupyter来使用,anaconda是“巨蟒”的意思,是好用的python的包管理器和环境管理器、jupyter是一种 Web 应用,能让用户将说明文本、数学方程、代码和可视化内容全部组合到一个易于共享的文档中。
本文不过多赘述anaconda和jupyter的安装和使用,如有需要可以在网络上找到大量相关文档。
二、数据结构
pandas中最常用的数据结构是series和dataframe,pandas中的所有操作几乎全是依赖于这两种数据结构完成的,所以掌握这两种数据结构非常重要。另外index也是一种特殊的数据结构,大多数时候我们不需要直接使用index。
1.Series
series是一维带标签数组,也可以看作excel或sql表中的一列,能够存储任意数据类型,核心是一个值序列和索引(index)。如果不指定索引默认为从0到n-1的整数列。series的索引也有name属性,索引name不可以在series创建时指定,只能在series创建后修改。
属性:
| 属性名 | 作用 |
|---|---|
| values | series的数据值,本身是一个NumPy数组 |
| index | series的索引,本身是pandas.Index类 |
| name | series的名称,用于识符series并和dataframe产生关联(不指定默认为None) |
| dtype | series数据的数据类型 |
| size | series中元素的总数 |
| empty | series是否为空 |
创建:
# 创建一个空的series对象
s = pandas.Series(data)

# 创建时传入一个数组,此时具有默认的索引
data = [10, 20, 30, 40]
s = pandas.Series(data)

# 创建时设置自定义索引
s = pandas.Series(data, index=['a', 'b', 'c', 'd'])

# 创建时传入一个字典,会将键设置为索引
data = {'a': 10, 'b': 20, 'c': 30, 'd':40}
s = pandas.Series(data)

# 创建时指定name属性
s = pandas.Series(data, name='numbers')
修改:
# 创建后使用.index修改索引
s.index = ['a', 'b', 'c', 'd']

# 创建后修改name属性
s.name = 'numbers'

# 创建后修改index.name属性
s.index.name = 'index'
获取:
# 获取值序列
data = s.values

# 通过索引获取数据
data = s['a']

# 通过位置获取数据
data = s.iloc[0]
2.DataFrame
dataframe是二维数组或者矩阵,也可以看作一个excel或sql表,核心是数据、行索引(index)和列索引(columns)。如果不指定行索引或列索引默认为从0到n-1的整数列。dataframe具有shape属性是dataframe的行数和列数。
属性:
| 属性名 | 作用 |
|---|---|
| values | dataframe的数据值,本身是一个NumPy二维数组 |
| columns | dataframe的列索引,本身是pandas.Index类 |
| index | dataframe的行索引,本身是pandas.Index类 |
| dtypes | dataframe每列数据的数据类型 |
| shape | dataframe的维度即行列数 |
| size | dataframe中元素的总数即行数乘以列数 |
| empty | dataframe是否为空 |
| T | dataframe的转置 |
创建:
# 创建一个空的dataframe对象
pandas.DataFrame()

# 创建时传入一个二维数组,此时具有默认的行索引和列索引
data = [
    ['A', 18, 60],
    ['B', 20, 70],
    ['C', 23, 85]
]
df = pandas.DataFrame(data)

# 创建时设置自定义列索引
df = pandas.DataFrame(data, columns=['name', 'age', 'score'])

# 创建时设置自定义行索引
df = pandas.DataFrame(data, index=['a', 'b', 'c'])

# 创建时设置自定义行索引和列索引
df = pandas.DataFrame(data, columns=['name', 'age', 'score'], index=['a', 'b', 'c'])

# 创建时传入一个字典,此时字典的键就是列索引,具有默认的行索引
data = {
	'name':['A', 'B', 'C'],
	'age':[18, 20, 23],
	'score':[60, 70, 85]
}
df = pandas.DataFrame(data)

# 创建时传入一个字典,并设置行索引
df = pandas.DataFrame(data, index=['a', 'b', 'c'])
修改:
# 创建后使用.columns修改列索引
df.columns = ['name', 'age', 'score']

# 创建后使用.index修改行索引
df.index = ['a', 'b', 'c']
获取:
# 获取行列数
data = df.shape

# 获取数据
data = df.values

# 通过列名获取数据
data = df['name']

# 通过列名获取多列数据
data = df[['name', 'age']]

# 通过行名获取行数据
data = df.loc['a']

# 通过行名获取多行数据
data = df.loc[['a', 'b']]

# 通过行位置获取行数据
data = df.iloc[0]

# 通过行位置获取多行数据
data = df.iloc[[0,1]]

# 通过行列名获取数据
data = df.loc['a', 'Age']

# 通过行列位置获取数据
df.iloc[0, 0]
3.Index
Index类型提供了一些方法,如下:
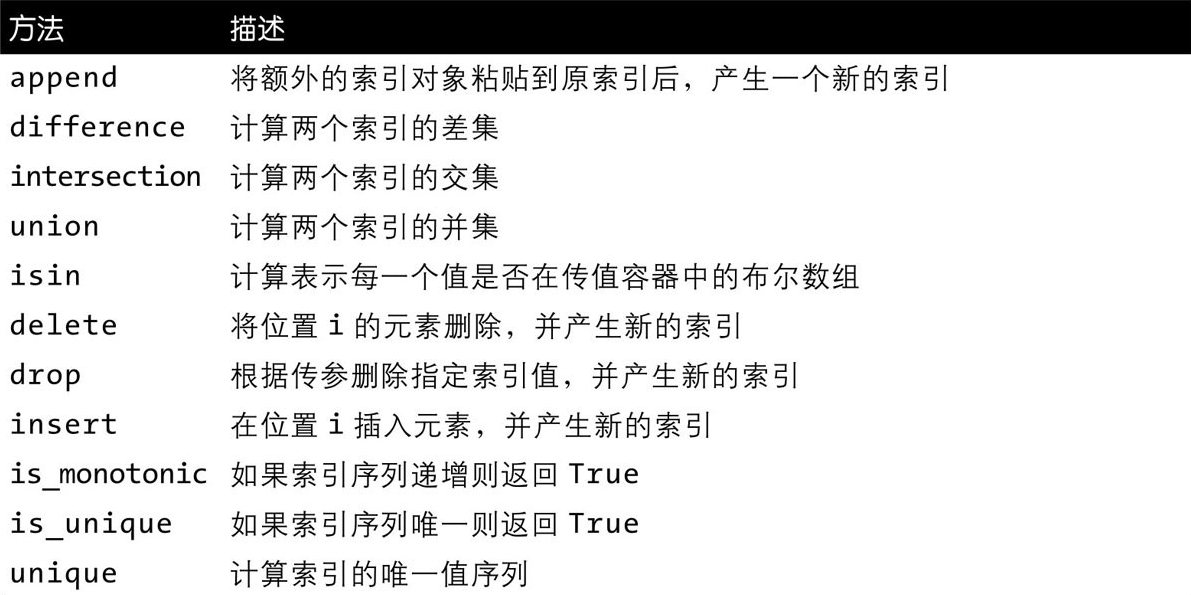
三、数据读写
pandas提供了非常方便的数据读写的函数用来读写不同格式的数据。
1.数据读取
pandas提供了不同的函数读取不同的数据,最常用的有以下几类:
data = pandas.read_csv(文件路径)
data = pandas.read_excel(文件路径)
data = pandas.read_json(文件路径)
data = pandas.read_html(url链接)
data = pandas.read_sql(sql语句,数据库连接对象)
这几个函数都会将读到得数据转换为pandas的dataframe对象,其中read_html()函数需要依赖一些其他第三方包,如果没有安装需要pip install一下否则会报错,并且需要注意这个函数只能读取网页上的表格也就是<table> 元素,如果没有读到表格将会报错。read_sql()函数需要通过数据库连接对象和sql语句返回数据转换成dataframe。除此之外还有read_pickle()、read_feather()、read_parquet()可以读取对应的文件类型,这些不太常用这里不展开描述了。
2.数据导出
pandas提供了不同的函数将数据导出为不同格式,最常用的有以下几类:
data.to_csv(文件路径)
data.to_excel(文件路径)
data.to_json(文件路径)
data.to_html(文件路径)
data.to_sql(表名, con=数据库连接对象)
这几个函数可以将dataframe对象转换为指定格式的文件,并且都可以使用encoding、index参数设置编码格式和不保存行索引。to_excel可以使用sheet_name=工作表名指定输出的sheet名称。to_json可以使用orient=‘records’:参数指定输出格式为列表+字典,force_ascii=False:参数指定支持非 ASCII 字符(如中文)。to_sql可以使用if_exists='replace’参数指定表存在时覆盖。除此之外还有to_parquet()、to_hdf()导出为对应的文件类型,这些不太常用这里不展开描述了。
3.Excel进阶操作
很多时候我们需要pandas操作exce数据用于代替vba,pandas提供了ExcelWriter进行更加复杂的读写操作
同时写入多个工作表:
import openpyxl
writer = pandas.ExcelWriter(文件路径, engine='xlsxwriter')
data1.to_excel(writer, sheet_name=工作表1)
data2.to_excel(writer, sheet_name=工作表2)
...
data3.to_excel(writer, sheet_name=工作表3)
writer.close()
使用excel公式:
data["Total"] = "=SUM(A1:A10)"
data.to_excel(writer, sheet_name="Sheet1")
四、常用操作
pandas提供了大量的以series或dataframe为主体的数据的函数,这些函数功能强大是数据处理中最常用的操作。
1.显示数据
为了方便查看较大的数据,pandas为我们提供了data.head()和data.tail()方法用于显示数据head默认显示数据前5行,tail默认显示数据后五行,也可以在参数中指定想要显示的行数。
2.过滤与数值计算
pandas是基于numpy构建的,所以可以支持numpy中的过滤模式和numpy中的函数对数据进行处理,如:布尔值数组过滤obj[obj>0]、数学运算obj*2、numpy函数运算numpy.exp(obj)等。由于过滤的返回值是一个与原数据等长的布尔型series,所以可以直接用这个返回值做过滤条件获取数据,如:data = data[data['score ']>100]
3.统计信息
pandas还提供了data.info()可以查看数据类型和缺失值情况,data.describe()可以查看基本的统计信息如平均值、方差等。
4.缺失值
在数据处理中经常会出现值缺失的问题,pandas把缺失的值标记为NaN,pandas提供了.isnull()和.notnull()函数来检查数据是否为缺失,提供了.dropna()直接删除含缺失值的行或列,.fillna()填充缺失值,.interpolate()在指定位置插值填充
5.重复值
在遇到数据重复的情况下可以使用.drop_duplicates()方法删除重复行
6.值替换
对于数据值可以使用.replace({'value_source1': 'value_target1', 'value_source2': 'value_target2'})进行替换,对于列名可以使用.rename(columns={'name_source1':'name_target1','name_source2':'name_target2'})进行替换
7.排序
pandas提供了.sort_values(by='column_name', ascending=False) 方法对数据进行排序
8.合并
pandas有两种合并方式,.concat([df1, df2])纵向或横向拼接,.merge(df1, df2, on='key')按照某列的匹配情况来合并
9.分组
.groupby('column_name')按某列分组
10.透视表与可视化
pandas提供了透视表和可视化的方法,这里不过多赘述,需要可以自行查阅相关资料
五、小技巧
在win上操作文件,有时候会遇到一些问题:
命令行乱码时可以使用命令:
import os
os.system("chcp 65001")
想要获取系统时间并生成指定格式:
from datetime import datetime
str_date = "%d-%02d-%02d" % (datetime.now().year, datetime.now().month, datetime.now().day)
判断文件或目录是否存在时:
import os
if not os.path.exists(文件路径):
简单的数据下载:
import wget
url_data = 'https://url'
def bar_progress(self, current, total, width=80):
    return "Downloading: %d%%" % (current / total * 100)
wget.download(url_data, out=file_out, bar=self.bar_progress)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)