机器学习(九)——聚类(分类+原理+计算示例)
1、聚类的定义
\qquad聚类:是机器学习中的无监督学习,目标是通过对无标记训练样本的学习来解释数据的内在性质以及规律,为进一步的数据分析提供基础。
\qquad聚类试图将数据集中的样本划分为若干个通常是不相交的子集,每个子集称为一个“簇”
2、常见聚类算法
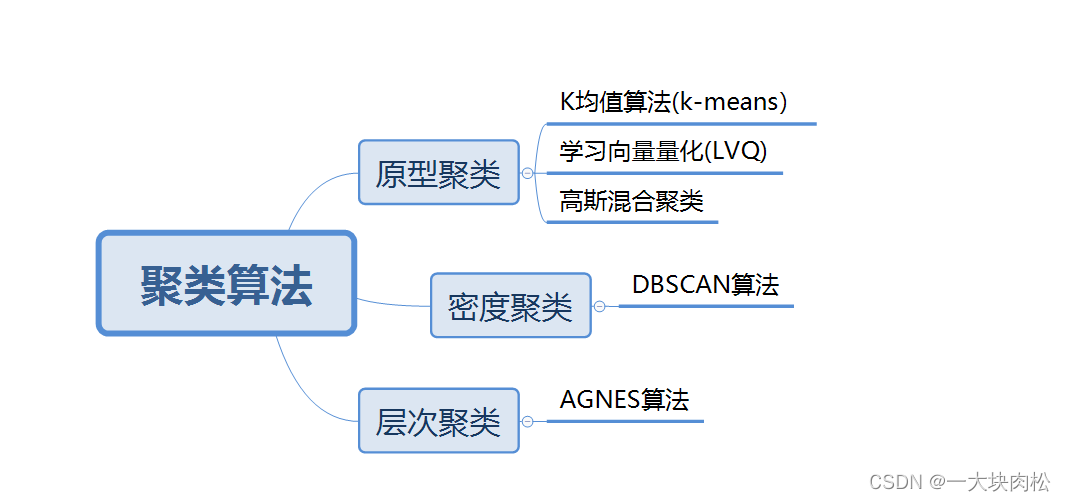
3、原型聚类
\qquad原型聚类亦称为“基于原型的聚类”(prototype-based clustering),这一类算法假设聚类结构能通过一组原型刻画,在现实聚类中很常用。
\qquad其统一的步骤为:
算法先对原型进行初始化,然后对原型进行迭代更新求解。
3.1 kkk均值聚类(k−meansk-meansk−means)算法
\qquad给定样本集D=(x1,x2,.....xm)D=(x_1,x_2,.....x_m)D=(x1,x2,.....xm),共m个样本集,“kkk均值”算法针对聚类所得簇划分C=(C1,C2,......Ck)C=(C_1,C_2,......C_k)C=(C1,C2,......Ck),即需要将样本集中的所有样本根据规则,将其分别划分至合适的簇中,最小化平方误差:
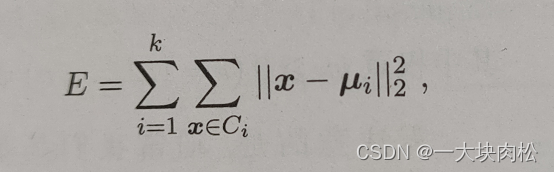
\qquad最小化平方误差,找到它的最优解需要考察样本集DDD中的所有可能的簇划分,这是一个NP难问题。因此,kkk均值算法采用了贪心策略,通过迭代优化来近似求解上式,算法的具体流程如下:
1.从样本集DDD中随机选择kkk个样本作为初始的均值向量,每个样本表示一个簇;
2.计算样本集中的其他样本与初始的均值向量的距离,根据距离最近的均值向量确定该样本所属的簇;
3.对D中的所有样本均划分完成后,根据划分的簇中的样本,重新计算均值向量,更新当前均值向量后,再重复计算样本与均值向量的距离,重新划分;
4.不断重复2、3的步骤,直到迭代的均值向量不再发生变换或达到最大迭代次数,算法终止,得到最终的簇划分。
3.1.1 实例计算kkk均值算法学习过程
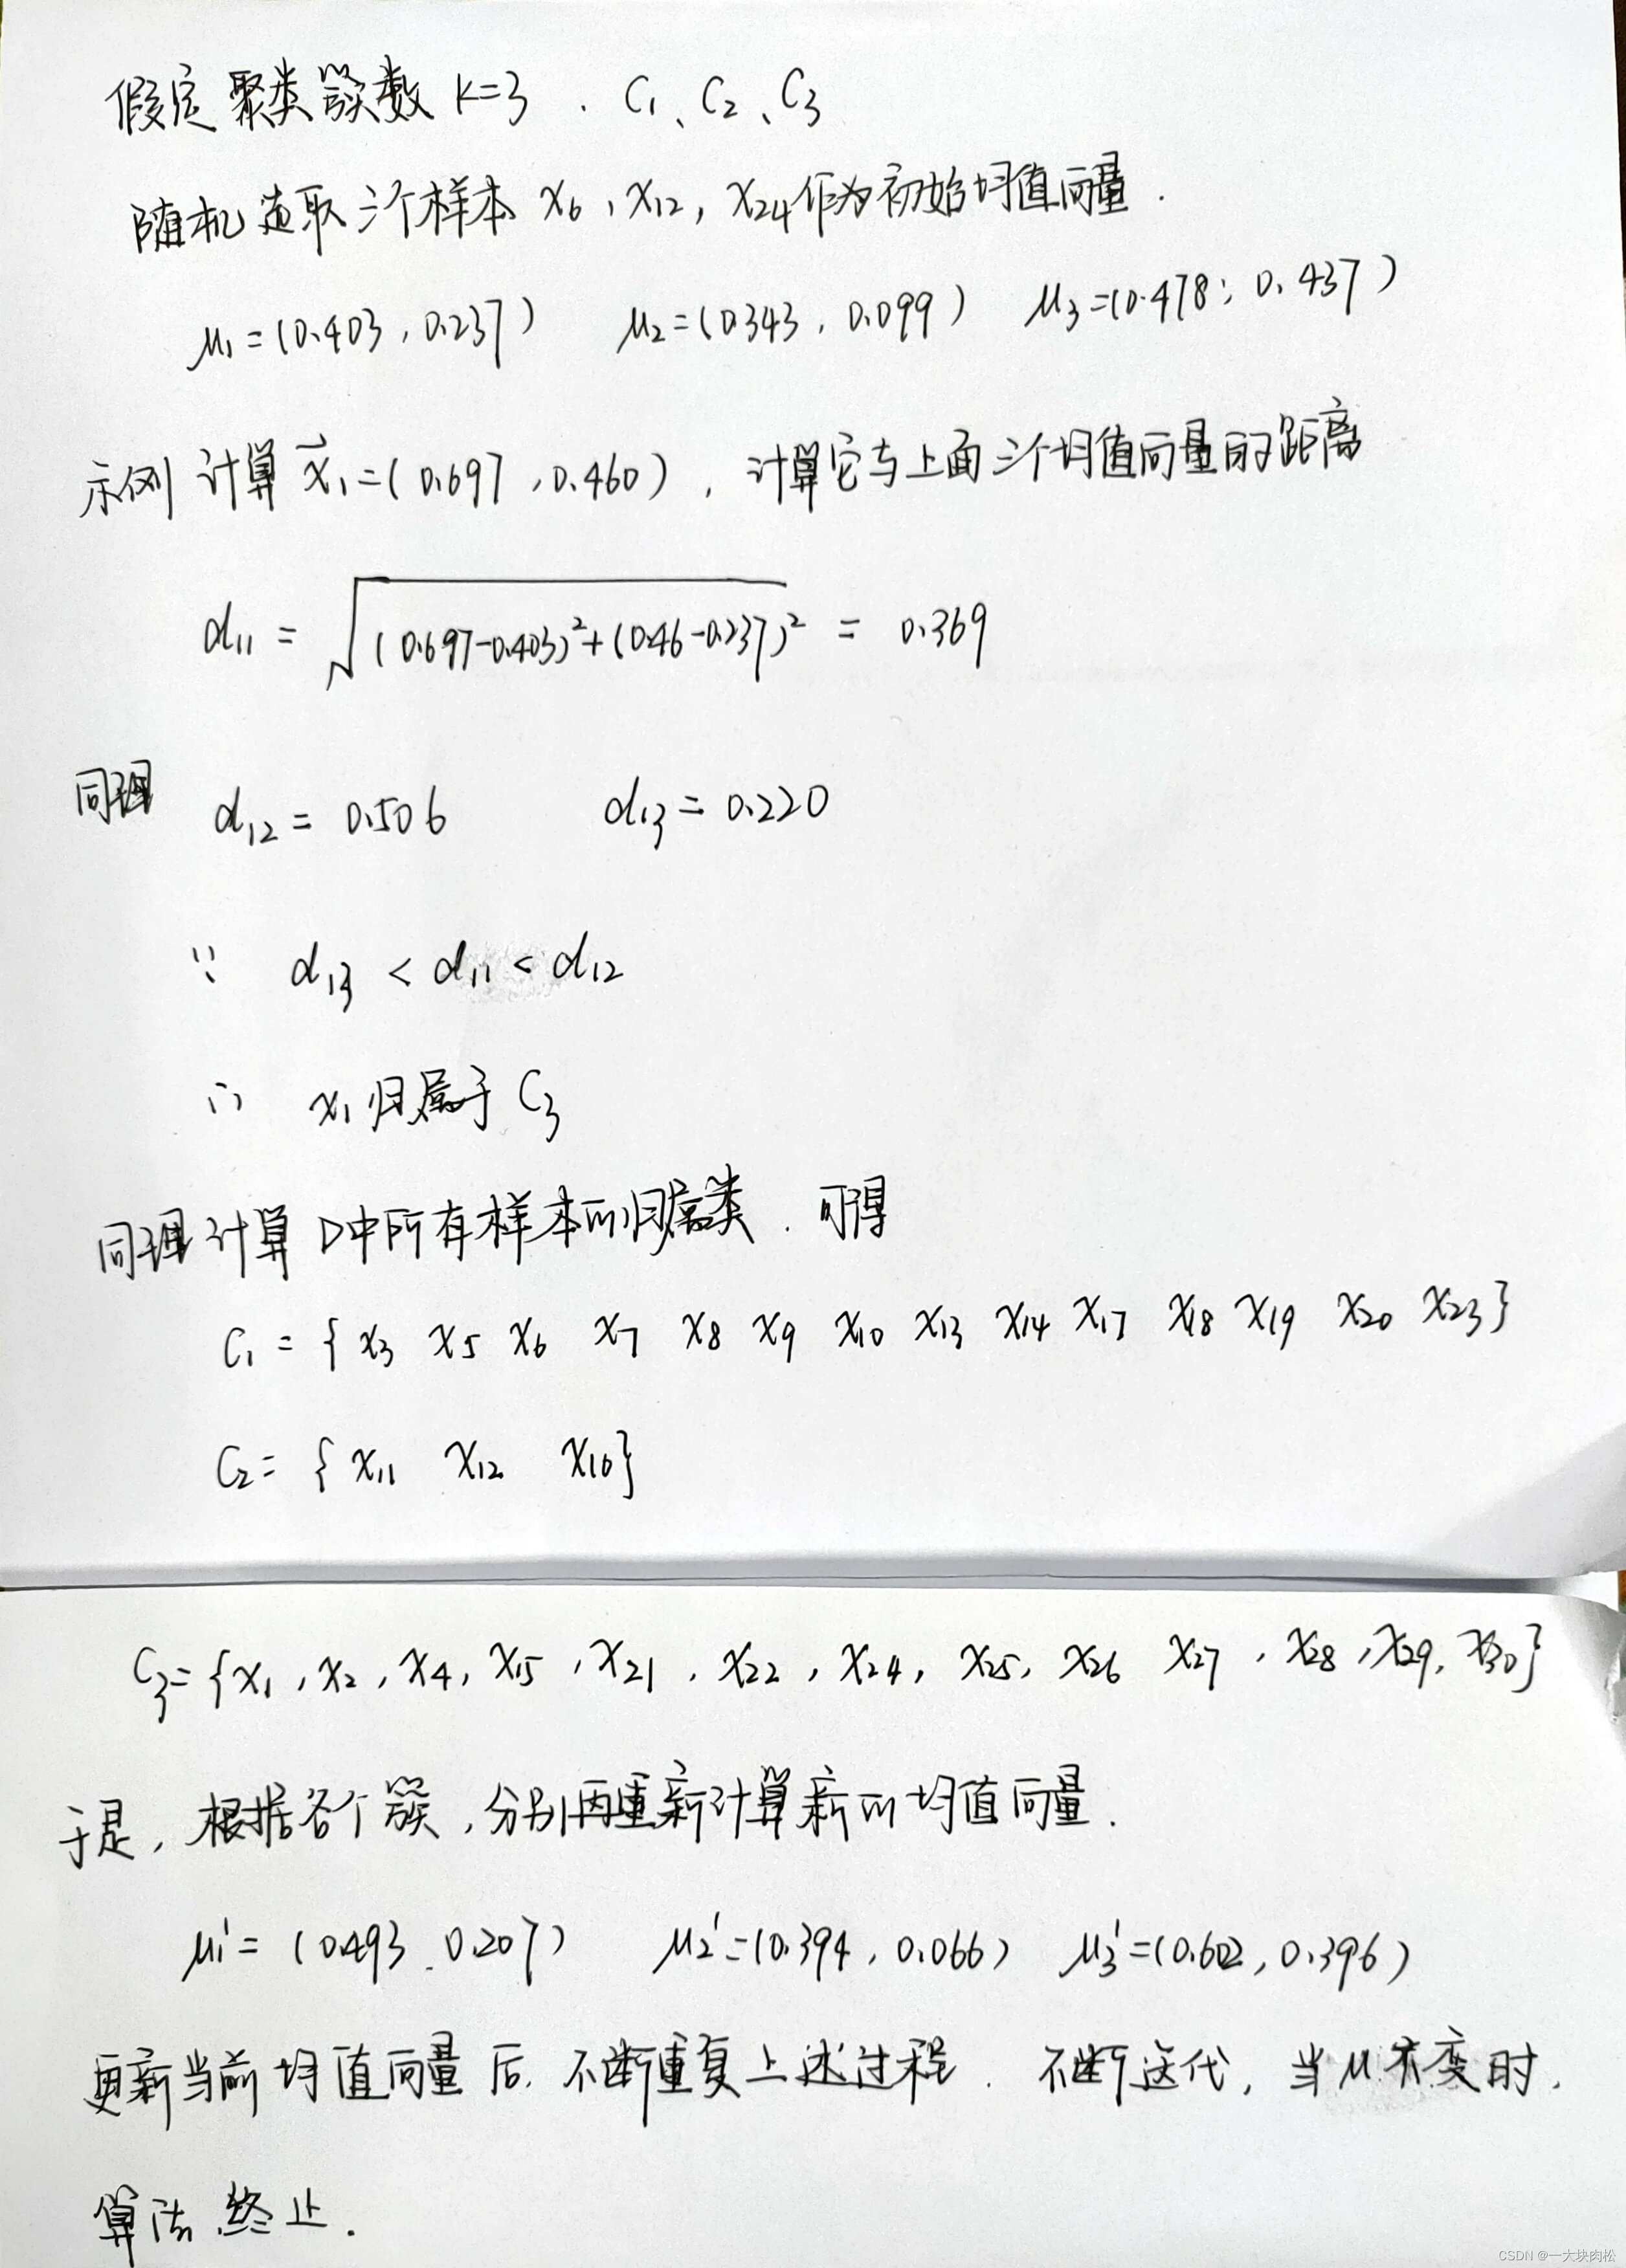
\qquad参考《机器学习》书中的西瓜案例进行计算演示:
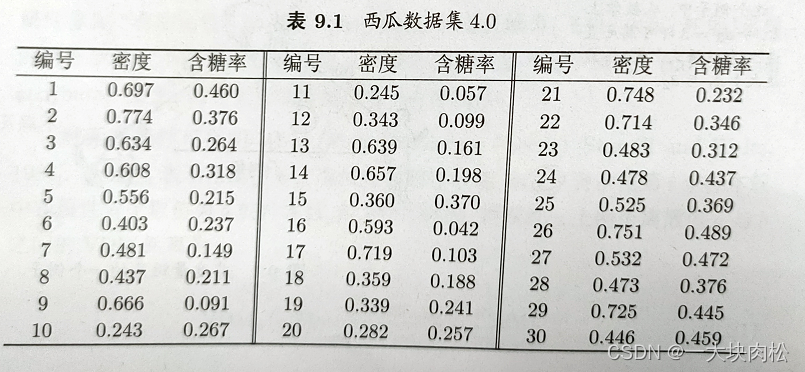
计算过程:
最终迭代的结果图:
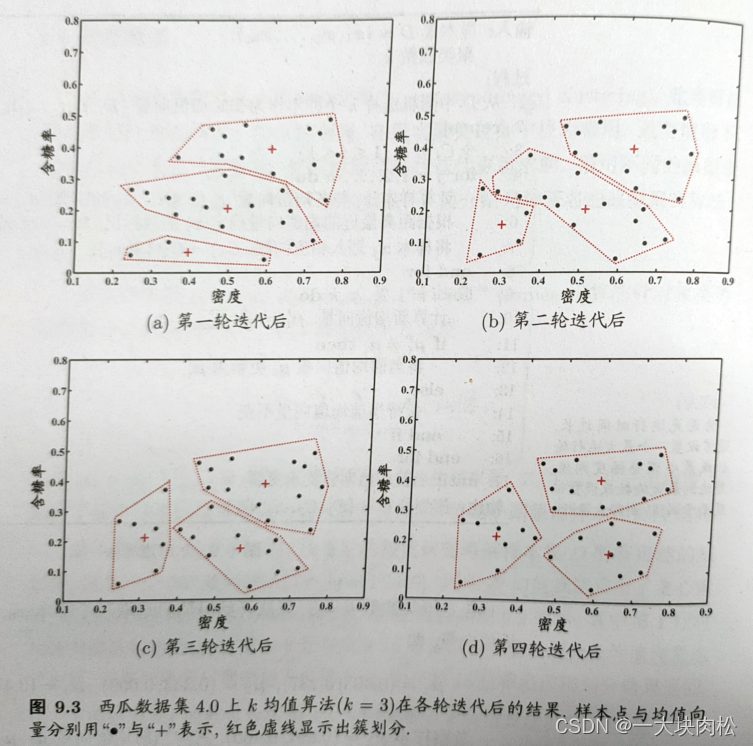
3.2 学习向量量化算法
\qquad与kkk均值算法类似,“学习向量量化”(Learning Vector Quantization,简称LVQ)也是试图找到一组原型向量来刻画聚类结构,但与一般聚类算法不同的是,LVQ假设数据样本具有类别标签(类别标签是人为定义的),学习过程中利用样本的这些监督信息来辅助聚类。
\qquad在样本数据集上会有一些变化,即样本集D=(x1,y1),(x2,y2).......(xm,ym)D={(x_1,y_1),(x_2,y_2).......(x_m,y_m)}D=(x1,y1),(x2,y2).......(xm,ym),其中,每个样本都有一个类别标签yjy_jyj。
\qquadLVQ的目标是学得一组nnn维原型向量{p1,p2,...,pnp_1,p_2,...,p_np1,p2,...,pn},每个原型向量代表一个聚类簇。
\qquad那么重点来了,初始阶段我们随机选取nnn个原型向量,即聚类的簇数,那么我们怎样通过计算,去更新我们的初始值(原型向量),以达到最好的聚类效果呢?
\qquad针对样本集DDD中的一个样本xjx_jxj,计算其与原型向量之间的距离,选择与xjx_jxj最近的一个原型向量pip_ipi,接下来判断该原型向量的类别与样本xjx_jxj的类别是否相同,若相同,则令该原型向量pip_ipi向xjx_jxj方向靠拢,由此得到新的原型向量,具体的计算公式为:
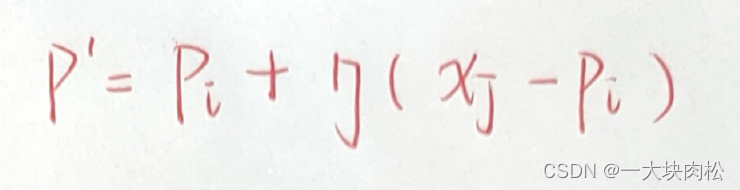
若不同,则令该原型向量pip_ipi远离xjx_jxj,由此得到新的原型向量,具体的计算公式为:
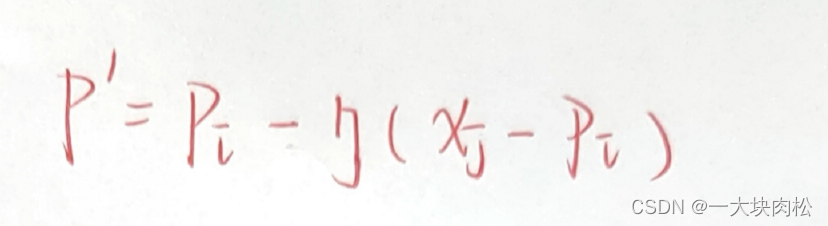
\qquad算法的整体流程如下:
1.从样本集DDD中选择一组原型向量,假设选取nnn个样本;
2.从样本集DDD中随机选取样本(xj,yj)(x_j,y_j)(xj,yj),分别计算其与第一步中选取的原型向量的距离d=∣∣xj−pi∣∣d=||x_j-p_i||d=∣∣xj−pi∣∣;
3.根据计算的距离,选取与样本距离最近的一个原型向量,接着去判断该样本与原型向量的类别标签是是否相同,根据不同的公式去更新该原型向量;
4.接着不断重复2,3步骤,不断迭代更新,直到满足条件停止更新;
5.输出最终的簇分类结果。
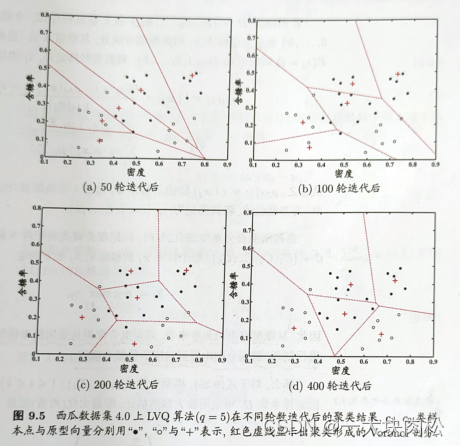
3.2.1实例计算LVQ算法学习过程
\qquad参考《机器学习》书中的西瓜案例进行计算演示:
计算过程:
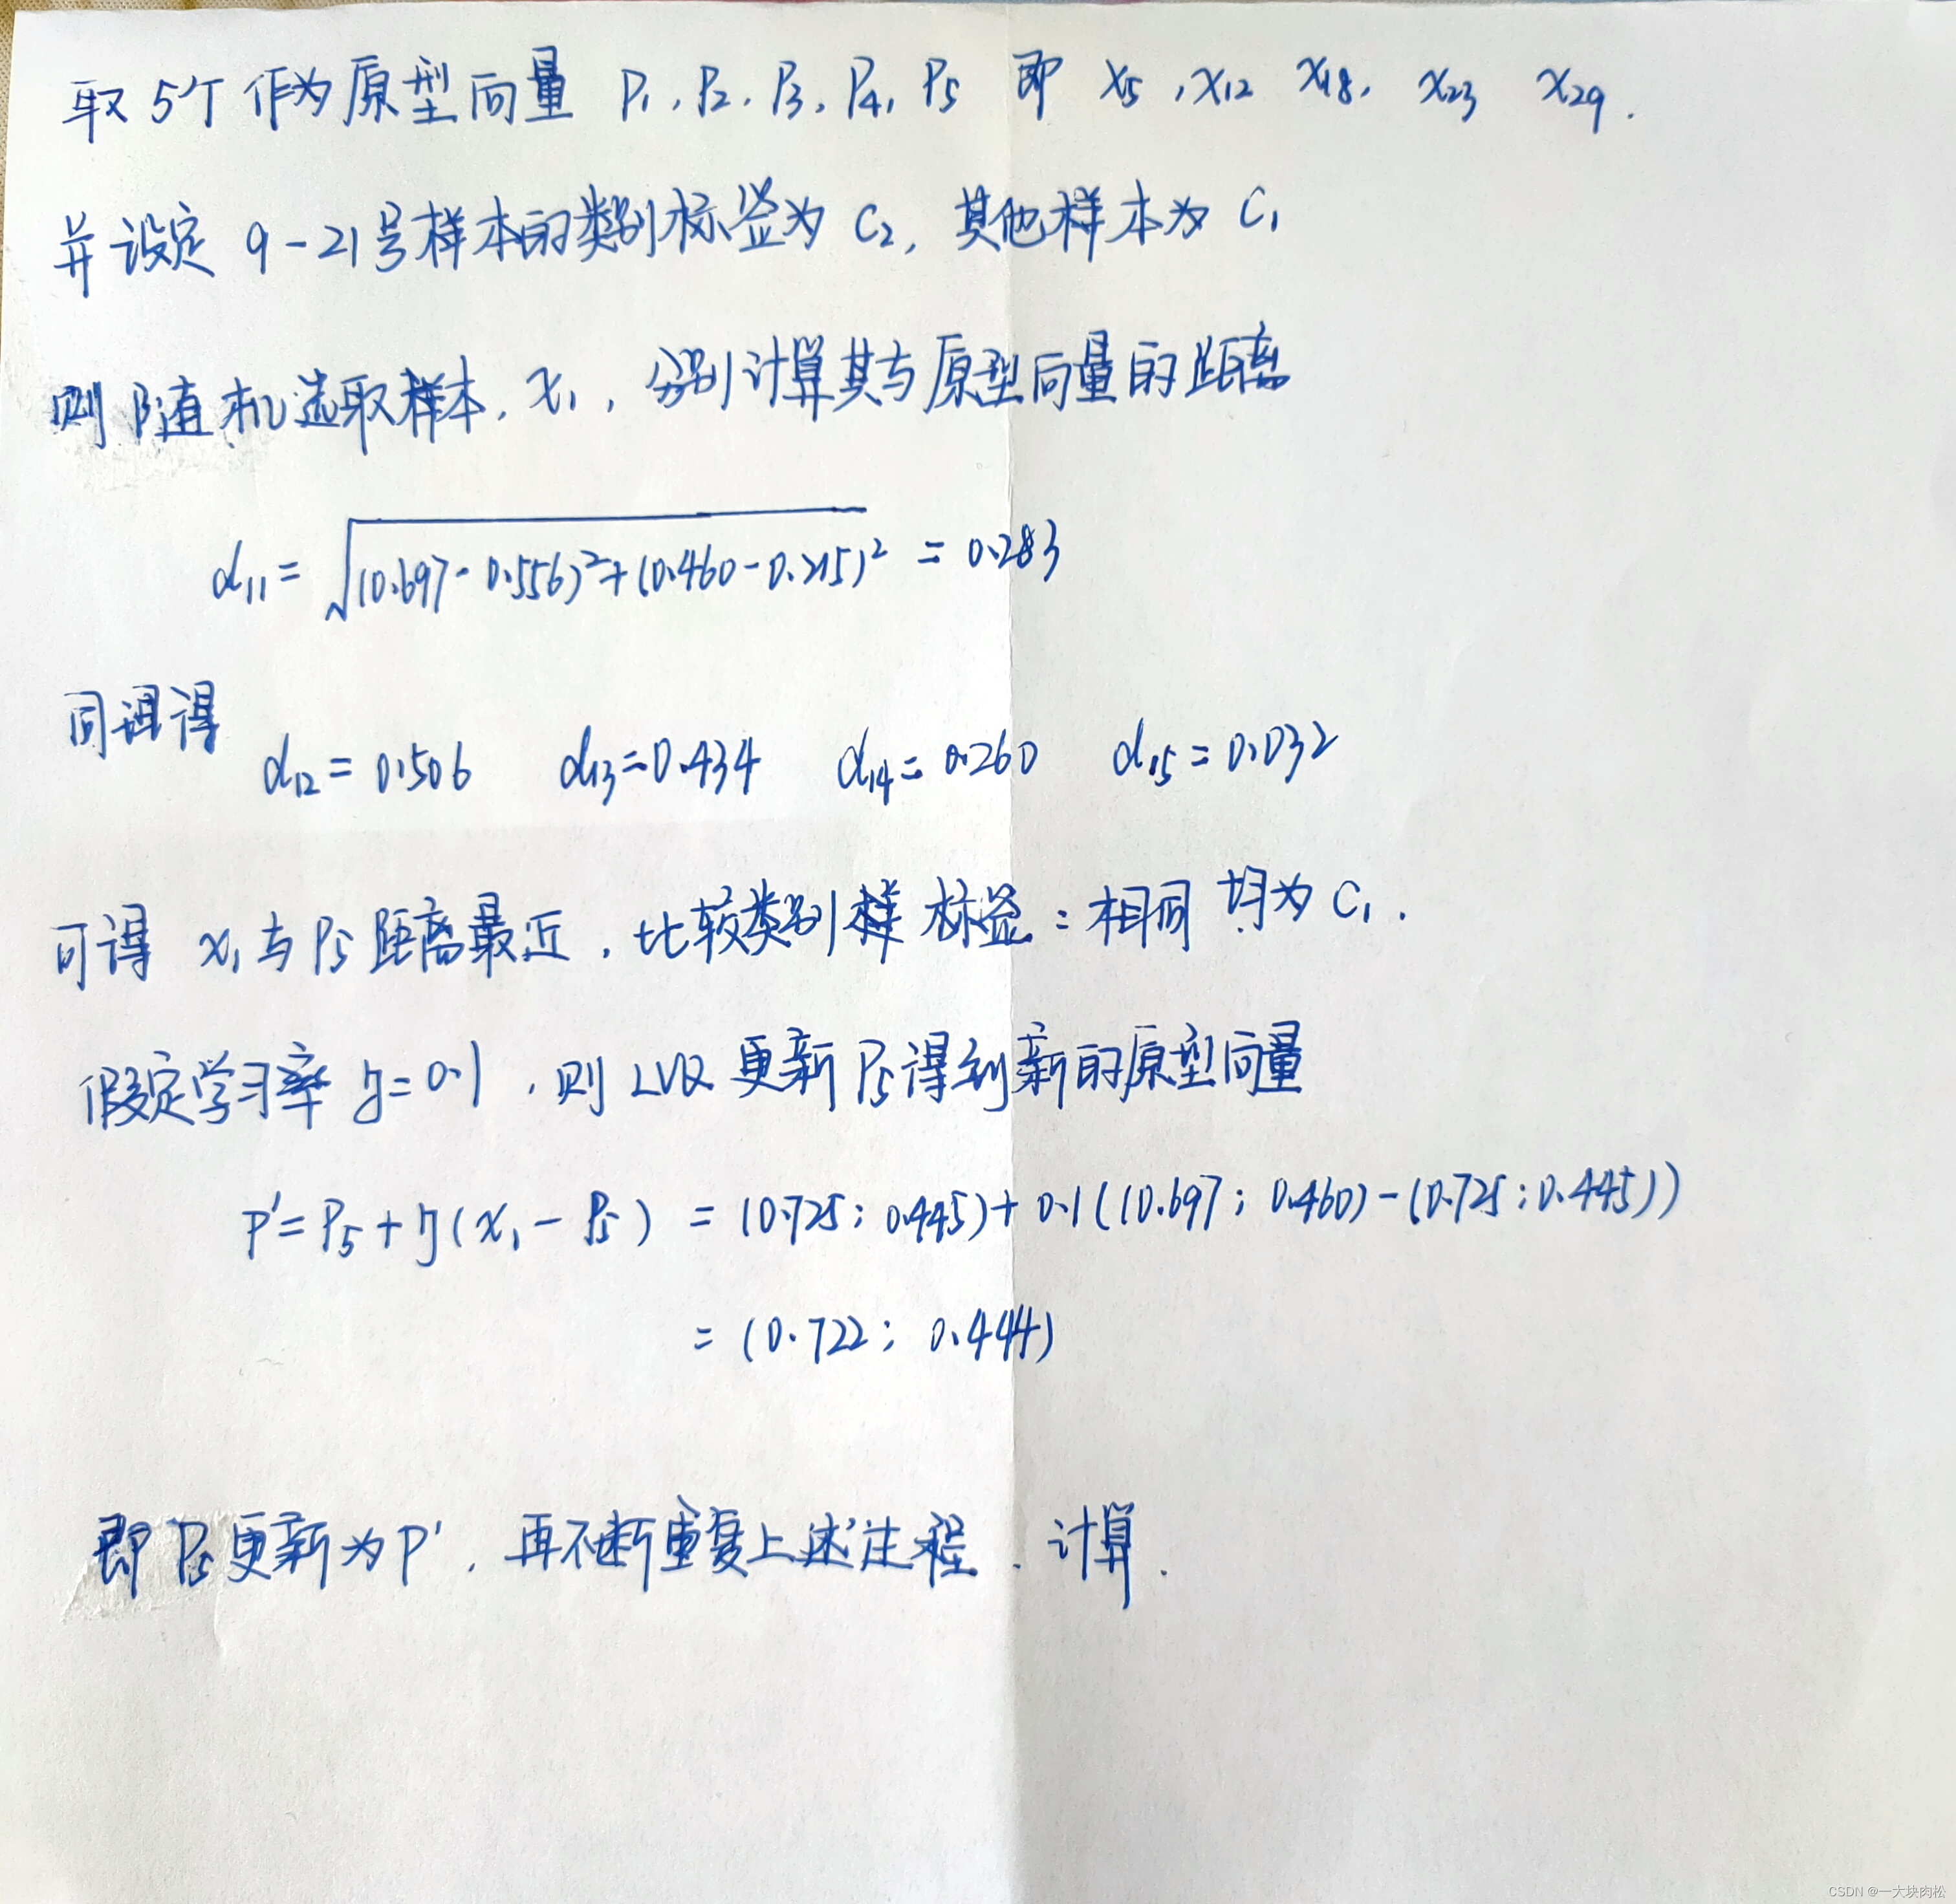
最终迭代的结果图:
3.3 高斯混合聚类算法
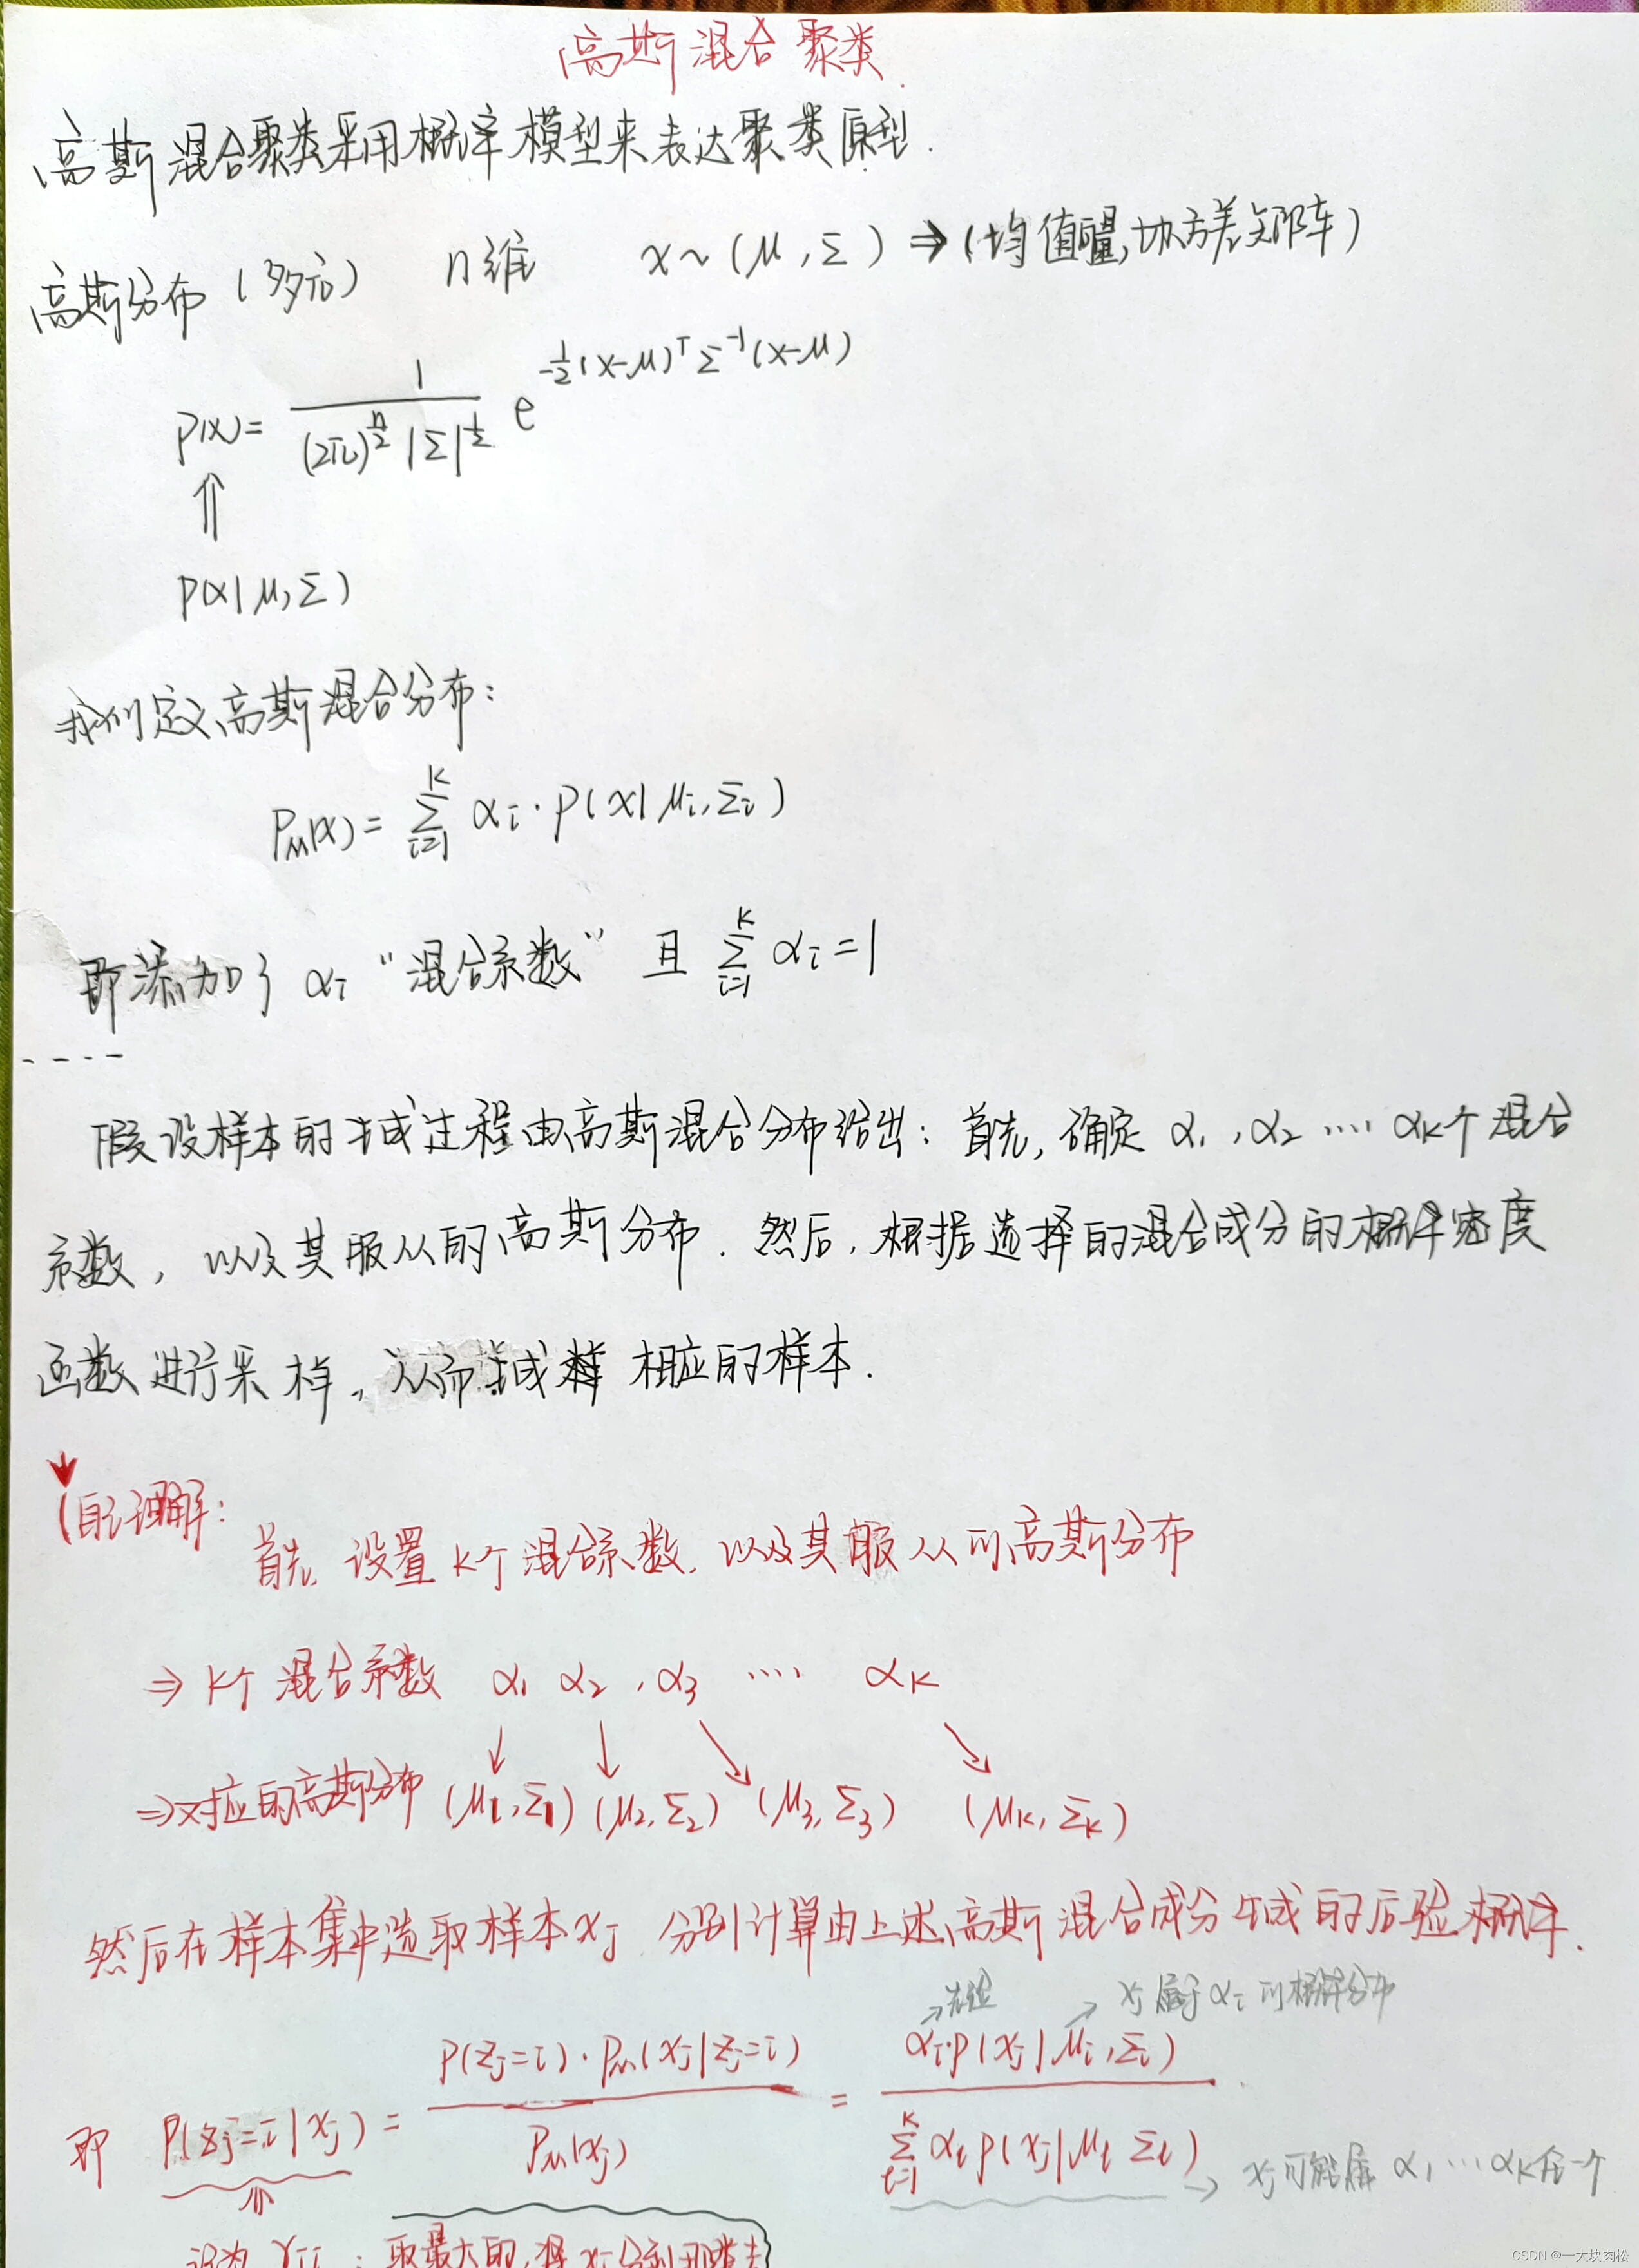
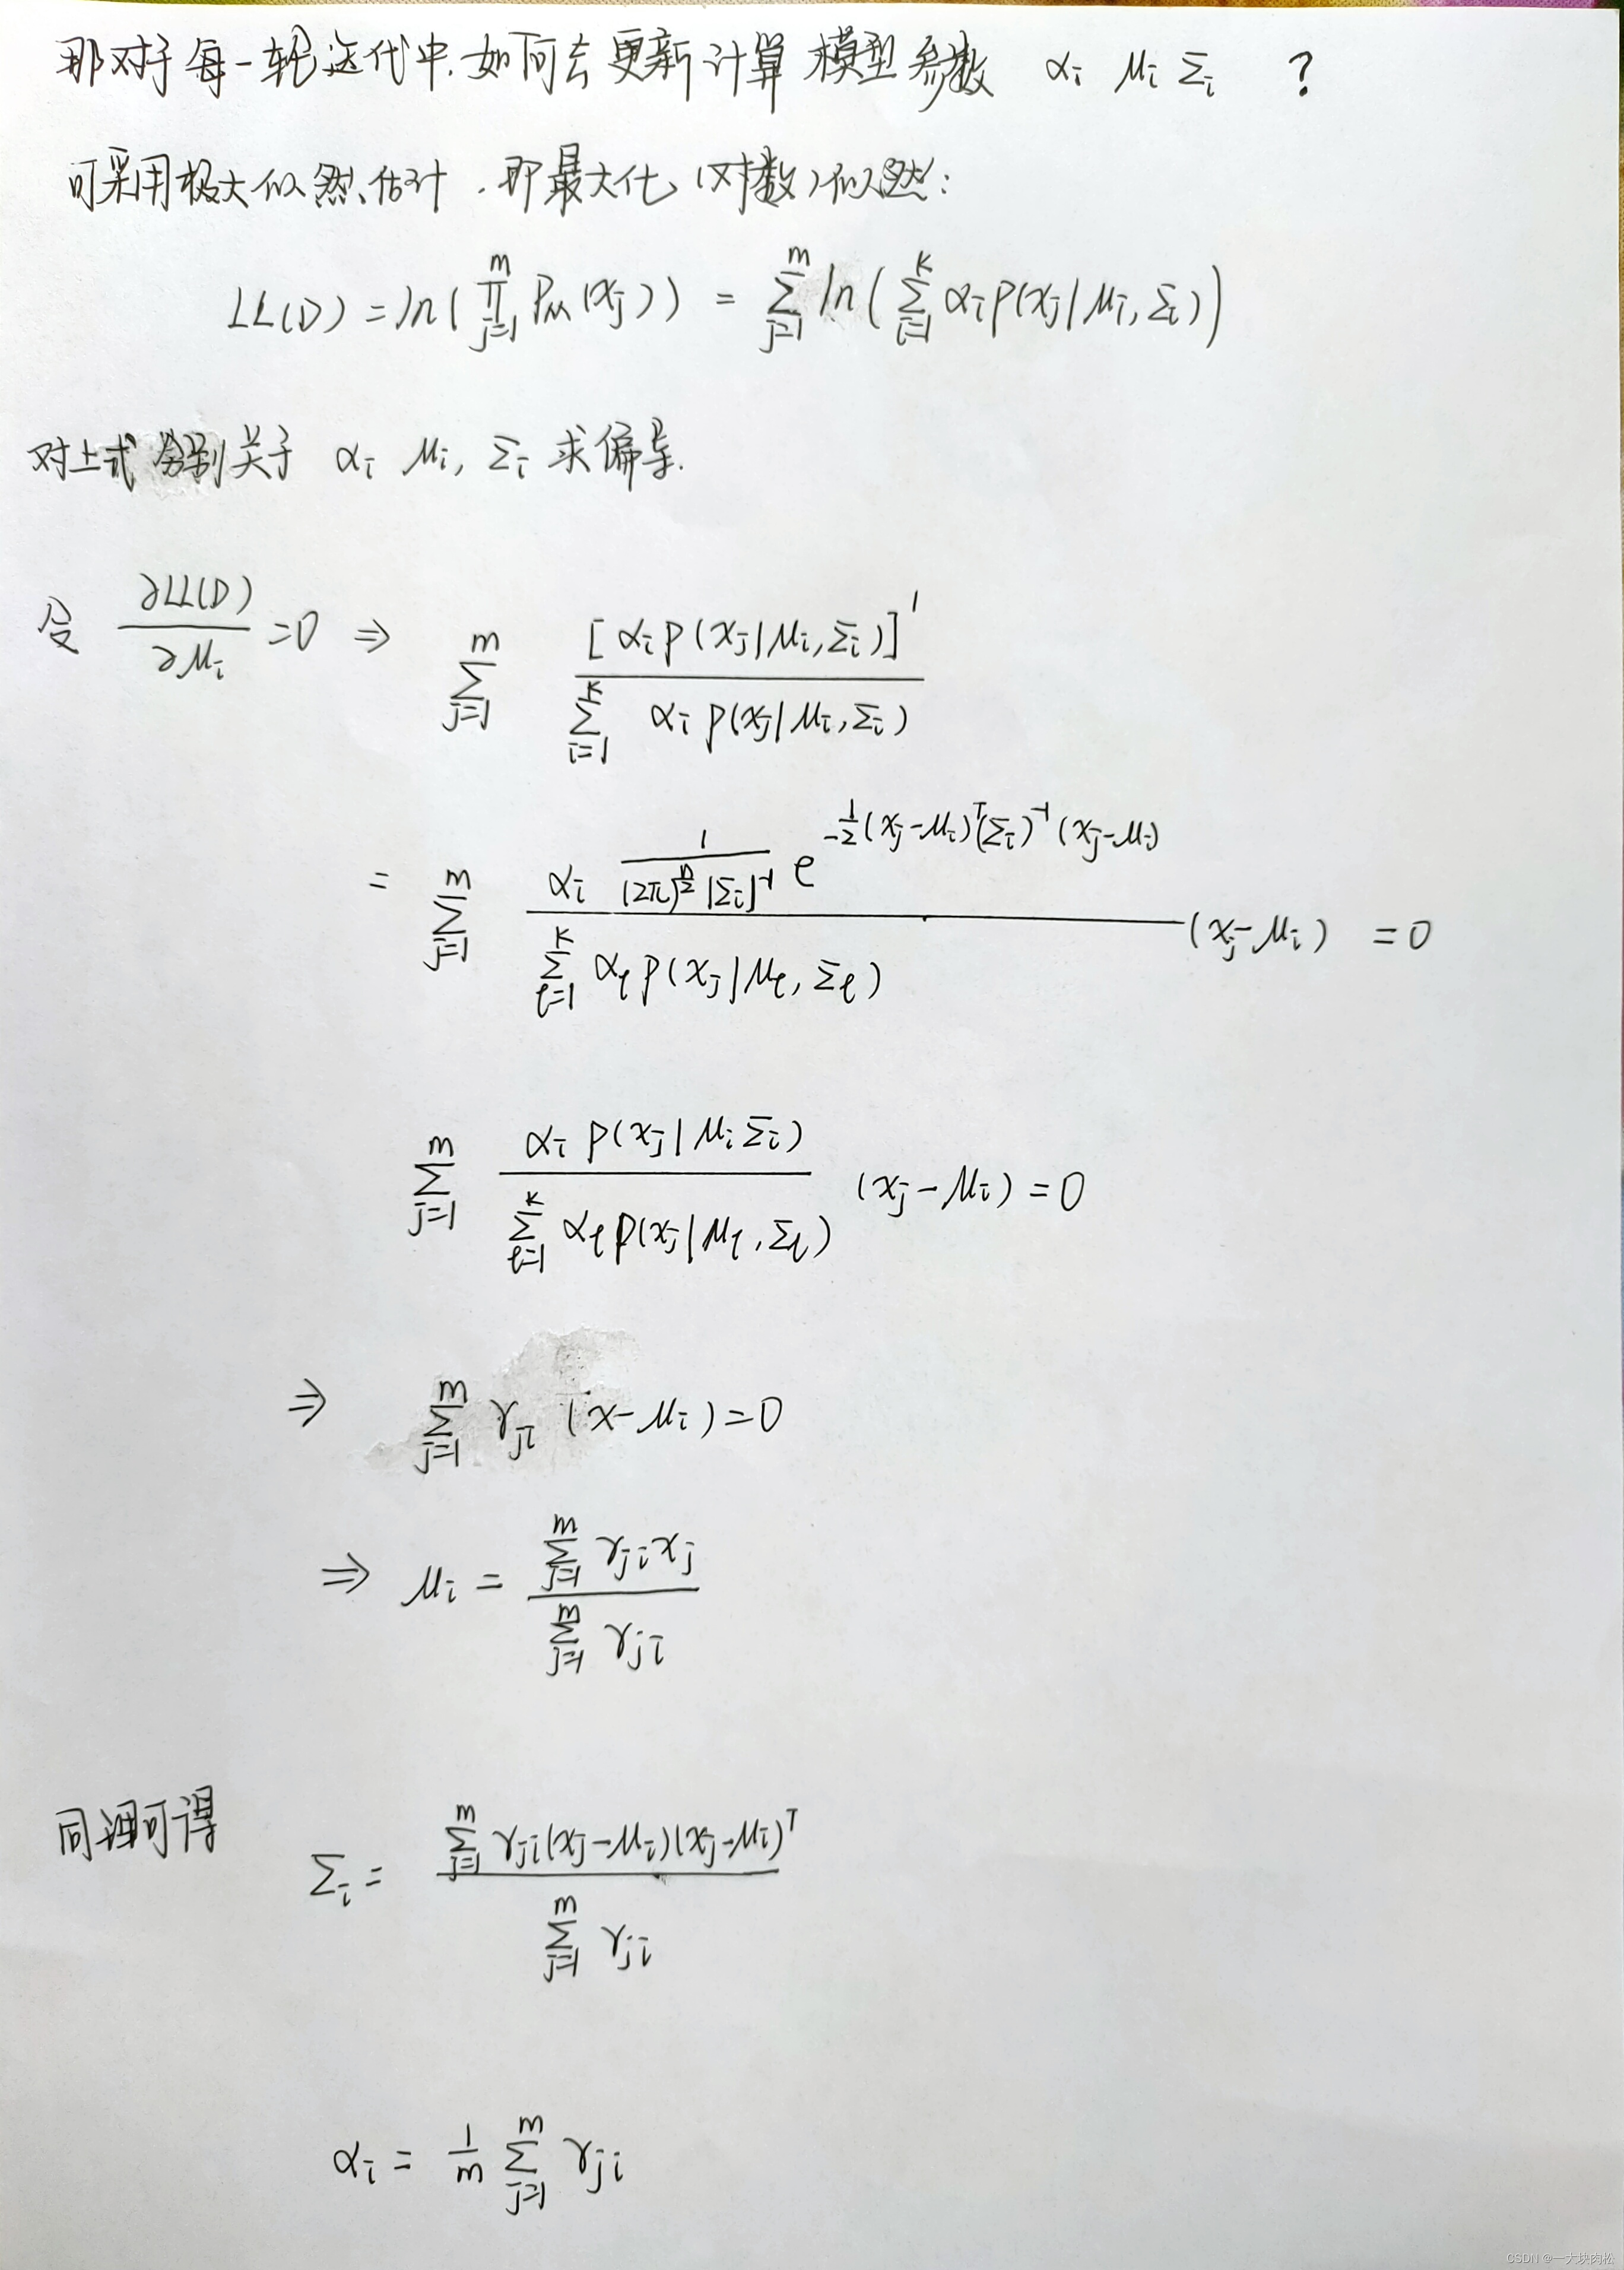
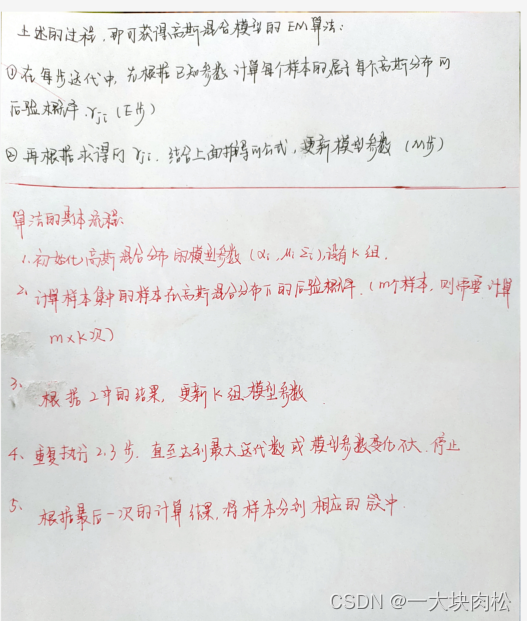
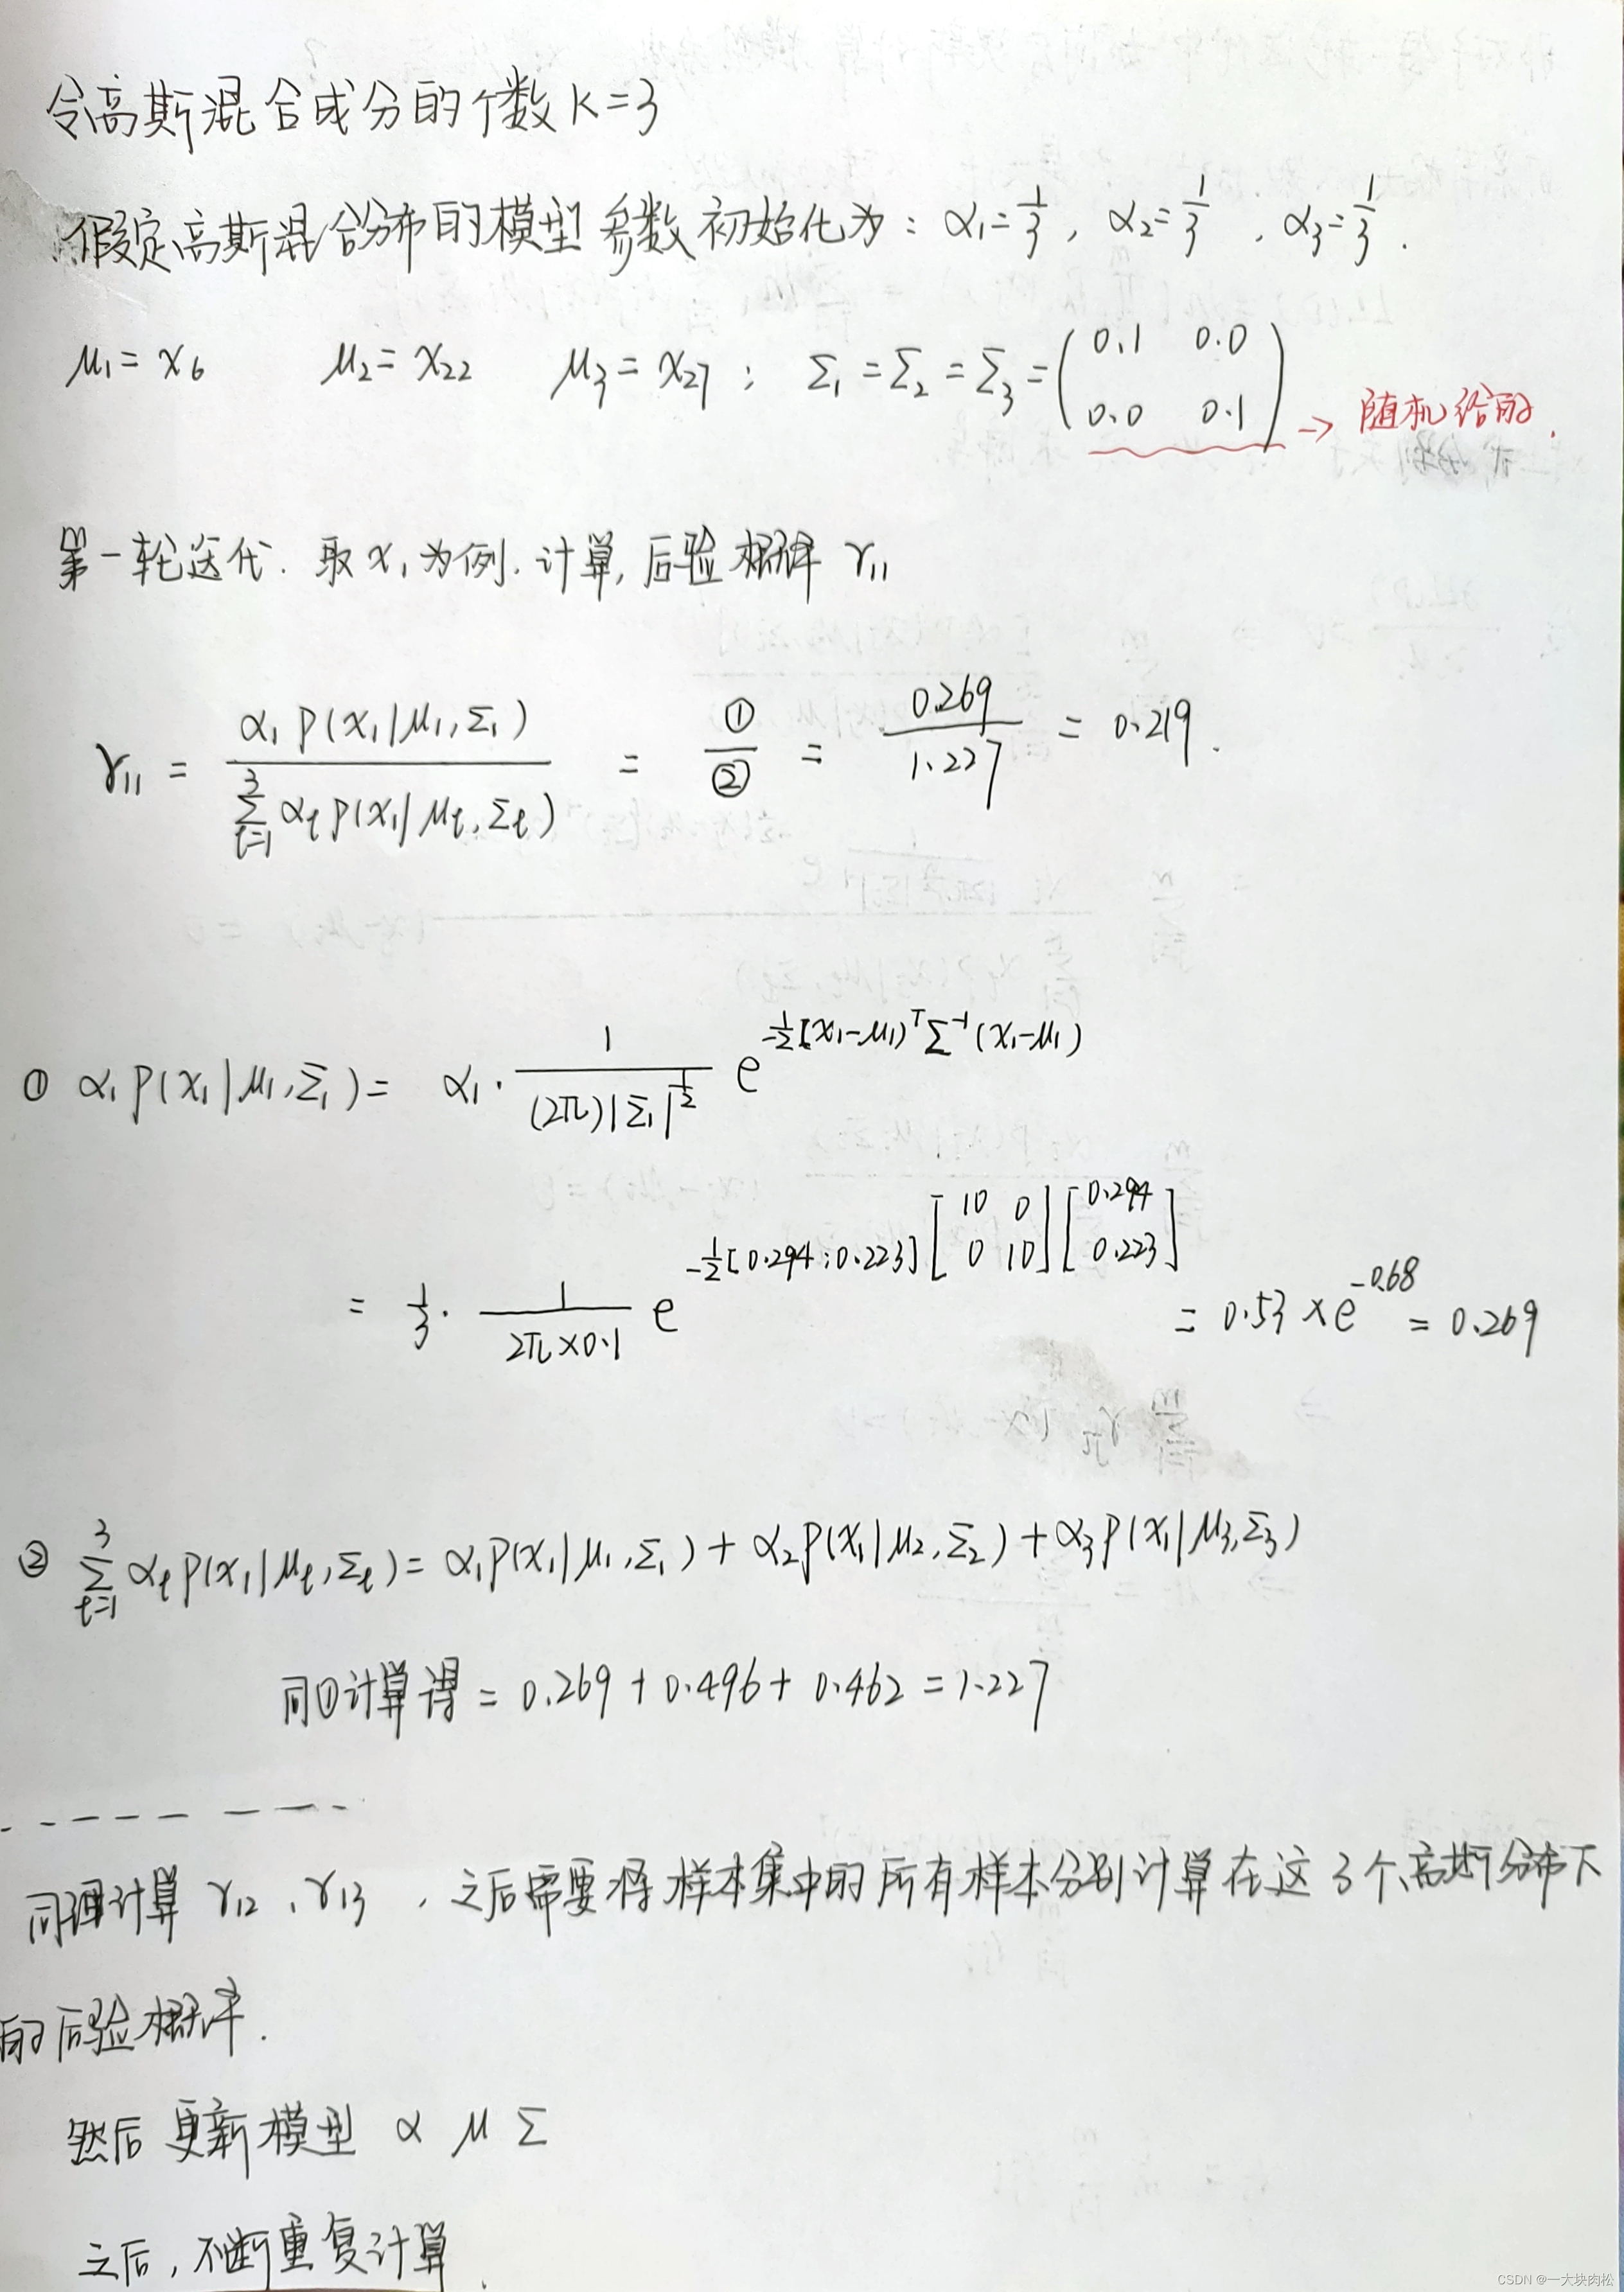
3.3.1实例计算高斯混合聚类算法学习过程
\qquad参考《机器学习》书中的西瓜案例进行计算演示:
计算过程:
4、密度聚类
\qquad密度聚类也称为“基于密度的聚类”,此类算法假设聚类结构能通过样本分布的紧密程度确定。通常情形下,密度聚类算法从样本密度的角度来考察样本间的可连接性,并基于可连接样本不断扩展聚类簇以获得最终的聚类结果。
\qquadDBSCAN是密度聚类的代表算法。
\qquad它是基于一组“邻域”的参数(ϵ\epsilonϵ,MinPts)来刻画样本分布的紧密程度。
\qquad所谓的“邻域”参数(ϵ\epsilonϵ,MinPts),即与样本xjx_jxj距离不大于ϵ\epsilonϵ的最少样本数MinPts。
了解几个概念: 核心对象 密度直达 密度可达
核心对象:是指样本xjx_jxj的邻域内至少包含MinPts个样本,则称xjx_jxj为核心对象
密度直达:若xix_ixi位于xjx_jxj的邻域内,且xjx_jxj是核心对象,则称xix_ixi由xjx_jxj密度直达
密度可达:对于样本xix_ixi、xjx_jxj,中间有一个样本xmx_mxm,使得xix_ixi由xm密度直达,那么称x_m密度直达,那么称xm密度直达,那么称x_i由由由x_j$密度可达。
\qquad算法的具体流程:
1.首先设定邻域参数(ϵ\epsilonϵ,MinPts);
2.然后计算样本集DDD中的每个样本xjx_jxj是否符合为核心对象,计算完所有的样本,将符合条件的样本放入一个集合中,即核心对象集合;
3.然后从核心对象集合中随机选取一个核心对象,作为一个种子,找出与它密度可达的所有样本,这样就构成一个样本簇;
4.将核心对象集合中与第3步中重合的样本,从核心对象集合中去除;
5.然后不断重复3,4步骤,直至核心对象集合为空,这样就构成了不同的聚类簇。
4、层次聚类
\qquad层次聚类试图在不同的层次对数据集进行划分,从而形成树形的聚类结构。数据集的划分可采用“自底向上”的聚合策略,也可采用“自顶向下”的分拆策略。
\qquadAGNES是一种采用“自底向上”聚合策略的层次聚类算法。它先将数据集中的每个样本看作是一个初始聚类簇,然后在算法运行的每一步中找出距离最近的两个聚类簇进行合并,该过程不断重复。直至达到预设的聚类簇个数。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 14
 0
- 0


 已为社区贡献6条内容

所有评论(0)