Python数据分析3-外部数据的读取于存储
对于数据分析而言,数据大部分来源于外部数据,如常用的CSV文件、Excel文件和数据库文件等。本章讲解如何李彤pandas库将外部数据转换为DataFrame数据格式,再通过Python进行处理,将DataFrame数据存储到相应的外部数据文件中。
3.1文本数据的读取于存储
3.1.1CSV文件的读取
pandas库提供了将表格型数据读取为DataFrame数据结构的函数。在现实应用中,常用的有read_csv和read_table函数,具体差异如下表:
| 字符 | 作用 |
| read_csv | 从文件中加载带分隔符的数据,默认分隔符为逗号 |
| read_table | 从文件中加载带分隔符的数据,默认分隔符为制表符 |
CSV是存储表格数据的常用文件格式,可通过read_csv函数进行读取。首先通过Python自带的CSV库创建CSV文件。
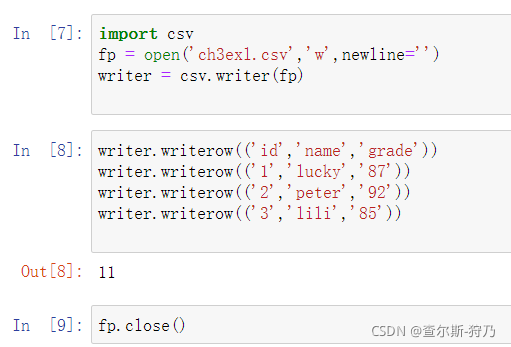
除了通过打开文件查看数据之外,还可以通过type方法查看数据,如图
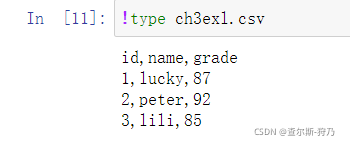
注:后面创建CSV文件的代码不再展示;type方法只适用于windows系统,UNIX系统使用!cat
由于创建的文件是标准的CSV文件,所以使用read_csv函数读取即可。如下图
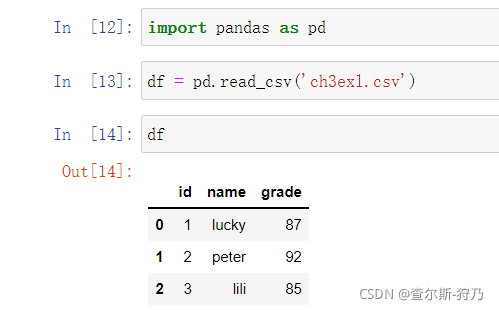
注:读取CSV文件时,如果文件路径中有中文,需要加open函数,否则会报错

对于CSV文件,也可以使用read_table进行读取,指定分隔符即可,如图
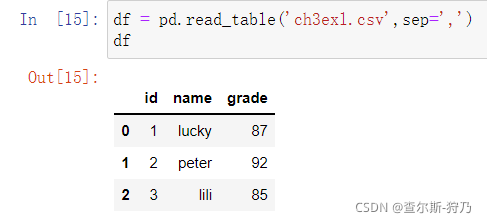
但实际应用中,CSV文件的格式并不会如此规整。下面通过几个例子来讲解read_csv函数的参数(read_table函数参数也相同)使用,以解决各种CSV文件的读取方法。
1 指定列作为索引
默认情况下,读取的DataFrame的行索引是从0开始计数。一前面的CSV文件为例,读者可自由指定列为行索引。例如,通过index_col参数指定id为行索引,如下图
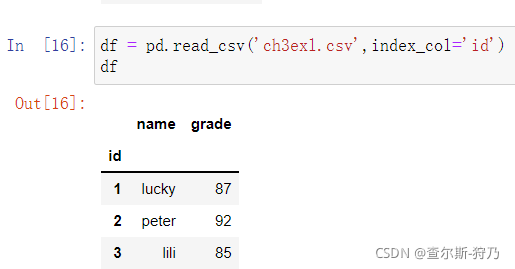
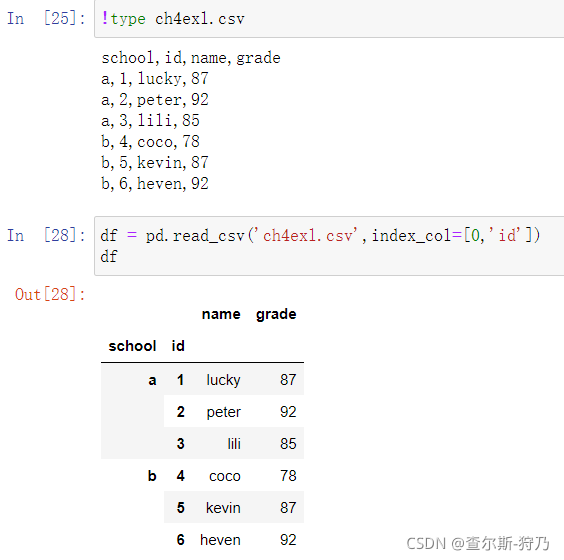
如果希望多个列做成一个层次化索引,传入如列标号或者列名组成的列表即可。首先看下CSV文件,如下图,传入列编号和列名,可将多列做成层次化索引
2 行标题设置
有些情况下,CSV文件没有标题行,如果使用默认情况读取,会指定第一行为标题行
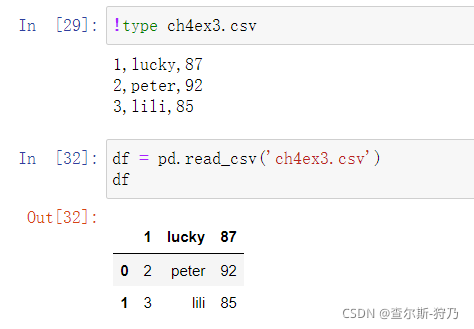
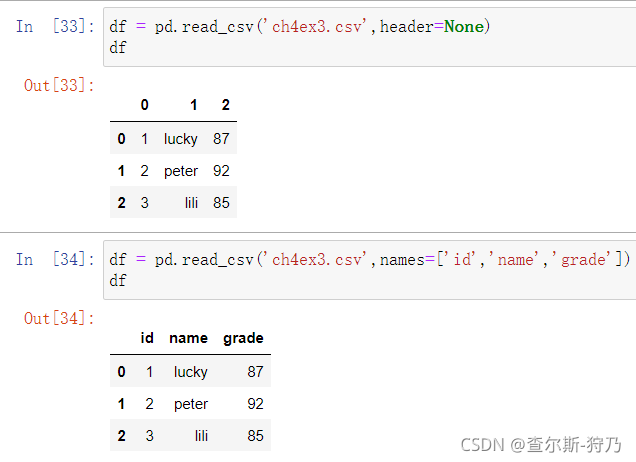
读取该 文件的方法有两种,一种是通过header参数分配默认的标题行,另一种是通过names参数给其指定列名,如图
3 自定义读取
由于数据原因或者数据分析的需要,有时间只需选择读取部分行或列。首先看一下数据情况
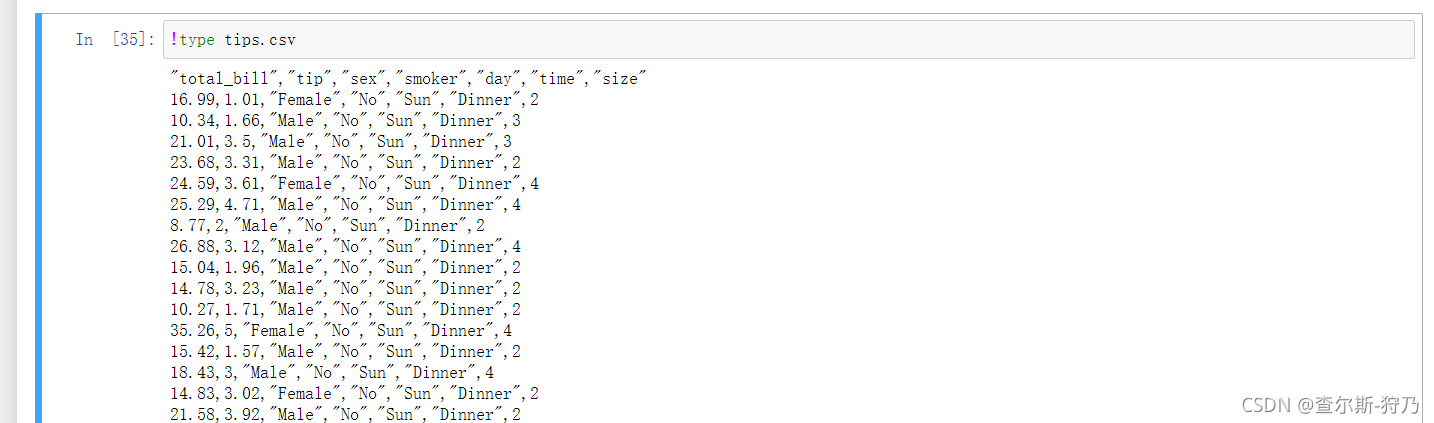
通过skiprows参数可跳过指定行。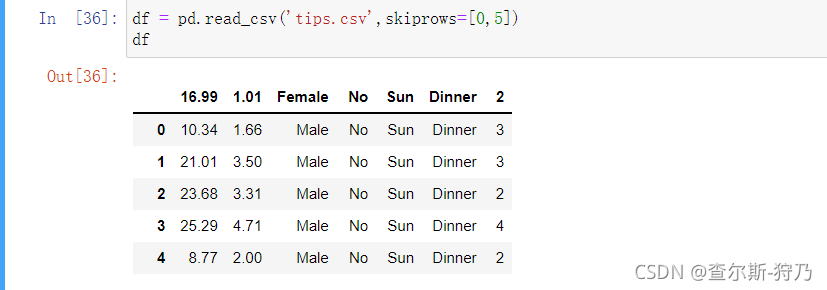
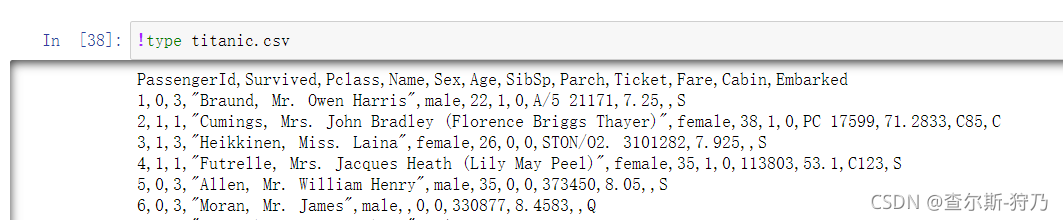
有时候只需要读取部分数据,下图是Kaggle比赛中的泰坦尼克号生还者数据。
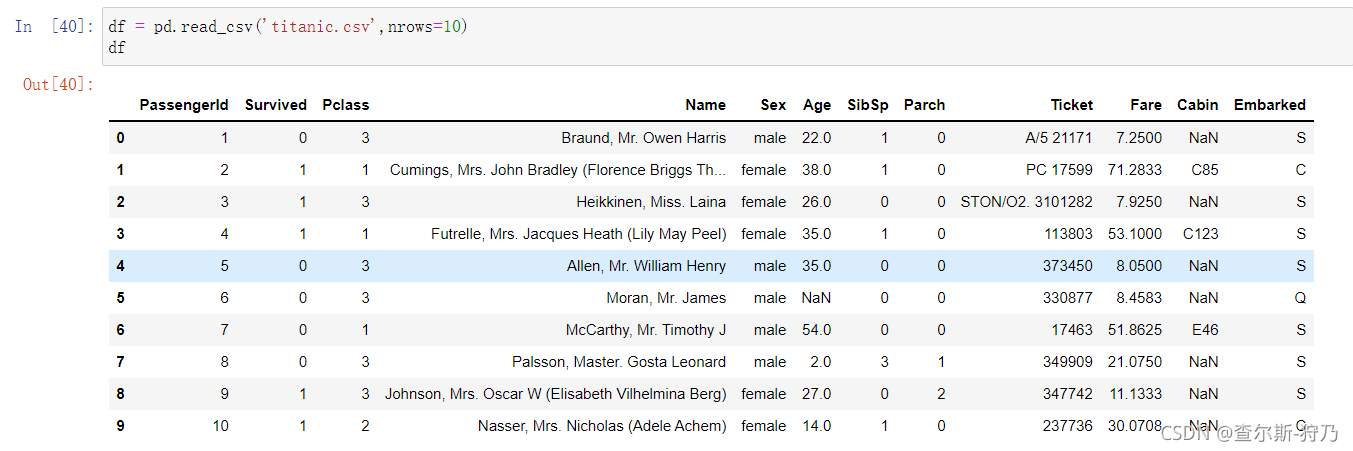
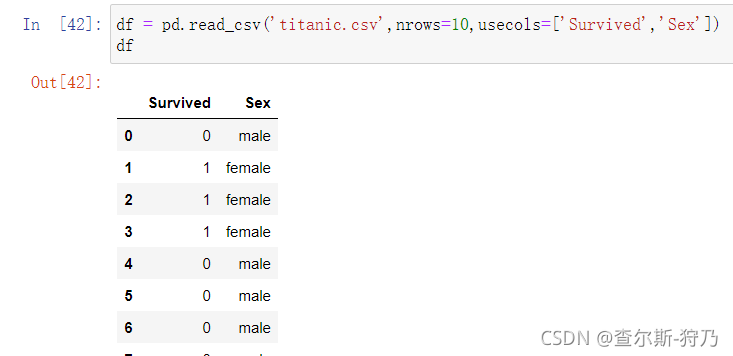
通过nrow参数,可以选择只读部分数据,
如果只是为了研究生还者(Survived)和性别(Sex)之间的关系,可通过 usecols参数进行部分列的选取,如图
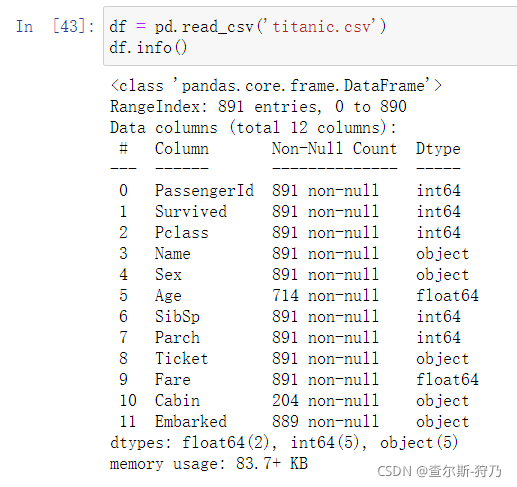
在处理很大文件的时候,需要对文件进行逐块读取,首先通过info函数查看泰坦尼克号的生还数据,共有891条数据,如图
通过chunksize参数,即可逐步读取文件,如图
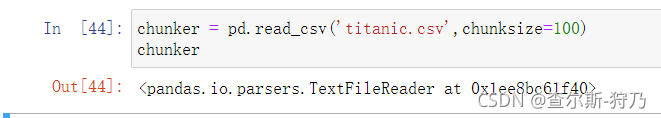
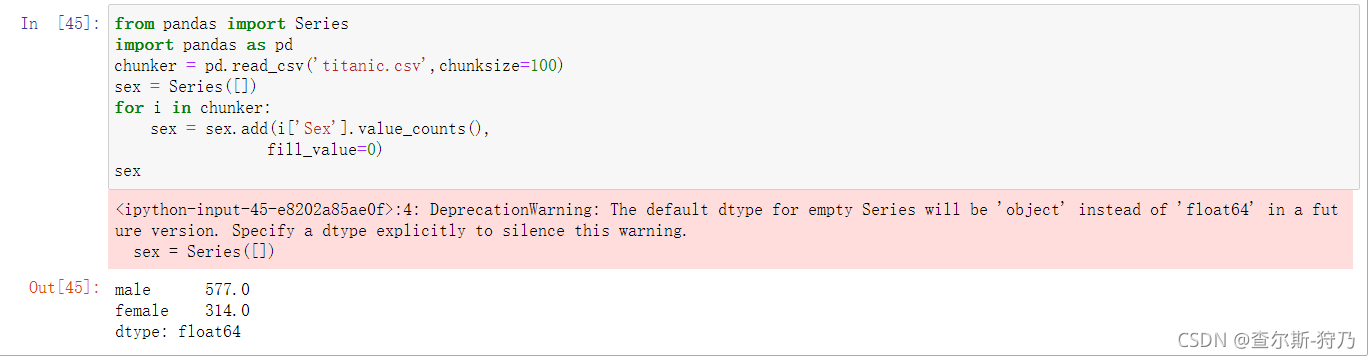
这里 返回的是可迭代的TextFileReader。通过迭代,可以对Sex列进行计数,结果如下图,代码如下
read_csv常用的参数说明如下表,更多参数说明可以参考查阅pandas官方文档。
| 参数 | 使用说明 |
| path | 文件的路径 |
| sep | 字段分隔开的字符序列,也可以使用正则表达式 |
| header | 指定列索引,默认为0(第一行),也可以为None,或者没有header行 |
| index_col | 用于行索引的列名或列编号 |
| names | 指定列索引列的名字 |
| skiprows | 需要忽略的行数(从文件开始处算) |
| nrows |
需要读取的行数(从文件开始处算) |
| chunksize | 文件块的大小 |
| usecols | 指定读取的列 |
3.1.2TXT文件的读取
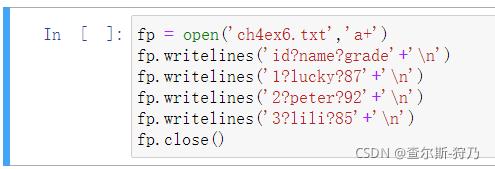
TXT文件使用的分隔符可能并不是都好,这里创建一个分隔符为“?”的TXT文档。
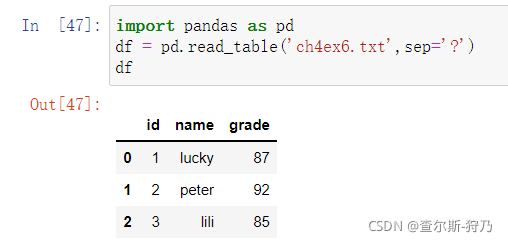
通过read_table函数中sep参数进行分隔符的指定,如下图
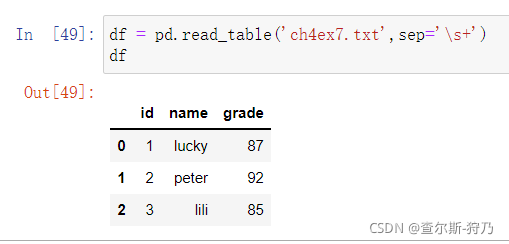
现实情况中,,有些TXT文件并没有固定的分隔符,而是用一些数量不定的空白符进行分隔,这种情况也可以手动处理,但数据量过多时,手动处理就会很耗时。这个情况可以通过正则表达式来处理。
3.1.3文本数据的存储
在对数据进行处理和分析之后,通常会把数据存储起来。下面以前面一个CSV文件为例讲解数据存储的方法,CSV文件数据如图
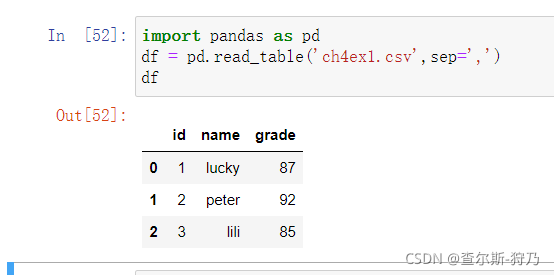
利用DataFrame的to_csv方法,可以将数据存储到以逗号分隔的CSV文件中,也可以通过sep参数指定存储的分隔符
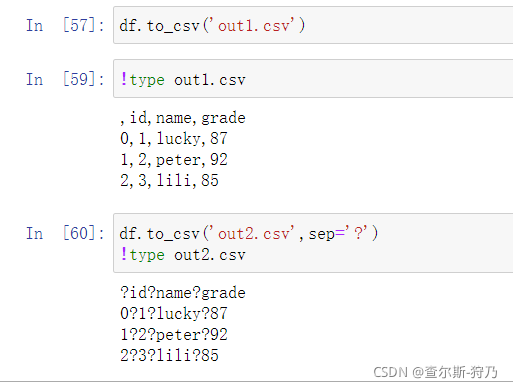
这种情况下会存储行和列索引,我们可以通过设置index和header分别处理行和列索引
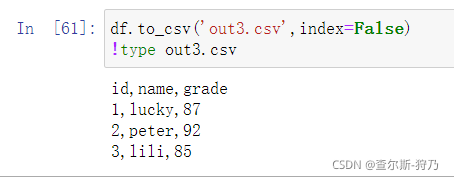
3.2JSON和Excel数据的读取和存储
3.2.1JSON数据的读取和存储
JSON(javascript object notation)数据是一种轻量级的数据交换格式,因其简单和清洗的层次结构使JSON成为了理性的数据交换语言。
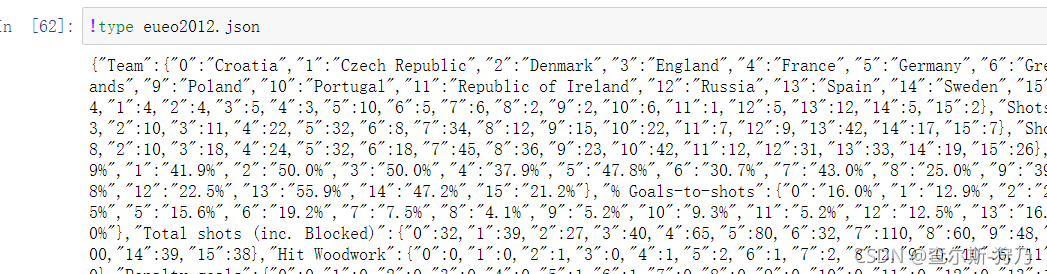
注:该数据为2012欧洲杯比赛数据
对于JSON数据,常使用两种方法来读取。一种是通过Python的第三方库json,通过下面代码可以将JSON数据转换为字符串格式,如图
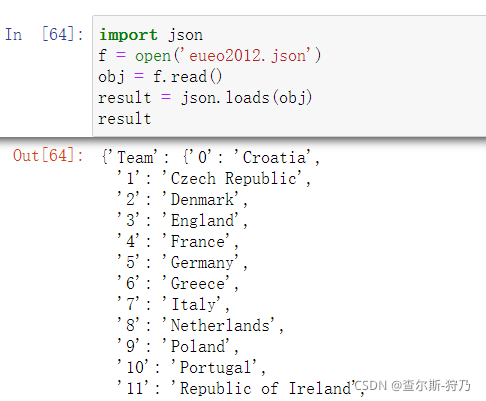
注:也可以通过json.dumps将字符串转换为json格式
然后将数据输入,DataFrame构造器,即可完成对JSON数据的读取,如图
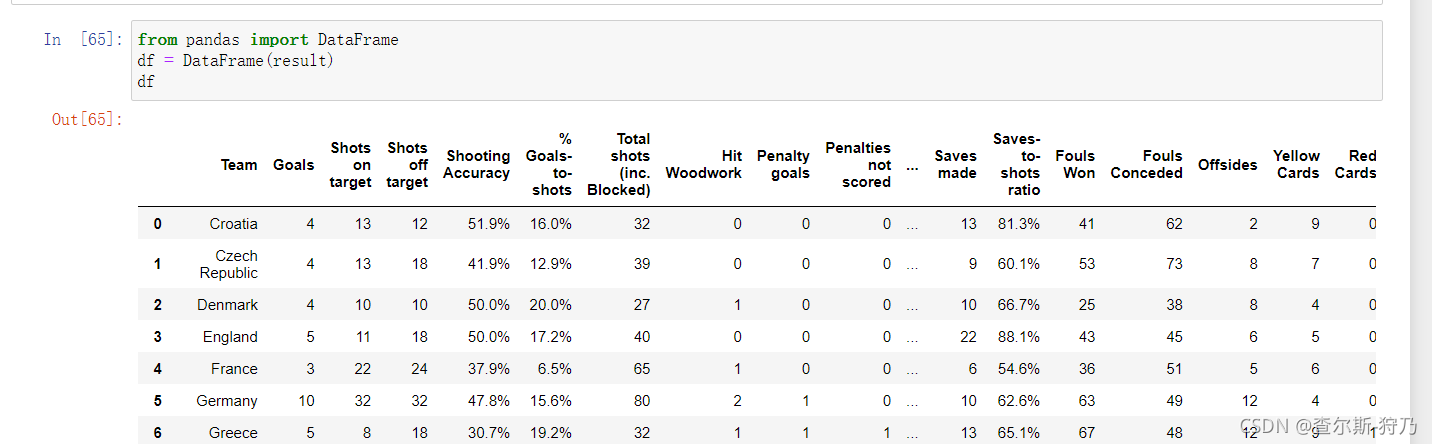
注:由于数据类似字典结构,因此读取时会乱序
另一种方法则是直接通过read_json函数来读取JSON数据
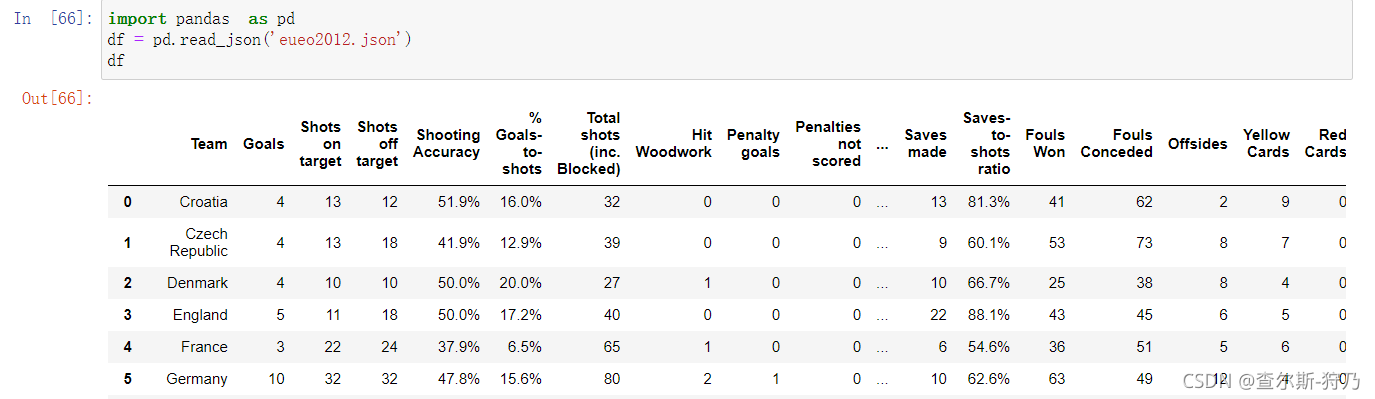
读取的时候可能会乱序,这里重新对行索引进行排序,如下图
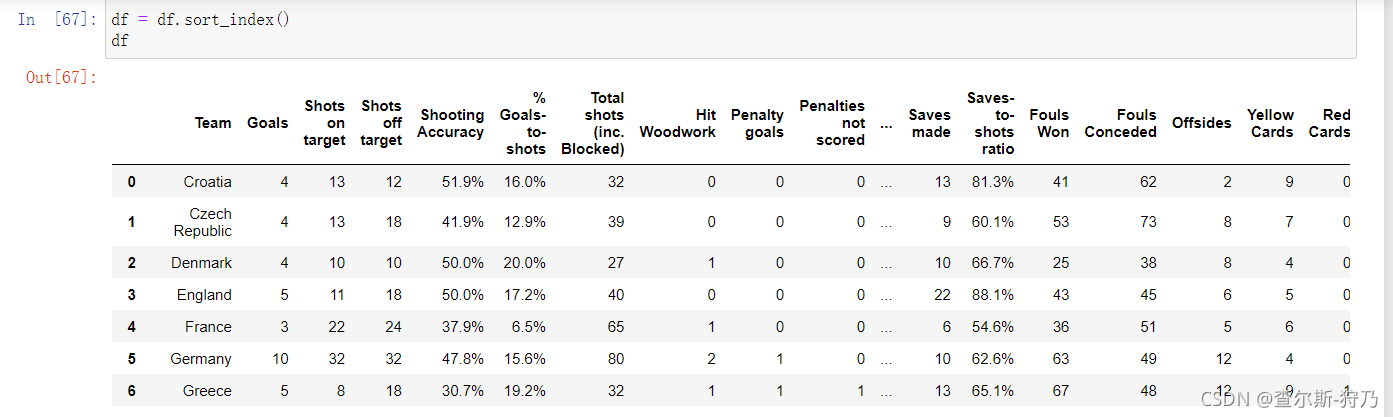
最后使用to_json函数对DataFrame数据进行相应的存储
3.2.2Excel数据的读取与存储
Excel表格数据也是工作中常用的一种数据,读者应该对其并不陌生。我们可以通过read_excel和to_excel函数对Excel数据进行读取和存储。首先创建一个Excel数据,如图
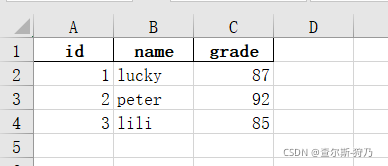
通过read_excel函数读取数据,可通过参数sheetname指定读取的工作簿,如下图
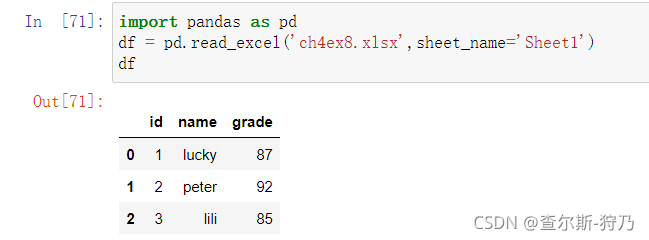
通过to_excel函数将DataFrame文件存储为Excel数据类型,如下图
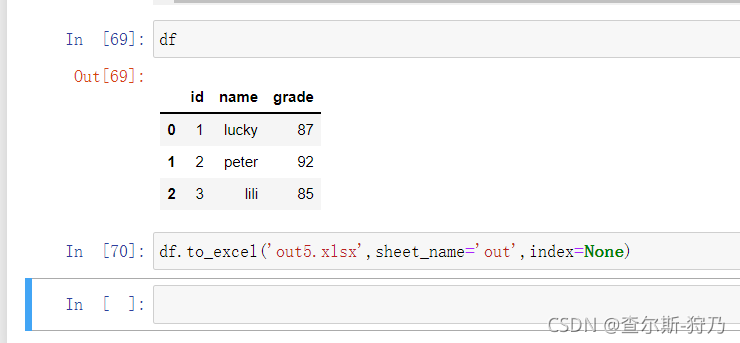
3.3数据库呢的读取与存储
3.3.1 链接数据库
首先安装python的第三方库pymsql
pip install pymysql
通过下面代码连接到本地数据库
import pymysql
conn = pymysql.connect(host='localhost',user='root',passwd='123456',db='mydb',port=3306,charset='utf8')
链接数据库后,可通过pymysql库来操作数据库,如建表、增删改查等操作。
import pymysql
conn = pymysql.connect(host='localhost',user='root',passwd='123456',db='mydb',port=3306,charset='utf8')  #链接数据库
cursor = conn.cursor()                         #创建游标

creat = '''
CREATE TABLE ch4ex9(
    id int,name char(8),grade int) ENGINE INNODB DEFAULT CHARSET=utf8;'''

cursor.execute(creat)      #执行命令
conn.commit()               #完成命令
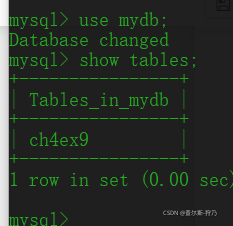
接下来插入几行数据,
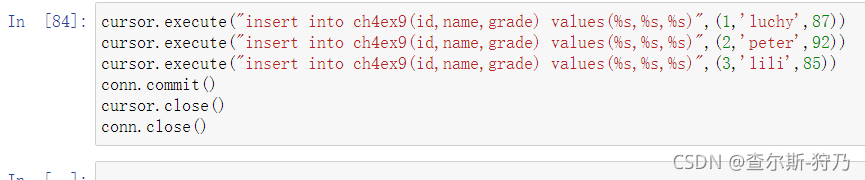
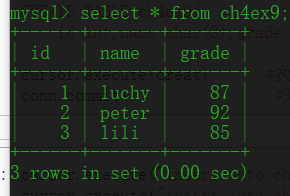
3.3.2读取数据库
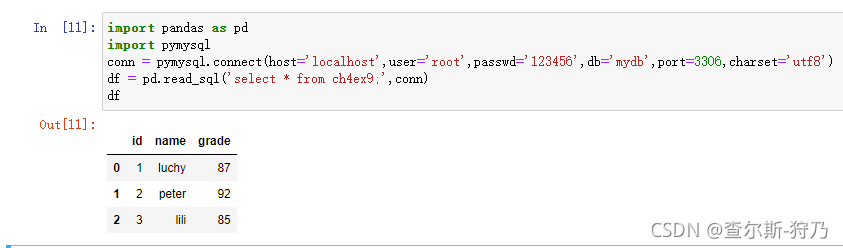
这里为你们提供两种方法提取Mysql数据,一种是通过Pymysql库读取数据库 ,然后传入DataFrame构造器中;另一种是直接使用read_sql函数进行数据的读取。
首先介绍第一种,先通过PyMySql库读取数据:
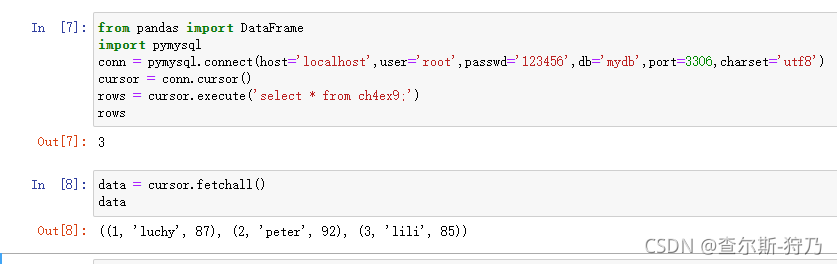
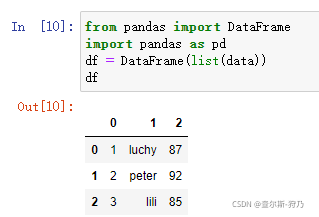
rows结果为3说明有3行数据。通过游标的fetchall方法,获得所有数据。然后把这个元组列表话后传给DataFrame构造器
另一种方法则是直接通过 read_sql函数读取MySql数据,如下图
3.3.3存储数据库
通过to_sql函数实现DataFrame数据存储为MySql数据,首先查看to_sql的参数
df.to_sql(name,con,flavor=None,schema=None,if_exists='fail',index=True,index_label=None,chunksize=None,dtype=None)

name参数为存储的表明
con参数为连接的数据库
if_exists参数用于判断是否有重复表明。其中,fail表示如果有重复表明,就不保存;replace表示替换重复表名,append表示在该表中继续插入数据。
注:新版pandas中,con参数不能使用pymsql连接数据库。
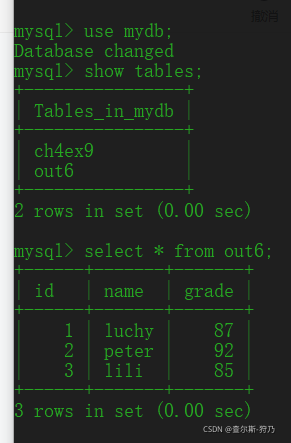
使用下面代码完成数据库的 存储,结果如下图
df.to_sql(name='out6',con='mysql+pymysql://root:123456@localhost:3306/mydb?charset=utf8',if_exists='replace',index=False)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)