eviews如何处理缺失数据填补_数据分析之缺失值处理篇
前面已经详细写过了数据预处理过程中可能涉及的问题及处理方法,这篇着重讲数据预处理中的缺失值处理。本次缺失值处理结果是基于模型效果给出的。
在实际工作中,根据不同的业务场景可能需要使用不同的算法进行特征工程或建模或其他应用,由于机器学习算法的优点与局限性,部分算法并不支持缺失值,但是在某些场景中又异常好用,这时候就需要对缺失值进行处理。
1、缺失值定义:缺失值是指粗糙数据中由于缺少信息而造成的数据不完全。
2、缺失值产生的原因:
缺失值产生的原因主要有两种:
- 机械原因:由于机械原因导致的数据收集或保存的失败造成的数据缺失,比如数据存储的失败、存储器损坏、机械故障导致某段时间数据未能收集。
- 人为原因:由于人的主观失误、历史局限或有意隐瞒造成的数据缺失,比如数据录入人员失误漏录了数据。
3、缺失值处理方法
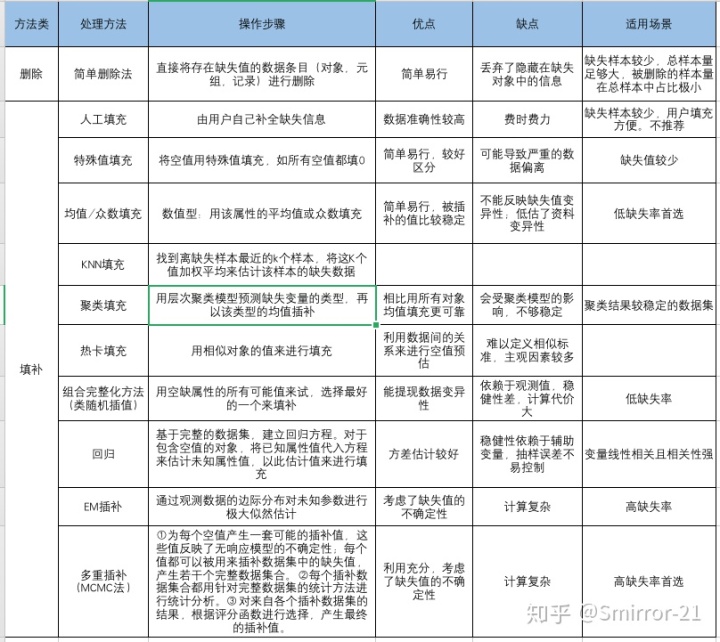
目前网上缺失值处理方法非常多,但是都大同小异,这里总结了主流的几种缺失值处理方法及其应用场景和优缺点:
4、实验对比
为了较好的对缺失值填充结果进行比较并验证结论,在模型参数和评估方式一致的前提下选取不同方法进行缺失值填充,并记录每种填充方法的模型效果,同时选取三套数据进行实验来验证结论(选取ks作为模型评估指标)
实验一:
1) 实验数据:标签A1+样本B1
2) 使用20次随机划分样本的平均ks进行评测
3) 参数设置:略
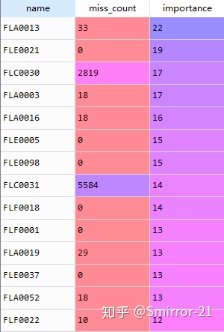
4) 特征缺失情况及重要性:
5) 部分填充方法说明:
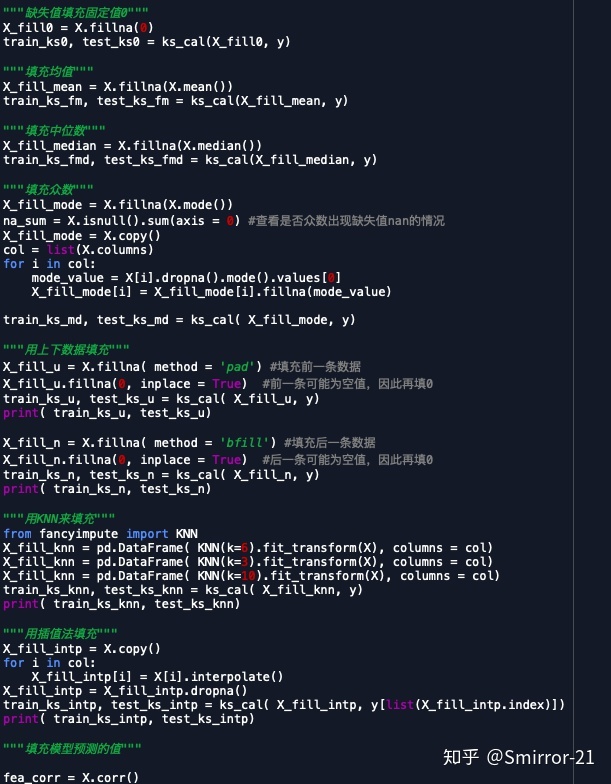
填充众数:在以众数填充时,会出现众数为缺失值的情况,所以要先去掉缺失值然后在表现值里面找出众数;同时,众数可能不止一个值,这里选取第一个来填充。
用前后数据填充:用前后数据填充时,也可能会出现前后数据为缺失值的情况。这里是先按照前后数据填充,剩余的缺失值以0填充。
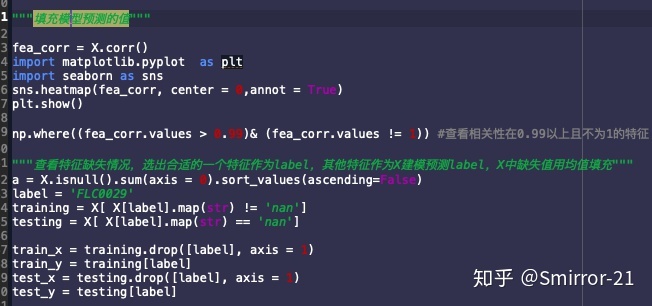
用模型预测缺失值:先查看特征之间的相关性及缺失情况,选出合适的一个特征作为label,其他特征作为X建模预测label,X中缺失值用均值填充。这里选出a——29这几个特征作为待预测的Y,选出它的原因是它的缺失比例较合适,4265条未缺失,2819条数据缺失;选取没有缺失值的数据来训练模型,预测有缺失值的数据。
6) 测试结果:
1) 测试结果:
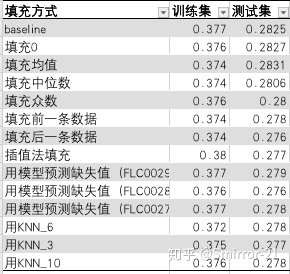
从测试结果看,这些填充方法差别不大,用均值填充相对好一点。前面几种方法及KNN在低缺失率时使用较合适,高缺失率会导致较大偏差以及会出现填充值也为缺失值的情况。插值法适用于高缺失率的情况;用模型预测缺失率要适中,缺失率太高训练样本和预测样本会严重不平衡,模型预测性会不稳定,缺失率太低,预测集太少,用模型预测意义不大。
实验二:
1) 实验数据:标签A2+样本B2
2) 使用20次随机划分样本的平均ks进行评测
3) 参数设置:略
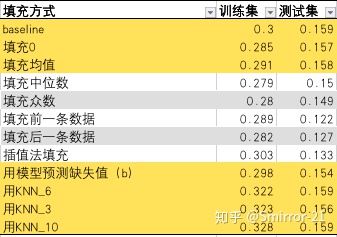
4) 建模过程及缺失值填充说明:由于特征太多且太过稀疏,因此从特征重要性中选出重要性大于0的特征进行建模;用模型预测选取的特征是b,这个特征重要性排第三,缺失率38%左右,并且是二元属性。
5) 特征缺失情况及重要性:
主要查看重要性靠前的特征:由于该数据未脱敏,这里就不放出具体表格。
6) 测试结果:
实验三:
1) 实验数据:标签A3+样本B3
2)测试结果:
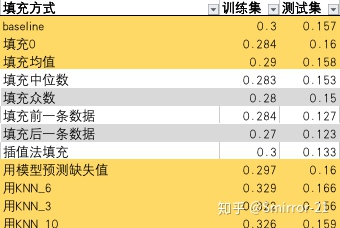
从上面结果看,填充0和均值效果都还可以,用KNN及模型预测效果较好,用插值和前后数据填充明显下降。(从模型结果看后面两个数据严重过拟合,由于数据维度较高,数据量较少,尝试过调参,很难解决,这里只是比较填充效果,故没有花过多精力去解决这个问题,后面有时间会专门说说过拟合及数据不平衡问题)
5、实验相关代码:
6、结论
总结:综上三个数据源三种数据测试结果来看,在缺失值填充方法中,填充0和均值较为稳定和方便;用前后数据及插值法填充不稳定,如果特征重要性靠前且缺失率适中的特征,可以考虑用模型预测;用KNN_6效果均不错,相比k=3或10更合适,但是使用KNN的场景需要再去查看相关文献,后续再补充。在做数据预处理时,可以多尝试几种填充方法,选择表现最佳的即可。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)