(数学建模-机器学习)K-means聚类算法(python实现)
一、算法简介:
K-means算法是典型的基于距离的非层次聚类算法,以距离作为相似性的评价指标,认为两个对象的距离越近,其相似度就越大。
二、算法流程:
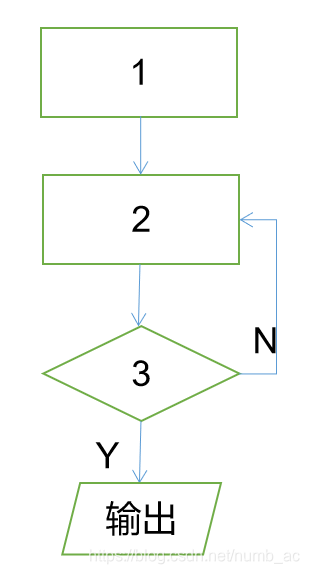
1.设置一个常数K作为类数,随机选取K个初始质心(K的取值方法以后会讲)。
2.重新计算K个聚类的质心(第一次时直接随机生成不需要计算),然后计算样本值和每个质心间的相似程度(如上文讲到,相似性评价指标为距离),将各个样本归类到其最接近的质心当中,(这样我们就“聚了”K个类了)。
3.与前次相比质心不发生变化。
三、取一些数据做例子
#代码(1)
import matplotlib.pyplot as plt

import numpy as np
x=np.array([1,3,6,3,2,1,0,7,9,8,7,0,6,2])
y=np.array([1,4,3,2,3,4,5,4,3,2,5,7,8,9])

plt.rcParams['font.sans-serif']=['SimHei'] #正常显示中文标签
plt.rcParams['axes.unicode_minus']=False   #正常显示符号标签
#上面两行是Python绘图中非常重要的语句,比较难记。此段代码虽然没有用到中文或符号,但建议同学每次绘图时写上这些,熟练就能加深记忆
plt.figure()                               #绘图范围,此处可以直接不写参数
plt.axis([-1,10,-1,10])                    #四个参数分别为x和y的最大最小范围,这里建议从负一算起
plt.grid()                                 #画网格函数,参数为两个,第一个是线条风格,默认为直线,第二个是颜色,默认为黑色
plt.plot(x,y, 'bo')                        #‘bo’里面,b代表蓝色,o代表大圆点(小点则用 . )
输出效果:
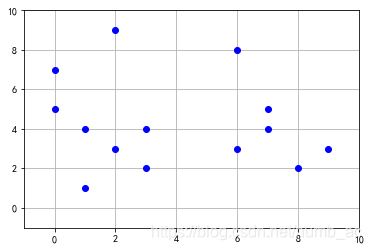
四、进行聚类分析
(以下阿拉伯数字标号与算法流程标号一致)
1.随机选取K个质心
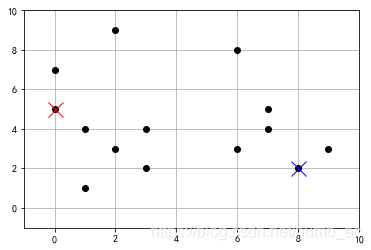
这里我们直观地看到,可能取两个质心合适一些,所以我们先取K为2,然后随机取质心为P6(0,5)和P9(8,2)注:这里的P点依照顺序为上面代码数组的顺序,编号从0开始。
在代码(1)下面加上两行代码,将这两个质心标注一下。
plt.plot(0,5,'rx',ms=15)
plt.plot(8,2,'bx',ms=15)
输出效果:
2.进行聚类:
这里我们需要引用Python内置的机器学习库sklearn.cluster,然后使用其中的 KMeans函数来进行计算。
import matplotlib.pyplot as plt

import numpy as np
x=np.array([1,3,6,3,2,1,0,7,9,8,7,0,6,2])
y=np.array([1,4,3,2,3,4,5,4,3,2,5,7,8,9])

plt.rcParams['font.sans-serif']=['SimHei'] #正常显示中文标签
plt.rcParams['axes.unicode_minus']=False   #正常显示符号标签
#上面两行是Python绘图中非常重要的语句,比较难记。此段代码虽然没有用到中文或符号,但建议同学每次绘图时写上这些,熟练就能加深记忆

from sklearn.cluster import KMeans         #引入KMeans函数
a=np.zeros(shape=(14,2))                   #这里我们新建一个二维数组,用来存我们的十四个点,每个点是一个含有两个元素的一维子数组。
for i in range(14):
    a[i][0]=x[i]
    a[i][1]=y[i]                           #用一次for循环把上面的两个一维数组x和y整合成一个二维数组。
kmeans=KMeans(n_clusters=2).fit(a)         #这里的fit(a),是以a中的元素(也就是一共的十四个子一维数组)作为元素(也就是以各个点作为元素)建立Kmeans模型。然后这个函数的意思是训练这个模型。n_clusters=2代表分为两类。此外,这里默认了最多进行十次循环。
pred=kmeans.predict(a)
print(pred)                                #输出数据
输出结果:
[0 0 1 0 0 0 0 1 1 1 1 0 1 0]
其中0和1各自表示一类,输出的含义是P0,P1, P3, P4, P5, P6, P11, P13是一类,其它点是另外一类。我们用直观地判断验证一下:
从上面的点阵中我们可以直观地将这些点分为左右两类(如图所示):
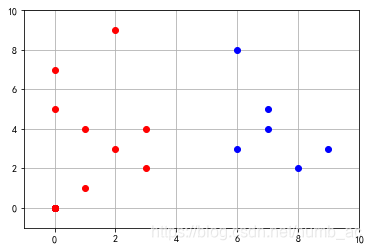
发现与我们的输出结果是一致的
因此,我们继续完善代码,将[0 0 1 0 0 0 0 1 1 1 1 0 1 0]这样的表示变为图示,代码如下:
import matplotlib.pyplot as plt

import numpy as np
x=np.array([1,3,6,3,2,1,0,7,9,8,7,0,6,2])
y=np.array([1,4,3,2,3,4,5,4,3,2,5,7,8,9])

plt.rcParams['font.sans-serif']=['SimHei'] #正常显示中文标签

from sklearn.cluster import KMeans         #引入KMeans函数
a=np.zeros(shape=(14,2))                   #这里我们新建一个二维数组,用来存我们的十四个点,每个点是一个含有两个元素的一维子数组。
for i in range(14):
    a[i][0]=x[i]
    a[i][1]=y[i]                           #用一次for循环把上面的两个一维数组x和y整合成一个二维数组。
kmeans=KMeans(n_clusters=2).fit(a)         #这里的fit(a),是以a中的元素(也就是一共的十四个子一维数组)作为元素(也就是以各个点作为元素)建立Kmeans模型。然后这个函数的意思是训练这个模型。n_clusters=2代表分为两类。此外,这里默认了最多进行十次循环。
pred=kmeans.predict(a)
print(pred)                                #输出数据

ax0=np.zeros(shape=(14,1))                 #我们将两类点分开放在四个数组中,数组分别存两类点的x和y坐标
ay0=np.zeros(shape=(14,1))
ax1=np.zeros(shape=(14,1))
ay1=np.zeros(shape=(14,1))
len0=0
len1=0
for i in range(14):
    if pred[i]==0:
      ax0[len0]=x[i]
      ay0[len0]=y[i]
      len0+=1
    if pred[i]==1:
      ax1[len1]=x[i]
      ay1[len1]=y[i]
      len1+=1

plt.figure()                               #绘图范围,此处可以直接不写参数
plt.axis([-1,10,-1,10])                    #四个参数分别为x和y的最大最小范围,这里建议从负一算起
plt.grid()                                 #画网格函数,参数为两个,第一个是线条风格,默认为直线,第二个是颜色,默认为黑色
plt.plot(ax0,ay0, 'bo')                        #‘bo’里面,b代表蓝色,o代表大圆点(小点则用 . )
plt.plot(ax1,ay1, 'ro')
运行效果:
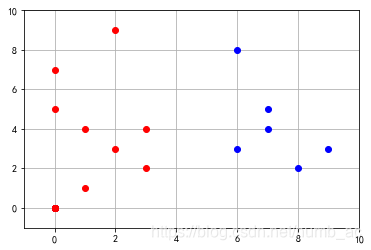
与我们预期相同。
事实上,由于质心的选取存在随机性,有时也会输出这样的图:
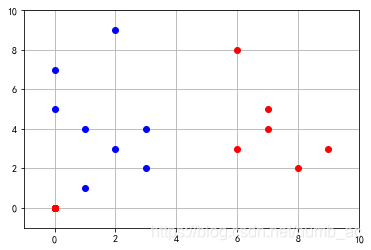
重复运行程序一百次后,仍然只有这两种情况。
五、结语
此文中的例子比较简单,只作为K-means聚类算法的基础学习参考。更复杂的应用情况,等待之后更新。
六、参考资料
https://blog.csdn.net/Andy_shenzl/article/details/83276084
https://www.cnblogs.com/IvyWong/p/10320770.html
七、作者
代码、注释及图表均为作者原创,转载时请注明出处,谢谢!欢迎大家一起学习交流!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)