python3《机器学习实战系列》学习笔记----4.线性模型之Logistic回归
前言
机器学习实战系列之学习笔记主要是本人进行学习机器学习的整理。本系列所有代码是用python3编写,并使用IDE Pycharm在Windows平台上编译通过。本系列所涉及的所有代码和资料可在我的github或者码云上下载到,gitbub地址:https://github.com/mcyJacky/MachineLearning,码云地址:https://gitee.com/mcyHome/MachineLearning,如有问题,欢迎指出~。
一、理论基础
1.1 基本形式
给定由
d
d
<script type="math/tex" id="MathJax-Element-51">d</script>个属性描述的示例<script type="math/tex" id="MathJax-Element-52">x = (x_1;x_2;...;x_d)</script>,其中
xi
x
i
<script type="math/tex" id="MathJax-Element-53">x_i</script>是
x
x
<script type="math/tex" id="MathJax-Element-54">x</script>在第<script type="math/tex" id="MathJax-Element-55">i</script>个属性上的取值,线性模型试图学得一个通过属性的线性组合来进行预测的函数,即:
一般用向量形式写成:
其中 w=(w1;w2;...;wd) w = ( w 1 ; w 2 ; . . . ; w d ) <script type="math/tex" id="MathJax-Element-58">w=(w_1;w_2;...;w_d)</script>,当 w w <script type="math/tex" id="MathJax-Element-59">w</script>和<script type="math/tex" id="MathJax-Element-60">b</script>确定之后模型就得以确定。
1.2 Sigmoid函数
当考虑二分类问题时,其输出标记 y∈{0,1} y ∈ { 0 , 1 } <script type="math/tex" id="MathJax-Element-61">y\in\{0,1\}</script>,而线性回归模型产生的预测值 z=wTx+b z = w T x + b <script type="math/tex" id="MathJax-Element-62">z = w^Tx + b</script>是实值,于是,我们需要将实值 z z <script type="math/tex" id="MathJax-Element-63">z</script>转化为0/1。这种情况下,最理想的是阶跃函数:
即若预测值
z
z
<script type="math/tex" id="MathJax-Element-65">z</script>大于零就判为正例,小于零则判为反例,预测值为临界值零则任意判断,如下图1.1所示。
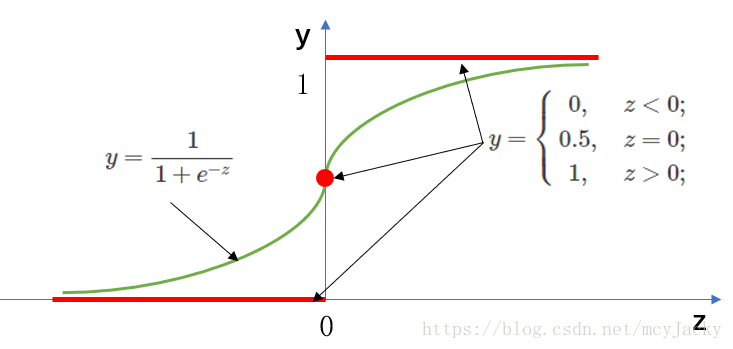
图1.1 单位阶跃函数与对数几率函数
由图1.1所知,单位阶跃函数不连续,所以它不单调可微。而对数几率函数正是一个常用的替代函数:
对数几率函数是一种“Sigmoid函数”,它将 z z <script type="math/tex" id="MathJax-Element-67">z</script>值转化为一个接近<script type="math/tex" id="MathJax-Element-68">0</script>或 1 1 <script type="math/tex" id="MathJax-Element-69">1</script>的<script type="math/tex" id="MathJax-Element-70">y</script>值。
1.3 对数几率回归(Logistic Regression)
我们将线性模型函数带入Sigmoid函数得到:
所以:
若将 y y <script type="math/tex" id="MathJax-Element-73">y</script>视为样本<script type="math/tex" id="MathJax-Element-74">x</script>作为正例的可能性,则 1−y 1 − y <script type="math/tex" id="MathJax-Element-75">1-y</script>是其反例可能性,两者的比值:
称为“几率”(odds),反映了x作为正例的相对可能性,对几率取对数则得到“对数几率”(log odds,亦称logit)。
由此可以看出,我们是用线性回归模型的预测结果去逼近真实标记的对数几率,因此,其对应的模型称为“对数几率回归”。它的名字虽然是“回归”,但实际却是一种分类的方法。
1.4 Logistic回归模型和梯度上升算法
为了计算方便,我们将线性回归中的权值向量和输入向量进行扩充,仍记作
w,x
w
,
x
<script type="math/tex" id="MathJax-Element-78">w,x</script>,即
w=(w1;w2;...;wn;b)
w
=
(
w
1
;
w
2
;
.
.
.
;
w
n
;
b
)
<script type="math/tex" id="MathJax-Element-79">w=(w_1;w_2;...;w_n;b)</script>,
x=(x1;x2;...;xn;1)
x
=
(
x
1
;
x
2
;
.
.
.
;
x
n
;
1
)
<script type="math/tex" id="MathJax-Element-80">x=(x_1;x_2;...;x_n;1)</script>。此时,logistics回归模型如下:
可以转化为:
所以:
上式就是在已知样本
x
x
<script type="math/tex" id="MathJax-Element-84">x</script>和参数<script type="math/tex" id="MathJax-Element-85">w</script>的条件下,样本
x
x
<script type="math/tex" id="MathJax-Element-86">x</script>属于正例和负例的条件概率。若给定训练数据集<script type="math/tex" id="MathJax-Element-87">T=\{(x_1,y_1), (x_2,y_2)...,(x_N,y_N)\}</script>,其中
xi∈Rn
x
i
∈
R
n
<script type="math/tex" id="MathJax-Element-88">x_i\in\mathbf{R}^n</script>,
yi∈{0,1}
y
i
∈
{
0
,
1
}
<script type="math/tex" id="MathJax-Element-89">y_i\in\{0,1\}</script>,可以用极大似然估计法估计模型参数,从而得到logistics模型。
似然函数为:
对数似然函数为:
其中, N N <script type="math/tex" id="MathJax-Element-92">N</script>为样本的总数,有<script type="math/tex" id="MathJax-Element-93">y^i</script>表示第 i i <script type="math/tex" id="MathJax-Element-94">i</script>个样本的类别,<script type="math/tex" id="MathJax-Element-95">x_i</script>表示第 i i <script type="math/tex" id="MathJax-Element-96">i</script>个样本,<script type="math/tex" id="MathJax-Element-97">w</script>和 xi x i <script type="math/tex" id="MathJax-Element-98">x_i</script>是多维向量。
现在我们需要求 似然函数的最大值,我们使用 梯度上升算法。它的思路就是要找到某函数的最大值,最好的方法是沿着该函数的梯度方向探寻。如果梯度记作 ∇ ∇ <script type="math/tex" id="MathJax-Element-99">\nabla</script>,则函数 f(x,y) f ( x , y ) <script type="math/tex" id="MathJax-Element-100">f(x,y)</script>的梯度可表示为:
梯度方向是函数增长最快的方向,我们将梯度的移动量大小设为 α α <script type="math/tex" id="MathJax-Element-102">\alpha</script>,也称为步长。用向量来表示 梯度上升算法迭代公式如下:
该公式将一直被迭代,直到 达到某个停止条件为止,比如迭代次数达到某个指定值或算法达到某个可以允许的误差范围。
公式推导过程:
由公式:
对 L(w) L ( w ) <script type="math/tex" id="MathJax-Element-105">L(w)</script>对 w w <script type="math/tex" id="MathJax-Element-106">w</script>求偏导:
右边第一项:
右边第二项:
右边第三项:
所以可求出:
从推导结果大致可以看出,对数似然函数的梯度为: (实际值-预测值)*某特征向量。
二、Logistic回归实战
在实际运算过程中,我们一般采取以下步骤:
- (1)收集数据:采用任意方法收集数据;
- (2)准备数据:由于需要进行距离计算,因此要求数据类型为数值型。另外,结构化数据格式则最佳;
- (3)分析数据:采用任意方法对数据进行分析;
- (4)训练算法:大部分时间都会用于训练,训练的目的是为了找到最佳的分类回归系数;
- (5)测试算法:一旦训练步骤完成,分类将会很快;
- (6)使用算法:首先,我们需要输入一些数据,并将其转换成对应的结构化数值;接着,基于训练好的回归系数就可以对这些数值进行简单的回归计算,判定它们属于哪个类别;在这之后,我们就可以在输出的类别上做一些其他分析工作;
2.1 准备数据
下面我们有一个简单的测试数据集testSet.txt文档,数据的第一列和第二列表示特征值,第三列表示分类,它是一个二分类的问题,部分测试数据如下所示:
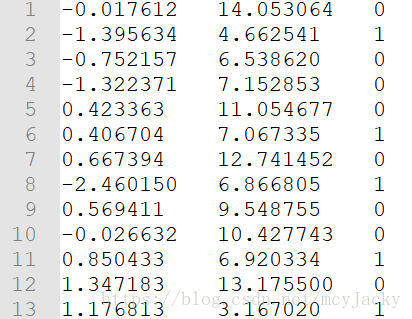
数据点绘制成散点图如下2.1:
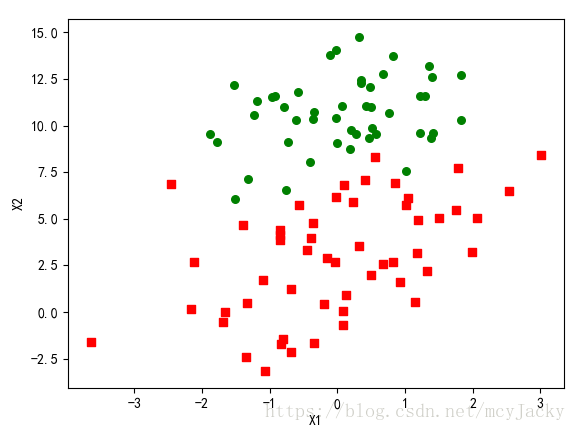
图2.1测试数据分布图
2.2 训练算法:使用梯度上升找到最佳参数
图2.1中有100个样本点,每个点包含两个数值特征:
X1
X
1
<script type="math/tex" id="MathJax-Element-112">X1</script>和
X2
X
2
<script type="math/tex" id="MathJax-Element-113">X2</script>。在此数据集我们将通过使用梯度上升法找到最佳回归系数,也就是拟合出Logistic回归模型的最佳参数。
梯度上升法的伪代码如下:
每个回归系数初始化为1
重复R次:
    计算整个数据集的梯度
    使用alphaxgradient更新回归系数的向量
返回回归系数
下面是梯度上升算法的具体实现:
import numpy as np
import time

'''
#function: 载入训练数据集
#param: none
#return:
    dataMat [list] 特征向量
    labelMat [list] 特征标签
'''
def loadDataSet():
    dataMat = []; labelMat = [] #初始化特征向量和分类标签列表
    with open(r'.\testSet.txt', 'r') as fr:
        for line in fr.readlines():
            lineArr = line.strip().split()
            dataMat.append([1, float(lineArr[0]), float(lineArr[1])])   #插入特征值,前面多加1
            labelMat.append(int(lineArr[-1]))   #插入分类标签
    fr.close()
    return dataMat, labelMat

'''
#function: sigmoid函数
#param:
    inX [matrix/num] 函数参数
#return: 函数值
'''
def sigmoid(inX):
    return 1 / (1 + np.exp(-inX))

'''
#function: 梯度上升法
#param:
    dataMatIn [list] 特征向量
    classLabels [list] 特征标签
#return:
    weights [matrix] 回归系数
'''
def gradAscent(dataMatIn, classLabels):
    dataMatrix = np.mat(dataMatIn)              #列表转化为矩阵
    m, n = np.shape(dataMatrix)
    labelMat = np.mat(classLabels).transpose()  #矩阵的转置
    alpha = 0.001       #迭代步长
    maxCycles = 500     #迭代次数
    weights = np.ones((n,1))    #初始化回归系数
    for i in range(maxCycles):
        h = sigmoid(dataMatrix * weights)   #预测值
        error = labelMat - h    #误差
        weights = weights + alpha * dataMatrix.transpose() * error  #梯度上升
    return weights

if __name__ == '__main__':
    start = time.clock()
    dataArr, labelMat = loadDataSet()
    print(dataArr)
    print(labelMat)
    weights = gradAscent(dataArr, labelMat)
    print(weights)
    end = time.clock()
    print(end - start)

'''输出结果:
[[1, -0.017612, 14.053064], [1, -1.395634, 4.662541],..., [1, 0.317029, 14.739025]]
[0, 1, 0, 0, 0, 1, 0,...,1, 0, 0]
[[ 4.12414349]
 [ 0.48007329]
 [-0.6168482 ]]
0.029194682932779513
'''首先我们先用loadDataSet()函数将文本数据转化成我们能用的数值列表,然后用sigmoid()函数计算数值(上述对应的是矩阵运算),最后运用gradAscent()函数来计算回归系数。
2.3 分析数据:画出决策边界
上述的计算已经解出了一组回归系数,它确定了不同类别数据之间的分隔线。下面使用plotBestFit()函数绘制出最佳拟合直线:
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif']=['SimHei'] #用来正常显示中文标签
plt.rcParams['axes.unicode_minus']=False #用来正常显示负号

'''
#function: 绘制拟合线
#param:
    weights [matrix] 回归系数
#return: 拟合曲线图
'''
def plotBestFit(weights):
    dataMat, lableMat = loadDataSet()
    dataArr = np.array(dataMat)
    n = np.shape(dataArr)[0] #行数
    xcord1 = []; ycord1 = [] #分类点1
    xcord2 = []; ycord2 = [] #分类点2
    for i in range(n):
        if int(lableMat[i]) == 1:
            xcord1.append(dataArr[i, 1]); ycord1.append([dataArr[i, 2]])
        else:
            xcord2.append(dataArr[i, 1]); ycord2.append([dataArr[i, 2]])
    fig = plt.figure()
    ax = fig.add_subplot(111)
    ax.scatter(xcord1, ycord1, s=30, c='red', marker='s') #绘制散点图
    ax.scatter(xcord2, ycord2, s=30, c='green')
    x1 = np.arange(-3.0, 3.0, 0.1) #x轴的取值范围
    weights = np.array(weights).ravel() #将数组降维
    x2 = (-weights[0]- weights[1] * x1) / weights[2] #y = w0 + w1*x + w2 * x ==> 当y = 0时
    ax.plot(x1, x2)
    plt.xlabel('x1'); plt.ylabel('x2')
    plt.show()

if __name__ == '__main__':
    dataArr, labelMat = loadDataSet()
    weights = gradAscent(dataArr, labelMat)
    plotBestFit(weights)
绘制出拟合直线如下图2.2所示:
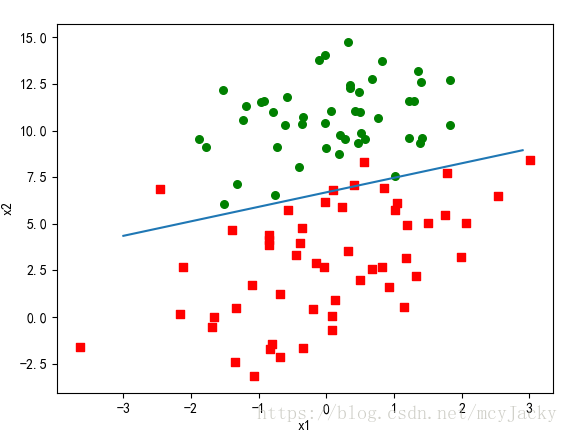
图2.2 梯度上升算法在迭代500次后得到的Logistic最佳拟合曲线
由图2.2可以看出,这次的分类效果相当不错,从图上看只分错了两到四个点。但是,尽管在这么小的数据集中,我们也使用了大量的计算(每次做梯度计算时,都需要遍历整个数据集进行相乘)。下面对该算法稍作改动。
2.4 训练算法:随机梯度上升
我们已经知道梯度上升算法在每次更新回归系数时都需要遍历整个数据集,该方法在处理100个左右的数据集尚可,但是如果有数亿个样本和成千上万的特征,那么该方法的计算复杂度就会太高了。一种改进的方法是一次仅用一个样本点来更新回归系数,该方法称为随机梯度上升算法。由于可以在样本到来时对分类器进行增量式更新,因此随机梯度上升算法是一个在线学习算法,而与在线学习算法相对应的是一次处理所有数据被称作是“批处理”。随机梯度上升算法的伪代码如下:
所有回归系数初始化为1
对数据集中每个样本
    计算该样本的梯度
    使用alphaxgradient更新回归系数值
返回回归系数值
具体代码实现如下:
'''
#function: 随机梯度上升
#param:
    dataMatrix [darray] 特征向量
    classLabels [list] 特征标签
#return:
    weights [matrix] 回归系数
'''
def stocGradAscent0(dataMatrix, classLabel):
    m, n = np.shape(dataMatrix)
    alpha = 0.01
    weights = np.ones(n) #创建一维数组 n表示数组个数
    for i in range(m):
        h = sigmoid(np.sum(dataMatrix[i] * weights)) #数值
        error = classLabel[i] - h   #误差值,非向量
        weights = weights + alpha * error * dataMatrix[i] #梯度上升
    return weights

if __name__ == '__main__':
    weights = stocGradAscent0(np.array(dataArr), labelMat)
    print(weights)
    plotBestFit(weights)
通过随机梯度上升算法我们可以拟合出如下图2.3所示:
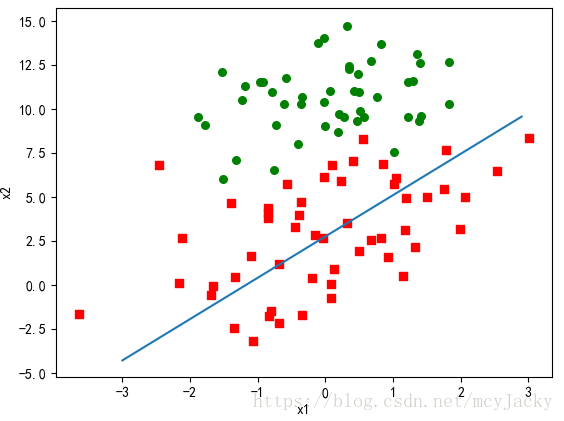
图2.3 随机梯度上升算法的执行结果
从图2.3拟合直线的效果来看也还不错,但是并不像图2.2这样完美,但是图2.2得到的结果是在整个数据集上迭代500次得到的结果,而随机梯度算法是在整个数据集上运行了200次。下面我们采用一种改进的随机梯度上升算法来改进。
'''
#function: 改进的随机梯度上升
#param:
    dataMatrix [numpy.ndarray] 特征向量
    classLabels [list] 特征标签
    numIter [num] 迭代次数
#return:
    weights [numpy.ndarray] 回归系数
'''
def stocGradAscent1(dataMatrix, classLabels, numIter=150):
    m, n = np.shape(dataMatrix)
    weights = np.ones(n)
    for j in range(numIter):
        dataIndex = list(range(m))
        for i in range(m):
            alpha = 4 / (1.0 + i + j) + 0.01  # 调整alpha步长
            randIndex = int(np.random.uniform(0, len(dataIndex)))  # 选取随机量进行更新
            h = sigmoid(sum(dataMatrix[randIndex] * weights))
            error = classLabels[randIndex] - h
            weights = weights + alpha * error * dataMatrix[randIndex]
            del(dataIndex[randIndex])
    return weights

if __name__ == '__main__':
    weights = stocGradAscent1(np.array(dataArr), labelMat)
plotBestFit(weights) 在改进的随机梯度上升算法中,我们主要对两方面进行了改进。①迭代步长alpha在每次迭代过程中都会减少,但是永远都有一个常系数(保证多次迭代后对数据还有一定的影响)。在上述降低alpha函数中,alpha每次减少1/(i + j),其中j是迭代次数,i是样本点的下标。当j << max(i) ,alpha就是不严格下降,这样就避免参数的严格下降。②通过随机选取样本来更新回归系数,这样可以减少周期性的波动,而且算法还增加了第三个参数表示迭代次数。改进的随机梯度上升算法拟合结果如下图2.4:
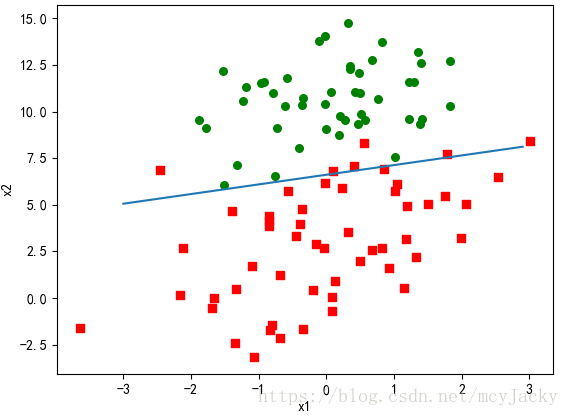
图2.4 改进的随机梯度上升算法的执行结果
三、示例:从疝气病预测病马的死亡率
现在我们用Logistic回归来预测患有疝病的马的存活问题。其流程步骤如下:
- (1)收集数据:给定数据文件;
- (2)准备数据:准备Python解析文本文件并填充缺失值;
- (3)分析数据:可视化并观察数据;
- (4)训练算法:使用优化算法,找到最佳的系数;
- (5)测试算法:为了量化回归的效果,需要观察错误率。根据错误率决定是否回退到训练阶段,通过改变迭代的次数和步长等参数来得到更好的回归系数;
- (6)使用算法:使用一个简单的命令行程序来收集马的症状并输出预测结果。
3.1 准备数据:处理数据中的缺失值
数据中的缺失值是一个非常棘手的问题,有很多文献都致力于解决这个问题。那么,数据缺失究竟会带来什么问题?假设有100个样本和20个特征,这些数据都是机器收集回来的。若机器上某个传感器损坏导致一个特征无效时该怎么办?此时是否要扔掉整个数据?这种情况下,另外19个特征怎么办?它们是否还可用?答案是肯定的。因为数据有时候相当昂贵,扔掉和重新获取都是不可取的,所以必须采用一些方法来解决这个问题:
- 使用可用的特征值的均值来填补缺失值;
- 使用特殊值来填补缺失值,如-1;
- 忽略有缺失值的样本;
- 使用相似样本的均值填补缺失值;
- 使用另外的机器学习算法预测缺失值;
这里,我们只简单叙述对数据进行预处理的方法。我们在预处理阶段,①我们对所有缺失值必须用一个实数值来替换,即如果某特征用0替换后,那么该特征系数将不会更新,而通过Sigmoid函数计算结果为0.5,对结果的预测也不具任何的倾向性。②如果在测试数据集中发现了一条数据的类标签已经缺失,那么简单的做法是将该数据丢弃,因为类标签与特征不同,很难确定采用某个合适的值来替换。
通过预处理,我们得到两个文件:horseColicTest.txt和horseColicTraining.txt,一个测试数据和一个训练数据。
3.2 测试算法:用Logistic回归进行分类
使用Logistic回归方法进行分类并不需要很多工作,所需做的只是把测试集上每个特征向量乘以最优化方法得来的回归系数,再将该乘积结果求和,最后输入到Sigmoid函数中即可。如果对应的Sigmoid值大于0.5就预测标签为1,否则为0。
'''
#function: 分类函数
#param:
    inX [numpy.ndarray] 测试特征向量
    weights [numpy.ndarray] 回归系数
#return: 分类结果
'''
def classifyVector(inX, weights):
    prob = sigmoid(sum(inX*weights))
    if prob > 0.5: return 1.0
    else: return 0.0

'''
#function: 数据处理主函数
#param: None
#return:
    errorRate [num] 测试数据的错误率
'''
def colicTest():
    frTrain = open(r'.\horseColicTraining.txt') #打开训练文本文件
    frTest = open(r'.\horseColicTest.txt')      #打开测试文本文件
    trainingSet = []; trainingLabels = []
    for line in frTrain.readlines():
        currLine = line.strip().split('\t')
        lineArr = []
        for i in range(21):
            lineArr.append(float(currLine[i]))
        trainingSet.append(lineArr)                 #添加训练特征向量
        trainingLabels.append(float(currLine[-1]))  #添加训练特征标签
    trainWeights = stocGradAscent1(np.array(trainingSet), trainingLabels, 500) #使用改进的随机梯度算法计算回归系数
    errorCount = 0; numTestVect = 0.0
    for line in frTest.readlines():
        numTestVect += 1.0
        currLine = line.strip().split('\t')
        lineArr = []
        for i in range(21):
            lineArr.append(float(currLine[i]))
        if int(classifyVector(np.array(lineArr), trainWeights)) != int(currLine[-1]): #分类判断
            errorCount += 1
    errorRate = float(errorCount) / numTestVect #错误率计算
    print(f"the error rate of this test is: {errorRate}")
    return errorRate

'''
#function: 多次计算求平均值
#param: None
#return: 平均错误率
'''
def multiTest():
    numTests = 10; errorSum = 0.0
    for k in range(numTests):
        errorSum += colicTest()
    print(f'after {numTests} iterations the avg error rate is: {errorSum/float(numTests)}')

if __name__ == '__main__':
    start = time.clock()
    multiTest()
    end = time.clock()
    print(end - start)

'''输出结果:
the error rate of this test is: 0.34328358208955223
the error rate of this test is: 0.23880597014925373
the error rate of this test is: 0.34328358208955223
the error rate of this test is: 0.40298507462686567
the error rate of this test is: 0.31343283582089554
the error rate of this test is: 0.44776119402985076
the error rate of this test is: 0.3582089552238806
the error rate of this test is: 0.417910447761194
the error rate of this test is: 0.3582089552238806
the error rate of this test is: 0.3880597014925373
after 10 iterations the avg error rate is: 0.3611940298507463
29.20000236854104
'''
上述首先通过classifyVector()函数,以回归系数和输入特征向量为参数计算Sigmoid值进行预测。接着使用colicTest()函数,打开训练和测试数据集,并对数据进行格式化处理,并使用改进的随机梯度算法迭代500次进行计算,并测试错误率。最后,使用multiTest()函数将10次错误率计算结果求平均值。
通过计算结果可知10次迭代后的评价错误率为36%。而事实上,这个结果并不差,因为有30%的数据缺失。当然如果调整colicTest()中的迭代次数和stocGradAcent1()中的步长,平均错误率可以降到20%左右。
四、小结
①Logistic回归的目的是寻找一个非线性函数Sigmoid的最佳拟合参数,求解过程可以由最优化算法完成,在最优化算法中,最常用的是梯度上升算法,而梯度上升算法又可以简化为改进的随机梯度上升算法。
②随机梯度上升算法与梯度上升算法的效果相当,但占用更少的计算资源。此外,随机梯度上升算法是一个在线的算法,它可以在新数据到来时就完成参数更新,而不需要重新读取整个数据集来进行批处理计算。
②Logistic回归的优点:计算代价不高,易于理解和实现;缺点:容易欠拟合,分类精度可能不高。试用数据类型:数值型和标称型数据。
【参考】:
1. 《统计学习方法》作者:李航 第6章 逻辑斯谛回归与最大熵模型
2. 《机器学习实战》作者:Peter Harrington 第5章 Logistic回归
3. 《机器学习》作者:周志华 第3章 线性模型
转载声明:
版权声明:非商用自由转载-保持署名-注明出处
署名 :mcyJacky
文章出处:https://blog.csdn.net/mcyJacky

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)